
ملاحظة الكاتب: أصبحت أوزان ونشين 5.5 Flash Base مفتوحة المصدر متاحة للتنزيل. تساعدك هذه المقالة على الاختيار بين النشر الذاتي للنموذج الأساسي واستدعائه عبر API عند الحاجة، من خلال أربعة جوانب: معلمات البنية، ومتطلبات العتاد، والغرض من الاستخدام، والتكلفة.
في 5 نوفمبر 2026، أطلقت بايدو رسميًا وأتاحت أوزان ونشين 5.5 Flash Base (ERNIE-5.5-Flash-Base) كمصدر مفتوح. وهو نموذج أساسي بتقنية خليط الخبراء المتناثر (MoE)، يضم 280B معلمة إجمالًا، ويُفعّل 14B منها لكل رمز (token). وقد حقق نتائج رائدة بين النماذج ذات الحجم المماثل في عدة اختبارات معيارية. تتوفر الأوزان على Hugging Face بإصداري FP8 وBF16، كما صدرت إضافة vLLM ودليل SGLang Cookbook بالتزامن معها. هذه المرة لم يقتصر الإصدار على ورقة بحثية من دون أوزان.
هذه ليست مقالة أخرى تسرد نتائج الاختبارات فحسب. فكثير من الفرق ترى عبارة «مفتوح المصدر وذو نتائج رائدة» فتستعد لتنزيل الأوزان ونشر النموذج، لكنها تتجاهل حقيقة أساسية: إنه نموذج أساسي (Base) لم يخضع للتدريب المتوسط أو اللاحق. وهو مناسب كنقطة انطلاق للتدريب، لكنه ليس جاهزًا للاستخدام المباشر كروبوت محادثة.
ما ستستفيده: بعد قراءة المقالة، ستعرف الحالات التي يناسبها ونشين 5.5 Flash Base، ومقدار ذاكرة GPU التقريبي اللازم لنشره ذاتيًا، والظروف التي يكون فيها استدعاؤه عبر API عند الحاجة أقل تكلفة.
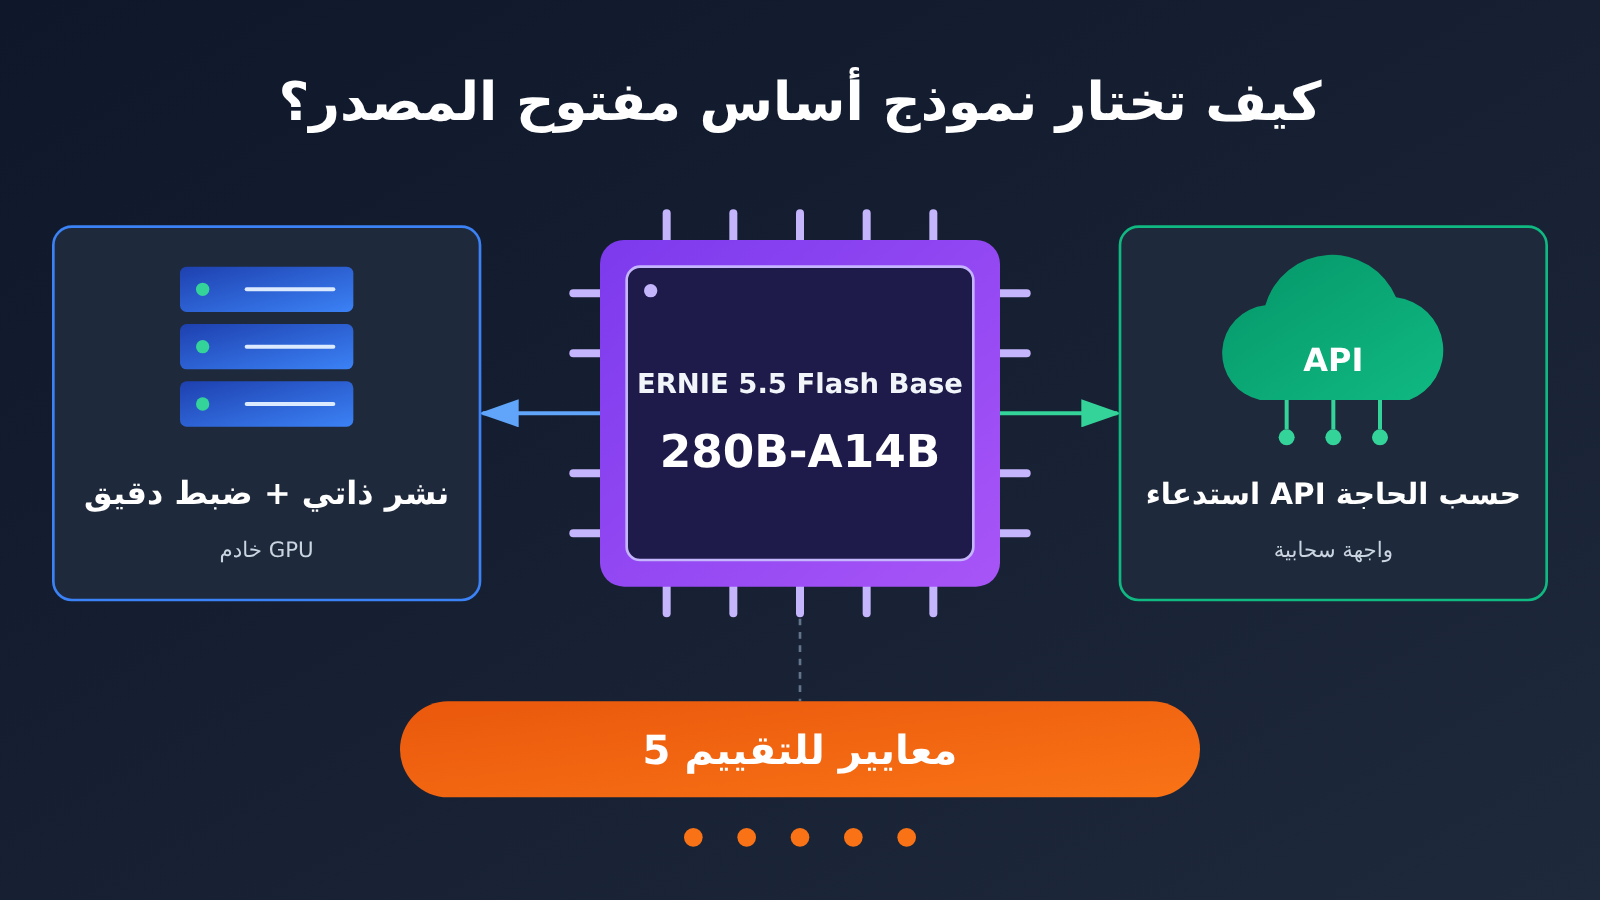
أبرز ما يميز Wenxin 5.5 Flash Base
لنبدأ بجدول يلخص أهم المعلومات عن النموذج، فهي تؤثر مباشرة في قرارك لاحقًا: هل تنشر النموذج بنفسك أم تستدعيه؟
| العنصر | التفاصيل | أثره على اختيار النموذج |
|---|---|---|
| نوع النموذج | نقطة حفظ (Checkpoint) عند نهاية التدريب المسبق، من دون تدريب متوسط أو لاحق | لا يصلح للمحادثة مباشرة، لكنه مناسب لمواصلة التدريب |
| حجم المعلمات | إجمالي 280B معلمة، يُفعّل منها 14B لكل token | التكلفة الحسابية للاستدلال منخفضة، لكن ذاكرة الأوزان تُحسب على أساس 280B |
| السياق | سياق التدريب 128K، مع دعم 1M tokens للضبط الدقيق والاستدلال | مناسب للتكييف مع مجالات مثل المستندات الطويلة والشفرة على مستوى المستودع |
| تنسيق الأوزان | يوفر Hugging Face تنسيقي FP8 وBF16 | يخفّض FP8 متطلبات النشر بدرجة كبيرة |
| دعم المنظومة | إضافة vLLM ودليل SGLang Cookbook | يمكن دمجه مباشرة مع أطر الاستدلال الشائعة |
ماذا تعني كلمة «Base» في Wenxin 5.5 Flash Base؟
لم يتعلم نموذج Base سوى «التنبؤ بالـ token التالي»، ولم يتعلم «فهم التعليمات وتقديم إجابة». إذا طرحت عليه سؤالًا، فقد يرجّح أن يواصل كتابة أسئلة أخرى بدلًا من الإجابة. وتوضح Baidu رسميًا أن المطورين يستطيعون استخدام هذه النقطة الموحدة للانطلاق ومواصلة تكييف النموذج مع مجالات محددة، وضبطه على اتباع التعليمات، وتعزيز قدرات الاستدلال، وتدريبه على مهام الوكلاء.
لذلك، معيار الاختيار الأول بسيط: إذا كان هدفك استخدام النموذج، فإن Base ليس ما تبحث عنه؛ أما إذا كان هدفك تدريب نموذج، فهو نقطة انطلاق جيدة. وكشفت Baidu أيضًا أن الإصدار النهائي من Wenxin 5.5 Flash سيصدر قريبًا، ويمكن للفرق التي تريد استخدامه مباشرة للمحادثة انتظار ذلك الإصدار.
منافسو Wenxin 5.5 Flash Base من الحجم نفسه
في التقييمات التي نشرتها Baidu، شملت النماذج المقارنة DeepSeek-V4-Flash-Base (284B-A13B) وHy3-preview-Base (295B-A21B) وMiMo-V2.5-Base (310B-A15B). وقد أظهر Wenxin 5.5 Flash Base أداءً لافتًا في الاستدلال والبرمجة والمعرفة بالمجالات المختلفة ومهام السياق الطويل. وبالنسبة إلى الفرق التي تخطط لضبط نموذج لمهام مثل وكلاء البرمجة وفهم المستندات الطويلة، يستحق هذا النموذج الأساسي أن يُدرج ضمن الخيارات المرشحة.
كيف يعمل Wenxin 5.5 Flash Base: ثلاثة تحسينات للكفاءة
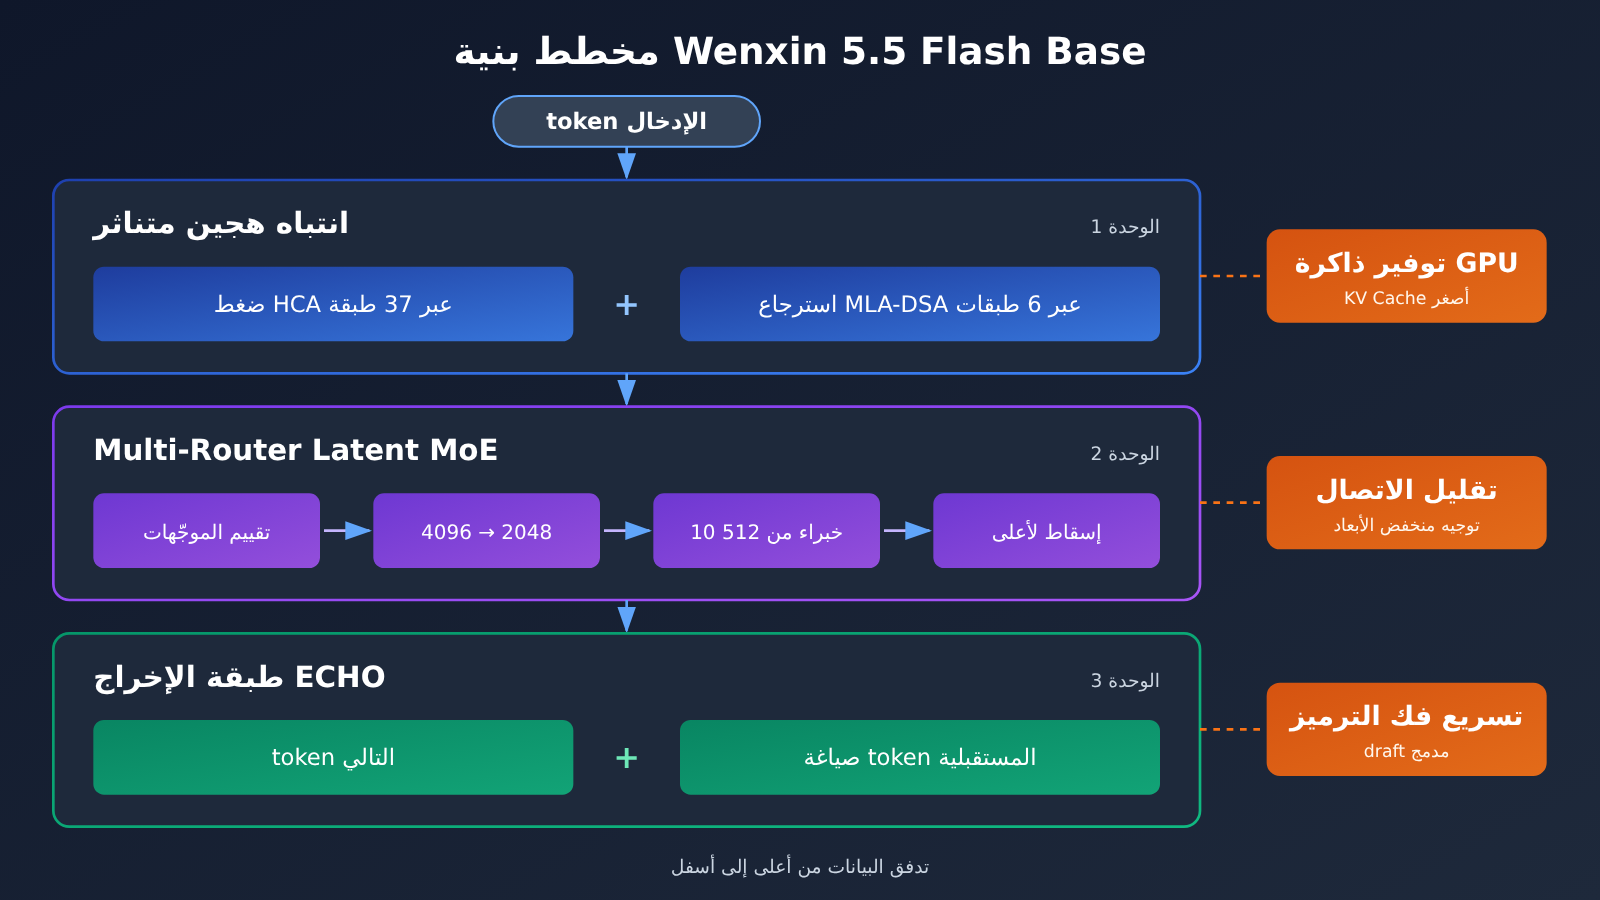
يساعد فهم بنية النموذج على تقدير تكلفة نشره. جعل فريق Wenxin الكفاءة عاملًا أساسيًا في تصميم التدريب المسبق، وركز التحسينات على ثلاث مراحل: الانتباه، وتوجيه الخبراء، والتنبؤ بالرموز المستقبلية.
| الوحدة | التصميم الأساسي | فوائدها عند النشر |
|---|---|---|
| الانتباه المتناثر الهجين | 37 طبقة HCA من أصل 43، تضغط كل 128 رمزًا في مدخل واحد للتخزين المؤقت، و6 طبقات MLA + DSA للاسترجاع المتناثر | تقليص كبير لذاكرة KV Cache، واستهلاك أقل لذاكرة GPU مع السياقات الطويلة |
| Multi-Router Latent MoE | عدة موجّهات Sigmoid تشارك في حساب الدرجات، واختيار 10 خبراء من أصل 512 خبيرًا موجّهًا، بالإضافة إلى خبير مشترك واحد، مع تنفيذ حسابات الخبراء في فضاء كامن من 2048 بُعدًا | خفض عمليات FLOPs الخاصة بالخبراء وحجم بيانات التوزيع بنحو النصف |
| ECHO | إعادة استخدام الطبقة الأخيرة من النموذج الأساسي للتنبؤ بالرموز المستقبلية | يمكن استخدامها مباشرة كنموذج draft مدمج لفك الترميز الاستباقي، دون زيادة عدد المعاملات |
| تصميمات داعمة | رأس إخراج MultiMax ومجزّئ رموز R2L بمفردات تقارب 200 ألف رمز | معالجة أكثر استقرارًا للأرقام والعمليات الحسابية |
لماذا يستهلك KV Cache مساحة أقل في Wenxin 5.5 Flash Base؟
في النماذج التقليدية، تحفظ كل طبقة ذاكرة KV Cache كاملة، ويزداد الضغط على ذاكرة GPU كلما طال السياق. أما Wenxin 5.5 Flash Base، فيجعل 37 طبقة تطّلع فقط على «ملخص» مضغوط، بينما تصل 6 طبقات وحدها إلى السجل رمزًا برمز. وتستخدم هذه الطبقات الست أداة Indexer خفيفة لاختيار أهم K مواضع لإجراء حسابات أكثر دقة.
هذا يعني أن استهلاك KV Cache مع سياق بطول 128K أو أكثر يقل كثيرًا مقارنةً بنموذج بالحجم نفسه يستخدم الانتباه الكامل، وهو توفير ملموس في ذاكرة GPU للفرق التي تنشر النموذج ذاتيًا.
أهمية ECHO في تسريع الاستدلال
أثناء التدريب المسبق، تتنبأ ECHO برمز إضافي واحد فقط. لكنها، عند استخدامها كنموذج draft، تستطيع صياغة عدة رموز متتالية، وبمعدل قبول أعلى من وحدة MTP خارجية دُرّبت بالطريقة نفسها. وعند النشر الذاتي، يمكن أن يرتفع معدل المعالجة بشكل ملحوظ إذا كان إطار الاستدلال يدعم مسار فك الترميز الاستباقي هذا. وهذه إحدى مزايا الأوزان مفتوحة المصدر مقارنةً باستخدام API: إذ يمكنك التحكم الكامل في تحسينات الاستدلال من هذا النوع.
البدء السريع مع 文心5.5 Flash Base: مسار النشر الذاتي
إذا كنت تنوي استخدام هذا النموذج الأساسي للتدريب أو الاستدلال الخاص، فإليك أقصر طريق للبدء. لن نورد شفرة برمجية؛ سنشرح المعلمات الأساسية بالكلمات.
الخطوة الأولى: تقدير متطلبات ذاكرة GPU
يُحسب حجم العمليات في نموذج MoE بناءً على المعلمات النشطة، لكن يجب تحميل جميع الأوزان، لذا تُحسب متطلبات الذاكرة على أساس إجمالي المعلمات البالغ 280B. الجدول التالي تقدير تقريبي يعتمد على «عدد البايتات لكل معلمة × عدد المعلمات»، ولا يشمل ذاكرة KV Cache أو قيم التنشيط أو النفقات الإضافية لإطار العمل. راجع الوثائق الرسمية واختبر بنفسك لتحديد المتطلبات الفعلية.
| إصدار الأوزان | تقدير ذاكرة الأوزان | توصية النشر (تقديرية) | الاستخدام المناسب |
|---|---|---|---|
| FP8 | نحو 280GB | جهاز واحد يضم 8 وحدات GPU بذاكرة من فئة 80GB، مع إمكانية ترك مساحة لـ KV Cache | تقييم الاستدلال والخدمات خفيفة الحمل |
| BF16 | نحو 560GB | جهاز واحد يضم 8 وحدات GPU بذاكرة كبيرة، أو توازي الموترات عبر أجهزة متعددة | التقييم الحساس للدقة ونقطة انطلاق للضبط الدقيق |
| الضبط الدقيق لجميع المعلمات | أعلى بكثير من الاستدلال، لأنه يتطلب أيضًا حالات المُحسِّن والتدرجات | عنقود متعدد الأجهزة يتطلب إطار عمل للتدريب الموزع | التكييف المتعمق مع مجال محدد |
| الضبط الدقيق بأسلوب LoRA | بين متطلبات الاستدلال ومتطلبات ضبط جميع المعلمات | يعتمد على الرتبة وطول التسلسل | تكييف النموذج مع مجال محدد للفرق الصغيرة والمتوسطة |
الخطوة الثانية: اختيار إطار الاستدلال وتحميل الأوزان
تتوفر إضافة vLLM ودليل SGLang Cookbook رسميًا، ويُنصح بالبدء بهما. الخطوات كالتالي:
- نزّل أوزان FP8 أو BF16 من Hugging Face، واحرص على توفير مساحة قرص تقارب حجم الذاكرة الرسومية التي تشغلها الأوزان.
- ثبّت vLLM وحمّل الإضافة الرسمية، أو اضبط معاملات التشغيل وفقًا لدليل SGLang Cookbook.
- اجعل حجم التوازي الموترّي مساويًا لعدد البطاقات الرسومية، باستخدام المعامل
tensor-parallel-sizeفي vLLM. - ابدأ بنافذة سياق يبلغ طولها نحو 32K للتأكد من عمل النموذج، ثم زدها تدريجيًا مع مراقبة استهلاك KV Cache.
- أجرِ اختبارًا أوليًا باستخدام موجه لاستكمال النص؛ مثل إعطاء النموذج بداية شفرة برمجية ليكملها، بدلًا من طرح سؤال مباشر.
الخطوة الثالثة: تحديد هدف التدريب
بعد نشر أوزان النموذج الأساسي، يبدأ العمل الفعلي. هناك ثلاثة مسارات شائعة: مواصلة التدريب المسبق باستخدام بيانات متخصصة، أو إجراء الضبط الدقيق الخاضع للإشراف (SFT) باستخدام بيانات التعليمات، أو تعزيز قدرات الاستدلال أو تدريب مسارات عمل الوكيل (Agent) بعد SFT. وقد استخدم نموذج Wenxin أثناء التدريب المسبق بيانات برمجية تشمل commit وissue وPR والتحقق من الإصلاحات عبر CI، إلى جانب مستندات طويلة تتضمن أسئلة وأجوبة متعددة الخطوات. لذلك، تبدو فرص الضبط الدقيق في مجالَي هندسة البرمجيات والمستندات الطويلة واعدة بشكل خاص.
🎯 نصيحة تقنية: قبل تخصيص موارد GPU للضبط الدقيق، يُنصح باختبار نموذج جاهز متبع للتعليمات على مجموعة تقييم الأعمال لتحديد «النتيجة المرجعية». توفر APIYI عبر apiyi.com واجهة موحدة لعدة نماذج رائدة، ما يتيح الحصول على نتيجة مرجعية للمقارنة بتكلفة منخفضة، ثم تحديد ما إذا كان تدريب نموذج أساسي خاص يستحق الاستثمار.
البدء السريع مع 文心5.5 Flash Base: استدعاء API حسب الحاجة
لنوضح أولًا أن APIYI لم تطرح بعد نماذج 文心 ERNIE، بما فيها 文心5.5 Flash Base، وستعمل على إتاحتها في أقرب وقت. كذلك، لا يناسب نموذج Base الاستخدام المباشر بوصفه واجهة API للمحادثة؛ فمعظم التطبيقات تحتاج إلى إصدار مهيأ للتعليمات أو للاستدلال.
إذا كنت تريد دمج هذه الإمكانات في منتجك فورًا، يمكنك بناء مسار العمل باستخدام النماذج المتاحة حاليًا، ثم تجربة إصدار 文心5.5 Flash الرسمي ومقارنته بها عند إطلاقه. تدعم APIYI تنسيقي واجهات OpenAI وAnthropic، لذا يكفي تغيير معامل model للتبديل بين النماذج دون إعادة كتابة منطق الاستدعاء.
أسعار النماذج البديلة المتاحة على APIYI
الأسعار التالية مستندة إلى بيانات صفحة أسعار APIYI على docs.apiyi.com/models، وهي بالدولار لكل مليون رمز. يرجى مراجعة أحدث الأسعار على الصفحة قبل الاستدعاء.
| النموذج | الإدخال | الإخراج | ذاكرة التخزين المؤقت | الاستخدام المناسب | المنصة المتاحة |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | المهام عالية التزامن والحساسة للتكلفة | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | السياقات الطويلة والمهام باللغة الصينية | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | خيار أساسي للبرمجة والوكلاء | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | الاستدلال المعقد والمهام الصعبة | APIYI apiyi.com |
| 文心5.5 Flash Base / الإصدار الرسمي | — | — | — | النموذج غير متاح حاليًا على APIYI | سيتاح في أقرب وقت |
توفر APIYI أيضًا نماذج صينية أخرى مثل سلسلة qwen3.8، إلى جانب نموذجي الصور gpt-image-2.6-flare وgpt-image-2.6-sunburst، بسعر $5 لإدخال النصوص و$8 لإدخال الصور و$30 للإخراج، مع الرجوع دائمًا إلى صفحة الأسعار. وتجدر الإشارة إلى أن deepseek-v4.1-flash في الجدول نموذج مهيأ للتعليمات ويمكن استدعاؤه مباشرة، وهو ليس نموذج DeepSeek-V4-Flash-Base المستخدم في المقارنة ضمن التقييم.
كيفية التكامل
عند استخدام تنسيق OpenAI، اضبط base_url في حزمة SDK على عنوان الواجهة الوارد في وثائق APIYI، وأدخل المفتاح الذي أنشأته من لوحة التحكم في api_key. ويمكن أيضًا للمشاريع التي تستخدم Anthropic SDK الاتصال مباشرة. للاطلاع على عنوان الواجهة الكامل وشرح المعاملات والأمثلة، راجع مركز وثائق APIYI على docs.apiyi.com.
🚀 البدء السريع: ننصحك بالبدء باستخدام deepseek-v4.1-flash أو claude-sonnet-5-5 على APIYI عبر apiyi.com لتشغيل نموذج أولي لتطبيقك. وعندما يتاح إصدار 文心5.5 Flash الرسمي على المنصة، يكفي تغيير اسم النموذج لإجراء مقارنة A/B.
مقارنة النشر الذاتي لـ 文心5.5 Flash Base باستدعاء API: جدول القرار
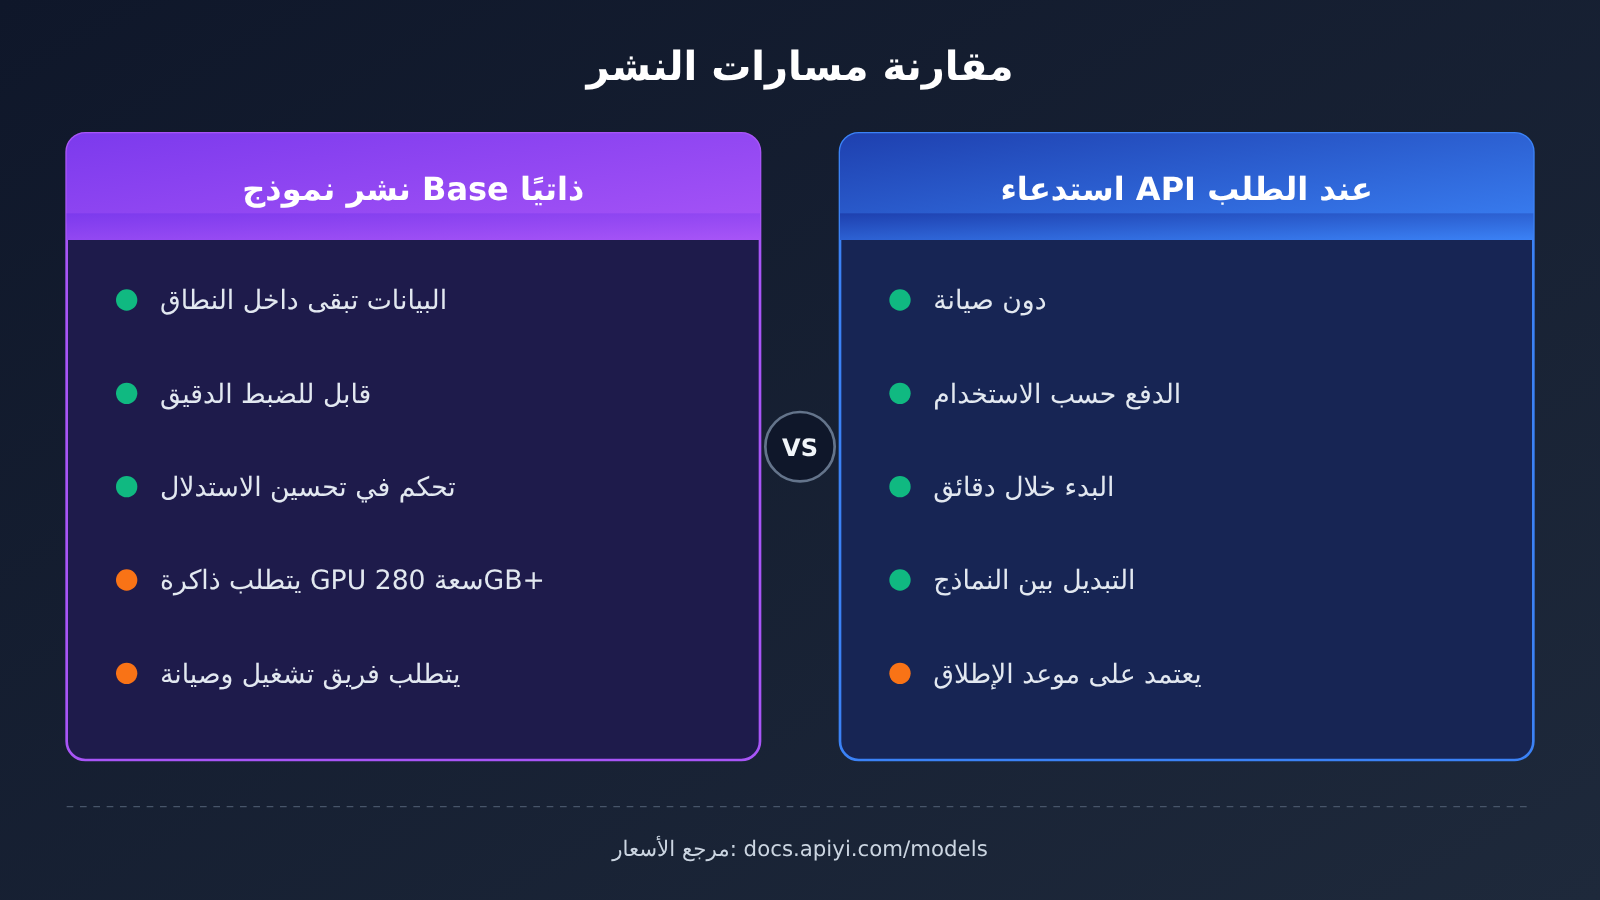
إليك توصيات واضحة عبر خمسة معايير تساعدك على تحديد الخيار المناسب لفريقك.
| معيار القرار | اختر النشر الذاتي لـ Base | اختر استدعاء API حسب الطلب |
|---|---|---|
| هدف الاستخدام | إجراء تدريب مسبق إضافي على بيانات متخصصة، أو SFT، أو RL، أو تجارب بحثية مقارنة | تطوير تطبيقات مباشرة مثل المساعدين للأسئلة والأجوبة والكتابة والبرمجة |
| الامتثال لمتطلبات البيانات | لا يمكن إخراج البيانات من الشبكة الداخلية، ويلزم نشر خاص | يمكن إرسال البيانات إلى السحابة، مع قبول شروط الامتثال لدى مزود الخدمة |
| حجم الاستدعاءات | حمل مرتفع ومستقر على المدى الطويل، مع إمكانية الحفاظ على معدل استخدام مرتفع لوحدات GPU | حركة متقلبة أو عدد محدود من الاستدعاءات اليومية |
| قدرات الفريق | يتوفر مهندسون لتشغيل وصيانة أنظمة التدريب والاستدلال | يركز الفريق على تطوير التطبيقات ولا يرغب في صيانة عنقود حوسبة |
| موعد الإطلاق | يمكن الانتظار لأسابيع أو أشهر لإتمام التدريب | يلزم الإطلاق هذا الأسبوع |
نوعان من المستخدمين المناسبين لـ 文心5.5 Flash Base
فرق يناسبها النشر الذاتي: مثل فرق القطاع المالي والطبي والجهات الحكومية والمؤسسات التي تحتاج إلى نشر خاص، وتمتلك كميات كبيرة من النصوص المتخصصة، وتهدف إلى تدريب نموذج خاص بها. تختار هذه الفرق 文心5.5 Flash Base للاستفادة من أساس تدريبه المسبق على الشفرة البرمجية والسياقات الطويلة، ومن التوفير في ذاكرة KV Cache الذي تتيحه بنية HCA.
فرق يناسبها استدعاء API: مثل فرق تطبيقات SaaS وأدوات المحتوى وأنظمة خدمة العملاء، التي تبحث أساسًا عن الاستقرار والسرعة والدفع حسب الاستخدام. بالنسبة إليها، سيعني استخدام نموذج Base مباشرةً المرور بخطوة تدريب إضافية. والأفضل أن تبدأ بإطلاق منتجها باستخدام نموذج تعليمات جاهز، وتوجه جهودها إلى تطوير المنتج.
يمكن الجمع بين المسارين
تعمل فرق كثيرة بنمط مختلط: تستخدم API لضمان استقرار الخدمة، وتجرب أوزان Base داخليًا في الوقت نفسه. وعندما يتفوق النموذج الذي دربته على خط الأساس الخاص بـ API في مجموعة التقييم، تبدأ بتحويل حركة الاستخدام إليه تدريجيًا. يقلل هذا النهج المخاطر ويوفر معيار مقارنة واضحًا لجهود التطوير الداخلي.
💡 نصيحة للاختيار: إذا لم تحسم قرارك بعد، ابدأ بحساب التكلفة الشهرية المقدرة وفقًا لحجم استدعاءاتك وأسعار صفحة APIYI، ثم قارنها بتكلفة استئجار وحدات GPU أو استهلاك قيمتها. جرّب الواجهة الموحدة لدى APIYI على apiyi.com على نطاق صغير لمدة أسبوع، ثم اتخذ قرارك بناءً على الاستهلاك الفعلي للرموز؛ سيكون ذلك أدق بكثير من التقدير الحدسي.
الأسئلة الشائعة FAQ
س1: ما هو وينشين 5.5 Flash Base؟
هو نموذج أساسي مفتوح المصدر أصدرته بايدو في 5 نوفمبر 2026. يعتمد على بنية MoE متفرقة، ويضم 280B من المعلمات، يُفعّل منها 14B لكل رمز، وقد دُرّب مسبقًا من الصفر على 33.5T رمز. الأوزان المنشورة رسميًا هي أوزان نهاية التدريب المسبق، وهي مخصصة أساسًا لمواصلة التدريب، لا للمحادثة المباشرة.
س2: ما الفرق بين وينشين 5.5 Flash Base وDeepSeek-V4-Flash-Base؟
النموذجان متقاربان في الحجم، إذ يبلغ حجم DeepSeek-V4-Flash-Base نحو 284B-A13B. وهو أيضًا نموذج أساسي قوي، لكن وفقًا للتقييمات التي نشرتها بايدو، يتفوق وينشين 5.5 Flash Base في الاستدلال والبرمجة والمواد الأكاديمية والسياق الطويل. ومن حيث البنية، يستخدم وينشين آلية انتباه هجينة تجمع بين HCA وMLA، إلى جانب MoE متعدد الموجّهات، مع تركيز أكبر على ضغط KV Cache وتحسين موثوقية التوجيه.
س3: متى سيصدر الإصدار النهائي من وينشين 5.5 Flash؟
قالت بايدو إن الإصدار النهائي سيصدر قريبًا، لكنها لم تحدد موعدًا دقيقًا حتى وقت كتابة هذا المقال، في 6 نوفمبر 2026. وسيخضع الإصدار النهائي لتدريب لاحق انطلاقًا من نموذج Base، ما يجعله أكثر ملاءمة للدمج المباشر في التطبيقات.
س4: ما السيناريوهات الأنسب لوينشين 5.5 Flash Base؟
يناسب النموذج بشكل أساسي السيناريوهات التالية:
– **تدريب نماذج برمجية على مستوى المستودع**: يتضمن التدريب المسبق بيانات هندسية مثل commit وPR وإصلاحات CI.
– **نماذج متخصصة في المستندات الطويلة**: مثل فهم السياق الطويل للملفات القانونية والتقارير البحثية، مع دعم مليون رمز في الضبط الدقيق والاستدلال.
– **البحث في أساليب التدريب**: استخدامه كنقطة انطلاق موحدة لمقارنة نتائج استراتيجيات SFT وRL المختلفة.
س5: هل يمكن استدعاء وينشين 5.5 Flash Base عبر API الآن؟
لم تُتح APIYI هذا النموذج بعد، كما أن سلسلة ERNIE غير متاحة حاليًا، وسنعمل على إتاحتها في أقرب وقت. في الوقت الحالي، يمكنك عبر APIYI على apiyi.com استدعاء النماذج المتاحة مثل deepseek-v4.1-flash وkimi-k3.1-pro وclaude-sonnet-5-5. وتتوافق المنصة مع تنسيقات واجهات OpenAI وAnthropic، ويمكن الرجوع إلى docs.apiyi.com/models للاطلاع على الأسعار.
س6: ما قيود النشر الذاتي لوينشين 5.5 Flash Base؟
أولًا، يتطلب النموذج قدرًا كبيرًا من ذاكرة GPU؛ فحتى عند استخدام أوزان FP8، تحتاج الأوزان وحدها إلى نحو 280GB. ثانيًا، نموذج Base غير جاهز للاستخدام مباشرةً، بل يتطلب تدريبًا. ثالثًا، لا يزال الاستدلال بسياق طويل يتطلب تخصيص مساحة لـ KV Cache. إذا كان فريقك يفتقر إلى الخبرة في التدريب والتشغيل، فمن الأفضل البدء باستخدام API.
س7: ماذا تستطيع الفرق الصغيرة والمتوسطة أن تفعل بوينشين 5.5 Flash Base؟
يمكن استئجار وحدات GPU سحابية لتقييم القدرات باستخدام استدلال FP8، أو استخدام أساليب مثل LoRA لتكييف النموذج مع مجال محدد بتكلفة منخفضة. أما حركة الإنتاج، فيُنصح بإبقائها عبر API، مع استخدام خط الأساس للأداء في مهام العمل الذي تحصل عليه عبر APIYI، على apiyi.com، معيارًا لمقارنة النموذج الذي درّبته بنفسك.
أبرز النقاط حول 文心5.5 Flash Base
- نقطة انطلاق للتدريب: لم يخضع إصدار Base للتدريب اللاحق، لذا يناسب الضبط الدقيق والبحث، لكنه لا يصلح للمحادثة مباشرةً.
- الحوسبة بحسب المعلمات النشطة، وذاكرة GPU بحسب الإجمالي: لا يُفعّل النموذج سوى 14B معلمة، لكن أوزان FP8 لا تزال تتطلب نحو 280GB من ذاكرة GPU.
- تخزين مؤقت أكثر كفاءة للسياقات الطويلة: يؤدي ضغط HCA عبر 37 طبقة، مع 6 طبقات MLA-DSA، إلى تقليص KV Cache بشكل ملحوظ.
- أساس قوي للبرمجة والنصوص الطويلة: مناسب لبناء نماذج متخصصة تتعامل مع الشفرة على مستوى مستودع كامل والمستندات الطويلة.
- الأدوات جاهزة: صدر مكوّن vLLM الإضافي ودليل SGLang Cookbook بالتزامن، ما يسهّل بدء استخدام النموذج للاستدلال.
- غير متاح عبر API حاليًا: لم تُتح APIYI سلسلة 文心 بعد، لكن يمكنك استخدام النماذج المتاحة لبناء خط أساس لأداء مهام العمل.
الخلاصة
أهم النقاط عند الاختيار بشأن Wenxin 5.5 Flash Base:
- حدّد الهدف أولًا: إذا أردت تدريب النموذج، فاختر نموذج Base المستضاف ذاتيًا. أما إذا أردت استخدامه، فاختر API أو انتظر الإصدار الرسمي.
- تحقق من متطلبات التشغيل: ذاكرة GPU اللازمة لأوزان النموذج قيد لا يمكن تجاوزه: نحو 280GB بصيغة FP8، ونحو 560GB بصيغة BF16.
- احسب التكلفة أخيرًا: قارن رسوم API الشهرية بتكلفة GPU بناءً على حجم الاستدعاءات الفعلي؛ والنموذج الهجين هو الأقل مخاطرة.
بالنسبة إلى معظم فرق التطبيقات، يتمثل المسار الأكثر عملية في تشغيل التطبيق عبر API أولًا، ثم استخدام نموذج Base مفتوح المصدر للتجارب الداخلية. ننصح باستخدام APIYI عبر apiyi.com لبناء خط أساس سريع بالاعتماد على النماذج المتاحة. تجد شرح الواجهة في docs.apiyi.com، والأسعار المعتمدة في docs.apiyi.com/models. وعند إتاحة نماذج Wenxin، يكفي تغيير اسم النموذج في الشفرة نفسها لإجراء المقارنة.
📚 المراجع
- QbitAI – تقرير عن إتاحة بايدو نموذج Wenxin 5.5 Flash Base مفتوح المصدر: نظرة عامة على إصدار النموذج وتقييمه
- الرابط:
qbitai.com/2026/11/507787.html -
التوضيح: يتضمن مقارنة مع نماذج أساسية مماثلة في الحجم وشرحًا للتقنيات الرئيسية
-
مركز توثيق APIYI: عنوان الواجهة وتعليمات الاستدعاء المتوافق مع OpenAI وAnthropic
- الرابط:
docs.apiyi.com -
التوضيح: يُنصح بقراءته قبل التكامل، ويتضمن المعلمات والأمثلة
-
صفحة أسعار نماذج APIYI: أسعار وحدات الإدخال والإخراج والتخزين المؤقت للنماذج المتاحة
- الرابط:
docs.apiyi.com/models - التوضيح: تُعتمد البيانات الفعلية في هذه الصفحة لجميع الأسعار الواردة في المقال
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يمكنكم التواصل معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com، والاطلاع على مزيد من موارد التكامل في مركز التوثيق docs.apiyi.com


