
ملاحظة الكاتب: أصدرت Tencent النسخة الرسمية من Hy4، التي تدعم فهم الصور والتحكم في الحاسوب لأول مرة. نقارن في هذا المقال بين ادعاءات الشركة، واختبارات الشركاء، والتقييمات المستقلة من جهات خارجية، لتوضيح حدود قدراته ومجالات استخدامه المناسبة.
أطلقت Tencent النسخة الرسمية من Hy4 بعد نحو شهرين من النسخة التجريبية. وهي تدعم فهم الصور والتحكم الذاتي في برامج الحاسوب لأول مرة، مع الحفاظ على أسعار النسخة التجريبية. وتقول Tencent إن النموذج انضم لأول مرة إلى صف أقوى النماذج مفتوحة الأوزان، لكن أوزانه لن تُتاح إلا في موعد لم يُعلن عنه بعد.
هذا ليس مجرد تقرير ينقل ما ورد في حفل الإطلاق. فنتائج اختبارات Tencent، وآراء الشركاء، والتقييم المستقل من Artificial Analysis لا تتطابق تمامًا، بل توجد بينها فروق كبيرة في بعض المواضع. نقارن في هذا المقال ما تقوله الأطراف الثلاثة نقطةً بنقطة، لنميز بين ادعاءات الشركة والنتائج المستقلة.
ما ستستفيده: ستعرف القدرات الجديدة التي أضافها Hy4 وأسعاره والمهام التي يتأخر فيها بوضوح، وكيف تستخدمه بحذر في البرمجة والمال والأعمال المكتبية.
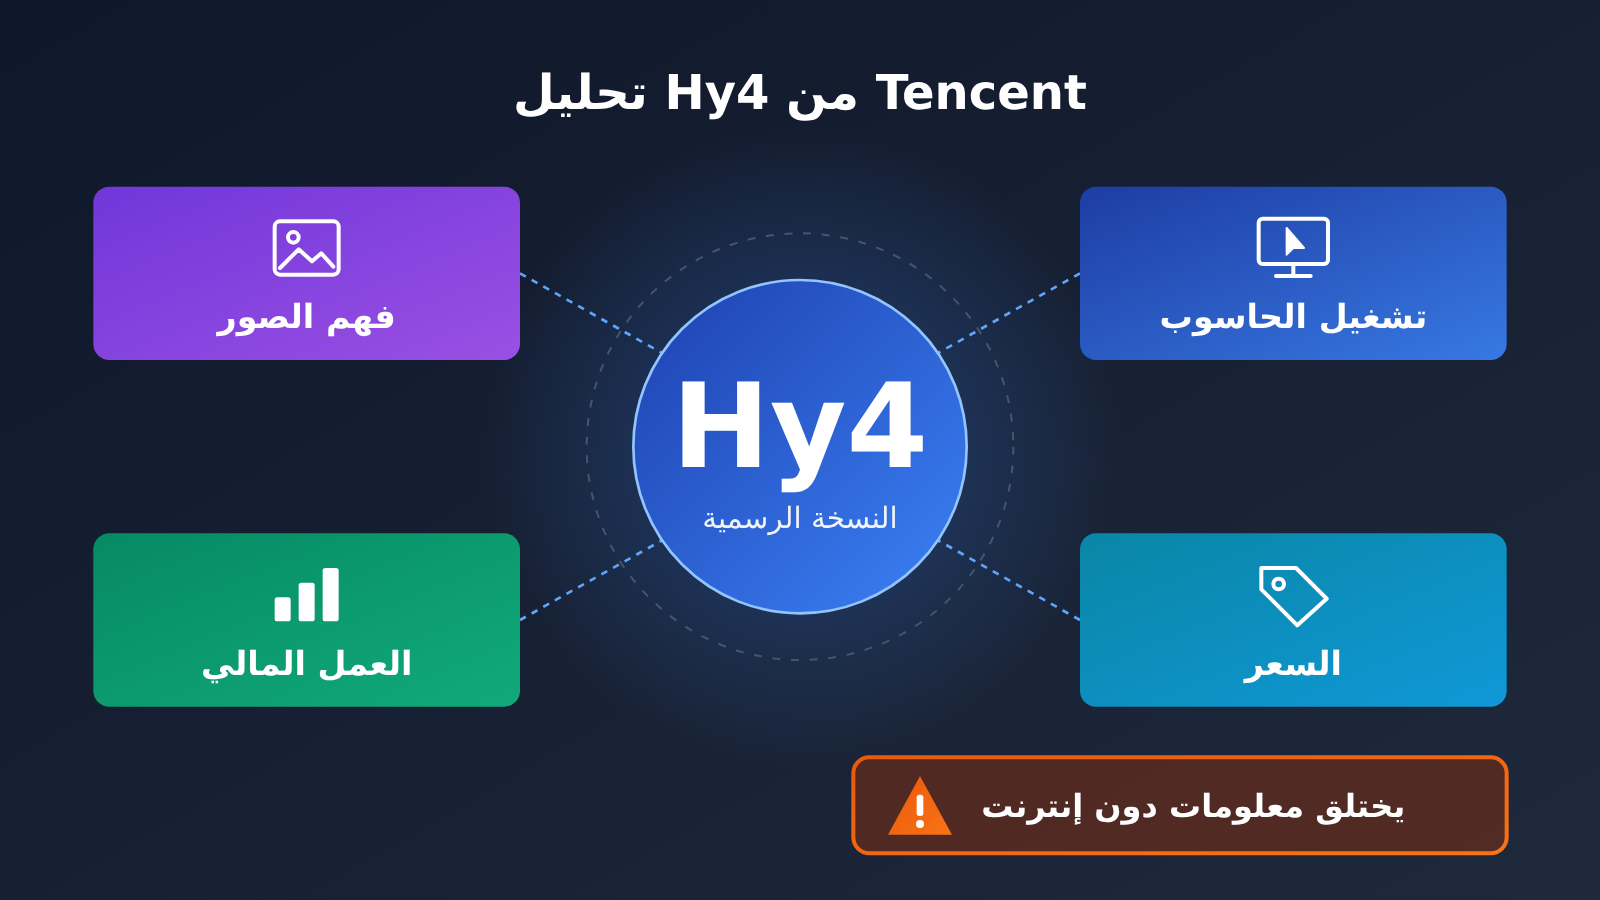
نظرة سريعة على أبرز المعلومات عن Tencent Hy4
لنبدأ بالحقائق المؤكدة في جدول واحد. تستند معظم أوصاف القدرات فيه إلى المعلومات الرسمية من Tencent، وسنوضح بيانات الجهات الخارجية بشكل منفصل لاحقًا.
| البند | التفاصيل |
|---|---|
| الجهة المطوّرة | Tencent |
| توقيت الإطلاق | أُطلق الإصدار النهائي بعد نحو شهرين من إصدار المعاينة |
| طرق الوصول الحالية | Tencent Cloud وOpenRouter، وتطبيقات Tencent مثل Yuanbao |
| أوزان النموذج | من المخطط إتاحتها، دون إعلان موعد محدد، وسيُنشر تقرير الأمان معها |
| أبرز القدرات الجديدة | دعم فهم الصور والتشغيل الذاتي لبرامج الكمبيوتر للمرة الأولى |
| مجالات التحسين الرئيسية | البرمجة والتمويل والعمل المكتبي |
| التسعير | نحو 0.83 دولار لكل مليون رمز إدخال، ونحو 2.50 دولار لكل مليون رمز إخراج، كما في إصدار المعاينة |
| الخطط المستقبلية | إطلاق إصدار Hy4 flash أسرع وأقل تكلفة، دون تحديد الموعد أو السعر |
خلفية إطلاق Tencent Hy4
احتوى Hy3، الجيل السابق من Tencent، على 295 مليار مُعلَمة وأُتيحت أوزانه بموجب ترخيص Apache 2.0. وخلال الأشهر التالية، أطلقت Zhipu نموذج GLM-5.3، وأطلقت DeepSeek نموذج V4.1-Flash-1017، وقدمت Moonshot AI نموذج Kimi K3.1 Pro، ما أشعل المنافسة بين النماذج الصينية. ويهدف Hy4 إلى إعادة Tencent إلى مصافّ الرواد في هذه الجولة من المنافسة.
ومن التفاصيل المهمة أيضًا تغيّر منهجية التقييم. فقد عدّلت Artificial Analysis مؤشرها الشامل في أواخر أكتوبر، وأصبح 60% منه يعتمد على مجموعات اختبار خاصة غير منشورة. ووفق المنهجية الجديدة، اتسعت الفجوة بين النماذج المفتوحة والنماذج الرائدة من 3 نقاط إلى 12 نقطة. لذلك، لا يُنصح بمقارنة نتيجة Hy4 مباشرةً بالقوائم القديمة التي سبقت التعديل.
قدرات Tencent Hy4 متعددة الوسائط والتحكم في الكمبيوتر
يمثل فهم الصور والتحكم في الكمبيوتر أبرز تغييرين في جيل Hy4. تتيح الأولى للنموذج رؤية الصور، فيما تتيح له الثانية تنفيذ الإجراءات. والجمع بينهما هو ما قد يمكّنه من التعامل مع مهام العمل والتطوير الفعلية.
فهم الصور في Hy4: قصّ الصور برمجيًا للعثور على التفاصيل
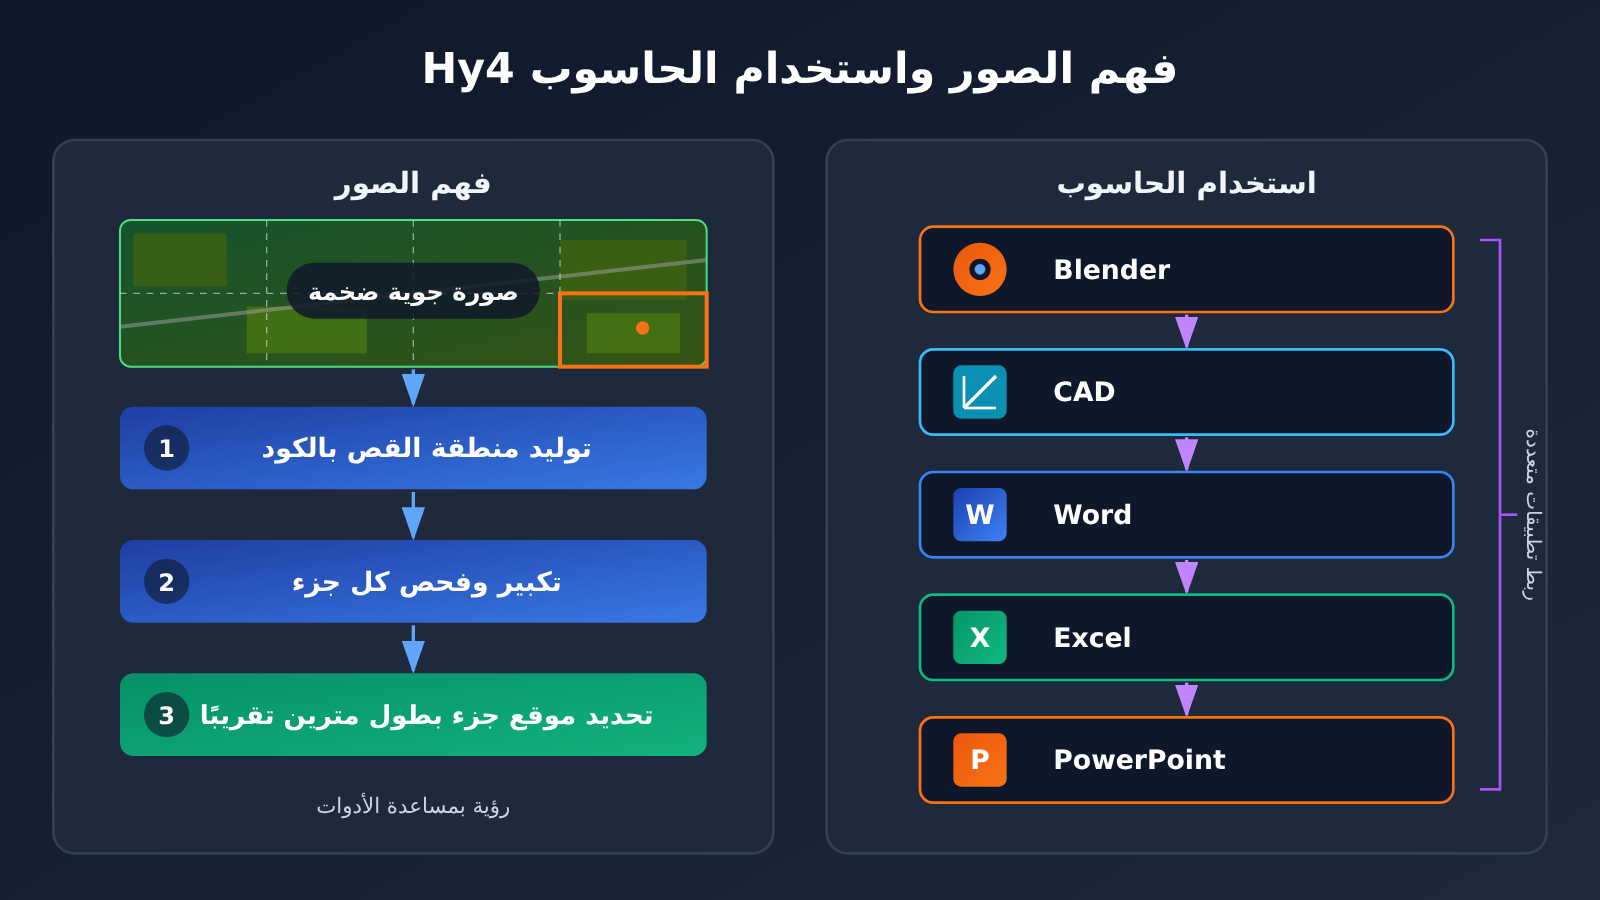
في عرض Tencent، طُلب من Hy4 العثور على جزء يبلغ حجمه نحو مترين على سطح مستودع، ضمن صورة جوية بدقة 2.8 مليار بكسل. استخدم النموذج الشفرة لإنشاء مناطق قصّ، ثم كبّرها وفحصها واحدة تلو الأخرى، بدلًا من محاولة «رؤية» الصورة كاملة دفعة واحدة. ويمكن الاستفادة من هذا الأسلوب، الذي يعتمد على الأدوات لفهم الصور، عند التعامل مع المخططات الضخمة وصور الاستشعار عن بُعد والرسوم البيانية المعقدة.
وتقول Tencent إن فهم الصور يساعد أيضًا في البرمجة، مثل بناء مواقع الويب والألعاب انطلاقًا من التصميمات. وفي تطوير الألعاب، تعاونت الشركة مع استوديوهات الألعاب التابعة لها لتكييف النموذج مع محركات شائعة مثل Unreal وUnity وGodot. وبحسب فريق تطوير لعبة «王者荣耀»، ينجز Hy4 مهام الإعدادات دون أخطاء تُذكر، كما ارتفع معدل نجاحه في تحديد الأسباب الجذرية للأخطاء البرمجية مقارنة بالسابق. لكن هذه إفادة من فريق داخلي في Tencent، ولم تُنشر منهجية اختبارها.
تشغيل الكمبيوتر في Hy4: للبرامج الاحترافية والمهام عبر تطبيقات متعددة
أصبح Hy4 قادرًا، للمرة الأولى، على تشغيل الكمبيوتر بصورة مستقلة والتحكم مباشرةً في البرامج لإنجاز المهام. ودرّبت Tencent النموذج خصيصًا على أدوات احترافية مثل Blender وCAD، وشمل التدريب أيضًا مهام تتطلب استخدام تطبيقات متعددة بالتتابع. وفي بيئة العمل المكتبي، يمكن لـ Hy4 التعاون مع المستخدمين في الوقت الفعلي لمعالجة ملفات Word وExcel وPowerPoint.
وهناك نقطة مرجعية مهمة للمقارنة. ففي اليوم نفسه، أصدرت مؤسسة التحليلات SemiAnalysis معيار GDPx، الذي يختبر قدرة وكلاء الذكاء الاصطناعي على تشغيل برامج احترافية مثل Siemens NX في بيئة تحاكي العمل الحقيقي، وتستمر المهمة الواحدة فيه لمدة تصل إلى 8 ساعات. لم يتجاوز أي نموذج نسبة 12%، وحصل Claude Opus 5.5، صاحب المركز الأول، على 12% فقط. لم يظهر Hy4 في قائمة الترتيب هذه، لكن النتيجة تذكّرنا بأن قدرة تشغيل الكمبيوتر لا تزال في مراحلها الأولى على مستوى القطاع، وأن الفجوة لا تزال كبيرة بين «القدرة على تشغيل البرامج» و«القدرة على إنجاز العمل الاحترافي بشكل مستقل».
Hy4 يشارك في تدريب «الأجيال اللاحقة» منه
عرضت تينسنت أيضًا توجهًا مميزًا: استخدام Hy4 لتحسين عملية تطوير الذكاء الاصطناعي نفسها. وتقول الشركة إن Hy4 تصدّر النماذج المفتوحة في اختبارات داخلية لمهام بحثية موزعة على سبعة مجالات. وبالاقتران مع نظام الوكلاء Hyra 2.0، رفع Hy4 معدل معالجة البنية التحتية الداخلية للتدريب لدى تينسنت بنحو 20% عبر ست خطوات.
بعد ذلك، درّب Hy4 بشكل مستقل إصدارًا من نموذج اتخاذ القرار Jev، الذي طورته الشركة الأمريكية الناشئة TypeSafe AI. وتفوّق هذا الإصدار، المسمى Hyra-Jev، على Jev الأصلي في 6 من أصل 8 اختبارات معيارية. وستطرح تينسنت أيضًا نموذجين متخصصين في الأحياء والفيزياء، أُنتجا بالطريقة نفسها، بوصفهما نموذجين مفتوحين. هذه النتائج كلها من اختبارات تينسنت نفسها، لكنها تكشف عن هدفها طويل المدى: جعل Hy4 وسيلة لتسريع البحث والتطوير الداخلي في الذكاء الاصطناعي.
مقارنة تقييمات Tencent Hy4 من ثلاثة أطراف: الشركة والشركاء والجهات المستقلة
هذا القسم هو محور المقال. فالجهات الثلاث تقدم صورًا مختلفة للنموذج نفسه، لذا من المهم معرفة مصدر كل تقييم قبل الاختيار.
| مصدر المعلومات | النتيجة الرئيسية | طبيعة التقييم | ملاحظات حول الموثوقية |
|---|---|---|---|
| تينسنت رسميًا | قيّم أكثر من 200 متخصص في القطاع المالي نحو 600 مهمة حقيقية، وجاء Hy4 متقدمًا على DeepSeek V4.1 Flash وKimi K3.1 Pro وGLM-5.3 Flash | اختبار داخلي للشركة | لم تُنشر تفاصيل منهجية الاختبار |
| تينسنت رسميًا | بعد تعديل وظيفة البحث، انخفض معدل الهلوسة عند البحث عبر الإنترنت من نحو 16% إلى نحو 5% | اختبار داخلي للشركة | يقتصر على سيناريو البحث عبر الإنترنت |
| تينسنت رسميًا | تصدّر Claude Opus 5.5 جميع اختبارات تينسنت المعيارية الـ12 متقدمًا على Hy4، فيما تفوق GPT 6.1 Sol في 8 اختبارات | اختبار داخلي للشركة | تينسنت نفسها تقرّ بالفجوة، ما يمنح النتيجة قيمة مرجعية أكبر |
| الشريك Comein | كان Hy4 النموذج الصيني الوحيد الذي تقاسم المركز الثاني مع Claude Opus 5.5، وتقدم بوضوح على GPT-6.1 Sol في الاستعلام عن البيانات | اختبار داخلي للشريك | يقتصر على سيناريو الاستعلام عن البيانات المالية الخاص به |
| الشريك Manus | نجح Hy4 في إنجاز جميع المهام المتعلقة بالمستندات تقريبًا | اختبار داخلي للشريك | لم يُكشف عن مستوى صعوبة المهام أو نطاقها |
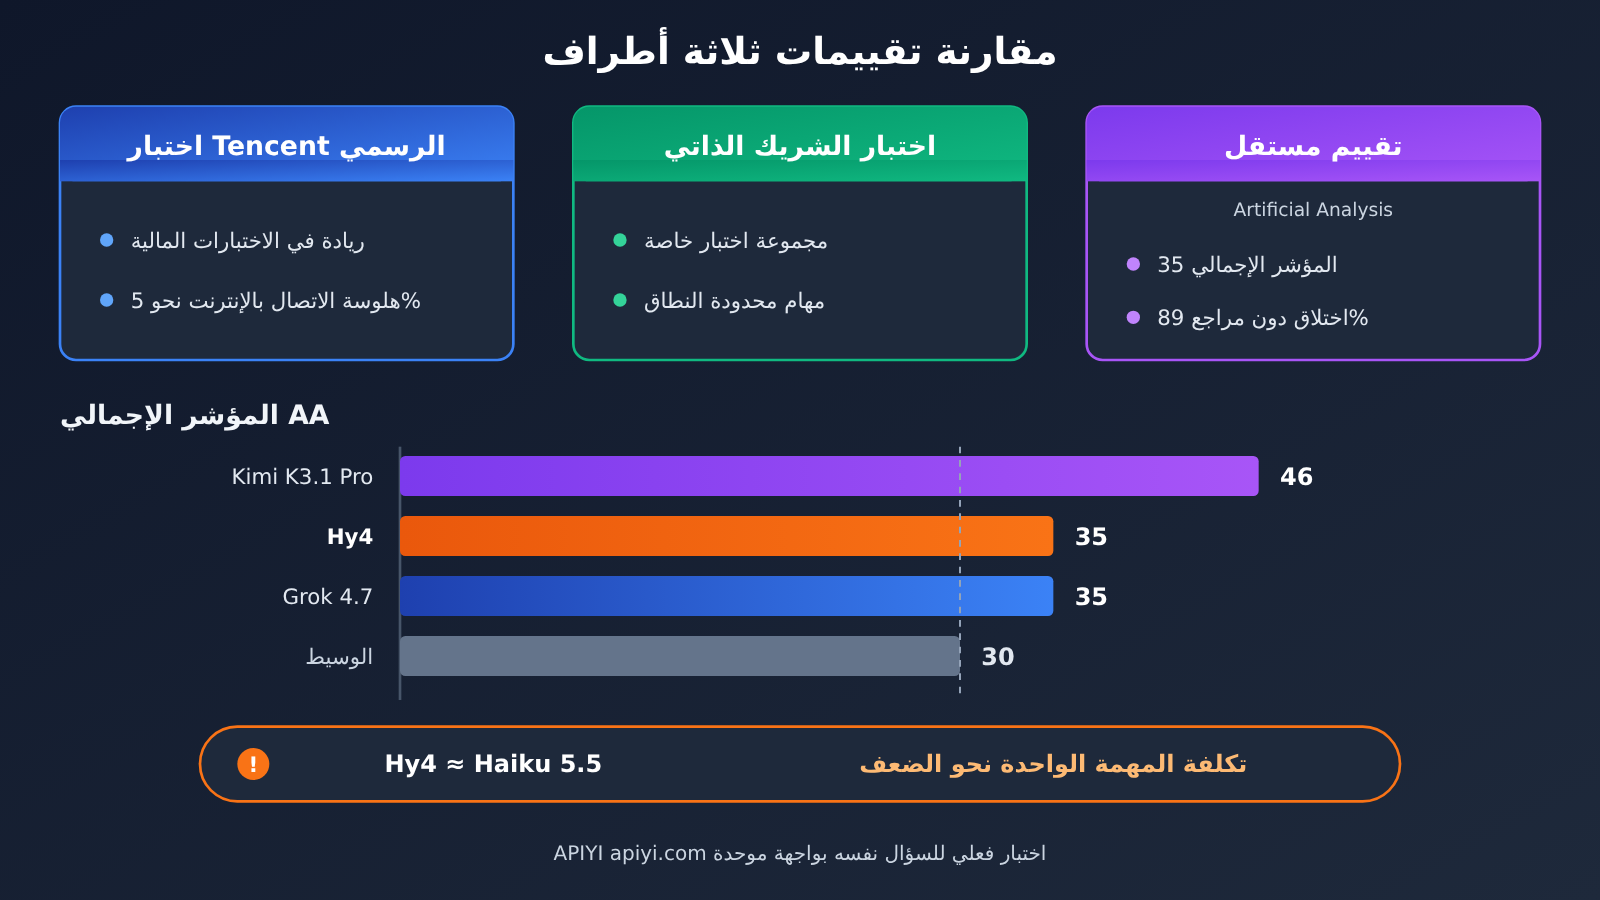
| Artificial Analysis | حصل على 35 نقطة في المؤشر الإجمالي، متجاوزًا الوسيط البالغ 30 نقطة ومساويًا لـGrok 4.7. وجاء ثانيًا بين النماذج الصينية، خلف Kimi K3.1 Pro الذي حصل على 46 نقطة | تقييم مستقل من طرف ثالث | 60% من مجموعة الاختبار خاصة، ما يجعل تحسين النموذج لاستهدافها أصعب |
| Artificial Analysis | أجاب إجابة صحيحة عن نحو نصف الأسئلة الواقعية دون اتصال بالإنترنت، واختلق إجابة في 89% من الحالات التي لم يكن يعرف فيها الإجابة | تقييم مستقل من طرف ثالث | اختبار دقة المعرفة دون الاستعانة بمصادر خارجية |
أبرز الاختلافات بين اختبارات Tencent الذاتية والتقييمات المستقلة لـ Hy4
يظهر الاختلاف الأوضح في المقارنة بين Hy4 وKimi K3.1 Pro. ففي اختبارات Tencent للقطاع المالي، جاء Hy4 قبل Kimi، لكنه تأخر عنه بـ 11 نقطة في المؤشر الشامل لدى Artificial Analysis. ولا يعني ذلك بالضرورة وجود تناقض: فالاختبار المالي يغطي نطاقًا ضيقًا، بينما يشمل المؤشر الشامل جوانب متعددة، مثل الأعمال المعرفية والبرمجة والعلوم والمعرفة العامة. ويمكن فهم النتيجة بأن Hy4 يتمتع بميزة في المجال المالي الذي ركزت Tencent على تحسين أدائه فيه، لكنه لا يتصدر من حيث القدرات الإجمالية.
هناك أيضًا نقطة تستحق الانتباه عند تقييم القيمة مقابل التكلفة. تشير بيانات Artificial Analysis إلى أن النتيجة الإجمالية لـ Hy4 تقارب نتيجة Haiku 5.5، أصغر نماذج Anthropic، لكن تكلفة المهمة الواحدة لدى Haiku 5.5 في هذا الاختبار تكاد تساوي نصف تكلفة Hy4. بمعنى آخر، لا يكفي النظر إلى سعر التوكن وحده للاستنتاج بأن «Hy4 أقل تكلفة»، بل يجب حساب عدد التوكنات المستهلكة فعليًا لإكمال المهمة.
نقاط ضعف Tencent Hy4 في المهام الصعبة
تقر Tencent نفسها بأن Hy4 لا يزال متأخرًا بوضوح عن أفضل النماذج التجارية في الرياضيات المتقدمة، ومشاريع البرمجة الطويلة، وتحليل الصور المعقدة. وتظهر الفجوة الأكبر في معيار Hy-FrontierMath T5، كما توضح البيانات التالية.
| المعيار / البُعد | Hy4 | GPT 6.1 Sol | Claude Opus 5.5 | المصدر |
|---|---|---|---|---|
| Hy-FrontierMath T5 | 13.0 | 97.5 | 91.3 | Tencent رسميًا |
| معايير Tencent الـ 12 الخاصة | يتأخر عن Opus 5.5 في جميعها | يتفوق على Hy4 في 8 منها | يتفوق في جميعها | Tencent رسميًا |
| مؤشر AA المركب | 35 | غير متوفر في المصادر | غير متوفر في المصادر | Artificial Analysis |
| دقة الحقائق دون اتصال بالإنترنت | يجيب عن نحو نصف الأسئلة إجابة صحيحة، ويختلق إجابة في 89% من الحالات التي لا يعرف فيها الإجابة | غير متوفر في المصادر | غير متوفر في المصادر | Artificial Analysis |
النتيجة 13.0 مقابل أكثر من 90 ليست مجرد فرق بسيط في الأداء، بل تضع النماذج في مستويين مختلفين تمامًا. إذا كان عملك يتطلب استدلالًا رياضيًا بمستوى المسابقات، أو كتابة شيفرة لمشاريع هندسية طويلة الأمد، أو تحليل صور عالي الدقة، فإن Hy4 لا يصلح حاليًا ليكون نموذجك الأساسي.
تحليل أثر Tencent Hy4: ماذا يعني للمطورين وفرق المنتجات؟
الأثر على المطورين: الاتصال بالإنترنت يصنع فرقًا بين نموذجين
عند النظر إلى رقمي «معدل هلوسة يقارب 5% مع الاتصال بالإنترنت» و«اختلاق الإجابات بنسبة 89% دون اتصال» معًا، تتضح النتيجة: تعتمد موثوقية Hy4 في الحقائق بدرجة كبيرة على الاسترجاع الخارجي. فنسبة 5% التي أعلنتها Tencent جاءت من اختبار داخلي في سيناريو البحث عبر الإنترنت، بينما قاست Artificial Analysis نسبة الاختلاق البالغة 89% في اختبار مغلق دون الرجوع إلى مصادر. لذلك، عند دمج Hy4 في منتج، يمكن تصميمه على أساس أنه «نموذج يحتاج إلى الاسترجاع».
يمكن الاستفادة من الممارسات التالية عند التطبيق:
- استخدم الاسترجاع لكل الأسئلة المتعلقة بالحقائق: استرجع المواد أولًا باستخدام البحث أو RAG، ثم اطلب من النموذج الإجابة بناءً عليها، بدلًا من الاعتماد على ذاكرته.
- اذكر صراحةً في الموجه أنه يمكنه قول «لا أعرف»: اطلب منه الإجابة بعبارة «لم ترد في المصادر» عندما لا يجد المعلومة، لتقليل احتمال اختلاقها.
- اطلب ذكر المصادر: اجعل النموذج يوضح الفقرة التي استند إليها في كل استنتاج، لتسهيل التحقق اليدوي.
- تحقق من الأرقام المهمة مرة أخرى: راجع الأرقام في المخرجات المالية والتقارير باستخدام برنامج أو قواعد تحقق. وكما أشار تقييم GDPx، قد يفقد الناتج بأكمله قيمته بسبب رقم واحد خاطئ في جدول.
فيما يلي مثال مبسط لاستدعاء يجمع بين «التوليد المعزز بالاسترجاع» والسماح بالامتناع عن الإجابة. استبدل اسم النموذج بالنموذج المتاح لك، وتحقق من معرّف نموذج Hy4 المحدد في لوحة تحكم المنصة التي تستخدمها.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "(这里放检索召回的资料片段)"
resp = client.chat.completions.create(
    model="your-model-name",
    messages=[
        {"role": "system", "content": "只依据给定资料回答;资料没有的内容回答“资料未提及”,并标注出处段落。"},
        {"role": "user", "content": f"资料:{context}\n\n问题:该公司三季度营收是多少?"}
    ],
    temperature=0
)
print(resp.choices[0].message.content)
عرض التنفيذ الكامل: مقارنة عدة نماذج على السؤال نفسه وإحصاء معدل الامتناع عن الإجابة
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "只依据给定资料回答问题。"
    "如果资料中没有答案,必须只回答:资料未提及。"
    "回答时注明依据的资料段落编号。"
)

def ask(model: str, context: str, question: str) -> str:
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": f"资料:\n{context}\n\n问题:{question}"}
            ],
            temperature=0,
            max_tokens=500
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

def evaluate(models: List[str], cases: List[Dict]) -> None:
    """الأسئلة التي تكون فيها answerable=False في cases لا تتضمن موادها الإجابة عمدًا، لاختبار الميل إلى الاختلاق"""
    for m in models:
        refused, fabricated = 0, 0
        for c in cases:
            out = ask(m, c["context"], c["question"])
            if not c["answerable"]:
                if "资料未提及" in out:
                    refused += 1
                else:
                    fabricated += 1
        print(f"{m}: 正确拒答 {refused},疑似编造 {fabricated}")

cases = [
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "三季度营收是多少?", "answerable": False},
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "二季度营收是多少?", "answerable": True},
]

# استبدل القائمة بمعرّفات النماذج التي تريد مقارنتها
evaluate(["model-a", "model-b"], cases)
🎯 نصيحة لاختيار النموذج: عند تقييم نماذج جديدة مثل Hy4، فإن الطريقة الأكثر موثوقية هي مقارنة إجاباتها عن الأسئلة نفسها باستخدام عينات من أعمالك، بدلًا من الاكتفاء بلوحات التصنيف. توفر APIYI عبر apiyi.com واجهة موحدة متوافقة مع OpenAI، ويكفي مفتاح API واحد لاستدعاء Claude وGPT وGemini ونماذج صينية متعددة، مما يسهل اختبار النماذج المرشحة على مجموعة الاختبار نفسها. للتحقق من توفر Hy4 على المنصة، راجع قائمة النماذج في لوحة التحكم.
ما يعنيه ذلك لمسؤولي المنتجات: المهام المناسبة وغير المناسبة لـ Hy4
بناءً على المعلومات الواردة من الأطراف الثلاثة، يمكن تلخيص مدى ملاءمة Hy4 للمهام المختلفة على النحو التالي:
| نوع المهمة | مدى الملاءمة | الأساس | توصيات الاستخدام |
|---|---|---|---|
| الاستعلام عن البيانات المالية وتنظيم تقارير الأبحاث | مناسب نسبيًا | اختبارات Tencent المالية وملاحظات Comein، وكلاهما من اختبارات ذاتية | لا بد من استخدام البحث والتحقق من الأرقام المهمة برمجيًا |
| معالجة مستندات Word وExcel وPPT | مناسب نسبيًا | إمكانات التعاون الفوري لدى Tencent، وملاحظات Manus عن ارتفاع معدل إنجاز مهام المستندات | ابدأ بتجربة مهام المستندات منخفضة المخاطر |
| إعداد محركات الألعاب وتحديد مواضع الأخطاء | يستحق التجربة | ملاحظات فرق الألعاب الداخلية لدى Tencent | مناسب للإعداد واستكشاف الأخطاء، لكنه غير مناسب للمشاريع الطويلة |
| بناء نماذج أولية لصفحات الويب والألعاب الصغيرة | يستحق التجربة | فهم الصور لدعم البرمجة | استخدمه للنماذج الأولية، مع مراجعة بشرية للشفرة المخصصة للإنتاج |
| الإجابة عن الأسئلة باستخدام البحث عبر الإنترنت | يستحق التجربة | بلغ معدل الهلوسة مع الاتصال بالإنترنت نحو 5% في الاختبارات الداخلية | فعّل البحث واطلب ذكر المصادر |
| الإجابة عن الأسئلة المعرفية دون اتصال بالإنترنت | غير موصى به | يختلق إجابة في 89% من الحالات التي لا يعرف فيها الإجابة | تجنب الاعتماد على ذاكرة النموذج للإجابة عن أسئلة الحقائق |
| الرياضيات المتقدمة والاستدلال في المسابقات | غير موصى به | حصل على 13.0 نقطة فقط في Hy-FrontierMath T5 | اختر نموذجًا تجاريًا من الفئة المتقدمة |
| مشاريع البرمجة طويلة الأمد وتحليل الصور المعقد | غير موصى به | أقرت Tencent رسميًا بتأخره الواضح في هذه المجالات | اختر نموذجًا أقوى أو قسّم المهام |
التأثير في القطاع: إتاحة الأوزان وتشديد التنظيم بالتوازي
توجد خطط لإتاحة أوزان Hy4، ما يعني أن الشركات قد تحصل مستقبلًا على خيار نشره في بيئاتها الخاصة. لكن موعد إتاحة الأوزان وشروط الترخيص لم يُعلنا بعد، لذا من السابق لأوانه إدراجه في خطط تتطلب موعد تسليم محددًا.
تطرأ تغييرات على مستوى السياسات أيضًا. فقد نشرت وزارة التجارة ووزارة العلوم والتكنولوجيا الصينيتان في أكتوبر مسودة إطار لضوابط التصدير، تشمل أوزان النماذج المصنفة ضمن المراكز العشرة الأولى عالميًا أو التي يتجاوز عدد معاملاتها تريليونَي معامل، مع مسار سريع للموافقة التلقائية على الإصدارات مفتوحة المصدر. وفي جانب السلامة، تقول Tencent إنها استبعدت عمدًا المواد المتعلقة بالقرصنة أثناء التدريب، وإن مختبر الأمن التابع لها لم يجد ارتفاعًا في مخاطر إساءة الاستخدام، كما أن المخاطر البيولوجية أقل بكثير من الحد الذي حددته. وسيُنشر تقرير مفصل عن السلامة بالتزامن مع إتاحة الأوزان.
الأسئلة الشائعة حول Tencent Hy4
س1: ما هو Tencent Hy4؟
Hy4 هو نموذج لغة كبير أطلقته Tencent كإصدار رسمي بعد الإصدار التجريبي. يدعم لأول مرة فهم الصور والتحكم الذاتي في برامج الكمبيوتر، مع تحسينه خصيصًا لمهام البرمجة والتمويل والعمل المكتبي. يمكن استخدامه حاليًا عبر Tencent Cloud وOpenRouter وتطبيقات مثل Yuanbao، على أن تتاح أوزانه لاحقًا.
س2: كيف يقارن Hy4 مع Kimi K3.1 Pro وClaude Opus 5.5؟
في الاختبارات المالية التي أجرتها Tencent، جاء Hy4 قبل Kimi K3.1 Pro، لكنه حصل على 35 نقطة في تقييم مستقل من Artificial Analysis، مقابل 46 نقطة لـ Kimi. وبالمقارنة مع Claude Opus 5.5، تأخر Hy4 في جميع معايير Tencent الاثني عشر. وإذا أردت المقارنة مباشرة في حالات استخدامك، يمكنك استدعاء عدة نماذج عبر واجهة موحدة من APIYI apiyi.com واختبارها بالأسئلة نفسها.
س3: متى ستُطرح أوزان Hy4 ونموذج Hy4 flash؟
حتى 6 نوفمبر 2026، لم تعلن Tencent موعدًا محددًا لإتاحة الأوزان أو الترخيص الذي ستصدر به، واكتفت بالقول إن تقرير السلامة سيُنشر بالتزامن معها. أما Hy4 flash، الأسرع والأقل تكلفة، فقد تأكد فقط أنه قيد التخطيط، دون الإعلان عن موعد إصداره أو سعره. لذا يجدر متابعة المعلومات الرسمية لاحقًا.
س4: هل سعر Hy4 مرتفع؟
تبلغ تكلفة Hy4 نحو 0.83 دولار لكل مليون رمز إدخال، ونحو 2.50 دولار لكل مليون رمز إخراج، وهي أسعار مماثلة للإصدار التجريبي. لكن بيانات Artificial Analysis تشير إلى أن تكلفة المهمة الواحدة باستخدام Haiku 5.5، الذي حصل على درجة قريبة منه، تبلغ نحو نصف تكلفة Hy4. لذلك من المهم حساب التكلفة الإجمالية بناءً على استهلاك مهامك الفعلية.
س5: كيف يمكن تقليل خطر اختلاق Hy4 للحقائق؟
الفكرة الأساسية هي ألا تطلب منه الإجابة عن الأسئلة المتعلقة بالحقائق اعتمادًا على ذاكرته وحدها: فعّل البحث على الويب أو اربطه بنظام RAG، واسمح له في الموجه بالإجابة بأن «المعلومات لم تذكر ذلك»، واطلب منه ذكر المصادر. يمكن لبرنامج المقارنة المذكور أعلاه مساعدتك في إحصاء حالات امتناع النماذج المختلفة عن الإجابة وحالات اختلاقها للمعلومات. وبالاستفادة من رصيد الاختبار المجاني للمستخدمين الجدد لدى APIYI apiyi.com، يمكنك إجراء جولة تحقق أولية بتكلفة منخفضة.
س6: ما القيود المعروفة في Hy4؟
هناك ثلاثة قيود رئيسية: أولًا، يتراجع أداؤه بفارق كبير في المهام عالية الصعوبة، إذ حصل على 13.0 نقطة فقط في Hy-FrontierMath T5. ثانيًا، تقل موثوقية معلوماته عند عدم اتصاله بالإنترنت، إذ يختلق إجابة في 89% من الحالات التي لا يعرف فيها الجواب. ثالثًا، تأتي عدة نتائج إيجابية من اختبارات أجرتها Tencent أو شركاؤها، ولم تُنشر تفاصيل منهجيتها، لذا يُنصح بالتحقق منها باستخدام بياناتك الخاصة.
أبرز النقاط عن Tencent Hy4
- قدرتان لأول مرة: يدعم Hy4 فهم الصور والتحكم الذاتي بالحاسوب، بما يشمل Blender وCAD ومستندات Office.
- الأسعار لم ترتفع: نحو 0.83 دولار لكل مليون رمز إدخال و2.50 دولار لكل مليون رمز إخراج، وهي أسعار مماثلة للنسخة التجريبية.
- نتائج متوسطة إلى جيدة في التقييم المستقل: حصل على 35 نقطة في المؤشر العام لـ AA، ليأتي ثانيًا بين النماذج الصينية، لكنه يتأخر بوضوح عن Kimi K3.1 Pro.
- البحث ضروري: يبلغ معدل الهلوسة نحو 5% عند الاتصال بالإنترنت، لكنه يختلق الإجابة في 89% من الحالات التي لا يعرف فيها الإجابة عند عدم الاتصال.
- يتأخر في المهام الصعبة: تظهر فجوة واضحة بينه وبين أفضل النماذج التجارية في الرياضيات المتقدمة، ومشاريع البرمجة الطويلة، وتحليل الصور المعقدة.
- راجع نتائج الاختبارات الذاتية: تعتمد التصنيفات المالية واستنتاجات الشركاء غالبًا على اختبارات ذاتية، لذا يُنصح بالتحقق باستخدام عيناتك الخاصة قبل الإطلاق.
- المقارنة أكثر أمانًا: يمكنك الاستعانة بالواجهة الموحدة من APIYI على apiyi.com لمقارنة Hy4 بالنماذج البديلة أو المرجعية على مجموعة الاختبار نفسها.
الخلاصة
أبرز النقاط حول Hy4 من Tencent:
- تقدم واضح في القدرات: يُعد فهم الصور واستخدام الحاسوب أبرز الإضافات في هذا الإصدار، مع تركيز خاص على تحسين الأداء في المجالات المالية والمكتبية.
- ميّز بين المصادر الثلاثة: تميل الاختبارات الذاتية للشركة وشركائها إلى التفاؤل، بينما يضعه التقييم المستقل من Artificial Analysis في المرتبة الثانية بين النماذج الصينية، بمستوى قريب من Haiku 5.5.
- نقاط الضعف محددة: قد يختلق معلومات دون الاتصال بالإنترنت، ويتأخر بوضوح في مسائل الرياضيات الصعبة ومشاريع البرمجة الطويلة. وكل ذلك يؤثر مباشرة في اختيار النموذج.
إذا كنت تعمل على مهام مثل الاستعلام عن البيانات المالية أو معالجة المستندات أو إعدادات الألعاب، فمن المجدي تجربة Hy4 مع الاستعانة بالبحث. أما إذا كانت مهامك تعتمد على المعرفة دون الرجوع إلى مصادر خارجية أو على الاستدلال المعقد، فمن الأنسب حاليًا اختيار نموذج أقوى. يُنصح أولًا باختبار النماذج المرشحة على المهام نفسها عبر واجهة موحدة من خلال APIYI على apiyi.com، ثم اتخاذ القرار بناءً على التكلفة والدقة.
📚 المراجع
- THE DECODER – Tencent releases Hy4 with vision and computer use: تقرير عن إطلاق Hy4
- الرابط:
the-decoder.com/tencent-releases-hy4-with-vision-and-computer-use-claims-second-place-among-chinese-ai-models -
التوضيح: يتضمن بيانات Tencent الرسمية، وآراء الشركاء، ونتائج التقييم المستقل من Artificial Analysis
-
THE DECODER – تقرير عن معيار SemiAnalysis GDPx: تقييم لوكلاء الذكاء الاصطناعي في مهام العمل الواقعية
- الرابط:
the-decoder.com/no-ai-agent-scores-above-12-percent-on-semianalysis-new-real-world-work-benchmark -
التوضيح: للاطلاع على المستوى العام للوكلاء القادرين على استخدام الحاسوب في البرامج الاحترافية
-
Artificial Analysis: جهة مستقلة لتقييم النماذج
- الرابط:
artificialanalysis.ai - التوضيح: يمكن الاطلاع على أحدث بيانات تقييمات مثل Intelligence Index وAA-Omniscience
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يُرجى التواصل معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ولمزيد من موارد التكامل يمكن زيارة مركز التوثيق على docs.apiyi.com


