
作者注:Codex 的任务耗时由模型、推理强度、服务路径、工具循环、缓存和网络共同决定,用同任务对照与分段计时可以定位瓶颈。
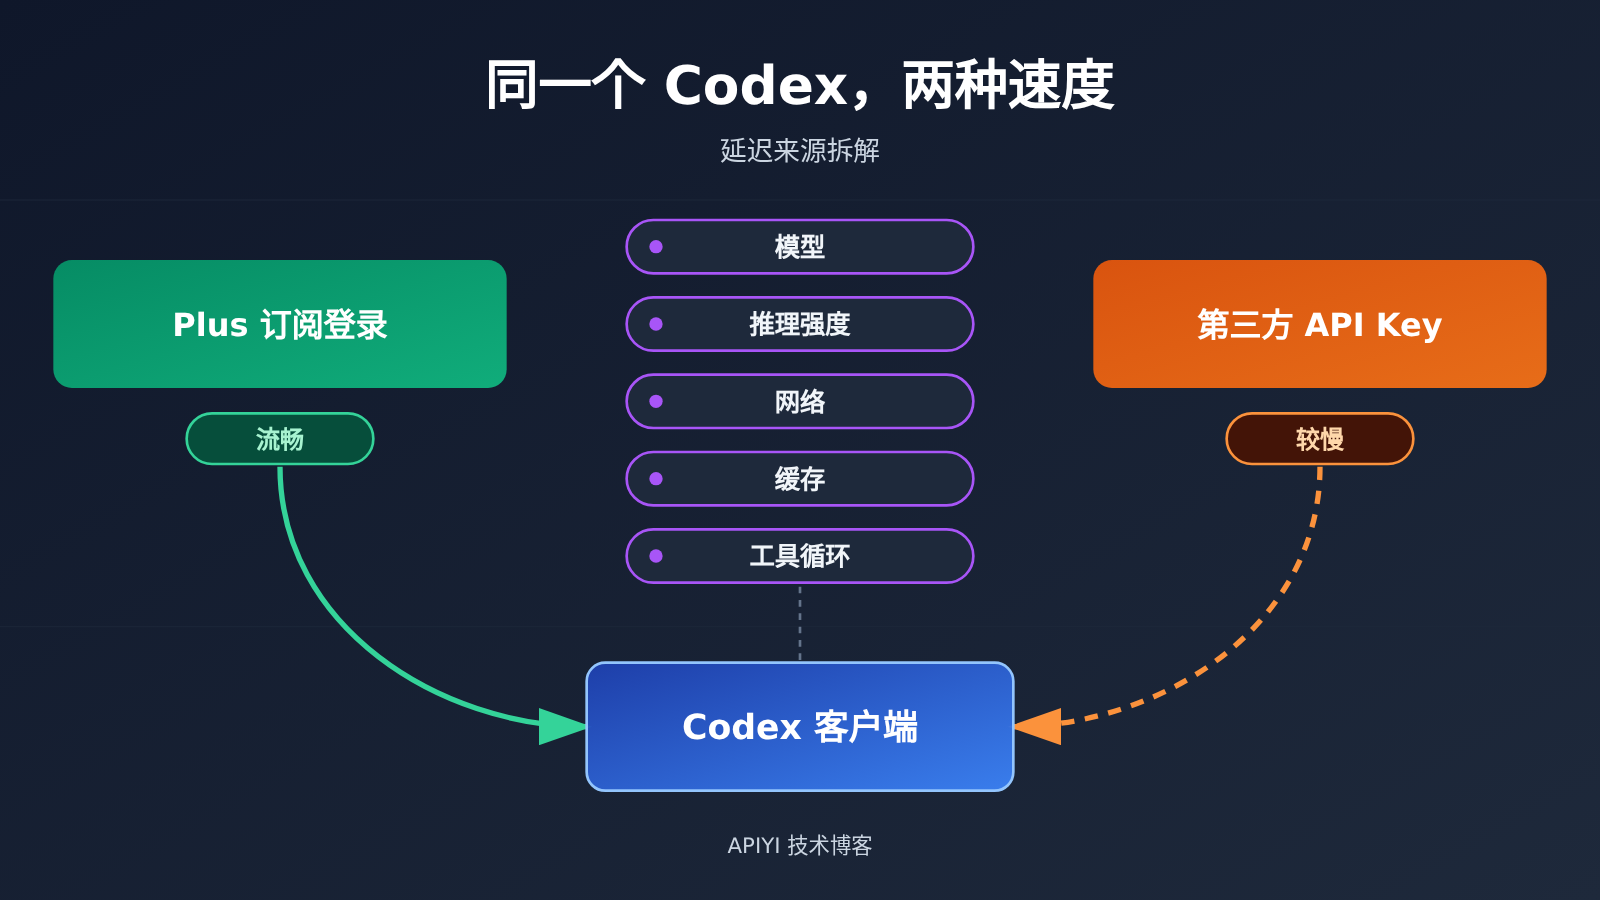
同一个 Codex,用 ChatGPT Plus 登录时流畅,换成第三方 API Key 后变慢,原因通常在于两者走的是 不同的服务路径,而 Codex 的 Agent 循环会把每一轮请求里的额外延迟成倍累积。客户端界面相同,但模型部署、推理档位、传输协议、缓存命中和工具事件兼容程度都可能不同。一次请求只多等 3 秒,一个需要 20 轮串行调用的编程任务就可能多出约 1 分钟。
下文先拆解 Codex 的工作方式和两种接入路径,再逐项说明第三方 API 的延迟来源,并用两个公开的 GitHub Issue 作为个案佐证。之后给出四项核心指标、三组对照测试和按症状分类的优化方案,帮助你判断自己的 Codex 慢在模型、网络、缓存还是工具循环。最后讨论选择第三方 API 时,哪些指标比单价更能反映真实成本。
To Know:理解 Codex 速度差异的术语
| 术语 | 解释 |
|---|---|
| Codex Harness | Codex 的执行框架,负责组织模型、工具、上下文和多轮任务循环。 |
| Responses API | OpenAI 提供的接口,支持模型输出、工具调用和多轮状态管理,Codex 依赖它运转。 |
| TTFT | Time To First Token,从发出请求到收到首个输出 token 的等待时间。 |
| TPS | Tokens Per Second,每秒生成的 token 数,反映持续输出速度。 |
| 端到端耗时 | 从提交任务到任务最终完成的总时间,包含所有模型调用和工具执行。 |
| 推理强度 | 模型思考的深浅档位,如 low、medium、high,档位越高通常输出越多、耗时越长。 |
| 工具调用(Tool Calling) | 模型请求外部程序读取文件、执行命令等,再拿结果继续推理的过程。 |
| 提示词缓存(Prompt Caching) | 输入前缀重复且符合条件时,复用已有计算结果以降低处理耗时。 |
| SSE | Server-Sent Events,服务器通过单向 HTTP 连接持续推送事件。 |
| WebSocket | 一种持久的双向连接,多轮请求可以复用同一条连接。 |
| previous_response_id | Responses API 中引用上一轮响应的参数,配合增量输入可减少重复传输。 |
| 服务档位 | 同一模型的不同处理选项,如 Standard、Fast,速度和价格各不相同。 |
1 为什么同一个 Codex 会有两种速度?
1.1 Codex 订阅登录与 API Key 走不同的服务路径
根据 OpenAI 的身份验证文档,Codex CLI、IDE 扩展和桌面应用都支持两种登录方式:ChatGPT 账号登录,或填入 API Key。ChatGPT 登录消耗的是订阅附带的 Codex 使用权益和对应限额;API Key 则按 API 账户的计量计费和限流规则执行。Plus 订阅本身也不包含免费调用任意 OpenAI API 的权利。
接入第三方 API Key 时,Codex 客户端只负责组织任务,真正的推理发生在该接口背后的服务上。实际调用的模型、计费方式、流式协议和服务质量,都由第三方接口及其后端实现决定。因此,客户端上显示的模型名称相同,只能说明你选择了同一个名字,无法确认两次请求经过了相同的模型部署、服务队列和传输路径。
1.2 Codex 的 Agent 循环决定了它需要反复请求模型
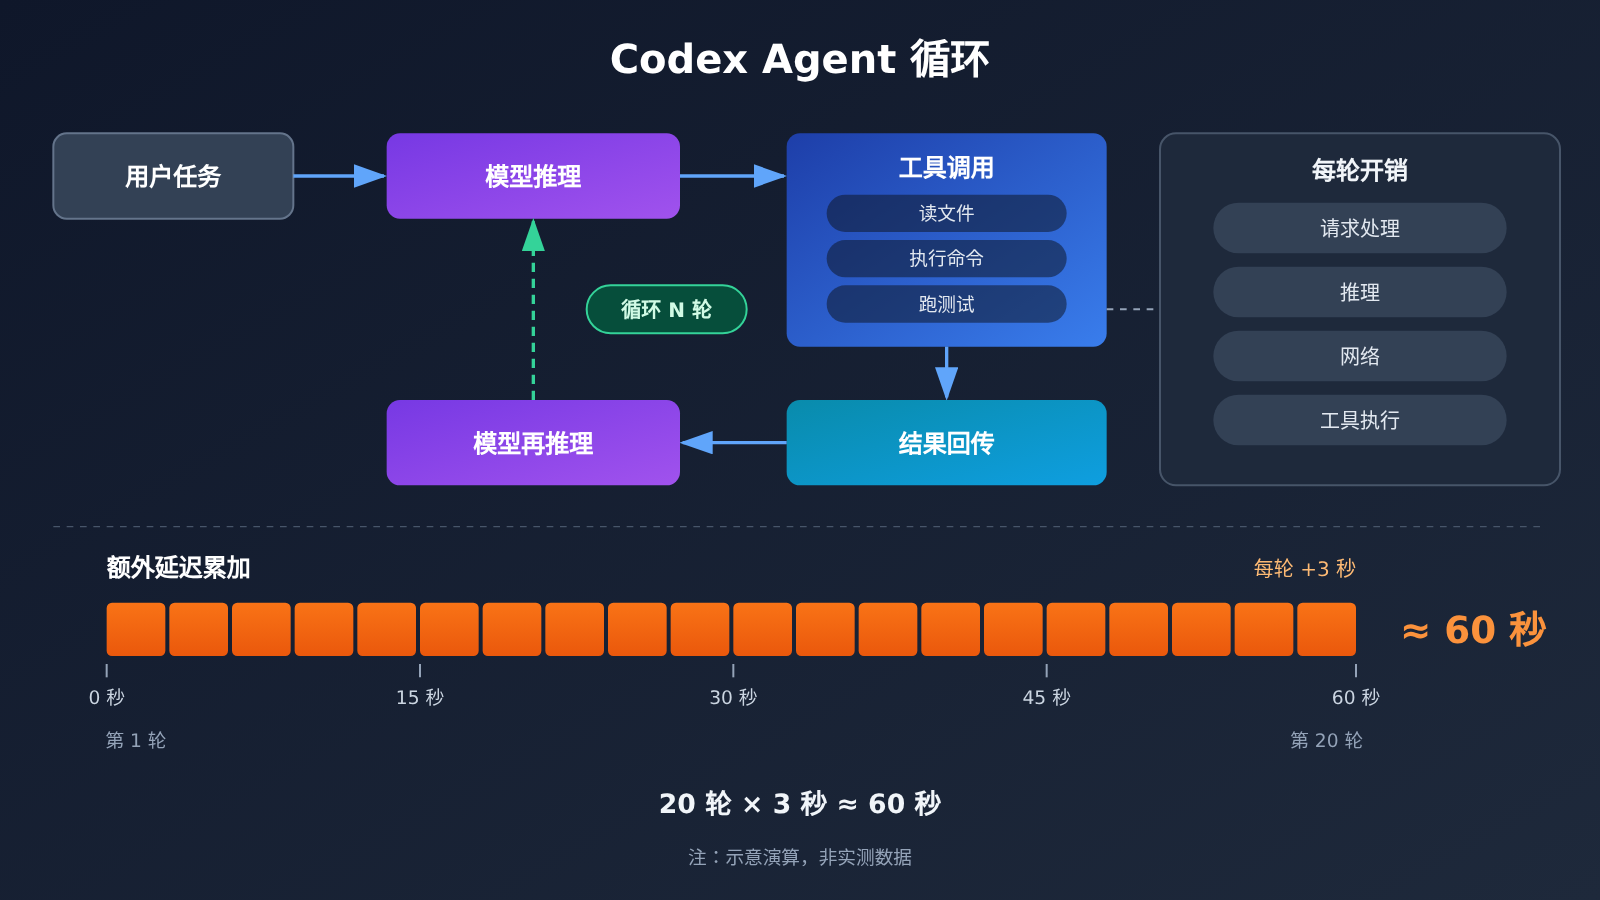
OpenAI 在 2026 年 8 月 19 日发布的《Codex as a platform》中说明,Codex 的开源 Agent Harness 负责理解任务、维护上下文、检索代码库、调用 Shell、编辑文件、运行测试,并处理失败恢复、用户审批和执行边界。它的本质是一个“模型推理 → 工具执行 → 再推理”的循环系统。
OpenAI 在 2026 年 4 月 22 日的工程文章中描述过典型流程:用户提出修改任务,模型判断要做什么,Codex 读取文件或执行命令,工具返回结果后模型重新分析,接着继续调用工具、修改代码、执行测试、检查结果。复杂任务可能包含数十轮模型与工具之间的往返,每一轮都是一次完整的 API 请求。
2 Codex 接第三方 API 的速度差异从哪里来?
先用一张表概括五类延迟来源,后面逐项展开。
| 延迟来源 | 主要影响的指标 | 典型表现 | 排查优先级 |
|---|---|---|---|
| 模型与推理强度 | TPS、单轮推理时间 | 输出持续偏慢,思考时间长 | 高 |
| 服务档位与路由 | TTFT、波动幅度 | 首响应慢或忽快忽慢 | 高 |
| 网关与网络路径 | 每轮固定附加时间 | 每次调用都多出稳定的几秒 | 中 |
| 传输协议(SSE / WebSocket) | 多轮累计开销、连接稳定性 | 长任务慢、中途断流 | 中 |
| 缓存与工具循环 | 输入处理时间、调用轮次 | 长对话明显变慢、轮次过多 | 高 |
2.1 模型推理速度和推理强度对 Codex 耗时的影响
对比两种接入方式之前,必须先确认实际模型 ID、推理强度、模型版本和服务档位是否一致。推理强度从 low 到 xhigh、max,档位越高,模型生成的思考内容越多,单轮耗时越长。
OpenAI 的延迟优化指南把输出 token 数列为影响推理耗时的关键变量:在部分场景中,输出 token 减少约 50%,生成延迟也可能下降接近 50%;而减少普通输入文本带来的影响通常小得多。服务档位同样重要,OpenAI 的 Fast 模式对适用模型和负载最高可达 2.5 倍速度,但它是付费档位选择,并且只对部分模型生效。
这意味着订阅侧和第三方侧哪怕都显示同一模型,只要推理档位或服务档位不同,速度差异就会很明显。
2.2 API 中转、网络路径与 WebSocket 对多轮任务的影响
第三方接口的请求链路通常更长:客户端 → 服务商网关 → 代理节点 → 可能的跨境链路 → 最终推理服务。每多一跳,就可能多一点固定延迟和网络波动,而这些延迟在 Agent 循环中会被逐轮叠加。
传输协议是另一个变量。传统 Responses API 多通过 HTTP/SSE 传输,每轮都要重新建立请求并携带上下文。WebSocket 模式维持持久连接,并借助 previous_response_id 和增量输入减少重复传输与处理。OpenAI 官方公布的数据如下:
- 2025 年末的一轮 API 优化使首 token 延迟改善接近 45%。
- 在 20 次以上工具调用的特定工作流中,WebSocket 模式带来最高约 40% 的端到端提速。
- Vercel 相关集成报告最高约 40% 的延迟改善,Cline 多文件工作流报告约 39% 的提速,Cursor 中的 OpenAI 模型报告最高约 30% 的改善。
这些数据来自不同产品和测试场景,属于特定工作流下的上限值。部分兼容网关只实现了 HTTP/SSE,或未完整支持 Codex 使用的 WebSocket 与增量状态管理,这类接入就拿不到这部分收益。
2.3 Codex 的上下文缓存与工具调用次数
长任务中,历史消息、工具定义和重复上下文会占据大量输入 token。提示词缓存命中时,这部分前缀的处理耗时可以降低。OpenAI 文档显示,GPT-5.6 及后续系列支持新的缓存写入、读取与 TTL 控制。
问题在于,缓存依赖请求前缀的稳定性。如果中转层改写了请求前缀、调整了工具定义顺序或改变了缓存边界,就可能影响缓存复用,让每一轮都重新处理大段上下文。工具调用次数则直接决定请求轮次:轮次越多,所有单轮开销被放大的倍数就越高。
2.4 为什么 Codex 首响应正常,后续仍然很慢?
这是标题问题最常见的形态。TTFT 只衡量第一个 token 来得快不快,而 Codex 任务的总耗时是所有轮次的累加。总耗时可以写成:
T_total = Σ(API 请求处理时间 + 模型推理时间 + 网络传输时间 + 本地工具执行时间 + 等待与重试时间)
首响应正常但整体慢,通常来自以下几种情况:持续输出速度(TPS)偏低,长回复拖慢每一轮;工具执行完成后模型重新推理,而每次重新推理都要再处理一遍上下文;流式连接中途断开或超时,客户端触发重试,用户看到的是“模型停住了”。按机制演算,一个需要 20 次串行模型调用的任务,每次多等 3 秒,总耗时就会增加约 60 秒,这个数字用于说明累积效应,并非实测结果。
3 公开案例为 Codex 慢速问题提供了哪些证据?
以下两个案例来自 openai/codex 仓库的用户报告,属于单一用户的个案日志,用于说明机制,不代表行业普遍水平。
3.1 Issue #60831:同一会话中约七倍的响应时间波动
2026 年 11 月提交的 Issue #60831 中,报告者在同一会话、同一客户端进程、相同推理设置下观察到两次请求:压缩后的请求体都约为 13.09 MB,中间没有发生上下文压缩,图片历史也没有变化。慢的一次从请求压缩完成到收到 HTTP 响应头用了 109.317 秒,快的一次是 15.637 秒,比值约 6.99 倍。
需要注意计时口径:这两个数字衡量的是“到收到响应头”的时间,属于服务处理阶段,而非整个任务的完成时长;两次请求也来自同一路径,与订阅和第三方的对比无关。它说明的是,在上下文大小不变时,服务端处理时间本身就可能大幅波动。报告本身无法确定具体是哪个服务环节造成了瓶颈。
3.2 Issue #44305:工具循环让一次只读任务耗时激增
2026 年 9 月的 Issue #44305 中,报告者对比了同类只读任务:另一个 Agent 用 3 次并行读取,约 10.6 秒完成;Codex 运行 91.5 秒后超时,仍未给出完整回答。期间 Codex 进行了约 11 次模型推理和 11 次工具调用,累计输入约 295,042 tokens,其中缓存输入约 260,608 tokens。
按这组数字计算,缓存输入占比约 88.3%,缓存命中情况良好,但串行的 11 轮循环仍然让耗时远超并行读取的方案。两个 Agent 的工作策略本身不同,时间差不能全部归因于 Codex 或模型,但它清楚展示了调用轮次和串行执行对总耗时的放大作用。
此外,还有两类问题与第三方接入直接相关:Issue #33029 报告 Codex Desktop 使用第三方兼容接口时,模型端点工作正常,但桌面端仍会请求部分 ChatGPT 辅助服务,这些请求超时会拖慢应用响应;Issue #41340 和 #42471 分别报告了第三方 Responses 端点出现“stream disconnected before completion”,以及工具调用事件被接收却未进入执行流程。简单聊天能跑通,与完整的 Codex 工具循环能跑通,是两个级别的兼容要求。
4 如何找到自己的 Codex 慢在哪里?
4.1 用四项核心指标定位 Codex 瓶颈
| 指标 | 记录方式 | 反映的问题 |
|---|---|---|
| TTFT | 每次请求的首个有效输出等待时间 | 队列、模型启动、网络首包 |
| 端到端耗时 | 任务从提交到完成的总时间 | 整体体验,是最终判断依据 |
| 模型 / 工具调用次数 | 统计推理轮次、工具次数及工具执行时间 | Agent 策略和串行放大 |
| 缓存命中 | 总输入、缓存读取、缓存写入、输出 token | 上下文重复处理开销 |
在这四项之外,建议同时记录 TPS、单次请求的输入输出 token、使用的协议(WebSocket 或 SSE),以及 429、5xx、超时和重试的次数。这些辅助数据能帮你区分“慢”和“出错后重试导致的慢”。
4.2 三组 Codex 对照测试的执行步骤
对照测试的前提是控制变量:模型 ID、推理强度、Codex 版本、项目文件和任务描述保持一致,并分别在新会话和长会话两种场景下各跑一遍,以识别上下文长度的影响。
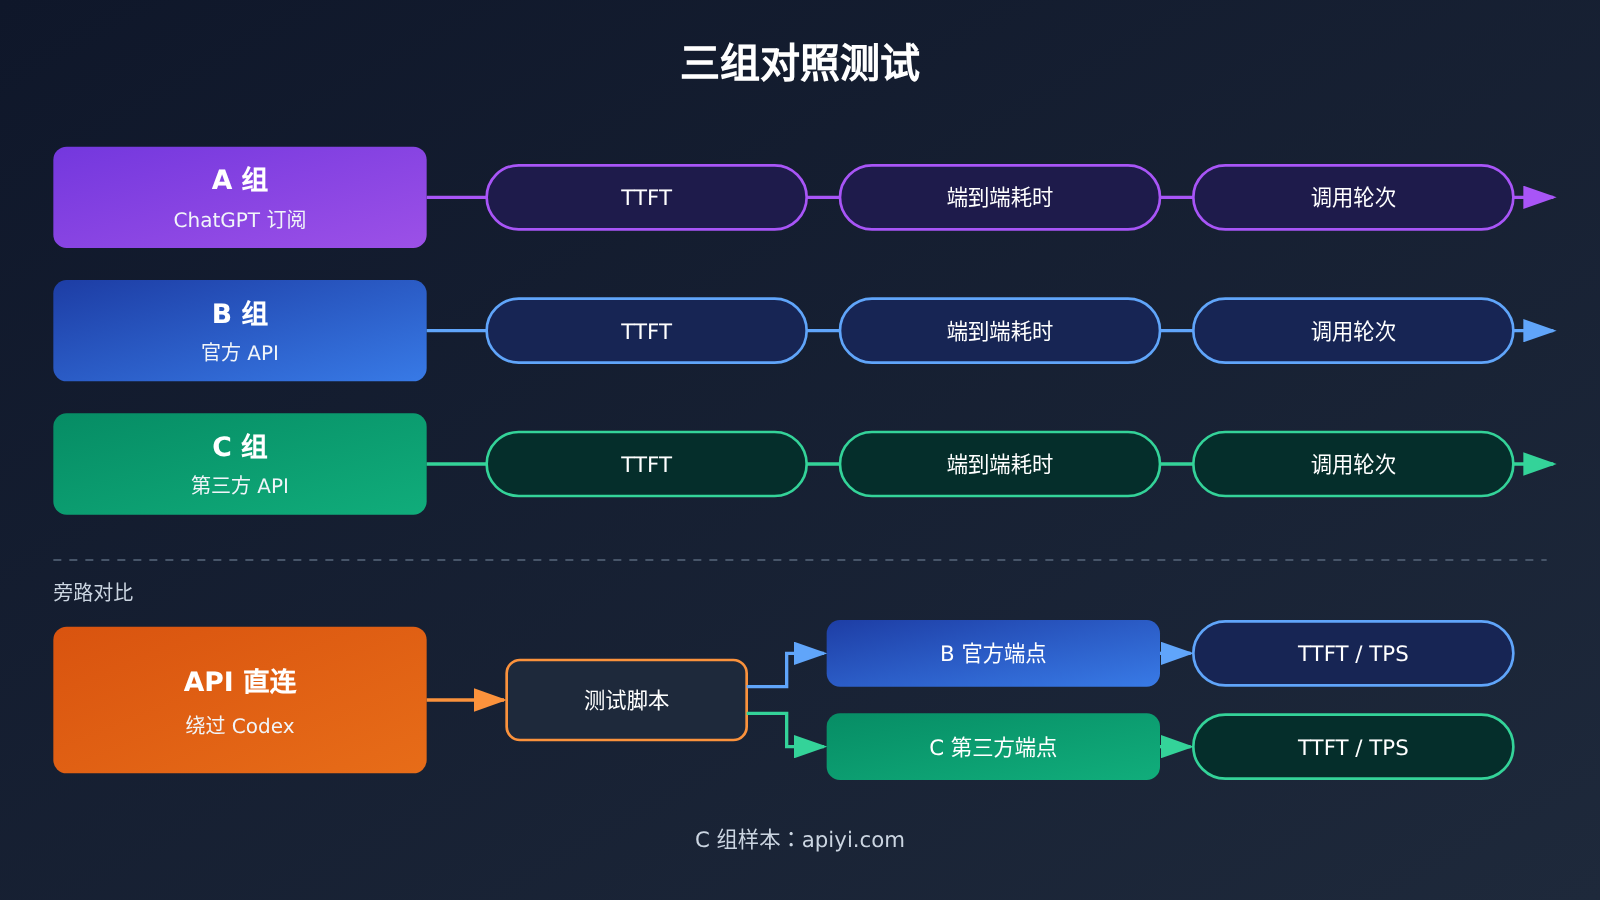
- A 组:用 ChatGPT 订阅登录 Codex,执行标准任务,记录端到端耗时和调用轮次。
- B 组:用同模型的官方 API Key 接入 Codex,执行同一任务。
- C 组:用第三方兼容 API 接入 Codex,执行同一任务。
- 直连组:对 B、C 两条路径,绕过 Codex,用脚本发送同样的单次请求,测量 TTFT 和 TPS。
A 与 B 的差异主要反映订阅路径和 API 路径的服务差异;B 与 C 的差异反映网关、路由和推理服务的差异;直连结果与 Codex 内结果的差距,则反映 Agent 循环、协议兼容和客户端带来的额外开销。每组建议重复多次取中位数,避免把一次偶发波动当成结论。
以下脚本用于“直连组”测试,通过流式 Responses 请求测量 TTFT、总时长、输出 token 和 TPS:
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口,切换到官方地址即可做 B 组对照
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # 与 Codex 中使用的模型 ID 保持一致
    reasoning={"effort": "medium"},   # 与 Codex 中的推理强度保持一致
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
查看多轮重复测试与缓存统计的完整脚本
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # API易 接口
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# 用较长的固定前缀模拟 Codex 的系统提示与工具定义,便于观察缓存命中
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
在 Codex 内做 C 组测试时,需要把第三方端点配置为模型提供方。以下是常见的 ~/.codex/config.toml 写法,具体字段名请以你所用 Codex 版本的官方文档为准:
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "API易"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 快速开始:做 C 组对照时,可以在 API易 apiyi.com 申请新用户免费测试额度,用同一个 Key 切换多个模型分别跑完上面的脚本,快速得到可比的 TTFT 与总耗时数据。
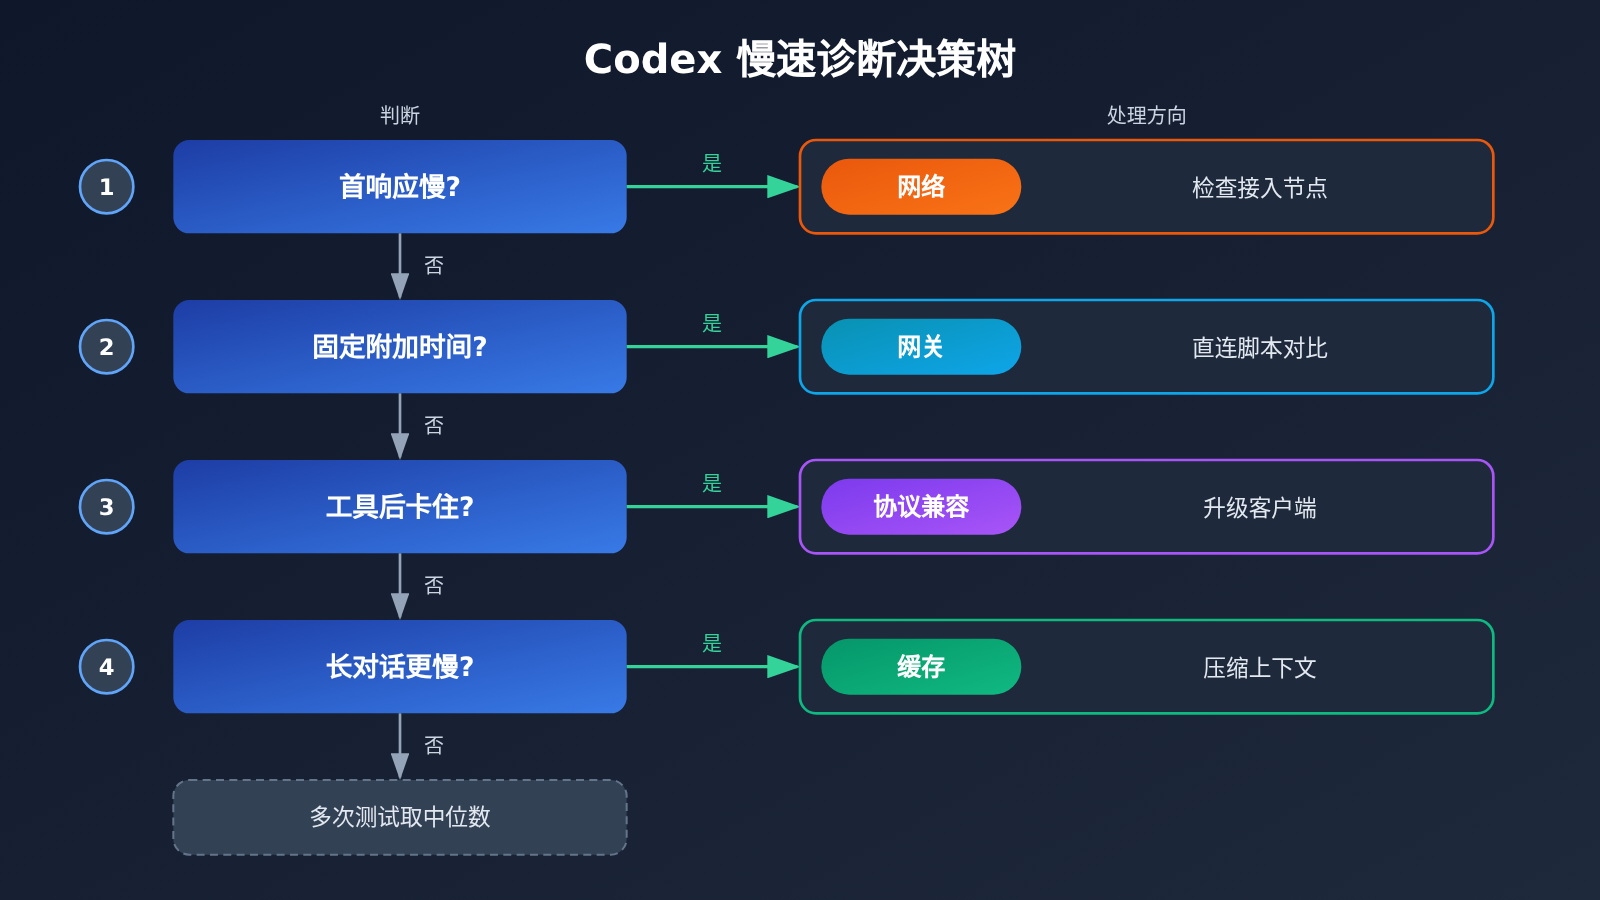
4.3 按症状对应的 Codex 优化方案
| 症状 | 优先排查 | 处理方法 |
|---|---|---|
| 首响应慢 | 队列、模型启动、网络首包 | 换用更近的接入节点,确认服务档位,避开高峰时段对比 |
| 首响应快,后续慢 | TPS、工具轮次、缓存 | 降低推理强度,限制输出长度,检查缓存命中率 |
| 每次调用多出稳定时间 | 中转链路、附加请求 | 用直连脚本对比 B、C 组,定位网关开销 |
| 工具调用后卡住 | Responses 事件、工具回传 | 检查是否出现断流或工具事件丢失,升级客户端版本 |
| 长对话明显慢于新对话 | 历史 token、压缩、缓存 | 适时开新会话或触发上下文压缩,观察缓存读取变化 |
| 速度忽快忽慢 | 服务负载、重试、网络波动 | 统计 429/5xx 和超时次数,多次测试取中位数 |
| 桌面端整体卡顿,API 正常 | ChatGPT 辅助服务请求 | 参考 Issue #33029,检查辅助请求是否超时,必要时改用 CLI |
模型层面的优化遵循 OpenAI 延迟指南的思路:减少输出 token、降低输入上下文、减少调用次数、并行处理独立步骤,能用普通程序完成的事就别交给模型。对于 Codex 来说,最直接的手段是给任务描述更明确的范围,让 Agent 少走探索性的读取轮次。
5 为 Codex 选择第三方 API 时,哪些指标比单价更重要?
5.1 从 token 单价转向任务完成成本
Codex 场景下,真正的成本由“完成一个任务”决定。单价低的接口,如果缓存命中差、调用轮次多、经常断流重试,最终消耗的 token 和时间都会更高。评估时建议把以下几项放在一起看:任务成功率、端到端耗时、单任务消耗的总 token(含缓存读取)、失败与重试带来的额外成本。
| 评估维度 | 关注点 | 测试方法 | 可用平台 |
|---|---|---|---|
| 模型身份与版本 | 模型 ID 与版本是否明确、稳定可用 | 核对返回的模型字段与文档 | API易 apiyi.com、官方 API |
| 首 token 与持续速度 | TTFT、TPS 的中位数和波动 | 直连脚本多轮测试 | API易 apiyi.com、官方 API |
| 多轮 Agent 完成时间 | Codex 内真实任务的总耗时 | 三组对照测试 | API易 apiyi.com、官方 API |
| 协议兼容 | Responses、WebSocket、工具事件支持 | 跑一次完整的读文件 + 改代码 + 测试任务 | 视服务商文档而定 |
| 缓存支持 | 缓存读取 token 是否正常返回 | 统计 usage 中的缓存字段 | 视服务商文档而定 |
| 稳定性与计费 | 失败率、并发、计费透明度 | 记录 429/5xx 与账单明细 | 视服务商文档而定 |
5.2 用真实任务评估 API易 等第三方接口
API易 apiyi.com 是 AI 大模型 API 聚合平台,一个 API Key 可以调用 OpenAI、Claude、Gemini 等主流模型,接口兼容 OpenAI 协议,按量计费。它在 Codex 场景中的价值,主要体现在方便横向比较:同一套配置切换不同模型和档位,就能在你自己的项目上跑出可比数据。
不同第三方服务商的链路、协议支持和稳定性各不相同,评估时应以具体测试数据和服务协议为依据。建议挑选 2~3 个代表性任务(例如一次多文件重构、一次带测试的 bug 修复),按第 4 节的方法在各接入方式上分别执行,再结合成功率和总 token 做决定。
💡 选择建议:先用直连脚本筛掉 TTFT 和 TPS 明显偏离的选项,再把剩下的候选放进 Codex 跑完整任务。通过 API易 apiyi.com 的统一接口,可以在不改代码结构的情况下完成多个模型的对比。
常见问题 FAQ
Q1:Codex 订阅和第三方 API 的速度差异主要来自哪里?
来自服务路径的整体差异:实际模型部署、推理强度、服务档位、网关链路、传输协议、缓存命中和工具事件兼容程度。Codex 的多轮 Agent 循环会把这些单轮差异逐轮累加,因此总耗时差距往往比单次请求差距大得多。
Q2:TTFT 正常,为什么 Codex 任务还是很慢?
TTFT 只衡量首个 token 的等待时间。Codex 一个任务包含多轮推理和工具调用,持续输出速度、工具执行后的重新推理、缓存未命中和中途重试都会拉长总时间。判断体验要看端到端耗时和调用轮次。
Q3:WebSocket 模式能让 Codex 快多少?
OpenAI 公布的数据是:在 20 次以上工具调用的特定工作流中,端到端速度最高约提升 40%。这是特定场景的上限,实际收益取决于任务轮次以及接口是否完整支持 WebSocket 和增量状态管理。
Q4:长对话中 Codex 越来越慢,应该怎么处理?
先记录每轮的总输入 token 和缓存读取 token,确认缓存是否正常命中。如果历史上下文过长,可以开启新会话或触发上下文压缩;同时缩小任务范围,减少探索性的文件读取轮次。
Q5:如何快速测出第三方 API 在 Codex 中的真实表现?
1. 在 API易 apiyi.com 注册并获取 API Key 与免费测试额度;
2. 用本文的直连脚本测量 TTFT、TPS 和缓存命中;
3. 按 4.2 节配置 Codex,执行与订阅侧相同的任务,对比端到端耗时与调用轮次。
这样可以分开看到推理服务差异和 Agent 循环带来的差异。
Q6:公开 Issue 里的数据能代表 Codex 的普遍性能吗?
不能直接代表。Issue #60831 和 #44305 都是单一用户的日志,前者衡量的是到 HTTP 响应头的时间,后者是一次超时的只读任务。它们的价值在于展示服务端波动和串行工具循环如何影响耗时,具体结论需要用你自己的任务测试来验证。
Codex 速度差异核心要点 Key Takeaways
- 路径不同:订阅登录与 API Key 走不同计费和服务路径,模型名相同不代表部署相同。
- 循环放大:Codex 的 Agent 循环会把每轮小延迟累加成显著的总耗时差。
- 指标分层:TTFT 看首响应,端到端耗时和调用轮次才反映真实体验。
- 协议有影响:WebSocket 在多轮工具调用场景下最高约 40% 提速,需接口完整支持。
- 缓存要核对:中转层改变请求前缀可能影响缓存,需统计缓存读取 token。
- 对照测试:订阅、官方 API、第三方 API 三组同任务对照,加直连测试定位瓶颈。
- 按任务选型:用真实任务在 API易 apiyi.com 等平台横向测试,看任务完成成本而非单价。
总结
同一个 Codex 出现两种速度,根源在于服务路径与 Agent 循环的叠加效应:
- 机制层面:模型、推理强度、服务档位、网关、协议、缓存和工具循环共同决定总耗时,任何单轮差异都会被多轮调用放大。
- 证据层面:官方数据说明协议和档位优化能带来可观提速,用户日志说明服务端波动和串行循环会显著拉长任务。
- 方法层面:记录四项核心指标,做三组对照加直连测试,再按症状逐项优化。
排查时先固定模型和推理强度,再用数据说话。如果你需要在多个模型和接入方式之间做对比,可以借助 API易 的统一接口,把测试成本降到最低。
📚 参考资料
- Codex as a platform: build on the open agent harness:OpenAI 介绍 Codex Agent Harness 的职责
- 链接:
developers.openai.com/blog/codex-as-a-platform -
说明: 理解 Codex 多轮模型与工具循环的官方依据
-
Codex 身份验证文档:ChatGPT 登录与 API Key 两种接入方式
- 链接:
learn.chatgpt.com/docs/auth?surface=cli -
说明: 区分订阅权益与 API 计费、限流规则
-
Speeding up agentic workflows with WebSockets in the Responses API:OpenAI 工程文章
- 链接:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
说明: Agent 循环流程与 WebSocket 提速数据
-
WebSocket mode 文档:Responses API 的 WebSocket 模式
- 链接:
developers.openai.com/api/docs/guides/websocket-mode -
说明: 持久连接、增量输入与适用场景
-
Latency optimization 指南:OpenAI 延迟优化原则
- 链接:
developers.openai.com/api/docs/guides/latency-optimization -
说明: 输出 token、调用次数、并行化等优化思路
-
Fast mode 文档:服务档位与加速范围
- 链接:
developers.openai.com/api/docs/guides/fast-mode -
说明: 比较速度时需控制的服务档位变量
-
Prompt caching 文档:缓存写入、读取与 TTL
- 链接:
developers.openai.com/api/docs/guides/prompt-caching -
说明: 长对话缓存命中的统计与优化
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471:用户报告的延迟与兼容问题
- 链接:
github.com/openai/codex/issues/60831、github.com/openai/codex/issues/44305、github.com/openai/codex/issues/33029 - 说明: 服务端波动、工具循环放大、桌面端辅助请求及第三方协议兼容的个案日志
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们交流 Codex 接入与性能测试经验,更多资料可访问 docs.apiyi.com 文档中心


