
作者注:本文把 GPT-6.2 Sol Ultrafast 的官方速度上限、促銷價和刊例價分開列出,並給出一張可以套用到自己任務上的速度溢價算法。
是否給 GPT-6.2 Sol 打開 Ultrafast,取決於這次任務能省下多少等待。官方給出的速度是 同一模型標準檔的最高 4.5 倍,促銷期價格是 標準價的 3 倍,2027 年 3 月起的刊例價是 6 倍。速度是一個上限,價格是確定的數字,兩者的確定程度不同,不能直接相除。
本文不替你回答“值不值得買”。我們不做自己的測速結論,也不會把一條沒有對照組的民間記錄當成最終結果。本文只提供一套算法:先測出你自己任務在標準檔的耗時,再用官方的“最高”倍數算出能省下時間的上限,最後和差價對比。
核心價值:讀完本文,你可以對任意一次任務算出“每省 1 分鐘要多付多少錢”,再按任務決定是否開啓速度檔。
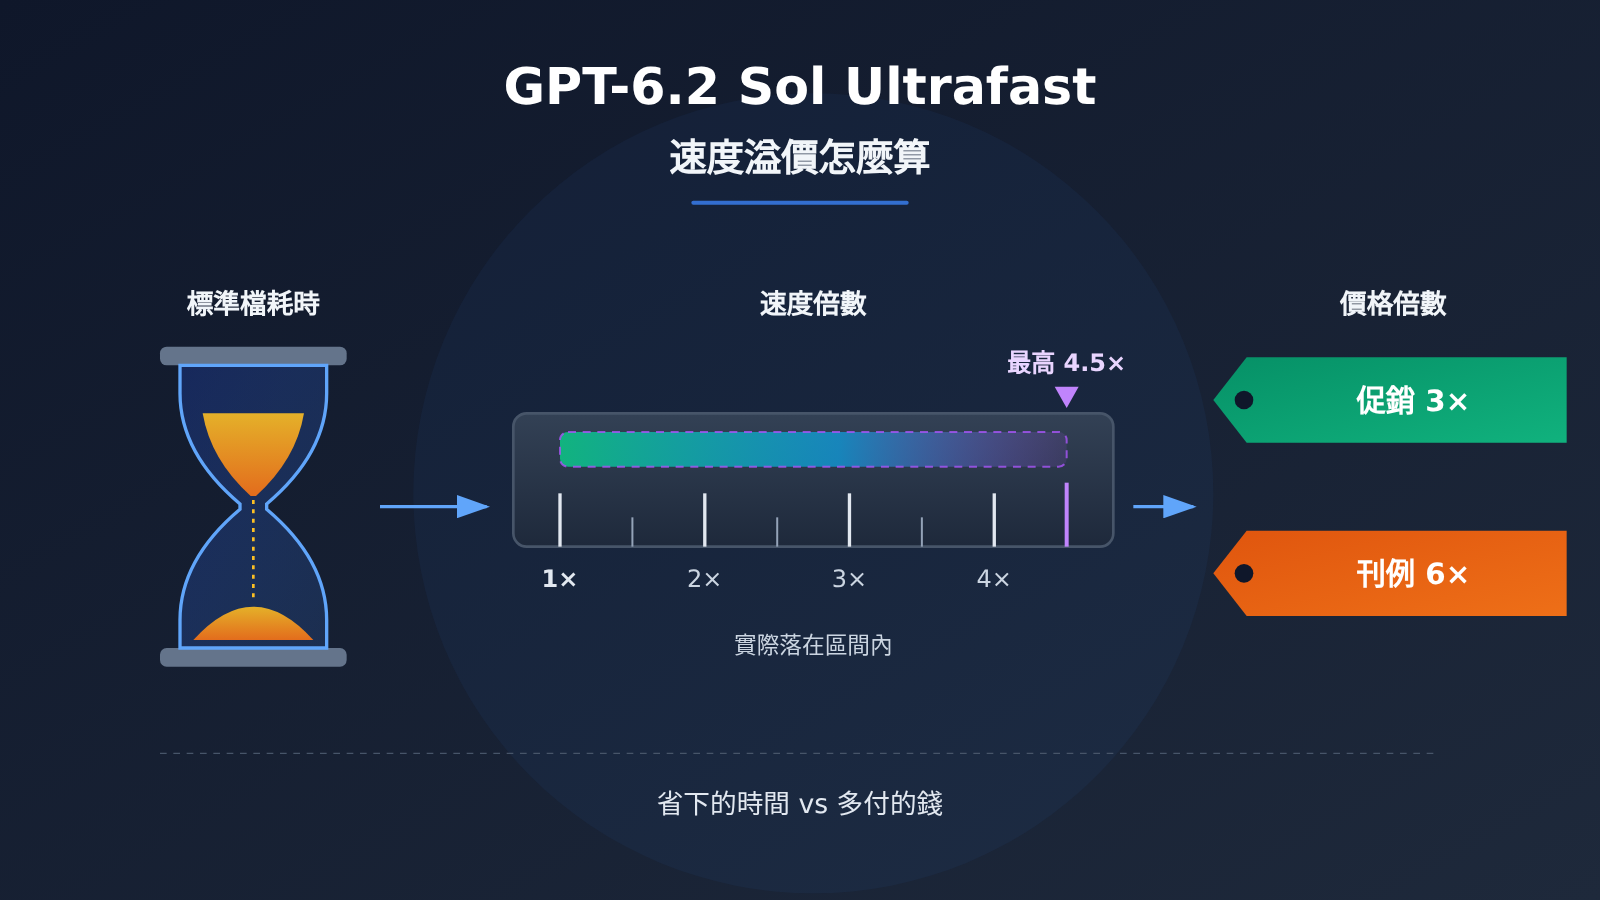
GPT-6.2 Sol Ultrafast 速度溢價的核心差異
需要先釐清一個概念:Ultrafast 是一個服務檔,並不是另一個模型。按官方 API 文檔的寫法,請求中的 model 仍然是 gpt-6.2-sol,只需另外加上 service_tier 並設爲 ultrafast。目前支持這個服務檔的有 GPT-6.2 Astra、GPT-6.2 Sol、GPT-6 Astra 和 GPT-6.1 Sol。
因此,你在比較的是同一個模型的兩種交付速度,而不是兩個模型的能力差異。輸出質量的問題可以放在一邊,這道題只剩兩個變量:時間和價格。
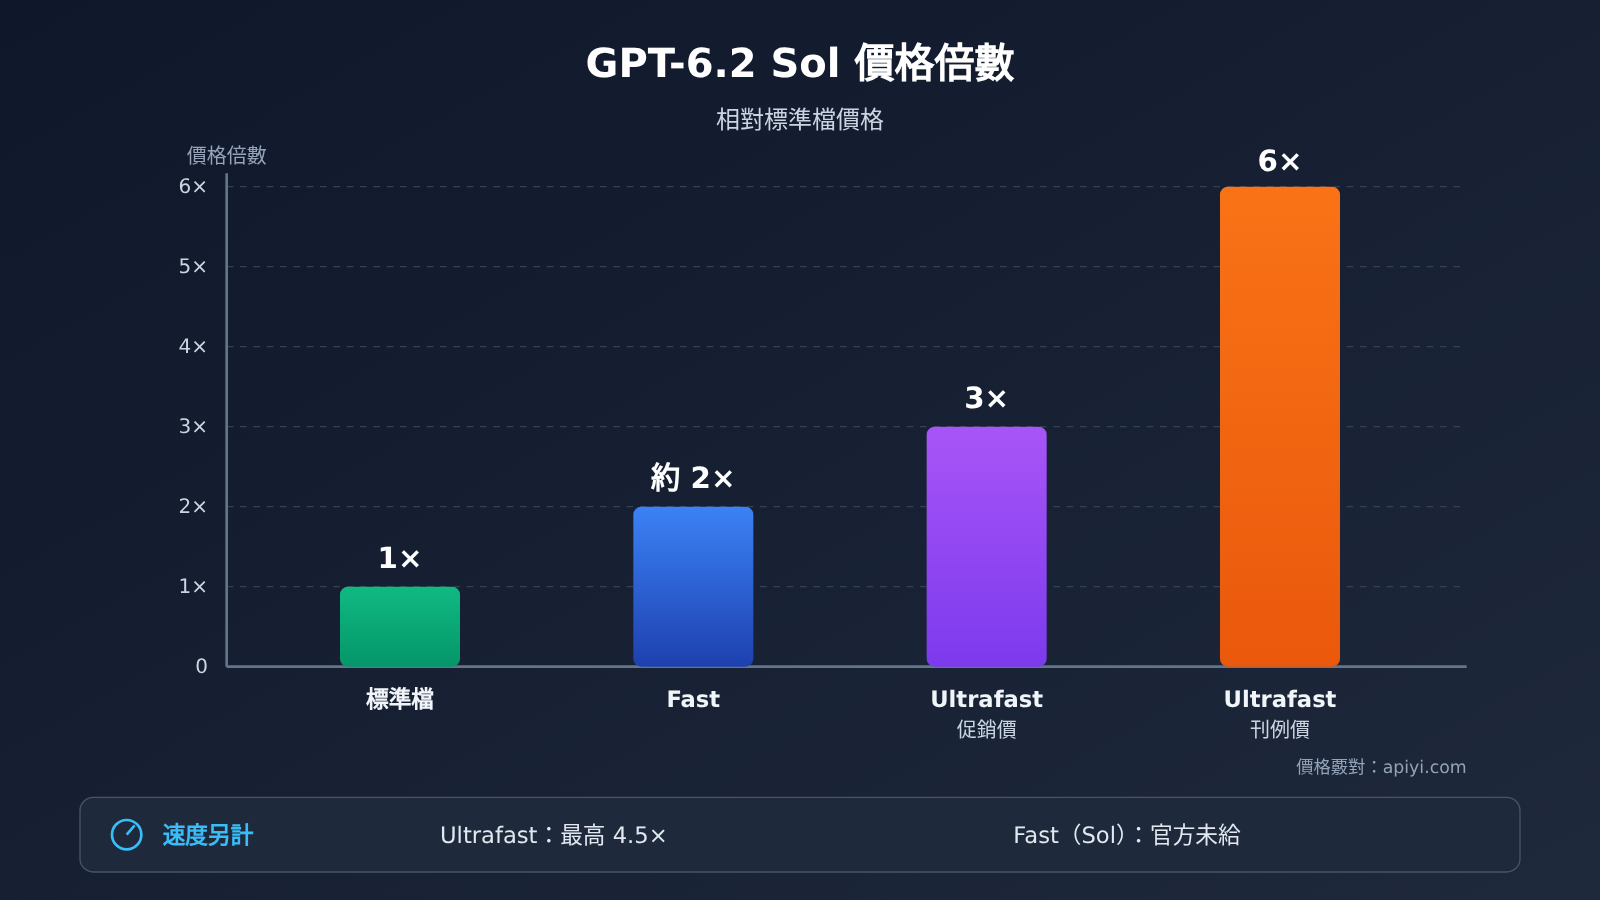
| 檔位(gpt-6.2-sol,短上下文) | 輸入 | 緩存讀 | 輸出 | 相對標準價 | 官方速度說法 |
|---|---|---|---|---|---|
| 標準檔 | 2 | 0.10 | 10 | 1× | 基準 |
| Fast | 4 | 0.20 | 20 | 約 2× | 文檔未對 Sol 寫速度倍數 |
| Ultrafast 促銷(至 2027-02-28 太平洋時間) | 6 | 0.30 | 30 | 3× | 最高 4.5 倍 |
| Ultrafast 刊例(2027-03-01 起) | 12 | 0.60 | 60 | 6× | 最高 4.5 倍 |
表中價格單位爲美元/百萬 tokens,短上下文指輸入不超過 27.2 萬 tokens。Fast 檔需要單獨提醒:官方文檔寫的“約 1.5 倍速度”針對的是 GPT-6.2 Astra 和 GPT-5.6,並沒有寫在 GPT-6.2 Sol 上,所以不能把這個倍數套到 Sol 的 Fast 檔。
GPT-6.2 Sol Ultrafast 長上下文價格
如果輸入超過 27.2 萬 tokens,就進入長上下文計價。官方標準檔的長上下文價格是輸入 4、緩存讀 0.20、輸出 15。Ultrafast 促銷價爲 12 / 0.60 / 45,刊例價爲 24 / 1.20 / 90,仍然是標準價的 3 倍和 6 倍。
| 計價項(長上下文,美元/百萬 tokens) | 輸入 | 緩存讀 | 輸出 |
|---|---|---|---|
| 官方標準檔 | 4 | 0.20 | 15 |
| Ultrafast 促銷 | 12 | 0.60 | 45 |
| Ultrafast 刊例 | 24 | 1.20 | 90 |
API易 總表 gpt-6.2-sol(超過 27.2 萬輸入) |
3 | 以平臺列表爲準 | 以平臺列表爲準 |
這裏有一處數字不一致,需要單獨說明:API易 apiyi.com 的模型總表把階梯寫成 0 到 27.2 萬 tokens 輸入 2 美元,超過 27.2 萬爲輸入 3 美元,而官方標準檔長上下文的輸入價是 4 美元。這兩個數字不要合併:通過 API易 調用按總表的 3 美元計算,直連官方按 4 美元計算。
GPT-6.2 Sol Ultrafast 的速度從哪來:官方上限與民間記錄
速度這一側目前有兩類信息,可信程度差別很大,建議分開對待。
| 來源 | 內容 | 性質 | 能否當作你的倍數 |
|---|---|---|---|
| 官方 Codex / API 文檔 | Ultrafast 生成速度最高到同一模型標準檔的 4.5 倍(up to 4.5 times) | 官方上限說法 | 只能當上限 |
| Artificial Analysis | 同一模型標準檔約 85 輸出 token/秒 | 第三方公開基準 | 只能當參考 |
| OrcaRouter 2026-11-18 轉述 | 一次任務平均約 126 token/秒,峯值約 252 | 單次、無標準檔對照的轉述 | 不能 |
官方原文用的是 “up to”,意思是最高可以達到,並不承諾每次請求都能達到 4.5 倍。在算法裏,它適合放在“最好情況”這一欄。
OrcaRouter 在 2026-11-18 轉述了 X 上一位剪輯師的單次任務:Ultrafast 平均約每秒 126 個 token,峯值約 252;任務牆鍾約 27 分鐘,其中模型響應約 14 分鐘。轉述作者把這個數字和 Artificial Analysis 公佈的標準檔 85 token/秒對比,得出約 1.5 倍。這條記錄只有一次運行,沒有重複,也沒有同一任務的標準檔對照,因此只能算一個數據點,不能代表這個速度檔的最終表現。
這條記錄還暴露了一個容易被忽略的事實:27 分鐘的牆鍾裏,模型響應只佔約 14 分鐘。速度檔只能加快模型生成這一段,工具調用、文件讀寫、人工確認等環節不會因此變快。
如何計算 GPT-6.2 Sol Ultrafast 速度溢價:一張可套用的算法
下面這套算法刻意不使用任何“別人測到的倍數”。唯一需要你自己提供的數據,是這次任務在標準檔下的耗時。
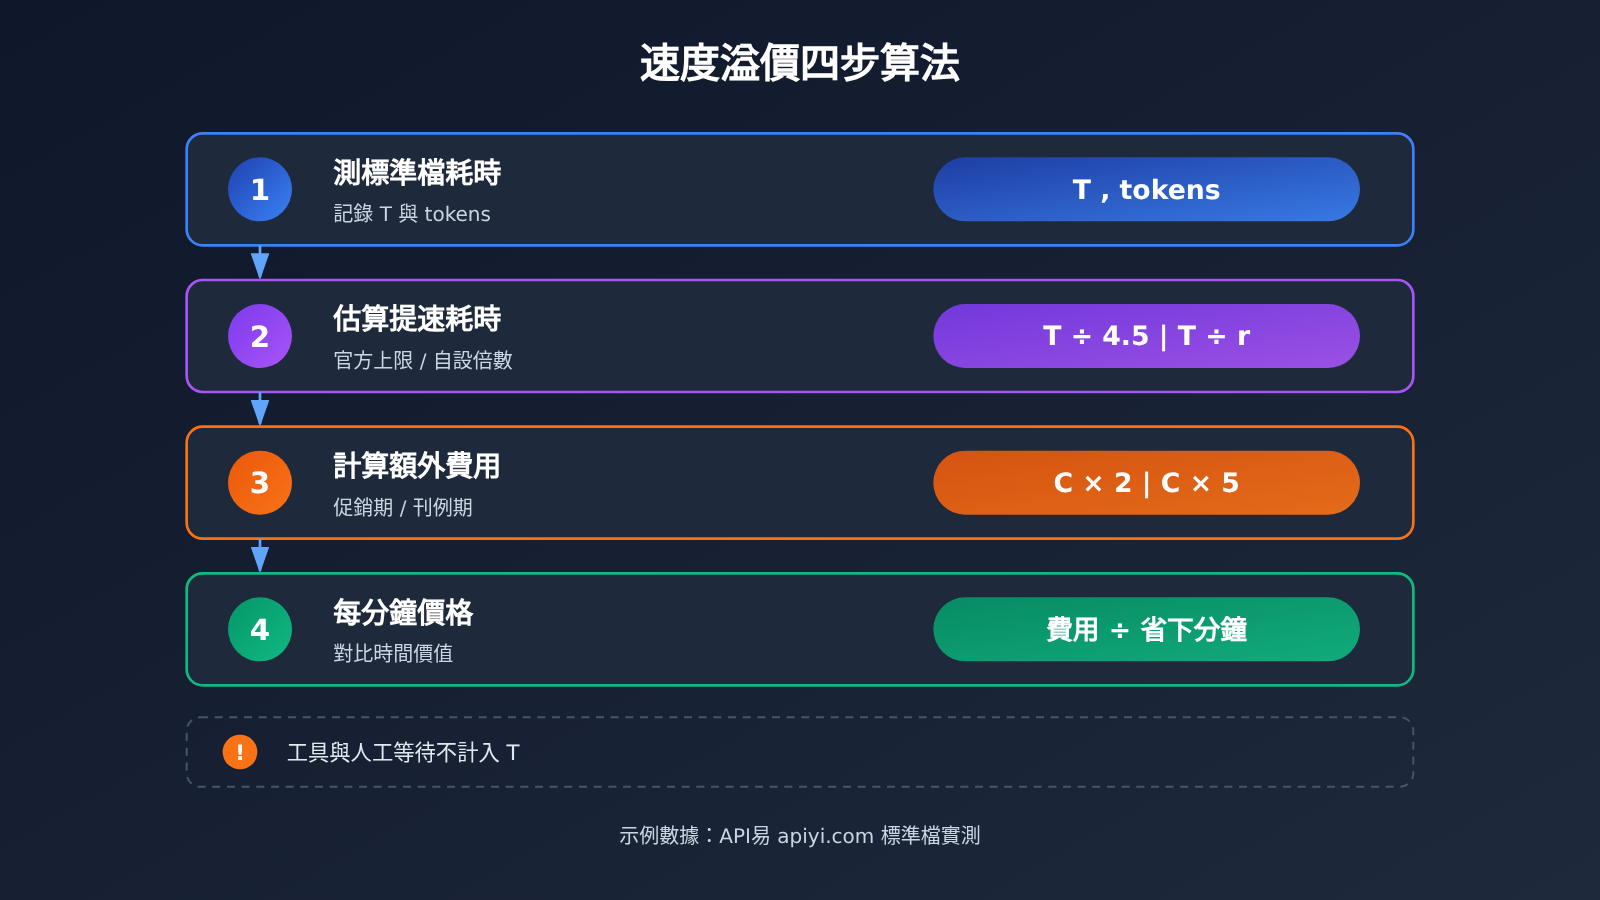
| 步驟 | 計算項 | 公式 | 說明 |
|---|---|---|---|
| ① | 標準檔生成耗時 T | 自己測 | 只計模型生成,不計工具時間 |
| ② | 最好情況可省時間 | T ×(1 − 1/4.5)≈ 0.78T | 用官方上限 |
| ②′ | 保守情況可省時間 | T ×(1 − 1/r) | r 爲你自定的倍數,且 r ≤ 4.5 |
| ③ | 標準檔費用 C | 輸入×單價 + 緩存讀×單價 + 輸出×單價 | 按上下文長度選擇價格檔 |
| ④ | 促銷期額外費用 | C × 2 | Ultrafast 促銷價爲 3C |
| ④′ | 刊例期額外費用 | C × 5 | Ultrafast 刊例價爲 6C |
| ⑤ | 每省 1 分鐘的價格 | 額外費用 ÷ 省下的分鐘數 | 和你的時間價值比較 |
GPT-6.2 Sol Ultrafast 示例計算
下面用一組假設數字演示算法,這些數字不是測速結果。假設一次任務輸入 20 萬 tokens(短上下文),輸出 5 萬 tokens,沒有緩存命中;你自己用標準檔跑出來的輸出速度是 80 token/秒。
- 標準檔費用 C = 0.2 × 2 + 0.05 × 10 = 0.9 美元。
- 標準檔生成耗時 T = 50000 ÷ 80 ≈ 625 秒,約 10.4 分鐘。
- Ultrafast 促銷價爲 2.7 美元,額外支出 1.8 美元;刊例價爲 5.4 美元,額外支出 4.5 美元。
| 假設倍數 r | 生成耗時 | 省下時間 | 促銷期每分鐘價格 | 刊例期每分鐘價格 |
|---|---|---|---|---|
| 4.5(官方上限) | 約 2.3 分鐘 | 約 8.1 分鐘 | 約 0.22 美元 | 約 0.56 美元 |
| 3 | 約 3.5 分鐘 | 約 6.9 分鐘 | 約 0.26 美元 | 約 0.65 美元 |
| 2 | 約 5.2 分鐘 | 約 5.2 分鐘 | 約 0.35 美元 | 約 0.87 美元 |
| 1.5 | 約 6.9 分鐘 | 約 3.5 分鐘 | 約 0.51 美元 | 約 1.29 美元 |
這張表可以看出兩點。第一,倍數從 4.5 降到 1.5 時,每分鐘價格大約翻倍,所以倍數假設比價格本身更關鍵。第二,2027 年 3 月刊例價生效後,同樣省下 1 分鐘要多付約 2.5 倍的錢,促銷期的結論不能直接沿用到明年。
💰 成本覈對建議:示例中的標準檔單價可以直接對照 API易 apiyi.com 總表裏
gpt-6.2-sol的標價(輸入 2、緩存讀 0.1、輸出 10),這組價格和官方標準檔短上下文一致,適合作爲算法裏的 C 值來源。
用代碼測出你自己的 GPT-6.2 Sol 標準檔耗時
算法第一步需要真實的 T。下面這段代碼用流式輸出記錄首 token 時間和總生成時間,並讀取 usage 中的 token 數,用來計算你這類任務在標準檔的速度。
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容入口
)

start = time.time(); first = None; usage = None
stream = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "把你的真實任務提示詞放在這裏"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and first is None:
        first = time.time()
    if chunk.usage:
        usage = chunk.usage
end = time.time()
gen = end - (first or start)
print(f"首 token {first - start:.1f}s,生成 {gen:.1f}s,"
      f"輸出 {usage.completion_tokens} tokens,約 {usage.completion_tokens / gen:.0f} tok/s")
查看包含 service_tier 的完整對照腳本
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PRICE = {  # 美元/百萬 tokens,短上下文
    "default":   {"in": 2,  "cache": 0.10, "out": 10},
    "promo":     {"in": 6,  "cache": 0.30, "out": 30},
    "list":      {"in": 12, "cache": 0.60, "out": 60},
}

def run(prompt: str, tier: str | None = None):
    kwargs = dict(
        model="gpt-6.2-sol",
        messages=[{"role": "user", "content": prompt}],
        stream=True,
        stream_options={"include_usage": True},
    )
    if tier:
        # 官方寫法:同一模型 ID 加 service_tier
        kwargs["extra_body"] = {"service_tier": tier}
    start = time.time(); first = None; usage = None; served = None
    for chunk in client.chat.completions.create(**kwargs):
        if chunk.choices and chunk.choices[0].delta.content and first is None:
            first = time.time()
        if chunk.usage:
            usage = chunk.usage
        served = getattr(chunk, "service_tier", served)
    gen = time.time() - (first or start)
    return gen, usage, served

def cost(usage, p):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * p["in"] + cached * p["cache"] + usage.completion_tokens * p["out"]) / 1e6

prompt = "把你的真實任務提示詞放在這裏"
t_std, u_std, s_std = run(prompt)
c_std = cost(u_std, PRICE["default"])
print(f"標準檔:生成 {t_std:.1f}s,費用約 ${c_std:.3f},返回檔位 {s_std}")

for name, r in [("官方上限", 4.5), ("保守假設", 2.0)]:
    saved_min = t_std * (1 - 1 / r) / 60
    print(f"{name} r={r}:省 {saved_min:.1f} 分鐘,"
          f"促銷每分鐘 ${c_std * 2 / saved_min:.3f},刊例每分鐘 ${c_std * 5 / saved_min:.3f}")

# 如需實測速度檔,取消下面註釋,並檢查返回的 service_tier 字段是否爲 ultrafast
# t_uf, u_uf, s_uf = run(prompt, tier="ultrafast")
# print(f"速度檔:生成 {t_uf:.1f}s,實際倍數約 {t_std / t_uf:.2f},返回檔位 {s_uf}")
關於 service_tier 需要說明:API易 apiyi.com 的模型總表只列出 gpt-6.2-sol,沒有單獨的 ultrafast 型號,也沒有寫出 service_tier 字段,列表上的標價對應標準檔。本文只覈對了文檔和價目,沒有發送真實請求,所以無法說明這個參數經 https://api.apiyi.com/v1 調用時的表現。如果你需要速度檔,請以響應裏返回的檔位字段和賬單爲準,型號與價格以平臺型號列表爲準。
🚀 上手建議:先用 API易 apiyi.com 的標準檔
gpt-6.2-sol跑兩三次自己的真實任務,取生成耗時的中位數作爲 T。這一步只花標準價,卻決定了後面所有計算的準確性。
GPT-6.2 Sol Ultrafast 場景推薦
結論要按任務來下。同一個人,在不同任務上可能得出相反的答案。
適合開啓 Ultrafast 的場景
- 人在屏幕前等結果的交互任務:例如實時結對編程、現場演示。等待的時間直接是人力成本,按上面的公式,單價通常能夠覆蓋。
- 生成佔牆鍾比例高的任務:如果 T 佔整次任務耗時的大部分,節省的時間能直接體現在交付時間上。
- 促銷期內的短上下文任務:3 倍價格配合短上下文的低單價,額外支出的絕對金額較小。
更適合留在標準檔的場景
- 後臺批處理、夜間任務:沒有人在等待,節省的分鐘數沒有對應的時間價值。
- 工具調用密集的 Agent 任務:類似前面那條轉述記錄,牆鍾 27 分鐘中模型響應只佔約 14 分鐘,速度檔只能壓縮其中一部分。
- 長上下文、大輸出任務:刊例期長上下文輸出單價達到 90,額外支出增長很快。
| 任務特徵 | 生成時間佔比 | 有人等待 | 傾向 |
|---|---|---|---|
| 交互式編碼、現場演示 | 高 | 是 | 先按算法計算,單價通常可以覆蓋 |
| 工具密集型 Agent | 中低 | 視情況 | 只按生成部分計算,收益會被稀釋 |
| 夜間批處理 | 高 | 否 | 留在標準檔 |
| 長上下文大輸出 | 高 | 視情況 | 刊例期需要謹慎計算 |
💡 選擇建議:如果同一個項目裏兩類任務都有,可以在代碼中按任務類型決定是否帶上
service_tier,不必全局開啓。通過 API易 apiyi.com 用同一個 Key 跑標準檔基線,再決定哪類任務值得進一步測試速度檔。
GPT-6.2 Sol Ultrafast 決策建議
把前面的內容整理成一套固定流程:
- 用標準檔跑真實任務,記下生成耗時 T 和 tokens 用量,不使用別人的速度數字。
- 用官方上限 4.5 算出最好情況,再選一個你認爲合理的保守倍數 r,兩種情況都算出來。
- 分別按促銷 3 倍和刊例 6 倍計算額外支出,得到兩個“每分鐘價格”。
- 和你的時間價值比較:在保守倍數下仍然划算的,纔是值得開啓的任務。
- 2027-03-01 刊例價生效前,用新價格重新計算一遍。
這套流程的關鍵是第 2 步。官方的“最高 4.5 倍”可以作爲上限,而 2026-11-18 那條約 126 token/秒的轉述只是一個單次數據點,兩者都不是你這次任務的實際倍數。實際倍數只能通過在自己的任務上做對照測試獲得。
常見問題 FAQ
Q1:GPT-6.2 Sol Ultrafast 是一個新模型嗎?
不是。按官方 API 文檔,Ultrafast 是服務檔,請求中的 `model` 仍爲 `gpt-6.2-sol`,另外加上 `service_tier` 並設爲 `ultrafast`,模型本身不變。
Q2:開了 Ultrafast 是否一定能達到 4.5 倍?
不一定。官方原文是 “up to 4.5 times”,屬於上限說法。計算時應同時準備一個更低的保守倍數,並以自己的對照測試爲準。
Q3:GPT-6.2 Sol Ultrafast 的促銷價什麼時候結束?
官方促銷價持續到 2027-02-28(太平洋時間),價格爲標準價的 3 倍;2027-03-01 起執行刊例價,爲標準價的 6 倍。短上下文和長上下文都遵循這個倍數關係。
Q4:那條約 126 token/秒的記錄能參考嗎?
可以作爲一個數據點,但不能當作結論。它是 OrcaRouter 在 2026-11-18 轉述的一次任務,沒有重複運行,也沒有同一任務的標準檔對照;文中約 1.5 倍的說法,是拿 Artificial Analysis 公佈的標準檔 85 token/秒對比得出的。
Q5:在 API易 上看到的 gpt-6.2-sol 價格是哪一檔?
是標準檔。API易 apiyi.com 總表中 `gpt-6.2-sol` 的標價爲輸入 2、緩存讀 0.1、輸出 10,與官方標準檔短上下文一致,支持 responses 和 chat 端點。總表中沒有單獨的 ultrafast 型號,也沒有寫出 `service_tier`。
Q6:超過 27.2 萬輸入 tokens 時,標準檔按多少計算?
兩個來源的數字不同,需要分開計算:API易 總表寫的是超過 27.2 萬輸入爲 3 美元,官方標準檔長上下文輸入爲 4 美元。通過 https://api.apiyi.com/v1 調用時按平臺型號列表計算,直連官方按 4 美元計算。
GPT-6.2 Sol Ultrafast 速度溢價核心要點 Key Takeaways
- Ultrafast 是服務檔:同一模型 ID
gpt-6.2-sol加上service_tier即可,模型能力不變。 - 4.5 倍是官方上限:原文爲 up to,計算時不能把它當作每次都能達到的倍數。
- 價格分兩段:促銷期爲標準價的 3 倍,2027-03-01 起刊例價爲 6 倍。
- 只有生成時間會變快:工具調用等非生成時間不計入可節省的部分。
- 單次轉述不能代表結果:2026-11-18 約 126 token/秒的記錄沒有標準檔對照。
- 先測自己的標準檔:可以用 API易 apiyi.com 的標準檔
gpt-6.2-sol測出 T,再代入算法。
總結
GPT-6.2 Sol Ultrafast 速度溢價的計算,可以歸納爲三點:
- 速度取上限和保守兩個值:官方最高 4.5 倍放在最好情況,自定的保守倍數放在另一欄。
- 價格分開計算:促銷期額外支出爲標準費用的 2 倍,刊例期爲 5 倍,兩套結論不能混用。
- 結論按任務決定:每省 1 分鐘的價格低於你的時間價值,才說明這次任務適合開啓速度檔。
標題裏的問題,答案取決於你自己的任務數據。建議先在 API易 apiyi.com 用標準檔測出基線,再把數字代入本文的算法表。
📚 參考資料
-
OpenAI Codex 速度檔說明:Ultrafast 最高 4.5 倍的官方說法
- 鏈接:
developers.openai.com/codex/agent-configuration/speed - 說明:確認 “up to 4.5 times” 的原文和適用模型
- 鏈接:
-
OpenAI Ultrafast 模式 API 指南:
service_tier的用法與支持模型- 鏈接:
developers.openai.com/api/docs/guides/ultrafast-mode - 說明:確認 Ultrafast 是服務檔,
model不變
- 鏈接:
-
OpenAI API 定價頁:標準檔、Fast、Ultrafast 促銷價與刊例價
- 鏈接:
developers.openai.com/api/docs/pricing - 說明:短上下文與長上下文的完整價格
- 鏈接:
-
OrcaRouter 轉述記錄:2026-11-18 的單次 Ultrafast 任務數據
- 鏈接:
orcarouter.ai/blog/gpt-6-2-sol-ultrafast-tokens-per-second - 說明:單次、無對照的轉述,只能作爲一個數據點
- 鏈接:
-
API易 模型總表:
gpt-6.2-sol標準檔標價與階梯- 鏈接:
docs.apiyi.com/models.md - 說明:覈對標準檔單價和超過 27.2 萬輸入的價格
- 鏈接:
作者:APIYI 技術團隊
技術交流:如有計算或接入問題,歡迎通過 API易 官網首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心


