
直接回答:OpenAI Batch API 適合“結果可以晚一點拿到、彼此獨立、批量很大”的任務。 它的價格是同步 API 的一半,並且使用獨立的限速池。它的約束是 24 小時處理窗口,而且這個窗口不保證在某個具體時點交付結果。既定規則的分類、知識庫加工、模型評測這類離線工作,可以優先考慮 Batch。實時客服、需要即時回覆的交互,以及前一步結果決定後一步內容的依賴流程,不應交給 Batch API。
您讀完此文能瞭解到什麼?
- OpenAI Batch API 的核心規則:折扣、限速、窗口、文件格式和數量上限。
- 提交成功、生成成功和按時交付這三件事之間的區別。
- 批次過期後如何計費,以及如何只補跑失敗的請求。
- 五折具體省下哪部分成本,哪些成本不會跟着減半。
- 判斷一項任務是否適合 Batch 的實用方法。
索引: 正文前先用一張概念表和一份影響速覽幫你建立基礎認知。「客觀事實」部分逐條整理官方文檔中的規則;「分析判斷」部分討論這些規則對任務選型、成本測算和工程設計意味着什麼,並給出適合與不適合的任務類型。
需要說明的是,本文依據的是 OpenAI 官方持續維護的 Batch 指南,於 2026-11-17 覈查。這份文檔沒有明確的首發日期,所以本文不把它當作當日發佈的新功能,而是對一項現有能力的規則解讀。
To Know:理解 OpenAI Batch API 的關鍵概念
| 概念 | 簡要解釋 |
|---|---|
| 同步 API | 發出請求後即時等待並返回結果的常規調用方式 |
| Batch API | 一次提交大量請求、異步處理、稍後統一取回結果的接口 |
| JSONL | 每一行是一個獨立 JSON 對象的文本格式,Batch 中每行對應一個請求 |
| custom_id | 你爲每條請求設定的唯一標識,用來把輸出結果對應回原始請求 |
| 獨立限速池 | Batch 請求的速率限制與同步請求分開計算,彼此不互相擠佔 |
| 24 小時處理窗口 | 批次的處理時限;超時後未完成的請求會被取消 |
| 過期批次 | 超過處理窗口仍未全部完成的批次 |
OpenAI Batch API 影響速覽
- 開發者: 離線批量任務的 API 費用可以按同步價格的一半來估算,同時不會佔用線上服務的同步限速額度。但需要自己實現 custom_id 匹配、失敗重提和結果校驗。
- 內容與數據團隊: 大批量的分類、摘要、知識庫清洗等工作更划算。代價是放棄“當場出結果”,交付時間要留出餘量。
- 評測與研究人員: 大規模跑測試集非常適合 Batch。不過需要注意,單個文件只能使用一個模型,多模型對比要拆成多個文件。
- 產品與運營負責人: 不能把“24 小時”理解爲“明早一定交稿”。對外承諾時效時,應當把 Batch 視爲盡力而爲的通道。
OpenAI Batch API 客觀事實
Batch API 的計費與限速規則
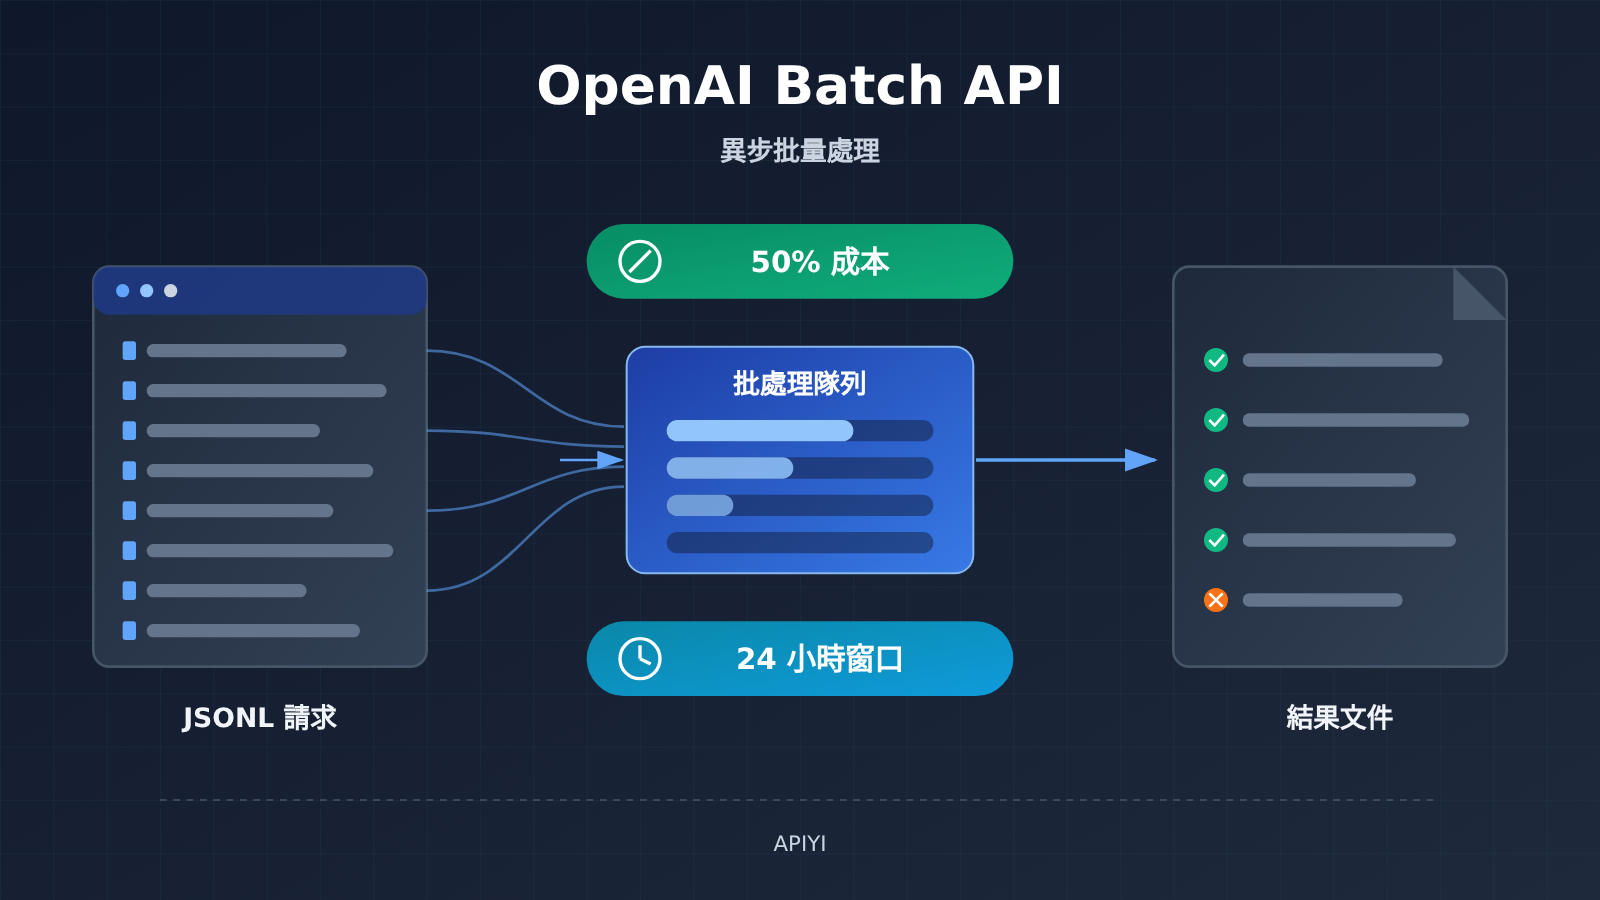
根據官方 Batch 指南(OpenAI 官方文檔: developers.openai.com/api/docs/guides/batch),Batch API 有三項核心特性:
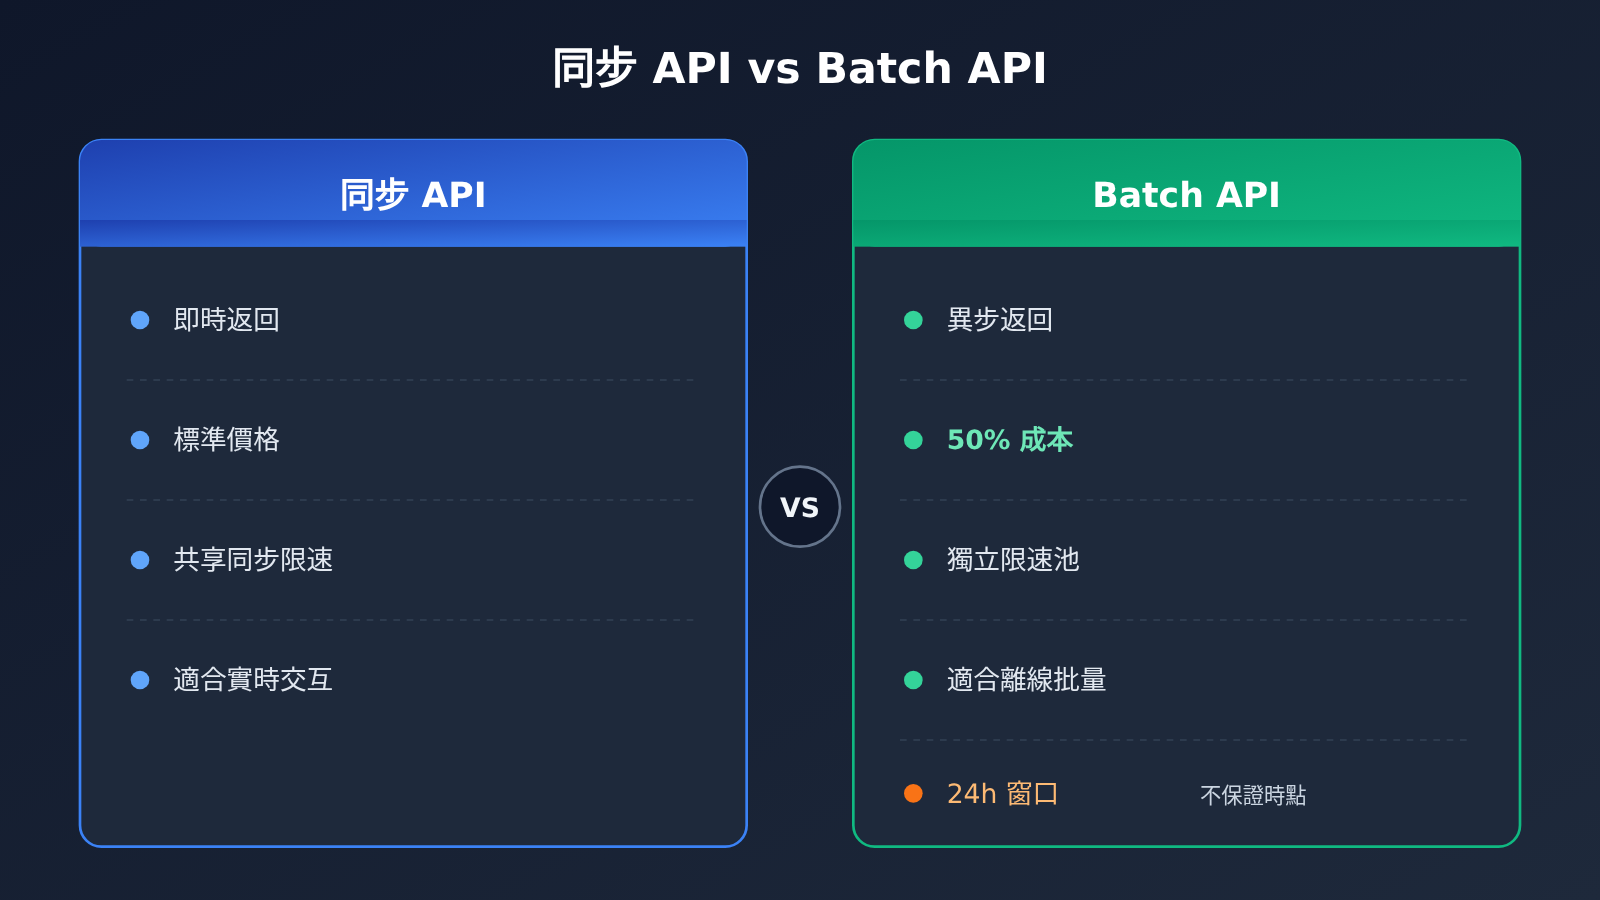
- 成本折扣: 相比同步 API 提供 50% 的成本折扣。
- 獨立限速: 使用獨立的限速池,不與同步請求共享額度。
- 處理窗口: 批次在 24 小時窗口內完成處理。
支持哪些模型和端點,以官方文檔列出的範圍爲準。目前不能籠統地說“所有模型都支持 Batch”。
Batch API 的文件格式與數量上限
| 規則項 | 官方要求 | 實際含義 |
|---|---|---|
| 文件格式 | JSONL,每行一個請求 | 一行就是一個獨立任務 |
| 請求標識 | 每條請求有唯一 custom_id | 結果回收全靠它來匹配 |
| 模型約束 | 單個文件只能用一個模型 | 多模型任務需要拆成多個文件 |
| 數量上限 | 單批最多 50,000 個請求 | 超過上限要分批提交 |
| 體積上限 | 單批文件最大 200MB | 長上下文任務可能先觸及體積上限 |
| 輸出順序 | 不保證與輸入順序一致 | 不能按行號對應結果 |
下面是一條請求行的示意結構,用於說明 custom_id 的位置。具體端點和參數以官方文檔的支持列表爲準:
{"custom_id": "article-001", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "MODEL_NAME", "messages": [{"role": "user", "content": "爲以下主題寫一段摘要:..."}]}}
Batch API 的過期與計費規則
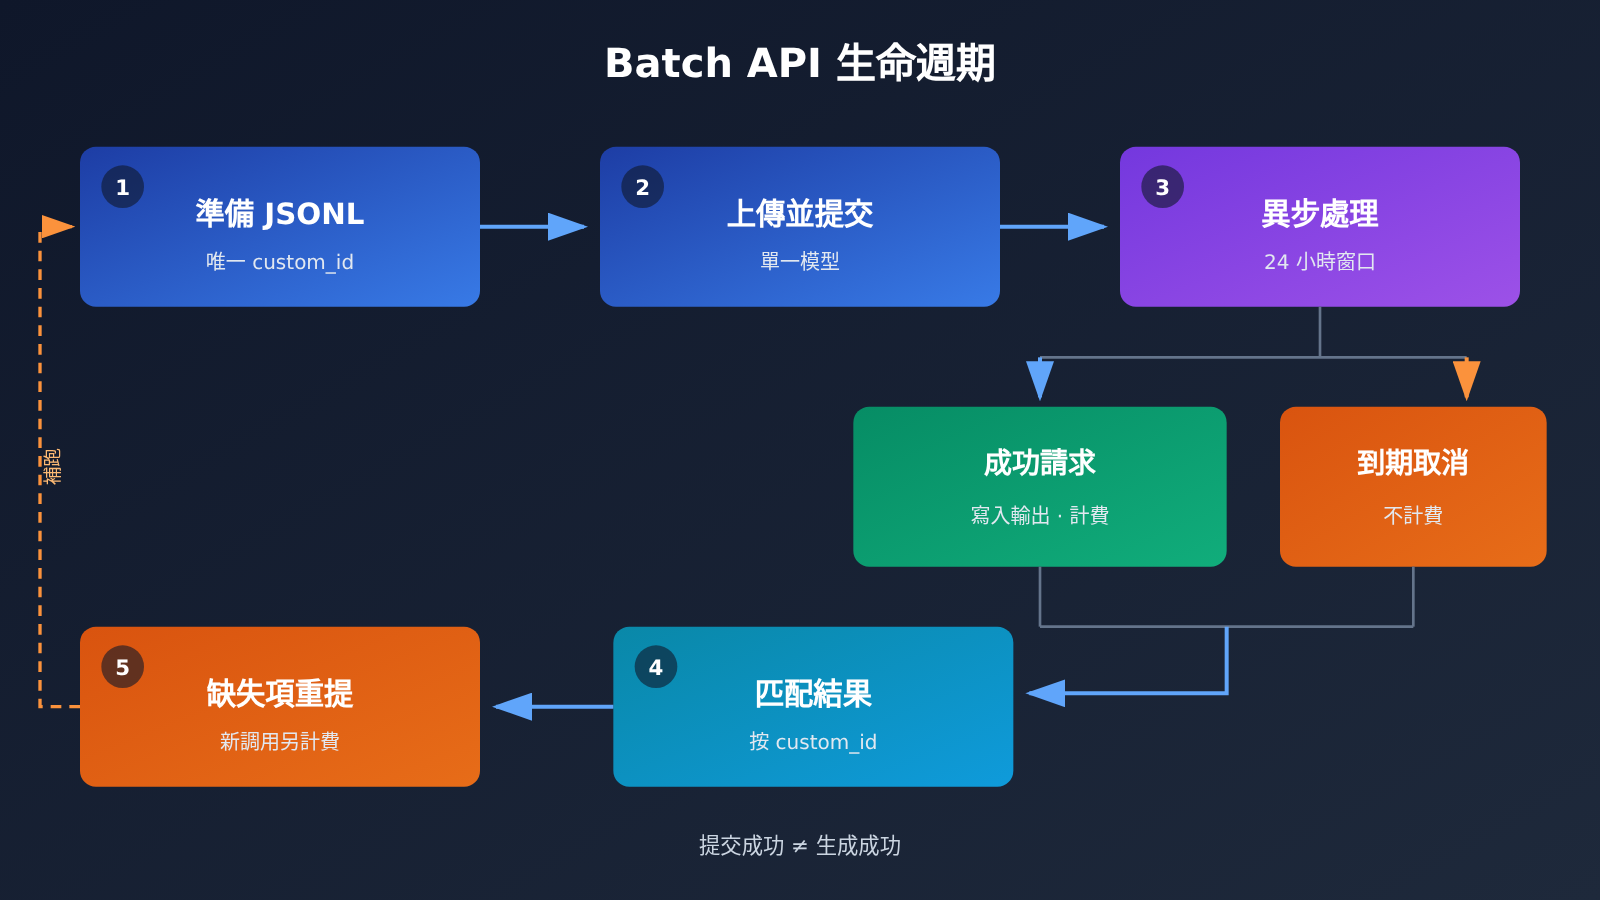
如果批次超過處理窗口,其中尚未完成的請求會被取消。已經成功的結果仍然可以下載,計費只針對成功的請求。
文檔同時提醒了一點:提交成功不等於生成成功。 批次被接收,只代表進入了處理流程,不代表每一行都會產出結果。24 小時窗口也不是“明早某個時點交稿”的承諾。
OpenAI Batch API 分析判斷
五折省的是哪部分錢
“五折”針對的是 Batch 處理本身的模型調用費用。下面用一個設計示例說明,數字不是實測數據。
假設某項任務按同步請求計費爲 100 元,那麼相同請求走 Batch 的示意費用是 50 元。整個項目的總成本卻未必減半,因爲有幾類成本不會自動打折:
| 成本項 | 是否隨 Batch 五折 | 說明 |
|---|---|---|
| 批處理請求的模型調用費 | 是 | 示意:同步 100 元對應 Batch 50 元 |
| 前置研究所用的工具調用 | 否 | 例如先檢索、調研再確定寫什麼 |
| 人工審覈 | 否 | 人力成本與計費方式無關 |
| 額外重試 | 否,需另行計算 | 失敗或過期後補跑會產生新的調用 |
| 工程開發與維護 | 否 | 文件生成、結果匹配、重提邏輯需要投入 |
所以做預算時,應把五折只套在“可批處理的那部分調用”上,不要直接把項目總預算砍一半。如果一個項目裏研究和審覈佔比很高,Batch 帶來的整體節省會明顯小於 50%。
24 小時窗口應該怎樣理解
24 小時窗口描述的是處理時限,不是交付承諾。比較穩妥的做法是:把 Batch 結果當作“窗口期內大概率可得,但可能部分缺失”的產出,並在排期裏爲補跑留出時間。
如果業務方要求“明天上午 9 點前必須拿到全部結果”,那麼只靠一次 Batch 提交是有風險的。對時效要求剛性的任務,可以提前提交、預留補跑窗口,或者把關鍵部分改走同步請求。
custom_id 是 Batch 工程設計的核心
由於輸出不保證順序,結果回收必須完全依賴 custom_id。這就要求 custom_id 在設計階段就有業務含義,並且全局唯一,比如“任務類型-批次號-序號”。
下面這個設計示例同樣不是實測:要生成 20 篇同一模型、彼此獨立的文章,可以寫成 20 行 JSONL。如果最終 18 篇成功、2 篇因過期被取消,只需通過 custom_id 找出缺失的 2 篇重新提交,不必把 20 篇全部重跑。已成功的 18 篇按成功請求計費,被取消的 2 篇不計費。
這個流程的關鍵點可以歸納爲:
- 提交前校驗每行 custom_id 是否唯一。
- 結果回收後,用輸入 custom_id 集合減去輸出 custom_id 集合,得到缺失清單。
- 只針對缺失清單生成新的 JSONL 再提交。
- 補跑產生的是新的調用費用,要計入預算。
多模型和依賴流程要拆開處理
單個文件只能使用一個模型。如果同一個項目想讓 A 模型做分類、B 模型做摘要,就要分別準備兩個文件,各自提交、各自回收。
更值得注意的是依賴關係。如果流程是“先研究資料,再根據研究結論決定寫什麼”,第二步依賴第一步的輸出,那麼 Batch 不會替你自動編排這兩步。你需要在第一批結果回收後,由自己的程序生成第二批請求再提交。這也意味着整條鏈路的總耗時可能疊加多個處理窗口。
哪些任務適合 OpenAI Batch API
| 任務類型 | 是否適合 Batch | 理由 |
|---|---|---|
| 按既定規則的批量分類 | 適合 | 規則固定、條目獨立、不急於實時返回 |
| 知識庫加工(摘要、清洗、結構化) | 適合 | 數據量大,可離線完成 |
| 模型評測、測試集批量推理 | 適合 | 天然批量,對時效不敏感 |
| 同模型獨立內容批量生成 | 適合 | 每行獨立,失敗可按 custom_id 補跑 |
| 實時客服、對話交互 | 不適合 | 用戶需要即時回覆,應使用同步等方式 |
| 有嚴格交付時點的任務 | 謹慎 | 24 小時窗口不保證具體時點 |
| 先研究再決定內容的多步流程 | 需自行編排 | Batch 不自動處理步驟間依賴 |
一個簡單的判斷方法是連問三個問題:結果能不能晚一點拿到?每條請求是否彼此獨立?量是否大到值得寫文件和回收邏輯?三個答案都是“是”,Batch 通常就是更划算的選擇。只要有一個答案是“否”,就要先拆分任務,或者保留同步調用。
後續值得關注的變化
由於這是一份持續維護的官方文檔,支持的模型與端點範圍、數量和體積上限都可能調整。以下判斷屬於預測:隨着更多模型和端點被納入 Batch,離線評測和數據加工類工作流會更多地默認採用批處理。實際接入時,仍應以屆時文檔列出的規則爲準,不要直接沿用本文覈查日的數值。
Batch API 的價值,在於讓人想清楚哪些事可以等。願意等的任務換來一半的價格和不受打擾的限速額度;必須立刻得到回應的任務,則繼續交給同步請求。
「無慾速,無見小利。欲速則不達,見小利則大事不成。」——《論語·子路》


