
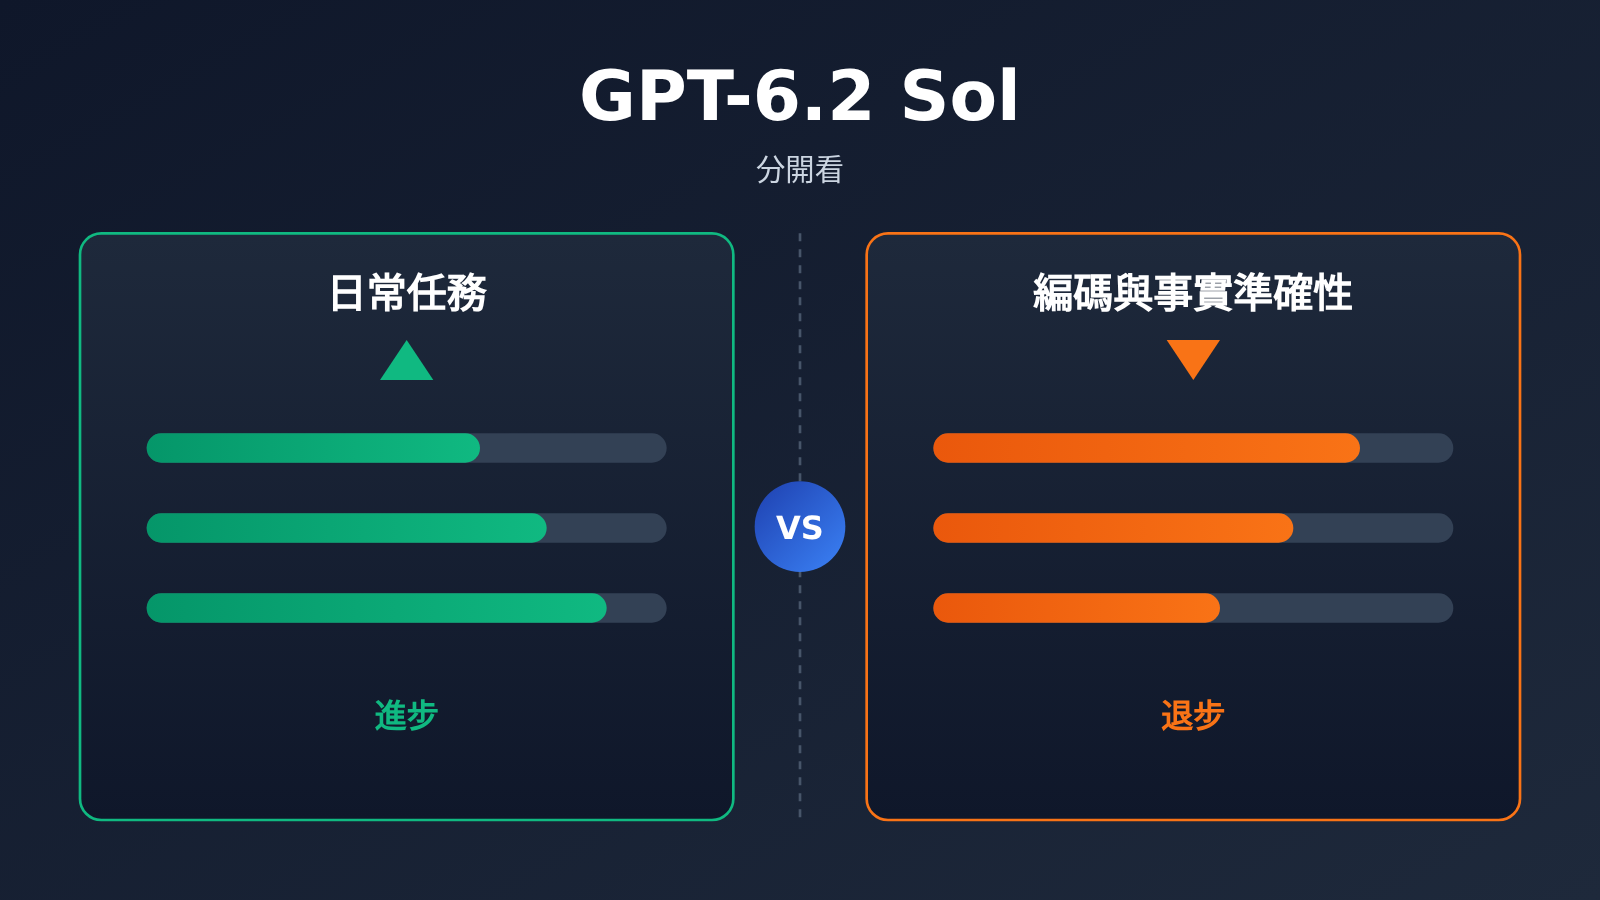
作者注:拆開看 GPT-6.2 Sol 的官方自報成績和第三方綜合分,講清它在日常任務上的進步、在編碼代理和事實準確性上的退步,以及標價、計價規則與選型建議。
OpenAI 在 2026-11-17 同時發佈了 GPT-6.2 Astra 和 GPT-6.2 Sol。其中 GPT-6.2 Sol 沿用 GPT-6.1 Sol 的 API 標價,日常任務成績卻明顯往上走,很多人會順手把它設成默認模型。官方發佈文、系統卡和模型頁已經同步上線,Artificial Analysis 也在當天給出了第三方綜合分,這不是坊間傳言。
這不是一篇把官方跑分復讀一遍的稿子。 本文把數字分成官方自報和第三方兩套,各說各的,不加成一個結論。GPT-6.2 Sol 的日常任務和編碼要分開看:前者確實在進步,後者有一項第三方指標比上一代低了 3 分。
核心價值:讀完本文,你能判斷 GPT-6.2 Sol 適不適合當默認模型,也能知道哪些場景不能只看綜合分。
GPT-6.2 Sol 核心要點
先給一張速讀表,下文再逐項展開。表裏每一行都註明了數字來源,官方自報和第三方結果分開寫。
| 要點 | 說明 | 數據來源 |
|---|---|---|
| 日常任務 | LifeVal 得分高於 GPT-6 Astra,成本約七分之一 | 官方自報 |
| 代碼合併 | FrontierCode 2.0 與 GPT-6.2 Astra 相差不到 0.5 分,成本約五分之一,雙方都是 Max | 官方自報 |
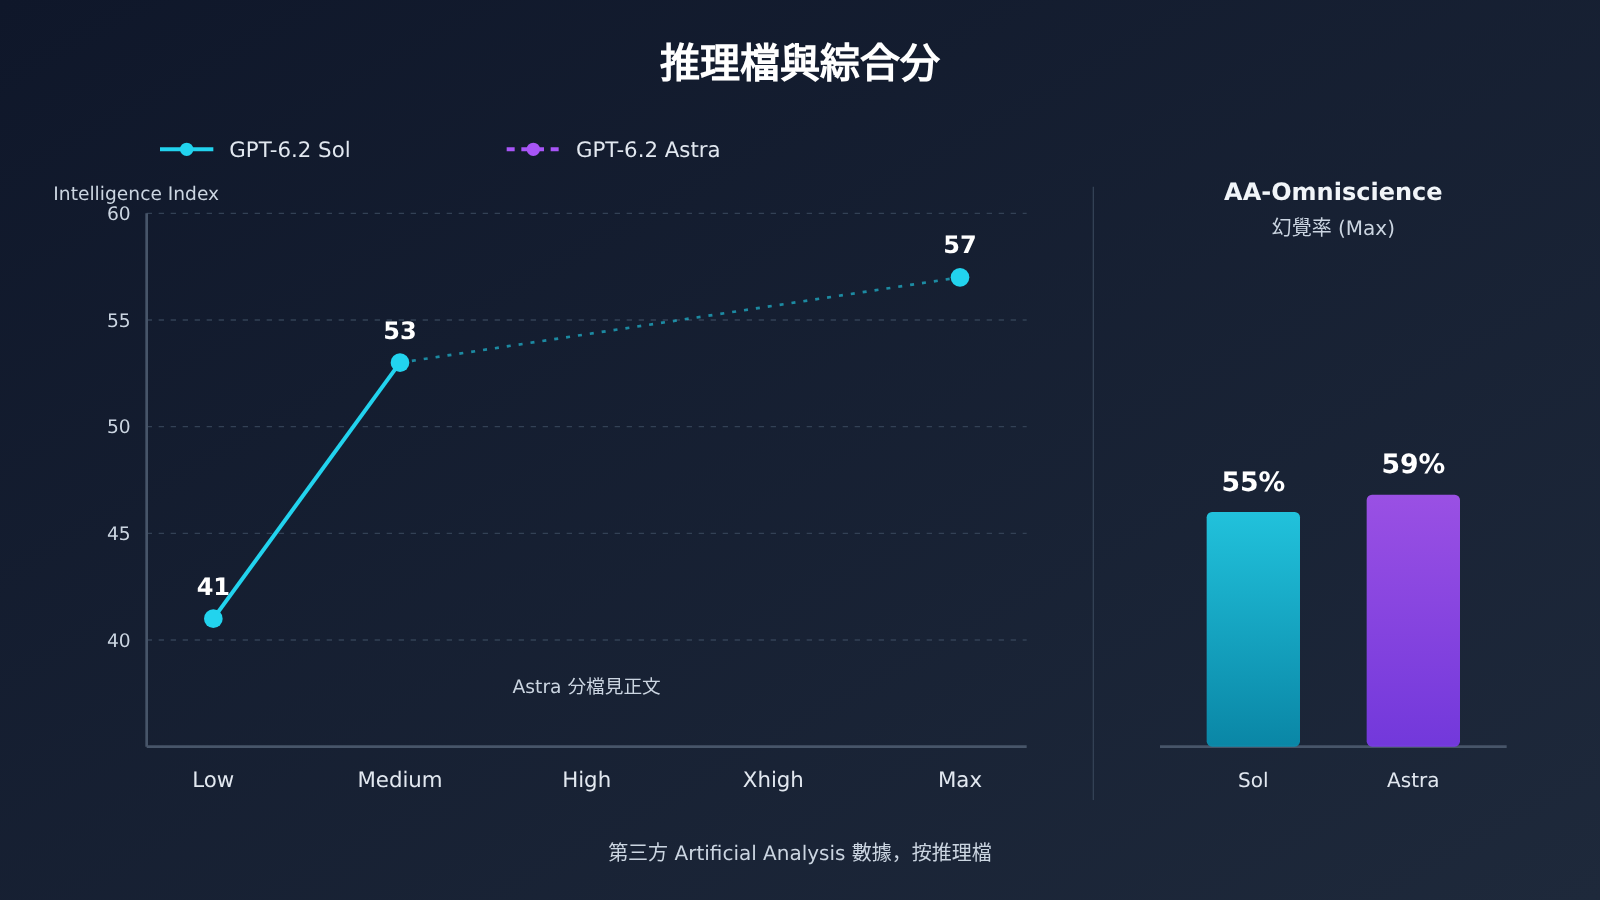
| 綜合分 | Intelligence Index v5.0.1:Max 57、Xhigh 56、High 55、Medium 53、Low 41 | 第三方 Artificial Analysis |
| 編碼代理 | Coding Agent Index 比 GPT-6.1 Sol 低 3 分,更容易漏掉關鍵事實 | 第三方 Artificial Analysis |
| 幻覺率 | AA-Omniscience 幻覺率(Max)爲 55% | 第三方 Artificial Analysis |
| 標價 | 與 GPT-6.1 Sol 相同,輸入 $2、輸出 $10(每 100 萬 token) | OpenAI 官方 |
GPT-6.2 Sol 重點詳解
GPT-6.2 Sol 這一代最大的看點,是“同樣的價格,日常工作做得更好”。官方自報的 LifeVal 和 GDPval v2 都指向同一個方向:Sol 在日常辦公類任務上的表現已經超過了上一代旗艦 GPT-6 Astra,成本卻低很多。對把它當默認模型的人來說,這部分進步最容易感知到。
另一面同樣要講清楚。第三方 Artificial Analysis 的 Coding Agent Index 顯示,GPT-6.2 Sol 比 GPT-6.1 Sol 低 3 分,主要拖累來自一個考查代碼庫問答的子項。AA-Omniscience 的幻覺率也有 55%。所以“綜合分漲了”不等於“每件事都更穩”,尤其是漏一個事實就要返工的場景。
GPT-6.2 Sol 核心功能與規格
GPT-6.2 Sol 的型號 ID 是 gpt-6.2-sol,輸入支持文本和圖像,輸出只有文本,不支持音頻和視頻。上下文窗口 1,050,000 token,最大輸入 922,000,最大輸出 128,000,知識截止 2026-06-01,比 Astra 的 2026-05-18 稍晚。API 不允許把 reasoning effort 設爲 none,最低只能用 Low 檔。
下表對照 Sol 和 Astra 的官方規格與標價,價格是短上下文標準檔、每 100 萬 token。查平臺在架情況時,我們覈對了 API易 apiyi.com 的型號總表(數據時間 2026-11-17 15:54,UTC+8)和公開定價接口,兩款 6.2 都還沒有出現。
| 項目 | gpt-6.2-sol | gpt-6.2-astra |
|---|---|---|
| 輸入 / 緩存讀 / 輸出 | $2 / $0.10 / $10 | $8 / $0.40 / $40 |
| 緩存寫入(30 分鐘 / 12 小時) | $2.50 / $5 | $10 / $20 |
| 上下文 / 最大輸出 | 1,050,000 / 128,000 | 1,050,000 / 128,000 |
| 知識截止 | 2026-06-01 | 2026-05-18 |
| 價格變化 | 沿用 GPT-6.1 Sol 標價 | 輸入輸出比 GPT-6 Astra 低 20%,緩存輸入低 60% |
| 可用平臺 | OpenAI API;API易 apiyi.com 暫未上架 | OpenAI API;API易 apiyi.com 暫未上架 |
以上是 OpenAI 官方標價。gpt-6.2-sol 和 gpt-6.2-astra 在 API易:暫未上架,我們會盡快上架這個模型;型號與價格以平臺型號列表爲準。
GPT-6.2 Sol 的計價規則
模型頁寫了幾條兩款通用的計價規則,賬單差異主要出在這裏:
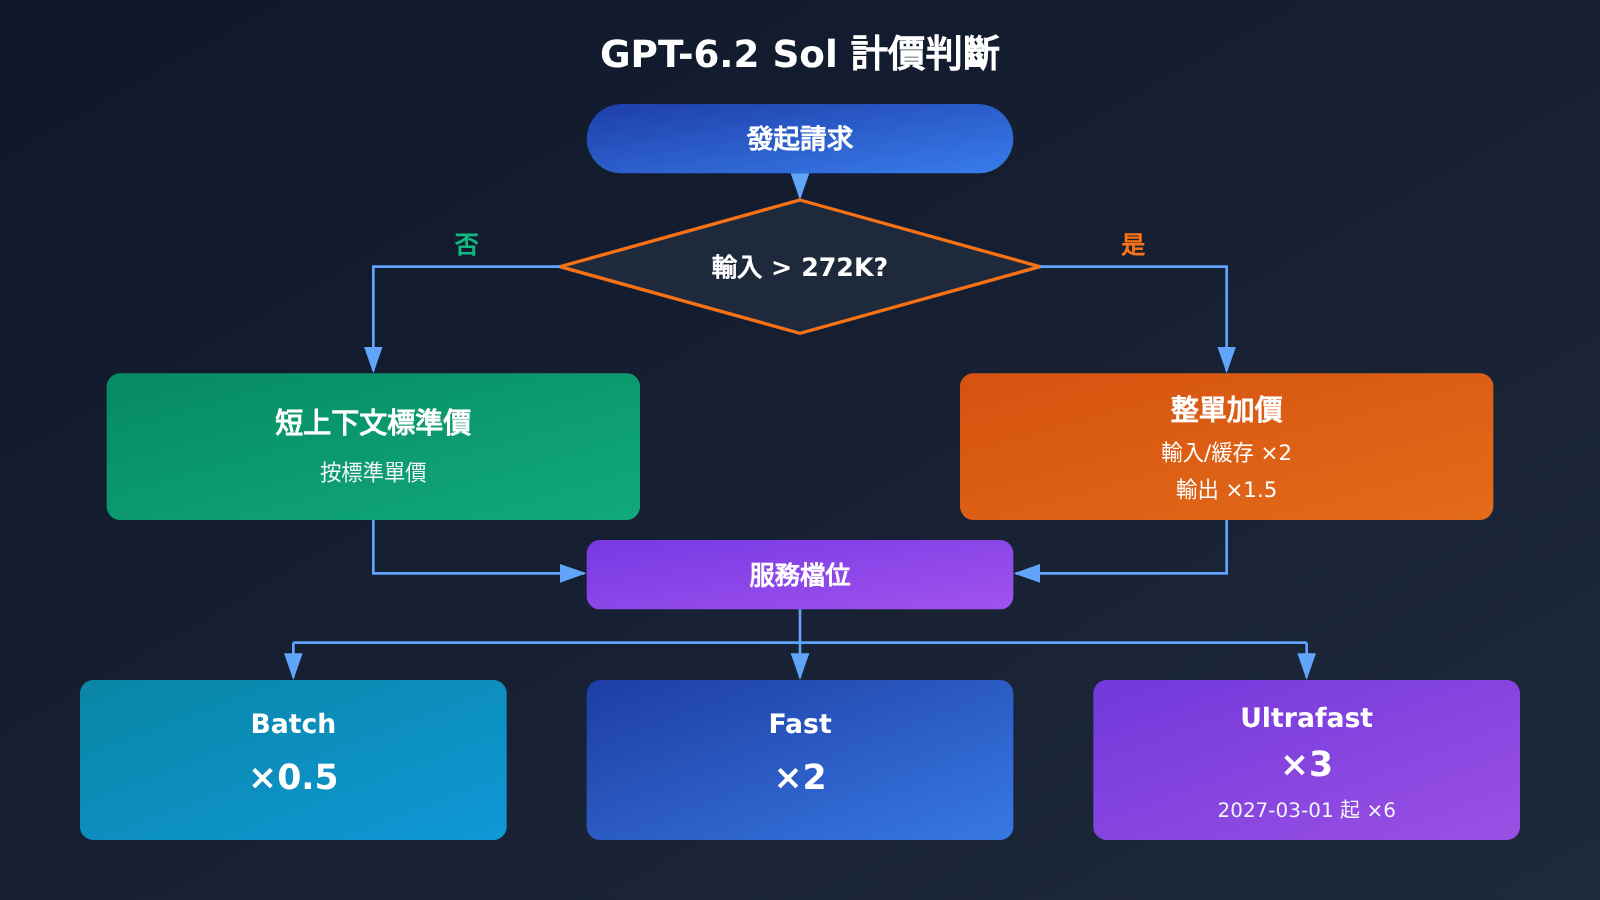
- 長輸入整單加價:單次請求輸入超過 272K token 時,輸入和緩存單價翻倍,輸出按短上下文的 1.5 倍,並且是整單按這個價格計算,不是隻算超出部分。
- Batch:標準價的 50%。
- Fast:同一上下文長度標準價的 2 倍。
- Ultrafast:到 2027-02-28(太平洋時間)爲標準價的 3 倍,2027-03-01 起變爲 6 倍。
端點方面,Chat Completions、Responses 和 Batch 都支持,Realtime、Assistants、微調、圖像生成、視頻和語音都不支持。也就是說,GPT-6.2 Sol 是一個純文本輸出的對話與推理模型,接入方式和上一代基本一致。
GPT-6.2 Sol 評測數據:日常任務
這一節只用官方自報數字。OpenAI 發佈文裏給 Sol 的日常任務成績主要有兩項,下表把它們和編碼項一起列出,方便對照,但請注意它們都是官方自己測、自己報的。
| 評測 | 類別 | GPT-6.2 Sol 結果 | 來源 |
|---|---|---|---|
| LifeVal | 日常任務(官方自建) | 高於 GPT-6 Astra,成本約七分之一 | 官方自報 |
| GDPval v2 | 職業工作任務(官方內部) | 比 GPT-6.1 Sol 高 5.3 分 | 官方自報 |
| FrontierCode 2.0 | 真實代碼庫改動能否被合併 | 與 GPT-6.2 Astra 相差不到 0.5 分,成本約五分之一,雙方 Max | 官方自報 |
| AA-3D | 人工盲評 Elo | 1259(Astra 1318,Claude Fable 5.2 1271) | 官方轉述 |
LifeVal 是 OpenAI 自建的日常任務集,發佈文的說法是 Sol 得分高於 GPT-6 Astra,成本約爲後者的七分之一。GDPval v2 是官方內部評測,Sol 比 GPT-6.1 Sol 高 5.3 分。兩項都沒有公開絕對分,本文也不去推算。
這兩項說明了一件事:在寫郵件、整理資料、做表格、起草文檔這類日常工作上,GPT-6.2 Sol 用的是 Sol 的價格,交出的是接近甚至超過上一代旗艦的結果。但“官方自建的評測集”天然更貼合自家模型,讀者把它當成方向性信號更穩妥。
GPT-6.2 Sol 評測數據:編碼
編碼這一塊最需要分開看,因爲官方自報和第三方給出的方向並不一致。兩者測的任務也不一樣,下面分開說,不合併成一個判斷。
官方自報:FrontierCode 2.0
FrontierCode 2.0 由 Cognition 構建,考的是模型在真實代碼庫裏做的改動能不能被維護者合併。官方自報 GPT-6.2 Sol 與 GPT-6.2 Astra 相差不到 0.5 分,成本約五分之一,比較時雙方都用 Max 推理檔。這個結果對“小步改代碼、提交 PR”類工作是個好消息。
第三方:Coding Agent Index
Artificial Analysis 的 Coding Agent Index 使用 Codex harness、Max 推理檔。結果是 Astra 與 GPT-6 Astra 持平,而 GPT-6.2 Sol 比 GPT-6.1 Sol 低 3 分。文章給出的主因是 SWE-Atlas-QnA-AA 這一子項低了 14 分,模型更容易漏掉關鍵事實。
把兩者放在一起看就清楚了:FrontierCode 2.0 衡量“改動能不能合進去”,SWE-Atlas-QnA-AA 偏向“對代碼庫的問題能不能答全”。GPT-6.2 Sol 在前者上接近 Astra,在後者上比自家上一代還退了一步。如果你的編碼代理要大量回答“這個函數在哪被調用”“這個配置影響哪些模塊”這類問題,就不能只看 FrontierCode。
GPT-6.2 Sol 第三方綜合分與幻覺率
Artificial Analysis 的 Intelligence Index v5.0.1 按推理檔分別打分。下表全部是第三方數字,每一格都對應一個推理檔,不要拿 Sol 的 Max 去和別人的 Medium 比。
| 推理檔 | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Max | 57 | 62 |
| Xhigh | 56 | 62 |
| High | 55 | 60 |
| Medium | 53 | 57 |
| Low | 41 | 46 |
| 綜合指數單任務成本(Max) | $1.01 | $4.00 |
同一篇文章裏,Claude Fable 5.2 最高檔 65 排第一,Gemini 4 Carbon 最高檔 60,Claude Opus 5.5 最高檔 59。GPT-6.2 Sol 的 Max 57 比 GPT-6.1 Sol 高 2 分,與 GPT-6 Astra 持平,單任務成本約後者的 15%。所以 Sol 並沒有全面強過 Astra,它強在“用更低成本追平了上一代旗艦”。
推理檔的落差也值得注意。Sol 從 Medium 的 53 到 Low 的 41 掉了 12 分,而 API 又不允許關掉推理,Low 已經是最低檔。日常默認如果爲了省錢壓到 Low,得到的就不是 57 分那個模型了。
GPT-6.2 Sol 的幻覺率
AA-Omniscience 幻覺率(Max)上,GPT-6.2 Sol 爲 55%,Astra 爲 59%。Sol 的數字略低一些,但兩者都在一半以上,這意味着在模型不確定的時候,它仍有相當高的傾向給出看似確定的錯誤答案。結合上面 SWE-Atlas-QnA-AA 低 14 分的結果,事實敏感型問答需要額外的檢索或覈對環節。
GPT-6.2 Sol 安全分級與可用範圍
按 OpenAI 準備框架,GPT-6.2 Sol 和 Astra 都達到了網絡安全“嚴重”級,生物和化學爲“高”級。官方提到達到“AI 自我改進”高閾值的只有 Astra,沒有寫給 Sol。對應地,防護變得更嚴,一部分合法的漏洞研究請求也會被拒絕,做安全工作的讀者要有心理準備。
面向防禦方的 Daybreak 項目目前提供的是 GPT-6 Astra 的 Alpha、Daybreak Blue 上的 GPT-6 Sol 和 Daybreak Red 上的 GPT-6 Cyber。官方表示會努力把 6.2 引進 Daybreak,但現在還沒有。對齊方面,多數評估與 GPT-6 Astra 接近,模擬職場裏的不當行動更少;不過有兩項測試顯示它更容易漏報擋路的問題,比如文件缺失、搜索工具不可用,Codex 里加了指令後這類遺漏明顯減少。
可用範圍上,Plus、Pro、Enterprise、Edu 即日起可在 ChatGPT Work 和 Codex 使用。Pro 500 可爲兩款開啓 Ultrafast,Pro 200 首次獲得 Ultrafast,先從 GPT-6.2 Sol 開始;符合條件的 Enterprise、Edu 需要工作區管理員打開。開發者走 OpenAI API,兩款發佈時都支持 Ultrafast。
GPT-6.2 Sol 優缺點分析
優勢
- 日常任務性價比高:官方自報 LifeVal 高於 GPT-6 Astra、成本約七分之一,GDPval v2 比 GPT-6.1 Sol 高 5.3 分。
- 價格不變:標價與 GPT-6.1 Sol 相同,升級不增加單價。
- 代碼合併能力接近 Astra:官方自報 FrontierCode 2.0 與 Astra 相差不到 0.5 分,成本約五分之一。
- 綜合分追平上一代旗艦:第三方 Max 57,與 GPT-6 Astra 持平,單任務成本約其 15%。
侷限
- 編碼代理退步:第三方 Coding Agent Index 比 GPT-6.1 Sol 低 3 分,SWE-Atlas-QnA-AA 低 14 分。解決思路是給代碼庫問答加檢索和交叉覈對。
- 幻覺率偏高:AA-Omniscience 幻覺率 55%,事實敏感任務要有引用或人工複覈。
- 低推理檔掉分明顯:Low 檔只有 41,又不能關閉推理,壓成本時要權衡。
- 安全防護更嚴:部分合法漏洞研究會被拒絕,Daybreak 暫無 6.2。
GPT-6.2 Sol 快速上手
GPT-6.2 Sol 的接入方式和上一代一致,走 Chat Completions 或 Responses 都可以,型號名填 gpt-6.2-sol,推理檔從 Low 到 Max 選一個,不要傳 none。如果你已經在用 OpenAI 兼容接口,換型號通常只是改一個參數的事。
等它在 API易 上架後,把 OpenAI SDK 的 base_url 設爲 https://api.apiyi.com/v1,填入 API易 的 Key,再把 model 改成 gpt-6.2-sol 即可,型號名以平臺型號列表爲準。在此之前,平臺上已在架的 gpt-6.1-sol 標價爲輸入 $2、輸出 $10、緩存讀 $0.1,超過 272,000 輸入時輸入爲 $4,可以先用來搭建流程,但它不是 6.2,價格也不能當作 6.2 的價格。
選型可以按任務類型拆開,下表是建議思路,依據都來自前文的公開數據:
| 任務場景 | 建議 | 依據 |
|---|---|---|
| 寫作、整理、辦公類日常任務 | 可以先考慮 GPT-6.2 Sol 作爲默認 | 官方自報 LifeVal、GDPval v2 |
| 小步代碼改動、提交 PR | GPT-6.2 Sol 可用,成本敏感時優先 | 官方自報 FrontierCode 2.0 |
| 代碼庫問答、長鏈路編碼代理 | 不要只看綜合分,先在自己的倉庫上對比 | 第三方 Coding Agent Index 低 3 分 |
| 漏一個事實代價很高的問答 | 加檢索與覈對,必要時多模型交叉 | 第三方幻覺率 55% |
| 超長輸入(超過 272K) | 先估算整單加價後的成本 | 官方模型頁計價規則 |
🚀 上手建議:日常默認可以先考慮 GPT-6.2 Sol,但漏事實代價高的問答不要只看綜合分。可以在 API易 apiyi.com 用同一個 Key 對比在架的
gpt-6.1-sol、claude-opus-5-5、gemini-4-carbon等型號,先在自己的任務上跑一輪,6.2 上架後再接入對照。
常見問題 FAQ
Q1:GPT-6.2 Sol 是什麼定位的模型?
GPT-6.2 Sol 是 OpenAI 2026-11-17 發佈的 6.2 系列中價格較低的一款,型號 ID `gpt-6.2-sol`,文本和圖像輸入、文本輸出,上下文 1,050,000 token,知識截止 2026-06-01。它的定位是高性價比的通用模型,與更貴的 GPT-6.2 Astra 同期發佈。
Q2:GPT-6.2 Sol 和 GPT-6.1 Sol 相比強在哪、弱在哪?
標價相同。官方自報 GDPval v2 高 5.3 分;第三方 Intelligence Index 在 Max 檔高 2 分到 57。但第三方 Coding Agent Index 低 3 分,主因 SWE-Atlas-QnA-AA 低 14 分,更容易漏關鍵事實。日常任務在進步,編碼代理裏的代碼庫問答在退步。
Q3:GPT-6.2 Sol 比 GPT-6.2 Astra 更好嗎?
不能這麼說。第三方綜合分各推理檔上 Astra 都更高,Max 檔是 62 對 57。Sol 的優勢是成本:官方自報 FrontierCode 2.0 與 Astra 相差不到 0.5 分、成本約五分之一,第三方單任務成本是 $1.01 對 $4.00。
Q4:GPT-6.2 Sol 的官方價格是多少?
OpenAI 官方短上下文標準價爲輸入 $2、緩存讀 $0.10、30 分鐘緩存寫入 $2.50、輸出 $10(每 100 萬 token),輸入超過 272K 時整單加價。API易:暫未上架,我們會盡快上架這個模型;型號與價格以平臺型號列表爲準。
Q5:6.2 上架之前,怎麼通過 API 做對照測試?
可以先用已在架的型號搭好流程:
1. 在 API易 apiyi.com 註冊並獲取 API Key 和免費測試額度
2. 用 OpenAI 兼容接口調用 `gpt-6.1-sol`、`gpt-6-astra` 等在架型號
3. 6.2 上架後只改 model 參數做 A/B 對照
注意 `gpt-6-sol` 和 `gpt-6.1-sol` 都不是 6.2,價格也不能互相替代。
Q6:Gemini 4 Carbon 價格和 Sol 一樣,該怎麼選?
Gemini 4 Carbon 官方標準價到 2026-11-30 爲輸入 $2、輸出 $10,2026-12-01 起變爲 $4 / $20,第三方綜合分最高檔 60。API易 apiyi.com 上的 `gemini-4-carbon` 目前標的是介紹價,12 月 1 日之後請以平臺列表爲準。它支持視頻和音頻輸入,但沒有 Responses 端點,選型時按輸入類型和接口來定。
Q7:GPT-6.2 Sol 能用來做漏洞研究嗎?
它達到了網絡安全“嚴重”級,防護更嚴,部分合法漏洞研究請求會被拒絕。面向防禦方的 Daybreak 目前還沒有 6.2,官方只表示會努力引進。
GPT-6.2 Sol 核心要點 Key Takeaways
- 日常任務進步明顯:官方自報 LifeVal 高於 GPT-6 Astra,成本約七分之一。
- 價格沒變:標價與 GPT-6.1 Sol 相同,輸入 $2、輸出 $10。
- 代碼合併接近 Astra:官方自報 FrontierCode 2.0 差距不到 0.5 分。
- 第三方綜合分:Max 57、Xhigh 56、High 55、Medium 53、Low 41。
- 編碼代理有退步:第三方 Coding Agent Index 比 6.1 Sol 低 3 分,易漏事實。
- 幻覺率 55%:事實敏感問答必須加檢索與複覈。
- 上手方式:6.2 上架前可在 API易 apiyi.com 先用在架型號搭好對照流程。
總結
GPT-6.2 Sol 的核心要點:
- 日常任務:官方自報的 LifeVal 和 GDPval v2 都顯示進步,用 Sol 的價格拿到接近上一代旗艦的日常表現。
- 編碼要分開看:官方自報的 FrontierCode 2.0 接近 Astra,但第三方 Coding Agent Index 比 GPT-6.1 Sol 低 3 分,代碼庫問答更容易漏事實。
- 綜合分不是全部:第三方 Max 57 追平 GPT-6 Astra,但 55% 的幻覺率和 Low 檔 41 分提醒你不要只看一個數字。
如果你的日常工作以寫作、整理和辦公任務爲主,GPT-6.2 Sol 值得先考慮作爲默認模型;如果你依賴編碼代理回答代碼庫問題,或者漏一個事實就要返工,建議在自己的任務上先做對照。推薦通過 API易 apiyi.com 用同一個 Key 對比在架型號,6.2 上架後再切換驗證。
📚 參考資料
-
OpenAI 發佈文:GPT-6.2 Astra 與 Sol 的官方介紹和自報評測
- 鏈接:
openai.com/index/introducing-gpt-6-2-astra-sol - 說明: LifeVal、FrontierCode 2.0、GDPval v2 等官方自報成績來源
- 鏈接:
-
OpenAI 模型頁:gpt-6.2-sol 規格與標價
- 鏈接:
platform.openai.com/docs/models/gpt-6.2-sol - 說明: 上下文、知識截止、272K 整單加價與 Batch、Fast、Ultrafast 規則
- 鏈接:
-
OpenAI 系統卡:安全分級與對齊評估
- 鏈接:
deploymentsafety.openai.com/gpt-6-2-astra-sol - 說明: 網絡安全“嚴重”級、生物化學“高”級和防護說明
- 鏈接:
-
Artificial Analysis 評測文章:第三方綜合分與編碼代理指數
- 鏈接:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - 說明: 各推理檔 Intelligence Index、Coding Agent Index 與幻覺率
- 鏈接:
-
Artificial Analysis 模型頁:GPT-6.2 Sol 單任務成本
- 鏈接:
artificialanalysis.ai/models/gpt-6-2-sol - 說明: 綜合指數單任務成本等第三方數據
- 鏈接:
-
API易 型號總表:平臺在架型號與價格
- 鏈接:
docs.apiyi.com/models.md - 說明: 覈對 6.2 是否上架及在架型號標價
- 鏈接:
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心


