
作者注:本文所有能力邊界均對照 API易模型文檔整理,寫作前按 2026 年 11 月版本覈對過一遍,結論以文檔爲準。
一張人像圖、一段音頻,想讓畫面裏的人開口說話,這是圖生視頻裏最常見的訴求。很多人的第一反應是把 driving_audio 一起塞給 happyhorse-1.1-i2v,結果音頻驅動沒有生效,於是開始懷疑素材、懷疑參數順序,甚至懷疑自己的調用方式。
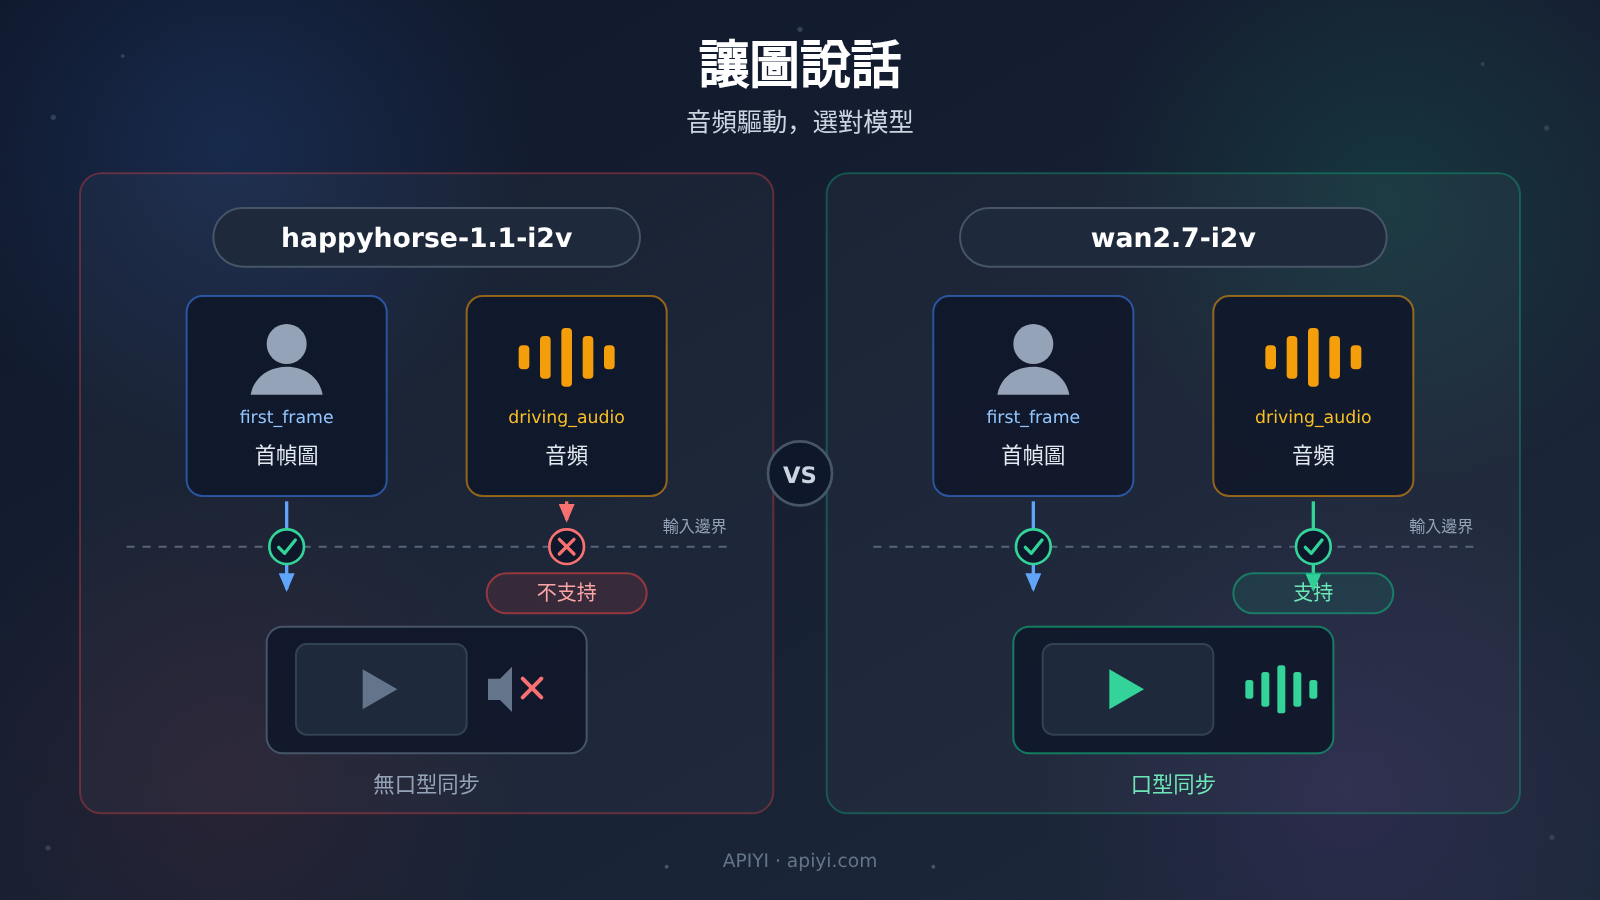
這不是玄學故障,也不是素材不夠好。文檔在這件事上寫得非常直白:happyhorse-1.1-i2v 只接受 first_frame,不支持 driving_audio;要做口型同步或說唱,文檔給出的方向是換 wan2.7-i2v。
核心價值:看完本文,你會清楚 happyhorse-1.1-i2v 和 wan2.7-i2v 的分工邊界,知道“讓圖說話”該把參數傳給誰,一次跑通。
happyhorse-1.1-i2v 核心要點
先給結論,細節後面展開:
| 要點 | 文檔記載 | 對你的意義 |
|---|---|---|
| 只認首幀圖 | happyhorse-1.1-i2v 接受 first_frame 輸入 |
圖像是它唯一的驅動入口 |
| 不支持音頻驅動 | 該模型不支持 driving_audio |
傳了也不生效,不必反覆重試 |
| 口型同步另有去處 | 文檔建議口型同步場景改用 wan2.7-i2v |
換模型比換參數更快解決問題 |
第一點是最容易誤判的地方。driving_audio 不是 happyhorse-1.1-i2v 的隱藏參數,也不是要等某個版本纔開放的能力。模型文檔明確把它標註爲不支持,連概覽頁的圖生視頻條目也寫了同樣的結論。換句話說,問題不在你的調用姿勢,而在模型的能力邊界本來就在這裏。
第二點關於替代路線。文檔記載,音頻驅動是 wan2.7-i2v 的專屬能力,HappyHorse 的 i2v 不承擔這類任務。所以當人物需要開口說話時,正確的動作不是繼續調參,而是直接切換模型。
happyhorse-1.1-i2v 與 wan2.7-i2v 核心差異
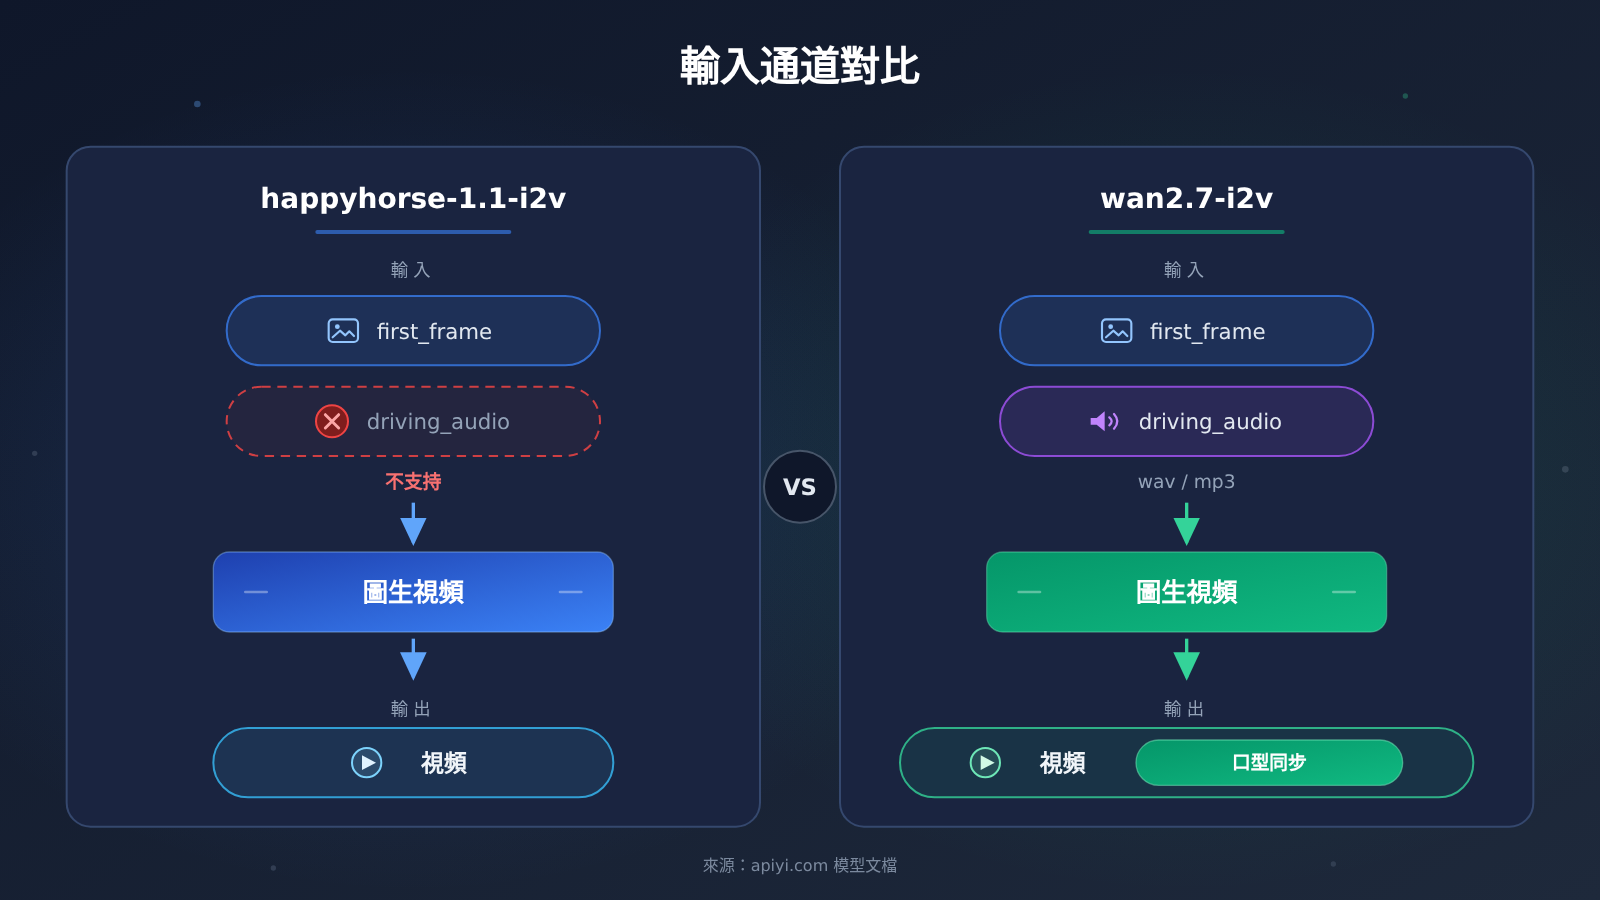
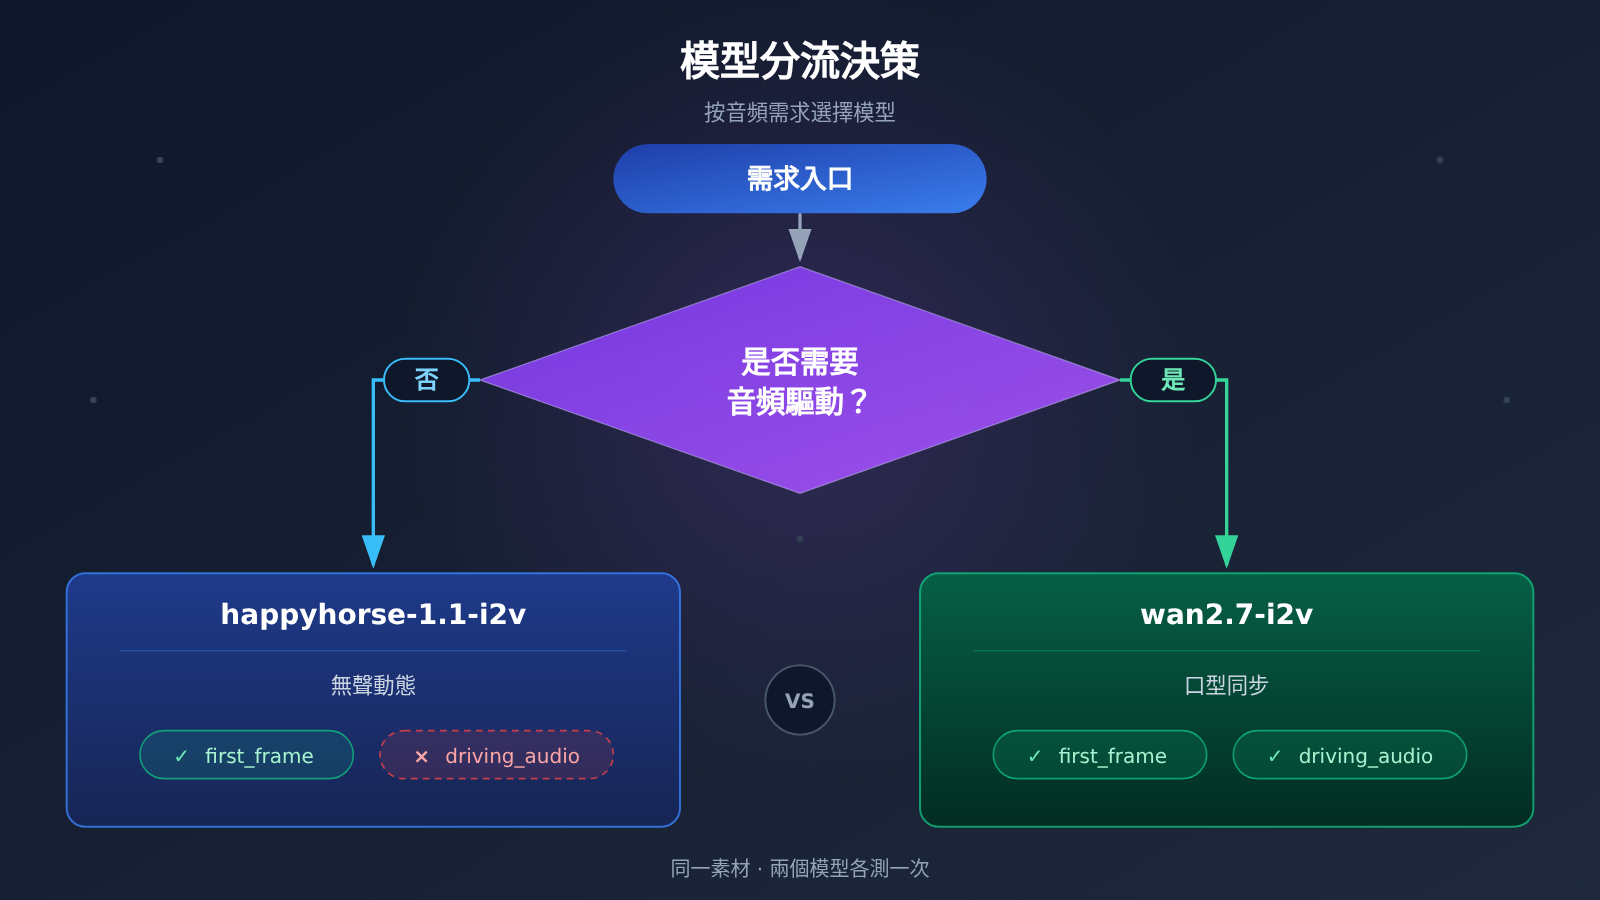
兩個模型同爲首幀圖生視頻,定位重疊,真正拉開差距的是音頻輸入這一行:
| 對比維度 | happyhorse-1.1-i2v |
wan2.7-i2v |
差異結論 |
|---|---|---|---|
| 任務類型 | 首幀圖生成視頻 | 首幀圖生成視頻 | 定位重疊,別按名字分高下 |
first_frame |
接受 | 必須有 1 個 | 圖像輸入兩邊都不可缺 |
driving_audio |
不支持 | 支持,可選 1 個 | 口型同步的分水嶺 |
| 音頻格式 | 不適用 | wav 或 mp3 |
傳參前先確認格式 |
| 口型同步場景 | 文檔建議改用 wan2.7-i2v |
文檔指定承載該場景 | 選型看這一行就夠了 |
上表與配圖均依據 API易模型文檔(apiyi.com)整理,不是經驗推測。
happyhorse-1.1-i2v 在“讓靜態首幀動起來”這件事上是正路:給它一張 first_frame,它負責把畫面演下去。但音頻不在它的輸入清單裏,文檔記載音頻驅動能力沒有開放給 HappyHorse 的 i2v。相比之下,wan2.7-i2v 在同樣的首幀輸入之外多開了一扇門,driving_audio,人物的動作節奏可以跟着音頻走。
wan2.7-i2v 的約束也更具體:媒體裏必須恰好有 1 個 first_frame,driving_audio 至多 1 個,音頻格式限定 wav 或 mp3。這些約束寫得很死,好處是你照着文檔組裝,一次就能跑通,不用靠猜。
爲什麼 happyhorse-1.1-i2v 不接受 driving_audio
把文檔線索攤開,至少有四層信息指向同一個結論:
- 模型頁寫明:
happyhorse-1.1-i2v是首幀圖生成視頻模型,只接受first_frame。 - 同頁明確標註:不支持
driving_audio。 - 概覽頁的圖生視頻條目,同樣標註不支持音頻驅動。
- 面對口型或說唱需求,文檔直接給出遷移建議:改用
wan2.7-i2v。
於是回到那個經典場景:你在請求裏放進了 driving_audio,結果與預期對不上,開始逐項排查素材和參數。無論接口最終以什麼形式反饋,根因都只有一個——這個字段對 happyhorse-1.1-i2v 來說不在輸入範圍內。文檔沒有留下“換個寫法就行”的口子,重試和換素材都改變不了輸入邊界。
如果你是在 API易(apiyi.com)上發起的調用,排查時先把請求裏的模型 ID 與字段名和文檔逐項對照,再檢查其它環節。多數“音頻沒生效”的問題,在這一步就能定位,不需要繞遠路。
用 wan2.7-i2v 的 driving_audio 完成口型同步:快速上手
確認換用 wan2.7-i2v 之後,整個流程只剩四步,重心全在媒體組裝上:
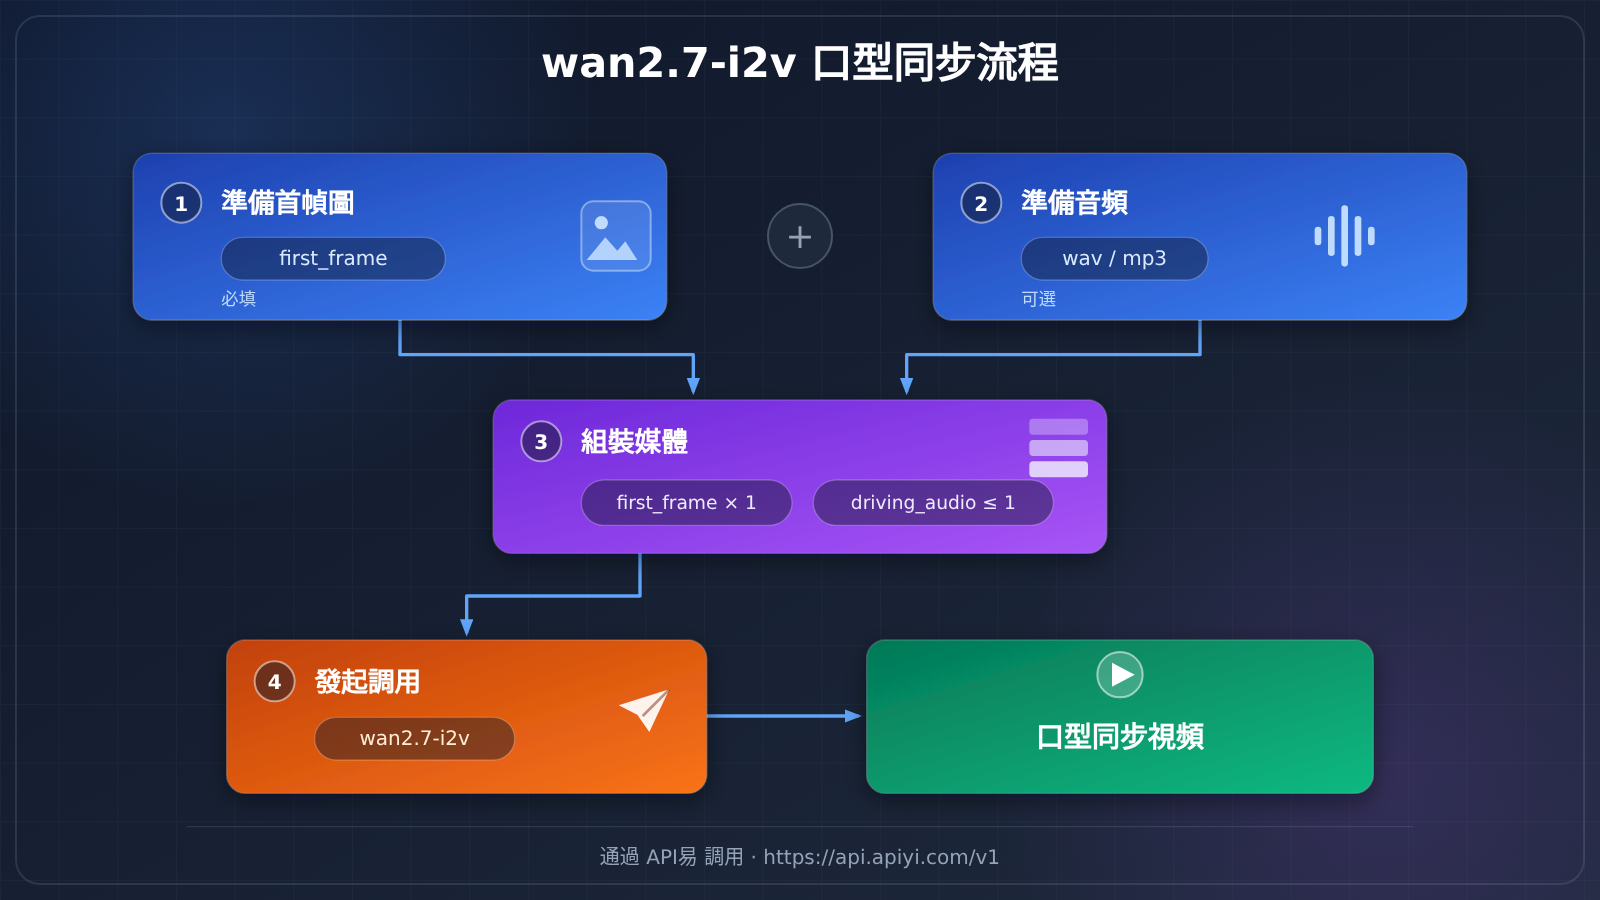
- 準備首幀圖:一張人物清晰、構圖穩定的圖,作爲
first_frame。 - 準備音頻:
wav或mp3格式,作爲driving_audio驅動口型與節奏。 - 組裝媒體:恰好 1 個
first_frame,至多 1 個driving_audio,不要多塞。 - 發起調用:模型填
wan2.7-i2v;通過 API易調用時,接口基礎地址爲https://api.apiyi.com/v1。
| 字段 | 是否必填 | 數量約束 | 格式要求 |
|---|---|---|---|
first_frame |
必填 | 恰好 1 個 | 首幀圖 |
driving_audio |
可選 | 至多 1 個 | wav 或 mp3 |
前兩步沒有懸念,真正決定成敗的是第 3 步。文檔對數量的表述非常嚴格:first_frame 必須有且恰好 1 個,driving_audio 可選且至多 1 個。圖或音頻多傳都可能讓請求不符合約定,別把“多多益善”的直覺帶進參數組裝。
🚀 快速開始:推薦直接通過 API易 apiyi.com 驗證這套流程。平臺聚合 OpenAI、Claude、Gemini 等主流模型 API,一個 Key 可調用多個模型,按量計費,新用戶有免費測試額度,跑通
wan2.7-i2v的口型同步幾乎零成本。
happyhorse-1.1-i2v 還是 wan2.7-i2v:場景推薦
| 你的需求 | 推薦模型 | 關鍵輸入 |
|---|---|---|
| 人物開口說話、口型對齊音頻 | wan2.7-i2v |
first_frame 加 driving_audio |
| 說唱、臺詞等節奏型表演 | wan2.7-i2v |
first_frame 加 driving_audio |
| 讓靜態圖自然動起來,不需要聲音 | happyhorse-1.1-i2v |
僅 first_frame |
繼續留在 happyhorse-1.1-i2v 的場景
不需要聲音參與的動態化任務,happyhorse-1.1-i2v 依然是正經選擇。它的職責是把一張首幀圖演成一段有運動感的視頻,輸入乾淨,只認 first_frame。如果你的成片交給後期配音,或者根本不需要音頻,留在這裏反而省事。
- 首幀驅動運動:讓人物、景物從靜態畫面裏自然動起來。
- 無聲內容生產:成片後期配音,或用於不需要聲音的展示場景。
換到 wan2.7-i2v 的場景
只要成片需要人物“跟着聲音動”,答案就落在 wan2.7-i2v 上。文檔記載的音頻驅動能力,讓它成爲這兩個模型裏唯一接收 driving_audio 的選項,口型與節奏由音頻直接牽引。
- 口型同步:一張人像加一段人聲,生成開口說話的視頻。
- 音頻驅動表演:說唱、臺詞等節奏型內容,動作跟着音頻走。
如果兩類需求你都有,可以在 API易上把同一組素材分別跑一次,切換模型不需要換 Key,對比完再定分工也不遲。
happyhorse-1.1-i2v 與 wan2.7-i2v 決策建議
| 當前狀態 | 建議動作 |
|---|---|
| 口型同步是硬需求 | 直接用 wan2.7-i2v,帶上 driving_audio |
| 只需要畫面動起來 | 留在 happyhorse-1.1-i2v,只傳 first_frame |
已把音頻傳給 happyhorse-1.1-i2v 卻不生效 |
停止重試,換 wan2.7-i2v,這不是參數問題 |
決策的核心只有一句話:先問“這段視頻需要開口嗎”。需要聲音參與表演,答案就是 wan2.7-i2v;不需要,happyhorse-1.1-i2v 繼續勝任首幀圖生視頻。把音頻交給正確的模型,比在任何模型上死磕參數都省時間。
💡 選擇建議:拿不準效果時,別停留在文檔層面的推理,直接在 API易 apiyi.com 上各跑一次最小用例,用兩段真實結果做決定最可靠。
關於 driving_audio 的常見問題 FAQ
Q1:什麼是 happyhorse-1.1-i2v?
首幀圖生成視頻模型,輸入只接受 `first_frame`。文檔明確標註它不支持 `driving_audio`,音頻驅動不在它的能力範圍內。
Q2:happyhorse-1.1-i2v 和 wan2.7-i2v 在音頻驅動上有什麼區別?
文檔把音頻驅動標註爲 `wan2.7-i2v` 的專屬能力,同時寫明 HappyHorse 的 i2v 不支持。也就是說,`wan2.7-i2v` 接收 `driving_audio`,`happyhorse-1.1-i2v` 不接收。其它型號是否支持,請以各自文檔爲準,別按系列名類推。
Q3:把 driving_audio 傳給 happyhorse-1.1-i2v 會發生什麼?
文檔的答覆很直接:不支持,只接受 `first_frame`。與其研究各種反饋細節,不如把這組素材改投 `wan2.7-i2v`,同樣的圖和音頻立刻就有用武之地。
Q4:driving_audio 對格式和數量有什麼要求?
音頻格式爲 `wav` 或 `mp3`;媒體中必須恰好有 1 個 `first_frame`,至多 1 個 `driving_audio`。照這個約束組裝請求,一次通過率最高。
Q5:如何通過 API 快速調用 wan2.7-i2v?
推薦從聚合平臺起步:
1. 在 API易 apiyi.com 註冊並獲取 API Key,新用戶有免費測試額度;
2. 接口基礎地址使用 `https://api.apiyi.com/v1`;
3. 按“1 個 `first_frame` 加 1 個 `driving_audio`”組裝媒體,模型填 `wan2.7-i2v`。
Q6:是不是萬相系列都能這樣傳音頻?
不能這麼類推。文檔只把音頻驅動寫給了 `wan2.7-i2v`,其它型號是否支持,以對應文檔爲準,別憑系列名猜能力。
Q7:去哪裏覈對這兩個模型的能力說明?
API易把能力邊界寫在模型文檔裏,訪問 docs.apiyi.com 即可逐條覈對。選型前查一遍文檔,比踩坑後再排查便宜得多。
happyhorse-1.1-i2v 與 driving_audio 核心要點 Key Takeaways
- 能力邊界:
happyhorse-1.1-i2v只接受first_frame,driving_audio不在其輸入中。 - 專屬能力:音頻驅動屬於
wan2.7-i2v,口型同步直接找它。 - 媒體約束:恰好 1 個
first_frame,至多 1 個driving_audio,音頻限wav或mp3。 - 遷移指引:文檔建議口型或說唱場景從
happyhorse-1.1-i2v換到wan2.7-i2v。 - 驗證方式:用一組素材各跑一次最小用例,兩段結果即可敲定選型。
總結
關於“想讓圖說話”這件事,三個結論值得帶走:
- 輸入邊界:
happyhorse-1.1-i2v不接受driving_audio,只認first_frame,這是文檔寫明的能力邊界。 - 正確去處:口型同步與音頻驅動是
wan2.7-i2v的專屬能力,一張圖加一段wav或mp3即可開工。 - 排障思路:音頻不生效時先查模型與字段的匹配關係,而不是反覆重試。
選型拿不準時,用最小用例各跑一次再決定。推薦通過 API易 apiyi.com 快速驗證,平臺提供免費測試額度和多模型統一接入,換模型不需要換 Key。
📚 參考資料
- API易文檔 · HappyHorse 圖生視頻
- 鏈接:
docs.apiyi.com/api-capabilities/happyhorse/image-to-video.md -
說明:
happyhorse-1.1-i2v的輸入定義與“不支持driving_audio”的原文出處。 -
API易文檔 · Wan 圖生視頻
- 鏈接:
docs.apiyi.com/api-capabilities/wan/image-to-video.md -
說明:
wan2.7-i2v對first_frame與driving_audio的數量及格式約束。 -
API易文檔 · HappyHorse 概覽
- 鏈接:
docs.apiyi.com/api-capabilities/happyhorse/overview.md - 說明: 圖生視頻條目對音頻驅動能力的整體標註。
作者: API易技術團隊
技術交流: 歡迎在 API易 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心


