
Примечание автора: если ваша модель показывает результат хуже, чем в официальном лидерборде, не спешите с выводами. Часто уровень рассуждений, точка входа или ID модели не совпадают с тем, что использовалось в тесте лидерборда. В этой статье приведён порядок проверки этих трёх вещей: сначала сверьте их, а потом решайте, менять ли модель.
Многие разработчики сталкиваются с одним и тем же расхождением. В официальном анонсе написано, что модель набрала высокий балл в лидерборде; вы пробуете задачи того же типа — и результат заметно хуже ожидаемого. Тогда начинаешь подозревать, что модель «поглупела» или её «урезали». В статье предложен более практичный подход к разбору: сначала совместите уровень рассуждений, точку входа и тот же ID модели, а затем оценивайте, действительно ли расхождение существует.
Это не секретный рецепт «переключи три тумблера и сравняешься с официальным лидербордом». Все описанные ниже различия взяты из публичной документации. Они лишь помогают убедиться, что вы сравниваете одно и то же; они не гарантируют, что после настройки вы получите баллы, как в лидерборде, и не означают, что APIYI воспроизводил официальный лидерборд.
Главная польза: после прочтения статьи вы будете знать порядок проверки этих трёх вещей и то, какую документацию смотреть на каждом шаге. А ещё вы узнаете, какие цены и эндпоинты нужно сверить перед сменой модели, если после проверки расхождение всё равно осталось.
Ключевые моменты, из-за которых результаты не сходятся с официальным бенчмарком
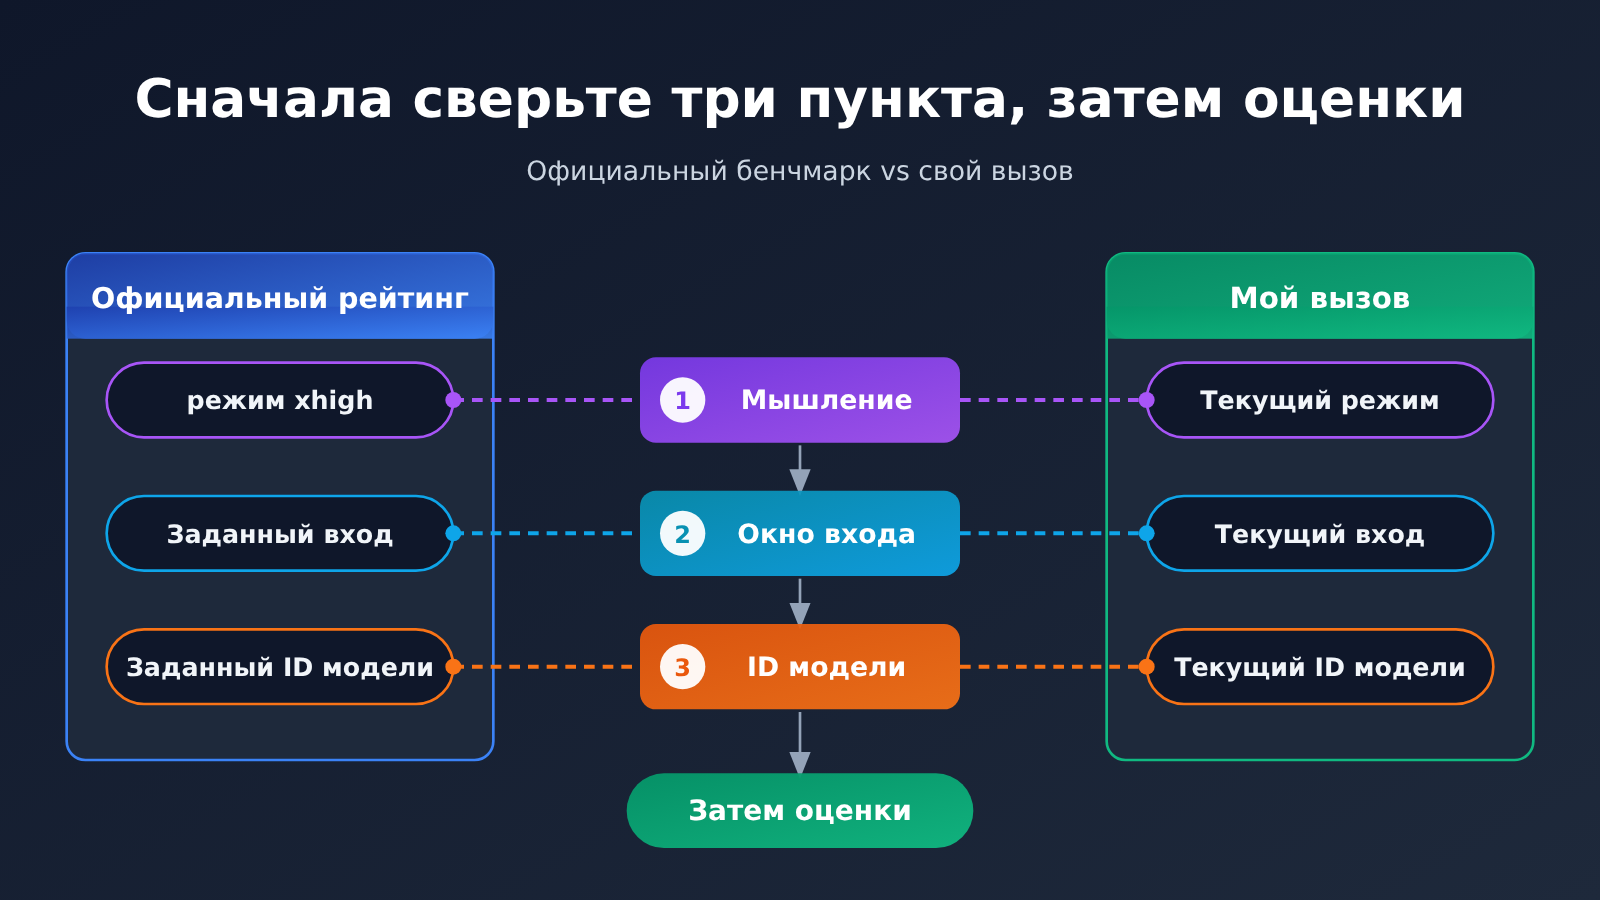
Сразу к выводу. Оценка в лидерборде — это никогда не оценка «названия модели», а оценка для конкретного «ID модели + уровня рассуждений + условий на входе». Достаточно, чтобы хоть одно из трёх отличалось — и ваш результат уже нельзя напрямую сравнивать с лидербордом.
| Что сверяем | Типичные расхождения (по открытой документации) | Что будет, если не совпадёт | Приоритет |
|---|---|---|---|
| Уровень рассуждений | Neon в API по умолчанию high, есть также low, medium, xhigh; у Carbon по умолчанию medium, а xhigh нет |
Другая длина вывода и другая глубина рассуждений — результат, естественно, отличается | Шаг первый |
| Окно на входе | Окно API у Neon — 1,048,576 токенов, а в документации Antigravity указано максимум 512K |
Возможности длинного контекста из лидерборда ваш вход может и не вместить | Шаг второй |
| ID модели | У Gemini 4 есть как минимум четыре варианта — argon, carbon, hydrogen, neon, и у них разные уровни рассуждений и разные цены |
Сравнивать результат A с лидербордом B — значит сравнивать не одно и то же | Шаг третий |
Почему уровень рассуждений стоит первым при проверке официальных бенчмарков
Уровень рассуждений — самый легко упускаемый параметр, потому что у него часто есть значение по умолчанию: можно ничего не настраивать, и вызов всё равно пройдёт нормально. Проблема в том, что значения по умолчанию у разных моделей различаются. Возьмём Gemini 4: у Neon в API по умолчанию high, а у Carbon — medium. Один и тот же промпт при разных уровнях даст разную длину ответа и разный итоговый результат.
В лидербордах обычно указывают, на каком уровне проводилось тестирование. Оценки, на которые ссылаются официальные анонсы, например 61 балл Neon на Artificial Analysis при уровне xhigh, нужно читать вместе с уровнем. Если сравнивать оценку при уровне по умолчанию high с оценкой при xhigh, это уже разные условия. И ещё: у Carbon вообще нет уровня xhigh, поэтому «выкрутить Carbon на максимум» — не то же самое, что xhigh у Neon.
Разные точки входа могут называть один и тот же уровень по-разному. В Antigravity максимальный уровень Neon в интерфейсе называется Extra, а в документации API — xhigh. При проверке ориентируйтесь на соответствие из документации, а не на буквальное название.
Почему контекстное окно точки входа и ID модели так же важны
Контекстное окно точки входа определяет, сколько контекста можно передать модели. При вызове Neon через API окно составляет 1,048,576 токенов, а в документации Antigravity указано максимум 512K. Если лидерборд проверяет поиск по длинным документам или понимание большой кодовой базы, то в точке входа с меньшим окном даже та же модель может показать худший результат из-за обрезки содержимого.
ID модели — самый однозначный пункт. У поколения Gemini 4 есть как минимум четыре ID: argon, carbon, hydrogen и neon; у них разные настройки уровня рассуждений и цены. Если сравнить результаты Hydrogen с оценками Neon на уровне xhigh, разница вполне ожидаема. Перед вызовом советую проверить в сводной таблице моделей APIYI apiyi.com, какой именно ID вы отправляете в запросе, а не заполнять по памяти или по чужому скриншоту.
Быстрые шаги сверки с официальными эталонными показателями
В этом разделе три проверки превращаются в конкретные действия. Чтобы было удобно копировать, имена параметров, ID моделей и адреса вынесены в строчный код — можете сверять их со своим запросом пункт за пунктом.
Шаг 1: Определите точку входа и эндпоинт
Сначала поймите, через какую точку входа вы используете модель: веб-интерфейс, плагин для IDE или напрямую API. У разных точек входа лимиты контекстного окна и названия уровней могут отличаться. Если работаете через OpenAI-совместимый интерфейс, установите base_url в https://api.apiyi.com/v1, а в api_key укажите ключ, сгенерированный в консоли APIYI. Тогда при последующей смене модели нужно будет менять только поле model, а условия входа останутся одинаковыми — только так сравнение имеет смысл.
Шаг второй: указывайте полный ID модели
В запросе записывайте model как полный ID, например gemini-4-neon или gemini-4-carbon, а не расплывчатое «Gemini 4». После этого вернитесь к сводной таблице моделей и сверьтесь: убедитесь, что этот ID — именно та модель, которая тестировалась в рейтинге. Если в рейтинге тестировали Neon, а вы вызываете gemini-4-hydrogen, то все дальнейшие сравнения бессмысленны — сначала исправьте ID.
Шаг третий: явно задавайте уровень «размышления»
Не полагайтесь на значения по умолчанию — указывайте уровень размышления в запросе явно. Конкретное имя поля смотрите в официальной документации соответствующей модели. При настройке обратите внимание на три момента:
- Совпадение с уровнем из рейтинга: если в рейтинге указано
xhigh, ставьтеxhigh; если указаноhigh, ставьтеhigh. - Проверьте, что уровень существует: у Carbon нет
xhigh, и искусственно подгонять его под рейтинг Neon сxhighне имеет смысла. - Следите за соответствием названий:
Extraв интерфейсе Antigravity соответствует высшему уровню Neon, а при переходе на API его нужно заменить на имя уровня из документации.
Шаг четвёртый: проверяем, не упирается ли контекст в лимит входного окна
Если тестовый материал объёмный, сначала прикиньте количество токенов, а потом сравните с лимитом входа. При вызове Neon через API лимит составляет 1,048,576 токенов, а в документации Antigravity указано максимум 512K. Всё, что выходит за лимит, обрезается или возвращает ошибку — и «плохой результат» в таком случае на самом деле означает неполный ввод.
🚀 Быстрый старт: если хочется сравнить несколько model ID в одинаковых условиях входа, можно через APIYI apiyi.com вызывать Gemini, Claude, GPT и другие модели одним ключом. Новым пользователям дают бесплатный тестовый лимит — удобно сначала выровнять тарифы и ID, а уже потом делать небольшое сравнение.
Чек-лист из трёх пунктов проверки
| Что проверяем | Какое поле смотреть в запросе | Критерий соответствия | Частая ошибка |
|---|---|---|---|
| Вход | base_url |
Один фиксированный вход, например https://api.apiyi.com/v1 |
Один раз тестировать в веб-интерфейсе, другой раз через API и сравнивать вперемешку |
| ID модели | model |
Полный ID, совпадающий с лидербордом | Сравнивать hydrogen с лидербордом neon |
| Уровень мышления | параметр уровня мышления (имя поля — по документации) | Совпадает с тестируемым уровнем, и такой уровень существует | Полагаться на значение по умолчанию; задавать xhigh для Carbon |
| Контекст | количество входных токенов | Не превышает лимит входного окна | Пихать миллионный объём во вход с лимитом 512K |
Официальные бенчмарки сверены, но разрыв остаётся: перед сменой модели проверьте цену и эндпоинт
Если все три пункта совпали, а разрыв всё ещё заметен, только тогда стоит задуматься о смене модели. Смена модели — это не просто другое имя: нужно одновременно смотреть на уровень возможностей и стоимость, потому что у разных ID Gemini 4 цены заметно различаются. Ниже — цены на витрине APIYI, проверенные 2026-11-20; все они указаны в долларах США за миллион токенов.
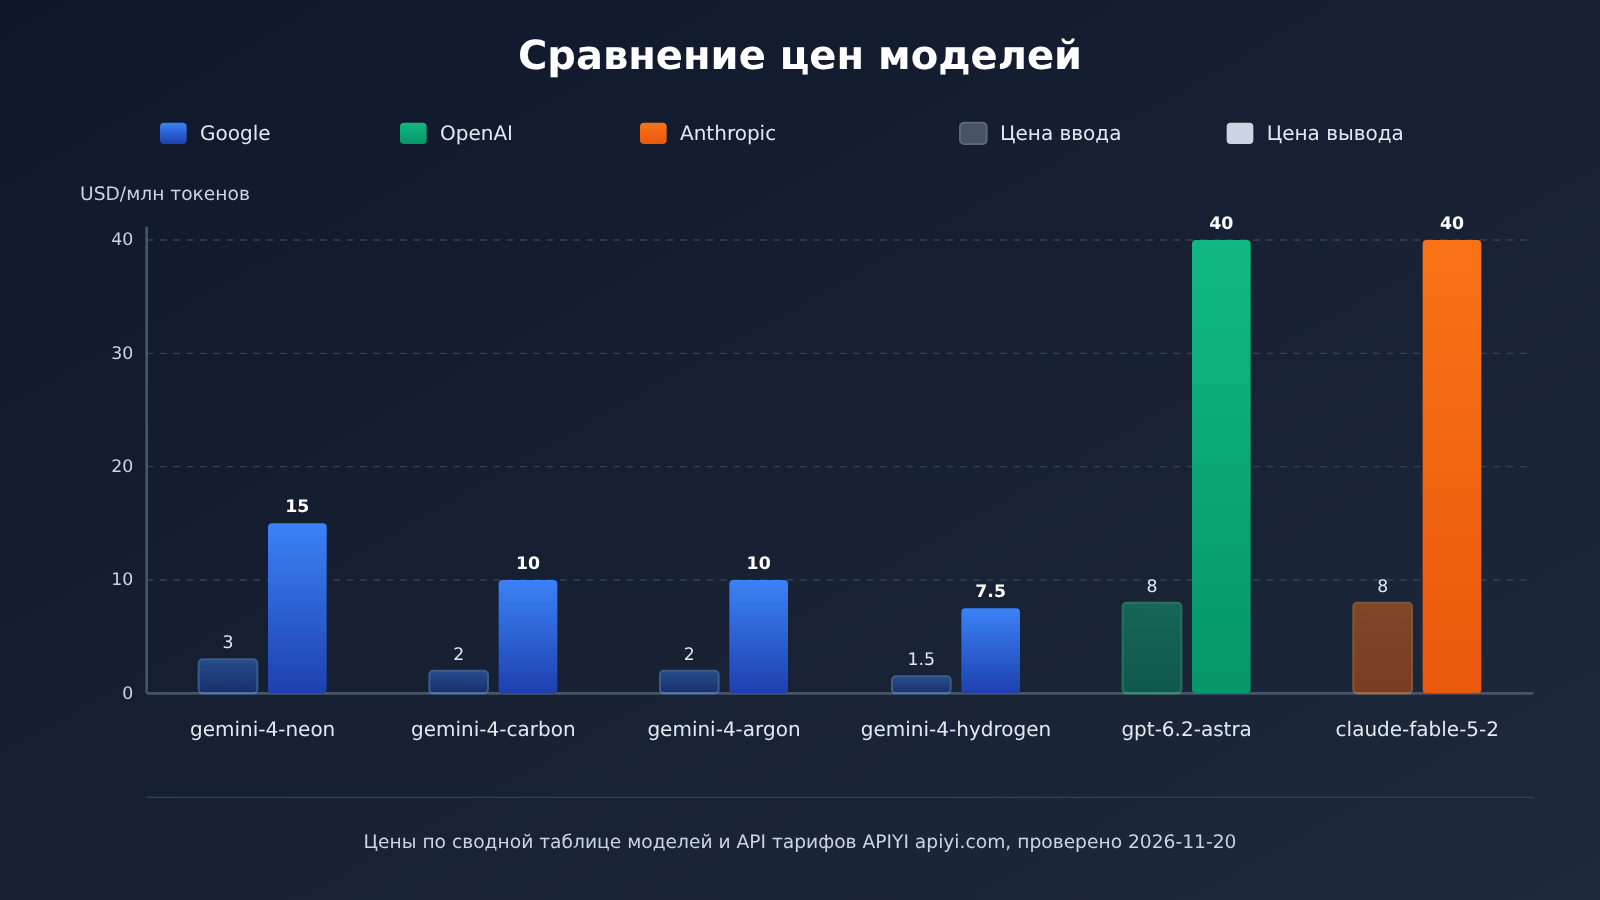
| ID модели | Вход | Чтение из кэша | Выход | Примечание |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
По API ценообразования; совпадает с ценой Google |
gemini-4-carbon |
2 |
0.1 |
10 |
Соответствует вводной цене Google до 2026-11-30 |
gemini-4-argon |
2 |
0.1 |
10 |
Из сводной таблицы моделей |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
Самая низкая цена за единицу среди четырёх |
gpt-6.2-astra |
8 |
0.4 |
40 |
После 272000 токенов вход — 16, подробности ниже |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 |
0.2 |
40 |
Цены для обоих ID одинаковы |
В этой таблице есть несколько моментов, которые нужно пояснить отдельно, иначе легко ошибиться в расчёте стоимости:
- Откуда взялся gemini-4-neon: в сводной таблице моделей, обновлённой 2026-11-19 10:59 (UTC+8), его нет, но в API ценообразования он есть. API ценообразования выдаёт
model_ratio=1.5,completion_ratio=5,cache_ratio=0.05. Если считать, чтоmodel_ratio=1соответствует входной цене2доллара за миллион токенов, получаем вход3, выход15, чтение из кэша0.15. - Актуальность цены gemini-4-carbon: текущая цена соответствует вводной цене Google до 2026-11-30. С 1 декабря стандартная цена Google — вход
4, выход20; при долгосрочном планировании бюджета это изменение нужно учитывать. - Тарификация gpt-6.2-astra по уровням: в сводной таблице моделей указан первый уровень — вход
8, чтение из кэша0.4, выход40; после272000токенов вход —16. API ценообразования при превышении272000токенов считает выход по60, а чтение из кэша — по0.8. Учитывайте оба источника вместе.
💡 Совет по выбору: при смене модели поместите кандидатов под один и тот же
base_urlи сравнивайте на одинаковом уровне рассуждений и одинаковых входных данных — только так вывод будет обоснованным. В сводной таблице моделей и API ценообразования APIYI apiyi.com можно проверить текущие цены этих ID; перед вызовом лучше ещё раз подтвердить их, а не опираться только на эту таблицу.
Чек-лист по эндпоинтам и биллингу при смене модели
| Что проверять | Где смотреть | Зачем проверять |
|---|---|---|
| Существует ли ID модели | Сводная таблица моделей docs.apiyi.com/models.md |
Версия сводной таблицы может отставать, отдельные ID нужно дополнительно сверять через интерфейс цен |
| Текущая цена за единицу и множитель | Интерфейс цен api.apiyi.com/api/pricing |
Множитель пересчитывается в цену за единицу в долларах, номер версии — shell-api-modelmak-v1 |
| Градация для длинного контекста | Сверять по двум источникам: сводная таблица и интерфейс цен | Например, у gpt-6.2-astra после превышения 272000 токенов цена за единицу меняется |
| Эндпоинт вызова | https://api.apiyi.com/v1 |
Формат, совместимый с OpenAI: при смене модели меняется только model |
| Изменение цен у upstream-провайдера | Официальные объявления о ценах | Например, вводная цена Carbon действует до 2026-11-30 |
Частые вопросы (FAQ)
Вопрос 1. Какому именно условию соответствуют официальные баллы бенчмарка?
Балл в рейтинге соответствует комбинации «конкретный ID модели + конкретный уровень размышлений + определённые условия входа», а не обобщённому названию модели. Например, 61 балл Neon — это результат Artificial Analysis на уровне `xhigh`. Если цитировать эту цифру в отрыве от уровня размышлений, очень легко ввести людей в заблуждение.
Вопрос 2. Что проверять первым: уровень размышлений, окно входа или ID модели?
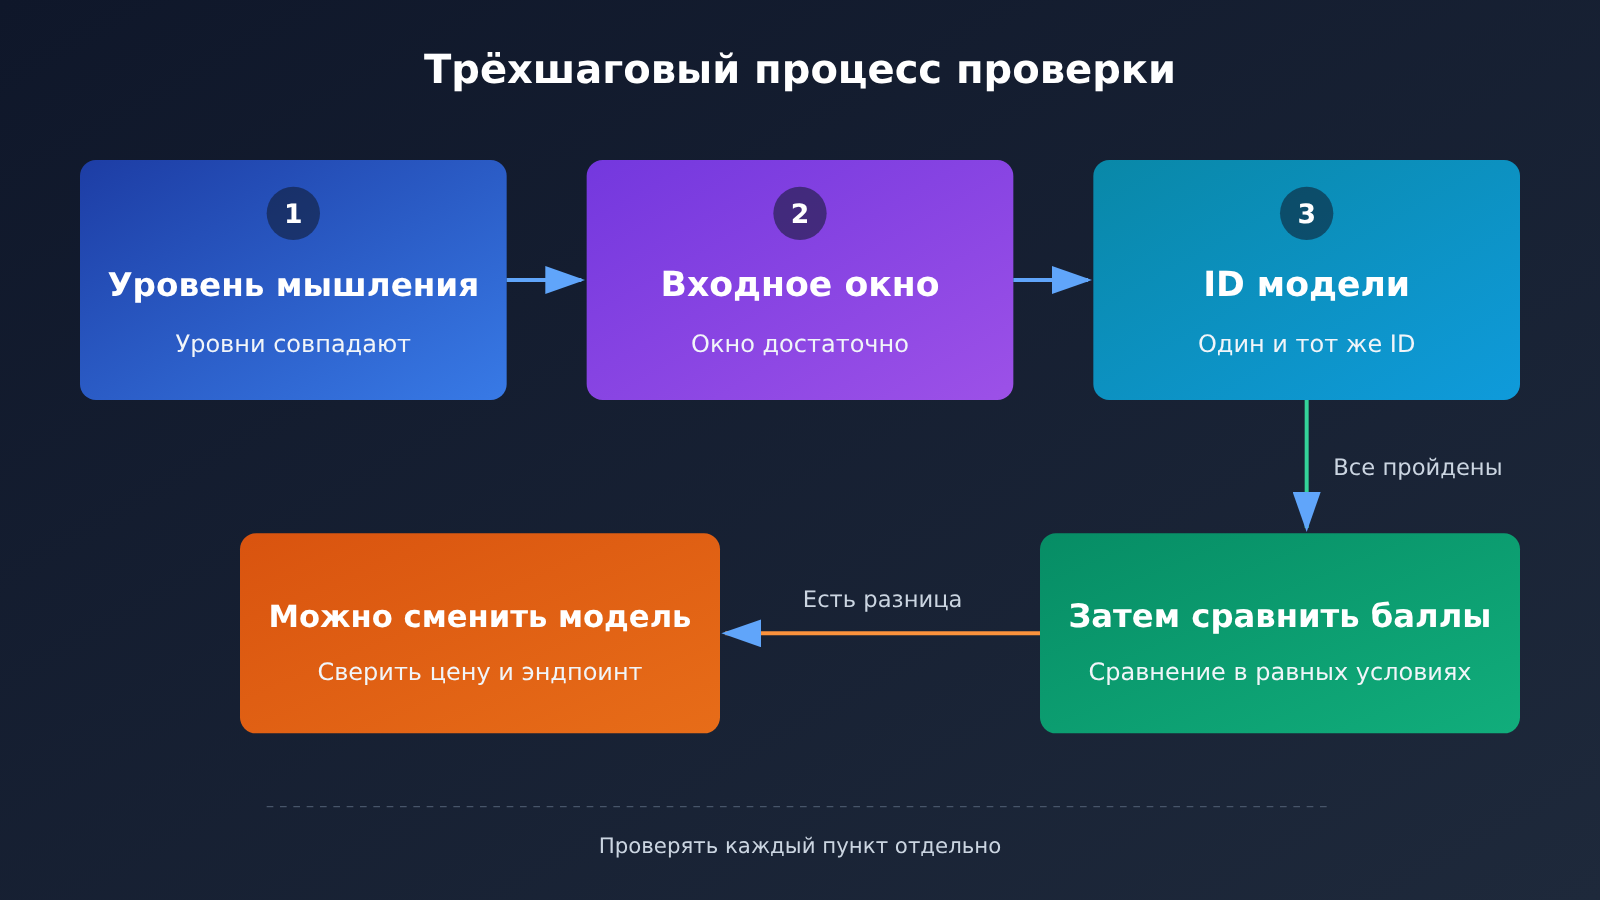
Рекомендуемый порядок такой: сначала уровень размышлений, затем окно входа, и в конце сверка с ID модели. Только когда все три пункта совпали, можно сравнивать баллы. На практике можно для начала мельком взглянуть на ID — если ID неверный, остальные два пункта можно даже не смотреть. Смысл порядка в том, чтобы исключать пункт за пунктом, а не в том, чтобы каждый раз механически повторять фиксированные шаги.
Вопрос 3. Если выкрутить уровень размышлений на максимум, можно дотянуть до официального бенчмарка?
Обещать этого нельзя. Согласование уровня гарантирует лишь то, что вы сравниваете с рейтингом при одинаковых условиях; распределение задач, формулировка промптов, способ сэмплирования и другие факторы всё равно могут давать расхождения. Кроме того, не у каждого ID есть максимальный уровень — например, у Carbon нет `xhigh`, и его максимальный уровень не равен `xhigh` у Neon.
Вопрос 4. Почему один и тот же Neon в IDE и при прямом вызове API ведёт себя по-разному?
Условия входа могут различаться. Когда Neon работает через API, окно составляет `1,048,576` токенов, а в документации Antigravity указано максимум `512K`. Названия уровней с обеих сторон тоже не совпадают: в интерфейсе Antigravity высший уровень называется `Extra`. Ухудшение результатов на задачах с длинным контекстом во входе с меньшим окном — это следствие различий в условиях, а не свидетельство деградации самой модели.
Вопрос 5. Как сравнить несколько ID моделей в рамках одного входа?
Можно действовать в три шага:
1. Зарегистрируйтесь на APIYI apiyi.com и создайте API-ключ — новые пользователи могут получить бесплатный тестовый лимит.
2. Установите `base_url` единым образом на `https://api.apiyi.com/v1` и меняйте только поле `model`, чтобы переключать ID.
3. Для каждого ID явно задайте одинаковый уровень размышлений и сравните на одной и той же партии входных данных.
Так вход и уровень оказываются фиксированными, и различия в основном идут от самой модели.
Вопрос 6. `gemini-4-neon` нет в общем списке моделей — его всё равно можно вызвать?
В версии общего списка, обновлённой 2026-11-19, `gemini-4-neon` не учтён, но в интерфейсе ценообразования есть его коэффициент. После пересчёта получается: вход `3`, выход `15`, чтение кэша `0.15` доллара за миллион токенов — совпадает с ценой Google. Рекомендуем ориентироваться на актуальные результаты интерфейса ценообразования APIYI apiyi.com и уточнить ещё раз перед вызовом.
Вопрос 7. Какой пункт чаще всего считают неправильно при смене модели?
Самые частые ошибки — в тарифных уровнях для длинного контекста и в актуальности цен. У `gpt-6.2-astra` после `272000` токенов цена за единицу ввода меняется с `8` на `16`, а API тарификации также указывает, что в этом случае вывод тарифицируется по `60`, а чтение кэша — по `0.8`. У Carbon сейчас вводная цена; с 1 декабря стандартная цена Google составит `4` за ввод и `20` за вывод.
Официальные бенчмарки: ключевые выводы
- Баллы в рейтинге зависят от условий: результат бенчмарка соответствует комбинации «ID модели + уровень рассуждений + точка входа», а не самому названию модели.
- Сначала проверьте уровень рассуждений: у Neon по умолчанию
high, у Carbon —mediumи нетxhigh; не полагайтесь на значения по умолчанию. - Затем проверьте окно точки входа: у Neon в API доступно
1,048,576токенов, а в документации Antigravity указано максимум512K. - ID должен быть одним и тем же: у Gemini 4 есть как минимум четыре ID; сравнивать результат Hydrogen с рейтингом Neon не имеет смысла.
- После настройки совпадение не гарантировано: выравнивание условий только делает сравнение корректным, но не обещает, что результат догонит рейтинг.
- Смена модели — сверка с ценой в прайсе: в APIYI apiyi.com сравните несколько ID на едином эндпоинте и одновременно сверьте цены в сводной таблице и API тарификации.
Краткий итог
Когда модель показывает результаты хуже официального бенчмарка, проверять нужно три вещи в таком порядке:
- Сверьте уровень рассуждений: явно выставьте тот же уровень, что и в тесте рейтинга, и убедитесь, что у этого ID такой уровень вообще есть.
- Сверьте контекстное окно эндпоинта: проверьте, что его хватает под тестовое содержимое, и учитывайте, что в разных эндпоинтах уровни могут называться по-разному.
- Сверьте ID модели: указывайте в запросе полный ID и сверяйте его посимвольно со сводной таблицей моделей.
Если все три пункта совпали, а разрыв всё ещё есть, тогда уже думайте о смене модели. При смене сравнивайте сразу несколько параметров: уровень возможностей, цену за единицу, тарифы для длинного контекста и актуальность цены. Решение в этом случае должно опираться на сравнение в одинаковых условиях, а не на цифру из рейтинга, вырванную из контекста.
Рекомендуем проверять несколько ID моделей через APIYI apiyi.com на одном и том же эндпоинте https://api.apiyi.com/v1. Когда эндпоинт и уровень фиксированы, выводы из сравнения становятся гораздо надёжнее.
📚 Справочные материалы
-
Сводная таблица моделей APIYI: ID моделей и цены по каталогу
- Ссылка:
docs.apiyi.com/models.md - Описание: в статье используется версия, обновлённая 2026-11-19 10:59 (UTC+8); по ней можно проверить, существует ли модель с таким ID
- Ссылка:
-
Интерфейс цен APIYI: актуальные коэффициенты и цена за единицу
- Ссылка:
api.apiyi.com/api/pricing - Описание: версия
shell-api-modelmak-v1; приmodel_ratio, равном1, это соответствует входной цене 2 доллара за миллион токенов, так можно пересчитать цену для каждой модели
- Ссылка:
-
Официальная документация и описание цен Google Gemini 4: уровни рассуждений, окно и прайс-лист
- Ссылка:
ai.google.dev - Описание: здесь можно узнать уровень рассуждений по умолчанию для каждого ID, доступные уровни, предельный размер окна API и время изменения цен
- Ссылка:
Автор: техническая команда APIYI
По техническим вопросам: свяжитесь с нами через главную страницу сайта APIYI; больше материалов о моделях и интерфейсах — в центре документации APIYI


