
Примечание автора: разбираем по отдельности официальные результаты GPT-6.2 Sol (самоотчёт OpenAI) и сторонний агрегированный балл, объясняем, где модель прибавила в повседневных задачах, а где просела в кодинг-агентах и фактической точности, плюс обзор прайса, правил тарификации и рекомендаций по выбору модели.
17 ноября 2026 года OpenAI одновременно выпустила GPT-6.2 Astra и GPT-6.2 Sol. При этом GPT-6.2 Sol переняла прайс-лист API у GPT-6.1 Sol, а результаты в повседневных задачах заметно подросли — многие не раздумывая ставят её моделью по умолчанию. Официальный анонс, системная карта и страница модели уже опубликованы, а Artificial Analysis в тот же день выдала и независимый агрегированный балл. Так что это никакие не слухи.
Это не статья, которая слово в слово пересказывает официальные бенчмарки. В тексте цифры разбиты на два набора — заявленные самой OpenAI и сторонние, — каждый подаётся отдельно, без сведения к единому выводу. Повседневные задачи и кодинг у GPT-6.2 Sol стоит оценивать раздельно: в первом модель действительно прибавила, а во втором одна из сторонних метрик на 3 балла ниже, чем у предыдущего поколения.
Главная ценность: дочитав статью, вы сможете решить, годится ли GPT-6.2 Sol в модель по умолчанию, и поймёте, в каких случаях нельзя ориентироваться только на агрегированный балл.
Ключевые моменты GPT-6.2 Sol
Сначала — таблица для быстрого чтения, ниже разберём каждый пункт подробнее. В каждой строке таблицы указан источник цифр: официально заявленные результаты и данные сторонних источников приведены раздельно.
| Пункт | Описание | Источник данных |
|---|---|---|
| Повседневные задачи | Балл LifeVal выше, чем у GPT-6 Astra, стоимость примерно в 7 раз ниже | Официально заявлено |
| Слияние кода | FrontierCode 2.0: отставание от GPT-6.2 Astra меньше 0,5 балла, стоимость примерно в 5 раз ниже, у обеих — режим Max | Официально заявлено |
| Общий балл | Intelligence Index v5.0.1: Max — 57, Xhigh — 56, High — 55, Medium — 53, Low — 41 | Artificial Analysis (сторонний источник) |
| Кодинг-агенты | Coding Agent Index на 3 балла ниже, чем у GPT-6.1 Sol, чаще пропускает ключевые факты | Artificial Analysis (сторонний источник) |
| Уровень галлюцинаций | Уровень галлюцинаций по AA-Omniscience (Max) — 55% | Artificial Analysis (сторонний источник) |
| Цены | Те же, что у GPT-6.1 Sol: вход — $2, выход — $10 (за 1 млн токенов) | OpenAI (официально) |
Подробный разбор GPT-6.2 Sol
Главный плюс нового поколения GPT-6.2 Sol можно описать формулой «за те же деньги — лучше справляется с повседневной работой». Официальные результаты по LifeVal и GDPval v2 указывают в одну сторону: в повседневных офисных задачах Sol уже обгоняет флагмана прошлого поколения GPT-6 Astra, при этом обходится заметно дешевле. Для тех, кто держит его в качестве модели по умолчанию, именно этот прогресс чувствуется сильнее всего.
Но и обратную сторону нужно проговорить честно. По данным независимой Artificial Analysis, Coding Agent Index у GPT-6.2 Sol на 3 балла ниже, чем у GPT-6.1 Sol, — больше всего баллов съел подвопрос, проверяющий умение отвечать на вопросы по кодовой базе. Уровень галлюцинаций по AA-Omniscience при этом достигает 55%. Так что «общий балл вырос» не значит «стал стабильнее во всём» — особенно в сценариях, где один упущенный факт оборачивается переделкой работы.
Ключевые возможности и характеристики GPT-6.2 Sol
У GPT-6.2 Sol идентификатор модели — gpt-6.2-sol. На вход модель принимает текст и изображения, на выходе даёт только текст — аудио и видео не поддерживаются. Контекстное окно — 1 050 000 токенов, максимальный ввод — 922 000, максимальный вывод — 128 000, срез знаний — 2026-06-01, то есть чуть позже, чем у Astra (2026-05-18). В API нельзя выставить reasoning effort в значение none — минимум доступен уровень Low.
В таблице ниже сравниваются официальные характеристики и цены Sol и Astra. Цены указаны для стандартного тарифа короткого контекста, за 1 млн токенов. Проверяя наличие моделей на площадках, мы сверились со сводной таблицей моделей APIYI apiyi.com (данные на 2026-11-17 15:54, UTC+8) и с публичным API с ценами — обе модели 6.2 там пока не появились.
| Параметр | gpt-6.2-sol | gpt-6.2-astra |
|---|---|---|
| Ввод / чтение кэша / вывод | $2 / $0.10 / $10 | $8 / $0.40 / $40 |
| Запись в кэш (30 минут / 12 часов) | $2.50 / $5 | $10 / $20 |
| Контекст / максимальный вывод | 1 050 000 / 128 000 | 1 050 000 / 128 000 |
| Срез знаний | 2026-06-01 | 2026-05-18 |
| Изменение цен | Такие же расценки, как у GPT-6.1 Sol | Ввод и вывод на 20% дешевле, чем у GPT-6 Astra, кэшированный ввод — на 60% дешевле |
| Доступные платформы | OpenAI API; на APIYI apiyi.com пока не добавлена | OpenAI API; на APIYI apiyi.com пока не добавлена |
Выше — официальные цены OpenAI. gpt-6.2-sol и gpt-6.2-astra на APIYI: пока не добавлены, мы разместим эти модели в ближайшее время; актуальные модели и цены смотрите в списке моделей на платформе.
Правила тарификации GPT-6.2 Sol
На странице модели перечислено несколько правил тарификации, общих для обеих моделей, — именно здесь и кроется основная разница в счетах:
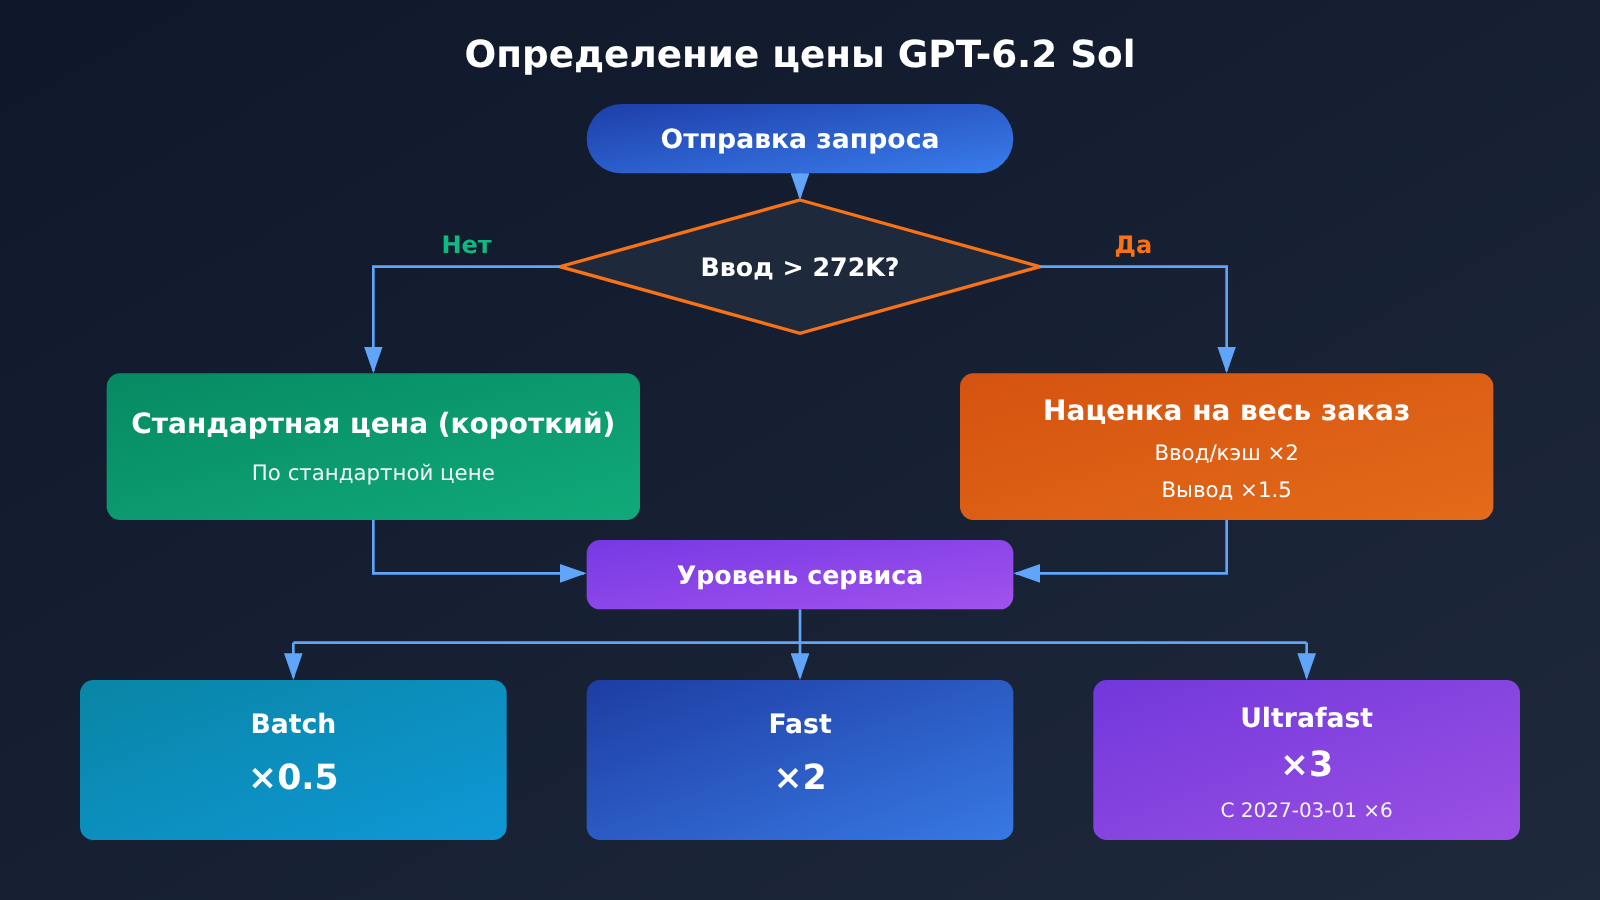
- Надбавка за длинный ввод на весь запрос: если ввод одного запроса превышает 272K токенов, цены на ввод и кэш удваиваются, вывод стоит в 1,5 раза дороже тарифа короткого контекста, причём весь запрос считается по этим ценам, а не только часть сверх порога.
- Batch: 50% от стандартной цены.
- Fast: двукратная стандартная цена при той же длине контекста.
- Ultrafast: до 2027-02-28 (по тихоокеанскому времени) — трёхкратная стандартная цена, с 2027-03-01 — шестикратная.
Что касается эндпоинтов, поддерживаются Chat Completions, Responses и Batch, а вот Realtime, Assistants, дообучение (fine-tuning), генерация изображений, видео и голос — нет. Иначе говоря, GPT-6.2 Sol — это диалоговая модель с текстовым выводом и возможностью рассуждений, подключается практически так же, как предыдущее поколение.
Данные тестирования GPT-6.2 Sol: повседневные задачи
В этом разделе мы опираемся только на официально заявленные цифры. В анонсе OpenAI у Sol есть два основных результата по повседневным задачам — в таблице ниже они приведены вместе с пунктами по кодированию для удобства сравнения. Но учтите: всё это OpenAI тестировала и публиковала сама.
| Тест | Категория | Результат GPT-6.2 Sol | Источник |
|---|---|---|---|
| LifeVal | Повседневные задачи (собственный набор OpenAI) | Выше, чем у GPT-6 Astra, при стоимости около одной седьмой | Самоотчёт OpenAI |
| GDPval v2 | Профессиональные рабочие задачи (внутренний тест OpenAI) | На 5,3 балла выше, чем у GPT-6.1 Sol | Самоотчёт OpenAI |
| FrontierCode 2.0 | Правки в реальных кодовых базах: принимаются ли они к слиянию | Отставание от GPT-6.2 Astra менее 0,5 балла при стоимости около одной пятой; у обеих — режим Max | Самоотчёт OpenAI |
| AA-3D | Слепая оценка Elo людьми | 1259 (Astra — 1318, Claude Fable 5.2 — 1271) | Самоотчёт OpenAI |
LifeVal — это собственный набор повседневных задач OpenAI. Согласно анонсу, Sol набирает больше, чем GPT-6 Astra, а обходится примерно в семь раз дешевле. GDPval v2 — внутренний тест OpenAI: Sol опережает GPT-6.1 Sol на 5,3 балла. Абсолютные баллы ни для одного из этих тестов не раскрыты, и в этой статье мы их вычислять не будем.
Оба результата говорят об одном: в такой повседневной работе, как написание писем, разбор материалов, составление таблиц и подготовка документов, GPT-6.2 Sol стоит как Sol, а выдаёт результат, близкий к прошлому флагману или даже его превосходящий. Правда, «официально собранный оценочный набор» по определению лучше подходит собственным моделям вендора, поэтому читателю надёжнее воспринимать эти цифры как индикатор направления, а не как точную меру.
Данные бенчмарков GPT-6.2 Sol: программирование
Показатели в программировании особенно важно рассматривать по отдельности, потому что официальные самоотчёты и сторонние тесты указывают в разные стороны. К тому же задачи они проверяют разные, поэтому разберём каждый ниже отдельно, не сводя всё к одному общему выводу.
Официальные данные: FrontierCode 2.0
FrontierCode 2.0 разработан компанией Cognition и проверяет, будут ли изменения, которые модель вносит в реальные кодовые базы, приняты мейнтейнерами. По официальным данным, разрыв между GPT-6.2 Sol и GPT-6.2 Astra — менее 0,5 балла, при этом Sol обходится примерно в одну пятую стоимости; при сравнении обе модели работали на уровне рассуждений Max. Для работы в духе «небольшие правки кода, отправка PR» это хорошая новость.
Данные третьих сторон: Coding Agent Index
Coding Agent Index от Artificial Analysis использует Codex harness и уровень рассуждений Max. Итог: Astra идёт вровень с GPT-6 Astra, а вот GPT-6.2 Sol на 3 балла ниже, чем GPT-6.1 Sol. По мнению авторов статьи, главная причина — подпункт SWE-Atlas-QnA-AA, где модель потеряла 14 баллов и стала чаще упускать ключевые факты.
Если поставить оба результата рядом, всё встаёт на свои места: FrontierCode 2.0 измеряет, «вливаются ли изменения», а SWE-Atlas-QnA-AA скорее проверяет, «удаётся ли полно ответить на вопросы о кодовой базе». GPT-6.2 Sol по первому близок к Astra, а по второму просел даже относительно собственной предыдущей версии. Если вашему кодинг-агенту приходится массово отвечать на вопросы вроде «где вызывается эта функция» и «какие модули затрагивает эта конфигурация», ориентироваться только на FrontierCode нельзя.
GPT-6.2 Sol: сторонние сводные баллы и уровень галлюцинаций
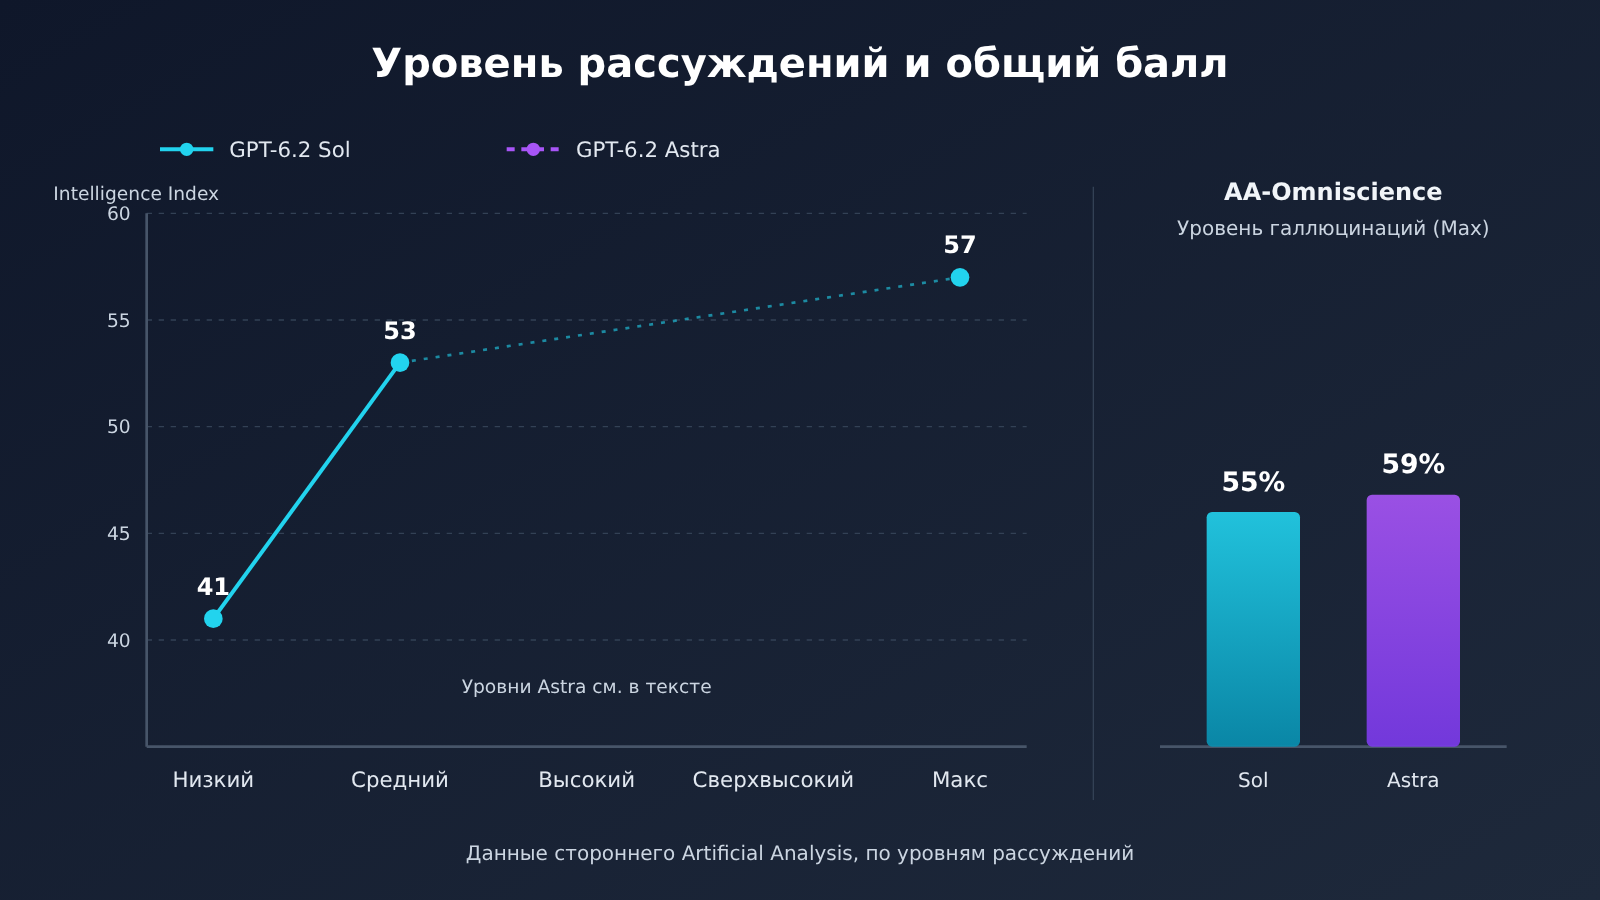
Artificial Analysis в Intelligence Index v5.0.1 выставляет баллы отдельно для каждого уровня рассуждений. Все цифры в таблице ниже — сторонние данные, и каждая ячейка соответствует своему уровню рассуждений: не сравнивайте Max у Sol с Medium у других моделей.
| Уровень рассуждений | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Max | 57 | 62 |
| Xhigh | 56 | 62 |
| High | 55 | 60 |
| Medium | 53 | 57 |
| Low | 41 | 46 |
| Стоимость одной задачи по сводному индексу (Max) | $1.01 | $4.00 |
В той же статье Claude Fable 5.2 с максимальным уровнем 65 занимает первое место, Gemini 4 Carbon — 60, Claude Opus 5.5 — 59. Max-показатель GPT-6.2 Sol — 57 баллов: на 2 балла выше, чем у GPT-6.1 Sol, и наравне с GPT-6 Astra, при этом стоимость одной задачи — около 15% от её уровня у GPT-6 Astra. Так что Sol не сильнее Astra по всем фронтам: его сильная сторона в том, что он «догнал флагман прошлого поколения за меньшие деньги».
Разрыв между уровнями рассуждений тоже заслуживает внимания. У Sol балл падает с 53 на Medium до 41 на Low — минус 12 пунктов, а API не даёт полностью отключить рассуждения: Low — минимальный уровень. Если в повседневной работе по умолчанию ставить Low ради экономии, вы получите уже не ту модель, что набирает 57 баллов.
Уровень галлюцинаций GPT-6.2 Sol
По уровню галлюцинаций AA-Omniscience (Max) GPT-6.2 Sol показывает 55%, Astra — 59%. Цифра у Sol чуть ниже, но у обеих моделей она выше половины: это значит, что когда модель не уверена в ответе, она с немалой вероятностью выдаст звучащий уверенно неверный результат. В сочетании с приведённым выше отставанием на 14 баллов в SWE-Atlas-QnA-AA для задач вопрос-ответ, где важна точность фактов, понадобятся дополнительные этапы поиска или перепроверки.
Уровни безопасности GPT-6.2 Sol и доступность
По фреймворку подготовки OpenAI (Preparedness Framework) и GPT-6.2 Sol, и Astra достигли «критического» уровня по кибербезопасности, а по биологии и химии — «высокого». При этом официально о достижении высокого порога «самоулучшения ИИ» говорится только про Astra — Sol в этой строке нет. Соответственно, защита стала строже: часть вполне легитимных запросов на исследование уязвимостей теперь тоже будет отклоняться, так что тем, кто работает в сфере безопасности, стоит быть к этому готовым.
Программа Daybreak для защитников сейчас предлагает Alpha-версию GPT-6 Astra, GPT-6 Sol в Daybreak Blue и GPT-6 Cyber в Daybreak Red. В OpenAI говорят, что постараются добавить в Daybreak и 6.2, но пока этого не произошло. Что касается выравнивания (alignment), большинство оценок близки к GPT-6 Astra, а неуместных действий в смоделированной рабочей обстановке стало меньше; правда, в двух тестах модель чаще пропускала блокирующие проблемы — например, отсутствующий файл или недоступный поисковый инструмент. В Codex после добавления инструкций такие пропуски заметно сократились.
Теперь о доступности: тарифы Plus, Pro, Enterprise и Edu могут пользоваться моделью в ChatGPT Work и Codex уже сегодня. Владельцы Pro 500 могут включить Ultrafast для обеих моделей, Pro 200 впервые получает Ultrafast — сначала для GPT-6.2 Sol; на подходящих тарифах Enterprise и Edu это должен активировать администратор рабочего пространства. Разработчикам — через OpenAI API: обе модели поддерживают Ultrafast уже на момент запуска.
Анализ преимуществ и недостатков GPT-6.2 Sol
Преимущества
- Выгодно для повседневных задач: по официальным данным, LifeVal выше, чем у GPT-6 Astra, а затраты — примерно в семь раз ниже; в GDPval v2 модель на 5,3 балла обошла GPT-6.1 Sol.
- Цена прежняя: прайс такой же, как у GPT-6.1 Sol, — обновление не поднимает стоимость.
- Слияние кода почти на уровне Astra: по официальным данным, в FrontierCode 2.0 разрыв с Astra составляет менее 0,5 балла, а затраты — примерно в пять раз ниже.
- Общий балл догнал флагман прошлого поколения: в стороннем тесте Max модель набрала 57 баллов — наравне с GPT-6 Astra, при этом одна задача обходится примерно в 15% от её стоимости.
Ограничения
- Регресс в работе кодинг-агентов: в стороннем Coding Agent Index модель отстаёт от GPT-6.1 Sol на 3 балла, а в SWE-Atlas-QnA-AA — на 14. Возможное решение — усилить ответы на вопросы по кодовой базе поиском по документам и перекрёстной проверкой.
- Повышенный уровень галлюцинаций: в AA-Omniscience доля галлюцинаций достигает 55%, поэтому в задачах, чувствительных к фактам, нужны ссылки на источники или проверка человеком.
- Заметная просадка в режиме Low: на низком уровне рассуждений — всего 41 балл, а полностью отключить рассуждения нельзя, так что при оптимизации затрат придётся искать компромисс.
- Более строгие механизмы безопасности: часть легитимных исследований уязвимостей будет отклоняться, а в Daybreak модель 6.2 пока недоступна.
Быстрый старт с GPT-6.2 Sol
Подключение GPT-6.2 Sol устроено так же, как у предыдущего поколения: подойдёт и Chat Completions, и Responses. В качестве имени модели указывайте gpt-6.2-sol, а уровень рассуждений (reasoning effort) выбирайте из диапазона от Low до Max — none передавать не нужно. Если вы уже работаете с OpenAI-совместимым интерфейсом, смена модели обычно сводится к правке одного параметра.
Когда модель появится на APIYI, достаточно установить base_url в OpenAI SDK на https://api.apiyi.com/v1, вписать API-ключ APIYI и поменять model на gpt-6.2-sol — актуальное имя модели всегда сверяйте со списком моделей на платформе. Пока же на платформе уже доступна gpt-6.1-sol с ценами: $2 за вход, $10 за выход и $0.1 за чтение кэша, а при объёме ввода свыше 272 000 токенов ставка входа составляет $4. Её можно взять, чтобы отладить пайплайн, но это не 6.2, и её цены нельзя переносить на 6.2.
Выбор модели удобно разбить по типам задач — в таблице ниже собраны рекомендации, и все они опираются на публичные данные из предыдущих разделов:
| Сценарий задачи | Рекомендация | Обоснование |
|---|---|---|
| Письменные задачи, структурирование информации, офисная рутина | Можно сначала рассматривать GPT-6.2 Sol как модель по умолчанию | Официальные результаты LifeVal, GDPval v2 |
| Небольшие правки кода, отправка PR | GPT-6.2 Sol подходит; приоритет, когда важна экономия | Официальные результаты FrontierCode 2.0 |
| Вопросы по кодовой базе, длинные цепочки кодинг-агентов | Не смотрите только на общие баллы — сначала сравните на своём репозитории | Сторонний Coding Agent Index ниже на 3 балла |
| Вопросы, где пропуск одного факта обходится дорого | Добавьте поиск и проверку фактов, при необходимости — кросс-проверку несколькими моделями | Сторонний уровень галлюцинаций 55% |
| Сверхдлинный ввод (более 272K) | Сначала прикиньте итоговую стоимость с учётом надбавки | Правила тарификации на официальной странице модели |
🚀 Совет по началу работы: для повседневных задач GPT-6.2 Sol вполне может стать моделью по умолчанию, но там, где цена пропущенного факта высока, не полагайтесь только на общие баллы. На APIYI (apiyi.com) с одним и тем же API-ключом можно сравнить уже доступные модели —
gpt-6.1-sol,claude-opus-5-5,gemini-4-carbonи другие. Сначала прогоните их на своих задачах, а когда выйдет 6.2, подключите её и сравните результаты.
Часто задаваемые вопросы (FAQ)
Q1: Какое позиционирование у модели GPT-6.2 Sol?
GPT-6.2 Sol — одна из самых недорогих моделей в серии 6.2, которую OpenAI выпустила 17 ноября 2026 года (2026-11-17). Идентификатор модели — `gpt-6.2-sol`: на вход принимает текст и изображения, на выходе — текст; контекст — 1 050 000 токенов, срез знаний — 2026-06-01. Позиционируется как универсальная модель с упором на соотношение цена/качество, вышедшая в один релиз с более дорогой GPT-6.2 Astra.
Q2: В чём GPT-6.2 Sol сильнее и слабее GPT-6.1 Sol?
Официальные цены совпадают. По данным, заявленным самой OpenAI, GDPval v2 — на 5,3 балла выше; по стороннему Intelligence Index в категории Max — на 2 балла выше, до 57. Однако сторонний Coding Agent Index на 3 балла ниже — в основном из-за SWE-Atlas-QnA-AA, который просел на 14 баллов: модель чаще пропускает ключевые факты. С повседневными задачами прогресс, а вот ответы на вопросы по кодовой базе в кодинг-агентах стали хуже.
Q3: GPT-6.2 Sol лучше, чем GPT-6.2 Astra?
Не совсем. По сторонним сводным оценкам Astra опережает на всех уровнях рассуждений — в категории Max это 62 против 57. Преимущество Sol — стоимость: по официальным данным, разница во FrontierCode 2.0 с Astra меньше 0,5 балла, а цена примерно впятеро ниже; сторонняя оценка стоимости одной задачи — $1.01 против $4.00.
Q4: Какая официальная цена у GPT-6.2 Sol?
Официальная стандартная цена OpenAI для короткого контекста: вход — $2, чтение из кэша — $0.10, запись в кэш на 30 минут — $2.50, выход — $10 (за 1 млн токенов). Если на входе больше 272K токенов, весь запрос тарифицируется по повышенным ставкам. APIYI: модель пока не добавлена на платформу, мы разместим её как можно скорее; актуальные названия моделей и цены смотрите в списке моделей на платформе.
Q5: Как провести сравнительное тестирование через API, пока 6.2 нет на платформе?
Можно заранее выстроить процесс на уже доступных моделях:
1. Зарегистрируйтесь на APIYI (apiyi.com) и получите API-ключ и бесплатный тестовый лимит
2. Вызывайте доступные модели, например `gpt-6.1-sol` и `gpt-6-astra`, через OpenAI-совместимый интерфейс
3. Когда появится 6.2, достаточно будет поменять параметр `model` для A/B-сравнения
Обратите внимание: `gpt-6-sol` и `gpt-6.1-sol` — это не 6.2, и их цены не взаимозаменяемы.
Q6: Цена Gemini 4 Carbon такая же, как у Sol. Как выбрать?
Официальная стандартная цена Gemini 4 Carbon до 2026-11-30: вход — $2, выход — $10; с 2026-12-01 она становится $4 / $20. Максимальный сторонний сводный балл — 60. У `gemini-4-carbon` на APIYI (apiyi.com) сейчас указана вводная (промо) цена, после 1 декабря ориентируйтесь на список моделей на платформе. Модель поддерживает ввод видео и аудио, но не имеет эндпоинта Responses — выбирайте исходя из типа входных данных и нужного интерфейса.
Q7: Можно ли использовать GPT-6.2 Sol для исследования уязвимостей?
Она получила «критический» уровень опасности в кибербезопасности, поэтому защитные фильтры стали жёстче: часть легитимных запросов на исследование уязвимостей будет отклоняться. Для оборонительного Daybreak версии 6.2 пока нет — официально сообщили лишь, что постараются её добавить.
GPT-6.2 Sol: ключевые выводы
- Заметный прогресс в повседневных задачах: по официально заявленным результатам, LifeVal выше, чем у GPT-6 Astra, а стоимость — примерно одна седьмая.
- Цены не изменились: прайс тот же, что у GPT-6.1 Sol — $2 за вход, $10 за выход.
- Кодинг почти догнал Astra: по официальным данным, разрыв в FrontierCode 2.0 — меньше 0,5 балла.
- Комплексный балл третьих сторон: Max 57, Xhigh 56, High 55, Medium 53, Low 41.
- Кодинг-агенты просели: сторонний Coding Agent Index на 3 балла ниже, чем у 6.1 Sol, модель склонна упускать факты.
- Частота галлюцинаций — 55%: в вопросах, чувствительных к фактам, обязательно добавляйте поиск по источникам и перепроверку.
- Как опробовать: до появления 6.2 в каталоге на APIYI (apiyi.com) можно заранее настроить процесс сравнения на уже доступных моделях.
Итоги
Ключевые моменты GPT-6.2 Sol:
- Повседневные задачи: официально заявленные результаты LifeVal и GDPval v2 показывают прогресс — по цене Sol вы получаете повседневную производительность, близкую к флагману прошлого поколения.
- Кодинг стоит оценивать отдельно: официально заявленный FrontierCode 2.0 близок к Astra, но сторонний Coding Agent Index на 3 балла ниже, чем у GPT-6.1 Sol, а при ответах на вопросы по кодовой базе факты теряются чаще.
- Общий балл — ещё не всё: сторонний Max 57 сравнялся с GPT-6 Astra, но уровень галлюцинаций 55% и 41 балл в Low-режиме напоминают: нельзя ориентироваться только на одну цифру.
Если ваша повседневная работа — это в первую очередь тексты, структурирование информации и офисные задачи, GPT-6.2 Sol стоит первым кандидатом на роль модели по умолчанию. Если же вы полагаетесь на кодинг-агентов для ответов по кодовой базе, и один упущенный факт означает переделку работы, лучше сначала сравнить модель на собственных задачах. Рекомендуем через APIYI (apiyi.com) с одним и тем же API-ключом сравнить доступные на платформе модели, а после выхода 6.2 — переключиться и перепроверить.
📚 Справочные материалы
-
Публикация OpenAI: официальное представление GPT-6.2 Astra и Sol с самостоятельно заявленными оценками
- Ссылка:
openai.com/index/introducing-gpt-6-2-astra-sol - Описание: источник официально заявленных результатов LifeVal, FrontierCode 2.0, GDPval v2 и других
- Ссылка:
-
Страница модели OpenAI: характеристики и цены gpt-6.2-sol
- Ссылка:
platform.openai.com/docs/models/gpt-6.2-sol - Описание: контекстное окно, дата актуальности знаний, надбавка 272K за весь заказ и правила Batch, Fast, Ultrafast
- Ссылка:
-
Системная карта OpenAI: классы безопасности и оценка alignment
- Ссылка:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Описание: уровень «критический» для кибербезопасности, «высокий» для биохимии и описание мер защиты
- Ссылка:
-
Статья Artificial Analysis: сторонний общий балл и индекс кодинг-агентов
- Ссылка:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Описание: Intelligence Index по каждому режиму рассуждений, Coding Agent Index и уровень галлюцинаций
- Ссылка:
-
Страница модели Artificial Analysis: стоимость одной задачи для GPT-6.2 Sol
- Ссылка:
artificialanalysis.ai/models/gpt-6-2-sol - Описание: сторонние данные, включая стоимость одной задачи по общему индексу
- Ссылка:
-
Общая таблица моделей APIYI: модели на платформе и их цены
- Ссылка:
docs.apiyi.com/models.md - Описание: проверить, доступна ли 6.2 в продаже, и цены актуальных моделей
- Ссылка:
Автор: техническая команда APIYI
Технический контакт: будем рады вашему обращению через главную страницу сайта APIYI, больше материалов — в центре документации docs.apiyi.com


