
Примечание автора: мультимодельные приложения должны работать через единый формат сообщений, слой адаптации под каждого провайдера и реестр возможностей моделей — так проще уживаться с различиями в вызове инструментов, состоянии рассуждений, потоковом выводе, структурированных данных и кэшировании.
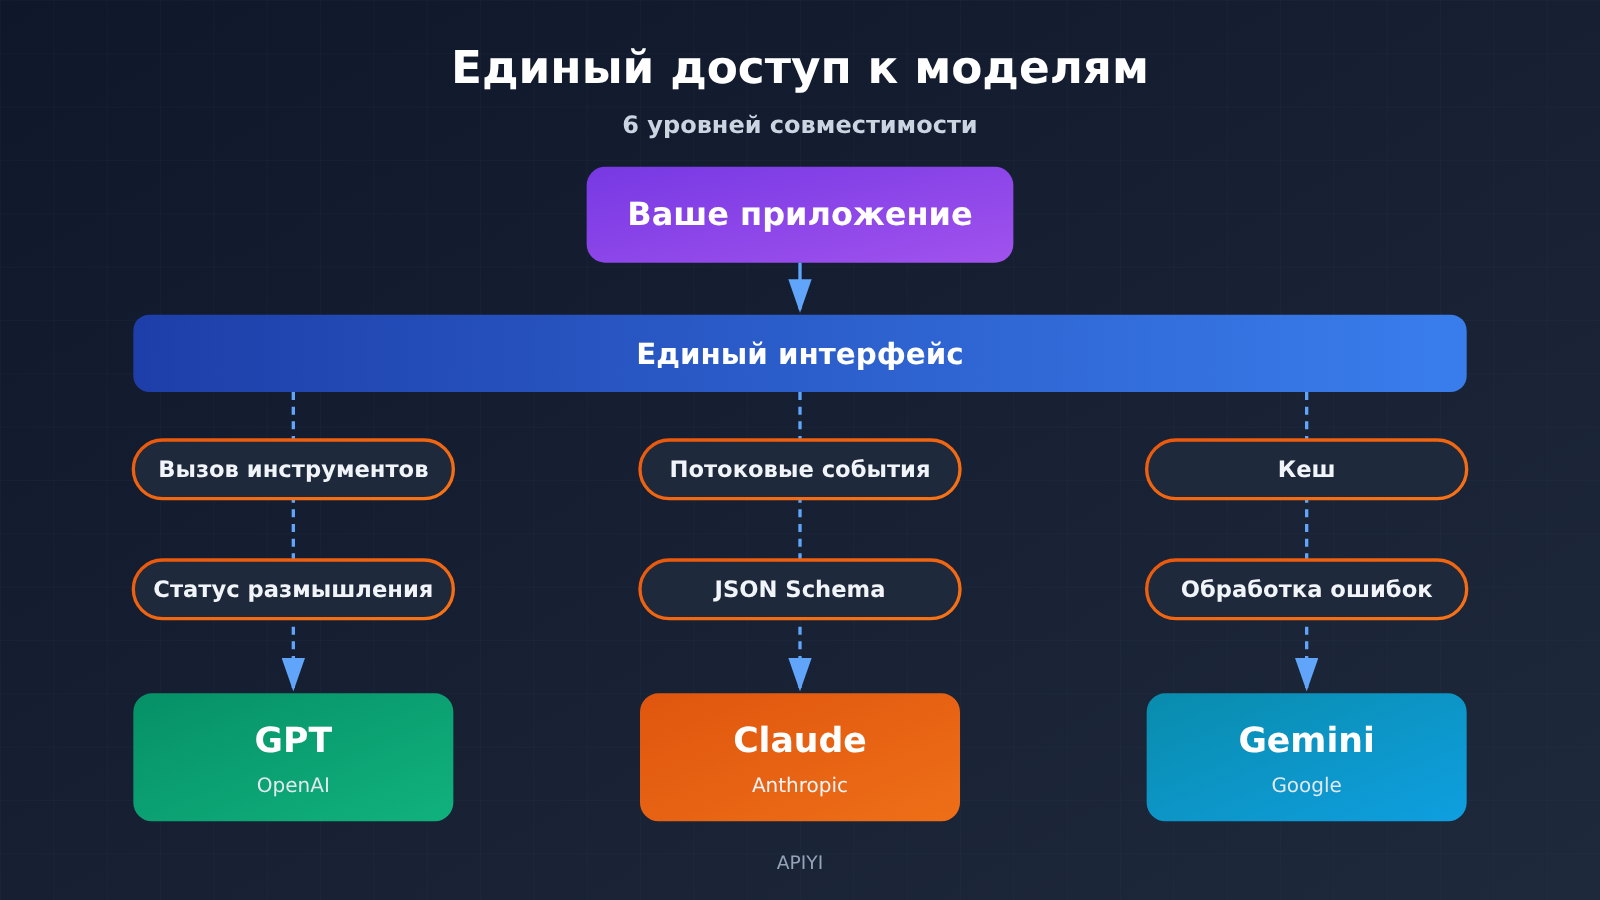
GPT, Claude и Gemini все справляются с обычным текстовым вызовом, а Claude и Gemini ещё и предоставляют официальные точки входа, совместимые с OpenAI SDK. Когда продакшен-приложение переключается между моделями, приходится решать 6 классов проблем совместимости: роли сообщений и системные инструкции, протокол вызова инструментов, параметры рассуждений и состояние «размышления», потоковые события, структурированный вывод и мультимодальность, кэширование, биллинг и обработка ошибок. Если просто заменить Model ID, простые вопросы-ответы заработают, а вот многораундовый вызов инструментов, восстановление после обрыва потока и подсчёт стоимости потребуют отдельной работы. Довольно надёжный инженерный подход — «единый бизнес-интерфейс + слой адаптации провайдеров (Provider Adapter) + реестр возможностей моделей». Тогда переключение модели становится нормальной продуктовой функцией, которую можно поддерживать.
Ниже сначала сравним структурные различия нативных API всех трёх вендоров и разберём, какие сценарии покрывает OpenAI-совместимый интерфейс. Затем по очереди распишем, какие реальные сбои вызывают 6 классов проблем совместимости, дадим шестиуровневую архитектуру подключения и рабочий код унифицированного вызова. В конце — шесть тестов совместимости перед запуском и объяснение того, как разделить обязанности между единым API-шлюзом и адаптацией нативных возможностей.
To Know: глоссарий терминов совместимости API для мультимодельных сервисов
| Термин | Объяснение |
|---|---|
| API | Интерфейс, через который приложение отправляет запросы к сервису модели и получает результаты. |
| SDK | Комплект средств разработки, инкапсулирующий детали вызовов API. |
| Нативный API | Основной интерфейс, разработанный самим производителем, например OpenAI Responses, Claude Messages, Gemini Interactions. |
| Совместимый интерфейс | Точка входа адаптера, использующая другой формат запросов (обычно формат OpenAI), чтобы сервис можно было вызывать через один и тот же SDK. |
| Вызов функций (Function Calling) | Модель с помощью структурированных параметров просит приложение выполнить внешнюю функцию. |
| ID вызова | Идентификатор, сопоставляющий запрос инструмента, инициированный моделью, с результатом выполнения, возвращённым приложением. |
| Подпись размышлений (Thought / Thinking Signature) | Зашифрованные данные состояния, которые некоторые модели используют для сохранения контекста рассуждений и вызова инструментов; их необходимо возвращать в исходном виде. |
| Потоковый вывод (Streaming) | Сервер возвращает результат по событиям частями, а фронтенд может отображать его по мере поступления. |
| JSON Schema | Спецификация, описывающая структуру данных JSON и правила валидации. |
| Кэширование промптов (Prompt Caching) | Повторное использование результатов вычислений для повторяющегося входного префикса, чтобы снизить задержку и затраты. |
| TTL | Время жизни кэша; после истечения срока данные нужно записать заново. |
| Адаптер провайдера (Provider Adapter) | Компонент, который преобразует унифицированный запрос в нативный формат конкретного производителя, а затем преобразует ответ обратно в унифицированный формат. |
| Реестр возможностей | Конфигурационный список, в котором фиксируется, какие параметры и функции фактически поддерживает каждая модель и каждый эндпоинт. |
| Идемпотентность | Свойство, при котором однократное и многократное выполнение одной и той же операции даёт одинаковый результат; используется, чтобы повторные попытки не приводили к повторному списанию средств или повторной отправке сообщений. |
1 Совместимость API разных моделей: почему при смене модели нельзя ограничиться сменой Model ID
Все три провайдера позволяют указать модель через одно поле model, но структура тела запроса, объекта ответа и состояния контекста у них разная. В обычном Q&A различия сводятся к именам полей, и стоимость адаптации невелика. А вот в приложениях класса Agent, где всё держится на вызове инструментов, состоянии рассуждений и потоковых событиях, эти различия превращаются в реальные сбои в продакшене.
1.1 Сравнение нативных API GPT, Claude и Gemini
Таблица ниже описывает только нативные API — без каких-либо слоёв совместимости и шлюзов.
| Аспект | OpenAI (нативно) | Claude (нативно) | Gemini (нативно) |
|---|---|---|---|
| Основной интерфейс | Responses API, /v1/responses |
Messages API, /v1/messages |
Interactions API (GA в июне 2026, официально рекомендован для новых проектов); generateContent по-прежнему поддерживается |
| Организация ввода | model + input |
model + messages + max_tokens, system вынесен отдельно от массива сообщений |
Нативная структура Interactions, плюс правила system_instruction |
| Структура вывода | Выходные элементы разных типов: текст, элементы reasoning, function_call и т.д. |
content blocks: text, thinking, tool_use и т.д. |
steps: вывод модели, вызовы инструментов, шаги рассуждений и т.д. |
| Определение завершения | Событие завершения ответа / тип выходного элемента | stop_reason (нормальное завершение, требуется выполнить инструмент и т.д.) |
Тип шага и состояние взаимодействия |
| Продолжение контекста | previous_response_id |
Приложение само возвращает полную историю сообщений | previous_interaction_id, опционально — состояние сессии на стороне сервера |
| Встроенные инструменты | Платформенные инструменты + пользовательские функции | В основном пользовательские инструменты | Встроенные инструменты Google Search, URL Context, выполнение кода и т.д.; сторонние инструменты выполняет приложение |
Из таблицы видно, что три провайдера расходятся уже в том, «кто хранит контекст». OpenAI и Gemini поддерживают продолжение контекста на стороне сервера, а в Claude Messages историю возвращает само приложение. Если хранилище сессий в приложении построено только под один из этих вариантов, то при переключении на другого провайдера контекст либо потеряется, либо будет отправляться повторно.
1.2 Сколько проблем способен решить OpenAI-совместимый интерфейс
И Claude, и Gemini предлагают точку входа, совместимую с OpenAI SDK. Официальный endpoint совместимости у Gemini — generativelanguage.googleapis.com/v1beta/openai/: при использовании клиента OpenAI достаточно изменить base_url, API Key и model. А документация по совместимости у Claude явно ограничивает поддерживаемый объём; известные на 2026-11-13 ограничения таковы:
- Параметр
strictв определениях инструментов игнорируется, из-за чего строгие ограничения на параметры инструментов перестают работать. - Prompt Caching не поддерживается.
- Входные данные типов audio и file не поддерживаются.
- Сообщения
systemиdeveloperподнимаются в начало и обрабатываются объединённо. - Поля, связанные с
thinking, отличаются от нативного API.
Совместимый интерфейс подходит для трёх сценариев: обычный чат, однораундовая генерация и быстрое сравнение качества ответов разных моделей. А вот миграция сложных Agent’ов включает строгие параметры инструментов, кэширование, файловый ввод и состояние рассуждений на нескольких раундах — такие возможности требуют возврата к нативному API либо поэлементной проверки перед выкладкой в прод. Практичный критерий для оценки: если функция, от которой зависит приложение, встречается только в нативной документации, заносите её в реестр возможностей и передавайте на обработку отдельному адаптеру.
2. Шесть типов проблем совместимости, которые чаще всего возникают при переключении между моделями GPT, Claude и Gemini
2.1 Совместимая обработка ролей сообщений и системных инструкций
OpenAI различает роли вроде developer и system. У Claude системная инструкция system находится вне массива сообщений. Gemini использует system_instruction, а у пользовательского и модельного контента свои правила структуры. Все три выражают одно и то же — «приоритет инструкций + многораундовая история», — но поля, в которых это хранится, у всех разные.
Типичная ошибка — ленивая склейка: системную инструкцию, историю сообщений и результаты инструментов сваливают в одну длинную строку и передают модели как пользовательский ввод. Работать-то оно работает, но приоритет инструкций ослабляется, и модель может воспринять вывод инструмента из истории как новое требование пользователя. Правильный подход — сохранять семантику ролей внутри приложения, а маппинг в поля каждого производителя поручать адаптеру. Кроме того, учтите: слой совместимости Claude объединяет system и developer, поэтому дизайн промптов, завязанный на их разделение, нужно проверять на практике.
2.2 Протокол вызова инструментов и совместимость с ID вызовов
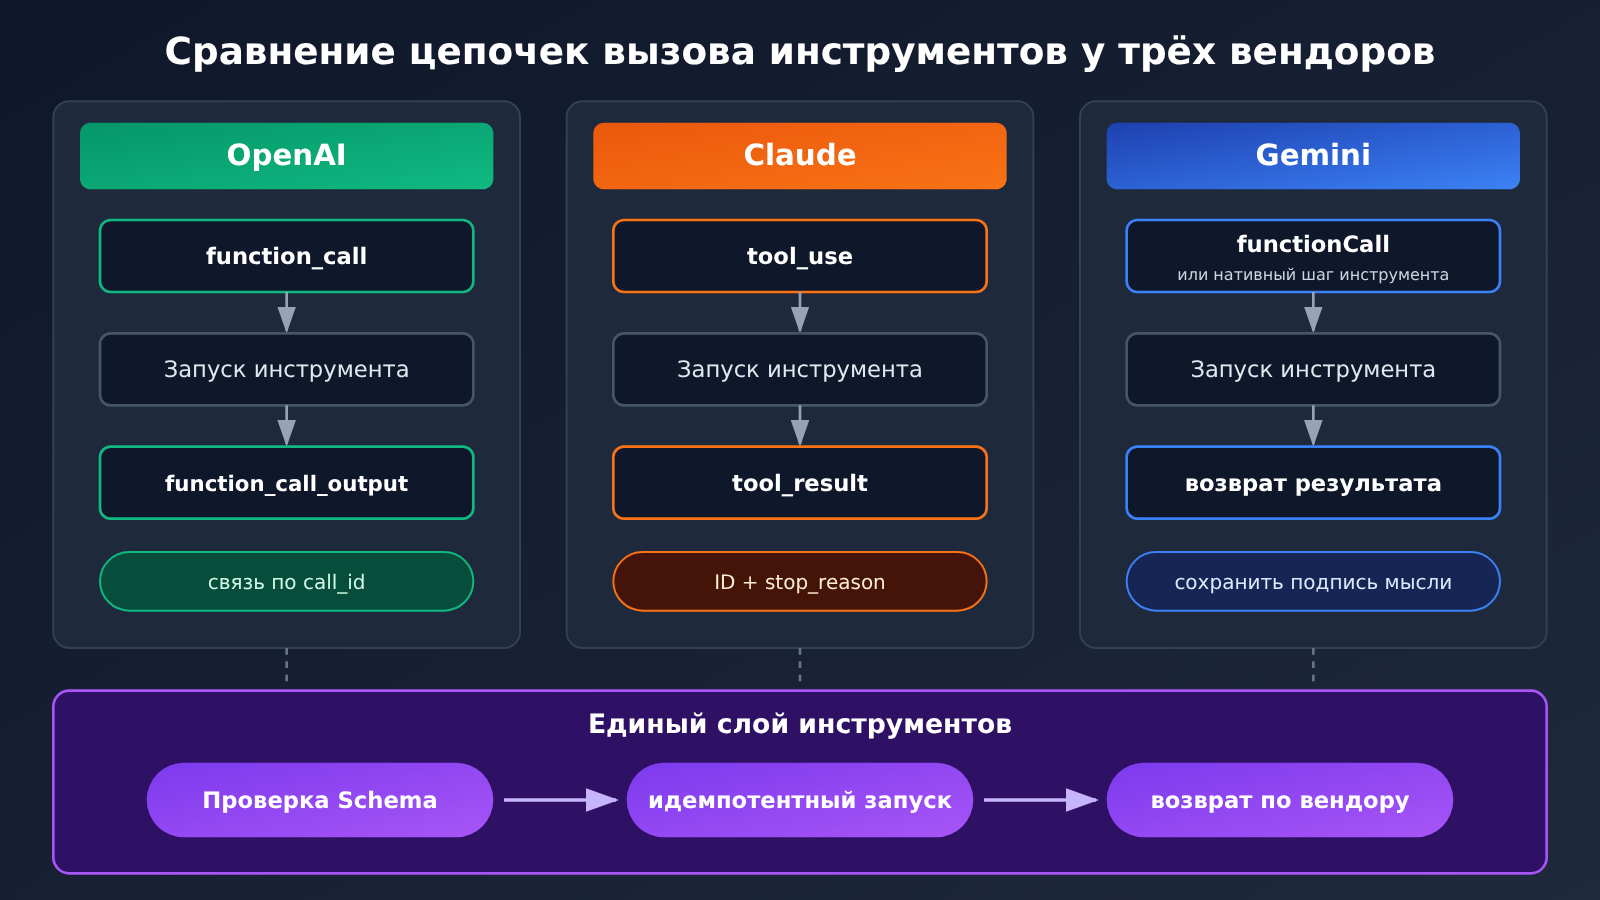
Все три провайдера поддерживают Function Calling, и цепочка вызовов выглядит так:
| Этап | OpenAI | Claude | Gemini |
|---|---|---|---|
| Модель инициирует вызов | выходной элемент function_call |
блок содержимого tool_use |
functionCall / нативный шаг инструмента |
| Связанный идентификатор | call_id |
ID из tool_use |
соответствующий идентификатор вызова |
| Ответ приложения | function_call_output |
блок содержимого tool_result |
соответствующая структура возврата результата |
| Нужно ли продолжать | определяется по выходному элементу | stop_reason указывает на необходимость выполнить инструмент |
определяется по статусу шага |
| Состояние рассуждения | элементы reasoning, возможно, нужно передавать вместе с историей | блоки thinking, возможно, нужно возвращать как есть | в stateless-режиме нужно сохранять блоки thought и подпись |
Уровень инструментов должен полностью хранить шесть элементов информации: ID вызова, имя функции, JSON параметров, связи между параллельными вызовами, результат выполнения и то, требует ли модель продолжения рассуждения. Параллельные вызовы — самое частое место ошибок. Модель за один раз инициирует несколько запросов к инструментам, а приложение возвращает только один из результатов или сопоставляет результаты с ID неправильно — и в следующем запросе появляется ошибка параметров, либо модель продолжает отвечать на основе неверных данных.
Рекомендую в уровне инструментов сначала проверять параметры с помощью JSON Schema и только после успешной проверки выполнять реальные внешние операции. Параметры, которые генерирует модель, не всегда валидны, и предварительная проверка позволяет перехватить ошибку ещё до «вызова внешней системы».
2.3 Совместимость режимов рассуждения и состояния контекста
Названия и смысл параметров рассуждения у трёх провайдеров не совпадают:
- OpenAI: использует параметры вроде
reasoning.effort. GPT-6 Astra и GPT-6.1 Sol не принимаютreasoning.effort=none, а вызов инструментов в этих двух моделях также требует Responses API. - Claude: модели нового поколения в основном работают через Adaptive Thinking с конфигурацией рассуждения на основе effort. Часть новых моделей уже не поддерживает старый ручной режим рассуждения с фиксированным
budget_tokens. - Gemini: разные модели используют thinking level или budget — и возможность отключить рассуждение, и доступные уровни зависят от модели. Правила маппинга параметров у нативного API и у OpenAI-совместимого входа тоже различаются.
Когда в интерфейсе продукта вы проектируете три уровня интенсивности рассуждения — «быстрый, стандартный, глубокий», — названия уровней выражают намерение продукта. Адаптеру нужно преобразовать их в параметры, которые реально поддерживает каждая модель, при этом вычислительные ресурсы, получаемые тремя провайдерами на одном и том же уровне, тоже различаются. Кроме того, видимая пользователю сводка рассуждения может не совпадать с фактическим числом оплачиваемых токенов рассуждения — в статистике затрат нужно ориентироваться на поля usage, возвращаемые интерфейсом.
Зашифрованное состояние в многоходовых вызовах инструментов — самое часто упускаемое место в длинных Agent-сценариях:
- Элементы reasoning и вызовы инструментов в OpenAI Responses, возможно, нужно передавать дальше вместе с историей.
- Блоки
thinking/redacted_thinkingв Claude могут содержать зашифрованное состояние — при возврате после выполнения инструментов нужно сохранять исходную структуру. - Stateless-режим Gemini Interactions требует сохранять thought-блоки и подписи как есть; при использовании stateful-режима часть состояния может поддерживаться на стороне сервера.
Если сохранять только тот текст, что отображается в окне чата, полностью восстановить историю рассуждений модели не получится. Типичный сбой: Agent внезапно падает с ошибкой после третьего вызова инструментов или начинает повторять уже выполненные шаги. Причина обычно в том, что на каком-то промежуточном ходе потерялся блок подписи.
2.4 Унификация потоковых событий Streaming
У трёх провайдеров типы потоковых событий, их порядок и сигналы завершения заметно различаются. OpenAI Responses может выдавать response.output_text.delta, приращения вызовов инструментов и событие завершения response. Поток Claude Messages использует события message_start, content_block_delta, message_delta и другие. А нативный API Gemini работает со своей структурой вывода и шагов.
Если фронтенд разбирает сырые события провайдеров напрямую, то при каждом подключении новой модели приходится переписывать фронтенд-код. Поэтому лучше, чтобы бэкенд приводил всё к единому внутреннему протоколу событий:
| Внутреннее событие | Значение | На что обратить внимание |
|---|---|---|
text_delta |
приращение текста | просто дописывать в отображение |
reasoning_summary |
краткое изложение рассуждений | можно показывать в сворачиваемом виде; тарификация — по usage |
tool_call_start |
начало вызова инструмента | записать ID вызова и имя функции |
tool_call_args |
фрагмент аргументов | склеивать по ID вызова или индексу; разбирать можно только после получения всех частей |
tool_result |
результат выполнения инструмента | соответствует ID вызова один к одному |
usage |
статистика расхода | различать входные, кэшированные, «мыслительные» и выходные токены |
completed |
нормальное завершение | должен прийти явный сигнал завершения |
error |
ошибка или обрыв потока | различать повторяемые и неповторяемые случаи |
В потоковой обработке есть три частых места отказа. Первое: фрагменты аргументов нескольких вызовов инструментов приходят вперемешку, и если склеивать их в порядке поступления, вызовы перепутаются. Второе: JSON-аргументы разрезаются в произвольных местах, и попытка разобрать их, получив лишь половину, выбросит исключение. Третье: соединение обрывается на полпути, а событие завершения так и не приходит — интерфейс навсегда застревает в состоянии «генерация». Слой преобразования должен явно обрабатывать все эти три ситуации.
2.5 Структурированный вывод JSON Schema и различия в мультимодальных возможностях
Все три решения предоставляют возможность структурированного вывода, но поддерживаемые возможности JSON Schema, строгий режим и способы комбинирования с вызовом инструментов различаются. Claude официально разделяет два механизма: JSON outputs задаёт структуру финального ответа, а Strict tool use — структуру параметров вызова инструментов. Некоторые модели при использовании строгого формата создают дополнительные накладные расходы на компиляцию или кэширование схемы.
С инженерной точки зрения рекомендация такая: приложение поддерживает собственную стандартную JSON Schema и фиксирует в реестре возможностей, какие свойства схемы поддерживает каждая модель. Для неподдерживаемых свойств адаптер выполняет понижающее преобразование. Как бы строго ни заявляла себя модель, на стороне приложения всё равно нужно делать дополнительную проверку, а при неудаче — переходить в контролируемый процесс повторных попыток или сообщения об ошибке.
С мультимодальностью та же история. Формулировка «поддерживает ввод изображений» описывает лишь категорию возможностей; конкретно нужно сравнивать ещё и следующее: допустимые типы файлов, размер и количество изображений, поддержку видео и аудио, способ загрузки файлов, верхний предел длинного контекста и фактически доступный диапазон, максимальное количество выходных токенов, а также возможность комбинировать вызов инструментов с мультимодальным вводом. То, что слой совместимости Claude не поддерживает ввод audio и file, — как раз конкретное ограничение, которое нужно записать в реестр.
2.6 Межмодельные различия в кэшировании, биллинге и обработке ошибок
Механизмы кэширования промптов у всех трёх провайдеров заметно различаются:
- OpenAI: GPT-5.6 и последующие модели поддерживают неявное кэширование и явные точки останова кэша; TTL бывает двух видов — 30 минут и 12 часов.
- Claude: через
cache_controlзадаётся автоматическое или явное кэширование, поддерживаются режимы на 5 минут и на 1 час; в OpenAI-совместимом слое эта возможность не поддерживается. - Gemini: новые модели предоставляют автоматическое неявное кэширование, а некоторые API и модели позволяют явно создавать объекты кэша.
После переключения модели кэш прежнего провайдера обычно уже не используется. Если в середине сессии перейти с Claude на Gemini, первый запрос будет оплачен по полному объёму входных данных. Если при оценке стоимости по умолчанию предполагать, что «кэш всегда попадает», то чем чаще меняется стратегия маршрутизации, тем сильнее расходятся прогноз и реальный счёт.
Заметная разница есть и в стандартных ценах. Официальные стандартные цены по состоянию на 2026-11-13 (USD за миллион токенов):
| Модель | Вход | Выход | Примечание |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | Для вызова инструментов нужен Responses API |
| GPT-6.1 Sol | $1 | $5 | Для вызова инструментов нужен Responses API |
| Claude Sonnet 5.5 | $2 | $10 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | Промо-цена действует до 2026-12-31; с 2027-01-01 планируется изменение до $1.50 / $7.50 |
Эта таблица нужна, чтобы показать различия в биллинге: возможности и условия использования у моделей разные, и по цене нельзя напрямую судить о производительности. В таблицу также не включены расходы на запись кэша, вызов инструментов, уровни обслуживания и наценки третьих сторон.
💰 Рекомендация по расчёту затрат: в счетах мультимодельных приложений нужно отдельно учитывать «обычный ввод, запись кэша, попадание в кэш, рассуждения и вывод, расходы на инструменты, надбавку за длинный контекст». При едином вызове нескольких моделей через APIYI apiyi.com можно в одном месте просматривать расход по каждой модели — так проще сопоставлять стратегию маршрутизации с фактическими затратами.
Что касается обработки ошибок, у трёх провайдеров различаются лимиты частоты запросов, скорости по токенам, квоты, тайм-ауты и форматы ошибок. Приложению стоит ввести единую классификацию ошибок: сбой аутентификации, неподдерживаемая модель, недопустимые параметры, слишком большой запрос или превышение контекста, ограничение 429, ошибка сервера, обрыв сети, прерывание потока ответа, сбой вызова инструмента.
При откате на резервную модель нужно также учитывать, есть ли у задачи побочные эффекты. Если основная модель отвалилась по тайм-ауту уже после выполнения инструмента, а система автоматически переключается на резервную и повторно прогоняет всю задачу, то операции вроде оплаты, отправки письма или изменения файла могут выполниться дважды. Решение — добавить идемпотентные ключи для инструментов с побочными эффектами и при откате продолжать только с «ещё не выполненных шагов».
3 Как должна быть построена архитектура совместимости с API нескольких моделей
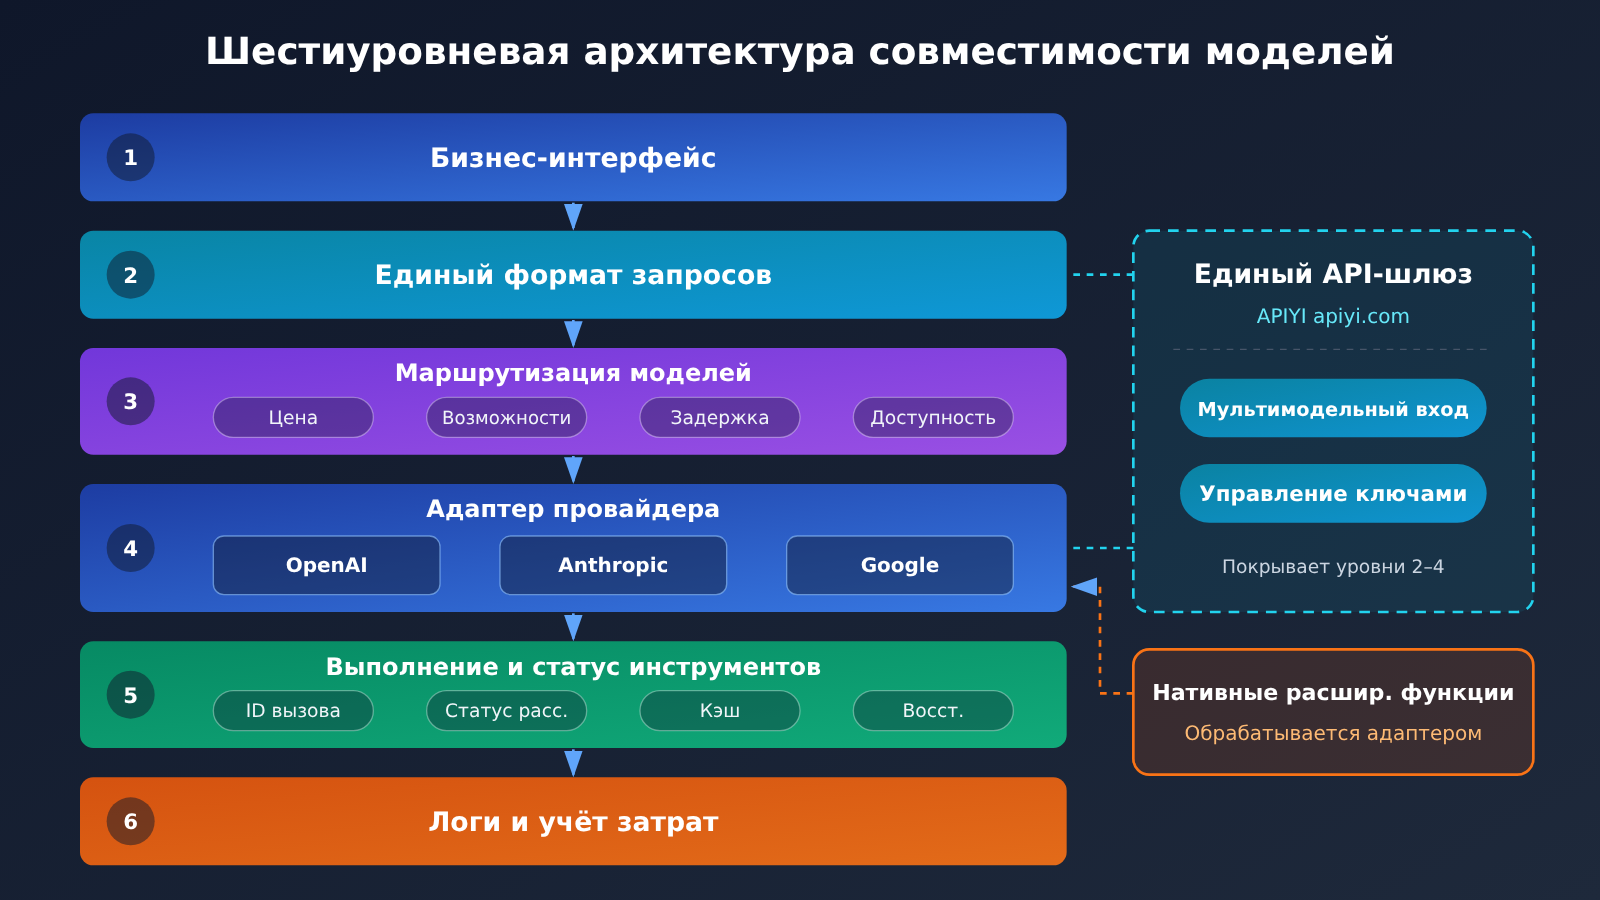
Рекомендуемая шестиуровневая структура выглядит так:
- Бизнес-интерфейс: пользователь задаёт вопрос, загружает материалы, выбирает модель и задачу.
- Единый формат запроса: единая структура для истории сообщений, вложений, списка инструментов, требований к структурированному выводу, интенсивности рассуждений и ID задачи.
- Маршрутизация моделей: выбор GPT, Claude или Gemini на основе цены, возможностей, задержки, доступности и бизнес-правил.
- Provider Adapter: преобразует стандартный запрос в нативный формат каждого вендора, а затем отображает возвращённый результат обратно во внутренний формат.
- Выполнение инструментов и управление состоянием: поддержка ID вызова, журнала выполнения, контекста диалога, состояния рассуждений вендора, кэша и восстановления после сбоев.
- Логирование и учёт затрат: для каждого запроса фиксируются модель, Token, фактические расходы, задержка, кэш, ошибки и вызовы инструментов.
3.1 Создание единого формата сообщений и инструментов
Ключевой принцип единого формата — хранить историю на двух уровнях. Первый уровень — универсальная стандартная история: сообщения пользователя, финальные ответы модели, запросы к инструментам и результаты их вызова. Её поймёт любой провайдер. Второй уровень — состояние, специфичное для провайдера: элементы reasoning, подписи thinking, блоки thought. Оно хранится отдельно по каждому провайдеру и передаётся обратно в исходном виде только при запросе к тому же провайдеру.
from dataclasses import dataclass, field
from typing import Any, Literal

@dataclass
class ToolCall:
    call_id: str              # единый ID вызова; адаптер сопоставляет его с ID провайдера
    name: str
    arguments: dict[str, Any]
    result: Any = None
    idempotency_key: str = "" # обязателен для инструментов с побочными эффектами

@dataclass
class Message:
    role: Literal["system", "developer", "user", "assistant", "tool"]
    content: list[dict]                      # мультимодальные блоки: текст, изображения и т. п.
    tool_calls: list[ToolCall] = field(default_factory=list)
    # состояние провайдера: ключ — имя провайдера, значение — сохранённые как есть подписи / блоки reasoning
    vendor_state: dict[str, Any] = field(default_factory=dict)
При переключении модели адаптер читает стандартные поля и формирует новый запрос. Часть vendor_state, относящаяся к другим провайдерам, не отправляется, а часть, относящаяся к целевому провайдеру, передаётся обратно как есть.
3.2 Адаптация нативных API через Provider Adapter
Каждый адаптер выполняет три задачи:
- Преобразование входа: маппинг ролей (например, перенос
systemв отдельное поле Claude), преобразование определений инструментов, понижение схемы, маппинг уровней reasoning. - Преобразование выхода: преобразование нативных ответов и стриминговых событий во внутренние события из раздела 2.4, маппинг ID вызовов инструментов в единый ID.
- Работа с состоянием: извлечение и сохранение состояния провайдера — сигнатур, reasoning-элементов и прочего, а также решение о том, использовать ли серверное продолжение (
previous_response_id,previous_interaction_id) или передавать историю целиком.
Обычные вопросы-ответы можно пускать через общий адаптер в OpenAI-совместимом формате. А там, где нужны строгие параметры инструментов, управление кешированием или зашифрованное состояние размышлений, реализуйте отдельные нативные адаптеры. Так сохраняется удобство единой точки входа, и при этом у продвинутых возможностей появляется понятное место.
3.3 Определение доступных функций через реестр возможностей
Реестр возможностей фиксирует фактическую поддержку в разрезе «модель + эндпоинт»: одна и та же модель через нативный API и через слой совместимости может соответствовать двум разным записям. Ниже пример структуры; конкретные значения обязательно сверяйте с официальной документацией и результатами собственных тестов:
gpt-6.1-sol@responses:
  tools: true
  tool_api: responses          # вызовы инструментов требуют использования Responses API
  reasoning_effort: [low, medium, high]   # не принимает none
  vendor_state: reasoning_items
claude-sonnet@openai-compat:
  tools: true
  strict_tools: false          # слой совместимости игнорирует strict
  prompt_caching: false
  file_input: false
  merges_system_developer: true
gemini-flash@interactions:
  tools: true
  builtin_tools: [google_search, url_context, code_execution]
  vendor_state: thought_signatures
Маршрутизатор перед выбором модели обращается к реестру. Если в запросе есть файл, записи с file_input: false исключаются; если нужны строгие параметры инструментов, выбираются только записи со strict_tools: true. Интерфейс продукта тоже может на этом основании скрывать опции, которые текущая модель не поддерживает, — так пользователи реже натыкаются на ошибки.
4 Тестирование и наблюдаемость перед запуском совместимого мультимодельного API
4.1 Шесть проверок совместимости: от простого диалога до многораундовых цепочек с инструментами
В порядке возрастания сложности последовательно пройдите шесть тестов:
- Обычный диалог: отправьте один и тот же промпт трём моделям и проверьте, что ответы и статистика токенов в норме.
- Потоковый вывод: убедитесь, что вывод приходит постепенно и получен корректный сигнал завершения.
- Вызов инструментов: модель вызывает инструмент запроса погоды или данных, приложение выполняет его и возвращает результат.
- Цикл с несколькими инструментами: не менее двух раундов вызовов подряд; проверьте целостность истории и ID вызовов.
- Структурированный JSON: вывод по одной и той же схеме с проверкой структуры валидатором на стороне приложения.
- Переключение моделей: в рамках одной бизнес-сессии переключайтесь между GPT, Claude и Gemini; контекст, записи вызовов инструментов и итоговый ответ должны оставаться корректными.
Пункты 4 и 6 лучше всего вскрывают проблемы состояния рассуждения — их стоит добавить в CI. При каждом обновлении версии модели или смене эндпоинта прогоняйте их заново.
4.2 Единая наблюдаемость стоимости и стабильности
Для каждого запроса фиксируйте как минимум: модель и эндпоинт, долю успешных запросов, тип сбоя (по классификации из раздела 2.6), задержку до первого токена и общее время выполнения задачи, токены по категориям (входные, запись в кэш, попадание в кэш, размышления, выходные), число вызовов инструментов и число неудачных вызовов, количество повторов и откатов.
Оценивая модель, смотрите на общее время и полную стоимость задачи: данные одного запроса мало что дают. Дешёвая модель с высоким процентом ошибок в аргументах инструментов может требовать нескольких повторов — и в итоге обходиться дороже.
5 Роль единого API-шлюза в совместимости API разных моделей
5.1 Затраты на подключение и поддержку
Если использовать три модели одновременно, это значит три набора аккаунтов, три набора ключей, три системы биллинга и три конфигурации SDK. Единый API-шлюз сводит всю эту работу к одной точке входа: централизованное управление подключением моделей и учётными данными, меньше хлопот с настройкой у каждого провайдера, возможность выбирать и переключать модели на уровне конфигурации, а также единый обзор расхода и стоимости. Для команд, которым нужно часто сравнивать результаты моделей, порог входа при тестировании новой модели тоже становится ниже.
5.2 Место APIYI: разделение ролей между единой точкой входа и адаптацией под нативные возможности
APIYI — это платформа-агрегатор API больших языковых моделей: с одним API-ключом через OpenAI-совместимый интерфейс можно вызывать OpenAI, Claude, Gemini и другие популярные модели, оплата — по факту использования. Она хорошо подходит на роль слоя «единая точка входа для вызовов» в архитектуре: обычные вопросы-ответы, потоковый вывод, сравнение моделей и маршрутизация между несколькими моделями подключаются напрямую.
Единая точка входа для вызовов и полное соответствие нативным возможностям провайдера — это два разных технических требования. При подключении конкретной модели всё равно нужно по пунктам сверяться с реестром возможностей: поддержка вызова инструментов, состояние «размышления», мультимодальность, кэширование и структурированный вывод. Для цепочек, которые зависят от нативных возможностей вроде Responses API, cache_control или зашифрованных подписей, нужно сначала убедиться, что соответствующий эндпоинт действительно доступен, и только потом выводить их в продакшен — либо держать для них отдельный нативный адаптер.
Быстрый старт с совместимостью мультимодельного API
Минимальный пример: сравнение трёх моделей на одном промпте
Код ниже использует один и тот же клиент OpenAI SDK, чтобы по очереди вызвать три модели — это соответствует тесту № 1 из раздела 4.1.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI
)

# ID моделей — согласно списку моделей на платформе
MODELS = ["你的GPT模型ID", "你的Claude模型ID", "你的Gemini模型ID"]

for model in MODELS:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是幂等"}],
    )
    print(model, "→", resp.choices[0].message.content)
    print("usage:", resp.usage)
Полная реализация: унифицированные потоковые события + реестр возможностей + валидация инструментов
import json
import openai
from openai import OpenAI
from jsonschema import validate, ValidationError

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI — единый интерфейс
)

# Реестр возможностей: значения — лишь пример структуры, поддерживайте по официальной документации и результатам тестов
CAPABILITIES = {
    "gpt":    {"model": "你的GPT模型ID",    "tools_via": "responses"},  # вызовы инструментов должны идти через адаптер Responses
    "claude": {"model": "你的Claude模型ID", "tools_via": "chat"},
    "gemini": {"model": "你的Gemini模型ID", "tools_via": "chat"},
}

def classify_error(e: Exception) -> str:
    """Единая классификация ошибок: определяет, можно ли повторять запрос"""
    if isinstance(e, openai.AuthenticationError):
        return "auth_failed"
    if isinstance(e, openai.NotFoundError):
        return "model_not_supported"
    if isinstance(e, openai.RateLimitError):
        return "rate_limited"          # можно повторить с задержкой
    if isinstance(e, openai.BadRequestError):
        return "invalid_request"       # ошибка параметров или выход за контекст — слепо повторять не стоит
    if isinstance(e, openai.APIConnectionError):
        return "network_error"
    if isinstance(e, openai.InternalServerError):
        return "server_error"
    return "unknown"

def stream_chat(provider: str, messages: list, tools: list | None = None):
    """Преобразует поток в формате, совместимом с OpenAI, во внутренние унифицированные события"""
    cap = CAPABILITIES[provider]
    if tools and cap["tools_via"] != "chat":
        raise NotImplementedError(f"{provider} 的工具调用请交给原生适配器处理")

    kwargs = {
        "model": cap["model"],
        "messages": messages,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    if tools:
        kwargs["tools"] = tools

    calls: dict[int, dict] = {}   # склеиваем фрагменты аргументов параллельных вызовов инструментов по index
    finished = False
    try:
        for chunk in client.chat.completions.create(**kwargs):
            if not chunk.choices:
                if chunk.usage:
                    yield {"type": "usage", "data": chunk.usage.model_dump()}
                continue
            choice = chunk.choices[0]
            delta = choice.delta
            if delta.content:
                yield {"type": "text_delta", "data": delta.content}
            for tc in delta.tool_calls or []:
                slot = calls.setdefault(tc.index, {"id": None, "name": "", "args": ""})
                if tc.id:
                    slot["id"] = tc.id
                if tc.function and tc.function.name:
                    slot["name"] = tc.function.name
                    yield {"type": "tool_call_start", "data": {"id": slot["id"], "name": slot["name"]}}
                if tc.function and tc.function.arguments:
                    slot["args"] += tc.function.arguments
                    yield {"type": "tool_call_args", "data": {"index": tc.index}}
            if choice.finish_reason:
                finished = True
                yield {"type": "completed", "data": {
                    "finish_reason": choice.finish_reason,
                    "tool_calls": list(calls.values()),
                }}
    except Exception as e:
        yield {"type": "error", "data": classify_error(e)}
        return
    if not finished:
        yield {"type": "error", "data": "stream_interrupted"}  # поток оборвался на полпути

EXECUTED_KEYS: set[str] = set()   # в продакшене замените на постоянное хранилище

def run_tool(call: dict, schema: dict, func, idempotency_key: str | None = None):
    """Сначала проверяем параметры, затем выполняем идемпотентно"""
    try:
        args = json.loads(call["args"])   # разбираем только после того, как все фрагменты собраны
        validate(instance=args, schema=schema)
    except (json.JSONDecodeError, ValidationError) as e:
        return {"error": f"invalid_arguments: {e}"}
    if idempotency_key:
        if idempotency_key in EXECUTED_KEYS:
            return {"skipped": "already_executed"}
        EXECUTED_KEYS.add(idempotency_key)
    return func(**args)

# Пример использования
for event in stream_chat("claude", [{"role": "user", "content": "介绍一下流式输出"}]):
    print(event)
🚀 Быстрый старт: зарегистрируйтесь через APIYI apiyi.com и получите бесплатный тестовый лимит, а затем с помощью приведённого выше кода выполните первые два теста из раздела 4.1 под одним и тем же ключом. Тесты, связанные с вызовом инструментов и многораундовым рассуждением, проверяйте по каждому моделью отдельно, сверяясь с реестром возможностей.
Частые вопросы (FAQ)
В1: Что именно означает «проблема совместимости API разных моделей»?
Это различия, которые приходится обрабатывать, когда одно и то же приложение переключается между GPT, Claude и Gemini: нативные API устроены по-разному. Категорий всего шесть: роли сообщений, вызов инструментов, состояние рассуждений, потоковые события, структурированный вывод и мультимодальность, кеширование с оплатой и обработка ошибок.
В2: Если вызывать Claude и Gemini через OpenAI-совместимый интерфейс, всё равно нужен слой адаптации?
Для обычного чата можно работать с совместимым интерфейсом напрямую. Но когда дело доходит до строгих параметров инструментов, Prompt Caching, файлового ввода и зашифрованного состояния размышлений, без слоя адаптации не обойтись. На примере официального совместимого слоя Claude: он игнорирует `strict`, а также не поддерживает кеширование и ввод audio/file. Все такие расхождения стоит фиксировать в реестре возможностей.
В3: В новом проекте на Gemini использовать Interactions API или generateContent?
Interactions API вышел в GA в июне 2026 года, и Google рекомендует новым проектам выбирать именно его. Он поддерживает серверное состояние сессии, `previous_interaction_id` и структуру steps. `generateContent` по-прежнему поддерживается, а существующие проекты могут миграцию по плану.
В4: Как работать с историей, если модель меняется посреди диалога?
Сообщения пользователя, финальные ответы, запросы к инструментам и их результаты хранятся как стандартная история — после переключения целевой адаптер собирает её заново. Специфичное для провайдера состояние (подписи, элементы reasoning и т. п.) хранится отдельно и передаётся обратно как есть только при запросах к тому же провайдеру. Кроме того, кеш прежнего провайдера после переключения обычно уже не переиспользовать, поэтому на первый раунд стоит заранее заложить полную стоимость входных данных.
В5: Как быстро проверить совместимость трёх моделей на моём сценарии?
Рекомендую такой порядок:
1. Зайдите на APIYI apiyi.com, зарегистрируйте аккаунт и получите API-ключ и бесплатную тестовую квоту.
2. Возьмите код из этой статьи, укажите в base_url адрес APIYI и подставьте ID трёх моделей.
3. Пройдите по порядку шесть тестов из раздела 4.1 и запишите процент успеха, типы ошибок, стоимость и общее время выполнения.
В6: На что обратить внимание при настройке автоматического отката на другую модель?
Сначала определите, есть ли у задачи побочные эффекты. Инструменты вроде оплаты, отправки писем или изменения файлов обязательно должны нести ключ идемпотентности, а при откате нужно продолжать с незавершённого шага, а не перезапускать задачу целиком. Ограничение частоты запросов и серверные ошибки лечатся повтором с задержкой (backoff); ошибки параметров и превышение контекста требуют исправить запрос и только потом отправить его снова.
В7: Как контролировать расходы при маршрутизации между моделями?
Считайте стоимость по отдельным статьям токенов и сравнивайте по полной стоимости задачи. Цены у трёх провайдеров различаются сильно: например, у GPT-6 Astra вывод стоит $50 за миллион токенов, а у Gemini 3.8 Flash сейчас акционная цена — $3.75. Когда видишь расход по всем моделям в одном месте — на APIYI apiyi.com, — дорогие участки цепочки находятся быстрее, и уже по ним можно править правила маршрутизации.
В8: Какие ограничения есть у единого API-шлюза?
Шлюз унифицирует точку входа для вызовов, ключи и биллинг. Доступность нативных продвинутых возможностей провайдера (например, специализированных вызовов инструментов Responses API, `cache_control`, возврата зашифрованных подписей) зависит от поддержки конкретного эндпоинта и требует проверки по каждому пункту. Для цепочек, которые опираются на эти возможности, стоит сохранить нативный адаптер как дополнение.
Ключевые выводы по совместимости мультимодельного API (Key Takeaways)
- Смена модели ≠ смена ID: обычный вопрос-ответ можно перенести напрямую, а в цепочках Agent нужно обработать 6 типов различий.
- У слоя совместимости есть границы: слой совместимости Claude игнорирует
strict, не поддерживает кэширование и ввод файлов. - Подписи нужно сохранять как есть: потеря подписей thinking / thought — частая причина ошибок в многораундовых цепочках инструментов.
- Унификация потоковых событий: бэкенд выдаёт 8 типов внутренних событий, а фронтенд работает только с одним протоколом.
- Маршрутизация на основе реестра возможностей: реально поддерживаемые функции фиксируются в разрезе «модель + эндпоинт».
- Откат должен быть идемпотентным: для инструментов с побочными эффектами добавляйте ключ идемпотентности, чтобы избежать повторного выполнения.
- Сначала тестируйте, потом запускайте: прогоните шесть тестов совместимости на бесплатном лимите APIYI apiyi.com.
Итог
Когда одно приложение должно работать одновременно с GPT, Claude и Gemini, главное — сосредоточить все различия в нескольких компонентах:
- Единый формат сообщений и инструментов: стандартная история и вендорные состояния хранятся раздельно, поэтому при переключении модели контекст не теряется.
- Provider Adapter: отвечает за преобразование входа, преобразование выхода и работу с состоянием; именно здесь реализуются нативные продвинутые возможности.
- Реестр возможностей: честно фиксирует, что каждый конкретный эндпоинт каждой модели поддерживает по инструментам, reasoning, мультимодальности, Schema и кешированию — и уже он определяет маршрутизацию и доступные опции в интерфейсе.
На этой основе качество перед релизом обеспечивают шесть тестов совместимости и отдельное наблюдение за стоимостью по каждой статье затрат. На этапе обычных вызовов и сравнения моделей рекомендуется быстро проверить несколько моделей через APIYI apiyi.com с одним API-ключом, а затем по результатам тестов решить, какие цепочки требуют нативной адаптации.
📚 Справочные материалы
- OpenAI Function Calling: вызов инструментов,
call_idиfunction_call_output - Ссылка:
developers.openai.com/api/docs/guides/function-calling -
Описание: авторитетное руководство по протоколу вызова инструментов в Responses API
-
Руководство по миграции на новые модели OpenAI: параметры рассуждения и требования к интерфейсу серии GPT-6
- Ссылка:
developers.openai.com/api/docs/guides/latest-model -
Описание: ограничения на значения
reasoning.effortи требования Responses API -
OpenAI Prompt Caching: контрольные точки кеширования и TTL
- Ссылка:
developers.openai.com/api/docs/guides/prompt-caching -
Описание: механизмы неявного и явного кеширования
-
Совместимость Claude с OpenAI SDK: охват поддержки слоя совместимости и его ограничения
- Ссылка:
platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk -
Описание: различия в
strict, кешировании, файловом вводе, слиянии system и т. д. -
Claude Extended Thinking: Adaptive Thinking и сигнатуры мышления
- Ссылка:
platform.claude.com/docs/en/build-with-claude/extended-thinking -
Описание: правила возврата блоков thinking при многораундовых вызовах инструментов
-
Структурированный вывод и кеширование в Claude: JSON outputs, Strict tool use,
cache_control - Ссылка:
platform.claude.com/docs/en/build-with-claude/structured-outputs - Ссылка:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
Описание: структурные ограничения и режимы кеширования
-
Gemini Interactions API и совместимость с OpenAI: новый интерфейс и точка входа совместимости
- Ссылка:
ai.google.dev/gemini-api/docs/interactions-overview - Ссылка:
ai.google.dev/gemini-api/docs/openai -
Описание: структура steps, состояние сессии и сопоставление совместимых параметров
-
Сигнатуры мышления, вызов инструментов и кеширование в Gemini
- Ссылка:
ai.google.dev/gemini-api/docs/thought-signatures - Ссылка:
ai.google.dev/gemini-api/docs/function-calling - Ссылка:
ai.google.dev/gemini-api/docs/caching -
Описание: сохранение сигнатур в режиме stateless, протокол инструментов и явное кеширование
-
Официальные страницы с ценами всех трёх провайдеров
- Ссылка:
developers.openai.com/api/docs/pricing - Ссылка:
platform.claude.com/docs/en/models/sonnet-5-5/overview - Ссылка:
ai.google.dev/gemini-api/docs/pricing - Описание: источники данных для таблицы цен в этой статье, дата проверки — 2026-11-13
Автор: Техническая команда APIYI
Обратная связь: будем рады пообщаться — свяжитесь с нами через главную страницу сайта APIYI, а больше материалов найдёте в центре документации docs.apiyi.com


