
Примечание автора: открытые веса Wenxin 5.5 Flash Base уже доступны для скачивания. В этой статье разберём архитектуру модели, требования к оборудованию, цели использования и расходы, чтобы помочь вам решить: развернуть базовую модель самостоятельно или вызывать её через API по мере необходимости.
5 ноября 2026 года Baidu официально представила и открыла веса Wenxin 5.5 Flash Base (ERNIE-5.5-Flash-Base). Это базовая модель с разреженной архитектурой MoE: всего у неё 280 млрд параметров, из которых для каждого токена активируется 14 млрд. На нескольких бенчмарках она показала лучшие результаты среди моделей аналогичного размера. Веса доступны на Hugging Face в версиях FP8 и BF16; одновременно вышли плагин для vLLM и Cookbook для SGLang. На этот раз разработчики не ограничились публикацией статьи — веса тоже доступны.
Это не очередной пересказ результатов бенчмарков. Многие команды, увидев «открытые веса + SOTA», готовы сразу скачать модель и запустить её в работу, упуская важную деталь: это базовая модель, не прошедшая промежуточное обучение и постобучение. Она хорошо подходит в качестве отправной точки для обучения, но использовать её напрямую как чат-бота нельзя.
Главное: прочитав статью, вы узнаете, для каких задач подходит Wenxin 5.5 Flash Base, сколько примерно видеопамяти нужно для самостоятельного развёртывания и когда выгоднее вызывать модель через API по мере необходимости.
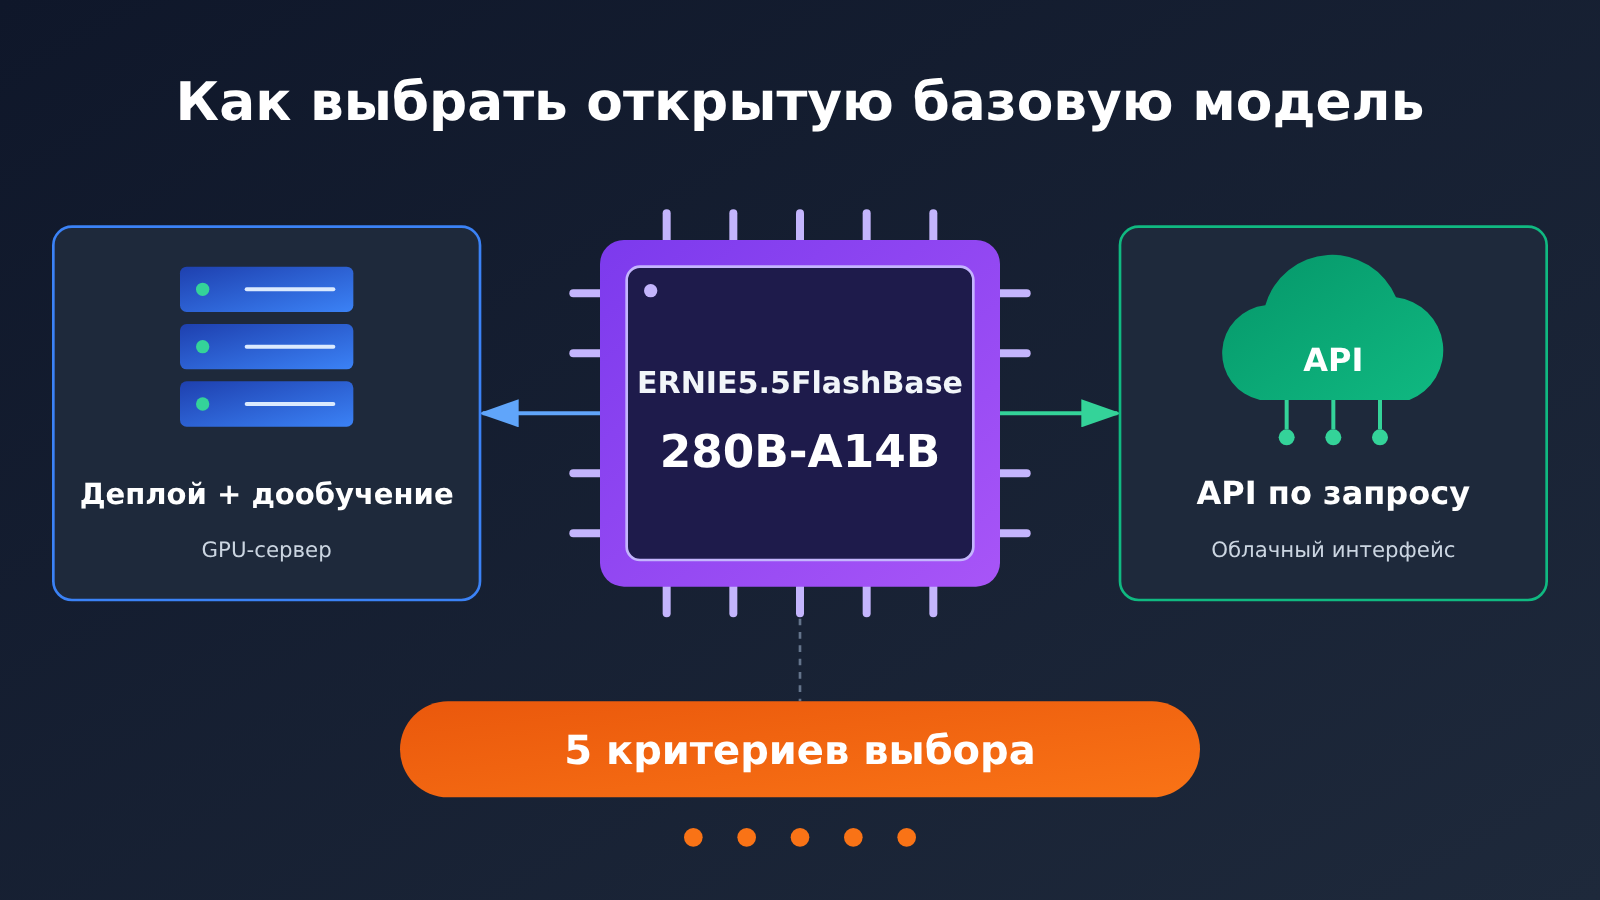
Вэньсинь 5.5 Flash Base: главное
Сначала соберём ключевые сведения о модели в одной таблице. Они помогут решить, что лучше: развернуть модель или обращаться к ней через API.
| Параметр | Описание | Влияние на выбор |
|---|---|---|
| Назначение | Чекпоинт после предобучения, без промежуточного и последующего обучения | Не подходит для диалога сразу, но годится для дальнейшего обучения |
| Размер модели | 280B параметров всего, 14B активируются на каждый токен | Вычислительные затраты при инференсе невелики, но объём памяти под веса рассчитывается исходя из 280B |
| Контекст | Контекст обучения — 128K, при дообучении и инференсе поддерживается 1M токенов | Подходит для адаптации к работе с длинными документами и кодом на уровне целого репозитория |
| Формат весов | На Hugging Face доступны FP8 и BF16 | FP8 существенно снижает требования к развёртыванию |
| Поддержка экосистемы | Плагин для vLLM, Cookbook для SGLang | Можно подключить к популярным фреймворкам инференса |
Что означает «Base» в Вэньсинь 5.5 Flash Base
Базовая модель обучена только «предсказывать следующий токен» — она не училась понимать инструкции и отвечать на них. Если задать ей вопрос, она, скорее всего, продолжит генерировать вопросы, а не даст ответ. В Baidu прямо говорят: разработчики могут использовать эту модель как общую отправную точку для дальнейшей адаптации к предметной области, инструкционного дообучения, усиления рассуждений и обучения агентов.
Поэтому первый критерий выбора прост: если вы хотите «использовать модель», Base вам не подойдёт; если хотите «обучать модель», она станет хорошей отправной точкой. В Baidu также сообщили, что полноценная версия Вэньсинь 5.5 Flash выйдет в ближайшее время. Команды, которым нужна модель для диалога, могут дождаться её.
Конкуренты Вэньсинь 5.5 Flash Base сопоставимого размера
В опубликованных Baidu тестах модель сравнивали с DeepSeek-V4-Flash-Base (284B-A13B), Hy3-preview-Base (295B-A21B) и MiMo-V2.5-Base (310B-A15B). Вэньсинь 5.5 Flash Base показала сильные результаты в задачах на рассуждение, работу с кодом, предметные знания и длинный контекст. Командам, которые собираются дообучать модель для кодовых агентов или понимания длинных документов, стоит включить её в список кандидатов.
Как работает Wenxin 5.5 Flash Base: три улучшения эффективности
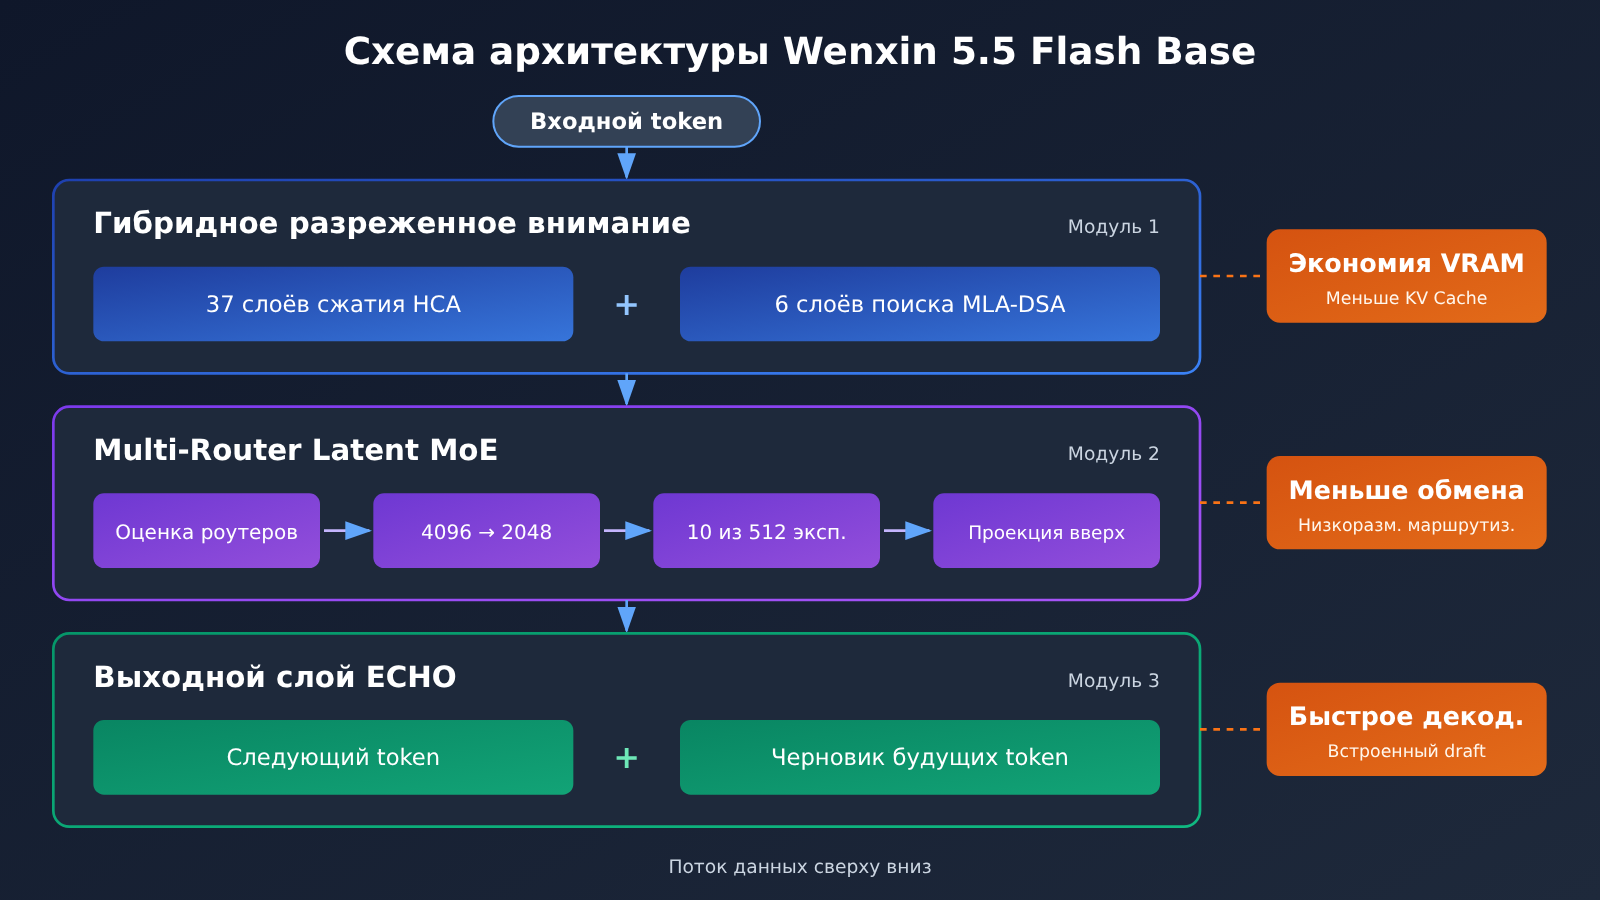
Понимание архитектуры помогает оценить стоимость развёртывания. Команда Wenxin сделала эффективность одним из параметров проектирования на этапе предобучения. Основные изменения затронули три механизма: внимание, маршрутизацию экспертов и предсказание будущих токенов.
| Модуль | Ключевое решение | Преимущества при развёртывании |
|---|---|---|
| Гибридное разреженное внимание | 37 из 43 слоёв используют HCA (каждые 128 токенов сжимаются в одну запись кэша), ещё 6 слоёв — MLA + DSA для разреженного поиска | KV Cache значительно меньше, для длинного контекста требуется меньше видеопамяти |
| Multi-Router Latent MoE | Несколько Sigmoid-маршрутизаторов совместно оценивают экспертов; выбираются 10 из 512 маршрутизируемых экспертов плюс 1 общий эксперт; вычисления экспертов выполняются в скрытом пространстве размерности 2048 | FLOPs экспертов и объём данных при распределении сокращаются примерно вдвое |
| ECHO | Последний слой основной модели повторно используется для предсказания будущих токенов | Может работать как встроенная draft-модель для спекулятивного декодирования без добавления параметров |
| Дополнительные решения | Выходная голова MultiMax, токенизатор R2L со словарём примерно в 200 тысяч токенов | Более надёжная обработка чисел и арифметических операций |
Почему Wenxin 5.5 Flash Base экономит память на KV Cache
В традиционной модели каждый слой хранит полный KV Cache, поэтому с ростом контекста нагрузка на видеопамять увеличивается. В Wenxin 5.5 Flash Base 37 слоёв видят только сжатое «резюме», и лишь 6 слоёв обращаются к истории по отдельным токенам. Затем эти 6 слоёв используют облегчённый Indexer, который выбирает Top-K позиций для детальных вычислений. Благодаря этому при контексте в 128K и более KV Cache занимает гораздо меньше места, чем у модели того же размера с полным вниманием. Для команд, развёртывающих модель самостоятельно, это реальная экономия видеопамяти.
Как ECHO ускоряет инференс
При предобучении ECHO предсказывает всего 1 дополнительный токен, но в роли draft-модели может последовательно предлагать несколько будущих токенов. Доля принятых токенов при этом выше, чем у внешнего модуля MTP, обученного таким же способом. Если при самостоятельном развёртывании фреймворк инференса поддерживает такой вариант спекулятивного декодирования, пропускная способность может заметно вырасти. Это ещё одно преимущество открытых весов перед API: вы полностью контролируете подобные оптимизации инференса.
Быстрый старт с 文心5.5 Flash Base: самостоятельное развёртывание
Если вы решили обучать модель на основе этого базового чекпойнта или запустить её в собственной инфраструктуре, вот кратчайший путь. Код приводить не будем — основные параметры объясним на словах.
Шаг 1. Оцените требования к видеопамяти
Вычислительная нагрузка модели MoE зависит от числа активируемых параметров, но загрузить нужно все веса. Поэтому видеопамять рассчитывается исходя из общего числа параметров — 280B. В таблице приведены приблизительные оценки по формуле «число байт на параметр × число параметров». KV Cache, значения активаций и накладные расходы фреймворка не учтены: ориентируйтесь на официальную документацию и результаты собственных тестов.
| Версия весов | Примерный объём видеопамяти для весов | Рекомендации по развёртыванию | Подходящие задачи |
|---|---|---|---|
| FP8 | Около 280 ГБ | Один сервер с 8 GPU по 80 ГБ: останется место для KV Cache | Тестирование инференса, небольшие сервисы |
| BF16 | Около 560 ГБ | Один сервер с 8 GPU большого объёма памяти или тензорный параллелизм на нескольких серверах | Тестирование, чувствительное к точности, и отправная точка для дообучения |
| Дообучение всех параметров | Значительно больше, чем для инференса: нужны также состояния оптимизатора и градиенты | Кластер из нескольких серверов и фреймворк для распределённого обучения | Глубокая адаптация к предметной области |
| Дообучение типа LoRA | Между требованиями инференса и дообучения всех параметров | Зависит от ранга и длины последовательности | Адаптация к предметной области для небольших и средних команд |
Шаг 2. Выберите фреймворк для инференса и загрузите веса
Разработчики также предоставили официальный плагин для vLLM и руководство SGLang Cookbook. Рекомендуется в первую очередь следовать этим материалам:
- Скачайте веса FP8 или BF16 с Hugging Face. Заранее выделите на диске примерно столько же места, сколько веса займут в видеопамяти.
- Установите vLLM и загрузите официальный плагин либо настройте параметры запуска по SGLang Cookbook.
- Установите степень тензорного параллелизма равной числу GPU в vLLM за это отвечает параметр
tensor-parallel-size. - Сначала проверьте работу с контекстом около 32K, затем постепенно увеличивайте его, следя за использованием KV Cache.
- Проведите первичную проверку с промптом на продолжение: например, дайте модели начало кода и попросите его дополнить, а не задавайте вопрос напрямую.
Шаг 3. Определите цель обучения
После развёртывания базовых весов настоящая работа только начинается. Есть три основных направления: продолжение предобучения на данных предметной области, SFT на инструкционных данных и, после SFT, усиление способностей к рассуждению или обучение на траекториях работы агентов. На этапе предобучения 文心 уже использовала данные о коде, включая коммиты, issue, PR и исправления с проверкой в CI, а также длинные тексты с многошаговыми вопросами и ответами. Поэтому особенно перспективно дообучение для работы с кодом и длинными документами.
🎯 Техническая рекомендация: прежде чем выделять GPU на дообучение, проверьте готовую инструкционную модель на своём наборе бизнес-тестов и определите базовый результат. APIYI apiyi.com предоставляет единый интерфейс к моделям нескольких ведущих разработчиков. Это позволяет с небольшими затратами получить результат для сравнения, а затем решить, стоит ли вкладываться в обучение собственной базовой модели.
Быстрый старт с 文心5.5 Flash Base: как выбрать API для ваших задач
Прежде всего важно уточнить: APIYI пока не поддерживает модели серии 文心 ERNIE, включая 文心5.5 Flash Base, но мы постараемся добавить их в ближайшее время. Кроме того, базовая модель сама по себе не подходит для прямого использования в качестве диалогового API: большинству проектов нужна версия, обученная следовать инструкциям, или версия для рассуждений.
Если вам нужно прямо сейчас интегрировать возможности моделей в продукт, можно сначала построить рабочую цепочку на уже доступных моделях, а после выхода официальной версии 文心5.5 Flash заменить модель и сравнить результаты. APIYI совместим с форматами интерфейсов OpenAI и Anthropic: чтобы переключить модель, достаточно изменить параметр model, не переписывая логику вызовов.
Цены на доступные альтернативы в APIYI
Цены ниже взяты со страницы docs.apiyi.com/models и указаны в долларах за миллион токенов. Перед использованием проверьте актуальные данные на странице.
| Модель | Вход | Выход | Кеш | Подходящие задачи | Доступная платформа |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Высокая нагрузка, задачи с ограниченным бюджетом | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Длинный контекст, задачи на китайском языке | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Основная модель для программирования и агентов | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Сложные рассуждения и задачи повышенной сложности | APIYI apiyi.com |
| 文心5.5 Flash Base / официальная версия | — | — | — | Модель пока недоступна в APIYI | Скоро появится |
Кроме того, APIYI предлагает другие китайские модели, в том числе серию qwen3.8, а также модели для генерации изображений gpt-image-2.6-flare и gpt-image-2.6-sunburst: входной текст — $5, входные изображения — $8, выход — $30. Актуальные цены также смотрите на странице тарифов. Обратите внимание: deepseek-v4.1-flash из таблицы — это модель, обученная следовать инструкциям и доступная для прямого вызова. Это не та же модель, что DeepSeek-V4-Flash-Base, участвовавшая в сравнительном тестировании.
Как подключиться
Для работы в формате OpenAI укажите в base_url SDK адрес интерфейса из документации APIYI, а в api_key — ключ, созданный в консоли. Проекты, использующие Anthropic SDK, тоже можно подключить напрямую. Полные адреса интерфейсов, описание параметров и примеры доступны в центре документации APIYI: docs.apiyi.com.
🚀 Быстрый старт: попробуйте сначала собрать работающий прототип в APIYI apiyi.com с помощью deepseek-v4.1-flash или claude-sonnet-5-5. Когда на платформе появится официальная версия 文心5.5 Flash, для A/B-сравнения достаточно будет изменить имя модели.
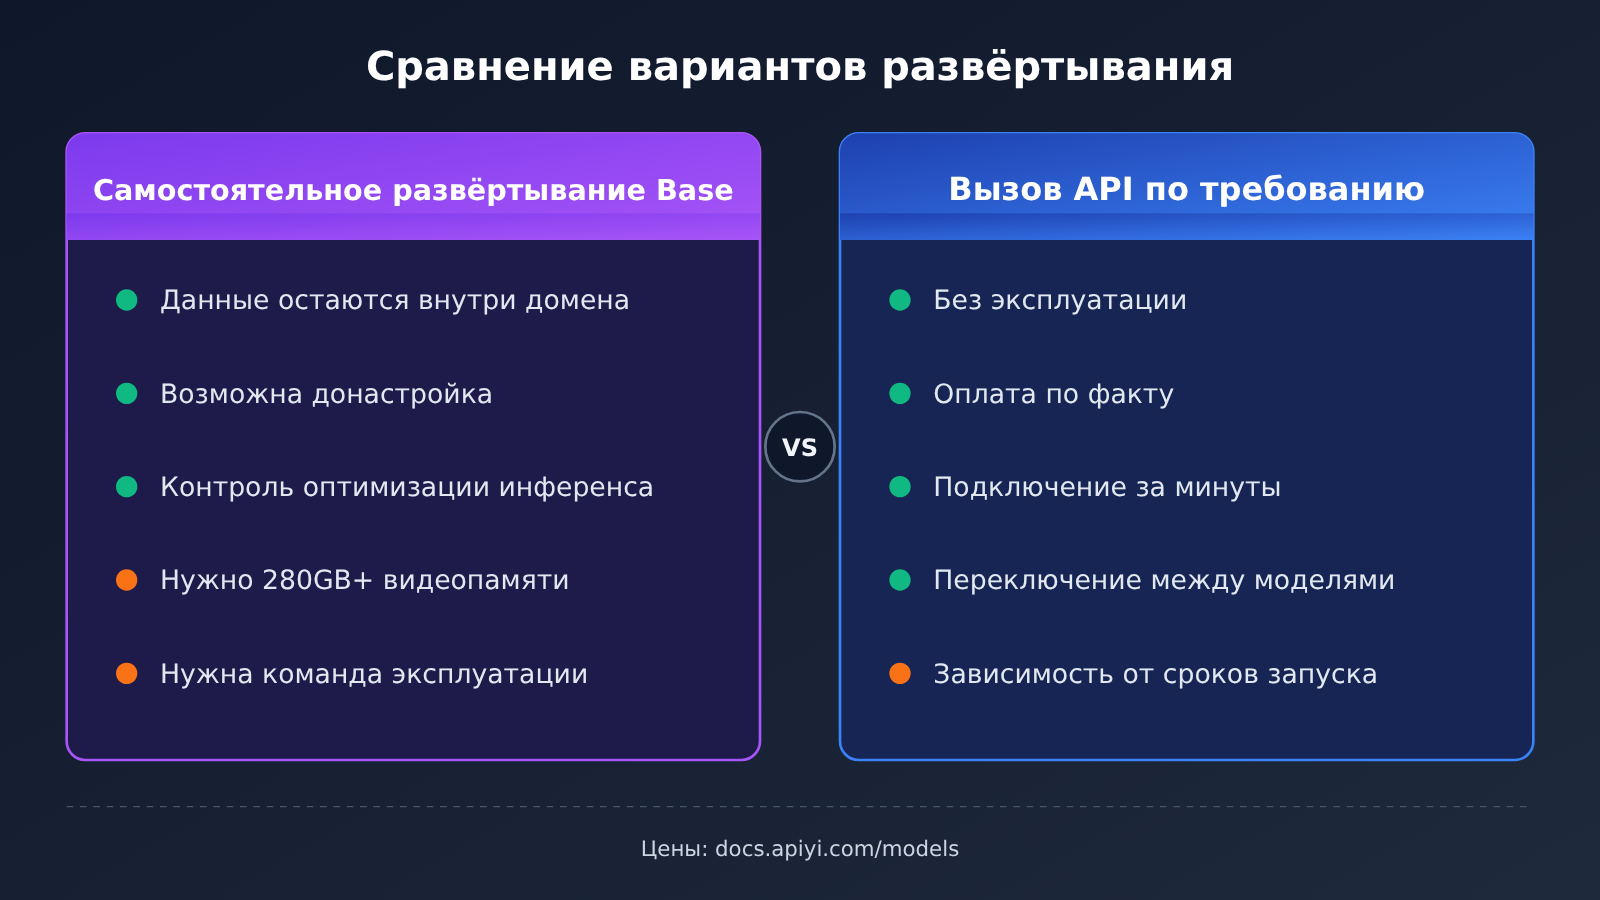
Самостоятельное развёртывание 文心5.5 Flash Base или вызовы через API: таблица для принятия решения
Вот рекомендации по пяти критериям, которые помогут определить, какой вариант подходит вашей команде.
| Критерий | Самостоятельное развёртывание Base | Вызовы через API по мере необходимости |
|---|---|---|
| Цель использования | Дополнительное предобучение на данных предметной области, SFT, RL или сравнительные исследования | Создание приложений для ответов на вопросы, написания текстов, помощи с программированием и других задач |
| Требования к данным | Данные не могут покидать внутреннюю сеть, необходимо частное развёртывание | Данные можно передавать в облако, условия поставщика приемлемы |
| Масштаб вызовов | Стабильно высокая нагрузка в течение длительного времени, высокая утилизация GPU | Нагрузка сильно меняется или число вызовов в день невелико |
| Возможности команды | Есть инженеры по обучению моделей и эксплуатации инфраструктуры инференса | Команда в основном занимается разработкой приложений и не хочет обслуживать кластер |
| Срок запуска | Можно выделить на обучение от нескольких недель до нескольких месяцев | Нужно запуститься уже на этой неделе |
Два типа пользователей 文心5.5 Flash Base
Команды, которым подходит самостоятельное развёртывание: например, команды из финансовой сферы, медицины, государственных организаций и крупных компаний, которым нужна частная инфраструктура. У них есть большие объёмы текстов из своей предметной области, а цель — обучить собственную модель. При выборе 文心5.5 Flash Base они обращают внимание на предобучение модели на коде и длинных контекстах, а также на экономию KV Cache благодаря архитектуре HCA.
Команды, которым подходят вызовы через API: например, разработчики SaaS, инструментов для работы с контентом и систем поддержки клиентов. Для них главное — стабильность, скорость и оплата по фактическому использованию. Если взять модель Base напрямую, её придётся дополнительно обучать. Разумнее сначала запуститься с готовой моделью, обученной следовать инструкциям, и сосредоточиться на продукте.
Оба подхода можно использовать параллельно
Многие команды работают в смешанном режиме: в рабочем продукте используют API для стабильности, а внутри компании экспериментируют с весами Base. Когда собственная модель превзойдёт базовый уровень API на тестовом наборе, трафик можно будет постепенно переключить на неё. Такой подход снижает риски и даёт чёткий ориентир для оценки результатов собственной разработки.
💡 Совет по выбору: если пока не уверены, начните с расчёта. Умножьте предполагаемый месячный объём вызовов на тариф со страницы цен APIYI и сравните полученную сумму со стоимостью аренды или амортизации GPU. Проведите небольшой недельный тест через единый интерфейс APIYI apiyi.com и примите решение, опираясь на фактический расход токенов. Это гораздо точнее оценки на глаз.
Часто задаваемые вопросы FAQ
Q1: Что такое Wenxin 5.5 Flash Base?
Это базовая модель, которую Baidu открыла 5 ноября 2026 года. Она использует разреженную архитектуру MoE, имеет 280B параметров, из которых 14B активируются для каждого токена, и предобучена с нуля на 33.5T токенов. Опубликованные веса получены на последнем этапе предобучения и предназначены главным образом для дальнейшего обучения, а не для диалога напрямую.
Q2: Чем Wenxin 5.5 Flash Base отличается от DeepSeek-V4-Flash-Base?
Модели близки по размеру: параметры DeepSeek-V4-Flash-Base составляют 284B-A13B. Это тоже сильная базовая модель, но, согласно опубликованным Baidu результатам, Wenxin 5.5 Flash Base лидирует в задачах на рассуждение, программирование, предметные знания и работу с длинным контекстом. С точки зрения архитектуры Wenxin использует гибридное внимание HCA и MLA, а также MoE с несколькими маршрутизаторами. Это помогает сжимать KV Cache и повышать устойчивость маршрутизации.
Q3: Когда выйдет финальная версия Wenxin 5.5 Flash?
Baidu сообщила, что финальная версия выйдет в ближайшее время, но на момент написания статьи (6 ноября 2026 года) точная дата ещё не объявлена. Финальная версия пройдёт дополнительное обучение на основе Base и будет лучше подходить для прямой интеграции в приложения.
Q4: Для каких задач лучше всего подходит Wenxin 5.5 Flash Base?
В первую очередь модель подходит для следующих задач:
— **Обучение кодовой модели для работы с целым репозиторием**: в данные предобучения уже включены инженерные данные, такие как коммиты, PR и исправления CI.
— **Отраслевые модели для работы с длинными документами**: например, для понимания юридических дел и аналитических отчётов в длинном контексте. При дообучении и инференсе поддерживается до 1M токенов.
— **Исследование методов обучения**: модель можно использовать как общую отправную точку для сравнения разных стратегий SFT и RL.
Q5: Можно ли сейчас вызывать Wenxin 5.5 Flash Base через API?
Пока что модель недоступна на APIYI, как и другие модели серии ERNIE. Мы постараемся добавить их в ближайшее время. Сейчас на APIYI apiyi.com можно вызывать уже доступные модели, в том числе deepseek-v4.1-flash, kimi-k3.1-pro и claude-sonnet-5-5. Платформа совместима с форматами API OpenAI и Anthropic. Актуальные цены указаны на docs.apiyi.com/models.
Q6: Какие есть ограничения при самостоятельном развёртывании Wenxin 5.5 Flash Base?
Во-первых, требуется большой объём видеопамяти: даже при использовании весов FP8 только для них понадобится около 280GB. Во-вторых, модель Base нельзя использовать сразу — её необходимо обучать. В-третьих, для инференса с длинным контекстом нужно дополнительно зарезервировать место под KV Cache. Если у команды нет опыта обучения и эксплуатации моделей, лучше начать с API.
Q7: Как малые и средние команды могут использовать Wenxin 5.5 Flash Base?
Можно арендовать облачные GPU для оценки модели при инференсе в FP8 или использовать методы вроде LoRA для лёгкой адаптации к предметной области. Для производственного трафика по-прежнему рекомендуется API: результаты на APIYI apiyi.com можно использовать как базовый ориентир для сравнения с собственной дообученной моделью.
文心5.5 Flash Base: главное
- Стартовая точка для обучения: Base не проходила постобучение, подходит для тонкой настройки и исследований, но не для прямого диалога.
- Вычисления зависят от активируемых параметров, видеопамять — от общего числа: активируется всего 14B параметров, но для весов в FP8 всё равно требуется около 280GB видеопамяти.
- Длинный контекст с меньшими затратами на кэш: сжатие HCA в 37 слоях и MLA-DSA в 6 слоях значительно уменьшают KV Cache.
- Хорошая основа для работы с кодом и длинными текстами: подходит для создания специализированных моделей, работающих с кодом на уровне репозитория и длинными документами.
- Экосистема готова: плагин vLLM и SGLang Cookbook выпущены одновременно, поэтому подключить модель для инференса несложно.
- API пока недоступен: APIYI ещё не добавил модели семейства 文心. Пока можно использовать доступные модели, чтобы получить базовые результаты для сравнения.
Итоги
Главное при выборе 文心5.5 Flash Base:
- Определитесь с целью: для обучения модели выбирайте самостоятельное развёртывание Base, для использования — API или дождитесь официальной версии.
- Оцените требования: веса модели займут около 280 ГБ видеопамяти в FP8 и 560 ГБ в BF16 — это жёсткое ограничение.
- Посчитайте затраты: сравните ежемесячную стоимость API с расходами на GPU при реальном объёме вызовов. Гибридный подход несёт меньше всего рисков.
Для большинства команд разработки самый практичный путь — сначала запустить приложение через API, а затем экспериментировать с открытой моделью Base внутри команды. Для быстрого построения базового решения можно использовать доступные модели через APIYI apiyi.com. Описание интерфейса — на docs.apiyi.com, актуальные цены — на docs.apiyi.com/models. Когда модели семейства 文心 станут доступны, для сравнения достаточно будет изменить имя модели в том же коде.
📚 Источники
- 量子位 — публикация об открытом выпуске 百度 文心5.5 Flash Base: обзор выпуска и результатов оценки модели
- Ссылка:
qbitai.com/2026/11/507787.html -
Описание: сравнение с базовыми моделями того же размера и обзор ключевых технологий
-
Центр документации APIYI: адрес интерфейса и описание вызовов, совместимых с OpenAI и Anthropic
- Ссылка:
docs.apiyi.com -
Описание: обязательное чтение перед подключением; содержит параметры и примеры
-
Страница цен на модели APIYI: стоимость входных и выходных данных и кэширования для доступных моделей
- Ссылка:
docs.apiyi.com/models - Описание: актуальные цены для этой статьи указаны на странице
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу APIYI apiyi.com. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com


