
Resumo: este artigo explica como definir o limite de teste gratuito de um produto de IA e apresenta um método para estimar o orçamento a partir do custo real de invocação, ajustando-o depois com base na análise dos dados.
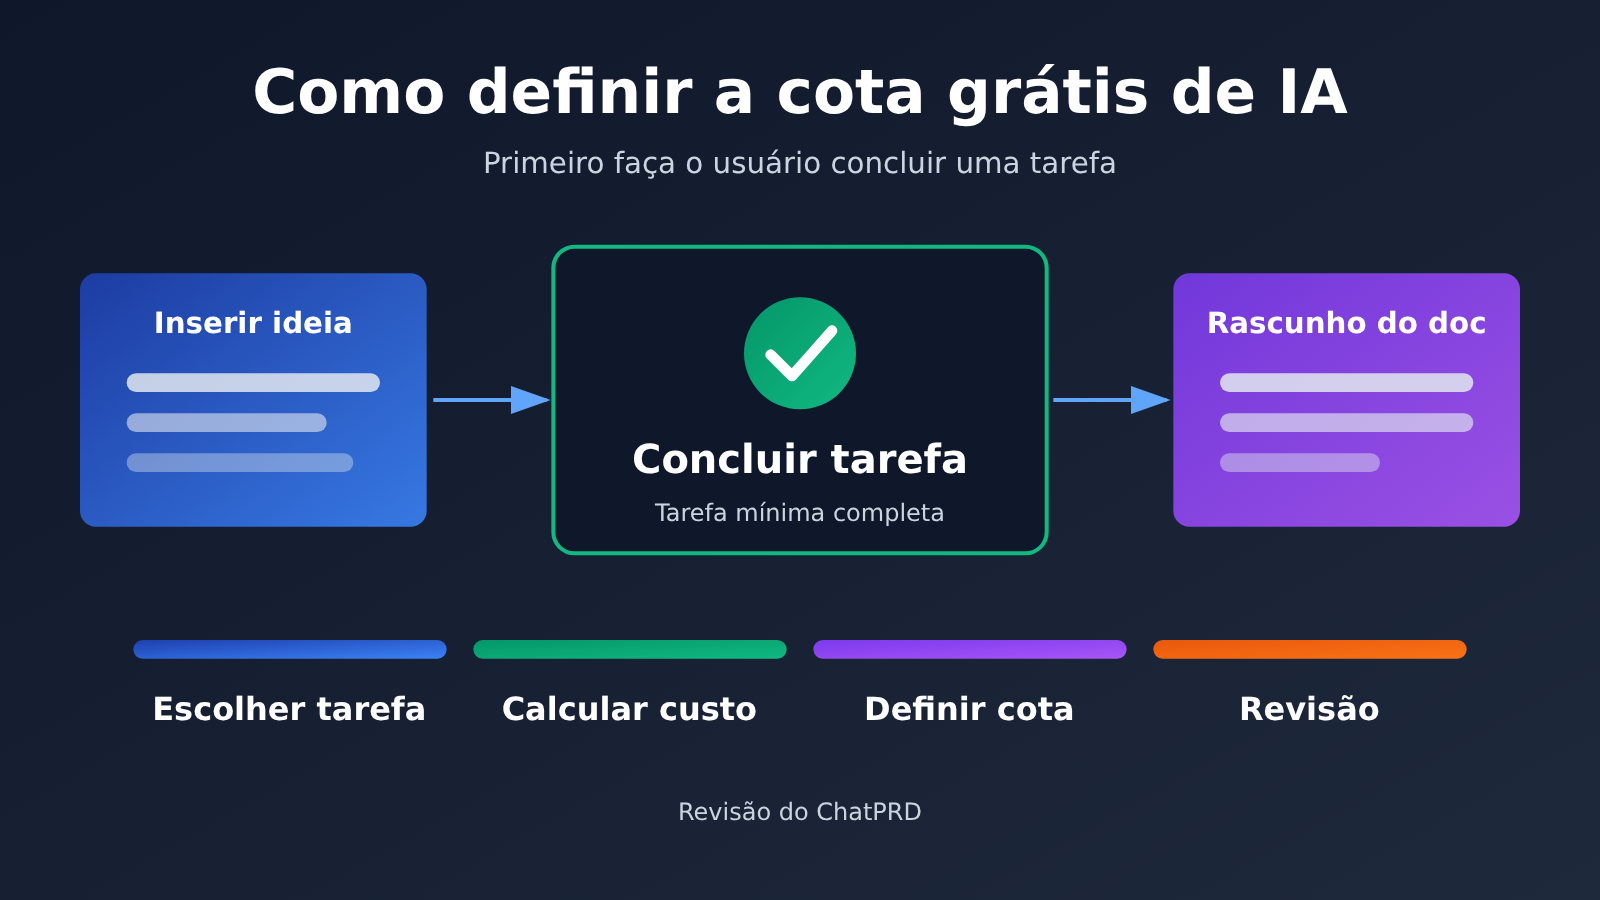
Conclusão antecipada: o limite de teste gratuito de um produto de IA deve girar em torno de uma única tarefa
O limite de teste gratuito de um produto de IA não pode ser definido a partir da quantidade de tokens ou de “quantos créditos dar”. Primeiro é preciso definir a única tarefa que o usuário deve concluir dentro do período de teste. O time do produto precisa identificar a menor tarefa completa na qual o usuário percebe valor de forma direta, medir com amostras reais quanto custa em invocação para concluí-la e, por fim, multiplicar por um número razoável de tarefas de teste para chegar ao limite por conta e ao orçamento total.
Essa resposta depende de três condições. A primeira é se a tarefa realmente pode ser concluída dentro do escopo do teste — uma tarefa que não se completa dificilmente vai converter, não importa quanto limite se dê. A segunda é se o custo vem de amostras reais, incluindo entrada, saída, novas tentativas e eventuais custos de cache ou de ferramentas. A terceira é se, quando o limite acabar, o usuário tem clareza do que recebeu e do que pode fazer em seguida.
O retrospecto da ChatPRD oferece uma referência concreta: um limite de teste mal definido gera prejuízo de custo, mas desligar o teste de forma generalizada também prejudica a aquisição de usuários. Por isso, o caminho é desenhar o teste como algo calculável e passível de revisão, em vez de escolher entre “tudo aberto” e “tudo fechado”.
Mapa de conhecimento e índice para o planejamento dos créditos de teste gratuito
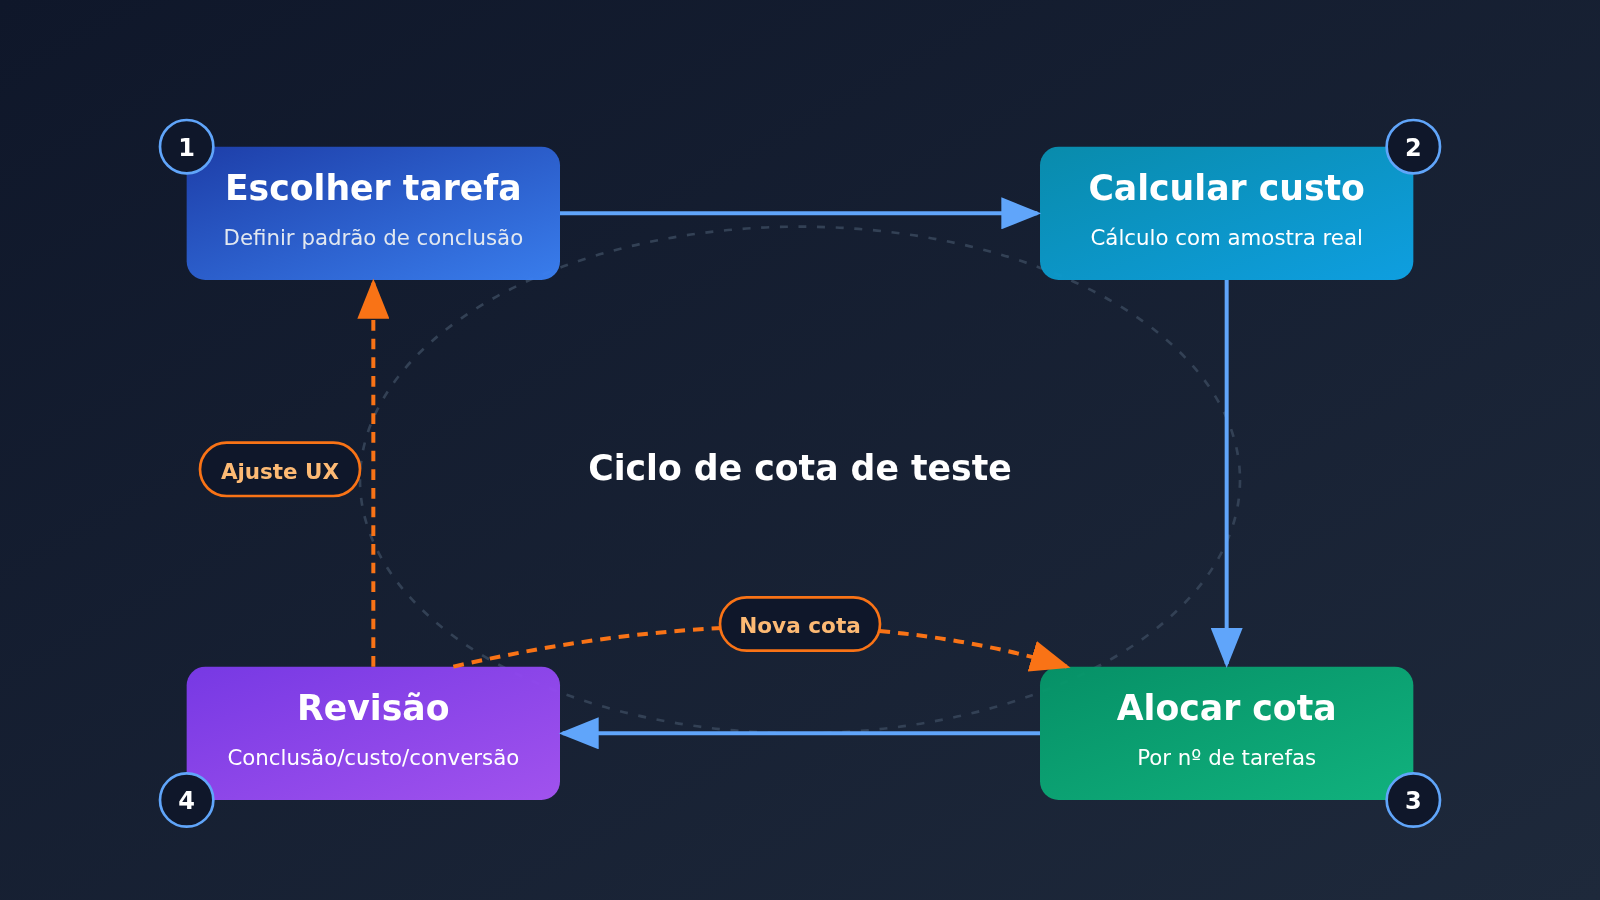
A tabela abaixo funciona ao mesmo tempo como mapa de conhecimento e índice de leitura. As quatro etapas estão ordenadas pela ordem de execução: a saída da etapa anterior é a entrada da próxima.
| Etapa | Seção correspondente | Por que fazer | O que é necessário | O que se obtém |
|---|---|---|---|---|
| Escolher a tarefa | 2, 2.1, 2.2 | Os créditos só fazem sentido se forem usados para concluir algo valioso | Valor central do produto, primeira necessidade do usuário típico | Uma tarefa mínima com critério de conclusão claro, além dos limites das funcionalidades disponíveis no teste |
| Calcular o custo | 3, 3.1, 3.2 | Sem o custo por uso, tanto os créditos quanto o orçamento só podem ser definidos no chute | Amostras reais de invocação, preço unitário do modelo, retentativas e custos adicionais | Custo por conclusão, custo por conta, teto do orçamento total |
| Definir os créditos | 3.3, 4 | O usuário precisa entender quantas tarefas os créditos permitem fazer, e não entender tokens | Custo por conta, número de tarefas, texto da mensagem exibida quando os créditos acabam | Créditos expressos em “número de tarefas” e um aviso claro de esgotamento |
| Revisar os resultados | 4.1 | O efeito dos créditos precisa ser validado com dados para decidir se é melhor mudar a experiência ou os créditos | Taxa de conclusão, custo por pessoa que concluiu, dados de conversão para pago | Direção de ajuste para a próxima rodada |
A ordem de leitura recomendada é da seção 1 à seção 4. A seção 1 apresenta o contexto do problema e ajuda a evitar uma leitura equivocada do caso ChatPRD. A seção 2 traz a tarefa de exemplo, e todos os cálculos da seção 3 se baseiam nessa tarefa. Já os indicadores de revisão da seção 4, por sua vez, corrigem as definições das seções 2 e 3, formando um ciclo. Se você já tem uma tarefa central bem definida, pode começar direto pela seção 3.
Para Saber: Termos Essenciais para Entender o Cálculo de Créditos de Teste Gratuito
| Termo | Explicação Resumida |
|---|---|
| Token | Unidade usada pelos Modelos de Linguagem Grande para medir o comprimento do texto de entrada e saída; a maioria das APIs de modelos cobra separadamente por tokens de entrada e de saída |
| Tarefa mínima completa | Uma coisa que o usuário consegue concluir sozinho durante o teste e que permite sentir diretamente o valor do produto — é a unidade básica do design de créditos |
| Nova tentativa | Quando o usuário não fica satisfeito com o resultado e gera novamente, ou quando a requisição falha e é chamada outra vez, ambos geram custo adicional |
| Custo de uma conclusão | O custo médio de chamada para concluir uma tarefa mínima completa uma vez, incluindo novas tentativas e eventuais taxas adicionais aplicáveis |
| Taxa de conclusão da primeira tarefa válida | A proporção de usuários em teste que concluem ao menos uma vez uma tarefa central por completo |
1. Retrospectiva do ChatPRD: o que aconteceu quando os créditos de teste gratuito deram problema
1.1 Fatos-chave da retrospectiva
Claire Vo, fundadora do ChatPRD, publicou em 16/11/2026 uma retrospectiva cujo tema era a fraude de tokens corroendo a margem dos produtos de IA. Ela contou que, ao longo de quase um ano, gastou dezenas de milhares de dólares com isso e chegou a desativar o teste gratuito, o que acabou prejudicando a aquisição de clientes e a geração de leads para vendas enterprise.
Há ainda um número na retrospectiva que é fácil de interpretar errado: quase 200 mil dólares. Esse é o valor das tentativas de pagamento que falharam, não o valor efetivamente perdido. Ao repassar esse caso, é preciso separar “as dezenas de milhares de dólares já gastas” das “quase 200 mil dólares em tentativas de pagamento falhas”; caso contrário, a escala do problema fica seriamente exagerada.
1.2 Não tire deste caso a conclusão de “cancelar o teste”
A página de preços pública atual do ChatPRD ainda lista um plano gratuito, e os planos Pro e Teams também oferecem 14 dias de teste. Portanto, não se deve entender esta retrospectiva como se o ChatPRD tivesse cancelado todos os testes gratuitos, e muito menos extrapolar a experiência de um único produto para o setor inteiro.
O que realmente vale aprender deste caso são duas lições. O uso indevido dos créditos de teste corrói diretamente a margem, mas desligar o teste faz com que potenciais usuários reais e clientes enterprise se percam. O que o produto precisa é de um método de design de créditos que faça o usuário real sentir o valor e, ao mesmo tempo, deixe o custo do subsídio claramente calculado — as próximas seções giram em torno desse objetivo.
2. Projetar a cota de teste gratuito em torno de “gerar um rascunho de PRD editável”
Para que os cálculos adiante tenham um objeto concreto, vamos usar uma tarefa de exemplo: o usuário informa uma ideia de produto e, no fim, recebe um rascunho de PRD que pode continuar editando. Escolhemos essa tarefa porque ela é a que mais se aproxima do dia a dia de um product manager — ao receber o resultado, o usuário consegue julgar na hora se “aquilo serve para alguma coisa”.
Vale deixar claro que esta é apenas uma tarefa de demonstração, usada para mostrar o método, e não representa o desenho real do teste gratuito do ChatPRD. Seu produto pode trocá-la por “gerar uma análise de concorrentes”, “reescrever um texto de marketing” ou “concluir uma revisão de código” — o método continua o mesmo.
2.1 Definir o critério de conclusão da tarefa de teste gratuito
O critério de conclusão precisa ser verificável e, de preferência, algo que dê para determinar por meio de eventos instrumentados nos dados do produto. Para “gerar um rascunho de PRD editável”, dá para definir assim:
- O usuário enviou uma ideia de produto e respondeu às perguntas de esclarecimento necessárias.
- O sistema gerou um rascunho com estrutura completa, contendo pelo menos estas partes: contexto, usuários-alvo, requisitos centrais e critérios de aceitação.
- O usuário editou o rascunho pelo menos uma vez ou pediu alguma alteração — sinal de que o conteúdo entrou no fluxo de trabalho real dele.
- O usuário exportou, copiou ou salvou o rascunho.
Os itens 3 e 4 são o que separa “deu uma olhada” de “usou de verdade”. Apenas gerar, sem editar e sem salvar, normalmente indica que o resultado não convenceu o usuário. Contar esse tipo de teste como concluído distorce os dados na análise posterior.
2.2 Escolher os recursos e limites disponíveis no teste gratuito
Os limites de recursos determinam quais capacidades precisam ser chamadas para concluir a tarefa e também definem diretamente a estrutura de custos. Os recursos liberados durante o teste devem cobrir exatamente o necessário para atender ao critério de conclusão — não é preciso abrir todas as capacidades avançadas de uma vez.
- O que liberar: diálogo de esclarecimento, geração do rascunho, modificações baseadas na conversa, exportação ou cópia. Esses são passos obrigatórios para concluir a tarefa; sem um deles o usuário não termina.
- O que pode ficar limitado: upload de documentos longos, busca na web, comparação entre múltiplos documentos e outras capacidades caras ou não essenciais. Elas podem ficar para o plano pago como motivo de upgrade.
- O que precisa de teto: comprimento de entrada por envio e número de rodadas de edição por rascunho. O teto serve para tornar o custo previsível, não para dificultar a vida do usuário.
Com os limites definidos, dá para listar o caminho típico de chamadas necessário para concluir uma tarefa. A estimativa de custo da seção 3 é construída somando passo a passo ao longo desse caminho.
3. Estimar o orçamento de subsídio para a cota de teste gratuito com base no uso real
A fórmula central desta seção é uma só: o orçamento do teste é igual ao custo de invocação necessário para concluir a tarefa-alvo, multiplicado por uma quantidade razoável de tarefas de teste. Esse custo deve ser levantado a partir de amostras reais, considerando entrada, saída, eventuais custos de cache ou ferramentas e novas tentativas. O teto geral do orçamento e a mensagem exibida quando a cota acaba ficam a critério da equipe de produto.
3.1 Estimar o custo de uma conclusão a partir de amostras reais
Antes de tudo, um esclarecimento sobre os critérios: os números de tokens, as taxas de nova tentativa e os preços unitários da tabela abaixo são todos valores hipotéticos definidos apenas para demonstrar o cálculo. Não são preços públicos de nenhum modelo nem dados medidos. Na prática, você deve substituir esses números pelos logs reais de invocação de testes internos ou de usuários em rollout gradual.
Se as invocações do seu modelo passarem por uma plataforma agregadora, você pode obter os dados comparando a página pública de preços dos modelos e o recurso de consulta de logs de invocação, como os documentos de preços de modelos e de consulta de logs da APIYI. Vale notar que esse tipo de plataforma fornece apenas dados de custo; a política de teste em si continua sendo definida por quem desenvolve a aplicação.
Hipóteses do exemplo: preço unitário de entrada de US$ 2 por milhão de tokens, preço unitário de saída de US$ 8 por milhão de tokens, sem uso de ferramentas como navegação na web e desconto de cache considerado como 0.
| Etapa | Tokens de entrada (hipótese) | Tokens de saída (hipótese) | Custo por chamada (US$) |
|---|---|---|---|
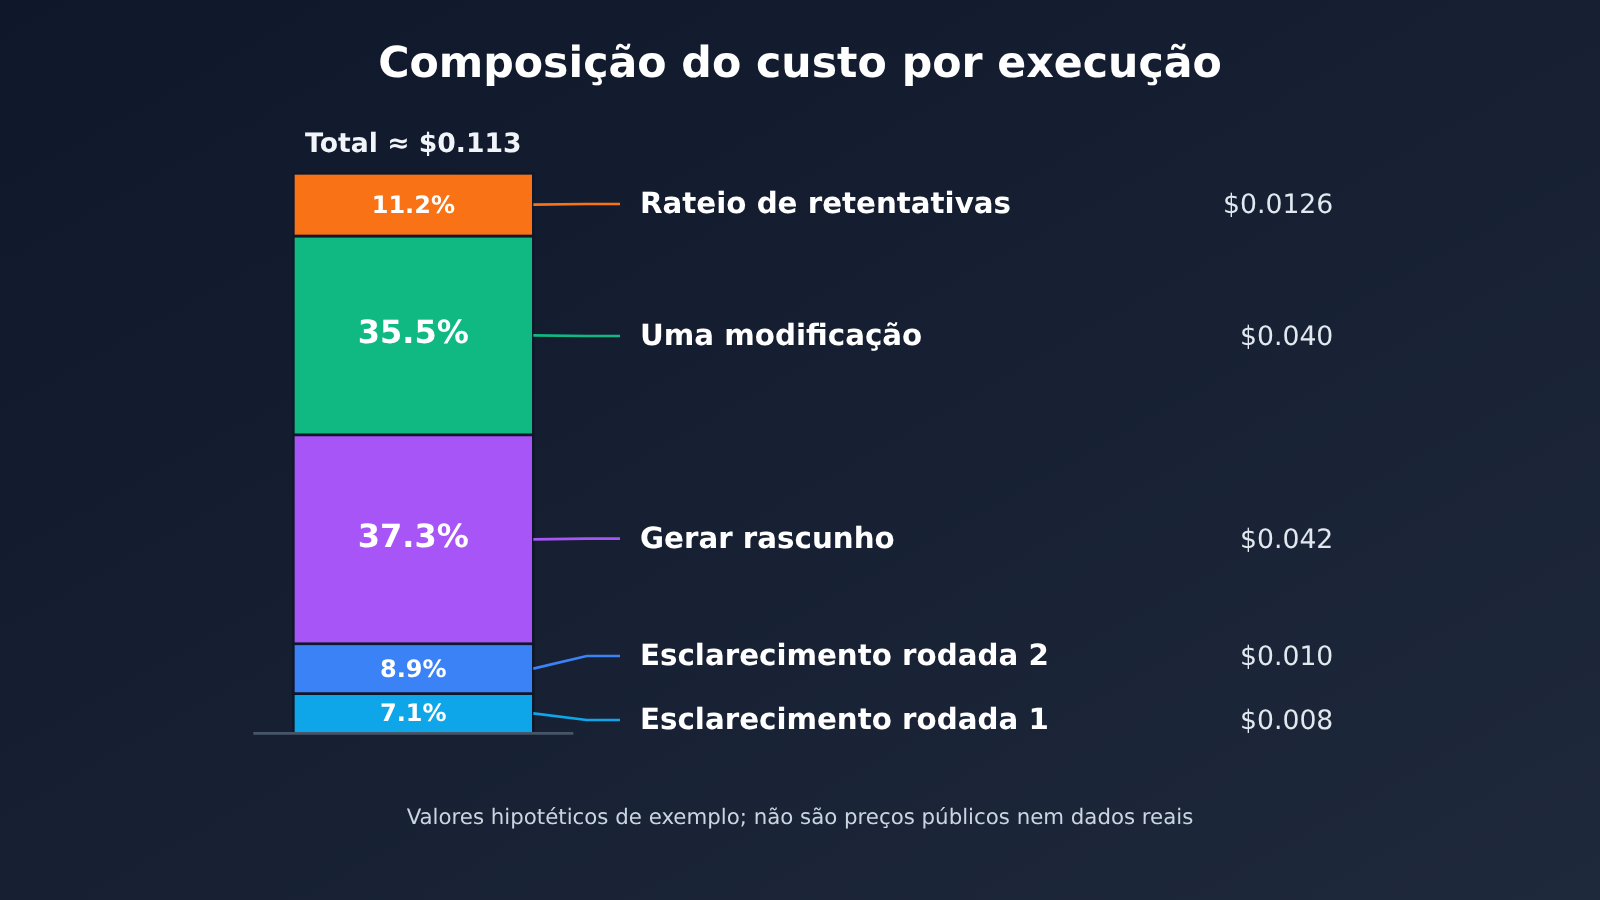
| Diálogo de esclarecimento, 1ª rodada | 2,000 | 500 | 0.008 |
| Diálogo de esclarecimento, 2ª rodada | 3,000 | 500 | 0.010 |
| Gerar rascunho | 5,000 | 4,000 | 0.042 |
| Uma revisão | 10,000 | 2,500 | 0.040 |
| Subtotal | 20,000 | 7,500 | 0.100 |
| Nova tentativa (hipótese: 30% dos usuários geram o rascunho novamente uma vez) | — | — | 0.0126 |
| Custo de uma conclusão | — | — | aprox. 0.113 |
O cálculo é bem direto: o custo de cada etapa é igual ao número de tokens de entrada multiplicado pelo preço unitário de entrada, mais o número de tokens de saída multiplicado pelo preço unitário de saída. A entrada da etapa de revisão é claramente maior porque ela carrega junto o diálogo anterior e o rascunho inteiro; essa é uma característica comum do custo em tarefas com várias rodadas. A nova tentativa é considerada apenas na etapa de geração de rascunho, que é a mais frequente, e entra rateada como US$ 0.042 multiplicado por 30%.
3.2 Do custo por conclusão ao orçamento por conta e ao orçamento total
Com o custo por conclusão em mãos, você decide quantas tarefas cada conta de teste pode concluir. No exemplo, definimos 3: a primeira para experimentar e as duas seguintes para o usuário testar mais um pouco no próprio projeto real. Esse número também é um valor hipotético e depende de quantas vezes seus usuários normalmente precisam para formar uma opinião.
| Item de orçamento | Como calcular | Resultado de exemplo (hipotético) |
|---|---|---|
| Custo por conclusão | Estatística da amostra da seção 3.1 | Cerca de US$ 0,113 |
| Tarefas de teste por conta | A equipe de produto define conforme o hábito de decisão dos usuários | 3 |
| Limite de custo por conta | Custo por conclusão × número de tarefas | Cerca de US$ 0,34 |
| Novas contas de teste mensais estimadas | Do plano de aquisição de clientes | 5.000 |
| Teto orçamentário mensal | Limite de custo por conta × número de contas | Cerca de US$ 1.690 |
O valor calculado aqui é o teto para quando todos os usuários usarem a cota completa. O gasto real costuma ficar abaixo disso, porque muitos usuários saem depois de uma ou duas tentativas ou partem direto para o plano pago. A equipe de produto pode definir o orçamento geral com base nesse teto; se o gasto real ultrapassar claramente o esperado, isso indica uso anômalo ou problema no critério da amostra, e é preciso voltar à seção 3.1 para revisar.
3.3 Tabela de orçamento de créditos de teste gratuito pronta para preencher
Juntando os passos acima em uma planilha em branco, sua equipe pode preencher diretamente com os próprios dados:
| Item a preencher | Seus dados | Fonte dos dados |
|---|---|---|
| Nome da tarefa mínima completa | Definição da tarefa na seção 2 | |
| Tokens médios de entrada por etapa | Logs de chamadas reais | |
| Tokens médios de saída por etapa | Logs de chamadas reais | |
| Preço unitário de entrada e saída | Página de preços públicos do modelo usado | |
| Custos de cache ou ferramentas aplicáveis | Fatura ou documentação de preços | |
| Proporção habitual de retentativas e etapas envolvidas | Dados de telemetria | |
| Custo de uma conclusão | Soma dos itens acima | |
| Número de tarefas de teste por conta | Decisão de produto | |
| Número estimado de contas de teste | Plano de aquisição | |
| Limite máximo do orçamento total e forma de lidar com ultrapassagem | Decisão conjunta de produto e finanças |
Depois de preencher, o crédito exibido externamente deve ser expresso em “número de tarefas” em vez de tokens ou pontos — por exemplo, “durante o período de teste você pode gerar 3 rascunhos de PRD”. O usuário entende na hora quantas coisas o crédito pode ajudá-lo a fazer, e internamente a equipe de produto faz a apuração com base no limite de custo.
4. Aviso claro quando a cota de teste gratuito acaba
O momento em que a cota acaba é o ponto decisivo para o usuário decidir se vale a pena pagar. Se o aviso for vago, o usuário pode pensar que o produto apresentou falha; se for rígido demais, o usuário sente que toda a experiência anterior foi só uma isca. Um aviso adequado deve conter três tipos de informação:
- O que já foi obtido: por exemplo, “Você já concluiu 3 rascunhos de PRD, todos salvos no projeto”, para o usuário confirmar que os resultados do teste continuam disponíveis.
- O que não é possível fazer agora: deixar claro qual operação exige cota, para o usuário não ser bloqueado no meio da ação.
- Quais são as próximas opções: como continuar usando as funções básicas do plano gratuito, assinar um plano pago ou falar com a equipe sobre o plano empresarial.
Há também um detalhe que vale a pena projetar desde já: evite esgotar a cota no meio de uma tarefa. Antes de iniciar uma nova tarefa, verifique se a cota restante é suficiente para concluí-la; se não for, avise antes de começar. Assim o usuário sente “já concluí várias coisas”, em vez de “fui interrompido no meio”.
4.1 Revisando a cota de teste gratuito: mudar a experiência ou a cota
Depois que o teste entra em operação, use três indicadores para identificar onde está o problema:
- Taxa de conclusão da primeira tarefa válida: proporção de usuários de teste que concluíram pelo menos uma tarefa segundo o critério de 2.1, refletindo se a experiência de teste está fluida.
- Custo por concluinte: custo total do teste dividido pelo número de concluintes, refletindo quanto de subsídio foi gasto para cada usuário que “sentiu valor”.
- Conversão para pagante: proporção dos concluintes que acabaram pagando, refletindo se o valor é suficiente para sustentar a decisão de compra.
Só olhando os três indicadores em conjunto é possível julgar o que ajustar:
| Desempenho dos dados | Possível causa | Direção do ajuste |
|---|---|---|
| Conclusão baixa, custo por concluinte alto | Usuários travam no meio da tarefa, o subsídio vai para quem não concluiu | Mudar a experiência: simplificar passos, otimizar a orientação inicial, verificar se os limites de funcionalidade deixam de fora capacidades necessárias |
| Conclusão baixa e muitos usuários esgotam a cota no meio da tarefa | O custo de uma tarefa foi subestimado, a cota não basta para concluir uma coisa | Mudar a cota: recalcular o custo de conclusão com uma nova amostra, ou reduzir o escopo da tarefa |
| Conclusão alta, conversão para pagante baixa | A tarefa pode ser concluída, mas o valor não basta para pagar, ou a cota é excessiva e o usuário não precisa fazer upgrade | Primeiro revisar o valor da tarefa, depois considerar reduzir o número de tarefas |
| Conclusão alta, conversão normal, custo por concluinte subindo continuamente | Aumento de tentativas repetidas ou entradas mais longas | Voltar a 3.1 para investigar as causas das tentativas repetidas e o comprimento do contexto |
A ordem sugerida de avaliação é: primeiro a taxa de conclusão, depois o custo, por fim a conversão. Quando a taxa de conclusão não atinge o esperado, ajustar a cota geralmente não faz sentido, porque o usuário nem concluiu uma coisa; dar mais cota só amplia o desperdício. Depois que a taxa de conclusão se estabiliza, use custo e conversão para ajustar finamente o número de tarefas e o orçamento total, e então volte à Seção 2 para verificar se a definição das tarefas precisa ser atualizada.
Depois de colocar todo esse método em prática, você deve conseguir responder a uma pergunta concreta: quanto custa ao produto cada novo usuário de teste que realmente sente valor, e quanto essa despesa traz em pagamentos. Conseguindo fechar essa conta, a cota de teste gratuito deixa de ser uma despesa difícil de controlar e passa a ser um canal de aquisição que pode ser otimizado continuamente.
Uma jornada de mil milhas começa com um único passo. — Laozi
Referências
-
Artigo de retrospectiva de Claire Vo, fundadora do ChatPRD: sobre como a fraude de tokens corrói as margens de IA e como lidar com isso
- Link:
chatprd.ai/how-i-ai/token-fraud-is-eating-ai-margins-here-s-how-claire-vo-is-fighting-it - Descrição: fonte dos fatos do caso na seção 1 deste artigo
- Link:
-
Página de preços do ChatPRD: informações sobre o plano gratuito atual e o teste de 14 dias do Pro e Teams
- Link:
chatprd.ai/pricing - Descrição: usada para confirmar a política de teste atual do produto
- Link:
-
Documentação de preços de modelos da APIYI: preços públicos de cada modelo
- Link:
docs.apiyi.com/models - Descrição: pode ser usada para consultar preços unitários e preencher a planilha de orçamento da seção 3.3
- Link:
-
Documentação de consulta de logs de chamadas da APIYI: registro de chamadas e consulta de uso
- Link:
docs.apiyi.com/api-capabilities/log-query - Descrição: pode ser usada para contabilizar tokens de entrada e saída e retentativas em amostras reais
- Link:


