
Nota do autor: o d1.2-ultra aparece em 1º lugar no Decision Index v2.1. Este artigo ensina você a primeiro identificar se o seu caso é extração de documentos, chamada de ferramentas ou resposta a perguntas difíceis, olhar apenas para a subpontuação que realmente importa e, então, usar de 20 a 50 amostras próprias para decidir se vale trocar.
Em 16 de novembro de 2026, a Liquid AI lançou o d1.2 e o d1.2-ultra. O blog oficial afirma que o d1.2-ultra obteve 75 pontos no Artificial Analysis Decision Index v2.1, a maior pontuação entre os modelos de decisão. Muitos desenvolvedores que estão integrando APIs, ao ver o “1º lugar”, têm como primeira reação trocar o modelo em produção.Não tenha pressa para trocar: a pontuação geral 75 é apenas o ponto de partida; o que realmente importa é a pontuação da subcategoria que corresponde ao seu negócio.
Este não é um artigo para detonar nem para endeusar o modelo. O mesmo modelo fica em 1º na extração de documentos, mas, em questões de múltipla escolha muito difíceis, tem a menor acurácia bruta entre 24 modelos de decisão. As duas coisas são verdade ao mesmo tempo, e a pontuação agregada as dilui.
Valor principal: ao terminar a leitura, você vai saber qual subpontuação olhar, como interpretar a pontuação de decisão e a acurácia bruta, e como usar de 20 a 50 amostras próprias para chegar, em uma tarde, à conclusão sobre trocar ou não.
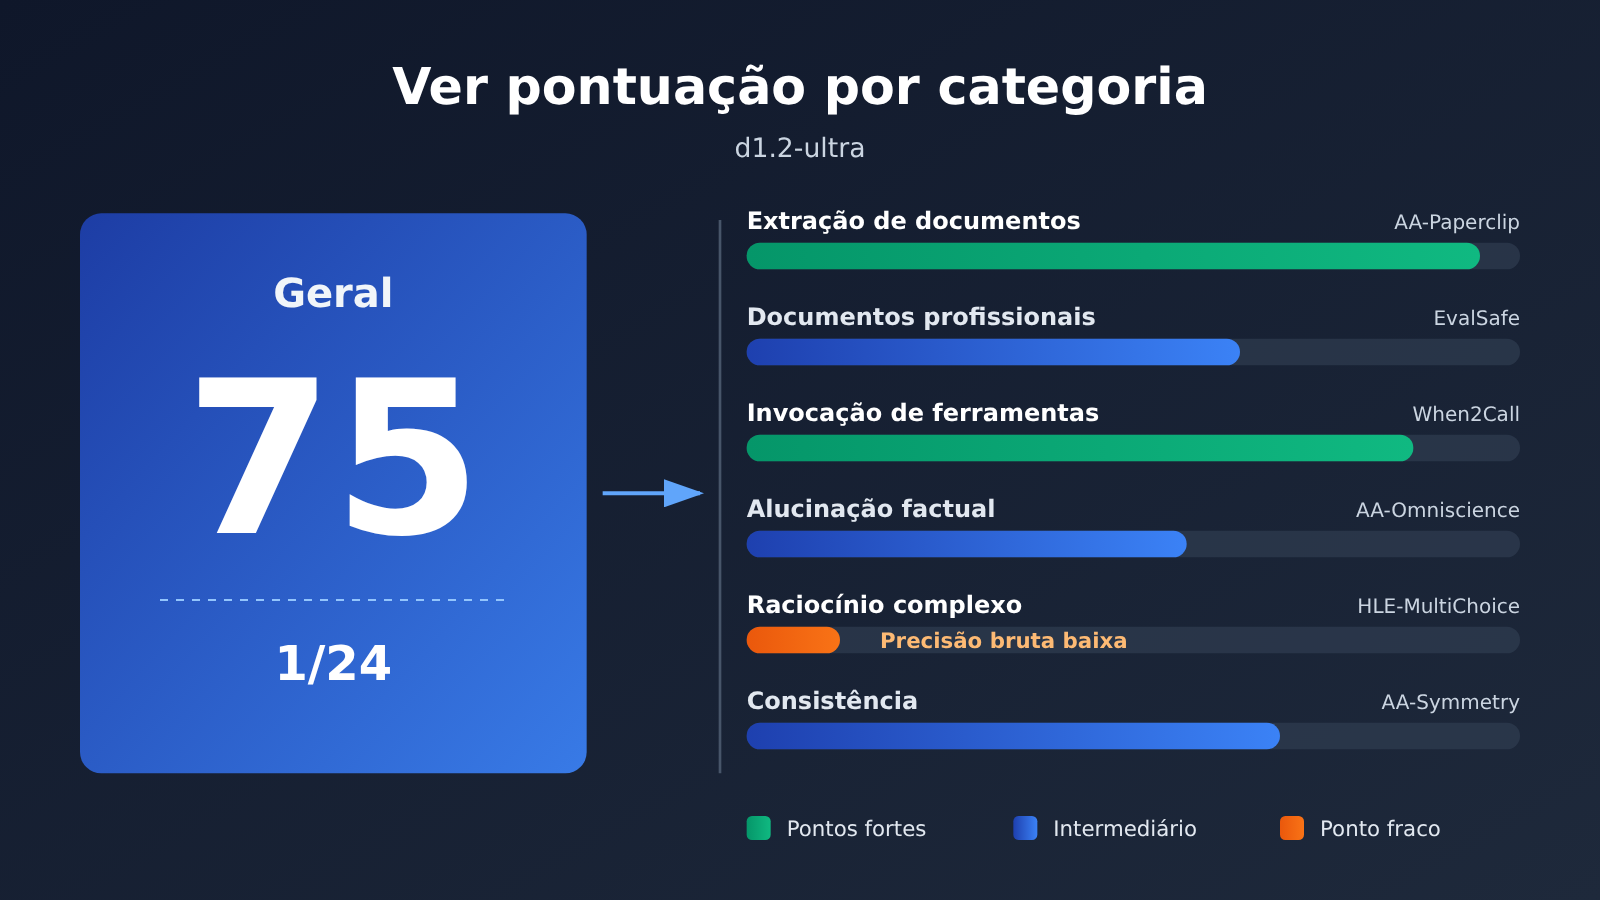
d1.2-ultra: os pontos centrais do primeiro lugar geral
Primeiro, vamos deixar claros os números da página do ranking. Os dados abaixo vêm da página do modelo d1.2-ultra no Artificial Analysis, com data de leitura em 2026-11-17, e são 24 modelos de decisão na comparação.
| Item | Dados da página do ranking | Como ler |
|---|---|---|
| Índice geral | 74.85, exibido como 75 na página, 1º/24 | O 2º lugar, Drex Max v1.1, tem 72.62, uma diferença de cerca de 2.2 pontos — é a mesma coisa que os “dois pontos” citados oficialmente, só que arredondada |
| Tempo | 218 ms/tarefa, 14º/24 | A mediana da página é 209 ms, o que fica na faixa intermediária |
| Custo para completar o índice | 133 dólares por milhão de tarefas, 11º/24 | É o custo por tarefa, não o preço de tabela por milhão de tokens |
| Preço de entrada | 0.042 dólar por milhão de tokens | Igual ao blog oficial da Liquid; oficialmente só a entrada é contabilizada |
| Brier | 0.150, o menor entre os 24 | Quanto menor, melhor — indica que as probabilidades fornecidas são mais “honestas” |
Como é calculada a pontuação geral do d1.2-ultra
O Decision Index v2.1 é a média ponderada de seis subitens. A definição da pontuação de decisão na página do modelo é: a acurácia menos o Brier score da probabilidade da resposta escolhida, numa faixa de 0 a 100, quanto maior melhor. Ou seja, errar com confiança desconta mais do que errar com hesitação. Já a acurácia bruta é a proporção de questões em que o modelo atribui a maior probabilidade à opção correta, e não é o mesmo número que a pontuação de decisão.
Essa diferença afeta diretamente como você lê o d1.2-ultra. Um modelo pode obter uma pontuação de decisão nada desprezível simplesmente por evitar palpites e cometer menos erros com confiança, enquanto sua acurácia bruta é baixa. Se o seu negócio exige “é preciso dar uma resposta”, você deve olhar a acurácia bruta; se o negócio permite “na dúvida, passe para um humano”, a pontuação de decisão é mais útil como referência.
| Subitem | Peso | O que mede | Classificação na AA |
|---|---|---|---|
| AA-Paperclip | 30% | Julgamento e extração de documentos; um documento com 15 respostas conta como um julgamento | Documentos |
| EvalSafe-O*NET-AA | 15% | Julgamento de documentos de trabalho | Documentos |
| When2Call | 10% | Invocação de ferramentas | Ferramentas |
| AA-Omniscience-Decision v1.1 | 15% | Conhecimento e alucinação | Conhecimento |
| HLE-MultiChoice v1.1 | 15% | Questões de múltipla escolha em texto do Humanity’s Last Exam, com opção de recusar resposta | Raciocínio |
| AA-Symmetry v1.1 | 15% | Se o julgamento permanece o mesmo após reformular, trocar a ordem das opções ou negar | Consistência |
Atenção: o HLE-MultiChoice é classificado como raciocínio na AA, não como conhecimento. Portanto, ao mencioná-lo adiante, não o descreva como “teste de conhecimento”.
Como identificar a métrica do d1.2-ultra que corresponde ao seu trabalho
O primeiro passo não é olhar o ranking, mas pegar uma folha de papel e anotar a qual categoria o seu trabalho pertence: extrair dados de documentos, chamar ferramentas, responder questões difíceis ou perguntas de conhecimento. Depois de escrever, olhe apenas para a métrica correspondente; por enquanto, ignore as outras métricas e a pontuação geral de 75.
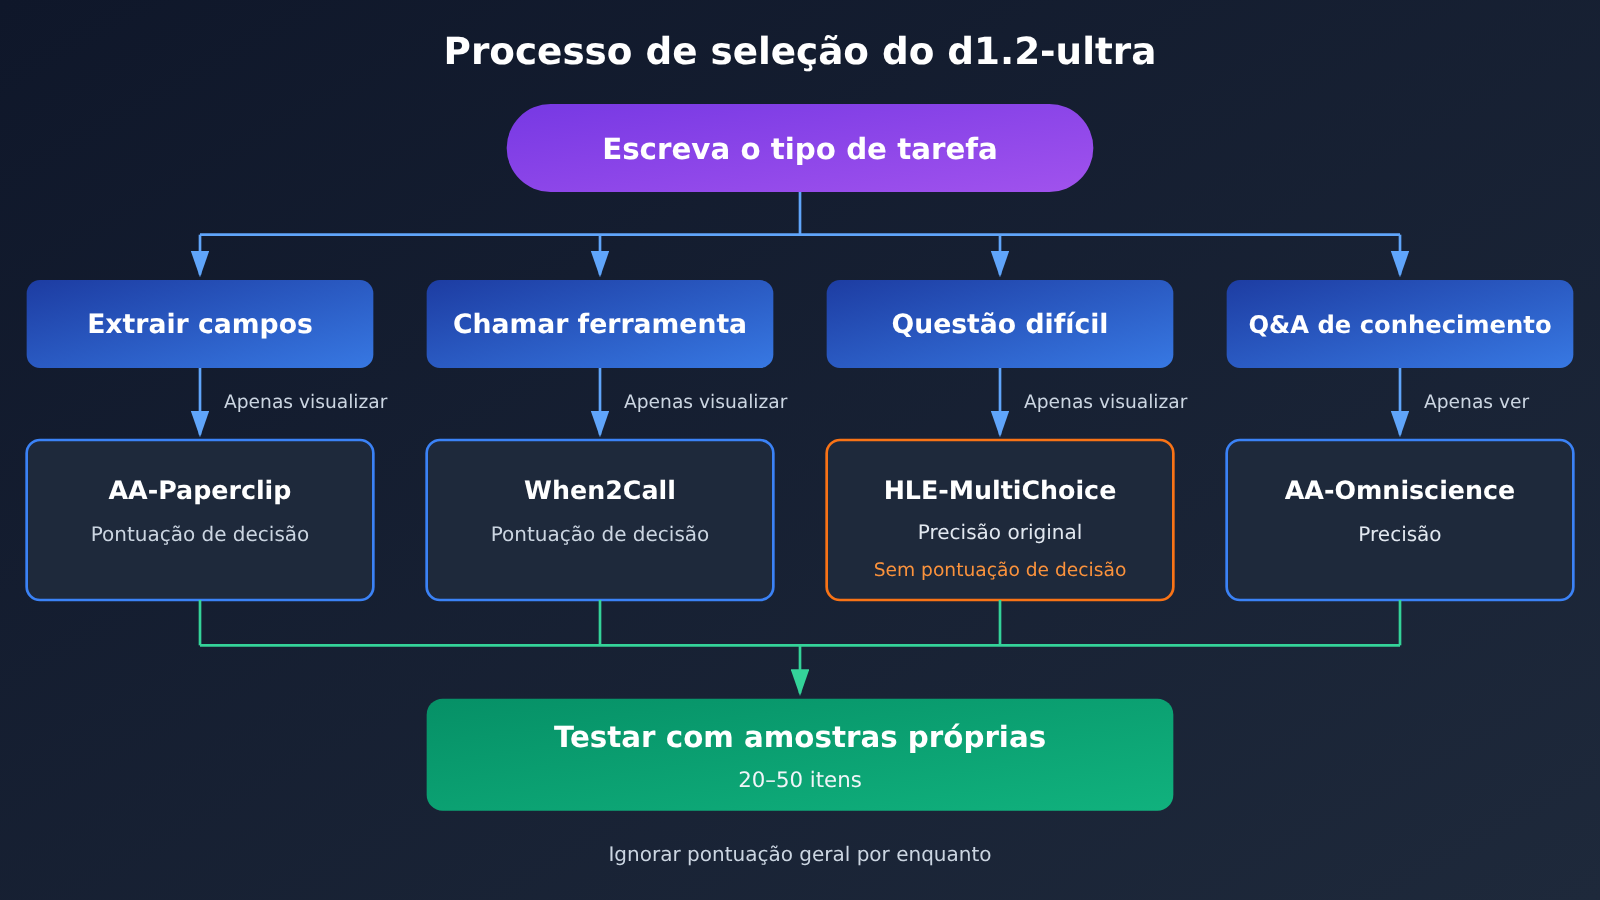
| O que você precisa fazer | Olhe só para esta métrica | Dados da página do ranking do d1.2-ultra | Como interpretar |
|---|---|---|---|
| Extrair campos de faturas, currículos e artigos | AA-Paperclip | Pontuação de decisão 75.81, taxa de documentos totalmente corretos 67.7%, ambas em 1/24 | O 2º lugar, Drex Max v1.1, tem 72.82 e 63.0%, então a liderança é relativamente clara |
| Chamar ferramentas e decidir se vale a pena chamá-las | When2Call | Pontuação de decisão 96.49, 1º lugar | SubQ Snap 1.2 tem 96.10, d1.2 tem 96.09; os primeiros colocados estão separados por cerca de 1 ponto |
| Julgamento de documentos de trabalho | EvalSafe-O*NET-AA | Pontuação de decisão 89.53, 3º lugar | À frente estão Jev 1.14 (91.14) e GLiDE v1.2 (89.67) |
| Responder questões de múltipla escolha muito difíceis | Acurácia bruta do HLE-MultiChoice | 2.36%, a mais baixa entre 24 modelos de decisão | A pontuação de decisão 46.36 não fica em último; a taxa de não alucinação é 76.1%, e ele costuma optar por não chutar |
| Perguntas e respostas de conhecimento | Acurácia do AA-Omniscience | Acurácia bruta 23.6%, 20/24 | A pontuação de decisão 60.80 fica em 6º lugar; a taxa de não alucinação é 83.8% |
| A resposta fica estável quando a pergunta é reformulada? | Taxa de aprovação total do AA-Symmetry | Pontuação 86.34, 2º lugar; taxa de aprovação total 56.7%, 5º lugar | Ficar em 2º na pontuação não significa ficar em 2º na estabilidade |
Os dois pontos mais fáceis de interpretar errado nos itens do d1.2-ultra
O primeiro é o HLE-MultiChoice. A acurácia bruta de 2.36% é mesmo a mais baixa entre os 24 modelos de decisão, mas sua pontuação de decisão de 46.36 não fica na lanterna — na mesma página há valores menores, como o 34.79 do Mercury Decide. Somando a isso uma taxa de não-alucinação de 76.1%, a leitura razoável é: diante de questões de múltipla escolha de raciocínio muito difíceis, o d1.2-ultra tende a não dar respostas com alta confiança. A AA classifica esse item como raciocínio, então não dá para dizer que ele é “o último colocado no teste de conhecimento”.
O segundo é o AA-Omniscience. A acurácia de 23.6% o coloca em 20º de 24, não em último lugar. Curiosamente, o d1.2, menor, aparece na mesma página com 30.0% neste item, e sua acurácia bruta no HLE também é 5.30% — os dois valores são maiores que os do ultra. Mas o índice composto do d1.2 é 68.69, o que o coloca em 9º de 24, então “o ultra, mais caro, tem conhecimento pior” vale só para esses dois itens — não dá para generalizar como se fosse pior em tudo.
🎯 Dica de leitura do ranking: se o seu trabalho é extrair dados de documentos, o 1º lugar do
d1.2-ultrano AA-Paperclip merece atenção séria; se for uso de ferramentas, o 1º lugar é real, mas a diferença para os seguintes fica dentro de 1 ponto — trocar ou não depende da sua própria amostra.
Como usar os dados autodeclarados do d1.2-ultra
No mesmo post do blog, a Liquid também apresentou cinco novas tarefas e resultados de testes internos. O fabricante deixa claro que essas novas tarefas ainda não têm cobertura de benchmarks públicos, e que os dados a seguir são todos autodeclarados, obtidos com conjuntos de validação internos — ou seja, não são resultados do Artificial Analysis.
| Nova tarefa (autodeclarada) | d1.2-ultra | d1.2 | Observações |
|---|---|---|---|
| Leitura de recibos (CORD, SROIE) | 98% | 96% | responde “not found” quando o valor não existe |
| Precisão/recall de spans de informações sensíveis (Nemotron PII) | 94% / 93% | 92% / 88% | indica a posição de cada trecho |
| Delimitar objetos por descrição (série RefCOCO) | 94% | 94% | ambos empatados |
| Contar objetos, tolerância de 1 (COCO) | 93% | 92% | estima um número e fornece um intervalo |
| Destacar cada objeto na imagem (COCO) | 87% | 90% | nesta linha, o d1.2 mais barato é melhor |
No caso de áudio, o fabricante afirma que, em gravações de validação, ao classificar categorias de som (ESC-50) e idiomas (FLEURS, 43 idiomas), ambos ficam na faixa de cerca de 95% a 97%. Quanto ao erro de calibração, a Liquid mediu, em 13 benchmarks e 22505 questões, d1.2-ultra com 0,8, d1.2 com 1,2, Jev 1.14 com 2,7, Perplexity Decider v1.3 com 3,7 e a Decisions API do GPT-6 Luna com 7,2.
Aqui é preciso separar bem as coisas: o GPT-6 Luna (Decisions) tem índice composto 60,25 no ranking de decisões do Artificial Analysis, ocupando a posição 22/24, com precisão bruta de 7,86% no HLE. Todos esses números são resultados da interface Decisions e não podem ser tratados como resultados da interface de chat gpt-6-luna. O blog oficial também menciona “Coming to OpenRouter and Vercel soon” — trata-se de uma prévia do fabricante, que não significa que já esteja disponível.
Início rápido do d1.2-ultra: teste com suas próprias amostras
Depois de ver o ranking, o que realmente decide se você troca ou não é o seu próprio conjunto de dados. Prepare de 20 a 50 amostras reais e já é o suficiente — por exemplo, 30 notas fiscais ou 30 currículos, cada uma com os campos corretos pré-anotados, e de preferência algumas delas com um campo faltando de propósito.
Passo a passo enxuto
- Selecione de 20 a 50 amostras do seu negócio e anote manualmente o valor correto de cada campo, marcando campos ausentes como not found.
- Escreva um comando fixo: peça ao modelo para retornar em JSON os campos especificados, e campos que não forem encontrados devem obrigatoriamente ser preenchidos com
not found, sem nenhuma especulação. - Use um SDK compatível com OpenAI, defina
base_urlcomohttps://api.apiyi.com/v1e preenchamodelprimeiro comgpt-6-luna, depois troque paragpt-6.1-sole rode uma vez com cada um. - Compare item por item e registre três números: precisão em nível de campo, taxa de acerto total do documento e quantidade de vezes em que campos ausentes foram preenchidos com valores inventados.
- Quando o modelo alvo estiver disponível para invocação, rode novamente com o mesmo lote de amostras e o mesmo comando, e compare os três números diretamente.
Ver a abordagem completa de comparação
– **Entrada**: um arquivo de amostras, cada linha contendo o texto original (ou a imagem) e o dicionário de campos anotado manualmente.
– **Invocação**: percorra as amostras em loop e chame `client.chat.completions.create` ou o endpoint `responses`, com `temperature` definido em 0 e exigindo saída em JSON estrito.
– **Parsing**: falhas de parsing da saída são contadas separadamente — isso em si já é um indicador de usabilidade.
– **Comparação**: faça uma comparação normalizada campo a campo (remover espaços, padronizar formato de data, manter valores monetários com duas casas decimais).
– **Contagem de alucinação**: campos anotados como not found em que o modelo preencheu algum valor são contados separadamente como “chute”.
– **Sumarização**: gere a precisão de campos, a taxa de acerto total do documento, o número de chutes e o consumo médio de tokens, para facilitar o cálculo de custo depois.
Rode primeiro uma linha de base no APIYI
Isso vai consumir tokens. O d1.2 e o d1.2-ultra não estão na lista de modelos do APIYI, então por enquanto você pode usar no APIYI (apiyi.com) os modelos já disponíveis gpt-6.1-sol ou gpt-6-luna, com o endereço de invocação https://api.apiyi.com/v1, e rodar o mesmo lote de notas fiscais ou currículos para ver se os campos estão corretos e se campos inexistentes são inventados. Assim você já tem uma linha de base quantificável nas mãos.
Ainda não está no catálogo; vamos disponibilizar esse modelo o mais rápido possível. Modelos e preços estão sujeitos à lista de modelos da plataforma.
| Item de autoverificação | Como registrar | Critério de avaliação |
|---|---|---|
| Precisão de campos | Campos corretos / total de campos | Comparar com o modelo em produção atual |
| Taxa de acerto total do documento | Proporção de documentos com todos os campos corretos | Corresponde à “taxa de acerto total do documento” do AA-Paperclip |
| Número de chutes | Vezes em que campos not found receberam valor | Quanto menos, melhor — segue a lógica da taxa de não alucinação |
| Falhas de parsing | Quantidade de itens com JSON não parseável | Afeta diretamente o custo de entrada em produção |
| Consumo de tokens | Média de tokens de entrada e saída por item | Usado para converter em custo real |
🚀 Dica para começar: use primeiro a cota gratuita de testes para novos usuários do APIYI apiyi.com para rodar 20 itens, confirme que o comando e o script de comparação estão funcionando e só depois amplie para 50 itens — assim você evita gastar a cota com depuração logo de cara.
d1.2-ultra: preços e modo de invocação
É preciso distinguir as unidades de preço. Os 133 dólares no ranking representam o custo de execução do benchmark “por milhão de tarefas”; já o preço oficial da Liquid é “por milhão de tokens de entrada”: 0.02 dólar para o d1.2 e 0.042 dólar para o d1.2-ultra, cobrando apenas a entrada. As imagens contam 1.5 token a cada 32×32 pixels e são cobradas pelo preço de texto; uma imagem 1024×1024 dá cerca de 1536 tokens. Em uma requisição, texto e imagens são contados apenas uma vez; cada pergunta adicional acrescenta somente o texto da própria pergunta.
O modo oficial de invocação também difere das interfaces de chat comuns: os IDs dos modelos são d1.2-ultra e d1.2, o endereço é https://api.liquid.ai/decisions/v1/systemone e a chave API é solicitada no console da Liquid. O blog oficial menciona entradas de texto, imagem e áudio; já a ficha técnica na página do Artificial Analysis informa texto e imagem, com janela de contexto de 66k. Esse número de janela aparece apenas na página do ranking e não é uma especificação divulgada no blog da Liquid.
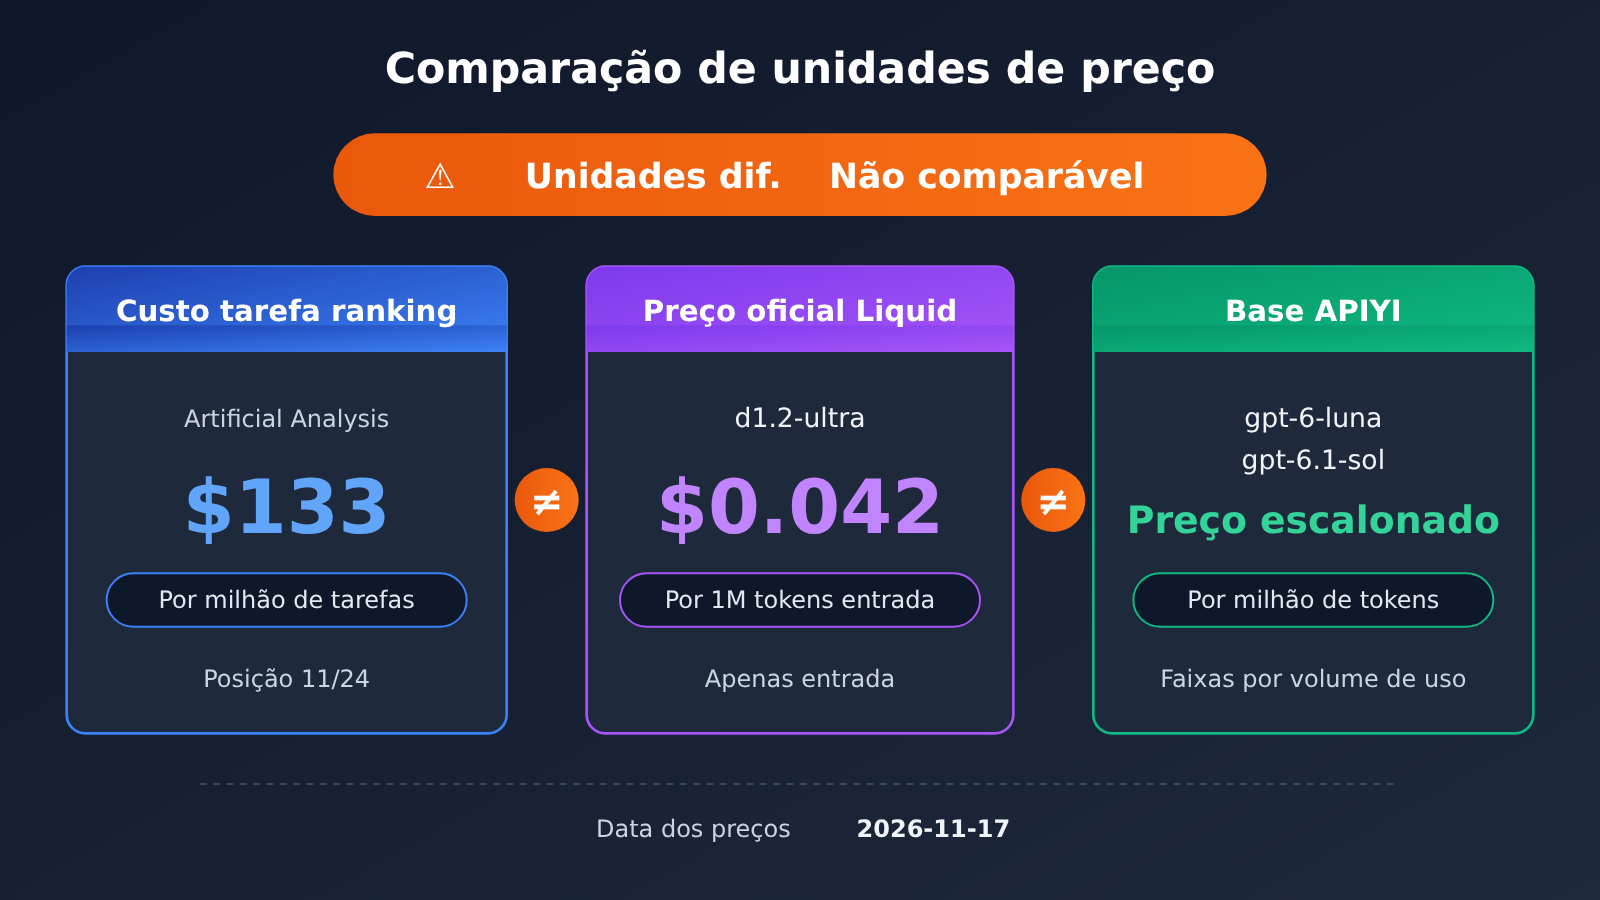
Os modelos da APIYI usados para rodar a linha de base têm os seguintes preços (unidade: dólares por milhão de tokens, em faixas conforme o volume de tokens por requisição; dados da interface de preços de 2026-11-17, em linha com a atualização da tabela geral de modelos de 2026-11-16):
| Modelo | Faixa | Entrada | Saída | Leitura de cache | Endpoint |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses preferencial; também há chat |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | não listado separadamente | O mesmo |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses preferencial; também há chat |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | não listado separadamente | O mesmo |
💰 Dica de custo: para comparar 50 amostras, o
gpt-6-lunaé indicado para rodar em volume primeiro, enquanto ogpt-6.1-solserve como referência de alta qualidade. Recargas na APIYI apiyi.com são calculadas na proporção 1:7, os descontos por grupo podem ser acumulados e a cobrança real deve ser conferida no console.
Perguntas frequentes (FAQ)
P1: O que é o modelo d1.2-ultra?
É um modelo de decisão lançado pela Liquid AI em 2026-11-16, junto com o d1.2, que é a versão menor. A característica dos modelos de decisão é atribuir uma probabilidade a cada opção. Eles se destacam em tarefas de “tomar decisões”, como extração de documentos, decisão de chamada de ferramentas e classificação, e não em redação de textos longos.
P2: O d1.2-ultra é o primeiro no índice geral. Isso significa que é o mais forte em tudo?
Não. O índice geral é 74.85, em 1º de 24, mas no EvalSafe-O\*NET-AA ele fica em 3º, no AA-Symmetry a taxa de aprovação total fica em 5º, no AA-Omniscience a acurácia bruta fica em 20º e no HLE-MultiChoice a acurácia bruta é a mais baixa entre os 24. A pontuação geral só mostra que ele lidera depois da ponderação.
P3: Aquela métrica do HLE-MultiChoice conta como último lugar no teste de conhecimento?
Não. O último lugar é a acurácia bruta do HLE-MultiChoice, 2.36% entre os 24 modelos de decisão; sua pontuação de decisão, 46.36, não fica em último, e a AA classifica essa métrica como raciocínio, não conhecimento.
P4: Para que cenários o d1.2-ultra se encaixa melhor?
Pelo que mostra a página do ranking, as tarefas em que ele mais se encaixa são a extração de campos de faturas, currículos e artigos (no AA-Paperclip, tanto a pontuação de decisão quanto a taxa de acerto total ficam em 1º) e a decisão de chamada de ferramentas (When2Call em 1º, mas a diferença para os primeiros colocados é de cerca de 1 ponto). Em questões difíceis de múltipla escolha e perguntas de conhecimento, sua acurácia bruta não se destaca.
P5: Já dá para chamar o d1.2-ultra na APIYI agora?
No momento, d1.2 e d1.2-ultra não estão na lista de modelos da APIYI. Ainda não foram disponibilizados; vamos colocá-los no catálogo o quanto antes. Modelos e preços seguem a lista de modelos da plataforma. Sugiro primeiro criar uma linha de base com seus próprios dados na APIYI (apiyi.com), usando `gpt-6-luna` ou `gpt-6.1-sol`; aí, quando o modelo estiver disponível, você troca o nome do modelo e compara.
P6: Dá para confiar direto no erro de calibração de 0.8 divulgado pela Liquid?
Esse número é da própria Liquid, medido em 13 benchmarks e 22505 questões, então é um dado autodeclarado pela empresa. O que dá para cruzar com a página do ranking é o Brier de 0.150, o mais baixo entre os 24; a direção bate. Mas, no seu caso específico, ainda vale olhar seus próprios dados para ver se ele realmente “chuta” menos.
P7: O 7.2 do GPT-6 Luna e o `gpt-6-luna` na APIYI são a mesma coisa?
Não são a mesma coisa. O 7.2 é o erro de calibração da Decisions API do GPT-6 Luna nos testes da Liquid; o 60.25 no ranking também é resultado da interface Decisions. O `gpt-6-luna` oferecido pela APIYI é a interface de chat, então o desempenho precisa ser medido com seus próprios dados.
P8: Quantas amostras são realmente necessárias?
20 a 50 já bastam para enxergar diferenças claras. O importante é cobrir a distribuição real: formatos comuns, formatos raros e amostras com campos faltando. Se a diferença entre os dois modelos em 50 amostras for de uma ou duas amostras, tanto faz trocar; priorize preço e latência.
d1.2-ultra Principais conclusões
- A pontuação geral de 75 é apenas um pretexto: 74,85, 1º de 24, cerca de 2,2 pontos à frente do 2º colocado — isso não significa que seja o primeiro em todos os itens.
- Para extração de documentos, olhe o AA-Paperclip: pontuação de decisão de 75,81 e taxa de acerto total de 67,7%, ambos em 1º lugar.
- Para chamadas de ferramentas, olhe o When2Call: 96,49, 1º lugar, mas os primeiros colocados estão separados por cerca de 1 ponto.
- Para problemas difíceis, olhe a precisão bruta: HLE-MultiChoice tem a menor taxa, 2,36%, mas a pontuação de decisão não é a última; o AA classifica como raciocínio.
- Para perguntas e respostas de conhecimento, olhe a precisão do Omniscience: 23,6%, 20º de 24, não é o último.
- Não confunda as unidades: 133 dólares é por milhão de tarefas; 0,042 dólar é por milhão de tokens de entrada.
- Decida com amostras: primeiro use na APIYI apiyi.com os modelos disponíveis para rodar de 20 a 50 casos, registrando a precisão dos campos e o número de suposições aleatórias.
Resumo
Para ler o ranking do d1.2-ultra, o essencial está em três passos:
- Anote o tipo de tarefa: extração de documentos, chamada de ferramentas, resposta a problemas difíceis ou perguntas e respostas de conhecimento — olhe apenas as pontuações específicas que correspondem.
- Distinga os dois números: a pontuação de decisão recompensa “não adivinhar quando não tiver confiança”; a precisão bruta mede “quantas vezes acertou ao adivinhar”. Escolha qual observar de acordo com a necessidade do negócio.
- Decida com suas próprias amostras: de 20 a 50 casos reais com anotações explicam melhor do que qualquer pontuação geral.
Se o seu trabalho for exatamente extração de documentos, o d1.2-ultra merece entrar na lista de candidatos; se for raciocínio em problemas difíceis ou perguntas e respostas de conhecimento, não troque só porque ele é o primeiro na pontuação geral. Recomendo que agora mesmo, na APIYI apiyi.com, você estabeleça uma linha de base com gpt-6-luna e gpt-6.1-sol e, quando o modelo desejado estiver disponível, faça a comparação com um clique.
📚 Referências
-
Blog oficial da Liquid AI — lançamento do d1.2: informações do lançamento, preço oficial e testes autorrelatados
- Link:
liquid.ai/blog/d1-2 - Descrição: A acurácia em novas tarefas e o erro de calibração são valores autorrelatados pela empresa
- Link:
-
Documentação dos modelos de decisão da Liquid AI: IDs dos modelos e endereço de invocação
- Link:
docs.liquid.ai/lfm/models/decision-models - Descrição: Explicação oficial de como fazer a invocação
- Link:
-
Artificial Analysis — página do modelo d1.2-ultra: índice geral e cada subitem
- Link:
artificialanalysis.ai/decision-models/d1-2-ultra - Descrição: Todos os dados de ranking deste artigo foram lidos em 2026-11-17
- Link:
-
Artificial Analysis — página de metodologia do Decision Index: pesos e definição das pontuações
- Link:
artificialanalysis.ai/methodology/decision-index - Descrição: A diferença entre a pontuação de decisão e a acurácia bruta
- Link:
-
Tabela geral de modelos da APIYI: modelos disponíveis e preços
- Link:
docs.apiyi.com/models - Descrição: Modelos e preços seguem a lista de modelos da plataforma
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Se você tiver dúvidas sobre seleção de modelos ou scripts de comparação, fale com a gente pela página inicial do site oficial da APIYI. Há mais instruções de integração no centro de documentação


