
Resumo: o Gemini Omni 1.2 Flash consegue gerar vídeos de 3 a 15 segundos com áudio nativo. Pela via oficial do Google, é necessário ter um nível pago e estar em uma região compatível. Convertendo com base nos preços públicos, 720p fica em cerca de $0.07 por segundo; um trecho de 10 segundos sai por volta de $0.70.
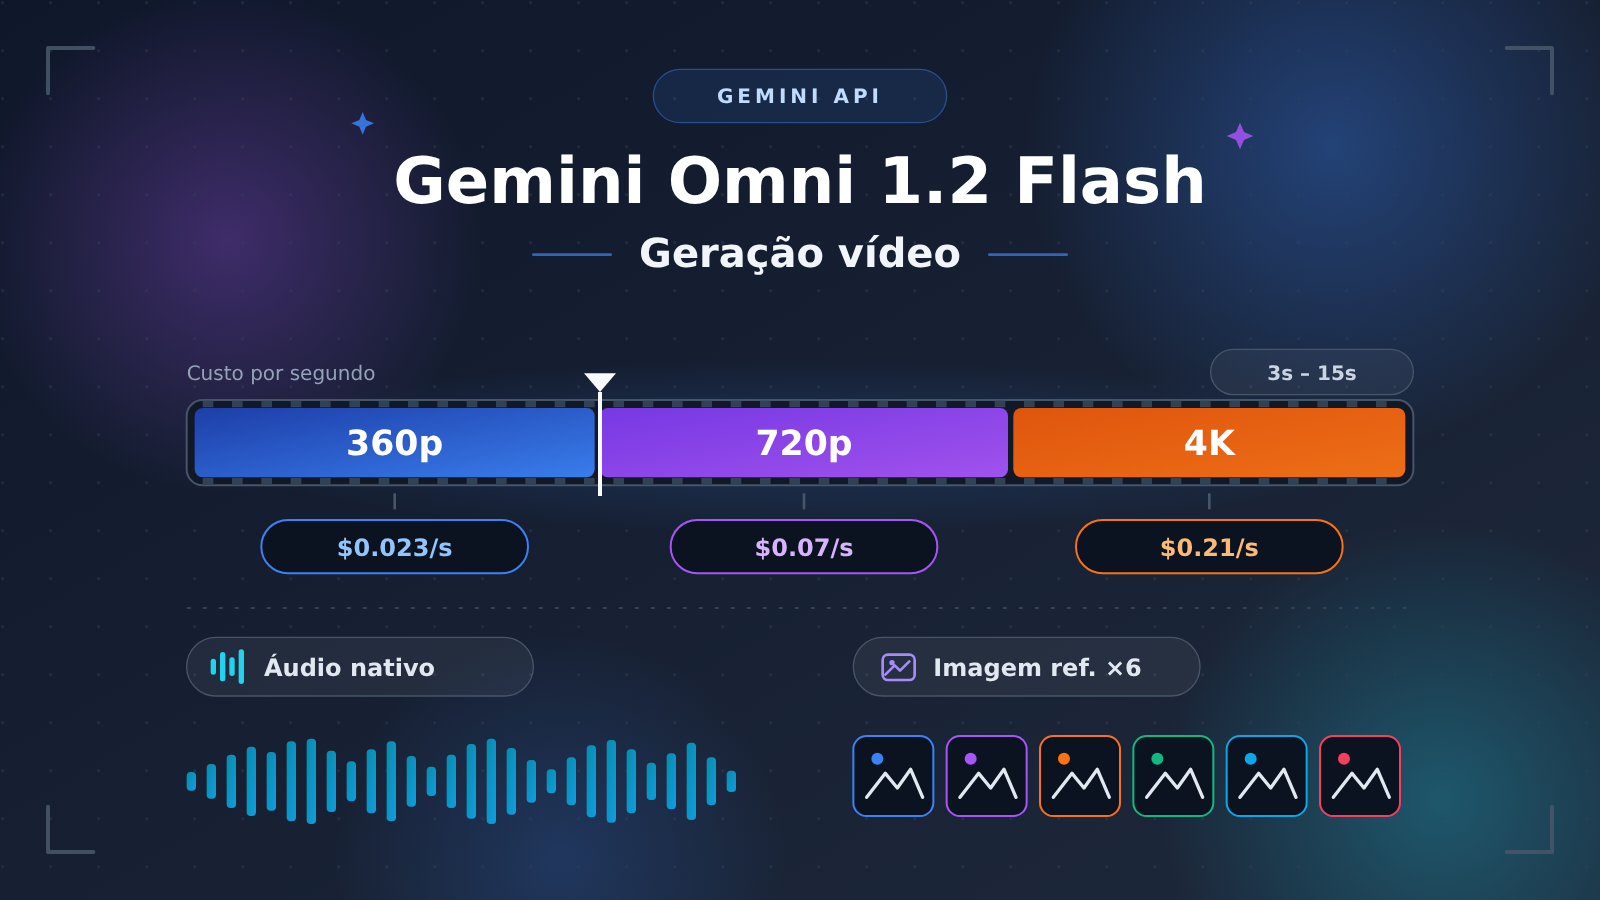
Vamos direto à conclusão: o Gemini Omni 1.2 Flash é um modelo de vídeo lançado pelo Google em 5 de novembro de 2026. Ele oferece suporte a durações de 3 a 15 segundos, resoluções de 360p a 4K, até 6 imagens de referência e saída direta de áudio nativo. Não existe nível gratuito no Gemini API: antes de fazer a invocação, é preciso ter um projeto pago com faturamento ativado, e a região precisa estar na lista de regiões compatíveis com o Google AI Studio e o Gemini API. Considerando a cobrança de $12.00 por milhão de tokens de saída de vídeo, 360p fica em cerca de $0.023 por segundo, 720p em cerca de $0.07 por segundo e o upscale para 4K em cerca de $0.21 por segundo. Para a maioria dos cenários de teste, um vídeo de 8 segundos em 720p custa cerca de $0.56; o custo por tentativa é baixo. A barreira de verdade está na conta, no faturamento e na região.
A seguir, uma tabela de termos esclarece os conceitos básicos; depois, destrincho as capacidades do modelo e os requisitos oficiais; na sequência, trago uma tabela comparativa de custos para diferentes combinações de resolução e duração e um método de estimativa; então explico o formato de invocação da tarefa assíncrona de vídeo — “criar, consultar o status e baixar”; por fim, listo os itens que precisam ser verificados um a um antes da integração. Ao terminar a leitura, você consegue avaliar se vale a pena colocar esse modelo no seu aplicativo ou no seu fluxo de produção de conteúdo.
Para saber: termos relacionados ao Gemini Omni 1.2 Flash
| Termo | Explicação |
|---|---|
| Gemini API | Interface de invocação de modelos do Google para desenvolvedores, com cobrança por token |
| Google AI Studio | Console web de depuração do Google, no qual é possível criar uma chave API e testar modelos |
| Nível pago (Paid Tier) | Nível de cobrança disponível somente após vincular uma conta de faturamento do Cloud; é o oposto do nível gratuito |
| Faturamento do Cloud | Conta de cobrança do Google Cloud, que normalmente exige a vinculação de um cartão de crédito |
| token | Unidade de medida do modelo; a saída de vídeo também é convertida em tokens conforme a resolução e a duração |
| Áudio nativo | O modelo gera o áudio junto com as imagens, sem precisar de uma etapa extra de dublagem |
| Imagem de referência | Imagem fornecida durante a geração para restringir a consistência de pessoas, objetos ou estilo |
| Texto para vídeo / imagem para vídeo | Geração de vídeo a partir de um comando de texto ou de uma imagem mais um comando, respectivamente |
| Upscale 4K | Abordagem que gera primeiro em resolução mais baixa e depois amplia para 4K; a cobrança segue a faixa de 4K |
| Tarefa assíncrona | Depois de enviar a solicitação, você recebe primeiro um ID da tarefa e busca o resultado quando a geração em segundo plano termina |
| Consulta periódica (polling) | Consultar o status da tarefa em intervalos regulares até que ela seja concluída ou falhe |
| Interactions API | Interface própria do Google que oferece recursos como edição conversacional e continuação de vídeos |
| Interface compatível com OpenAI | Interface encapsulada por plataformas de terceiros no formato de requisição do OpenAI SDK, para facilitar a reutilização de código |
1 Pontos principais do Gemini Omni 1.2 Flash: o que ele pode fazer
1.1 Limites de capacidade do Gemini Omni 1.2 Flash
A tabela abaixo reúne os principais parâmetros disponíveis nas informações públicas até o momento. Esses dados vêm da organização feita por plataformas de terceiros sobre os anúncios do Google; antes de integrar oficialmente, vale conferir mais uma vez na página oficial de lançamento do Google.
| Dimensão | Parâmetro | Significado para desenvolvedores |
|---|---|---|
| Data de lançamento | 5 de novembro de 2026 | É um modelo novo, então preço e disponibilidade ainda podem mudar |
| Duração do vídeo | 3~15 segundos | Adequado para trechos curtos, cenas publicitárias e demonstrações de produto; vídeos longos exigem montagem em partes |
| Resolução | 360p a 4K (o 4K é obtido por super-resolução) | Use resolução baixa na pré-visualização e alta no vídeo final, mantendo o custo sob controle |
| Imagem de referência | Até 6 imagens | Permite fixar a aparência do personagem, detalhes do produto ou o estilo visual |
| Áudio | Áudio nativo | Som ambiente e efeitos sonoros são gerados em sincronia com a imagem, reduzindo o trabalho de pós-produção |
| Nível gratuito | Não há | É preciso ativar um projeto pago antes de invocar o modelo |
1.2 A que pertencem as capacidades do Gemini Omni 1.2 Flash: quais ficam só na API própria do Google
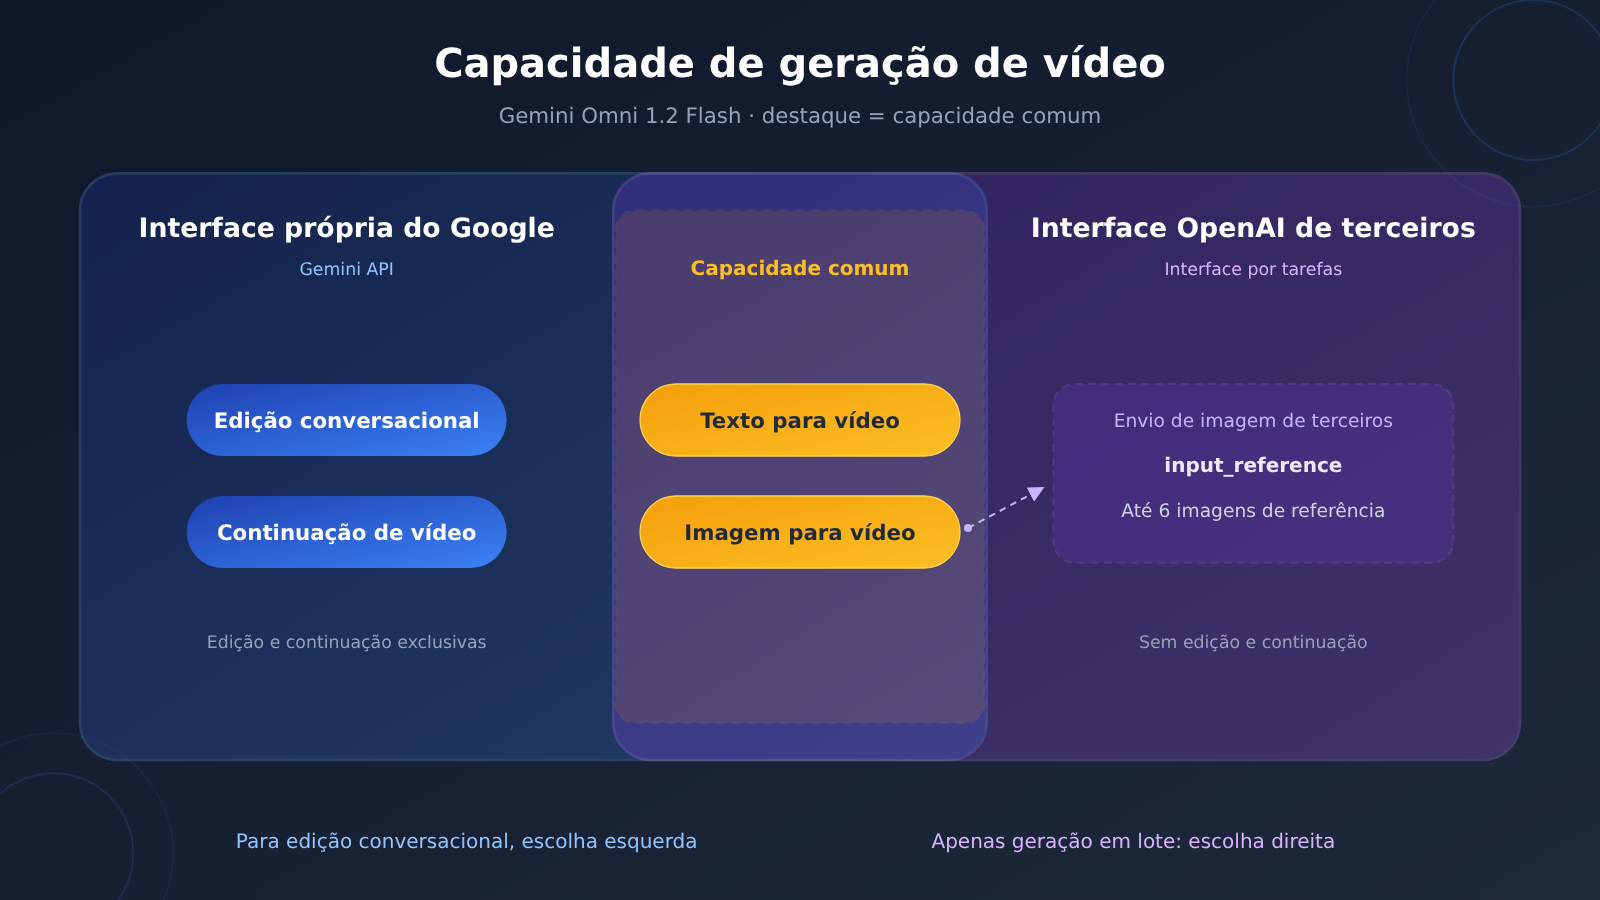
Texto para vídeo e imagem para vídeo são os dois modos mais básicos, e as plataformas de terceiros compatíveis com OpenAI normalmente também os cobrem. A edição conversacional (continuar modificando o vídeo anterior usando linguagem natural) e a continuação de vídeo são funcionalidades da Google Interactions API.
Essa distinção pesa bastante na escolha. Se o seu produto precisa que, “depois de gerar, o usuário altere uma cena com uma única frase”, você deve usar diretamente a API própria do Google; se for apenas gerar lotes de trechos independentes, uma API baseada em tarefas já basta.
2 Requisitos oficiais do Gemini Omni 1.2 Flash: o que é preciso para ir pelo Google
2.1 Nível pago e cobrança via Cloud
Na página de preços do Google, o nível gratuito do Gemini Omni 1.2 Flash aparece como “Not available”. Antes de invocar, você precisa de um projeto Gemini API com cobrança ativada, ou seja, habilitar a cobrança do Google Cloud e vincular um cartão de crédito.
Para desenvolvedores domésticos, a dificuldade prática nesta etapa costuma estar nos meios de pagamento internacionais disponíveis e na conta do Google. Ao usar em equipe, também é preciso planejar com antecedência quem detém a conta de cobrança e como configurar alertas de orçamento, para evitar que scripts de teste chamando em loop gerem faturas inesperadas.
2.2 Restrições regionais e identificação de erros
O Google AI Studio e a Gemini API só ficam disponíveis nas regiões suportadas. Em regiões fora da lista de suporte, o AI Studio não abre e a chamada à API retorna “User location is not supported for the API use”.
Quando você vê esse erro, o problema está na região de origem da requisição; trocar a chave ou alterar parâmetros não resolve. A lista de regiões suportadas pelo Google é atualizada dinamicamente, então, antes de integrar, use como referência a lista mais recente na documentação oficial.
2.3 Como diferenciar os fatos oficiais do Gemini Omni 1.2 Flash das declarações de terceiros
Já há plataformas de terceiros anunciando que vão integrar esse modelo, e as descrições delas misturam informações oficiais do Google com explicações sobre os serviços da própria plataforma. A tabela abaixo separa os dois tipos de informação, para facilitar sua avaliação de quais dados podem ser citados diretamente e quais precisam ser confirmados com a própria plataforma.
| Informação | Categoria | Descrição |
|---|---|---|
| Data de lançamento, duração, resolução, quantidade de imagens de referência, áudio nativo | Informação oficial do Google (repassada por terceiros) | Consulte a página de lançamento do Google |
| Sem nível gratuito; exige projeto pago | Página oficial de preços do Google | Consulte a página de preços da Gemini API |
| Preço por milhão de tokens, conversão de tokens por segundo | Página oficial de preços do Google | Consulte a página de preços da Gemini API |
| Edição conversacional, continuação atribuída à Interactions API | Capacidade própria da interface do Google | Consulte a documentação do Google |
ID do modelo gemini-omni-1.2-flash |
Declaração de plataformas terceiras | A nomenclatura pode variar entre plataformas; confirme uma a uma |
Interface de tarefas /v1/videos, parâmetros seconds / size |
Declaração de plataformas terceiras | Trata-se de um encapsulamento compatível com OpenAI, não do formato nativo do Google |
| Formas de recarga, valor mínimo de recarga, retorno 402 quando o saldo é insuficiente | Declaração de plataformas terceiras | Aplica-se apenas a essa plataforma |
| “Já disponível / Em breve” | Declaração de plataformas terceiras | Não estava disponível no momento da publicação da plataforma; é preciso confirmar em tempo real |
3 Estimativa de custo do Gemini Omni 1.2 Flash: conversão por segundo e por clipe
3.1 Estrutura oficial de precificação
A Gemini API cobra por token para esse modelo, com os seguintes preços por milhão de tokens: entrada $1.50, saída de vídeo $12.00, saída de texto $9.00. Os tokens de saída de vídeo são convertidos conforme a resolução e o número de segundos:
- 360p: 1,931 token por segundo, cerca de $0.023 por segundo
- 720p: 5,792 token por segundo, cerca de $0.07 por segundo
- 4K com super-resolução: 17,376 token por segundo, cerca de $0.209 por segundo
A fórmula de conversão é bem direta: custo da saída de vídeo por clipe = tokens por segundo × segundos × $12 ÷ 1,000,000. No caso de 720p com 10 segundos, 5,792 × 10 × 12 ÷ 1,000,000 ≈ $0.695.
3.2 Tabela de custo por resolução × duração do Gemini Omni 1.2 Flash
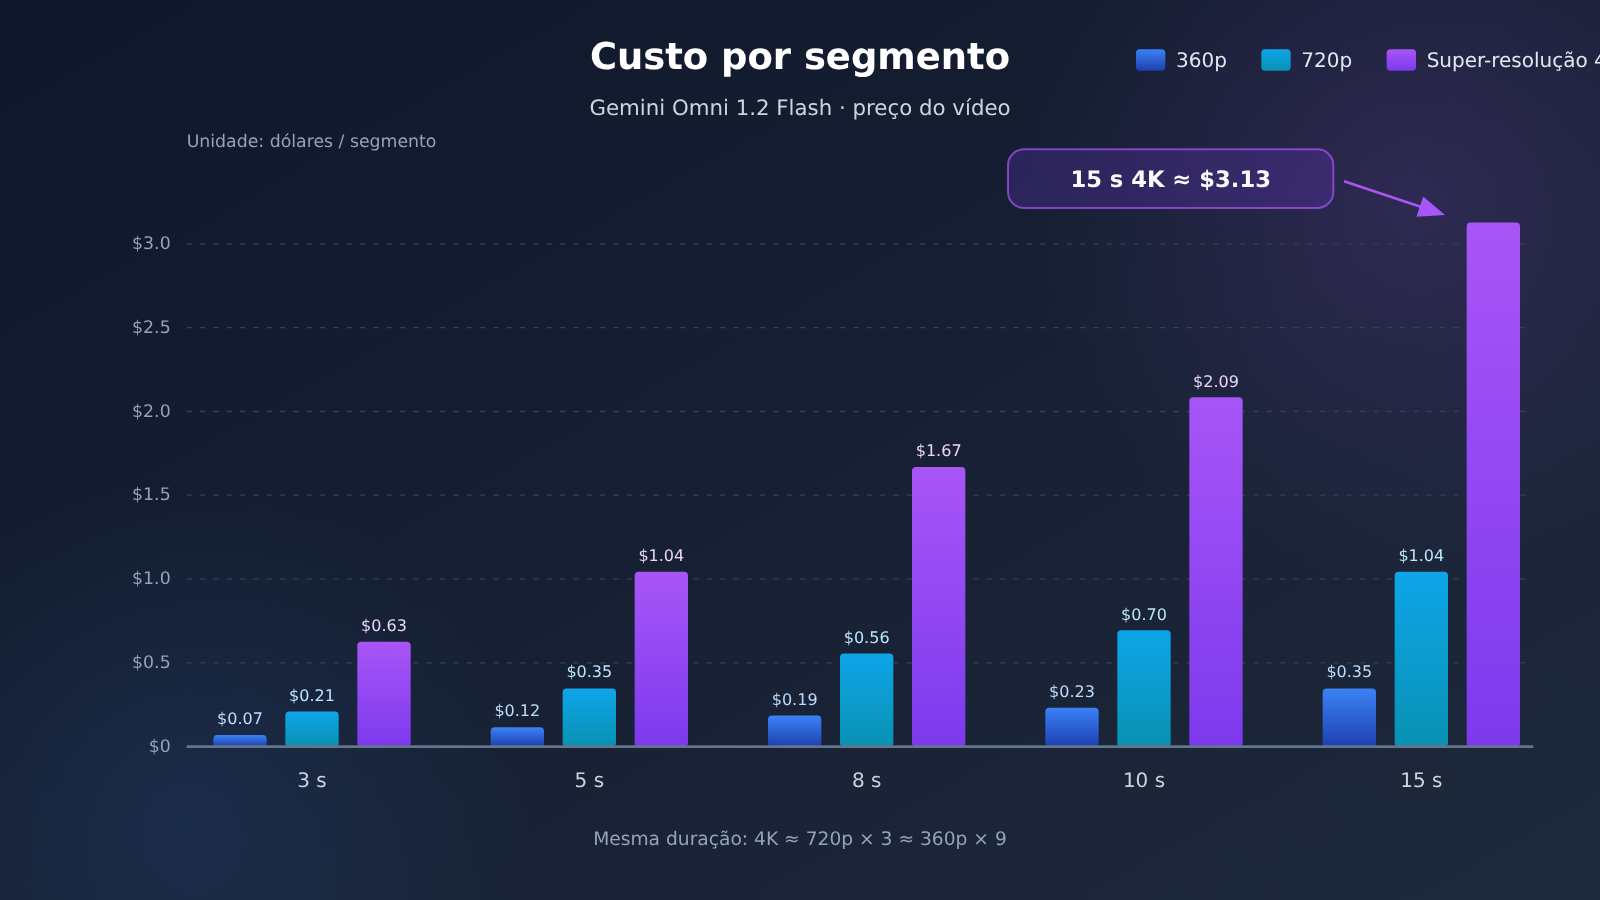
A tabela abaixo é calculada com base no preço oficial da saída de vídeo, cobre apenas a parte da saída de vídeo e arredonda para três casas decimais.
| Duração | 360p (1,931 token/s) | 720p (5,792 token/s) | 4K com super-resolução (17,376 token/s) |
|---|---|---|---|
| 3 segundos | $0.070 | $0.209 | $0.626 |
| 5 segundos | $0.116 | $0.348 | $1.043 |
| 8 segundos | $0.185 | $0.556 | $1.668 |
| 10 segundos | $0.232 | $0.695 | $2.085 |
| 15 segundos | $0.348 | $1.043 | $3.128 |
Dá para ver que, para a mesma duração, o 4K custa cerca de 3 vezes o 720p e 9 vezes o 360p. Os materiais públicos não trazem o valor de conversão de tokens para 1080p; se precisar dessa faixa, consulte a página oficial de preços.
3.3 Três custos que costumam passar batido na estimativa
A tabela acima cobre apenas a saída de vídeo. A fatura real ainda precisa considerar as seguintes partes:
- Tokens de entrada: prompt e imagens de referência são cobrados a $1.50 por milhão de tokens. O número de tokens para até 6 imagens de referência depende da regra oficial de conversão de imagens em tokens; os materiais públicos não trazem valores específicos.
- Custo de novas tentativas: se o resultado não agradar e for preciso rodar de novo, o orçamento deve ser calculado como “custo por trecho × número médio de tentativas”. Ainda não há dados públicos de taxa de falha ou de taxa de aprovação, então a sugestão é medir primeiro com tarefas em pequenos lotes.
- Estratégia de resolução: comece ajustando o comando e o enquadramento em 360p, e só depois de definir bem parta para 720p ou 4K — isso reduz bastante o custo de tentativa e erro. Testar um trecho de 8 segundos 5 vezes em 360p custa cerca de $0.93, quase o mesmo que rodar 2 vezes em 720p.
4 Guia rápido do Gemini Omni 1.2 Flash: fluxo de invocação de tarefas assíncronas de vídeo
4.1 As três fases de uma tarefa assíncrona
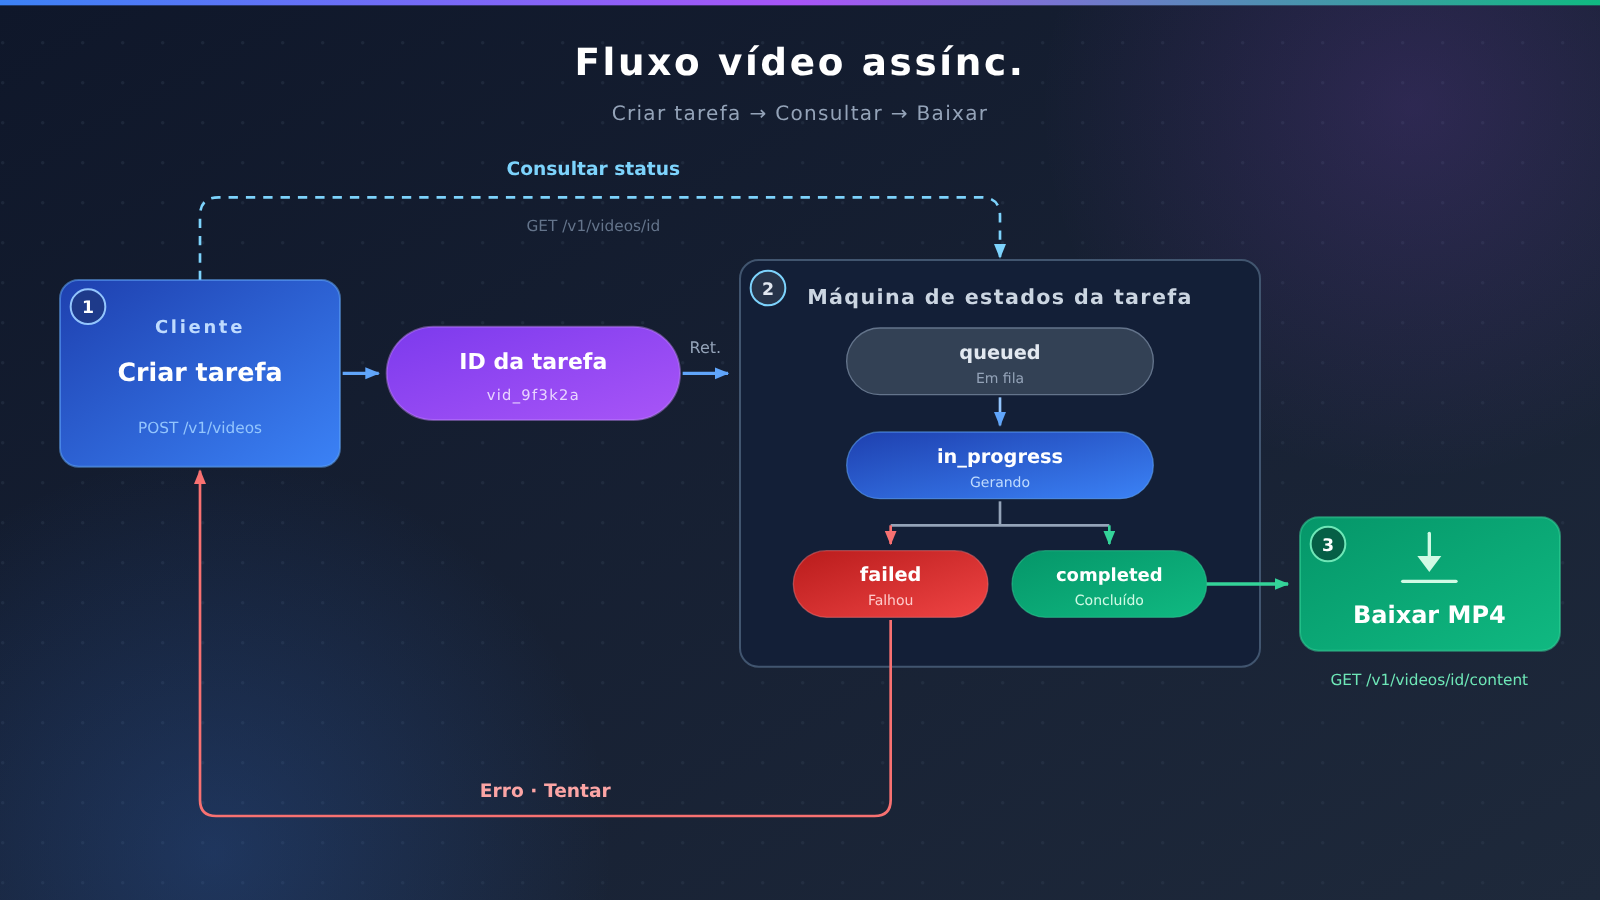
A geração de vídeo leva muito mais tempo do que a conclusão de texto, por isso o formato de tarefa assíncrona é o mais comum. Uma invocação completa acontece em três etapas:
- Criar a tarefa: envie o modelo, o comando, a duração, a resolução e outros parâmetros; a interface retorna na hora o ID da tarefa e o estado inicial (como
queued). - Consultar o status (polling): consulte a tarefa em intervalos fixos; o status passa por
queued,in_progresse, por fim, chega acompletedoufailed. - Baixar o resultado: quando o status for
completed, recupere o arquivo de vídeo pela interface de conteúdo.
4.2 Exemplo de invocação no formato compatível com OpenAI
O código abaixo usa a interface videos do SDK da OpenAI; os nomes dos parâmetros vêm do formato compatível com OpenAI divulgado por plataformas de terceiros. Substitua base_url e o ID do modelo pelos valores do serviço que você realmente usa, e confirme antes que esse serviço já oferece o Gemini Omni 1.2 Flash.
import os, time
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["VIDEO_API_KEY"],
    base_url=os.environ["VIDEO_API_BASE_URL"],  # substitua pelo endereço real do serviço
)

video = client.videos.create(
    model="gemini-omni-1.2-flash",   # use o ID do modelo publicado pelo provedor
    prompt="一只穿着迷你宇航服的猫在空间站里漂浮,背景有轻微的环境音",
    seconds="8",
    size="1280x720",
)

while video.status in ("queued", "in_progress"):
    time.sleep(5)
    video = client.videos.retrieve(video.id)

if video.status == "failed":
    raise RuntimeError(video.error)

client.videos.download_content(video.id).write_to_file("omni.mp4")
Se você não usar o SDK, o fluxo HTTP correspondente é: POST /v1/videos para criar a tarefa, GET /v1/videos/{id} para consultar o status e GET /v1/videos/{id}/content para baixar o vídeo. Para vídeo a partir de imagem, a imagem de referência é passada pelo campo input_reference. Alguns serviços também oferecem GET /v1/models?type=video, que lista as durações e os tamanhos suportados por cada modelo.
Ver a implementação completa com timeout, estimativa de orçamento e tratamento de erros
import os, time
from openai import OpenAI

# Conversão oficial da saída de vídeo (tokens por segundo), usada para estimar o custo antes do envio
TOKENS_PER_SECOND = {"640x360": 1931, "1280x720": 5792}
VIDEO_OUTPUT_PRICE_PER_M = 12.00  # dólares / milhão de tokens

def estimate_cost(size: str, seconds: int) -> float:
    tps = TOKENS_PER_SECOND.get(size)
    if tps is None:
        raise ValueError(f"未登记的分辨率: {size}")
    return tps * seconds * VIDEO_OUTPUT_PRICE_PER_M / 1_000_000

def generate_video(
    prompt: str,
    seconds: int = 8,
    size: str = "1280x720",
    out_path: str = "output.mp4",
    poll_interval: float = 5.0,
    timeout: float = 600.0,
    budget_usd: float = 1.0,
) -> str:
    cost = estimate_cost(size, seconds)
    if cost > budget_usd:
        raise ValueError(f"预估 ${cost:.3f} 超出单段预算 ${budget_usd}")
    print(f"预估视频输出成本: ${cost:.3f}")

    client = OpenAI(
        api_key=os.environ["VIDEO_API_KEY"],
        base_url=os.environ["VIDEO_API_BASE_URL"],
    )

    video = client.videos.create(
        model=os.environ.get("VIDEO_MODEL_ID", "gemini-omni-1.2-flash"),
        prompt=prompt,
        seconds=str(seconds),
        size=size,
    )
    print(f"任务已创建: {video.id}")

    start = time.time()
    while video.status in ("queued", "in_progress"):
        if time.time() - start > timeout:
            raise TimeoutError(f"任务 {video.id} 超时,可稍后用 ID 继续查询")
        time.sleep(poll_interval)
        video = client.videos.retrieve(video.id)
        print(f"状态: {video.status}")

    if video.status == "failed":
        raise RuntimeError(f"生成失败: {video.error}")

    client.videos.download_content(video.id).write_to_file(out_path)
    return out_path

if __name__ == "__main__":
    path = generate_video(
        prompt="清晨的咖啡店,蒸汽从杯口升起,背景有轻柔的人声与杯碟碰撞声",
        seconds=8,
        size="640x360",   # comece com 360p para ajustar o comando
        budget_usd=0.5,
    )
    print(f"已保存: {path}")
4.3 Recomendações de engenharia para polling e armazenamento
Um intervalo de polling em torno de 5 segundos já resolve. Consultar com muita frequência só gera requisições inúteis. Em produção, recomendo gravar o ID da tarefa no banco de dados e deixar um job em segundo plano fazer o polling de forma centralizada — assim, seja quando o frontend for atualizado, seja quando o processo reiniciar, você não perde tarefas que já foram pagas.
Assim que o vídeo for baixado, transfira-o o quanto antes para o seu próprio armazenamento de objetos. Se precisar gerar em lote, dá para usar uma fila para controlar a concorrência e, antes de enviar cada tarefa, fazer a validação de orçamento com uma função como estimate_cost, bloqueando de imediato as tarefas que estouram o limite.
5 O que confirmar antes de integrar o Gemini Omni 1.2 Flash
5.1 Checklist de confirmação para a integração do Gemini Omni 1.2 Flash
| Item a confirmar | Via Google oficial | Via plataforma compatível de terceiros |
|---|---|---|
| Conta e pagamento | Conta Google, cobrança no Cloud, cartão de crédito | Conta na plataforma e forma de recarga |
| Região | Sua região está na lista de suporte do Google | Cobertura de serviço da própria plataforma |
| Disponibilidade do modelo | Já listado na página de preços e na lista de modelos | Já disponível na lista de modelos da plataforma, com o ID do modelo confirmado |
| Escopo de funcionalidades | Inclui edição conversacional e continuação via Interactions API | Geralmente tarefas de texto para vídeo e imagem para vídeo |
| Preço | Preço unitário oficial por token | Preço da plataforma, comparado ao oficial |
5.2 Validar qualidade e tempo de execução com uma amostra pequena
Atualmente, não há dados públicos de testes sobre qualidade de geração, tempo de execução e taxa de falha. A recomendação é preparar de 5 a 10 comandos que cubram seus cenários principais, rodar uma primeira rodada em 360p com 5~8 segundos, anotar o tempo de cada um, se teve sucesso e se o resultado é utilizável, e só então decidir o orçamento para geração em lote em alta resolução. O custo de saída de vídeo dessa rodada de testes fica entre $1 e $2.
6 Perguntas frequentes (FAQ)
Q1: O que é o modelo Gemini Omni 1.2 Flash?
É um modelo de geração de vídeo lançado pelo Google em 5 de novembro de 2026. Ele gera vídeos de 3~15 segundos com áudio nativo, com resolução de 360p até 4K, e suporta até 6 imagens de referência.
Q2: O Gemini Omni 1.2 Flash tem cota gratuita?
Na página de preços da Gemini API, o nível gratuito desse modelo está marcado como “Not available”. É preciso ter um projeto pago com faturamento ativado para poder chamá-lo.
Q3: Quanto custa, mais ou menos, gerar um vídeo com o Gemini Omni 1.2 Flash?
Pelo preço oficial de saída de vídeo, 720p sai por cerca de $0.07 por segundo: aproximadamente $0.56 para 8 segundos, $0.70 para 10 segundos e $1.04 para 15 segundos. 360p custa cerca de um terço disso, e o upscale para 4K cerca de 3 vezes mais. Os tokens de entrada do comando e das imagens de referência são cobrados à parte.
Q4: Aparece o erro “User location is not supported for the API use” na chamada. O que fazer?
Isso significa que a região de origem da requisição não está na lista de regiões suportadas pela Gemini API — não tem nada a ver com a chave nem com os parâmetros. É preciso fazer a chamada a partir de uma região suportada, ou usar um serviço compatível que já tenha esse modelo disponível.
Q5: Dá para editar o vídeo do Gemini Omni 1.2 Flash depois de gerado, por conversa?
A edição e a continuação por conversa são funcionalidades da Google Interactions API. A interface `/v1/videos` compatível com OpenAI de terceiros normalmente só lida com tarefas de texto para vídeo e imagem para vídeo. Quando precisar de edição em múltiplas rodadas, use a interface própria do Google.
Q6: Para quais cenários o Gemini Omni 1.2 Flash é mais indicado?
É indicado para trechos curtos que precisam de sincronia entre som e imagem: tomadas de exibição de produtos em e-commerce, material de vídeo curto para redes sociais, capas animadas dentro de um app, pré-visualização de storyboard de anúncios. Cenários que dependem de imagens de referência para fixar a aparência de personagens ou produtos também funcionam bem.
Q7: Quais são as limitações atuais do Gemini Omni 1.2 Flash?
Cada trecho tem no máximo 15 segundos, então conteúdos longos precisam ser emendados; 4K é uma saída por upscale, com custo mais alto; não há nível gratuito; e os canais oficiais do Google sofrem restrições regionais. Ainda não há dados públicos de teste sobre qualidade de geração, tempo de execução e taxa de falha — é preciso validar com uma amostra pequena por conta própria.
7 Pontos-chave do Gemini Omni 1.2 Flash (Key Takeaways)
- Limites de capacidade: 3~15 segundos, 360p a 4K, até 6 imagens de referência, áudio nativo
- Barreira oficial: sem nível gratuito, exige projeto pago da Gemini API e região suportada
- Custo por segundo: 360p cerca de $0.023, 720p cerca de $0.07, upscale 4K cerca de $0.209
- Referências comuns: 8 segundos em 720p cerca de $0.56, 10 segundos em 720p cerca de $0.70
- Forma de chamada: tarefa assíncrona, concluída em três passos: criar, consultar status e baixar
- A que pertence cada recurso: edição e continuação por conversa fazem parte da Google Interactions API
- Estratégia para economizar: ajuste o comando em 360p primeiro, confirme o resultado e só depois gere em alta resolução
8 Conclusão: vale a pena experimentar o Gemini Omni 1.2 Flash?
O custo por segmento do Gemini Omni 1.2 Flash está numa faixa em que dá para testar sem medo de errar: um vídeo de 10 segundos em 720p sai por menos de 1 dólar, e o áudio nativo ainda elimina uma etapa inteira de dublagem. Para os desenvolvedores locais, os principais obstáculos estão nos requisitos de cobrança e nas restrições regionais do plano pago do Google, além do fato de a edição conversacional estar disponível apenas na interface própria do Google.
O caminho de decisão que sugiro é: primeiro confirme se você consegue cumprir os requisitos oficiais, ou encontre um serviço que já tenha lançado oficialmente esse modelo; depois use a tabela comparativa de custos deste artigo para montar seu orçamento; por fim, teste qualidade e tempo de execução com uma amostra pequena em 360p e, quando os números atenderem, amplie para escala de produção. O modelo foi lançado há pouco tempo, então preço e disponibilidade podem mudar — antes de cada integração, vale reconferir a página oficial de preços do Google.
Referências
- Blog do TeamoRouter: instruções de uso do Gemini Omni 1.2 Flash: compilação feita por uma plataforma de terceiros com informações de lançamento, preços oficiais e explicações sobre sua interface
- Link:
teamorouter.com/zh/blogs/use-gemini-omni-1-2-flash-without-google-account -
Descrição: fonte dos parâmetros de capacidade e dos dados de conversão de tokens deste artigo; os trechos sobre a interface da plataforma e recarga são declarações da própria plataforma
-
Página oficial de preços da Gemini API: padrão de cobrança dos modelos publicado pelo Google
- Link:
ai.google.dev/gemini-api/docs/pricing - Descrição: usada para verificar o status do plano gratuito, o preço por milhão de tokens e a conversão por resolução


