
Nota do autor: aplicações com múltiplos modelos devem usar um formato unificado de mensagens, uma camada de adaptação de provedores e um registro de capacidades para lidar com diferenças em chamadas de ferramentas, estado de raciocínio, saída em streaming, dados estruturados e cache.
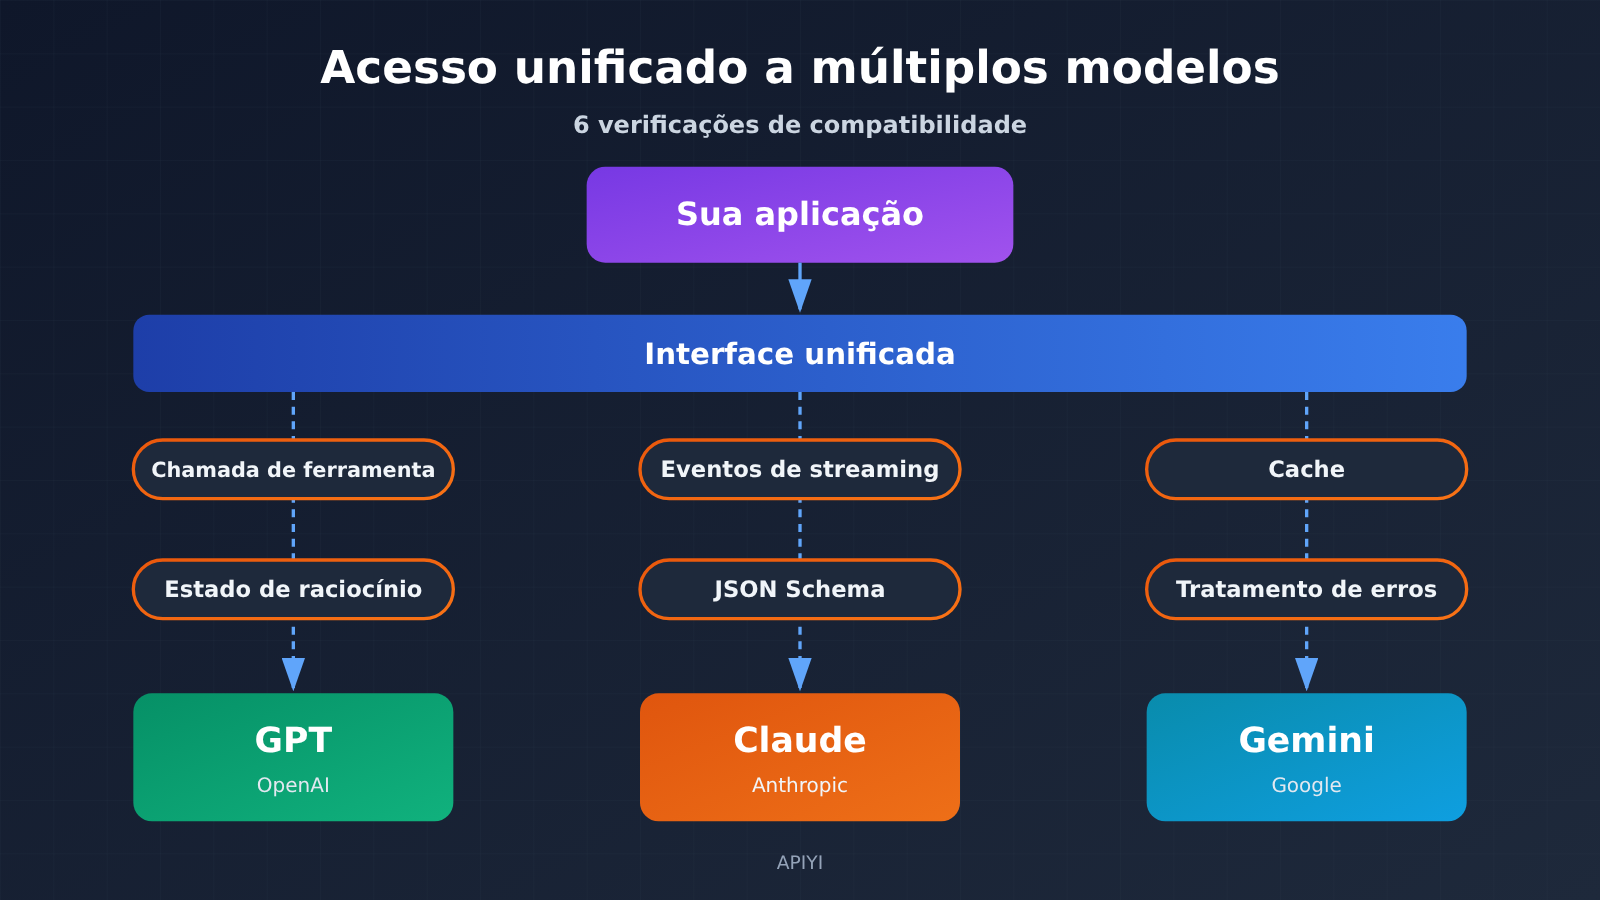
GPT, Claude e Gemini dão conta de chamadas de texto comuns; Claude e Gemini também oferecem endpoints oficiais compatíveis com o SDK da OpenAI. Em aplicações de nível de produção, ao trocar de modelo, é preciso resolver 6 categorias de problemas de compatibilidade: papéis de mensagem e instruções de sistema, protocolo de chamada de ferramentas, parâmetros de raciocínio e estado de pensamento, eventos de streaming, saída estruturada e multimodalidade, cobrança de cache e tratamento de erros. Trocar apenas o ID do modelo faz uma sessão simples de perguntas e respostas funcionar, mas chamadas de ferramentas em múltiplos turnos, recuperação de streaming interrompido e cálculo de custos exigem tratamento separado. A solução de engenharia mais robusta é “interface de negócio unificada + camada de adaptação de provedores (Provider Adapter) + registro de capacidades do modelo”. Assim, a troca de modelo pode ser gerenciada como uma funcionalidade de produto sustentável.
A seguir, comparamos as diferenças estruturais entre as APIs nativas dos três provedores e mostramos quais cenários os endpoints compatíveis com OpenAI conseguem cobrir. Depois, detalhamos uma a uma as falhas reais que as 6 categorias de problemas de compatibilidade podem provocar, e apresentamos uma arquitetura de integração em seis camadas e um código executável de chamada unificada. Por fim, listamos seis testes de compatibilidade antes do lançamento e explicamos como o gateway de API unificado e a adaptação de capacidades nativas dividem as responsabilidades.
Para saber: Glossário de termos de compatibilidade de API multi-modelo
| Termo | Explicação |
|---|---|
| API | Interface pela qual a aplicação envia requisições ao serviço de modelo e recebe os resultados de volta. |
| SDK | Kit de desenvolvimento de software que encapsula os detalhes da invocação da interface. |
| API nativa | Interface principal projetada pelo próprio fabricante, como OpenAI Responses, Claude Messages e Gemini Interactions. |
| Endpoint compatível | Ponto de adaptação que segue outro formato de requisição (normalmente o formato OpenAI), facilitando a chamada com o mesmo SDK. |
| Chamada de função (Function Calling) | O modelo solicita, com parâmetros estruturados, que a aplicação execute alguma função externa. |
| ID de chamada | Identificador que relaciona a solicitação de ferramenta iniciada pelo modelo ao resultado de execução devolvido pela aplicação. |
| Assinatura de pensamento (Thought / Thinking Signature) | Dados de estado criptografados usados por alguns modelos para armazenar o contexto de raciocínio e de chamada de ferramentas; precisam ser devolvidos sem alteração. |
| Saída em streaming (Streaming) | O servidor retorna os resultados por partes, na forma de eventos, e o frontend pode exibir conforme recebe. |
| JSON Schema | Especificação que descreve a estrutura de dados JSON e as regras de validação. |
| Cache de comando (Prompt Caching) | Reaproveita o resultado do cálculo de prefixos de entrada que se repetem, reduzindo latência e custo. |
| TTL | Tempo de vida do cache; depois de expirar, é preciso gravá-lo novamente. |
| Adaptador (Provider Adapter) | Componente que converte a requisição unificada no formato nativo de um fabricante e depois converte o resultado de volta ao formato unificado. |
| Registro de capacidades | Lista de configuração que registra quais parâmetros e funcionalidades cada modelo e cada endpoint de acesso realmente suporta. |
| Idempotente | A mesma operação, executada uma vez ou várias vezes, produz o mesmo efeito; serve para evitar cobranças duplicadas e envios repetidos causados por novas tentativas. |
1 Compatibilidade de API entre múltiplos modelos: por que trocar de modelo não é só trocar o Model ID
Os três serviços permitem especificar o modelo por meio de um campo model, mas a forma como organizam o corpo da requisição, o objeto de resposta e o estado de contexto é diferente. Em perguntas e respostas simples, as diferenças se concentram nos nomes dos campos, e o custo de adaptação é baixo. Em aplicações do tipo agente, que dependem de chamadas de ferramentas, estado de raciocínio e eventos de streaming, as diferenças se transformam diretamente em falhas em produção.
1.1 Comparativo das APIs nativas de GPT, Claude e Gemini
A tabela abaixo descreve apenas as APIs nativas, sem considerar qualquer camada de compatibilidade ou endpoint de gateway.
| Dimensão | OpenAI (nativa) | Claude (nativa) | Gemini (nativa) |
|---|---|---|---|
| Interface principal | Responses API, /v1/responses |
Messages API, /v1/messages |
Interactions API (GA em junho de 2026, recomendada oficialmente para novos projetos); generateContent continua com suporte |
| Organização da entrada | model + input |
model + messages + max_tokens; system separado do array de mensagens |
Estrutura nativa de Interactions, além de regras de system_instruction |
| Estrutura de saída | Itens de saída de vários tipos: texto, itens de raciocínio, function_call etc. |
content blocks: text, thinking, tool_use etc. |
steps: saída do modelo, chamada de ferramentas, raciocínio e outras etapas |
| Critério de término | Evento de conclusão da resposta / tipo de item de saída | stop_reason (conclusão normal, necessidade de executar ferramentas etc.) |
Tipo de etapa e estado da interação |
| Continuação de contexto | previous_response_id |
O aplicativo reenvia todo o histórico de mensagens por conta própria | previous_interaction_id; estado de sessão no servidor opcional |
| Ferramentas integradas | Ferramentas da plataforma + funções personalizadas | Principalmente ferramentas personalizadas | Ferramentas integradas como Google Search, URL Context e execução de código; ferramentas de terceiros são executadas pela aplicação |
Como dá para ver na tabela acima, as três empresas se dividem em duas abordagens quanto a “quem armazena o contexto”. OpenAI e Gemini oferecem continuação de contexto no servidor, enquanto Claude Messages deixa o reenvio do histórico por conta da aplicação. Se o armazenamento de sessão da aplicação for projetado para apenas um desses modos, trocar para outra empresa causará perda de contexto ou envio duplicado.
1.2 Até que ponto a interface compatível com OpenAI resolve o problema
Claude e Gemini oferecem endpoints compatíveis com o SDK da OpenAI. O endpoint oficial de compatibilidade do Gemini é generativelanguage.googleapis.com/v1beta/openai/; ao usar o cliente OpenAI, basta alterar base_url, a chave API e model. Já a documentação de compatibilidade do Claude delimita claramente o escopo de suporte. As limitações conhecidas em 2026-11-13 são:
- O parâmetro
strictna definição de ferramentas é ignorado, então a validação rigorosa dos parâmetros de ferramentas deixa de funcionar. - Não há suporte a Prompt Caching.
- Não há suporte a entradas dos tipos audio e file.
- As mensagens
systemedevelopersão movidas para o início e mescladas. - Os campos relacionados a
thinkingdiferem da API nativa.
A interface compatível atende bem a três tipos de cenário: chat comum, geração em turno único e comparação rápida da qualidade das respostas entre modelos. A migração de agentes complexos envolve parâmetros rigorosos de ferramentas, cache, entrada de arquivos e estado de raciocínio em múltiplos turnos; esses recursos exigem voltar à API nativa ou validar item por item antes de ir para produção. Um critério prático é: se um recurso do qual a aplicação depende aparece apenas na documentação nativa, registre-o no catálogo de capacidades e deixe que um adaptador dedicado cuide dele.
2 As seis categorias de problemas de compatibilidade mais comuns ao alternar entre os modelos GPT, Claude e Gemini
2.1 Tratamento de compatibilidade entre papéis de mensagem e instruções de sistema
A OpenAI diferencia papéis como developer e system. As instruções system do Claude ficam fora do array de mensagens. O Gemini usa system_instruction, e o conteúdo do usuário e do modelo também segue regras estruturais próprias. Os três expressam a mesma ideia de “prioridade de instruções + histórico multiturno”, mas os campos que carregam essas informações ficam em posições diferentes.
Uma falha comum vem de uma concatenação preguiçosa: juntar instruções de sistema, mensagens do histórico e resultados de ferramentas em uma única string e entregar tudo ao modelo como entrada do usuário. Isso até funciona, mas a prioridade das instruções fica enfraquecida, e o modelo pode tratar a saída de ferramentas no histórico como uma nova solicitação do usuário. O caminho correto é preservar a semântica de papéis dentro da aplicação e deixar o adaptador fazer o mapeamento para os campos de cada fornecedor. Além disso, vale lembrar que a camada de compatibilidade do Claude mescla system e developer; o design de comandos que depende da separação entre os dois precisa ser validado na prática.
2.2 Protocolo de invocação de ferramentas e tratamento de compatibilidade dos IDs de chamada
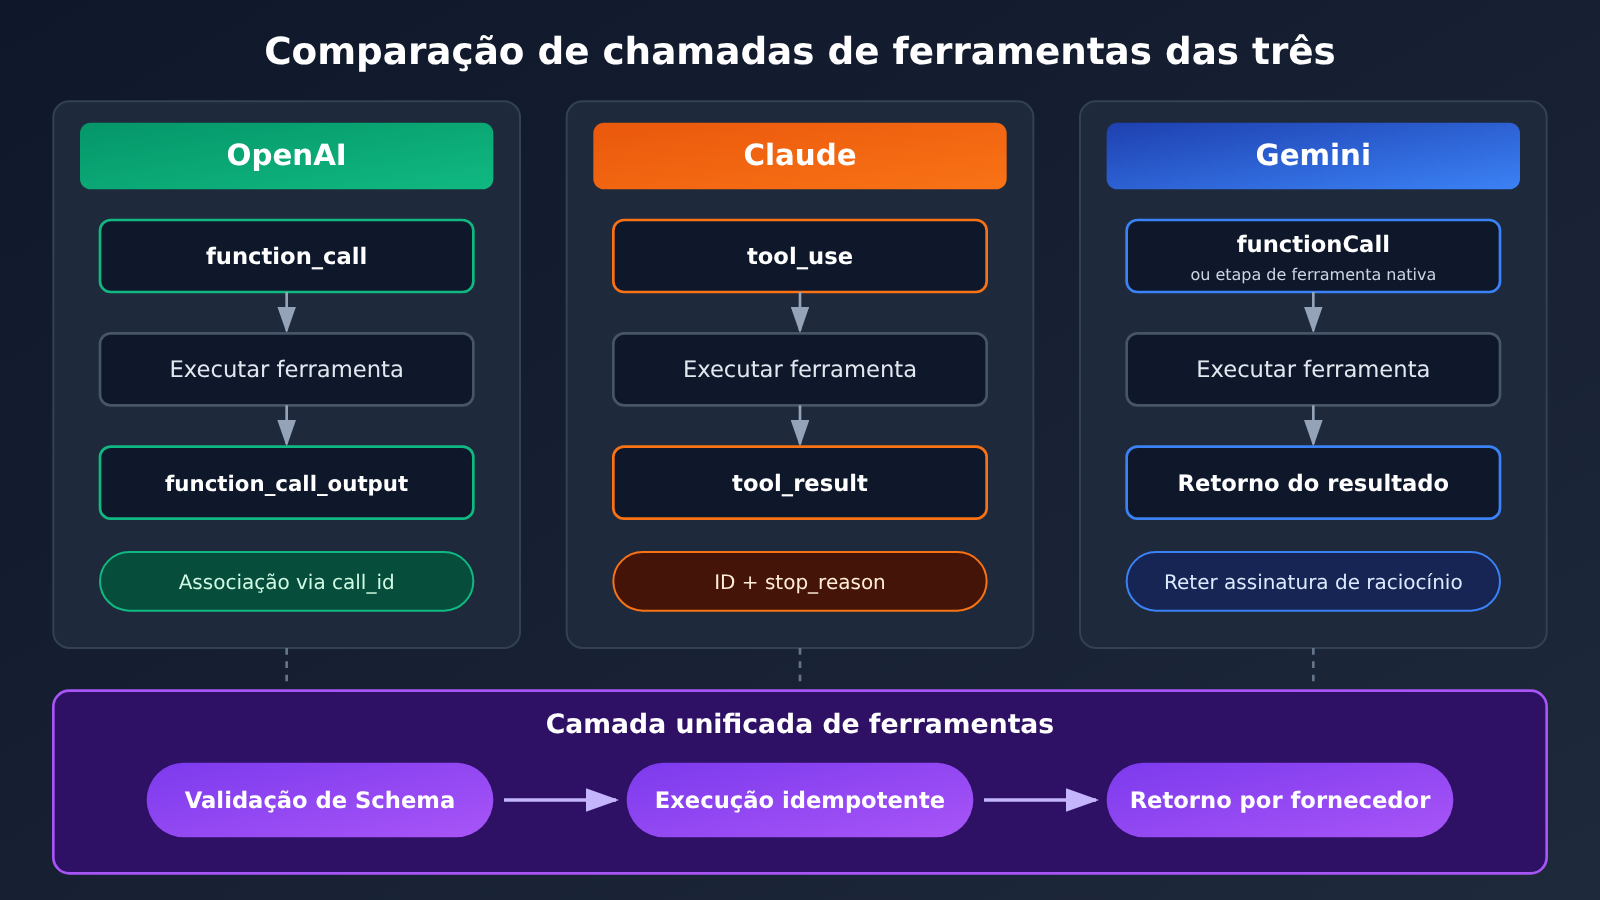
Os três modelos suportam Function Calling, e o fluxo de invocação acontece mais ou menos assim:
| Etapa | OpenAI | Claude | Gemini |
|---|---|---|---|
| O modelo inicia a chamada | item de saída function_call |
bloco de conteúdo tool_use |
functionCall / etapa de ferramenta nativa |
| Identificador de associação | call_id |
ID do tool_use |
identificador de chamada correspondente |
| Retorno da aplicação | function_call_output |
bloco de conteúdo tool_result |
estrutura de retorno do resultado correspondente |
| Precisa continuar? | Decidido pelo item de saída | stop_reason indica que a ferramenta precisa ser executada |
Decidido pelo estado da etapa |
| Estado de raciocínio | itens de reasoning podem precisar ser passados junto com o histórico | blocos thinking podem precisar ser devolvidos exatamente como estão | no modo stateless é preciso preservar o bloco thought e a assinatura |
A camada de ferramentas precisa guardar integralmente seis informações: o ID da chamada, o nome da função, o JSON dos parâmetros, a relação entre chamadas paralelas, o resultado da execução e se o modelo exige que o raciocínio continue. Chamadas paralelas são o ponto mais propenso a erro. O modelo dispara várias solicitações de ferramentas de uma vez, e a aplicação devolve o resultado de apenas uma delas, ou associa o resultado ao ID errado; na rodada seguinte a requisição acaba em erro de parâmetros, ou o modelo continua respondendo com base em dados incorretos.
A recomendação é que a camada de ferramentas unificada valide os parâmetros primeiro com JSON Schema e só depois execute a operação externa real. Os parâmetros gerados pelo modelo nem sempre são válidos, e a validação antecipada barra o erro antes de “chamar o sistema externo”.
2.3 Compatibilidade entre modos de raciocínio e estado de contexto
Os nomes e significados dos parâmetros de raciocínio não são equivalentes entre os três provedores:
- OpenAI: usa parâmetros como
reasoning.effort. GPT-6 Astra e GPT-6.1 Sol não aceitamreasoning.effort=none, e nesses dois modelos a chamada de ferramentas também exige a Responses API. - Claude: os modelos de nova geração adotam principalmente o Adaptive Thinking, combinado com configurações de raciocínio como effort. Alguns modelos novos já não oferecem o modo antigo de raciocínio manual com
budget_tokensfixo. - Gemini: modelos diferentes usam thinking level ou budget; se é possível desligar o raciocínio e quais níveis existem varia de modelo para modelo. As regras de mapeamento de parâmetros da API nativa também são diferentes das da entrada compatível com OpenAI.
Quando a interface do produto define três níveis de intensidade de raciocínio — “rápido, padrão e aprofundado” —, o nome do nível expressa a intenção do produto. O adaptador precisa traduzi-lo para os parâmetros que cada modelo realmente aceita, e os recursos computacionais que cada provedor entrega no mesmo nível também não são iguais. Além disso, o resumo de raciocínio que o usuário enxerga pode não bater com a quantidade de tokens de raciocínio efetivamente cobrada; a contabilização de custos deve se basear no campo de uso retornado pela interface.
O estado criptografado nas chamadas de ferramentas de múltiplos turnos é o ponto que Agents de longa duração mais costumam ignorar:
- Itens de reasoning e chamadas de ferramentas do OpenAI Responses podem precisar ser propagados junto com o histórico.
- Blocos
thinking/redacted_thinkingdo Claude podem conter estado criptografado; ao devolvê-los após a execução da ferramenta, é preciso manter a estrutura original. - O modo stateless do Gemini Interactions exige preservar literalmente os blocos thought e as assinaturas; no modo stateful, parte do estado pode ser mantida pelo servidor.
Guardar apenas o texto exibido na janela de chat não é suficiente para restaurar por completo o histórico de raciocínio do modelo. A falha típica é: o Agent dá erro de repente depois da terceira rodada de chamadas de ferramentas, ou começa a repetir passos já concluídos. A causa costuma ser o bloco de assinatura perdido em alguma rodada intermediária.
2.4 Unificação dos eventos de streaming
Cada um dos três provedores tem seus próprios tipos de evento de streaming, ordem e sinal de encerramento. O OpenAI Responses pode emitir response.output_text.delta, incrementos de chamada de ferramenta e o evento de conclusão da response. O stream do Claude Messages usa eventos como message_start, content_block_delta e message_delta. A API nativa do Gemini usa sua própria estrutura de saída e de etapas.
Se o frontend parseia os eventos brutos de cada fornecedor, cada modelo novo integrado exige uma alteração no código do frontend. A recomendação é o backend converter tudo para um protocolo interno de eventos:
| Evento interno | Significado | Pontos de atenção |
|---|---|---|
text_delta |
Incremento de texto | Anexar direto na exibição |
reasoning_summary |
Resumo do raciocínio | Pode ser exibido de forma recolhível; a cobrança segue o usage |
tool_call_start |
Início da chamada de ferramenta | Registrar o ID da chamada e o nome da função |
tool_call_args |
Fragmento de parâmetros | Concatenar pelo ID da chamada ou pelo índice; só é possível parsear depois de receber tudo |
tool_result |
Resultado da execução da ferramenta | Correspondência um a um com o ID da chamada |
usage |
Estatísticas de uso | Distinguir tokens de entrada, de cache, de raciocínio e de saída |
completed |
Encerramento normal | É obrigatório receber um sinal explícito de término |
error |
Erro ou stream interrompido | Distinguir o que é retentável do que não é |
Existem três pontos de falha recorrentes no processamento de streaming. Primeiro, os fragmentos de parâmetros de várias chamadas de ferramenta chegam intercalados e concatenar na ordem de chegada embaralha os IDs. Segundo, os parâmetros JSON são cortados em qualquer caractere; tentar parsear com apenas metade recebida lança exceção. Terceiro, a conexão cai no meio do caminho sem que o evento de conclusão chegue, e a interface fica travada em “gerando”. A camada de conversão precisa tratar explicitamente esses três casos.
2.5 Saída estruturada com JSON Schema e diferenças de capacidade multimodal
As três oferecem capacidade de saída estruturada, mas existem diferenças nas características de JSON Schema suportadas, no modo estrito e na forma de combinar isso com a invocação de ferramentas. A documentação oficial do Claude distingue dois mecanismos: JSON outputs restringe a estrutura da resposta final, enquanto Strict tool use restringe a estrutura dos parâmetros de invocação de ferramentas. Alguns modelos, ao usar o formato estrito, ainda geram custos extras de compilação ou cache do Schema.
A recomendação de engenharia é: o aplicativo mantém um JSON Schema padrão próprio e registra, na tabela de registro de capacidades, quais características de Schema cada modelo suporta. Para características não suportadas, o adaptador faz uma conversão de degradação. Por mais rígido que o modelo se declare, o lado da aplicação deve fazer mais uma validação; quando a validação falha, entra em um fluxo controlado de nova tentativa ou de erro.
O mesmo vale para multimodalidade. “Suporta entrada de imagens” indica apenas a categoria da capacidade; na prática, ainda é preciso comparar os seguintes pontos: tipos de arquivo aceitos, tamanho e quantidade de imagens, capacidades de vídeo e áudio, forma de upload de arquivos, limite da janela de contexto longa e faixa realmente utilizável, máximo de tokens de saída, e se a invocação de ferramentas pode ser combinada com entradas multimodais. O fato de a camada de compatibilidade do Claude não suportar entradas audio e file é exatamente uma limitação concreta que precisa ser registrada na tabela.
2.6 Diferenças entre modelos em cache, cobrança e tratamento de erros
Os mecanismos de cache de prompts dos três fornecedores são bem diferentes:
- OpenAI: o GPT-5.6 e os modelos seguintes oferecem cache implícito e pontos de quebra (breakpoints) de cache explícito, com TTL de 30 minutos ou 12 horas.
- Claude: usa
cache_controlpara indicar cache automático ou explícito, com dois modos, de 5 minutos e de 1 hora; esse recurso não é suportado na sua camada compatível com OpenAI. - Gemini: os modelos novos têm cache implícito automático, e algumas APIs e modelos permitem criar objetos de cache de forma explícita.
Depois de trocar de modelo, o cache do fornecedor anterior normalmente não pode ser reaproveitado. Se você migrar de Claude para Gemini no meio de uma conversa, a primeira requisição será cobrada pelo input completo. E se a estimativa de custo assumir por padrão que “o cache sempre acerta”, quanto mais frequente for a troca de estratégia, maior será a diferença na conta.
Os preços unitários padrão de cada fornecedor também variam bastante. Os preços oficiais de tabela, em 2026-11-13, são os seguintes (USD / milhão de tokens):
| Modelo | Entrada | Saída | Observações |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | Chamadas de ferramentas exigem a Responses API |
| GPT-6.1 Sol | $1 | $5 | Chamadas de ferramentas exigem a Responses API |
| Claude Sonnet 5.5 | $2 | $10 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | Preço promocional até 2026-12-31; a partir de 2027-01-01 o ajuste planejado é para $1.50 / $7.50 |
Esta tabela serve apenas para ilustrar as diferenças de cobrança. Cada modelo tem capacidades e condições de uso distintas, e preço mais alto ou mais baixo não se converte diretamente em comparação de desempenho. A tabela também não inclui custos de gravação em cache, chamadas de ferramentas, níveis de serviço nem acréscimos de terceiros.
💰 Sugestão para cálculo de custos: a conta de uma aplicação multimodelo precisa ser registrada por item: “input normal, gravação em cache, acerto de cache, pensamento e saída, custos de ferramentas, adicional de contexto longo”. Ao chamar vários modelos de forma unificada através do APIYI apiyi.com, você pode ver o consumo de cada modelo em um só lugar, o que facilita relacionar a estratégia de roteamento com o custo real.
No tratamento de erros, os três fornecedores diferem em taxa de requisições, taxa de tokens, cotas, timeouts e formato de erro. A aplicação deve estabelecer uma classificação unificada de erros: falha de autenticação, modelo não suportado, parâmetros inválidos, requisição grande demais ou acima do contexto, 429 (limite de requisições), erro no servidor, desconexão de rede, interrupção do stream de resposta, falha em chamada de ferramenta.
O fallback entre modelos também precisa considerar se a tarefa tem efeitos colaterais. Se o modelo principal der timeout depois que a ferramenta já foi executada, e o sistema trocar automaticamente para o modelo de reserva reexecutando toda a tarefa, operações como pagamentos, envio de e-mails ou alteração de arquivos podem acontecer duas vezes. A solução é adicionar chaves de idempotência às ferramentas com efeitos colaterais e, no fallback, continuar apenas a partir das “etapas ainda não executadas”.
3 Como projetar uma arquitetura de API compatível com múltiplos modelos
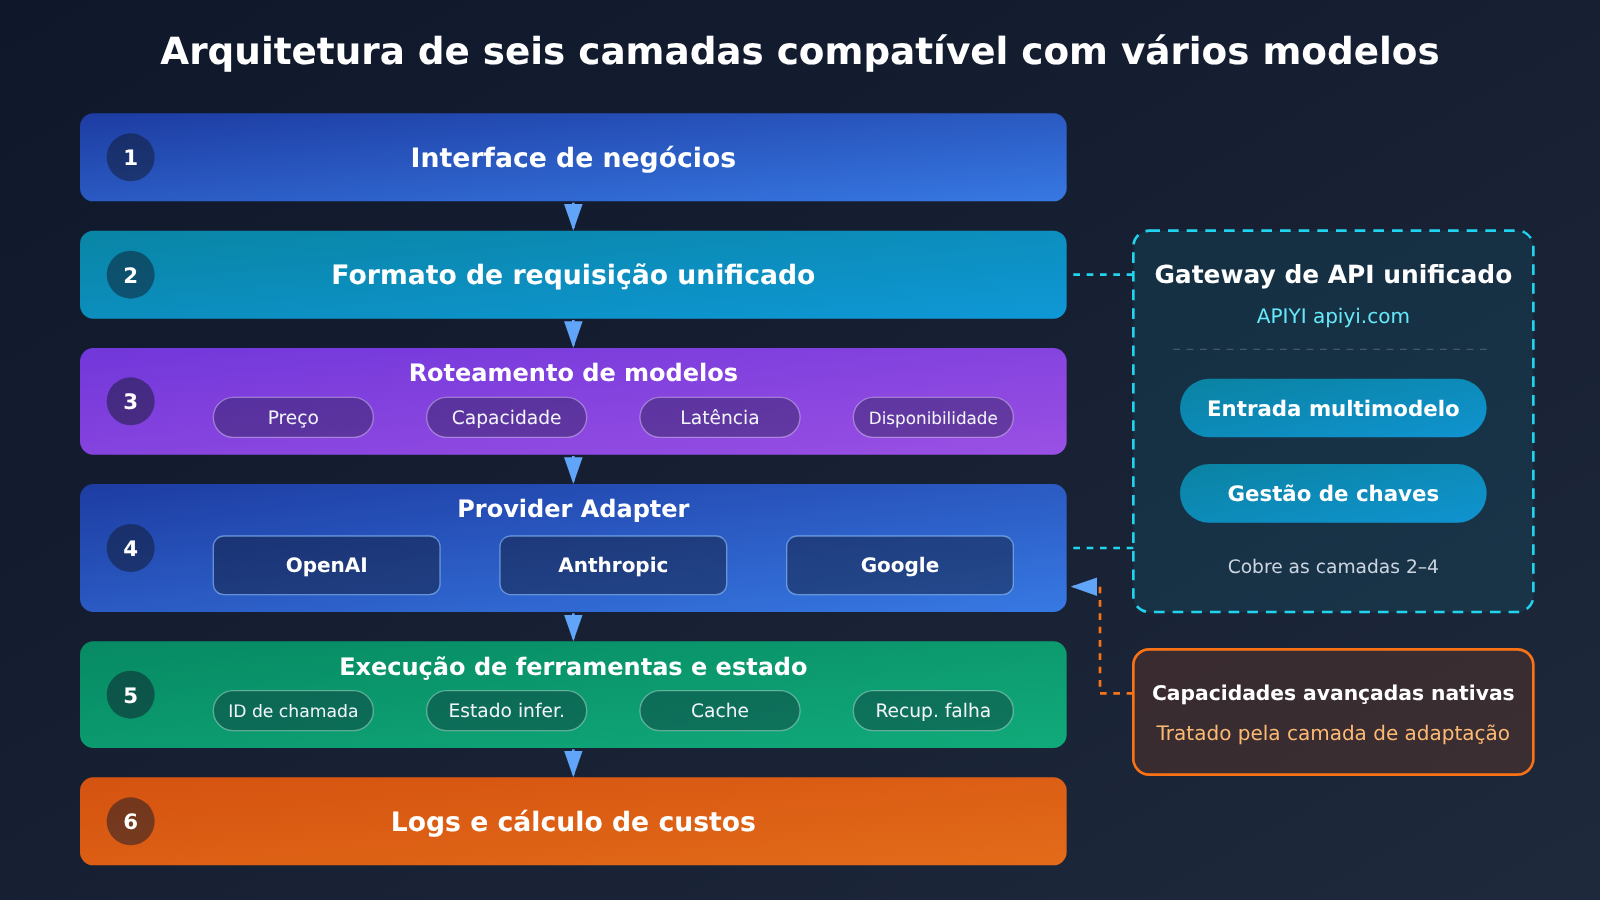
A estrutura recomendada em seis camadas é a seguinte:
- Interface de negócios: perguntas dos usuários, upload de materiais, seleção de modelo e tarefa.
- Formato de requisição unificado: usar uma estrutura unificada para representar o histórico de mensagens, anexos, lista de ferramentas, requisitos de saída estruturada, intensidade de raciocínio e ID da tarefa.
- Roteamento de modelos: selecionar GPT, Claude ou Gemini com base em preço, capacidade, latência, disponibilidade e regras de negócio.
- Provider Adapter: converter a requisição padrão no formato nativo de cada fornecedor e, em seguida, mapear o resultado retornado de volta para o formato interno.
- Execução de ferramentas e gerenciamento de estado: manter IDs de chamada, registros de execução, contexto da conversa, estado de raciocínio do fornecedor, cache e recuperação de falhas.
- Logs e contabilidade de custos: registrar, em cada requisição, o modelo, os tokens, o custo real, a latência, o cache, os erros e as chamadas de ferramentas.
3.1 Estabelecer um formato unificado de mensagens e ferramentas
O princípio central do formato unificado é armazenar o histórico em duas camadas. A primeira camada é o histórico padrão universal, que inclui mensagens do usuário, a resposta final do modelo, solicitações de ferramentas e resultados de ferramentas — algo que qualquer fornecedor consegue entender. A segunda camada é o estado exclusivo do fornecedor, como itens de reasoning, assinaturas de thinking e blocos de thought, armazenados de forma isolada por fornecedor e retornados como estão somente ao fazer uma requisição para o mesmo fornecedor.
from dataclasses import dataclass, field
from typing import Any, Literal

@dataclass
class ToolCall:
    call_id: str              # ID de chamada unificado; o adaptador é responsável por mapear mutuamente com o ID do fornecedor
    name: str
    arguments: dict[str, Any]
    result: Any = None
    idempotency_key: str = "" # ferramentas com efeitos colaterais devem definir

@dataclass
class Message:
    role: Literal["system", "developer", "user", "assistant", "tool"]
    content: list[dict]                      # blocos multimodais, como texto e imagens
    tool_calls: list[ToolCall] = field(default_factory=list)
    # estado exclusivo do fornecedor: a chave é o nome do fornecedor; o valor são blocos de assinatura / reasoning salvos como estão
    vendor_state: dict[str, Any] = field(default_factory=dict)
Ao trocar de modelo, o adaptador lê os campos padrão para gerar uma nova requisição. As partes de vendor_state pertencentes a outros fornecedores não são enviadas; as partes pertencentes ao fornecedor de destino são retornadas como estão.
3.2 Adaptando APIs nativas por meio de Provider Adapters
Cada adaptador tem três responsabilidades:
- Conversão de entrada: mapeamento de papéis (por exemplo, mover o system para o campo separado do Claude), conversão das definições de ferramentas, degradação de Schema e mapeamento de níveis de raciocínio.
- Conversão de saída: transformar as respostas nativas e os eventos de streaming nos eventos internos da seção 2.4, mapeando os IDs de chamada de ferramenta para um ID unificado.
- Tratamento de estado: extrair e salvar estados do fornecedor, como assinaturas e itens de reasoning, decidindo entre continuidade do lado do servidor (
previous_response_id,previous_interaction_id) ou reenvio completo do histórico.
Perguntas e respostas comuns podem usar o adaptador público no formato compatível com OpenAI. Cenários que exigem parâmetros de ferramenta rígidos, controle de cache ou estado de pensamento criptografado devem implementar adaptadores nativos separados. Assim você mantém a conveniência de um único ponto de entrada e dá aos recursos avançados um lugar claro para morar.
3.3 Decidindo os recursos disponíveis com um registro de capacidades
O registro de capacidades anota o suporte real por unidade de “modelo + endpoint de acesso”. Um mesmo modelo pode gerar duas entradas: uma para o caminho nativo e outra para a camada de compatibilidade. Veja abaixo um exemplo de estrutura; os valores concretos precisam se basear na documentação oficial e nos resultados dos seus próprios testes:
gpt-6.1-sol@responses:
  tools: true
  tool_api: responses          # a chamada de ferramentas exige a API Responses
  reasoning_effort: [low, medium, high]   # não aceita none
  vendor_state: reasoning_items
claude-sonnet@openai-compat:
  tools: true
  strict_tools: false          # a camada de compatibilidade ignora strict
  prompt_caching: false
  file_input: false
  merges_system_developer: true
gemini-flash@interactions:
  tools: true
  builtin_tools: [google_search, url_context, code_execution]
  vendor_state: thought_signatures
A camada de roteamento consulta o registro antes de escolher o modelo. Se a requisição trouxer arquivo, ela exclui as entradas com file_input: false; se precisar de parâmetros de ferramenta rígidos, seleciona apenas as entradas com strict_tools: true. A interface do produto também pode se basear nisso para ocultar opções que o modelo atual não suporta, reduzindo os erros que o usuário acaba disparando.
4 Testes e observação antes do lançamento da compatibilidade multi-modelo da API
4.1 Seis testes de compatibilidade, de perguntas simples a cadeias de ferramentas com múltiplos turnos
Em ordem crescente de complexidade, execute os seis testes a seguir:
- Perguntas e respostas simples: envie o mesmo comando para os três modelos e verifique se o conteúdo da resposta e as estatísticas de tokens estão normais.
- Saída em streaming: confirme que a saída chega de forma contínua e que o sinal de encerramento correto é recebido.
- Chamada de ferramentas: o modelo chama a ferramenta de consulta de clima ou de consulta de dados; a aplicação executa e devolve o resultado.
- Loop de múltiplas ferramentas: chame ferramentas por duas rodadas consecutivas ou mais e confirme que o histórico e os IDs de chamada estão completos.
- JSON estruturado: produza a saída conforme o mesmo Schema e valide a estrutura com o validador do lado da aplicação.
- Troca de modelo: a mesma sessão de negócio alterna entre GPT, Claude e Gemini; confirme que o contexto, o histórico de ferramentas e a resposta final estão normais.
Os itens 4 e 6 são os que mais expõem problemas de estado de raciocínio; recomenda-se incluí-los no pipeline de integração contínua. Sempre que atualizar a versão do modelo ou trocar o endpoint de acesso, execute-os novamente.
4.2 Criar uma observação unificada de custo e estabilidade
Para cada requisição, registre pelo menos os seguintes campos: modelo e endpoint, taxa de sucesso das requisições, tipo de exceção (conforme a classificação da seção 2.6), latência até o primeiro token e tempo total da tarefa, tokens discriminados por categoria (entrada, gravação em cache, acerto de cache, raciocínio, saída), número de chamadas de ferramentas e de falhas, número de novas tentativas e de fallbacks.
Ao avaliar um modelo, olhe para o tempo total e o custo total de uma tarefa completa; os dados de uma única requisição têm valor de referência limitado. Um modelo com preço unitário baixo, se tiver alta taxa de erro nos parâmetros das ferramentas e exigir várias rodadas de novas tentativas, pode acabar custando mais no total.
5 O papel de um gateway de API unificado na compatibilidade com APIs multimodelo
5.1 Custos de integração e manutenção
Usar três modelos ao mesmo tempo significa três conjuntos de contas, três conjuntos de chaves, três sistemas de cobrança e três configurações de SDK. Um gateway de API unificado concentra esse trabalho em um único ponto de entrada: gerencia de forma centralizada a integração de modelos e as credenciais, reduz a manutenção de configuração de cada provedor, permite escolher e alternar modelos na camada de configuração e oferece uma visão unificada de uso e custos. Para equipes que precisam comparar com frequência o desempenho dos modelos, a barreira para experimentar novos modelos também diminui.
5.2 O posicionamento do APIYI: divisão entre ponto de entrada unificado e adaptação de capacidades nativas
APIYI é uma plataforma agregadora de APIs de Modelos de Linguagem Grande de IA. Com uma única chave API, é possível chamar modelos populares como OpenAI, Claude e Gemini por meio de uma interface compatível com OpenAI, com cobrança por uso. Ele é adequado para assumir a camada de “ponto de entrada unificado de chamadas” na arquitetura: perguntas e respostas comuns, saída em streaming, comparação de modelos e roteamento multimodelo podem ser integrados diretamente.
Ter um ponto de entrada de chamadas unificado e garantir consistência total com as capacidades nativas do fornecedor são dois requisitos técnicos distintos. Ao integrar um modelo específico, ainda é necessário verificar, item por item no registro de capacidades, o escopo de suporte a chamadas de ferramentas, estado de pensamento, multimodalidade, cache e saída estruturada. Fluxos que dependem de capacidades nativas como Responses API, cache_control e assinaturas criptográficas precisam ter o endpoint correspondente confirmado como realmente disponível antes de entrarem em produção, ou então devem manter um adaptador nativo dedicado.
Início rápido para compatibilidade de API com vários modelos
Exemplo mínimo: comparar três modelos com o mesmo comando
O código abaixo usa o mesmo cliente OpenAI SDK para chamar três modelos em sequência, correspondendo ao teste 1 da seção 4.1.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

# Os IDs dos modelos devem seguir a lista de modelos da plataforma
MODELS = ["你的GPT模型ID", "你的Claude模型ID", "你的Gemini模型ID"]

for model in MODELS:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是幂等"}],
    )
    print(model, "→", resp.choices[0].message.content)
    print("usage:", resp.usage)
Ver implementação completa: eventos de streaming unificados + registro de capacidades + validação de ferramentas
import json
import openai
from openai import OpenAI
from jsonschema import validate, ValidationError

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

# Registro de capacidades: os valores são apenas exemplos de estrutura; mantenha conforme a documentação oficial e os resultados de testes reais
CAPABILITIES = {
    "gpt":    {"model": "你的GPT模型ID",    "tools_via": "responses"},  # A invocação de ferramentas precisa passar pelo adaptador Responses
    "claude": {"model": "你的Claude模型ID", "tools_via": "chat"},
    "gemini": {"model": "你的Gemini模型ID", "tools_via": "chat"},
}

def classify_error(e: Exception) -> str:
    """Classificação unificada de erros, decide se é possível tentar novamente"""
    if isinstance(e, openai.AuthenticationError):
        return "auth_failed"
    if isinstance(e, openai.NotFoundError):
        return "model_not_supported"
    if isinstance(e, openai.RateLimitError):
        return "rate_limited"          # Pode tentar novamente com backoff
    if isinstance(e, openai.BadRequestError):
        return "invalid_request"       # Erro de parâmetro ou contexto excedido; não deve tentar novamente às cegas
    if isinstance(e, openai.APIConnectionError):
        return "network_error"
    if isinstance(e, openai.InternalServerError):
        return "server_error"
    return "unknown"

def stream_chat(provider: str, messages: list, tools: list | None = None):
    """Converte o stream no formato compatível com OpenAI em eventos internos unificados"""
    cap = CAPABILITIES[provider]
    if tools and cap["tools_via"] != "chat":
        raise NotImplementedError(f"{provider} 的工具调用请交给原生适配器处理")

    kwargs = {
        "model": cap["model"],
        "messages": messages,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    if tools:
        kwargs["tools"] = tools

    calls: dict[int, dict] = {}   # Concatena por index os fragmentos de parâmetros das invocações paralelas de ferramentas
    finished = False
    try:
        for chunk in client.chat.completions.create(**kwargs):
            if not chunk.choices:
                if chunk.usage:
                    yield {"type": "usage", "data": chunk.usage.model_dump()}
                continue
            choice = chunk.choices[0]
            delta = choice.delta
            if delta.content:
                yield {"type": "text_delta", "data": delta.content}
            for tc in delta.tool_calls or []:
                slot = calls.setdefault(tc.index, {"id": None, "name": "", "args": ""})
                if tc.id:
                    slot["id"] = tc.id
                if tc.function and tc.function.name:
                    slot["name"] = tc.function.name
                    yield {"type": "tool_call_start", "data": {"id": slot["id"], "name": slot["name"]}}
                if tc.function and tc.function.arguments:
                    slot["args"] += tc.function.arguments
                    yield {"type": "tool_call_args", "data": {"index": tc.index}}
            if choice.finish_reason:
                finished = True
                yield {"type": "completed", "data": {
                    "finish_reason": choice.finish_reason,
                    "tool_calls": list(calls.values()),
                }}
    except Exception as e:
        yield {"type": "error", "data": classify_error(e)}
        return
    if not finished:
        yield {"type": "error", "data": "stream_interrupted"}  # Stream interrompido no meio

EXECUTED_KEYS: set[str] = set()   # Em produção, substitua por armazenamento persistente

def run_tool(call: dict, schema: dict, func, idempotency_key: str | None = None):
    """Primeiro valida os parâmetros, depois executa de forma idempotente"""
    try:
        args = json.loads(call["args"])   # Só faz o parse depois que todos os fragmentos estiverem completos
        validate(instance=args, schema=schema)
    except (json.JSONDecodeError, ValidationError) as e:
        return {"error": f"invalid_arguments: {e}"}
    if idempotency_key:
        if idempotency_key in EXECUTED_KEYS:
            return {"skipped": "already_executed"}
        EXECUTED_KEYS.add(idempotency_key)
    return func(**args)

# Exemplo de uso
for event in stream_chat("claude", [{"role": "user", "content": "介绍一下流式输出"}]):
    print(event)
🚀 Início rápido: cadastre-se na APIYI apiyi.com para obter uma cota de testes gratuita e use o código acima, com a mesma Key, para concluir os dois primeiros testes da seção 4.1. Para os testes relacionados à invocação de ferramentas e raciocínio multi-turno, valide modelo por modelo com base no registro de capacidades.
Perguntas frequentes (FAQ)
P1: O que significa, principalmente, o problema de compatibilidade de API entre múltiplos modelos?
Refere-se às diferenças que uma mesma aplicação precisa tratar ao alternar entre GPT, Claude e Gemini, por conta das estruturas distintas das APIs nativas. São principalmente 6 categorias: papéis de mensagem, chamadas de ferramentas, estado de raciocínio, eventos de streaming, saída estruturada e multimodalidade, cobrança de cache e tratamento de erros.
P2: Ao usar a interface compatível com OpenAI para chamar Claude e Gemini, ainda preciso de uma camada de adaptação?
Para conversas comuns, dá para usar a interface compatível diretamente. Quando envolve parâmetros de ferramenta estritos, Prompt Caching, entrada de arquivos e estado de pensamento criptografado, aí sim é necessário uma camada de adaptação. Tomando como exemplo a camada de compatibilidade oficial da Claude, ela ignora `strict` e também não oferece suporte a cache e a entradas audio/file. Essas diferenças devem ser registradas na tabela de capacidades.
P3: Em um projeto novo com Gemini, devo usar a Interactions API ou generateContent?
A Interactions API entrou em GA em junho de 2026, e o Google recomenda adotá-la prioritariamente em projetos novos. Ela suporta estado de sessão no lado do servidor, `previous_interaction_id` e a estrutura de steps. O `generateContent` continua suportado, e projetos existentes podem migrar conforme o planejado.
P4: Ao trocar de modelo no meio da conversa, como tratar o histórico?
Mensagens do usuário, respostas finais, requisições de ferramentas e resultados de ferramentas ficam armazenados como histórico padrão e são remontados pelo adaptador do modelo de destino após a troca. Estados exclusivos do fornecedor, como assinaturas e itens de reasoning, são salvos separadamente e só retornados como estão quando a requisição é para o mesmo fornecedor. Além disso, após a troca o cache do fornecedor original normalmente não pode ser reaproveitado, então é preciso reservar o custo de entrada completo do primeiro turno.
P5: Como validar rapidamente a compatibilidade dos três modelos no meu negócio?
Sugiro seguir estes passos:
1. Acesse APIYI apiyi.com, registre uma conta e obtenha a chave API e a cota gratuita de testes.
2. Use o código deste artigo, defina base_url como o endereço de endpoint da APIYI e preencha os IDs dos três modelos.
3. Execute progressivamente os seis testes da seção 4.1 e registre taxa de sucesso, tipos de exceção, custo e tempo total.
P6: O que devo observar ao configurar o fallback automático de modelos?
Primeiro, verifique se a tarefa tem efeitos colaterais. Ferramentas como pagamento, envio de e-mail e alteração de arquivos precisam carregar chaves de idempotência, e o fallback deve continuar a partir da etapa não concluída, evitando reexecutar a tarefa inteira. Limitação de taxa e erros de servidor pedem retry com backoff; já erros de parâmetro e estouro de contexto exigem corrigir a requisição antes de reenviar.
P7: Como controlar custos no roteamento entre múltiplos modelos?
Registre os custos por tokens discriminados e compare com base no custo total da tarefa completa. A diferença de preço unitário entre os três é grande; por exemplo, a saída do GPT-6 Astra custa US$ 50 por milhão de tokens, enquanto o Gemini 3.8 Flash está com preço promocional atual de US$ 3,75. Consultar o uso de cada modelo de forma unificada na APIYI apiyi.com ajuda a identificar mais rápido as cadeias de alto custo e, a partir disso, ajustar as regras de roteamento.
P8: Quais são as limitações de um gateway de API unificado?
O gateway unifica o ponto de entrada das chamadas, as chaves e a cobrança. A disponibilidade de recursos avançados nativos de cada fornecedor (como chamadas de ferramentas exclusivas da Responses API, `cache_control` e retorno de assinatura criptografada) depende do suporte de cada endpoint e precisa ser testada item por item. Cadeias que dependem desses recursos devem manter adaptadores nativos como complemento.
Pontos-chave da compatibilidade entre APIs multi-modelo (Key Takeaways)
- Trocar de modelo não é trocar de ID: perguntas e respostas simples migram diretamente; cadeias de Agent precisam lidar com 6 tipos de diferenças.
- A camada de compatibilidade tem limites: a camada de compatibilidade do Claude ignora
stricte não suporta cache nem entrada de arquivos. - As assinaturas devem ser preservadas como estão: a perda das assinaturas de thinking/thought é uma das causas mais comuns de erros em cadeias de ferramentas com múltiplos turnos.
- Eventos de streaming unificados: o backend produz 8 tipos de eventos internos e o frontend se conecta a um único protocolo.
- Roteamento guiado por registro de capacidades: registra, por “modelo + endpoint”, os recursos realmente suportados.
- O fallback precisa ser idempotente: ferramentas com efeitos colaterais recebem uma chave de idempotência para evitar execução duplicada.
- Teste antes de ir para produção: use a cota gratuita do APIYI apiyi.com para executar os seis testes de compatibilidade.
Resumo
Quando uma aplicação se conecta ao GPT, ao Claude e ao Gemini ao mesmo tempo, o segredo é concentrar as diferenças em poucos componentes:
- Unificar o formato de mensagens e ferramentas: histórico padrão e estado proprietário de cada fornecedor ficam armazenados em camadas separadas, assim o contexto não se perde ao trocar de modelo.
- Provider Adapter: responsável pela conversão de entrada, conversão de saída e tratamento de estado; os recursos avançados nativos são implementados aqui.
- Registro de capacidades: documenta fielmente, para cada modelo e cada endpoint, o suporte a ferramentas, raciocínio, multimodal, Schema e cache — é ele que define o roteamento e as opções de interface.
Sobre essa base, use os seis testes de compatibilidade e a observação de custos por item para garantir a qualidade antes do lançamento. Na fase de chamadas comuns e de comparação de modelos, recomenda-se usar o APIYI apiyi.com para concluir rapidamente a validação multi-modelo com uma única chave e, depois, decidir com base nos resultados dos testes quais cadeias precisam de adaptação nativa.
📚 Materiais de referência
- OpenAI Function Calling: chamada de ferramentas,
call_idefunction_call_output - Link:
developers.openai.com/api/docs/guides/function-calling -
Descrição: documentação autoritativa do protocolo de chamada de ferramentas da Responses API
-
Guia de migração para os modelos mais recentes da OpenAI: parâmetros de raciocínio e requisitos de interface da série GPT-6
- Link:
developers.openai.com/api/docs/guides/latest-model -
Descrição: limites dos valores de
reasoning.efforte requisitos da Responses API -
OpenAI Prompt Caching: breakpoints de cache e TTL
- Link:
developers.openai.com/api/docs/guides/prompt-caching -
Descrição: mecanismos de cache implícito e explícito
-
Compatibilidade do Claude com o SDK da OpenAI: escopo de suporte e limitações da camada de compatibilidade
- Link:
platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk -
Descrição: diferenças em
strict, cache, entrada de arquivos, mesclagem de system, entre outros -
Claude Extended Thinking: Adaptive Thinking e assinaturas de pensamento
- Link:
platform.claude.com/docs/en/build-with-claude/extended-thinking -
Descrição: regras de reenvio dos blocos de pensamento em chamadas de ferramentas com múltiplos turnos
-
Saídas estruturadas e cache do Claude: JSON outputs, Strict tool use,
cache_control - Link:
platform.claude.com/docs/en/build-with-claude/structured-outputs - Link:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
Descrição: restrições estruturais e padrões de cache
-
Gemini Interactions API e compatibilidade com OpenAI: nova interface e endpoint de compatibilidade
- Link:
ai.google.dev/gemini-api/docs/interactions-overview - Link:
ai.google.dev/gemini-api/docs/openai -
Descrição: estrutura de steps, estado da sessão e mapeamento de parâmetros compatíveis
-
Assinaturas de pensamento, chamada de ferramentas e cache do Gemini
- Link:
ai.google.dev/gemini-api/docs/thought-signatures - Link:
ai.google.dev/gemini-api/docs/function-calling - Link:
ai.google.dev/gemini-api/docs/caching -
Descrição: preservação de assinaturas no modo stateless, protocolo de ferramentas e cache explícito
-
Páginas oficiais de preços das três empresas
- Link:
developers.openai.com/api/docs/pricing - Link:
platform.claude.com/docs/en/models/sonnet-5-5/overview - Link:
ai.google.dev/gemini-api/docs/pricing - Descrição: fonte dos dados da tabela de preços deste artigo, data de verificação 2026-11-13
Autor: Equipe técnica da APIYI
Contato técnico: sinta-se à vontade para falar conosco pela página inicial do site da APIYI; há mais materiais no centro de documentação docs.apiyi.com


