
Nota do autor: quais indicadores de confiabilidade você deve verificar ao escolher um serviço proxy ou agregador de API de IA para produção? Este artigo apresenta 10 indicadores essenciais, um processo de validação de 7 dias e uma tabela de avaliação.
Muitas equipes começam a usar um serviço proxy ou agregador de API de IA porque “funciona e é barato”. Mas, quando o serviço entra em produção, os problemas começam a aparecer: mais erros 429 nos horários de pico, interrupções no streaming, divergências entre a fatura e a contagem própria de tokens, ou mudanças repentinas no comportamento do modelo. Neste artigo, reunimos 10 indicadores de confiabilidade essenciais para escolher um serviço proxy ou agregador de API de IA para produção, além de um processo de validação de 7 dias.
Este não é mais um comparativo de preços para escolher o serviço mais barato. Vamos tratar de uma questão: o serviço consegue suportar o tráfego em produção? E, quando algo dá errado, o problema pode ser detectado, explicado e compensado?
O que você vai ganhar: ao final da leitura, terá um checklist prático de confiabilidade para avaliar, com dados, se um serviço proxy de API de IA é adequado para produção antes de assinar contrato ou redirecionar o tráfego.
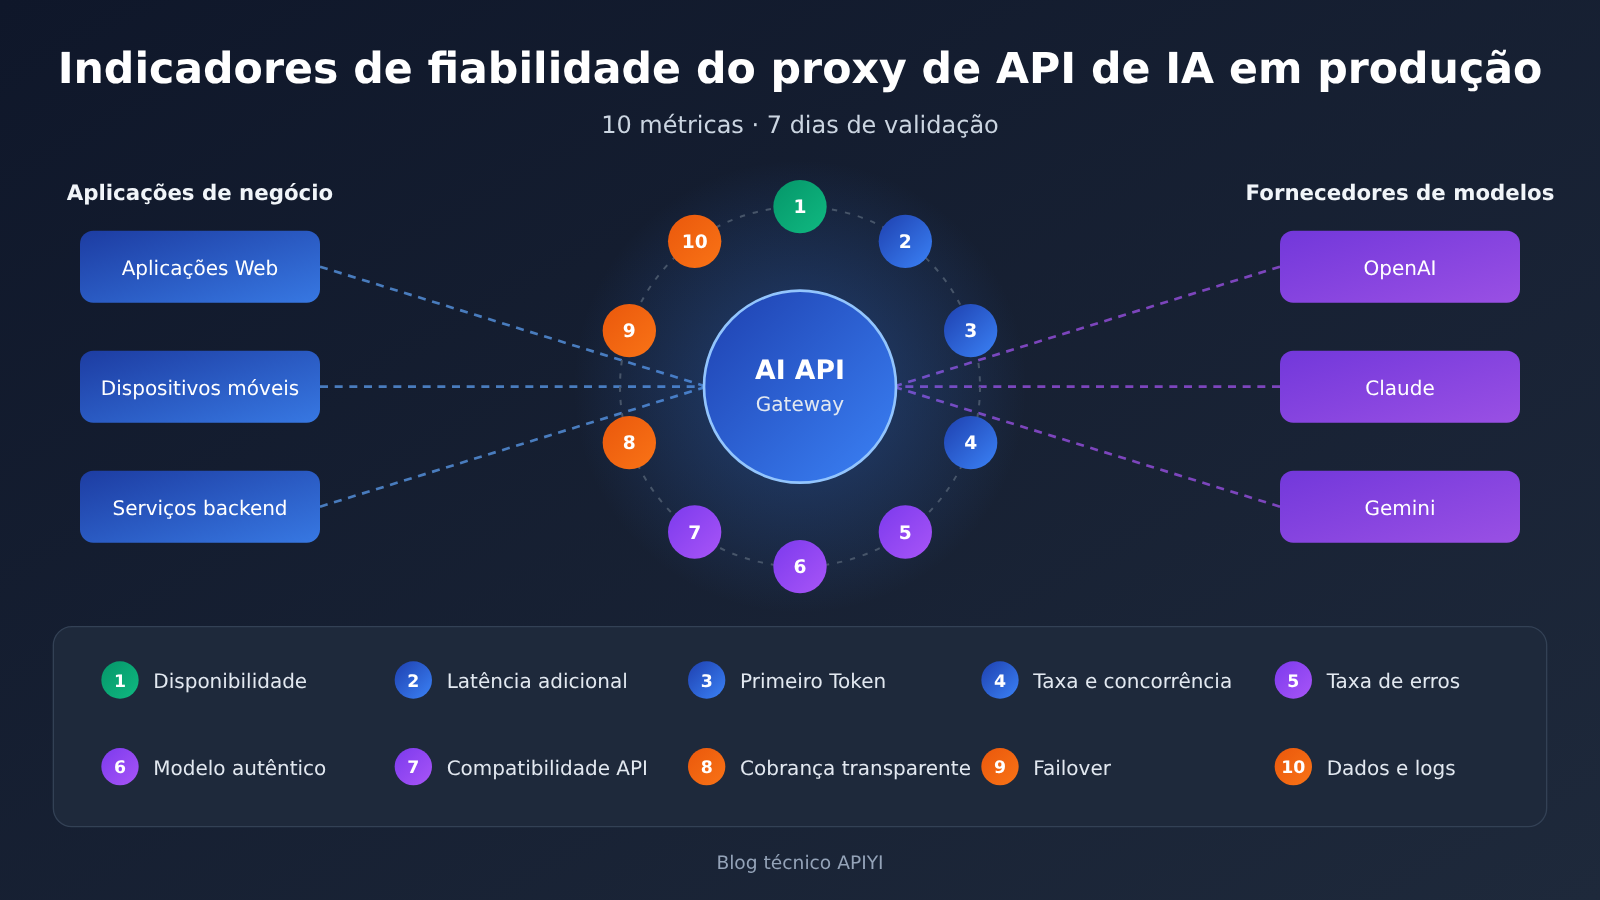
Pontos essenciais de confiabilidade de um serviço proxy e agregador de APIs de IA em produção
Antes de avaliar um serviço proxy e agregador de APIs de IA, vale organizar os indicadores por categoria. Confiabilidade não é só saber se o serviço está no ar: também envolve latência previsível, resultados confiáveis e cobranças que possam ser conferidas. A tabela abaixo reúne 10 indicadores em quatro categorias para facilitar a divisão da avaliação.
| Categoria | Indicadores principais | O que observar | Impacto em produção |
|---|---|---|---|
| Disponibilidade | Histórico de falhas, página de status, compromisso de SLA | Frequência das falhas, tempo de recuperação e publicação de análises dos incidentes | Determina se o serviço pode continuar operando |
| Desempenho | Latência adicional, tempo até o primeiro token, limites de taxa e concorrência | Sobrecarga introduzida pela camada proxy e desempenho nos horários de pico | Afeta diretamente a experiência do usuário e a taxa de timeouts |
| Consistência | Autenticidade da versão do modelo, compatibilidade da interface, transparência dos códigos de erro | Possível substituição de modelos e funcionamento completo do streaming e das chamadas de ferramentas | Determina a qualidade das respostas e a estabilidade do código |
| Governança | Transparência da cobrança, failover, políticas de dados e logs | Conferência das cobranças, redundância entre provedores upstream e conformidade de privacidade | Determina se o serviço pode ser usado com confiança a longo prazo |
Indicadores de disponibilidade de um serviço proxy de API de IA
A disponibilidade é o primeiro critério ao escolher um serviço proxy de API de IA para produção. Não olhe apenas para os percentuais divulgados pela plataforma: verifique também se ela tem uma página de status pública, se o histórico de falhas está disponível e se há uma análise de cada incidente. Uma plataforma que publica a linha do tempo dos incidentes tende a inspirar mais confiança do que outra que apenas promete “alta disponibilidade”.
Fontes independentes podem ajudar a estabelecer uma referência. Por exemplo, em uma avaliação do OpenRouter em produção, o blog da Ofox.ai menciona três falhas registradas entre 2025 e 2026 e uma latência adicional de cerca de 25 a 40 ms (fonte: Ofox.ai Blog, citada apenas como referência comparativa). Esses dados não servem para julgar uma plataforma específica, mas para lembrar que qualquer camada proxy terá falhas e alguma sobrecarga. O importante é saber se elas estão em níveis aceitáveis e se são comunicadas com transparência.
Desempenho e consistência de um serviço agregador de APIs de IA
Na avaliação de desempenho, vale separar a latência adicional da camada proxy em duas partes: a sobrecarga fixa de rede e autenticação e a sobrecarga variável causada pelas filas nos horários de pico. A primeira costuma ser estável e fácil de medir; a segunda é uma fonte importante de incidentes em produção. Por isso, faça os testes durante os horários de pico do seu próprio serviço, em vez de tirar conclusões com base em um único benchmark executado de madrugada.
Em relação à consistência, um risco difícil de perceber é a substituição do modelo. Algumas plataformas podem rotear solicitações para um modelo mais barato ou uma versão quantizada quando há pressão sobre o provedor upstream. A interface continua retornando 200, mas a qualidade das respostas cai visivelmente. Verifique se o campo model da resposta corresponde ao solicitado e execute testes de regressão periódicos com um conjunto fixo de perguntas para identificar mudanças bruscas no estilo ou na precisão das respostas.
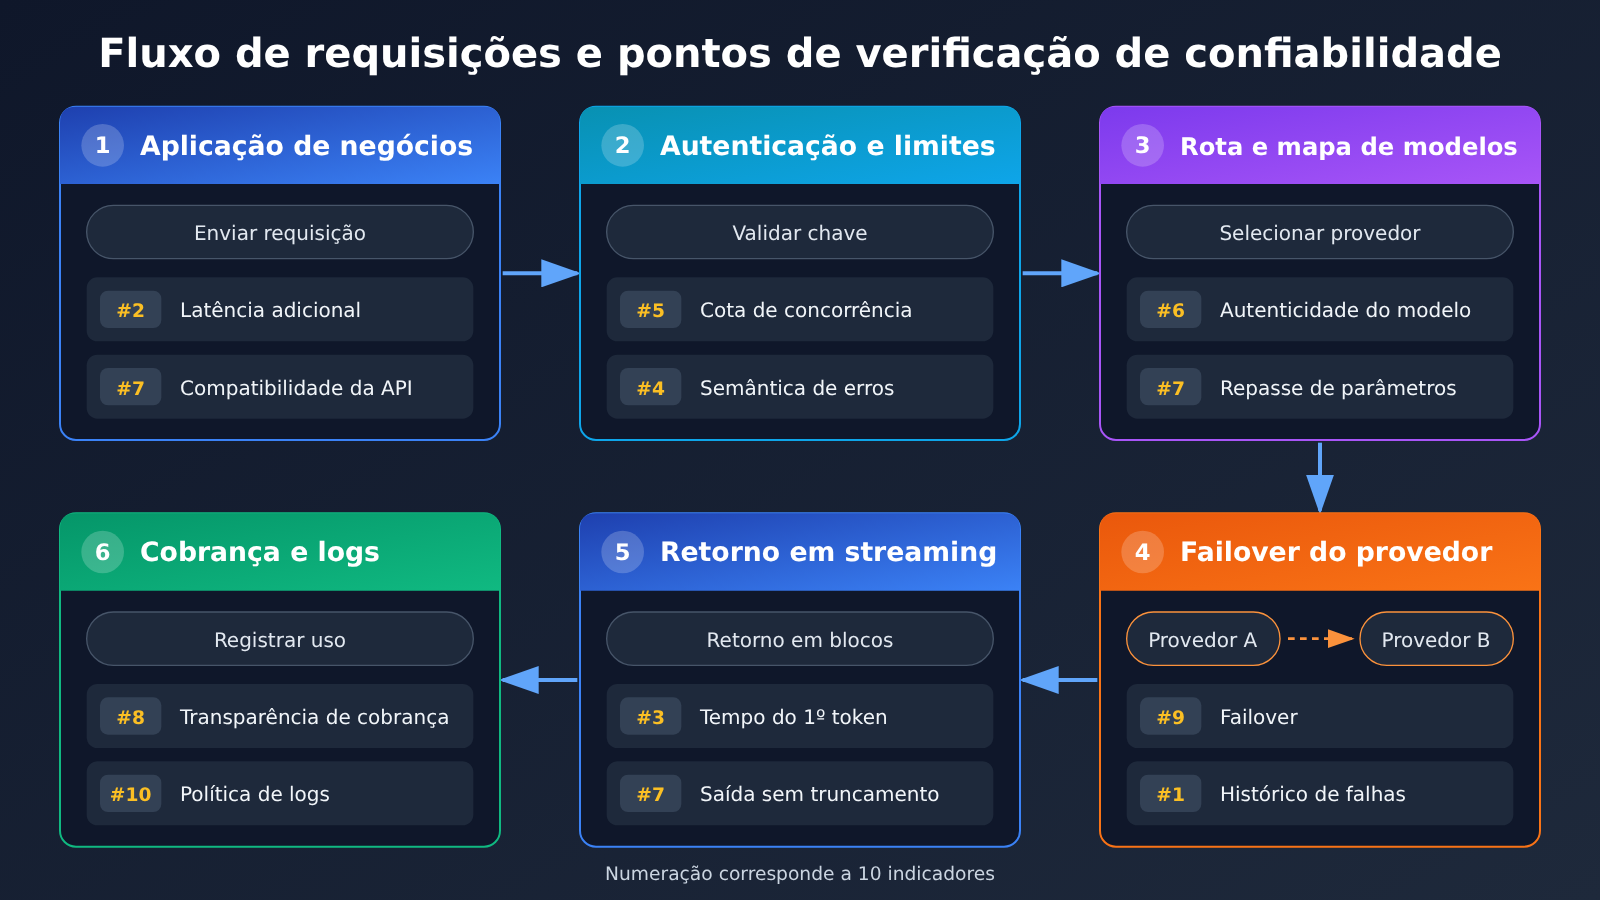
Checklist de 10 indicadores de confiabilidade para serviços proxy de API de IA em produção
A tabela abaixo é o checklist central deste artigo. Cada item traz um método de verificação e um critério de aprovação sugerido. Você pode copiá-la diretamente para um documento de avaliação interna. Os critérios são recomendações baseadas na experiência; ajuste-os conforme a tolerância do seu negócio.
| Nº | Indicador de confiabilidade | Método de verificação | Critério de aprovação sugerido |
|---|---|---|---|
| 1 | Histórico de falhas e página de status | Consulte a página de status pública e as análises de incidentes | Há uma página de status e análises das falhas graves |
| 2 | Latência adicional | Compare a mesma solicitação via conexão direta e via proxy | A latência adicional é estável, sem degradação significativa nos horários de pico |
| 3 | Tempo até o primeiro token | Registre o tempo de chegada do primeiro pacote em solicitações com streaming | Os percentis são estáveis e os casos extremos têm explicação |
| 4 | Taxa e códigos de erro | Analise a distribuição de erros 4xx e 5xx | Os códigos de erro têm significado claro e permitem distinguir problemas do provedor upstream e da plataforma |
| 5 | Limites de taxa e cotas de concorrência | Aumente a carga gradualmente e observe quando surgem erros 429 | As cotas são claras e é possível solicitar aumentos |
| 6 | Autenticidade da versão do modelo | Confira o campo model e execute testes de regressão com um conjunto fixo de perguntas | O modelo retornado corresponde ao solicitado e as respostas não apresentam desvios anormais |
| 7 | Compatibilidade da interface | Teste streaming, chamadas de ferramentas, recursos multimodais e cache | Os principais parâmetros são repassados integralmente, sem descarte silencioso |
| 8 | Transparência da cobrança | Compare sua própria contagem de tokens com a fatura da plataforma | As diferenças são explicáveis e os critérios de cobrança de cache são públicos |
| 9 | Capacidade de failover | Conheça a estratégia de redundância dos provedores upstream e os mecanismos de troca | Uma falha em um único provedor upstream não torna todo o serviço indisponível |
| 10 | Política de dados e logs | Leia os termos de privacidade e as informações sobre retenção de logs | Está claro se os dados são armazenados, por quanto tempo e se é possível desativar a retenção |
Por que a transparência na cobrança de um serviço proxy de API para IA é um indicador de confiabilidade
Muita gente encara a cobrança apenas como uma questão de custo, mas, em produção, a falta de transparência também representa um risco para a confiabilidade. Um aumento repentino na fatura pode indicar falhas no uso do cache, mudanças nas regras de contagem de tokens ou tentativas automáticas anormais por parte do cliente. Todos esses são problemas em nível de sistema. O blog da Ofox.ai relatou que a Anthropic confirmou limitações de taxa em horários de pico e dois bugs de cache que podiam aumentar as cobranças por tokens de 10 a 20 vezes (fonte: Ofox.ai Blog, citada apenas para comparação). Isso mostra que, mesmo nos canais oficiais, é importante conferir a cobrança por conta própria.
A mesma fonte também menciona que algumas plataformas agregadoras cobram taxas de recarga, como a taxa de 5,5% sobre créditos do OpenRouter (fonte: Ofox.ai Blog, citada apenas para comparação). Ao avaliar um serviço proxy de API, vale incluir taxas, câmbio, valor mínimo de recarga e preços de cache no cálculo do “preço unitário real”, em vez de olhar apenas para os preços de entrada e saída exibidos na página.
Pontos de atenção ao verificar a compatibilidade de interfaces de serviços agregadores de API para IA
Problemas de compatibilidade normalmente não aparecem na etapa do Hello World. Os cenários que realmente merecem atenção são outros: a saída em streaming ser interrompida pela camada intermediária, a estrutura dos parâmetros de chamadas de ferramentas ser alterada, o tamanho das imagens de entrada ser limitado ou campos de controle de cache no formato da Anthropic serem descartados silenciosamente. Liste os parâmetros que sua aplicação realmente usa e faça testes de regressão para cada um deles com requisições reais.
Se seu sistema usa os formatos de interface tanto da OpenAI quanto da Anthropic, confirme se o serviço proxy de API oferece suporte nativo aos dois, em vez de converter as requisições da Anthropic para o formato da OpenAI e depois convertê-las de volta. Quanto mais conversões de formato, maior a chance de perda de campos e de inconsistências de comportamento.
Primeiros passos com um serviço proxy de API de IA em produção: validação em 7 dias
Com o checklist em mãos, o próximo passo é validar o serviço. Recomendamos um teste de sete dias com baixo volume de tráfego: assim, você cobre os horários de pico dos dias úteis e também observa o padrão de tráfego no fim de semana. Não são necessárias ferramentas complexas: logs e uma planilha bastam.
| Etapa | Prazo | Principais ações | Resultado |
|---|---|---|---|
| Preparação | Dia 1 | Levantar os modelos, parâmetros e QPS de pico usados pela aplicação e preparar um conjunto fixo de testes de regressão | Lista de parâmetros e conjunto de testes |
| Regressão funcional | Dia 2 | Testar, item por item, streaming, chamada de ferramentas, recursos multimodais e campos de cache | Checklist de compatibilidade |
| Teste de carga | Dia 3 | Aumentar a carga gradualmente até 1,5 vez o pico e registrar os pontos em que ocorrem erros 429 e 5xx | Curvas de concorrência e limitação de taxa |
| Tráfego espelhado | Dias 4 a 6 | Copiar uma pequena parte das requisições reais para o serviço proxy de API e comparar com o fluxo atual | Relatório de latência, taxa de erros e diferenças nas respostas |
| Conciliação e revisão | Dia 7 | Comparar a contagem própria de tokens com a fatura da plataforma e consolidar as 10 métricas | Conclusão sobre a escolha do serviço e plano de migração |
Pontos essenciais para configurar um serviço proxy de API de IA
Na integração, procure alterar apenas a configuração, sem mexer no código. Se o projeto usa o SDK oficial da OpenAI, normalmente basta trocar o base_url pelo endereço fornecido pelo serviço proxy de API e substituir a api_key. No caso da APIYI, o base_url compatível com o formato da OpenAI pode ser definido como https://api.apiyi.com/v1. Para o nome do modelo, use o ID listado na página de preços.
Se você usa o SDK da Anthropic ou ferramentas baseadas no formato da Anthropic, como o Claude Code, confirme se a plataforma oferece integração no formato nativo da Anthropic. Depois, configure o endereço base e as variáveis de ambiente da chave conforme a documentação. A APIYI é compatível com os formatos de interface da OpenAI e da Anthropic. Consulte os endereços e parâmetros atualizados na central de documentação, docs.apiyi.com, em vez de copiar endereços antigos de tutoriais de terceiros.
Na integração, vale cuidar de três pontos:
- Separe os tempos limite e as tentativas de repetição: defina um tempo limite curto para conexão e um tempo maior para leitura, de acordo com o modelo e o tamanho da resposta. Repita apenas requisições que retornem 429 ou 5xx e use espera exponencial.
- Registre os campos importantes: em cada requisição, registre o ID da requisição, o nome do modelo, os tokens de entrada e saída, o tempo decorrido e o código de status. Esses dados são a base para conferir cobranças e investigar problemas.
- Mantenha uma rota alternativa: tenha pelo menos uma conexão de reserva, seja outro serviço proxy de API ou uma conexão direta com o provedor oficial, e use uma opção de configuração para alternar entre elas.
🚀 Sugestão para começar: se quiser testar primeiro o processo de 7 dias descrito acima com um volume pequeno de tráfego, você pode se cadastrar na APIYI, em apiyi.com, para obter créditos de teste. A plataforma oferece uma interface de API unificada, compatível com os formatos da OpenAI e da Anthropic. Basta alterar o base_url para direcionar o tráfego espelhado e fazer a comparação.
Cobertura de modelos e verificação de preços em serviços de agregação de APIs de IA
Ao escolher um serviço, confirme se os modelos necessários estão realmente disponíveis e se os critérios de cobrança são claros. A tabela abaixo apresenta alguns modelos disponíveis na APIYI e os preços unitários informados na página de preços. Todos os preços devem ser conferidos na página da APIYI: https://docs.apiyi.com/models. Consulte essa página para verificar as unidades de cobrança e as atualizações mais recentes; os valores deste artigo servem apenas como referência.
| ID do modelo | Casos de uso | Preço unitário de entrada / saída / cache (página de preços da APIYI) | Plataforma disponível |
|---|---|---|---|
| claude-opus-5-5 | Raciocínio complexo, programação com fluxos longos | $4 / $20 / $0.2 | APIYI apiyi.com |
| claude-sonnet-5-5 | Programação cotidiana, modelo principal para agentes | $2 / $10 / $0.1 | APIYI apiyi.com |
| kimi-k3.1-pro | Contexto longo, tarefas em chinês | $2 / $10 / $0.2 | APIYI apiyi.com |
| deepseek-v4.1-flash | Alta concorrência, processamento em lote de baixo custo | $0.3 / $1.2 / $0.006 | APIYI apiyi.com |
| gpt-image-2.6-flare / sunburst | Geração de imagens | Entrada de texto $5, entrada de imagem $8, saída $30 | APIYI apiyi.com |
| série qwen3.8 | Tarefas gerais em chinês | Consulte a página de preços | APIYI apiyi.com |
Vale destacar que, se sua operação depende da série ERNIE da Baidu, a APIYI ainda não disponibiliza esses modelos. Eles serão adicionados o mais rápido possível; até lá, mantenha sua forma atual de acesso. Faça essa mesma verificação ao avaliar qualquer serviço proxy de API: confirme, um a um, se os modelos realmente aparecem na tabela de preços. Não se deixe levar por afirmações genéricas como “suporte a centenas de modelos”.
💡 Dica de escolha: multiplique o preço unitário do cache pela taxa real de acertos no cache e some os custos de entrada e saída para chegar ao custo real. Na APIYI apiyi.com, teste modelos como Claude, Kimi e DeepSeek com o mesmo conjunto de requisições. Escolha pelo “menor custo que atende ao padrão de qualidade”, em vez de olhar apenas para o preço unitário.
Perguntas frequentes (FAQ)
Q1: O que é um serviço proxy e agregador de APIs de IA?
É uma camada de gateway entre sua aplicação e os fornecedores de modelos. Ela reúne os modelos de diferentes fornecedores em uma única interface e cuida da autenticação, do roteamento, da cobrança e da comutação em caso de falha. A vantagem é a integração simples e a flexibilidade para trocar de modelo; em contrapartida, há mais uma dependência cuja confiabilidade precisa ser avaliada.
Q2: Usar um serviço proxy de API de IA é sempre menos confiável do que acessar a API oficial diretamente?
Não necessariamente. Com acesso direto, você depende de um único fornecedor e não tem alternativa imediata caso ele apresente falhas ou limite suas requisições. Já um serviço proxy com redundância entre fornecedores pode fazer a troca automaticamente quando um deles apresenta problemas. A diferença está na qualidade da própria camada de proxy, então vale verificá-la usando os 10 indicadores deste artigo, sem partir de uma conclusão preconcebida.
Q3: Com que frequência devo revisar os indicadores de confiabilidade de um serviço proxy de API de IA?
Recomendamos uma validação completa de 7 dias antes de entrar em produção. Depois, confira mensalmente a taxa de erros, os percentis de latência e as divergências na cobrança. Sempre que a plataforma atualizar versões de modelos ou preços, ou quando seu tráfego crescer significativamente, execute novamente os testes de regressão funcional e de carga.
Q4: Quais cenários em produção exigem mais atenção à confiabilidade de um serviço agregador de APIs de IA?
Os principais são:
– **Conversas em tempo real com usuários finais**: o tempo até o primeiro token e a estabilidade do streaming afetam diretamente a experiência.
– **Agentes de programação e fluxos de trabalho automatizados**: se os campos de chamada de ferramentas forem alterados, todo o fluxo pode falhar.
– **Processamento de dados em lote**: as cotas de concorrência e a precisão da cobrança determinam se as tarefas serão concluídas no prazo e dentro do orçamento.
Q5: Como verificar rapidamente se um serviço proxy atende aos requisitos usando a API?
A maneira mais simples é começar com uma plataforma que ofereça suporte a vários modelos e fazer uma comparação com tráfego espelhado:
1. Acesse APIYI em apiyi.com, crie uma conta e obtenha créditos de teste
2. Defina base_url como `https://api.apiyi.com/v1` ou configure o formato Anthropic conforme a documentação em docs.apiyi.com
3. Copie uma pequena parte das requisições reais e compare a latência, a taxa de erros e as diferenças nas respostas
A APIYI oferece acesso via API aos modelos mencionados neste artigo, como Claude, Kimi, DeepSeek, GPT Image e Qwen, facilitando a comparação por meio de uma única interface.
Q6: Qual fonte devo consultar para verificar os preços de um serviço proxy?
Consulte a página oficial de preços da plataforma e salve uma captura de tela ou registre a data da consulta. No caso da APIYI, os preços de entrada, saída e cache de todos os modelos estão disponíveis em https://docs.apiyi.com/models. Valores publicados em blogs de terceiros servem apenas como referência para comparação, pois os critérios e as datas de atualização podem ser diferentes.
Q7: Quais são as limitações inevitáveis de um serviço proxy e agregador de APIs de IA?
Qualquer camada de proxy acrescenta alguma latência e mais um ponto de falha. Além disso, novos modelos geralmente chegam às plataformas proxy depois do lançamento oficial, e parâmetros específicos de alguns fornecedores podem levar tempo para ser adaptados. Para lidar com isso, mantenha o acesso direto à API oficial ou um segundo serviço como alternativa e prepare planos de degradação para operações críticas.
Principais pontos sobre a confiabilidade de serviços proxy de API para IA em produção
- A confiabilidade tem quatro dimensões: disponibilidade, desempenho, consistência e governabilidade. Não basta verificar se o serviço está fora do ar.
- Meça a latência nos horários de pico: o overhead adicional da camada de proxy é estável e mensurável; a variação nas filas durante os picos é a principal causa de incidentes.
- Fique atento à substituição de modelos: confira o campo model e execute testes de regressão com um conjunto fixo de perguntas para evitar degradações silenciosas.
- O faturamento também faz parte da confiabilidade: anomalias na cobrança costumam indicar falhas de cache ou uma avalanche de novas tentativas. Faça a conciliação regularmente.
- Teste a compatibilidade item por item: valide streaming, chamadas de ferramentas e campos de cache com requisições reais; não basta executar um Hello World.
- Valide com tráfego espelhado por 7 dias: compare os resultados com uma pequena parcela do tráfego, em vez de decidir por intuição.
- Como começar: use a interface unificada da APIYI em apiyi.com para comparar vários modelos. Consulte a página de preços para obter os valores atualizados.
Conclusão
Ao escolher um serviço proxy de API ou agregador de APIs de IA para produção, os pontos principais se resumem a três:
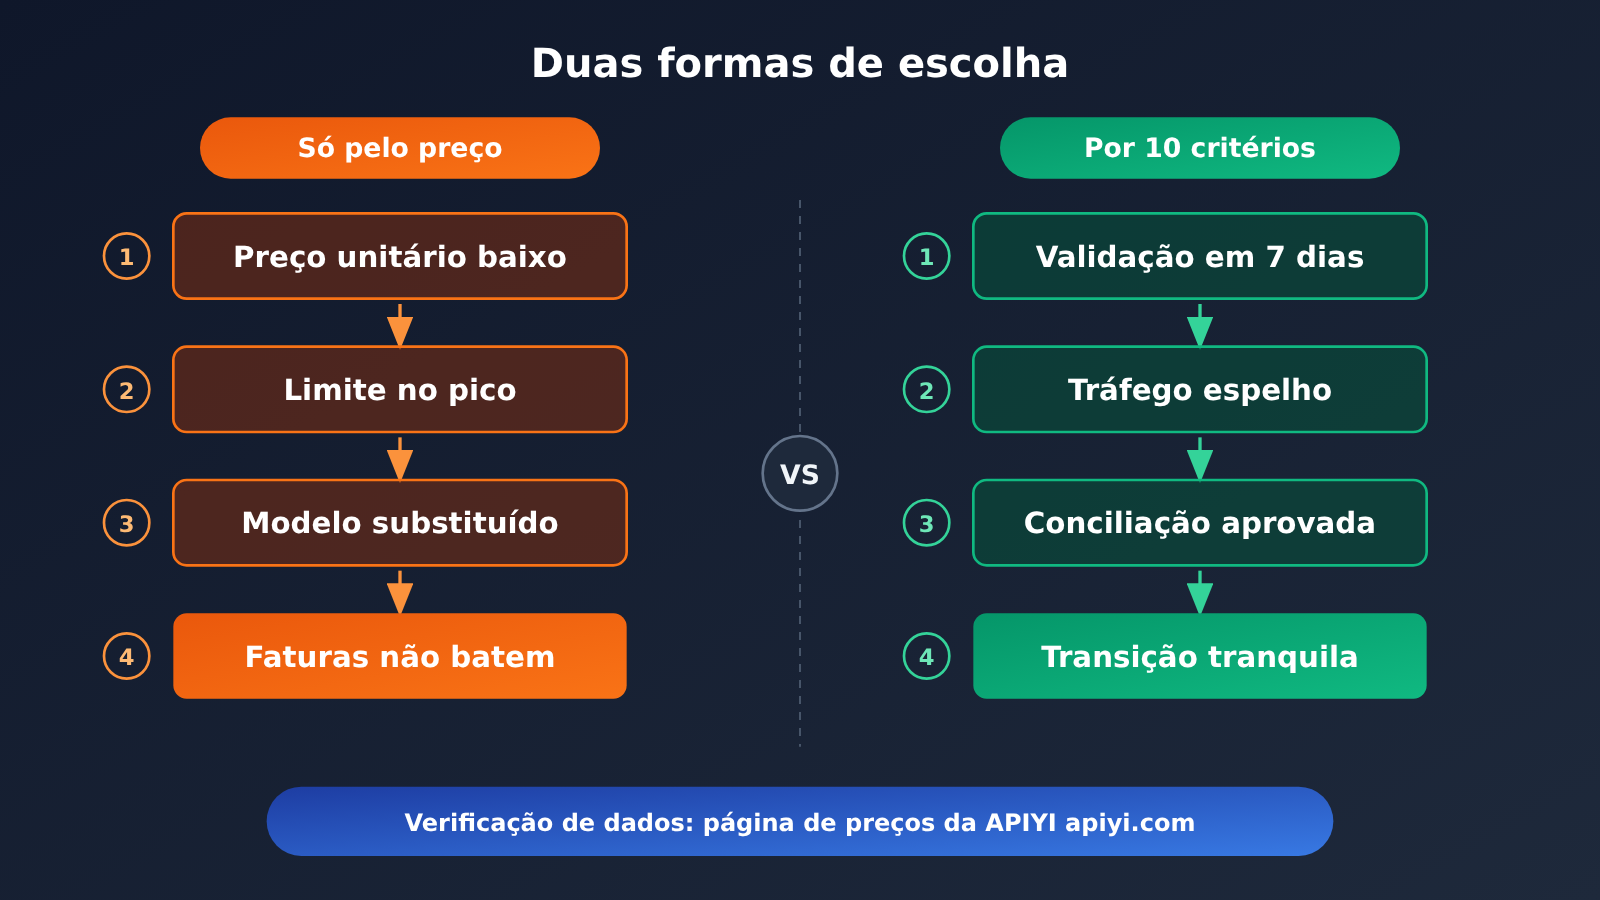
- Defina as métricas antes de comparar preços: use as 10 métricas de confiabilidade para eliminar plataformas inadequadas e, depois, compare os custos das aprovadas.
- Use dados em vez de promessas: siga o processo de validação de 7 dias para obter dados de latência, taxa de erros e faturamento nas condições reais do seu negócio.
- Tenha sempre um plano B: qualquer rota pode apresentar problemas. Canais alternativos e planos de contingência são essenciais em produção.
Se você está pensando em adicionar um gateway de API de IA ao seu serviço em produção, use a tabela de avaliação deste artigo para fazer uma primeira validação com uma pequena parcela do tráfego. Uma opção é testar rapidamente com a APIYI em apiyi.com. A plataforma é compatível com os formatos de API da OpenAI e da Anthropic; você pode consultar os modelos e preços diretamente em https://docs.apiyi.com/models e encontrar os detalhes de integração na central de documentação, em docs.apiyi.com.
📚 Referências
- Página de preços da APIYI: lista de modelos e preços unitários de entrada, saída e cache
- Link:
docs.apiyi.com/models -
Descrição: fonte de todos os preços da APIYI apresentados neste artigo
-
Central de documentação da APIYI: instruções de integração nos formatos OpenAI e Anthropic
- Link:
docs.apiyi.com -
Descrição: inclui configuração de base_url, IDs de modelos e perguntas frequentes
-
Blog Ofox.ai: avaliação da confiabilidade do OpenRouter em produção e reportagem sobre problemas de cobrança do Claude
- Link:
ofox.ai/blog/page/39 -
Descrição: fonte dos dados de terceiros sobre número de falhas, latência adicional e taxas citados no artigo, usados apenas para comparação
-
Blog Ofox.ai: reportagem sobre limitação de requisições do Claude em horários de pico e problemas de cobrança de cache
- Link:
ofox.ai/blog/page/36 - Descrição: citada apenas para comparação, para mostrar a importância de conferir a cobrança
Autor: equipe técnica da APIYI
Troca de experiências: entre em contato conosco pela página inicial da APIYI em apiyi.com para conversar sobre a escolha de gateways de API de IA. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com


