
Nota do autor: A partir da notícia de que a Apple reduziu o orçamento diário de tokens dos engenheiros de US$ 300 para US$ 200, este artigo explica quatro mecanismos para ajudar empresas a gerenciar os custos de uso de IA: faixas de orçamento, aprovação de exceções, divisão de modelos por nível e monitoramento de uso.
Segundo a Bloomberg, a Apple reduziu no mês passado o orçamento diário de tokens de alguns engenheiros de US$ 300 para US$ 200. A empresa também planeja baixá-lo para US$ 100 por dia, enquanto algumas equipes não técnicas podem ficar com apenas US$ 25. Funcionários que precisarem de mais recursos poderão solicitar uma exceção à gestão, e algumas equipes também serão direcionadas a modelos mais baratos ou a soluções locais de IA executadas no próprio dispositivo.
Não é apenas um rumor. Em 5 de novembro de 2026, o The Decoder divulgou esses números citando a reportagem da Bloomberg e destacou que Microsoft, Tesla, Uber e Meta também estabeleceram recentemente limites para os gastos internos com IA. A mudança das grandes empresas de um uso sem restrições para um uso dentro do orçamento mostra que os custos de invocação de modelos de IA já são uma questão que a gestão precisa enfrentar.
O que você vai aprender: ao ler este artigo, você entenderá como a Apple está restringindo o orçamento de tokens e terá acesso a uma estrutura pronta para gerenciar os custos de uso de IA na sua empresa, com faixas de orçamento, aprovação de exceções, divisão de modelos por nível e monitoramento de uso.
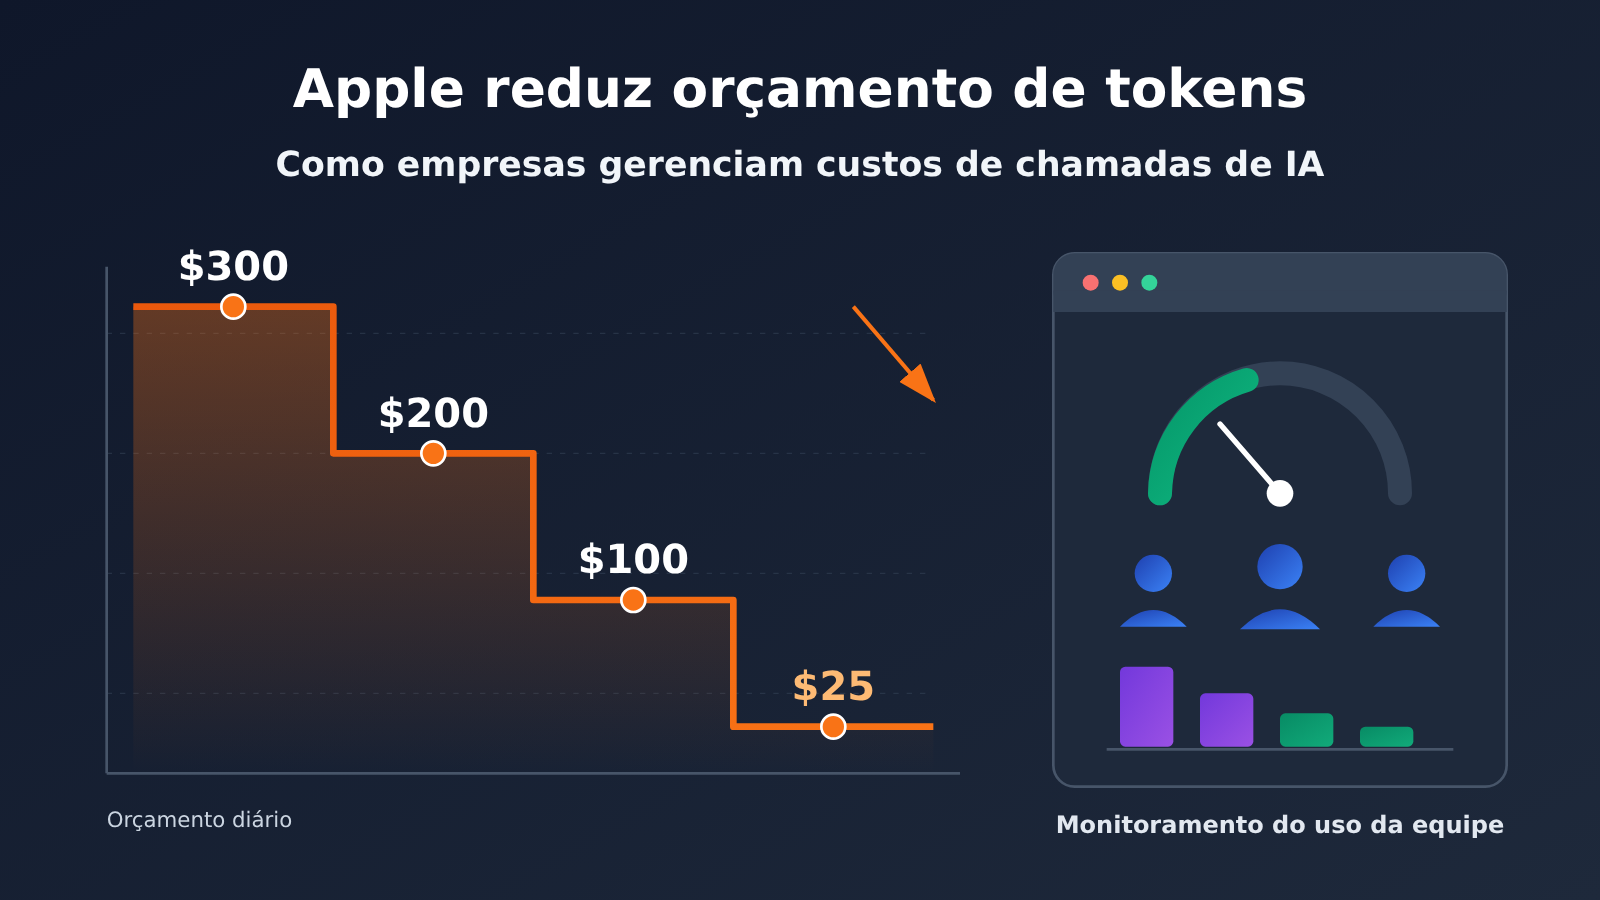
Apple reduz orçamento de tokens: resumo das principais informações
| Item | Detalhes |
|---|---|
| Fonte | Reportagem da Bloomberg, repercutida pelo The Decoder em 05/11/2026 |
| Quem é afetado | Parte dos engenheiros e de equipes não técnicas |
| Ajuste já implementado | No mês passado, o orçamento diário de tokens caiu de US$ 300 para US$ 200 |
| Próximos planos | Pode cair para US$ 100 por dia e, em algumas equipes não técnicas, para até US$ 25 |
| Tratamento de gastos acima do limite | Funcionários podem solicitar uma exceção à gestão |
| Modelos disponíveis | Anthropic Claude, OpenAI ChatGPT, Google Gemini, entre outros |
| Alternativas | Algumas equipes estão migrando para modelos mais baratos ou IA local executada no dispositivo |
| Contexto | O novo CEO, John Ternus, está promovendo uma estrutura mais enxuta; as despesas com pesquisa e desenvolvimento cresceram 32% no ano fiscal de 2026, principalmente devido aos custos de infraestrutura e IA |
| Movimento no setor | Microsoft, Tesla, Uber e Meta também limitaram recentemente os gastos internos com IA |
Três detalhes sobre o ajuste no orçamento de tokens da Apple
O primeiro detalhe é que o orçamento é calculado por dia e por pessoa. Em vez de definir apenas um orçamento anual para cada departamento, a Apple estabeleceu uma cota “por pessoa, por dia”. Isso permite que cada funcionário perceba diretamente o custo de usar IA e facilita a distribuição de recursos pela gestão de acordo com cada função.
O segundo detalhe é que as equipes técnicas e não técnicas têm cotas diferentes. A meta para engenheiros é de cerca de US$ 100, enquanto algumas equipes não técnicas podem ter apenas US$ 25: uma diferença de quatro vezes. Isso indica que a Apple considera o consumo de tokens em tarefas como escrever código e executar agentes de IA muito maior do que em atividades como redigir e-mails e fazer resumos.
O terceiro detalhe é que o limite não é inflexível. Os funcionários podem solicitar exceções, e algumas equipes são orientadas a usar modelos mais baratos ou locais. A ideia central não é “usar menos IA”, mas “reservar o poder computacional mais caro para as tarefas que justificam o custo”. A reportagem, porém, não revelou como a Apple classifica os modelos em faixas nem como aplica os limites. Esses detalhes ainda dependem de novas informações.
Por que o custo de uso de IA leva grandes empresas a restringir o orçamento de tokens
A maior diferença entre o custo de uso de IA e uma assinatura de software tradicional é que a IA é cobrada por consumo e tem um custo marginal diferente de zero. Se um funcionário abrir a mesma ferramenta SaaS 100 vezes por dia, o valor não muda. Mas, se ele pedir a um Modelo de Linguagem Grande que leia 100 documentos longos por dia, cada leitura gera um custo real em tokens. Quando esse uso se estende a dezenas de milhares de pessoas, a despesa cresce rapidamente.
Os gastos da Apple com pesquisa e desenvolvimento cresceram 32% no ano fiscal de 2026. Segundo as reportagens, um dos fatores foi o aumento dos custos de infraestrutura e IA. Com o novo CEO impulsionando medidas de enxugamento, os gastos internos com IA se tornam uma rubrica fácil de quantificar e ajustar. O fato de empresas como Microsoft, Tesla, Uber e Meta também terem imposto limites no mesmo período mostra que essa não é uma decisão isolada.
Pelas reações internas, alguns funcionários consideravam que os limites anteriores já eram generosos demais: para a maioria dos cargos, seria difícil consumir o teto diário de 300 dólares. Isso revela um problema comum: muitas empresas definem limites sem fazer uma estimativa inicial ao começar a adotar IA. Quando decidem restringi-los mais tarde, a mudança pode gerar controvérsia.
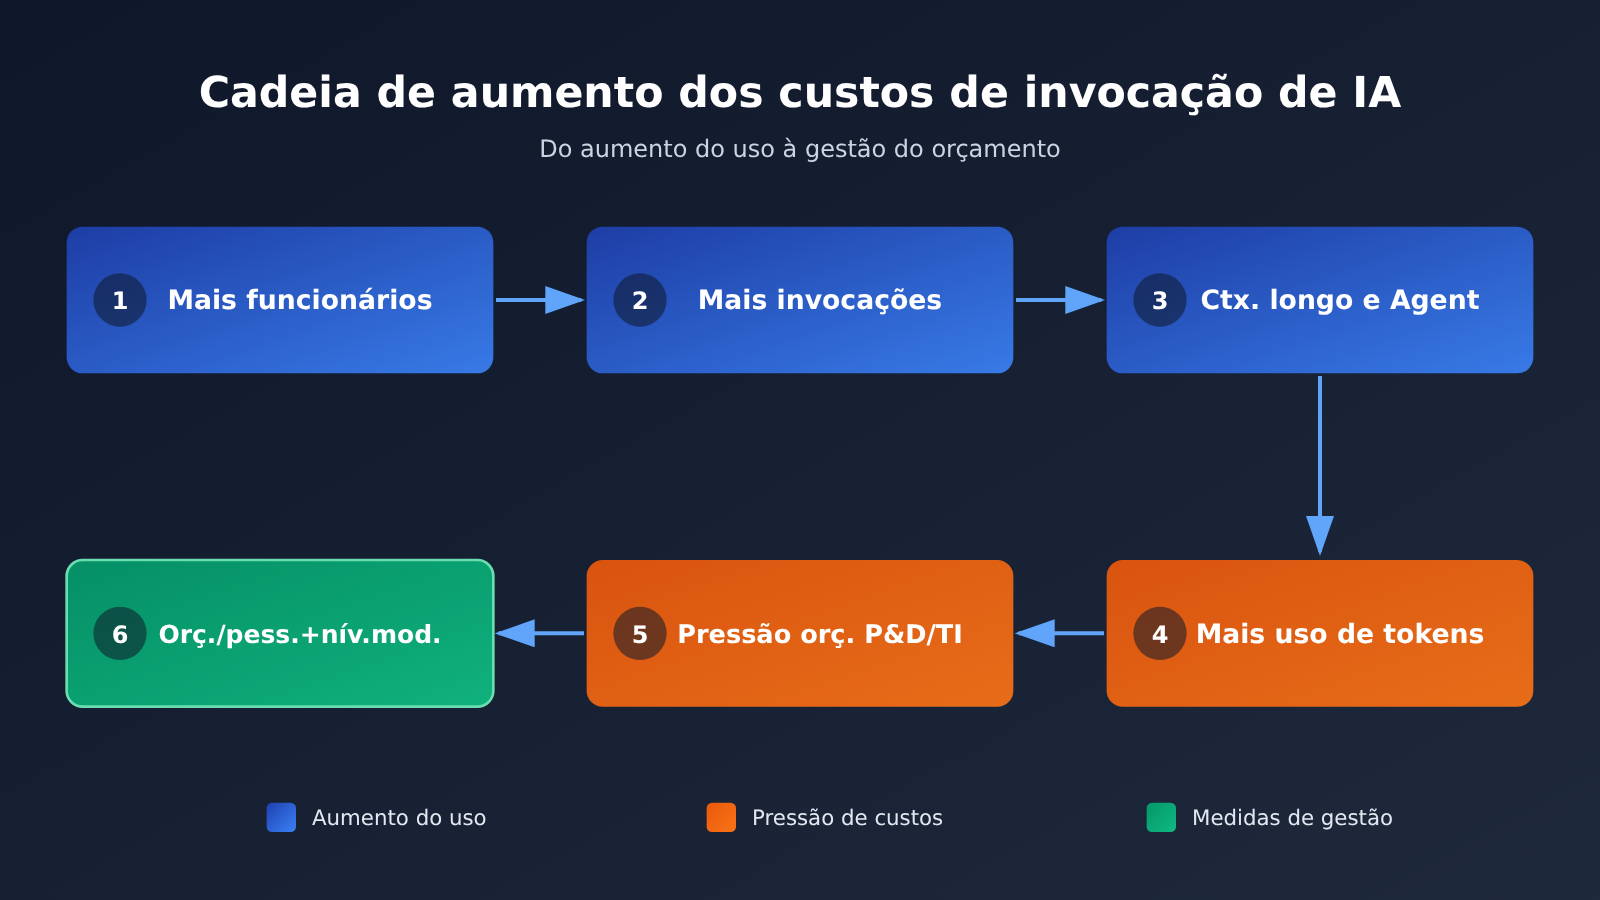
4 mecanismos para gerenciar os custos de uso de IA em equipes corporativas
Ao analisar a abordagem da Apple, podemos identificar 4 mecanismos de gestão reaproveitáveis. Eles funcionam em conjunto: o orçamento define os limites, a aprovação garante flexibilidade, a divisão por níveis reduz custos e o monitoramento assegura a execução.
Mecanismo 1: definir orçamentos de tokens por função
O segredo do orçamento individual está em separar os usuários por nível, não em distribuir o mesmo valor para todos. Cada função usa IA de um jeito. Aplicar um único limite pode deixar os engenheiros sem recursos suficientes ou manter boa parte da cota de usuários ocasionais ociosa. A tabela abaixo traz um exemplo inspirado na abordagem da Apple; os valores devem ser calculados com base no histórico de uso da sua equipe.
| Nível por função | Tarefas típicas | Abordagem de orçamento | Categoria padrão de modelo |
|---|---|---|---|
| Desenvolvimento principal | Geração de código, programação com agentes, análise de documentos longos | Cota alta, calculada por dia, com possibilidade de solicitar exceções | Modelo de ponta + modelo intermediário |
| Funções técnicas gerais | Revisão de código, criação de scripts, documentação técnica | Cota intermediária, próxima à prevista para engenheiros no plano da Apple | Principalmente modelos intermediários |
| Funções não técnicas | E-mails, resumos, tradução, organização de informações | Cota baixa, tomando como referência o nível da Apple que chega a US$ 25 | Principalmente modelos leves |
| Projetos-piloto / novos projetos | Validação exploratória | Cota temporária específica, com data de encerramento | Conforme a necessidade |
Para definir os níveis, comece levantando o uso real dos últimos 1 a 3 meses. Analise a mediana e os volumes mais altos de uso em cada função e, depois, estabeleça o orçamento acima da mediana e abaixo desses valores mais altos. Assim, a maioria terá recursos suficientes no dia a dia, enquanto os poucos usuários intensivos poderão recorrer ao processo de exceção, mantendo baixo o custo de gestão.
Mecanismo 2: aprovação de exceções, em vez de uma regra única para todos
A Apple permite que funcionários que ultrapassem o limite solicitem uma exceção à gestão — uma prática que vale a pena considerar. Um teto rígido demais pode interromper tarefas importantes, enquanto a ausência de limites tira o sentido do orçamento. Ao criar um processo de aprovação de exceções, considere:
- Definir condições claras: por exemplo, quando o limite diário se esgotar ou quando um projeto exigir chamadas intensivas por vários dias consecutivos;
- Limitar o prazo da aprovação: conceda a cota extra por dia ou por projeto, com expiração automática, para evitar que o “temporário” vire “permanente”;
- Pedir uma justificativa breve: registre o tipo de tarefa e o resultado esperado para avaliar depois se o custo das chamadas de IA valeu a pena;
- Revisar os pedidos mensalmente: se uma pessoa ou equipe solicita exceções com frequência, o orçamento básico pode estar baixo demais. Nesse caso, ajuste a categoria em vez de continuar aprovando pedidos.
Mecanismo 3: categorias de modelos e mudança automática para uma categoria inferior
A reportagem menciona que a Apple direcionará algumas equipes para modelos mais baratos ou para IA local, executada no dispositivo. Por trás dessa decisão está uma das formas mais eficazes de reduzir o custo das chamadas de IA: escolher o modelo de acordo com a dificuldade da tarefa. Modelos leves dão conta de muitas tarefas do dia a dia; apenas algumas tarefas complexas realmente precisam de modelos de ponta.
| Categoria de modelo | Tarefas adequadas | Características de custo | Plataformas disponíveis |
|---|---|---|---|
| Modelos de ponta (como versões avançadas do Claude, GPT e Gemini) | Raciocínio complexo, alterações de código em vários arquivos, análise para decisões importantes | Maior custo unitário; usar conforme a necessidade | APIYI apiyi.com, APIs oficiais dos provedores |
| Modelos intermediários | Programação rotineira, redação técnica, extração estruturada | Equilíbrio entre qualidade e custo | APIYI, APIs oficiais dos provedores |
| Modelos leves | Resumos, tradução, classificação, formatação | Baixo custo unitário, adequado para chamadas frequentes | APIYI, APIs oficiais dos provedores |
| Modelos no dispositivo / locais | Tarefas sensíveis à privacidade, uso offline, preenchimento simples | Sem cobrança por uso, mas com custos de hardware e manutenção | Implantação local |
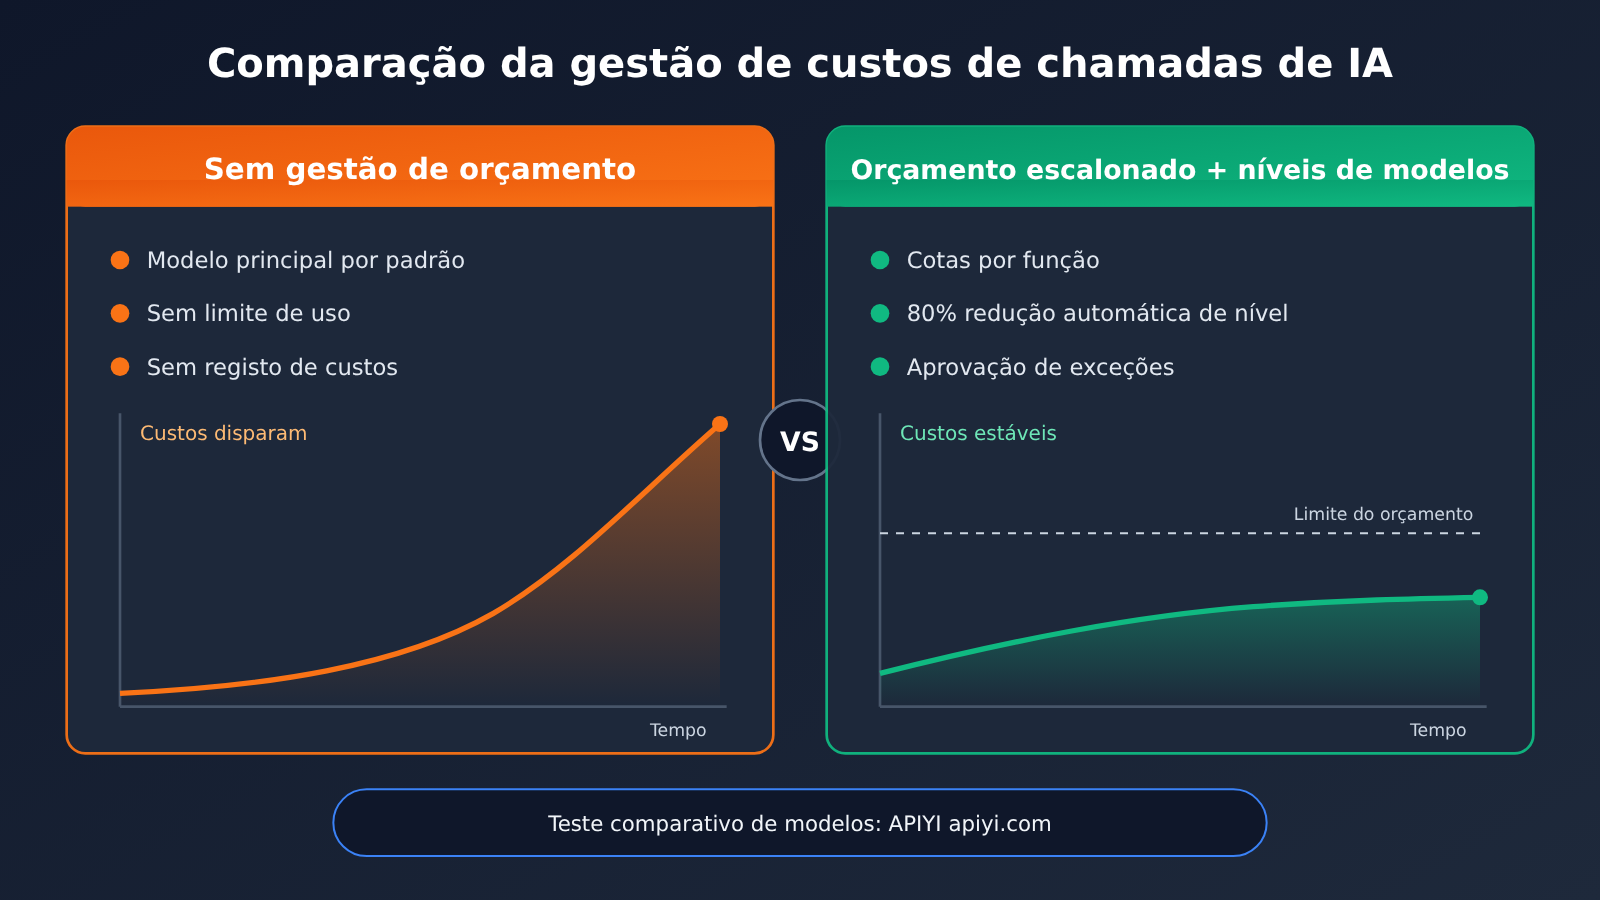
Uma regra comum para a mudança automática é trocar tarefas não críticas para a categoria de modelo seguinte quando o uso atingir uma parte do orçamento, como 80%. Quando a cota se esgotar, apenas os modelos leves continuam disponíveis, ou o usuário pode solicitar uma exceção. Assim, os funcionários não ficam sem acesso de repente e a experiência de trabalho é mais fluida. A diferença real de preços entre os modelos depende das tarifas vigentes em cada plataforma, então vale fazer as contas antes de implementar a estratégia.
💡 Dica de escolha: para distribuir tarefas entre categorias de modelos, é importante conseguir alternar facilmente entre provedores. Com uma plataforma agregadora como a APIYI apiyi.com, uma única chave API permite chamar modelos como OpenAI, Claude e Gemini. A interface é compatível com o formato da OpenAI, então basta alterar o parâmetro
modelpara rotear as tarefas entre as categorias.
Mecanismo 4: monitoramento de uso para colocar o orçamento em prática
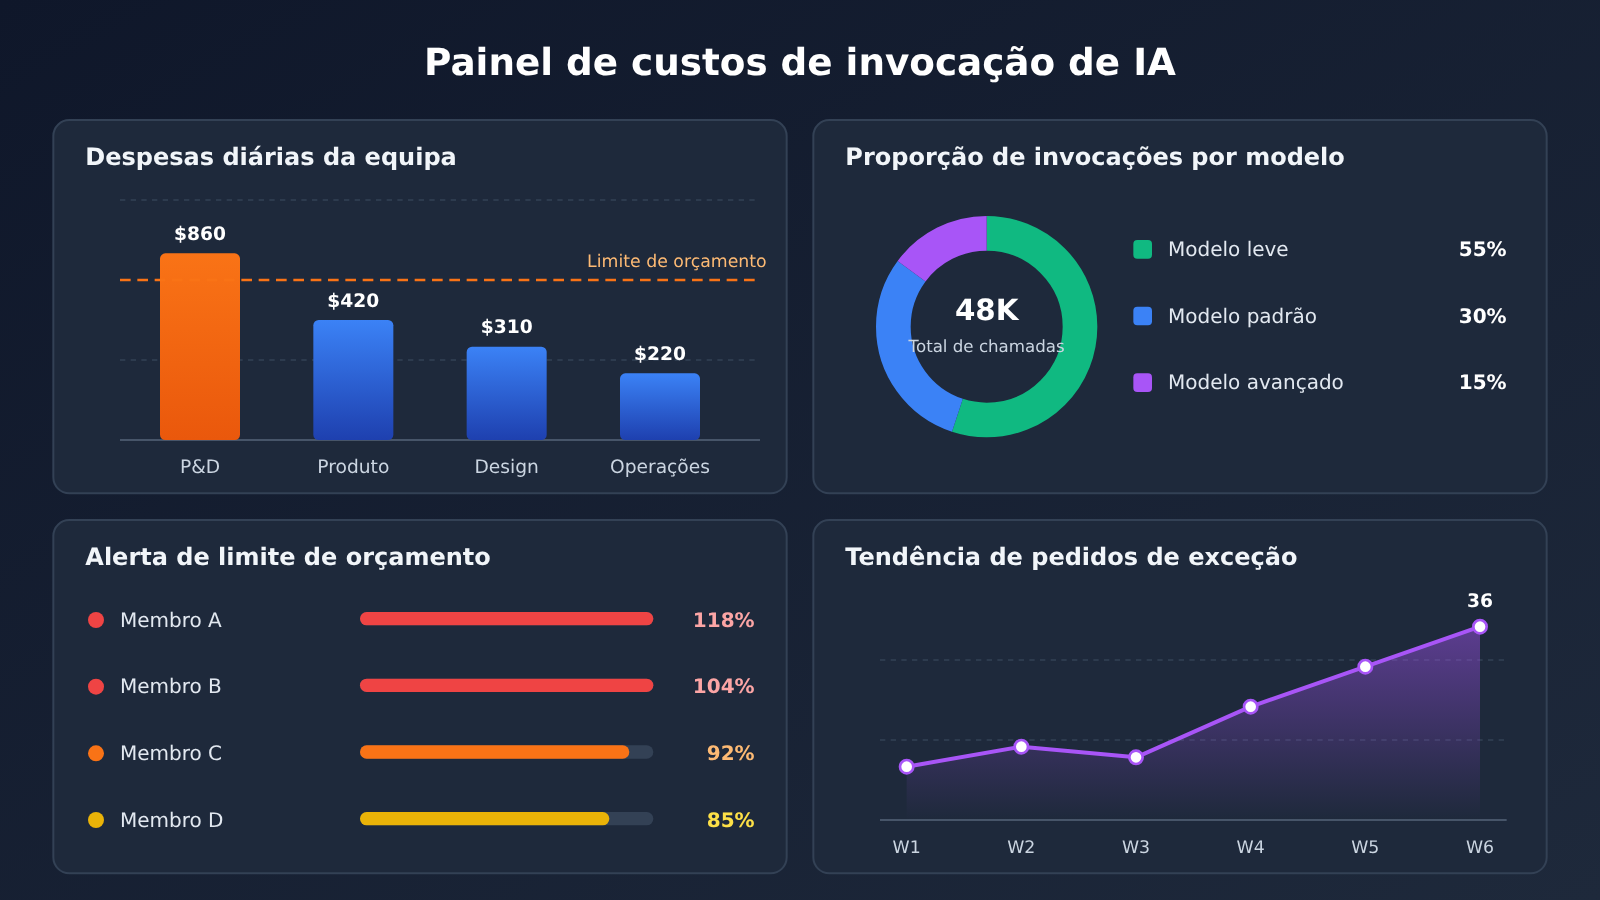
Sem monitoramento, o orçamento de tokens por pessoa é apenas uma regra no papel. Monitorar não serve apenas para identificar gastos acima do limite: o mais importante é fornecer dados para definir as faixas de orçamento e de modelos. Vale acompanhar pelo menos estes indicadores:
| Indicador | Nível de detalhamento | Finalidade |
|---|---|---|
| Consumo diário de tokens e custos | Por pessoa e por equipe | Avaliar se o orçamento é adequado e identificar chamadas anormais |
| Proporção de chamadas por modelo | Por equipe e por tipo de tarefa | Avaliar se a estratégia de níveis está funcionando |
| Frequência com que o limite do orçamento é atingido | Por pessoa e por semana | Identificar funções que precisam mudar de faixa |
| Número de solicitações de exceção e taxa de aprovação | Por equipe e por mês | Avaliar se o processo de aprovação está flexível ou rígido demais |
| Custo médio por tarefa | Por tipo de tarefa | Identificar os cenários de alto custo que mais merecem otimização |
Na prática, é possível registrar o campo usage de cada requisição na camada de gateway de IA da empresa e consolidar os dados por meio de tags de funcionários ou equipes. Se você usa uma plataforma de terceiros, confira se o nível de detalhamento das estatísticas de uso atende às suas necessidades de rateio. O suporte a subcontas, limites por membro e alertas depende dos recursos oferecidos pela plataforma.
Controle de custos de chamadas de IA: primeiros passos com roteamento baseado no orçamento
O exemplo simplificado abaixo mostra como implementar “orçamento por pessoa + troca automática por um modelo mais econômico”. Começamos com uma chamada básica, prestando atenção ao uso de tokens retornado em cada requisição:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI: uma chave para acessar modelos de vários fornecedores
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Priorize um modelo leve para tarefas cotidianas
    messages=[{"role": "user", "content": "把这段会议纪要整理成 5 条要点:..."}]
)
print(resp.choices[0].message.content)
print("本次消耗 tokens:", resp.usage.total_tokens)
Veja a implementação completa: orçamento por função + roteamento com troca automática
from collections import defaultdict
from datetime import date
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Níveis de modelos: substitua pelos nomes disponíveis na plataforma
TIERS = ["your-premium-model", "your-standard-model", "your-light-model"]

# Preços provisórios (dólares / milhão de tokens): preencha conforme os preços atuais da plataforma
PRICE = {
    "your-premium-model":  {"in": 0.0, "out": 0.0},
    "your-standard-model": {"in": 0.0, "out": 0.0},
    "your-light-model":    {"in": 0.0, "out": 0.0},
}

# Orçamento diário por função (dólares), inspirado na abordagem de níveis da Apple
DAILY_BUDGET = {"engineer": 100, "non_tech": 25}

spent = defaultdict(float)   # (user, date) -> valor gasto no dia
exceptions = set()           # (user, date) com exceção aprovada


def pick_model(user: str, role: str, preferred: str) -> str:
    key = (user, date.today())
    budget = DAILY_BUDGET[role]
    used = spent[key]
    if key in exceptions:
        return preferred
    if used >= budget:
        return TIERS[-1]                      # Orçamento esgotado: manter apenas o modelo leve
    if used >= budget * 0.8:
        idx = min(TIERS.index(preferred) + 1, len(TIERS) - 1)
        return TIERS[idx]                     # Perto do limite: descer um nível
    return preferred


def chat(user: str, role: str, prompt: str, preferred: str = "your-standard-model"):
    model = pick_model(user, role, preferred)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    p = PRICE[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    spent[(user, date.today())] += cost
    print(f"[{user}] model={model} cost=${cost:.4f} today=${spent[(user, date.today())]:.2f}")
    return resp.choices[0].message.content


# Exemplo de uso
print(chat("alice", "non_tech", "把这封邮件翻译成英文:..."))
Este exemplo não inclui armazenamento persistente, concorrência nem fluxo de aprovação. Em produção, é recomendável colocar spent em um banco de dados ou cache e integrar a aprovação de exceções ao sistema interno de chamados. A ideia central continua a mesma: registrar o custo de cada chamada e consultar o orçamento antes de escolher o modelo.
🚀 Comece rapidamente: para testar o roteamento por níveis, você pode obter créditos gratuitos para novos usuários na APIYI, em apiyi.com. Use a mesma chave para comparar a qualidade e o consumo de modelos de diferentes níveis nas suas tarefas reais e, depois, defina o modelo padrão para cada função.
Análise do impacto do ajuste no orçamento de tokens da Apple
Impacto para desenvolvedores
- Consciência de custos vira uma habilidade essencial: em grandes empresas, desenvolvedores precisam acompanhar quantos tokens cada tarefa consome e moderar o uso de operações mais caras, como contextos longos e tentativas repetidas.
- A capacidade de trabalhar com vários modelos ganha importância: quem sabe escolher o modelo adequado para cada tarefa e delegar tarefas simples a modelos leves ou locais tende a trabalhar com mais eficiência quando o orçamento aperta.
- Aumenta a demanda por gateways de IA e camadas de roteamento: as empresas precisam de um ponto de acesso unificado para registrar gastos, aplicar limites e fazer a troca para modelos mais econômicos. Com isso, haverá mais trabalho no desenvolvimento dessa infraestrutura interna.
Impacto para gestores
- De “incentivar o uso” para “gerenciar com mais precisão”: os custos de invocação de IA passam a fazer parte da gestão orçamentária habitual e precisam ser alocados e revisados, assim como os recursos de nuvem.
- Os valores do orçamento precisam ter fundamento: funcionários da Apple consideravam a cota anterior “generosa demais”, o que mostra que definir limites sem uma base concreta pode gerar custos de ajuste mais tarde.
- O risco na comunicação com a equipe não pode ser ignorado: segundo a reportagem, alguns funcionários temem que o corte de custos seja um sinal de futuras demissões. Se a redução do orçamento não for bem explicada, ela pode ser interpretada como indício de mudanças maiores na organização.
A tabela abaixo reúne riscos organizacionais comuns na implementação de controles de custos de invocação de IA e possíveis formas de lidar com eles:
| Risco | Como se manifesta | Possível resposta |
|---|---|---|
| Ansiedade dos funcionários | Os limites são interpretados como sinal de demissões | Explicar antecipadamente que o objetivo é otimizar a estrutura de custos e divulgar os critérios de alocação por nível |
| Queda de produtividade | Tarefas importantes são interrompidas por falta de cota | Configurar a troca automática para um modelo mais econômico em vez de cortar o acesso e oferecer um canal rápido para exceções |
| Gastos excessivos ocultos | Funcionários passam a usar contas pessoais ou ferramentas não aprovadas | Garantir que os canais internos sejam suficientes e fáceis de usar, em linha com os requisitos de conformidade |
| Sobrecarga de aprovações | Pedidos de exceção se acumulam e gestores passam muito tempo aprovando solicitações | Aumentar periodicamente as cotas básicas com base nos dados para reduzir pedidos desnecessários |
| Dificuldade de avaliar os resultados | Apenas os gastos são considerados, sem avaliar as entregas | Revisar o custo por tarefa junto com a qualidade do resultado |
Perguntas frequentes (FAQ)
Q1: De quanto foi a redução no orçamento de tokens da Apple?
Segundo a Bloomberg, a Apple reduziu no mês passado o orçamento diário de tokens de alguns engenheiros de US$ 300 para US$ 200. O valor pode cair para US$ 100 por dia, enquanto algumas equipes não técnicas têm um limite de apenas US$ 25. Funcionários que precisam de mais recursos podem solicitar uma exceção à gestão.
Q2: Como definir um orçamento razoável de tokens por pessoa?
Comece levantando o consumo real de cada função nos últimos 1 a 3 meses. Depois, crie faixas por perfil e defina o orçamento básico acima do consumo mediano, mas abaixo dos níveis mais altos. Usuários intensivos podem receber cotas adicionais por meio de aprovação de exceções. Ajuste as faixas mensalmente, de acordo com a frequência com que os limites são atingidos e o número de exceções.
Q3: Além da Apple, quais empresas estão limitando os gastos internos com IA?
A reportagem menciona que Microsoft, Tesla, Uber e Meta também estabeleceram limites para gastos internos com IA recentemente, mas não revelou como essas empresas aplicam os limites nem quais são os valores.
Q4: A divisão dos modelos em níveis pode afetar a qualidade do trabalho dos funcionários?
O segredo é escolher o modelo de acordo com a tarefa, em vez de usar modelos menos capazes para tudo. Modelos leves geralmente são suficientes para resumos, traduções e formatação; raciocínio complexo e alterações críticas no código podem ficar com os modelos mais avançados. Antes de implementar a divisão, compare os resultados em tarefas reais. Por exemplo, na APIYI apiyi.com, você pode usar a mesma chave para testar modelos de diferentes níveis e confirmar que a qualidade é aceitável antes de definir o nível padrão.
Q5: Como equipes pequenas e médias sem um gateway interno de IA podem começar a gerenciar os custos de chamadas de IA?
Comece com três passos: unifique o ponto de acesso às chamadas, registre o `usage` de cada requisição no código e defina um modelo padrão para cada tipo de tarefa. Com uma plataforma agregadora como a APIYI apiyi.com, é possível alternar entre modelos da OpenAI, Claude e Gemini com uma única chave e pagar pelo consumo, o que facilita a implementação inicial do roteamento entre modelos. Para saber se a plataforma permite definir cotas ou alertas por membro, confirme diretamente com ela.
Principais pontos sobre gestão de custos de uso de IA
- A Apple reduziu o orçamento: o limite diário de tokens para engenheiros caiu de US$ 300 para US$ 200, com planos de novas reduções.
- Faixas são melhores que uma média única: o consumo varia muito entre funções técnicas e não técnicas; na Apple, a diferença entre as faixas planejadas chega a quatro vezes.
- Aprovações de exceção garantem flexibilidade: o limite não é definitivo; tarefas críticas podem receber uma cota temporária.
- Usar modelos em camadas reduz custos: deixe tarefas rotineiras para modelos leves ou locais e reserve os modelos de ponta para tarefas complexas.
- O monitoramento coloca o orçamento em prática: registre tokens e custos por pessoa e por equipe para ajustar as faixas com base em dados.
- A comunicação interna é indispensável: cortes no orçamento podem gerar receio de demissões, por isso é importante explicar o objetivo com antecedência.
- Comece testando o roteamento: com a APIYI apiyi.com, é possível comparar modelos de diferentes categorias usando uma única chave e validar a estratégia de camadas.
Conclusão
A redução do orçamento diário de tokens dos funcionários da Apple é um sinal claro de que o uso de IA nas grandes empresas está deixando a fase de “expansão em escala” e entrando na de “análise detalhada de custos”. Para as equipes, a lição se resume a três pontos:
- Defina faixas de orçamento: estabeleça cotas por pessoa conforme a função e o tipo de tarefa, usando dados históricos em vez de intuição;
- Mantenha o processo flexível: combine aprovações de exceção com a troca automática para modelos mais econômicos, evitando que um bloqueio rígido prejudique trabalhos críticos;
- Organize os modelos em camadas: escolha o modelo adequado para cada tarefa e acompanhe o consumo para otimizar a estratégia continuamente.
Se sua equipe está planejando a gestão dos custos de uso de IA, vale começar com um projeto-piloto em um ou dois cenários frequentes. Com dados reais de custo e qualidade em mãos, fica mais fácil expandir a estratégia. A APIYI apiyi.com é uma opção para montar rapidamente um ambiente de testes com vários modelos; a cota gratuita para novos usuários é suficiente para uma comparação inicial.
📚 Referências
- Apple slashes internal AI budgets, with deeper cuts still planned: cobertura do The Decoder sobre a reportagem da Bloomberg
- Link:
the-decoder.com/apple-slashes-internal-ai-budgets-with-deeper-cuts-still-planned/ - Descrição: inclui números sobre os ajustes no orçamento diário de tokens da Apple, reações dos funcionários e informações sobre os limites de gastos com IA em outras empresas
Autor: Equipe técnica da APIYI
Discussões técnicas: entre em contato conosco pela página inicial do site da APIYI para conversar sobre gestão de custos de invocação de IA nas empresas e práticas de integração com múltiplos modelos.


