
Google은 2026-11-11 개발자 블로그에서 아주 구체적인 사용 사례를 공개했어요. Gemini Notebook이 Decisions API를 실시간 라우터로 사용해서, 요청이 들어오는 순간 일상적인 질문을 적합한 모델 티어와 사고(thinking) 티어로 분배한다는 내용이에요. 일상 쿼리의 지연 시간이 최대 40% 줄었다고 하는데, 이 수치는 어디까지나 Google이 직접 밝힌 수치예요. 제3자의 부하 테스트 결과도 아니고, 특정 플랫폼이 실측한 결론도 아니라는 점을 기억해 두세요.
이건 또 하나의 모델 성능 업그레이드가 아니에요. “어떤 모델을 쓸지 고르는” 일이 개발자의 코드 안에서 요청 경로 위로 옮겨 온 거예요.
핵심 가치: 3분 안에 gemini-decision-1이 무엇인지, 어떻게 과금되는지, 그리고 여러분의 호출 체인에 어떤 의미가 있는지 파악해 보세요.
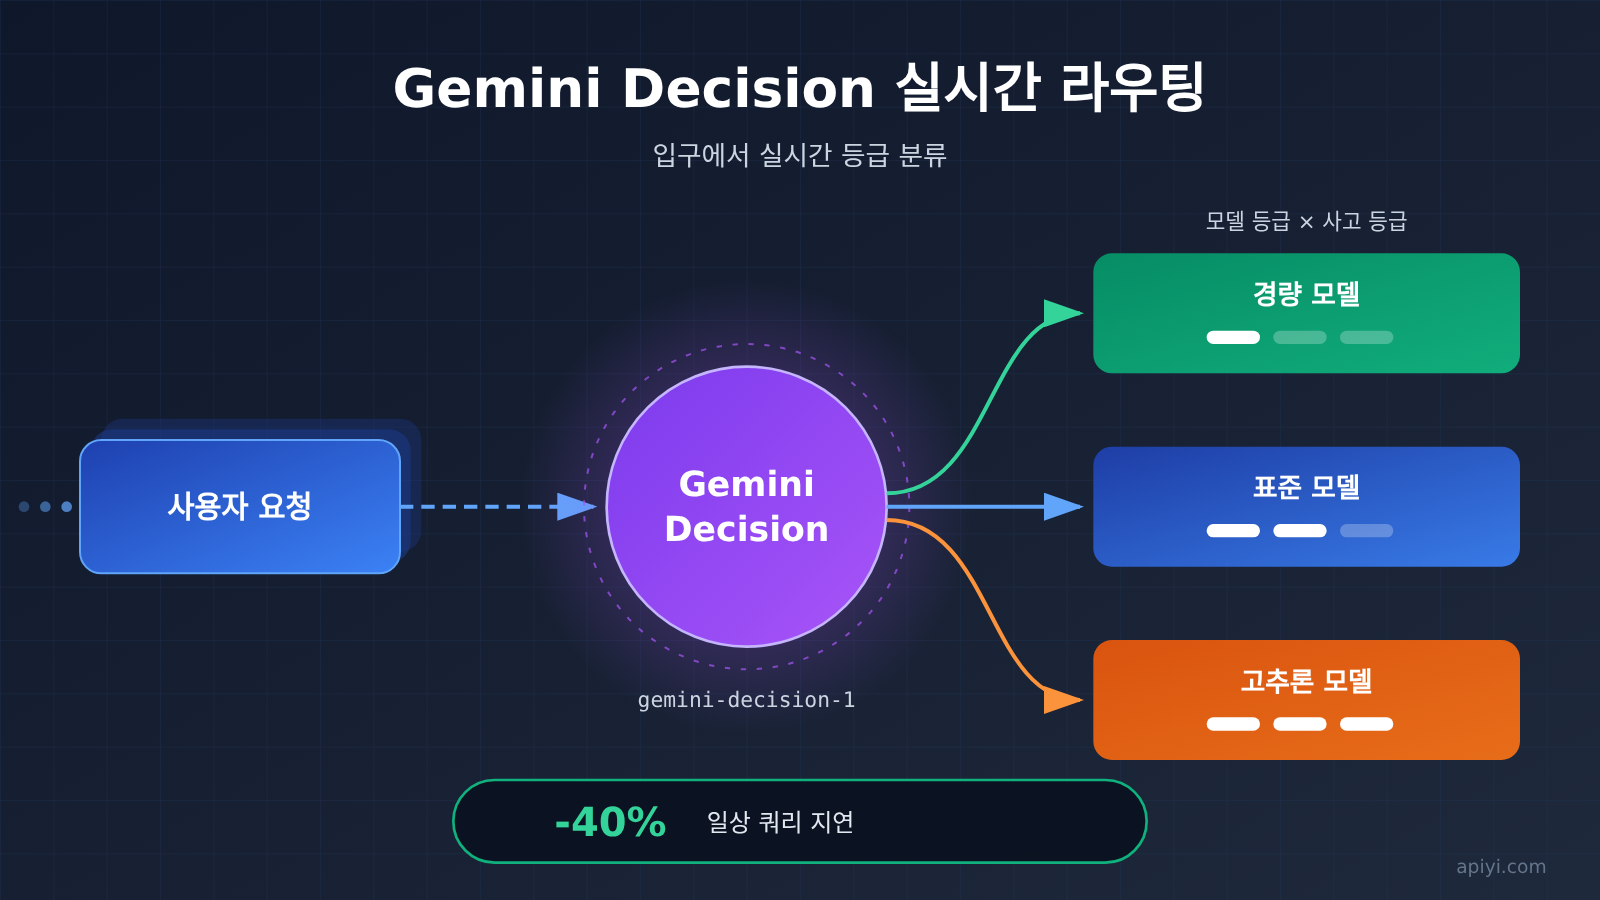
Gemini Decision 핵심 정보 한눈에 보기
| 항목 | 상세 내용 |
|---|---|
| 공개 시점 | 2026-11-11, Google 개발자 블로그 |
| 모델 ID | gemini-decision-1 |
| 포지셔닝 | 콘텐츠 생성이 아닌 실시간 라우팅 및 의사결정 |
| 첫 공개 사례 | Gemini Notebook 내부에서 일상 질문을 티어별로 분류 |
| 입력 가격 | $0.10 / 1M tokens |
| 출력 가격 | $0 |
| 지연 시간 개선 | 일상 쿼리 기준 최대 40% 감소 (공식 자체 발표) |
| 애그리게이터 플랫폼 지원 여부 | 2026-11-12 기준 APIYI apiyi.com 가격표에는 아직 해당 ID가 없음 |
표에서 가장 놓치기 쉬운 부분은 출력 가격이 $0이라는 행이에요. gemini-decision-1이 내놓는 결과는 본문이 아니라 아주 짧은 판단값이라는 뜻이거든요. 어느 티어로 보낼지, 사고 예산은 얼마나 쓸지 정도예요. 이런 모델을 대화형 모델과 같은 가격표에 올려 놓고 단가를 비교하면 완전히 잘못된 결론이 나와요.
또 하나 눈여겨볼 점은 이미 실제 프로덕션 사례가 있다는 거예요. 문서 속 예제 수준에 머무르지 않았다는 얘기죠. Gemini Notebook은 Google의 자체 제품이고, 이 라우팅을 자사 제품에서 먼저 돌려 본 다음 외부에 공개한 방식이라서 단순 벤치마크보다는 신뢰도가 높아요. 다만 여전히 공식 측의 일방적인 설명이라는 점은 변하지 않아요.
Gemini Decision은 어떻게 작동할까요: 공식이 밝힌 라우팅 사례
Google 블로그에 따르면 Gemini Notebook의 일상적인 질문은 먼저 Decisions API가 판단한 뒤, 어떤 모델 등급과 어떤 사고(thinking) 등급으로 처리할지 결정해요. 즉 라우팅 결정 자체가 하나의 모델 호출이 된 거예요. 코드에 하드코딩한 if-else 규칙이나 사람이 손으로 맞춘 임계값이 아니라는 점이 핵심이에요.
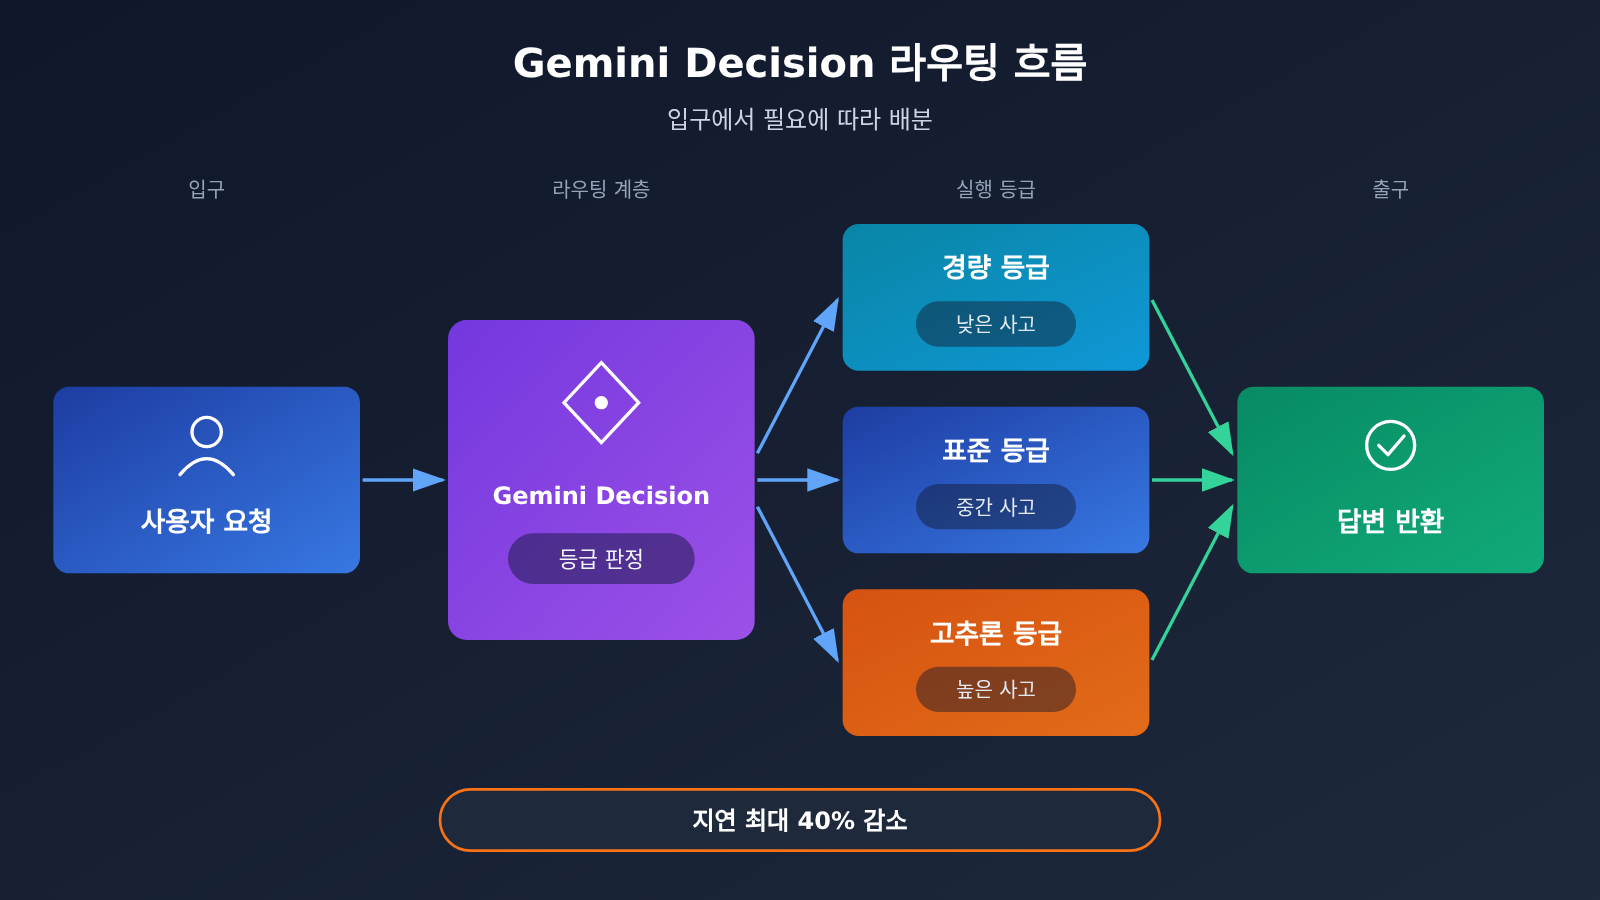
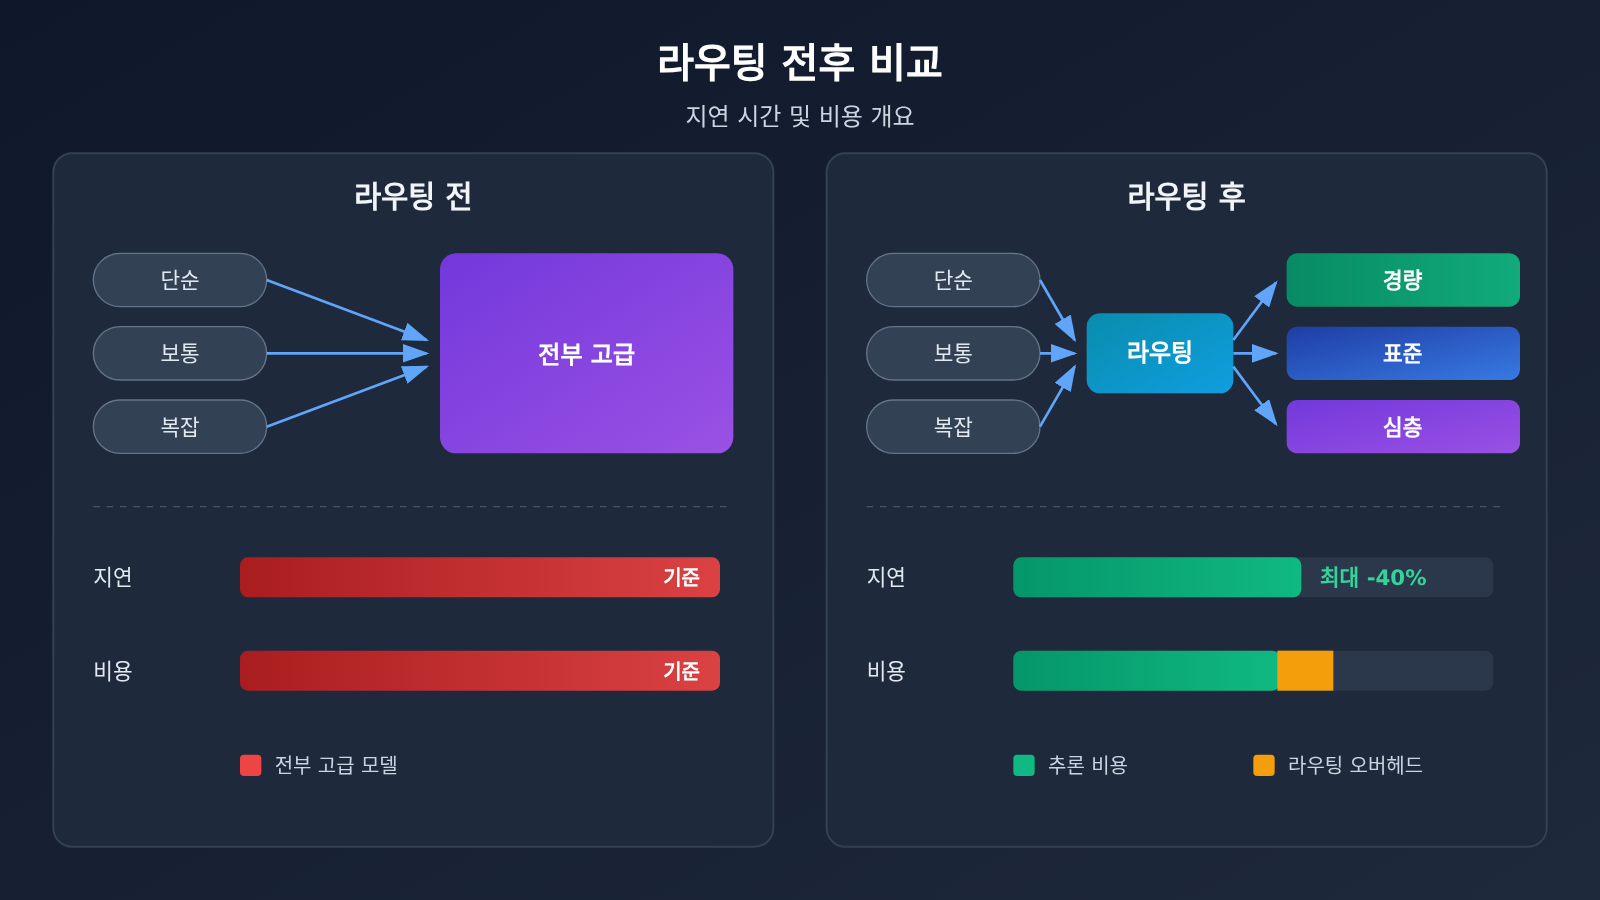
이 설계가 해결하려는 문제는 꽤 현실적이에요. 같은 제품 안에서도 대부분의 요청은 가벼운 일상 질문이고, 깊은 추론이 필요한 요청은 소수예요. 모든 요청을 같은 등급으로 처리하면 가벼운 요청이 무거운 모델에 끌려가 지연 시간과 비용이 함께 늘어나요. 반대로 전부 가벼운 등급으로 처리하면 복잡한 질문에는 제대로 답하지 못하고요. 입구에 전용 결정 모델을 두고 판단하게 하면, “필요한 만큼만 배분하는 것”을 인프라 차원에서 구현하는 셈이에요.
| 단계 | 라우팅 도입 전의 일반적인 방식 | Decision 도입 후 |
|---|---|---|
| 등급 판단 | 코드에 규칙을 작성하거나 키워드 매칭 | 모델이 요청 내용을 보고 판단 |
| 유지 보수 | 비즈니스가 바뀔 때마다 임계값을 수동 조정 | 모델이 업데이트되면 판단 로직도 함께 개선 |
| 지연 시간 영향 | 무거운 등급 요청이 많으면 전체가 느려짐 | 공식 발표 기준 일상 쿼리 지연 시간 최대 40% 감소 |
| 비용 영향 | 모든 요청을 같은 등급으로 과금 | 가벼운 요청은 가벼운 등급으로 처리되어 청구 구조가 달라짐 |
분명히 짚어 둘 점이 있어요. 40%라는 수치는 “일상 쿼리”에 해당하는 값이지 모든 요청에 적용되는 값이 아니에요. 공식 표현도 상한 기준이라서, 실제 서비스에서 얻는 효과는 전체 요청 중 낮은 등급으로 내려도 되는 질문이 얼마나 되는지에 달려 있어요. 제품이 처음부터 끝까지 긴 문서 분석이나 복잡한 코드 작업 위주라면, 등급을 낮출 수 있는 여지는 그만큼 작을 수밖에 없어요.
🎯 기술 팁: 이런 라우팅 방식이 내 서비스에서 얼마나 효과가 있을지 확인하고 싶다면, 먼저 APIYI(apiyi.com)의 통합 인터페이스로 등급별 모델을 각각 호출해 보세요. 같은 요청 묶음을 넣고 지연 시간과 출력 품질을 비교해 본 다음, 라우팅 계층을 도입할지 결정하면 돼요.
Gemini Decision의 과금 구조와 비용 의미
입력 $0.10 / 1M tokens, 출력 $0라는 구조는 본질적으로 “컨텍스트를 얼마나 읽어 들였는지”를 기준으로 요금을 매기는 방식이에요. 라우팅 판단은 요청 내용을 봐야 내릴 수 있으니 입력 쪽에 과금하는 건 합리적이에요. 반면 결과로는 등급 하나만 내놓기 때문에 출력 쪽에서는 비용이 거의 발생하지 않고, 공식적으로도 아예 0으로 책정했어요.
이는 도입하는 쪽에서 계산을 한 번 더 해야 한다는 뜻이기도 해요. 라우팅 계층 자체도 token을 소모하거든요. 요청이 낮은 등급으로 내려가면서 절약된 추론 비용이 이 추가 판단 비용을 넘어서야 전체적으로 이득이 돼요. 요청이 길고 등급 간 격차가 클수록 계산이 유리하게 나오고, 요청이 짧아서 원래부터 가벼운 등급으로 처리되던 상황이라면 라우팅 계층을 추가하는 쪽이 오히려 더 비쌀 수도 있어요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# gemini-decision-1은 현재 플랫폼 가격표에 아직 등록되지 않았어요
# 우선 model을 기존에 제공되는 대화 모델로 바꿔서 비즈니스 흐름을 검증해 볼 수 있어요
response = client.chat.completions.create(
    model="YOUR_MODEL",
    messages=[{"role": "user", "content": "这个问题需要多深的推理?"}]
)
print(response.choices[0].message.content)
🚀 빠른 시작: 2026-11-12 기준으로 APIYI(apiyi.com)의 가격 목록에는 아직 gemini-decision-1이 없어요. 플랫폼에서 최대한 빨리 추가할 예정이에요. 등록되기 전까지는 같은 OpenAI 호환 인터페이스로 다른 모델을 호출해 흐름을 검증해 보세요. 전환 비용이 거의 들지 않아요. 구체적인 모델명과 가격은 apiyi.com 목록을 기준으로 확인해 주세요.
누가 영향을 받을까: 세 가지 호출 흐름에서 달라지는 점
애플리케이션 측: 라우팅을 직접 짜는 대신 API로 호출해요
예전에는 여러 모델로 트래픽을 나누려면 팀에서 규칙 테이블을 따로 관리해야 했고, 모델 버전이 바뀔 때마다 파라미터를 반복해서 조정해야 했어요. 라우팅 판단을 전용 의사결정 모델에 맡길 수 있다면 애플리케이션 쪽 로직은 눈에 띄게 얇아져요. 남는 일은 “어떤 등급을 둘지”와 “각 등급에 어떤 모델을 배치할지”를 정의하는 것뿐이에요. 대신 직렬 호출이 한 번 더 생기기 때문에, 진입 계층의 네트워크 품질이 전체 지연 시간에 그대로 영향을 줘요.
비용 측: 지연 시간이 줄었다고 청구 금액도 줄어드는 건 아니에요
지연 시간과 비용은 서로 다른 곡선이에요. 등급을 낮추면 둘 다 줄일 수 있지만, 라우팅 호출 자체가 입력 토큰 기준으로 과금되기 때문에 짧은 요청이 많은 환경에서는 한계 비용이 오히려 높아져요. 안전한 방법은 먼저 요청 유형별로 그룹을 나누고, “복잡도 편차가 큰” 트래픽에만 라우팅을 적용하는 거예요. 나머지 트래픽은 고정 등급으로 처리하면 돼요.
| 팀 유형 | 주요 이점 | 주의할 비용 항목 |
|---|---|---|
| 일반 사용자 대상 Q&A 서비스 | 일상적인 질문의 지연 시간이 줄어 체감 개선이 뚜렷해요 | 라우팅 호출에 드는 추가 토큰 비용 |
| 사내 업무 도구 | 복잡한 요청과 단순한 요청이 섞여 있어 등급 간 차이가 커요 | 등급 구분을 새로 설계해야 해요 |
| 짧은 요청이 잦은 서비스 | 이점이 제한적이고 등급을 낮출 여지도 작아요 | 직렬 호출이 한 단계 늘어 오히려 손해일 수 있어요 |
플랫폼 측: 새 모델 ID를 얼마나 빨리 따라가느냐가 선택 기준이 돼요
모델 업데이트 주기가 점점 빨라지면서, ID가 공개된 뒤 안정적으로 쓸 수 있게 되기까지 보통 공백 기간이 생겨요. 통합 플랫폼을 쓰는 팀에게는 이 기간에 호출 가능한 API를 얼마나 빨리 확보하느냐가 검증 일정에 직접 영향을 줘요. APIYI(apiyi.com) 같은 플랫폼의 가치도 여기에 있어요. API 키 하나와 OpenAI 호환 인터페이스만 있으면, 모델이 추가된 뒤에도 코드 구조를 바꾸지 않고 바로 전환할 수 있거든요. 모델 추가 일정과 과금 세부 사항은 apiyi.com 페이지에 표시된 내용을 기준으로 확인해 주세요.
자주 묻는 질문 FAQ
Q1: Gemini Decision이 뭔가요?
Google이 공개한 gemini-decision-1은 실시간 라우팅과 의사결정을 위한 모델이에요. 본문을 생성하는 게 아니라, 하나의 요청을 어떤 모델 등급과 어떤 사고(thinking) 등급으로 처리할지 판단하는 역할을 해요. Gemini Notebook이 현재 공개된 첫 번째 프로덕션 사례예요.
Q2: 일반 Gemini 모델과는 어떻게 다른가요?
일반 대화 모델은 콘텐츠를 출력하지만, 이 모델의 출력은 아주 짧은 판단 결과예요. 그래서 과금 구조도 완전히 달라요. 입력은 $0.10 / 1M tokens, 출력은 $0예요. “더 저렴한 생성 모델”로 이해하면 방향부터 잘못 잡은 거예요.
Q3: 지연 시간이 최대 40% 줄어든다는 수치는 어디서 나온 건가요?
이 수치는 Google 공식 블로그에서 자체적으로 밝힌 내용이에요. Gemini Notebook의 일상적인 질의 시나리오에서 얻을 수 있는 지연 시간 개선의 상한선을 뜻하고, 제3자가 독립적으로 부하 테스트한 결과는 아니에요. 실제 효과는 여러분의 요청 중 낮은 등급으로 내려도 되는 가벼운 질문이 얼마나 되는지에 따라 달라져요.
Q4: 우리 서비스에서 비용을 얼마나 아낄 수 있나요?
모두에게 해당하는 정답은 없어요. 추론 비용 절감은 요청이 더 가벼운 등급으로 분류되면서 생기고, 라우팅 자체는 입력 토큰 기준으로 과금돼요. 요청이 길고 등급 간 차이가 클수록 순이익이 뚜렷해지고, 짧은 요청이 빈번하게 들어오는 시나리오에서는 신중하게 따져봐야 해요.
Q5: 지금 Gemini Decision을 호출할 수 있나요?
2026-11-12 기준으로 APIYI(apiyi.com) 가격표에는 아직 gemini-decision-1이 없어요. 플랫폼에서 최대한 빨리 추가할 예정이에요. 그 전에는 apiyi.com의 통합 인터페이스로 먼저 비즈니스 흐름을 구성해 두고, ID가 등록되면 모델 이름만 바꾸면 돼요. 구체적인 모델 종류와 가격은 apiyi.com 목록을 기준으로 확인해 주세요.
Q6: 라우팅 레이어를 도입하면 어떤 비용이 따르나요?
크게 세 가지예요. 첫째, 요청 경로에 직렬 호출이 한 번 더 늘어나서 진입 구간의 네트워크 품질이 더 중요해져요. 둘째, 라우팅 판단 자체가 입력 토큰을 소모하기 때문에 짧은 요청은 한계 비용이 올라가요. 셋째, 등급 구분은 서비스에 맞게 다시 설계해야 하고, 다른 곳의 분류 방식을 그대로 가져다 쓰면 안 돼요.
Gemini Decision 핵심 요점 Key Takeaways
- 포지셔닝: gemini-decision-1은 실시간 라우팅 모델이에요. 어떤 등급으로 처리할지 판단 결과만 내놓고, 본문은 생성하지 않아요.
- 활용 사례: Gemini Notebook은 이 모델로 일상적인 질문을 알맞은 모델 등급과 사고(thinking) 등급으로 나눠요.
- 기대 효과: 공식 발표에 따르면 일상 쿼리 지연 시간이 최대 40% 줄어들어요. 다만 자체 보고 기준이라는 점은 감안해야 해요.
- 과금: 입력은 $0.10 / 1M tokens, 출력은 $0이에요. 읽어 들인 컨텍스트 기준으로 과금돼요.
- 비용 측면의 단점: 라우팅 자체도 토큰을 소모해요. 짧은 요청이 많은 환경에서는 순이익을 따로 계산해 봐야 해요.
- 지원 현황: 2026-11-12 기준으로 APIYI(apiyi.com)에는 아직 해당 ID가 없어요. 빠르게 추가할 예정이며, 가격은 apiyi.com 목록을 기준으로 해주세요.
- 검증 방법: 먼저 통합 인터페이스로 전체 흐름을 돌려 본 다음, 프로덕션에 라우팅 계층을 도입할지 결정하세요.
정리
이번 발표에서 중요한 점은 모델 자체가 얼마나 강력한가가 아니에요. Google이 ‘모델 선택’을 외부에 제공할 수 있는 인터페이스로 만들었고, 그것을 먼저 자사 제품에서 검증했다는 점이 핵심이에요. 개발자라면 다음 세 가지를 기억해 두면 좋아요. 첫째, 라우팅 결정이 코드 로직에서 한 번의 모델 호출로 바뀌고 있어요. 둘째, 지연 시간 개선 수치는 공식이 밝힌 최대치 기준이라서, 내 트래픽 구성에 맞춰 다시 추산해야 해요. 셋째, 새로 생기는 과금 항목 때문에 비용 구조가 달라져요. 등급을 낮춰서 아끼는 부분만 보고 판단해서는 안 돼요.
이 방식을 미리 검증해 보고 싶다면, 지금 쓰는 모델로 등급 분류 로직을 먼저 돌려 보세요. gemini-decision-1이 APIYI(apiyi.com)에 올라오면 모델 이름만 한 번 바꿔서 전환할 수 있어요. 모델 ID와 가격은 apiyi.com 목록을 기준으로 해주세요.
참고 자료
- Google 공식 블로그: Gemini Decisions API
- 링크:
blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ -
설명: 이 글에서 다루는 모델 ID, 라우팅 사용 사례, 지연 시간 수치, 가격 정보의 유일한 원본 출처예요
-
APIYI apiyi.com 가격표
- 링크:
apiyi.com - 설명: gemini-decision-1의 출시 여부와 최종 과금 기준을 확인할 때 참고해요
작성자: APIYI 기술팀
기술 문의: APIYI apiyi.com 메인 페이지에서 언제든 문의해 주세요. 모델 출시 소식과 새 인터페이스 안내는 사이트 내 문서 센터에서 확인할 수 있어요


