
著者注:本記事では GPT-6.2 Sol Ultrafast の公式な速度上限、プロモーション価格、定価を分けて示し、自分のタスクに当てはめられる速度プレミアムの算出方法を1つ紹介します。
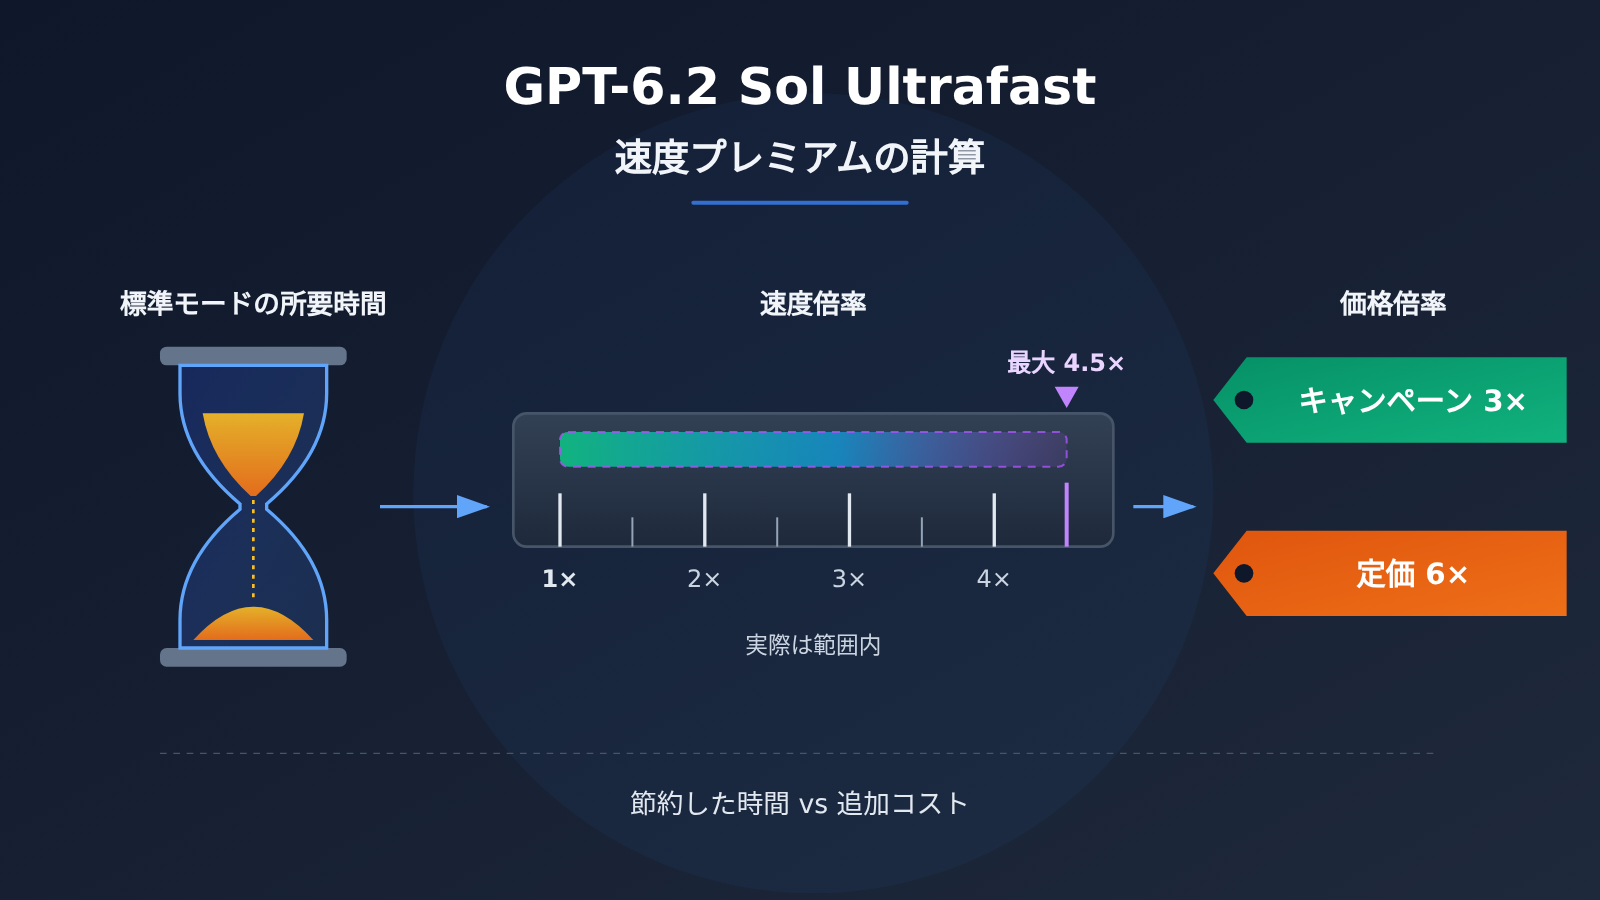
GPT-6.2 Sol で Ultrafast をオンにするかどうかは、そのタスクでどれだけ待ち時間を短縮できるかで決まります。公式が示す速度は同一モデルの標準ティアの最大4.5倍で、プロモーション期間中の価格は標準価格の3倍、2027年3月以降の定価は6倍です。速度は上限値であり、価格は確定した数値です。両者の確実さは異なるため、単純に割ることはできません。
本記事は「買う価値があるか」をあなたに代わって答えるものではありません。本記事では独自の速度測定による結論は出さず、対照群のない民間の記録を最終結果として扱うこともありません。本記事が提供するのは1つの計算方法だけです。まず自分のタスクが標準ティアでどれだけ時間を要するかを測定し、次に公式の「最大」倍率を使って短縮できる時間の上限を算出し、最後に価格差と比較します。
本記事のコアバリュー:本記事を読めば、任意のタスクについて「1分短縮するごとに余計にいくら支払うか」を計算でき、そのうえでタスクごとに速度ティアを有効にするか決められます。
GPT-6.2 Sol Ultrafast 速度プレミアムの本質的な違い
まず整理しておきたいのは、Ultrafast は別のモデルではなく、サービスティアだという点です。公式 API ドキュメントの記載では、リクエストの model は引き続き gpt-6.2-sol で、別途 service_tier を追加して ultrafast に設定するだけです。現在このサービスティアに対応しているのは、GPT-6.2 Astra、GPT-6.2 Sol、GPT-6 Astra、GPT-6.1 Sol です。
したがって、比較しているのは同じモデルの2つの提供速度であり、2つのモデルの能力差ではありません。出力品質の話は脇に置いておくと、この問いでは変数は時間と価格の2つだけになります。
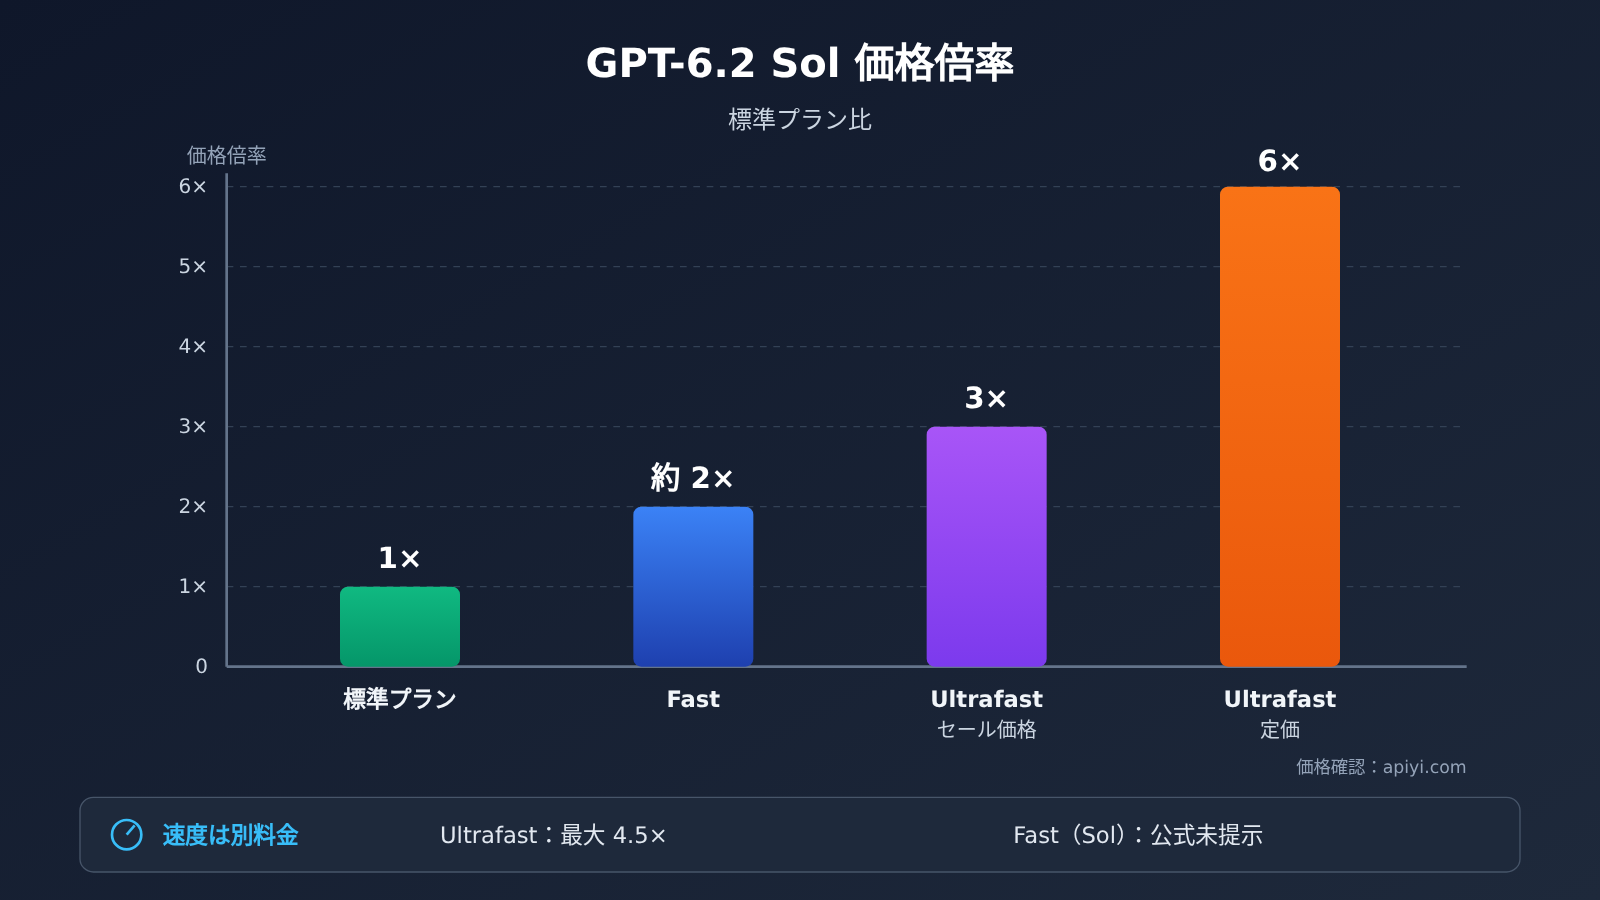
| ティア(gpt-6.2-sol、短コンテキスト) | 入力 | キャッシュ読み取り | 出力 | 標準価格比 | 公式の速度表記 |
|---|---|---|---|---|---|
| 標準ティア | 2 | 0.10 | 10 | 1× | 基準 |
| Fast | 4 | 0.20 | 20 | 約2× | ドキュメントには Sol の速度倍率の記載なし |
| Ultrafast プロモーション(2027-02-28 太平洋時間まで) | 6 | 0.30 | 30 | 3× | 最大4.5倍 |
| Ultrafast 定価(2027-03-01 以降) | 12 | 0.60 | 60 | 6× | 最大4.5倍 |
表内の価格単位は米ドル/100万トークンで、短コンテキストとは入力が27.2万トークン以下を指します。Fast ティアには別途注意が必要です。公式ドキュメントに書かれた「約1.5倍の速度」は GPT-6.2 Astra と GPT-5.6 を対象としたもので、GPT-6.2 Sol には記載されていません。そのため、この倍率を Sol の Fast ティアに当てはめることはできません。
GPT-6.2 Sol Ultrafast の長コンテキスト価格
入力が27.2万トークンを超えると、長コンテキストの料金体系に入ります。公式の標準ティアにおける長コンテキスト価格は、入力4、キャッシュ読み取り0.20、出力15です。Ultrafast のプロモーション価格は 12 / 0.60 / 45、定価は 24 / 1.20 / 90 で、それぞれ標準価格の3倍と6倍になります。
| 料金項目(長コンテキスト、米ドル/100万トークン) | 入力 | キャッシュ読み取り | 出力 |
|---|---|---|---|
| 公式標準ティア | 4 | 0.20 | 15 |
| Ultrafast プロモーション | 12 | 0.60 | 45 |
| Ultrafast 定価 | 24 | 1.20 | 90 |
APIYI 総合表 gpt-6.2-sol(入力27.2万超) |
3 | プラットフォームの料金表に準拠 | プラットフォームの料金表に準拠 |
ここで数字が1つ食い違っているため、個別に説明が必要です。APIYI apiyi.com のモデル総合表では、段階を「0~27.2万トークンの入力は2ドル、27.2万トークン超は入力3ドル」と記載していますが、公式標準ティアの長コンテキスト入力価格は4ドルです。この2つの数字は混同しないでください。APIYI 経由の呼び出しでは総合表の3ドル、公式へ直接接続する場合は4ドルで計算されます。
GPT-6.2 Sol Ultrafast の速度はどこから来るのか:公式の上限とコミュニティの記録
速度に関する情報は現在2種類あり、信頼度に大きな差があります。分けて扱うことをおすすめします。
| 情報源 | 内容 | 性質 | あなたの環境での倍率として使えるか |
|---|---|---|---|
| 公式 Codex / API ドキュメント | Ultrafast の生成速度は同一モデルの標準モードの最大4.5倍(up to 4.5 times) | 公式な上限の記述 | 上限としてのみ |
| Artificial Analysis | 同一モデルの標準モードで約85出力トークン/秒 | 第三者の公開ベンチマーク | 参考としてのみ |
| OrcaRouter 2026-11-18 の伝聞 | 1回のタスクで平均約126トークン/秒、ピーク約252 | 単発・標準モードとの照合なしの伝聞 | 使えない |
公式原文は “up to” を使っており、最高で到達し得るという意味であって、毎回のリクエストで4.5倍に達することを保証するものではありません。アルゴリズム的に言えば、「最良ケース」の欄に置くのが適切です。
OrcaRouter は2026-11-18に、X上の動画編集者による単発タスクを伝えています。Ultrafast は平均で毎秒約126トークン、ピークで約252。タスクの実時間(ウォールクロック)は約27分で、うちモデル応答が約14分でした。伝聞の著者はこの数値を、Artificial Analysis が公表した標準モードの85トークン/秒と比較し、約1.5倍と結論づけています。この記録は1回の実行のみで、再現も、同一タスクでの標準モードとの比較もありません。したがって1つのデータポイントにすぎず、この速度モードの最終的な性能を代表するものではありません。
この記録からは、見落としやすい事実も分かります。27分のウォールクロックのうち、モデル応答は約14分しか占めていません。速度モードが速くできるのはモデル生成のこの区間だけであり、ツール呼び出し、ファイルの読み書き、人による確認などの工程は速くならないのです。
GPT-6.2 Sol Ultrafast の速度プレミアムを計算する方法:そのまま使えるアルゴリズム
以下のアルゴリズムは、あえて「他の人が測定した倍数」を一切使っていません。あなた自身が用意する必要があるデータは、このタスクを標準ティアで実行したときの所要時間だけです。
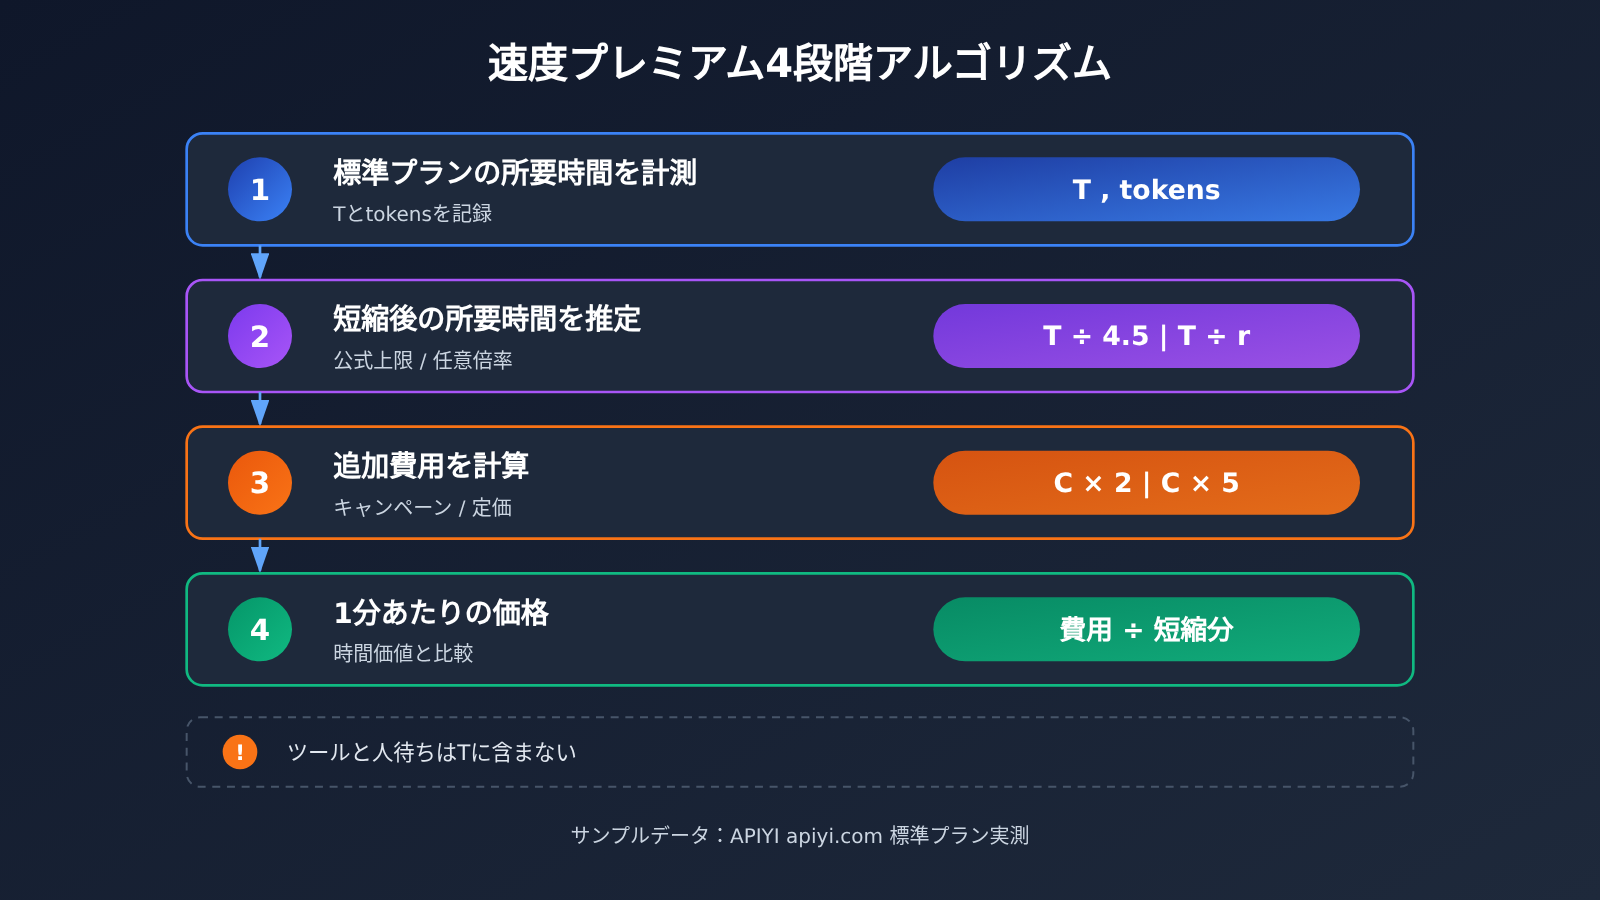
| ステップ | 計算項目 | 式 | 説明 |
|---|---|---|---|
| ① | 標準ティアの生成時間 T | 自分で測定 | モデル生成のみを計測し、ツールの時間は含めない |
| ② | 最良ケースで短縮できる時間 | T ×(1 − 1/4.5)≈ 0.78T | 公式の上限を使用 |
| ②′ | 保守的ケースで短縮できる時間 | T ×(1 − 1/r) | r は自分で決めた倍率で、r ≤ 4.5 |
| ③ | 標準ティアの費用 C | 入力×単価 + キャッシュ読み取り×単価 + 出力×単価 | コンテキスト長に応じて価格ティアを選択 |
| ④ | プロモーション期間の追加費用 | C × 2 | Ultrafast のプロモーション価格は 3C |
| ④′ | 定価期間の追加費用 | C × 5 | Ultrafast の定価は 6C |
| ⑤ | 1分短縮あたりの価格 | 追加費用 ÷ 短縮できた分数 | 自分の時間価値と比較 |
GPT-6.2 Sol Ultrafast の計算例
ここでは仮の数値を使ってアルゴリズムを説明します。これらの数値は実際の速度測定結果ではありません。1回のタスクで入力20万トークン(短いコンテキスト)、出力5万トークン、キャッシュヒットなしと仮定します。標準ティアで計測した出力速度は毎秒80トークンだとします。
- 標準ティアの費用 C = 0.2 × 2 + 0.05 × 10 = 0.9 ドル。
- 標準ティアの生成時間 T = 50000 ÷ 80 ≈ 625 秒、約10.4分。
- Ultrafast のプロモーション価格は2.7ドルで、追加支出は1.8ドル。定価は5.4ドルで、追加支出は4.5ドル。
| 仮定の倍率 r | 生成時間 | 短縮できた時間 | プロモーション期の1分あたり価格 | 定価期の1分あたり価格 |
|---|---|---|---|---|
| 4.5(公式の上限) | 約2.3分 | 約8.1分 | 約0.22ドル | 約0.56ドル |
| 3 | 約3.5分 | 約6.9分 | 約0.26ドル | 約0.65ドル |
| 2 | 約5.2分 | 約5.2分 | 約0.35ドル | 約0.87ドル |
| 1.5 | 約6.9分 | 約3.5分 | 約0.51ドル | 約1.29ドル |
この表から2つのポイントが読み取れます。1つ目は、倍率が4.5から1.5に下がると1分あたりの価格がおよそ2倍になるため、価格そのものよりも倍率の仮定のほうが重要だということです。2つ目は、2027年3月に定価が適用されると、同じ1分を短縮するのに約2.5倍の費用がかかるため、プロモーション期の結論をそのまま翌年へ持ち込むことはできないということです。
💰 コスト確認のヒント:この例の標準ティアの単価は、APIYI apiyi.com の総合表にある
gpt-6.2-solの価格(入力2、キャッシュ読み取り0.1、出力10)と直接照合できます。この価格設定は公式の標準ティアの短いコンテキストと一致しており、アルゴリズムの C 値の参照元として適しています。
コードで自分の GPT-6.2 Sol 標準ティアの所要時間を計測する
アルゴリズムの最初のステップでは、実際の T が必要になります。以下のコードはストリーミング出力を使って最初の token が届くまでの時間と総生成時間を記録し、usage に含まれる token 数を読み取ることで、こうしたタスクにおける標準ティアの速度を計算します。
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換エンドポイント
)

start = time.time(); first = None; usage = None
stream = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "ここにあなたの実際のタスクのプロンプトを入れてください"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and first is None:
        first = time.time()
    if chunk.usage:
        usage = chunk.usage
end = time.time()
gen = end - (first or start)
print(f"初回 token {first - start:.1f}s、生成 {gen:.1f}s、"
      f"出力 {usage.completion_tokens} tokens、約 {usage.completion_tokens / gen:.0f} tok/s")
service_tier を含む完全な比較スクリプトを見る
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PRICE = {  # 米ドル/100万 tokens、短いコンテキスト
    "default":   {"in": 2,  "cache": 0.10, "out": 10},
    "promo":     {"in": 6,  "cache": 0.30, "out": 30},
    "list":      {"in": 12, "cache": 0.60, "out": 60},
}

def run(prompt: str, tier: str | None = None):
    kwargs = dict(
        model="gpt-6.2-sol",
        messages=[{"role": "user", "content": prompt}],
        stream=True,
        stream_options={"include_usage": True},
    )
    if tier:
        # 公式の書き方:同じモデル ID に service_tier を付ける
        kwargs["extra_body"] = {"service_tier": tier}
    start = time.time(); first = None; usage = None; served = None
    for chunk in client.chat.completions.create(**kwargs):
        if chunk.choices and chunk.choices[0].delta.content and first is None:
            first = time.time()
        if chunk.usage:
            usage = chunk.usage
        served = getattr(chunk, "service_tier", served)
    gen = time.time() - (first or start)
    return gen, usage, served

def cost(usage, p):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * p["in"] + cached * p["cache"] + usage.completion_tokens * p["out"]) / 1e6

prompt = "ここにあなたの実際のタスクのプロンプトを入れてください"
t_std, u_std, s_std = run(prompt)
c_std = cost(u_std, PRICE["default"])
print(f"標準ティア:生成 {t_std:.1f}s、費用 約 ${c_std:.3f}、返されたティア {s_std}")

for name, r in [("公式の上限", 4.5), ("保守的な仮定", 2.0)]:
    saved_min = t_std * (1 - 1 / r) / 60
    print(f"{name} r={r}:{saved_min:.1f} 分の短縮、"
          f"プロモ毎分 ${c_std * 2 / saved_min:.3f}、定価毎分 ${c_std * 5 / saved_min:.3f}")

# 速度ティアを実測したい場合は、下のコメントを外し、返される service_tier フィールドが ultrafast かどうかを確認してください
# t_uf, u_uf, s_uf = run(prompt, tier="ultrafast")
# print(f"速度ティア:生成 {t_uf:.1f}s、実測倍率 約 {t_std / t_uf:.2f}、返されたティア {s_uf}")
service_tier について補足が必要です。APIYI apiyi.com のモデル一覧には gpt-6.2-sol のみが掲載されており、ultrafast という独立したモデルはなく、service_tier フィールドの記載もありません。一覧に表示されている価格は標準ティアに対応します。本文ではドキュメントと価格表のみを確認し、実際のリクエストは送信していないため、このパラメータが https://api.apiyi.com/v1 経由で呼び出された際の挙動については説明できません。速度ティアが必要な場合は、レスポンスで返されるティアのフィールドと請求内容を基準にしてください。モデル名と価格はプラットフォームのモデル一覧を基準にしてください。
🚀 導入のヒント:まず APIYI apiyi.com の標準ティア
gpt-6.2-solで自分の実際のタスクを2〜3回実行し、生成時間の中央値を T として取得しましょう。このステップは標準価格しかかかりませんが、以降のすべての計算の正確さを左右します。
GPT-6.2 Sol Ultrafast のシーン別推奨
結論はタスクごとに下すべきです。同じ人でも、タスクによっては逆の答えになることがあります。
Ultrafast を有効にすべきシーン
- 画面の前で人が結果を待つインタラクティブなタスク:たとえばリアルタイムのペアプログラミングやライブデモです。待ち時間はそのまま人件費になるため、上記の計算式では単価が通常カバーできる範囲になります。
- 生成時間がウォールクロックに占める割合が高いタスク:T がタスク全体の所要時間の大部分を占めるなら、短縮した時間はそのまま納品時間に反映されます。
- プロモーション期間中の短いコンテキストのタスク:3 倍の価格でも短いコンテキストなら単価が低いため、追加支出の絶対額は小さく済みます。
標準ティアに留めておくべきシーン
- バックグラウンドのバッチ処理や夜間タスク:誰も待っていないため、短縮した分に時間的な価値は対応しません。
- ツール呼び出しが密集する Agent タスク:先に述べた記録のように、ウォールクロック 27 分のうちモデルの応答は約 14 分のみで、速度ティアはその一部分しか短縮できません。
- 長いコンテキストと大量出力のタスク:定価期間(刊例期)の長いコンテキストの出力単価は 90 に達し、追加支出は急速に増えます。
| タスクの特徴 | 生成時間の割合 | 待ち人がいるか | 傾向 |
|---|---|---|---|
| インタラクティブなコーディング、ライブデモ | 高 | はい | まず計算式で試算、単価で通常カバー可能 |
| ツール集約型 Agent | 中〜低 | 状況次第 | 生成部分のみで計算、効果は希釈される |
| 夜間バッチ処理 | 高 | いいえ | 標準ティアに留める |
| 長いコンテキストの大量出力 | 高 | 状況次第 | 定価期間は慎重に試算する必要あり |
💡 選択のヒント:同じプロジェクト内に2種類のタスクが混在する場合は、コード内でタスク種別に応じて
service_tierを付けるかどうかを決めればよく、全体で有効化する必要はありません。APIYI apiyi.com で同じ Key を使って標準ティアのベースラインを取得し、その後どのタスク種別が速度ティアの追加検証に値するかを判断しましょう。
GPT-6.2 Sol Ultrafast の導入判断
ここまでの内容を、次の固定手順に整理します。
- 標準ティアで実際のタスクを実行し、生成にかかった時間 T とトークン使用量を記録します。他社の速度数値は使わないでください。
- 公式の上限である 4.5 倍から最良ケースを算出し、さらに妥当だと考える保守的な倍率 r を選んで、両方のケースを計算します。
- プロモーション価格の 3 倍と定価の 6 倍でそれぞれ追加コストを計算し、2 つの「1 分あたりの価格」を求めます。
- 自分の時間価値と比較します。保守的な倍率でも割に合うタスクだけが、有効化する価値のあるタスクです。
- 2027-03-01 に定価が有効になる前に、新しい価格で再計算します。
この手順の要点は第 2 ステップです。公式の「最大 4.5 倍」は上限として使えますが、2026-11-18 の約 126 トークン/秒という引用情報は単一のデータポイントにすぎません。どちらも今回のタスクにおける実際の倍率ではありません。実際の倍率は、自分のタスクで比較テストを行うことでしか得られません。
よくある質問(FAQ)
Q1:GPT-6.2 Sol Ultrafast は新しいモデルですか?
いいえ。公式 API ドキュメントによると、Ultrafast はサービスティアであり、リクエスト内の `model` は引き続き `gpt-6.2-sol` です。さらに `service_tier` を追加して `ultrafast` に設定しますが、モデル自体は変わりません。
Q2:Ultrafast を有効にすれば必ず 4.5 倍に達しますか?
必ずしもそうとは限りません。公式の原文は “up to 4.5 times” であり、上限を示す表現です。計算時には、より低い保守的な倍率も用意し、自分の比較テスト結果を基準にしてください。
Q3:GPT-6.2 Sol Ultrafast のプロモーション価格はいつ終了しますか?
公式のプロモーション価格は 2027-02-28(太平洋時間)まで適用され、価格は標準価格の 3 倍です。2027-03-01 から定価が適用され、標準価格の 6 倍になります。短いコンテキストと長いコンテキストのいずれも、この倍率関係に従います。
Q4:あの約 126 トークン/秒という記録は参考にできますか?
1 つのデータポイントとしては参考にできますが、結論として扱うことはできません。これは OrcaRouter が 2026-11-18 に引用した 1 回のタスクであり、繰り返し実行も、同一タスクでの標準ティアとの比較もありません。文中の約 1.5 倍という表現は、Artificial Analysis が公表した標準ティアの 85 トークン/秒と比較して得られたものです。
Q5:APIYI 上で表示される gpt-6.2-sol の価格はどのティアですか?
標準ティアです。APIYI apiyi.com の一覧表では、`gpt-6.2-sol` の価格は入力 2、キャッシュ読み取り 0.1、出力 10 と表示されており、公式の標準ティアの短いコンテキストと一致します。responses と chat エンドポイントをサポートしています。一覧表に ultrafast という独立したモデルはなく、`service_tier` の記載もありません。
Q6:入力トークンが 27.2 万を超える場合、標準ティアではどのように計算されますか?
2 つの情報源で数値が異なるため、別々に計算する必要があります。APIYI の一覧表では、入力が 27.2 万を超える場合の価格が 3 ドルと記載されていますが、公式の標準ティアの長いコンテキストでは入力が 4 ドルです。https://api.apiyi.com/v1 経由で呼び出す場合はプラットフォームのモデル一覧に従って計算し、公式に直接接続する場合は 4 ドルで計算します。
GPT-6.2 Sol Ultrafast 速度プレミアムの要点:Key Takeaways
- Ultrafast はサービスティア:同じモデルID
gpt-6.2-solにservice_tierを付けるだけです。モデル能力は変わりません。 - 4.5倍は公式の上限:原文は up to なので、計算時には毎回達成できる倍率として扱わないでください。
- 価格は2段階:プロモーション期間は標準価格の3倍、2027-03-01以降の定価は6倍です。
- 速くなるのは生成時間だけ:ツール呼び出しなど生成以外の時間は、短縮できる部分に含まれません。
- 単発の報告だけで結果を判断できない:2026-11-18 の約126 token/秒という記録には、標準ティアとの比較対照がありません。
- まず自分の標準ティアを測定:APIYI apiyi.com の標準ティア
gpt-6.2-solで T を測定し、その値を計算に代入できます。
まとめ
GPT-6.2 Sol Ultrafast の速度プレミアムの計算は、次の3点にまとめられます。
- 速度は上限と保守の2つの値を使う:公式の最大4.5倍を最良ケースに置き、自分で設定した保守的な倍率は別の欄に置きます。
- 価格は分けて計算する:プロモーション期間の追加支出は標準費用の2倍、定価期間は5倍です。2つの結論を混用できません。
- 結論はタスクごとに決める:1分短縮あたりのコストがあなたの時間価値より低い場合にのみ、このタスクで速度ティアを有効にするのが適切です。
タイトルの問いへの答えは、あなた自身のタスクデータ次第です。まず APIYI apiyi.com で標準ティアを使いベースラインを測定し、その数値を本文の計算表に代入することをおすすめします。
📚 参考資料
-
OpenAI Codex 速度ティアの解説:Ultrafast は最大 4.5 倍という公式の記述
- リンク:
developers.openai.com/codex/agent-configuration/speed - 説明:「up to 4.5 times」という原文と、適用されるモデルを確認できます
- リンク:
-
OpenAI Ultrafast モード API ガイド:
service_tierの使い方と対応モデル- リンク:
developers.openai.com/api/docs/guides/ultrafast-mode - 説明:Ultrafast がサービスティアであり、
modelは変わらないことを確認できます
- リンク:
-
OpenAI API 料金ページ:標準ティア、Fast、Ultrafast のキャンペーン価格と定価
- リンク:
developers.openai.com/api/docs/pricing - 説明:短いコンテキストと長いコンテキストそれぞれの完全な価格
- リンク:
-
OrcaRouter の転載記録:2026-11-18 の単一 Ultrafast タスクのデータ
- リンク:
orcarouter.ai/blog/gpt-6-2-sol-ultrafast-tokens-per-second - 説明:単発・対照なしの転載であるため、あくまで 1 つのデータポイントとして扱えます
- リンク:
-
APIYI モデル一覧表:
gpt-6.2-solの標準ティア価格と段階制- リンク:
docs.apiyi.com/models.md - 説明:標準ティアの単価と、入力が 27.2万 を超えた場合の価格を照合できます
- リンク:
作者:APIYI 技術チーム
技術交流:計算や接続に関するご不明点は、APIYI 公式サイトのトップページからお気軽にお問い合わせください。さらに詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください


