
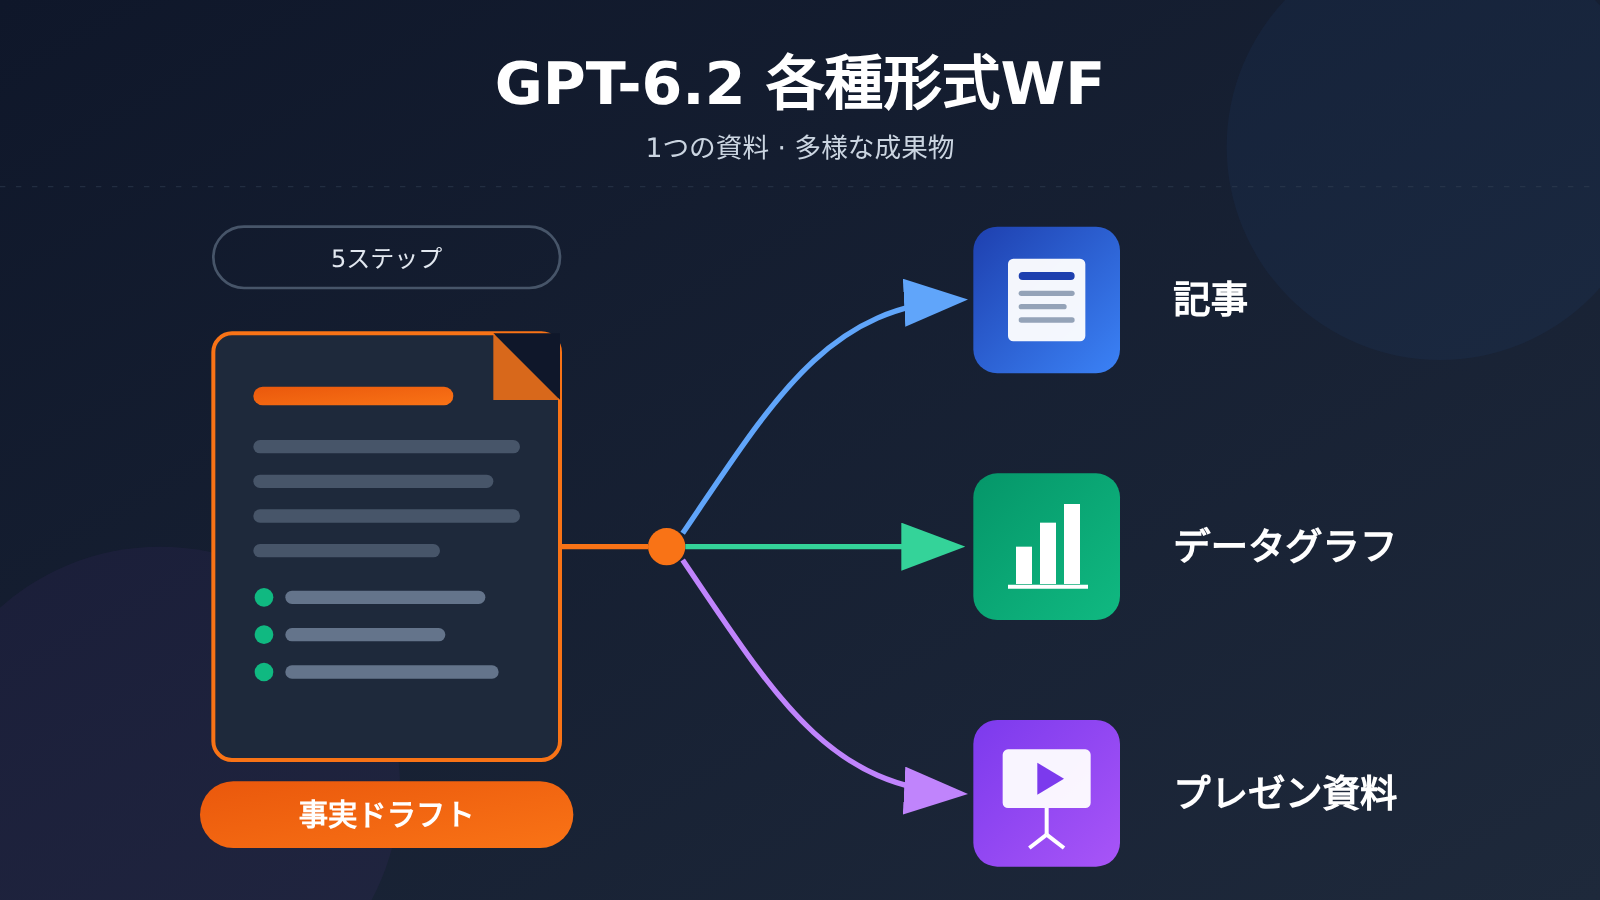
1つの資料から記事、グラフ、プレゼンテーションを派生させることができます。ただし前提として、まず検証済みの事実の下書き(ファクトベース)が必要です。より信頼できる方法は、まず資料を検証し、その後で読者の目的に応じて異なる成果物を生成することです。OpenAIは2026年11月17日にGPT-6.2 AstraとSolをリリースし、公式リリースページではテンプレート遵守や、ドキュメント、スライド、表を処理する能力について言及しています。しかし、こうした能力を信頼できる成果物へと変えるには、ツール環境、資料の整理、項目ごとの検証に依然として依存します。
この記事を読むと分かること
- GPT-6.2 AstraとSolの公式リリースページで、多形式の作業に関連するどの事実が確認されているか、どれが単なる顧客からのフィードバックなのか。
- なぜ「多形式での成果物提供」がツール環境に依存し、モデルが直接ファイルを出力するわけではないのか。
- 事実の下書きから出発し、読者の目的に応じて記事、グラフ、スライドへと分岐するワークフロー手法。
- 各成果物でそれぞれ何を検証すべきか、そして複数の成果物のバージョンをいかにして一致させるか。
本記事の索引
後半ではまず概念表と影響の概要で基本的な理解を築き、その後の「客観的事実」パートでGPT-6.2のリリースページとヘルプページの情報を項目ごとに整理し、出典と性質を明記します。「分析判断」パートは編集上の提案であり、GPT-6.2の多形式ワークフローについて5つのステップとリスク一覧を示しています。AIをコンテンツ制作プロセスに導入しようと準備している読者に、重点的に読んでいただきたい内容です。
GPT-6.2 マルチフォーマット・ワークフロー To Know:概念の説明
以下の概念は後述で何度も登場するため、まず1つの表でまとめて説明します。
| 概念 | 簡単な説明 |
|---|---|
| GPT-6.2 Astra / Sol | OpenAI が 2026-11-17 にリリースした2つのモデル。本記事は公式リリースページ、モデルドキュメント、ヘルプページに基づいています |
| テンプレート遵守 | モデルが指定されたレイアウト、構造、フォーマット要件に従って出力を組み立てる能力。リリースページでは重点項目の一つとして挙げられています |
| ツール環境 | モデル本体の外側で、ファイルの生成・レンダリング・保存を担うプログラムや製品機能。例えばドキュメントエディタやスライドレンダラーなどです |
| 事実ドラフト | 本記事で提唱する作業方法。資料の中にある事実、出典、日付、単位、不確実性を項目ごとに整理し、構造化されたリストにまとめることを指します |
| マルチフォーマット納品 | 同一の資料から、記事・図表・プレゼンテーションなど異なる形式の成果物を生み出すプロセス |
| 段階的開放 | 新しいモデルをすべての入口で同時に公開するのではなく、製品チャネルやユーザー範囲に応じて徐々に開放していくこと |
GPT-6.2 マルチフォーマット・ワークフローの影響早見表
今回のリリースの影響は、人によって受け方が異なります。以下の表は、根拠のある違いだけを挙げています。
| 対象者 | 主な影響 | 留意すべき点 |
|---|---|---|
| コンテンツクリエイター | 公式が強調するテンプレート遵守とドキュメント機能により、1つの原稿を多用途に展開しやすくなる可能性があります | 通常の Chat は今回は提供されていないため、自分が使っている入口を確認する必要があります |
| ナレッジワーカー | ブリーフィング、表、スライド系のタスクは、リリースページで明示的に言及された方向性です | 完成ファイルはツール環境に依存するため、モデルのネイティブ出力とは見なせません |
| 開発者 | API は公開済みで、アカウントのアクセスと制限は公式プラットフォームに準拠します | モデルの出力はテキストであり、ファイル生成には自前でレンダリング工程を構築する必要があります |
| チームマネージャー | 「1つの資料から複数の成果物」という協働フローを再設計できます | 成果物をまたぐ数値や引用の一貫性は、依然として人手でチェックする必要があります |
1. 客観的事実:公式事例はいったい何を示しているのか
確認日:2026年11月18日。以下の事例は OpenAI の公開ページ に掲載されているものであり、筆者による実測ではありません。
1.1 追跡可能な2種類の公式成果物事例
| 公式事例 | 入力と要件 | 示された成果物 | マルチフォーマット作業への示唆 |
|---|---|---|---|
| Alderfen Field Systems の財務ワークブック | 架空の農業テック企業の財務諸表、経営前提、市場データ | 編集可能な Excel の予測・評価ワークブック | 数値・前提・計算関係は追跡可能であるべき |
| 動物をテーマにしたチームグッズの提案 | OpenAI の公開スライドテンプレートと4チームのデザイン要件 | テーマ提案スライド、ベクターデザインファイル、制作手順書 | 同一プロジェクト内で、議論向けと実行向けの異なる成果物をまとめられる |
公式ページではさらに、IMC によるブリーフィングとインフォグラフィックへのフィードバックも引用されています。これは顧客の声であり、本記事の検証結果として扱うことはできません。これらの事例はそれぞれ別個のタスクであり、「同一の資料から記事・グラフ・PPT をワンクリックで生成する」といった一連の実験ではありません。
1.2 ファイル機能と製品の入口
GPT-6.2 Astra モデルドキュメントには、テキスト入力・画像入力・テキスト出力が記載されています。編集可能なファイルを生成するには、製品が提供するツール、または開発者が用意するファイル生成・レンダリング処理が必要です。単発のテキスト応答は、検証済みのファイルではありません。
Work と Codex のヘルプページでは、今回の段階的な提供に通常の Chat モデルセレクターが含まれていないことが明記されています。リリース告知では同時に、API で2つの新モデルが提供されていることも確認されています。利用にあたっては、使用する製品ごとにアカウントの権限とツール機能を確認してください。
2. 分析と判断:1つの資料を記事・図表・プレゼンテーションに変える5つのステップ
以下は編集上の提案であり、公式の見解ではありません。本記事は 実際には GPT-6.2 を呼び出して作品一式を制作したわけではありません。以下の例は構成ロジックを示すだけで、実際の生成結果を示すものではありません。根拠のない数値を作らないため、「GPT-6.2 リリース」という資料そのものを構造例として使います。
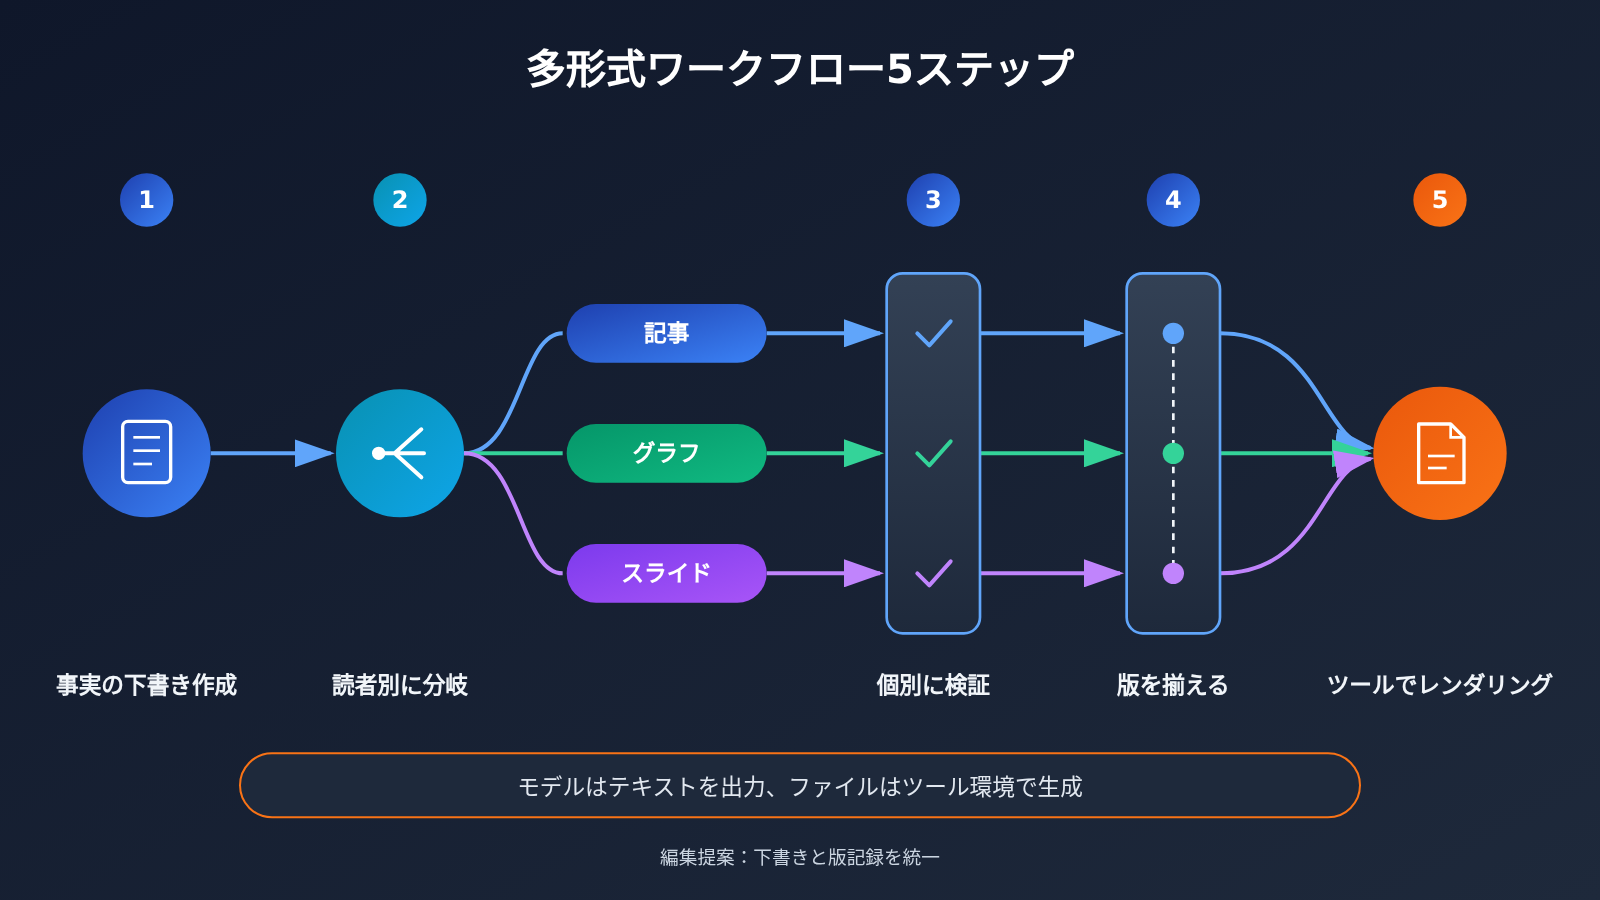
2.1 GPT-6.2 のマルチフォーマットワークフロー向けに事実のベース原稿を作成する
マルチフォーマットの成果物で誤りが生じるのは、多くの場合、文章作成の問題ではなく、元となる事実が固定されていないことです。まず資料を1件ごとの事実に分解し、それぞれに出典、日付、単位、不確実性を記録することをおすすめします。ベース原稿がいったん確定したら、以降のすべての成果物はここからだけ素材を得るようにし、成果物ごとに原資料を参照し直すのではなくなります。
| 事実 | 出典 | 日付 | 単位 | 不確実性 |
|---|---|---|---|---|
| OpenAI が GPT-6.2 Astra と Sol を公開 | 公式発表ページ | 2026-11-17 | なし | 低 |
| 公式発表でテンプレートへの準拠および文書/スライド/表計算の機能に言及 | 公式発表ページ | 2026-11-17 | なし | 宣伝的な説明であり、効果は自身で検証が必要 |
| IMC のブリーフィングとインフォグラフィックに関するフィードバック | 発表ページでの引用 | 2026-11-17 | なし | 単一顧客のフィードバックであり、一般化はできない |
| 通常の Chat は今回のリリースでは未提供 | ヘルプページ | 2026-11-18 に確認 | なし | 今後変更の可能性あり |
| Work/Codex は段階的に提供開始、API はすでに公開済み | ヘルプページとリリース告知 | 2026-11-18 に確認 | なし | アカウントごとの開放時期は不確定 |
「単位」欄はこの例ではすべて「なし」ですが、価格、ユーザー数、性能データを含む資料では、まさにグラフへの転記時に最も誤りが生じやすい項目です。「不確実性」欄は、ある事実をスライドの結論ページに載せられるかどうかを決めます。
2.2 読者の目的に応じて記事・図表・プレゼンテーションを分岐させる
同じ原稿でも、想定する読者が異なれば取捨選択の仕方も変わります。記事の読者は推論の過程を読みたいと望み、図表の読者はデータの関係を素早く把握したいだけであり、スライドの聴衆は1ページにつき1つの明確な結論を求めています。
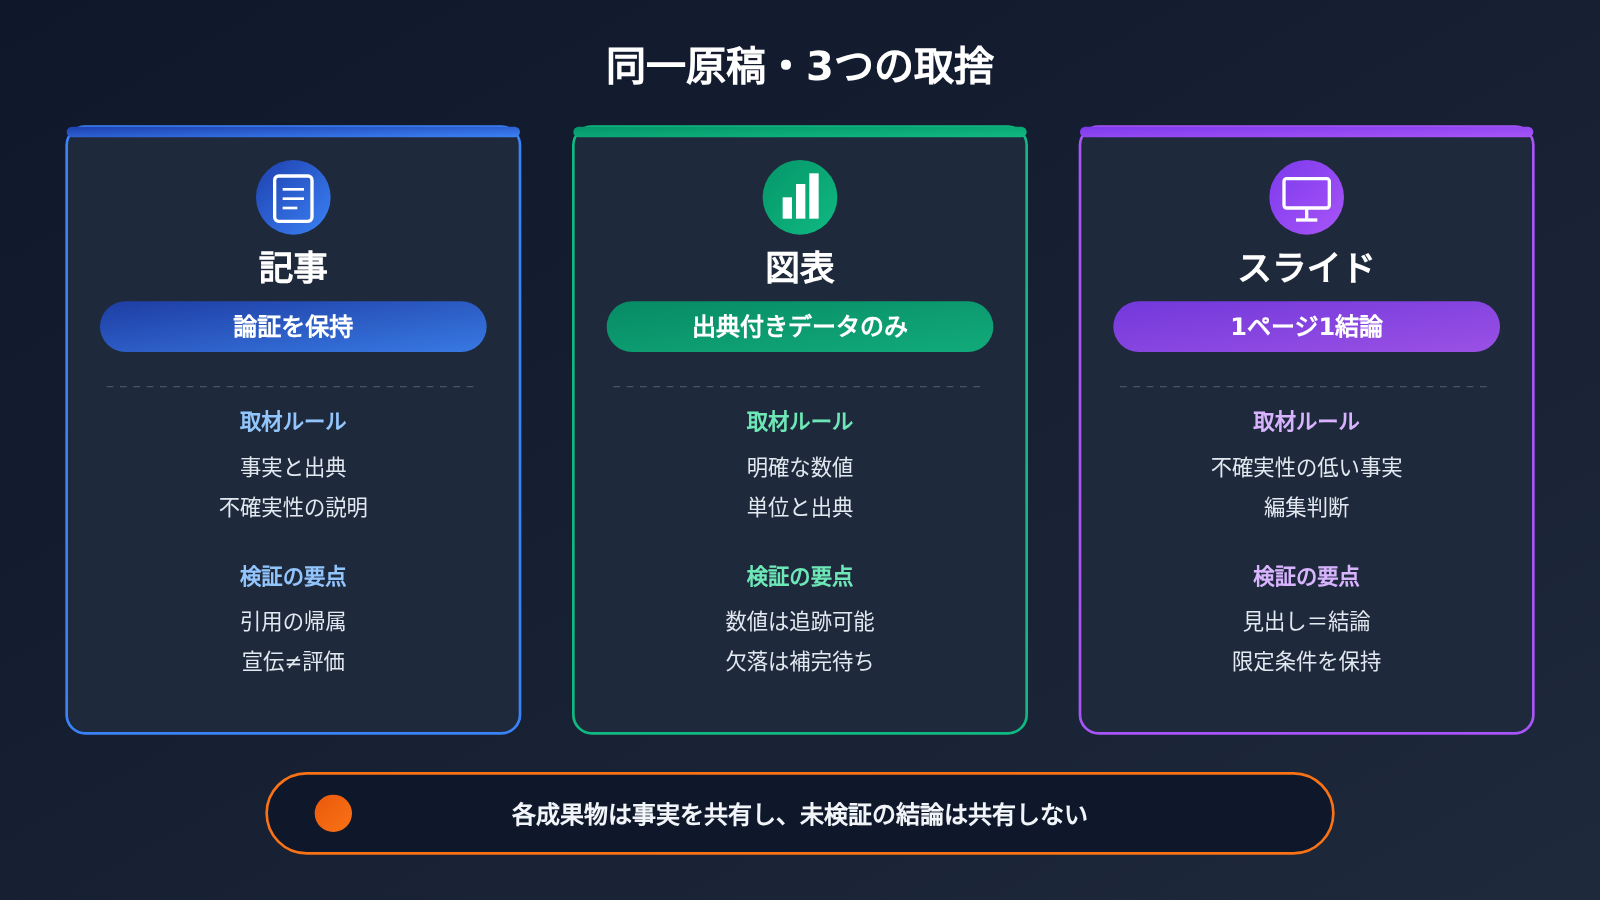
| 成果物 | 基本原則 | 原稿から何を取るか | よくあるリスク |
|---|---|---|---|
| 記事 | 論証を残す | 事実 + 出典 + 不確実性の説明 | 宣伝的な記述を評価結論として書いてしまう |
| 図表 | 出典のあるデータのみ提示 | 明確な数値・単位・出典がある項目 | データが欠けていると「もっともらしい」数字を補ってしまう |
| スライド | 1ページ1結論 | 不確実性の低い事実 + 編集判断 | 圧縮時に限定条件を失ってしまう |
本記事のサンプル原稿を例に挙げると、数値型の事実が一切含まれていないため、データ図表には適していません。むしろタイムラインやチャネルの開放状況を示す図のほうが適しています。この点は非常に重要です。モデルに無理やり「比較図を作って」と指示すると、資料に存在しない数字を補ってしまう恐れがあります。
編集メモ:プロンプトに「原稿中の項目のみを使用し、不足しているデータは『要補足』と明記する」と書き、各成果物の出典リストを保持してください。
2.3 GPT-6.2の出力における数値・引用・レイアウトを個別に検証する
3種類の成果物では検証の重点が異なるため、分けて処理することをお勧めします。「全体として問題なさそう」と一度確認するだけで済ませないでください。
- 数値検証:図表中の各数値は、ベース原稿の中に対応する項目が見つかるはずで、単位と日付が一致している必要があります。
- 引用検証:記事中でIMCのフィードバックに言及する表現では、「公開ページに引用された顧客フィードバック」という出典表示を必ず保持しなければなりません。
- レイアウト検証:スライドのタイトルがそのまま結論になっているか、テンプレートの要素が正しく踏襲されているか。公式が強調するテンプレート遵守能力こそ、この段階で実際に確認すべき対象です。
- 境界検証:すべての成果物において、「通常のChatで利用可能になった」といったヘルプページと矛盾する表現が現れてはなりません。
2.4 記事・図表・プレゼンテーション間でバージョンを揃える
マルチフォーマット作業で最も見落とされやすい問題はバージョンドリフトです。記事の表現を一箇所変えても、スライドは古いバージョンのまま残ってしまいます。ベース原稿にバージョン番号を付与し、各成果物にそれが依拠するベース原稿のバージョンを記録しておくことをお勧めします。ヘルプページの公開状態が更新されたときは、ベース原稿を修正するだけで済み、その後バージョン番号に基づいて、どの成果物を同期する必要があるかを一括で確認できます。
2.5 ファイルを生成し、実際の納品結果を確認する
開発環境がある場合は、まずモデルに記事本文、グラフの仕様、ページごとのアウトラインを返させ、その後で文書作成・作図・スライド作成のツールに渡すことができます。Work を使う場合は、編集可能なファイルの納品を明確に要求し、テンプレート、フォント、ページ比率を指定してください。ここで示しているのは推奨フローであり、実際の呼び出しや添付ファイルの生成は行っていません。
コピーして使えるタスク説明:
添付の下書きに含まれる検証済みの事実のみを使用してください。まず不足している情報を列挙し、その後、それぞれを準備してください:論証と出典を保持した文章、既存データのみを使ったグラフ案、1ページに1つの結論を置くプレゼン資料のアウトライン。数値データがない場合は、架空の棒グラフではなく関係図を使ってください。すべての成果物に下書きのバージョンを明記してください。ファイル完成後、検証できない内容を報告し、未完成の部分を完成と称さないでください。
ファイル生成後は、もう一度受け入れ確認を行います。文書を開いて段落と改ページを確認し、グラフを開いて座標とラベルを照合し、スライドはページごとに文字のはみ出し、重なり、フォント欠落がないかをチェックします。ソースデータの照合は、こうしたレンダリング後の確認の代わりにはなりません。
2.6 リスクと受け入れ基準
公式の能力説明をチームのプロセスに落とし込む際、あらかじめ規範に書き込んでおくべきリスクがいくつかあります。
- 宣伝と評価の混同:公開ページの能力説明や IMC のフィードバックは、独立した評価ではありません。対外コンテンツでは「実証済み」と書くべきではありません。
- チャネルの誤認:通常の Chat は今回未リリースのため、チームメンバーが異なる入口で操作すると、得られる結果が同じモデルによるものではない可能性があります。
- ファイル能力の誤認:モデルが出力するのはテキストであり、ファイルの品質はレンダリングツールやテンプレート自体に大きく依存します。
- 数値補完のリスク:資料にデータが欠けているときにグラフ生成を求めると、出典のない数値が入りやすくなります。
- 鮮度リスク:段階的な開放は状態が変わることを意味します。下書きに含まれる公開情報には、確認日を明記してください。
コンテンツクリエイターはまず下書きと引用を固定するとよいでしょう。ナレッジワーカーは自社のテンプレートを使って実際のレイアウトを確認できます。開発者は、モデル呼び出し、ファイル生成、受け入れ確認を独立した工程に分けるべきです。パイロットの結果は、次の3つの指標で記録することをおすすめします。事実修正の回数、レイアウトの手戻り回数、最終的な編集可能ファイルが受け入れ確認を通過したかどうかです。これにより、新しいモデルが単に成果物の数を増やすだけでなく、自分の仕事を本当に改善しているかを判断できます。
モデルの能力は進化していますが、「まず事実を固定し、次に読者に応じて分岐し、最後に項目ごとに検証する」という順序は、モデルによって変わるものではありません。ツールが強力になるほど、それを扱うための明確な情報整理の方法が必要になります。まさに「工欲善其事、必先利其器」(『論語・衛霊公』)です。


