
著者注:Apple がエンジニアの1日あたりのトークン予算を300ドルから200ドルに引き下げたというニュースをきっかけに、予算の段階設定、例外承認、モデルの階層化、使用量のモニタリングという4つの仕組みを解説します。企業チームがAI呼び出しのコストを管理するための参考にしてください。
Bloomberg の報道によると、Apple は先月、一部のエンジニアの1日あたりのトークン予算を300ドルから200ドルに引き下げました。今後は1日100ドルまで下げる計画もあり、一部の非技術系チームでは25ドルにとどまる可能性があります。より多くの予算が必要な従業員は経営陣に例外を申請できます。また、一部のチームは、より安価なモデルや端末上で動作するローカルAIへの移行を促されることもあります。
これは単なるうわさではありません。The Decoder は2026年11月5日、Bloomberg の報道を引用して上記の数字を伝え、Microsoft、Tesla、Uber、Meta も最近、社内のAI支出に上限を設けたと指摘しています。大企業が「自由に使う」方針から「予算内で使う」方針へと転換していることは、AI呼び出しのコストが企業の経営層にとって正面から取り組むべき課題になったことを示しています。
この記事でわかること:Apple が今回トークン予算を引き締めた具体的な方法を紹介するとともに、企業ですぐに活用できるAI呼び出しのコスト管理フレームワークを解説します。予算の段階設定、例外承認、モデルの階層化、使用量のモニタリングがその柱です。
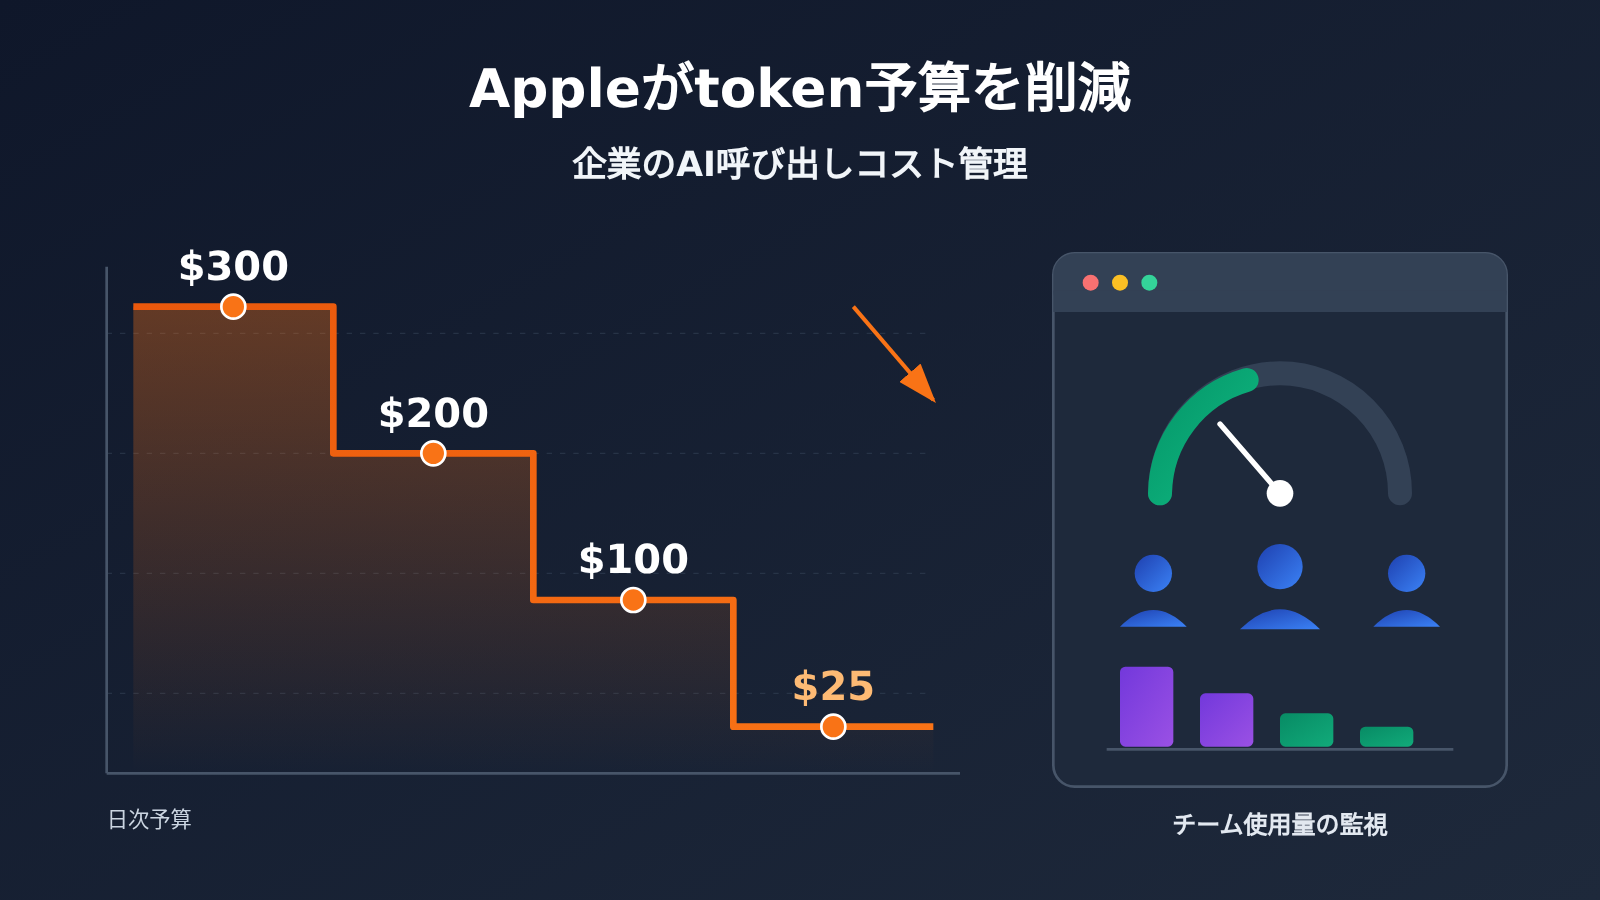
Apple の token 予算引き下げ:主要情報まとめ
| 項目 | 詳細 |
|---|---|
| 情報源 | Bloomberg の報道を The Decoder が 2026-11-05 に伝達 |
| 調整対象 | 一部のエンジニアと非技術系チーム |
| 実施済みの調整 | 先月、1 日あたりの token 予算を 300 ドルから 200 ドルに引き下げ |
| 今後の計画 | 1 日 100 ドルまで引き下げる可能性があり、一部の非技術系チームでは 25 ドルになる可能性も |
| 上限を超える場合 | 従業員は管理職に例外を申請可能 |
| 利用可能なモデル | Anthropic Claude、OpenAI ChatGPT、Google Gemini など |
| 代替策 | 一部のチームは、より安価なモデルやデバイス上で動作するローカル AI に移行 |
| 背景 | 新 CEO の John Ternus が効率化を推進。2026 会計年度の研究開発費は 32% 増加し、その主な要因はインフラと AI のコスト |
| 業界の動向 | Microsoft、Tesla、Uber、Meta も最近、社内の AI 支出を制限 |
Apple の token 予算調整に関する 3 つのポイント
1 つ目は、予算が 1 人あたり、1 日単位で設定されていることです。Apple は部門ごとに年間予算の総額を割り当てるだけでなく、「1 人あたり 1 日いくら」という枠を設けています。この単位なら、従業員が自分の AI 利用コストを直接把握でき、管理職も職務に応じて予算を配分しやすくなります。
2 つ目は、技術系と非技術系のチームで予算枠が分かれていることです。エンジニアの目標額は 100 ドル前後ですが、一部の非技術系チームでは 25 ドルになる可能性があり、4 倍の差があります。Apple は、コーディングや Agent の実行といった作業では、メールの作成や要約とは token の消費量が大きく異なると考えているようです。
3 つ目は、上限を超えて利用する余地があることです。従業員は例外を申請でき、一部のチームには、より安価なモデルやローカルモデルの利用が勧められています。この取り組みの核心は「AI の利用を減らす」ことではなく、「高価な計算資源を、それに見合うタスクに使う」ことです。ただし、Apple がモデルのグレードをどう分け、上限をどのように運用するかは報じられておらず、今後の情報を待つ必要があります。
AIの利用コストが大企業のtoken予算を圧迫する理由
AIの利用コストが従来のソフトウェアサブスクリプションと大きく異なるのは、従量課金であり、限界費用がゼロではないことです。従業員が同じSaaSツールを1日に100回開いても料金は変わりませんが、大規模言語モデルに毎日100本の長文文書を読ませれば、そのたびにtoken料金が発生します。利用者が数万人に拡大すると、この支出は急速に膨らみます。
Appleの2026会計年度の研究開発費は32%増加し、報道では、インフラとAIのコスト上昇がその要因だと明記されています。新CEOが事業の効率化を進めるなか、社内のAI支出は金額を把握しやすく、調整しやすい項目です。Microsoft、Tesla、Uber、Metaなども同時期に制限を設けており、これは一社だけの偶然の決定ではないことがうかがえます。
社内の反応を見ると、従来の利用枠はもともと大きすぎ、1日300ドルの上限を使い切ることは大半の職種ではない、との声もあります。これはよくある問題を示しています。多くの企業はAI導入の初期段階で十分に試算しないまま利用枠を設定しており、後から制限を厳しくすると議論を招きやすいのです。
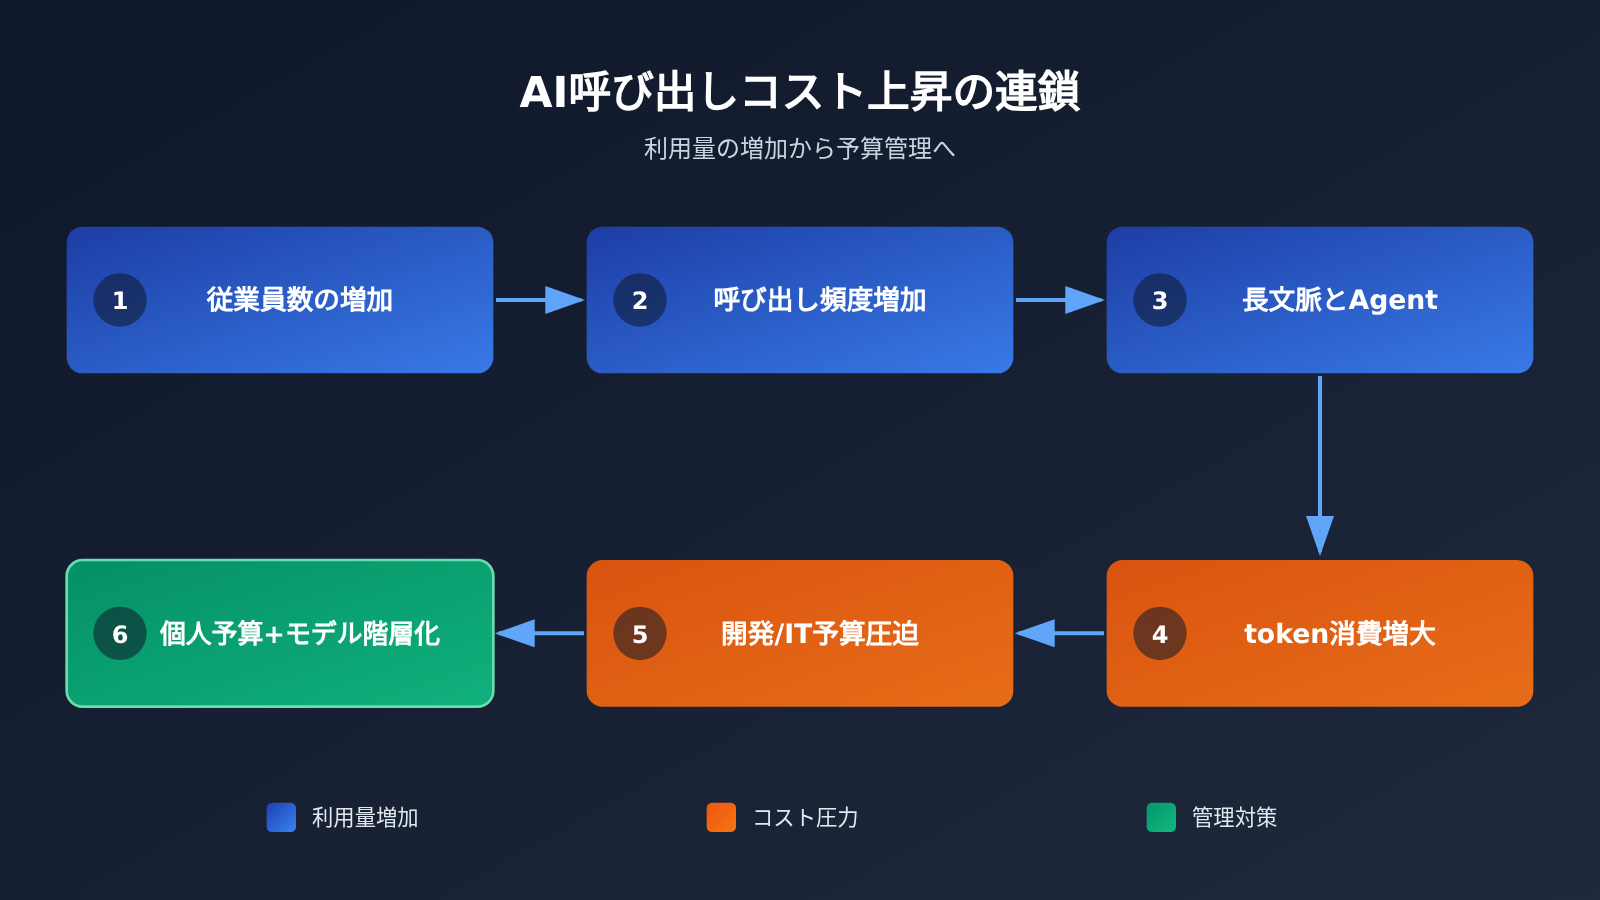
企業チームが AI の利用コストを管理する4つの仕組み
Apple の取り組みをひもとくと、他の企業でも応用できる4つの管理の仕組みが見えてきます。予算で上限を定め、承認フローで柔軟性を確保し、モデルの使い分けでコストを抑え、モニタリングで運用を徹底します。
仕組み1:役割に応じて token 予算を段階的に設定する
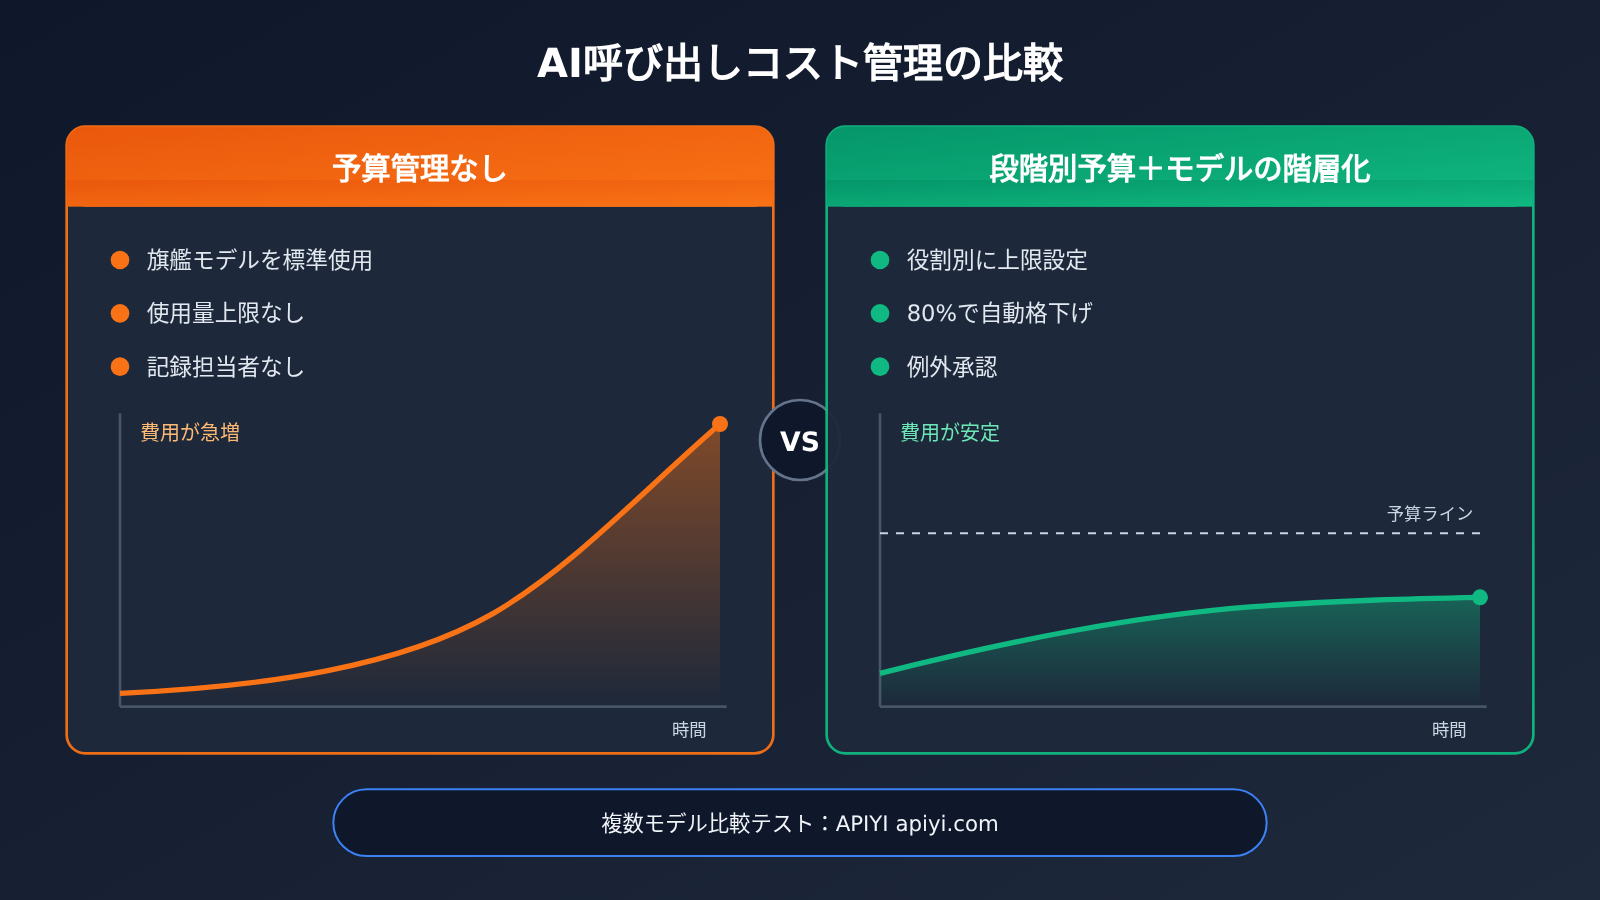
一人あたりの予算で重要なのは、「一律」ではなく「段階的」に設定することです。AI の使い方は職種によって大きく異なります。全員に同じ上限を設けると、エンジニアには足りない一方、利用頻度の低い人の枠は長期間使われないままになりかねません。以下は Apple の考え方を参考にした段階別の例です。具体的な金額は、チームの過去の利用量をもとに算出してください。
| 役割の区分 | 主なタスク | 予算の考え方 | デフォルトのモデル区分 |
|---|---|---|---|
| 中核の研究開発担当 | コード生成、Agent を使ったプログラミング、長文ドキュメントの分析 | 高めの枠を日単位で設定し、例外申請も可能にする | フラッグシップモデル + 中位モデル |
| 一般の技術職 | コードレビュー、スクリプト作成、技術ドキュメント | 中程度の枠。Apple が計画するエンジニア向け区分に近い水準 | 中位モデルが中心 |
| 非技術系の業務担当 | メール、要約、翻訳、資料整理 | 低めの枠。Apple の最低25ドルの区分を参考にする | 軽量モデルが中心 |
| 試験導入 / 新規プロジェクト | 探索的な検証 | 期限を設けた一時的な専用枠 | 必要に応じて利用を許可 |
区分を設定する際は、まず過去1〜3か月の実際の利用量を取得し、職種ごとの中央値と高い水準の利用量を確認しましょう。そのうえで、予算を中央値より上、高い水準の利用量より下に設定するのがおすすめです。こうすれば、ほとんどの人は日常業務で十分に使え、少数のヘビーユーザーは例外フローで対応できるため、管理の手間を抑えられます。
仕組み2:一律制限ではなく、例外を承認する
Apple が上限を超えた従業員に対し、管理職への例外申請を認めている点は参考になります。完全に上限を固定すると重要なタスクが途中で止まりかねません。一方、上限がまったくなければ、予算を設ける意味がなくなります。例外承認の設計では、次の点を参考にできます。
- 申請条件を明確にする:例えば、1日分の利用枠を使い切った場合や、特定のプロジェクトで数日間にわたって高頻度の呼び出しが必要な場合;
- 承認の有効期間を限定する:例外枠は日単位またはプロジェクト単位で付与し、期限が来たら自動的に回収する。「一時的」な措置が「恒久的」になるのを防ぐ;
- 簡単な説明を求める:タスクの種類と期待する成果を明記してもらい、AI の呼び出しコストに見合う価値があったかを後から振り返れるようにする;
- 月ごとに集計して振り返る:同じ人やチームが頻繁に例外を申請している場合は、基本予算が低すぎる可能性がある。承認を繰り返すのではなく、予算の区分を見直す。
仕組み3:モデルの階層化と自動切り替え
報道によると、Apple は一部のチームをより安価なモデルや端末上で動作するローカル AI に移行させています。これは、AI の呼び出しコストを抑えるうえで最も効果的な手段である、タスクの難易度に応じたモデルの使い分けにつながります。日常的なタスクの多くは軽量モデルで対応でき、フラッグシップモデルが本当に必要なのは一部の複雑なタスクだけです。
| モデルの区分 | 適したタスク | コストの特徴 | 利用可能なプラットフォーム |
|---|---|---|---|
| フラッグシップモデル(Claude、GPT、Gemini の上位モデルなど) | 複雑な推論、複数ファイルにまたがるコードの修正、重要な意思決定の分析 | 単価が最も高く、必要に応じて使用 | APIYI apiyi.com、各社の公式 API |
| 中位モデル | 通常のプログラミング、技術文書の作成、構造化データの抽出 | 品質とコストのバランスがよい | APIYI、各社の公式 API |
| 軽量モデル | 要約、翻訳、分類、書式の整理 | 単価が低く、高頻度の呼び出しに適している | APIYI、各社の公式 API |
| 端末上 / ローカルモデル | 機密性の高い処理、オフラインでの利用、簡単な補完 | 従量課金はないが、ハードウェアと運用・保守のコストがかかる | ローカル環境へのデプロイ |
自動切り替えの一般的なルールは、使用量が予算の一定割合(80%など)に達したら、重要度の低いタスクを自動的に一段下のモデルに切り替えることです。利用枠を使い切った後は軽量モデルだけを使えるようにするか、例外承認に進みます。これなら従業員が突然モデルを使えなくなることを避けられ、作業もスムーズに続けられます。モデルごとの実際の単価差は各プラットフォームの最新料金によるため、導入前に試算することをおすすめします。
💡 選び方のポイント:モデルを階層化するには、複数のモデルを手軽に切り替えられることが前提です。APIYI apiyi.com のような集約プラットフォームなら、1つの APIキーで OpenAI、Claude、Gemini などのモデルを呼び出せます。インターフェースは OpenAI 形式と互換性があるため、階層に応じたルーティングでは model パラメータを変更するだけで済みます。
仕組み4:利用量の監視で予算を実効性のあるものにする
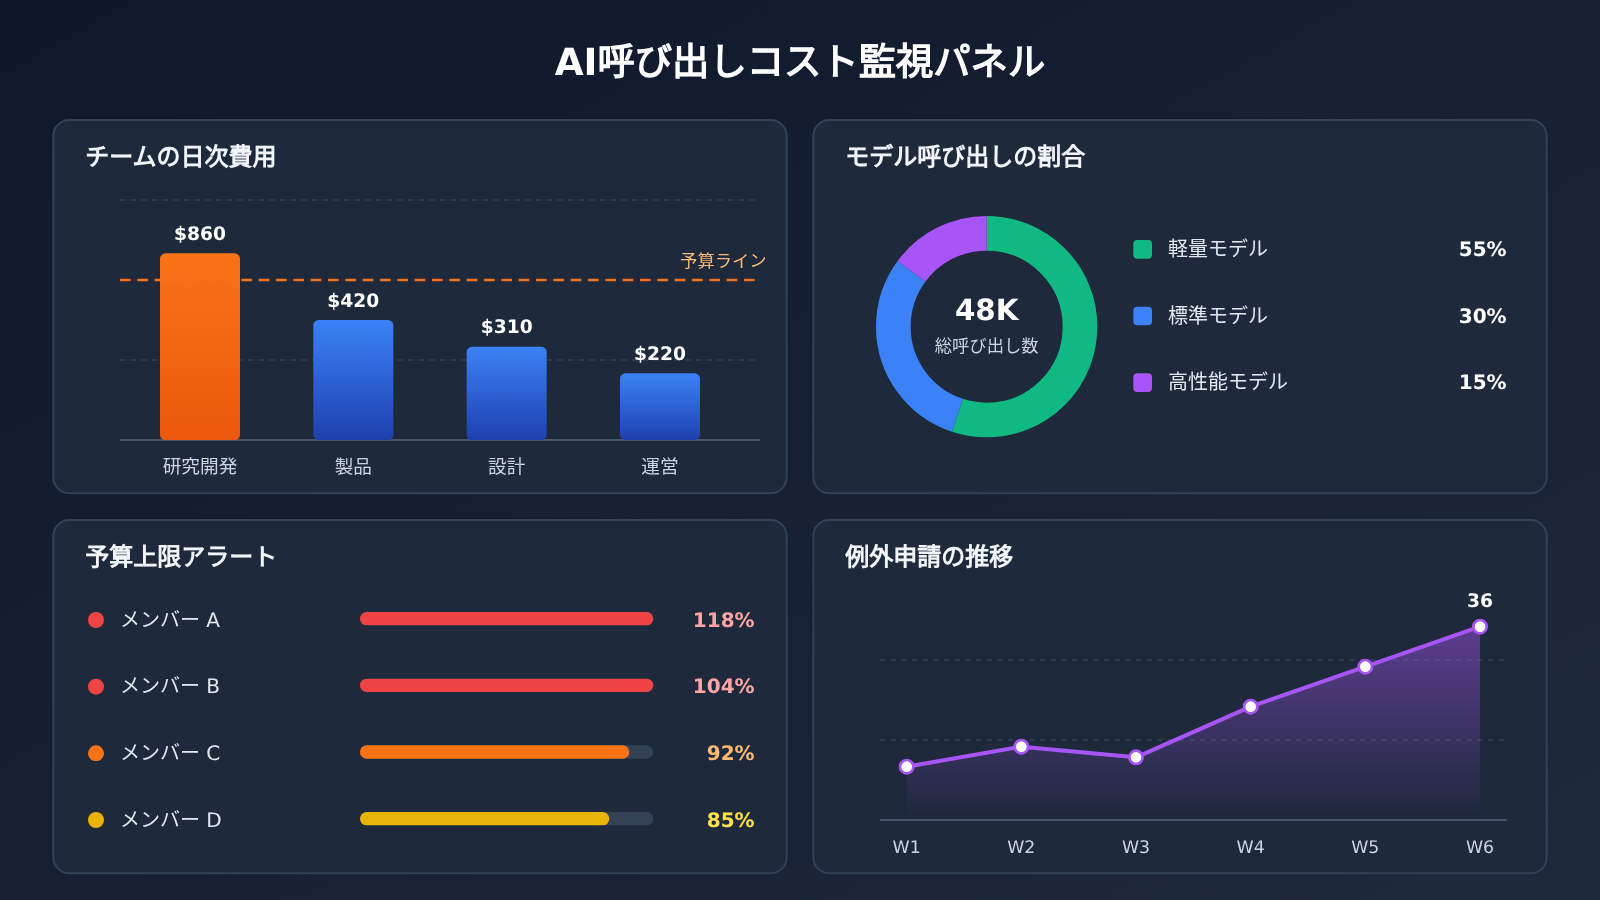
監視がなければ、1人当たりのトークン予算は形だけのルールになってしまいます。監視の目的は「予算超過を見つける」ことだけではありません。予算やモデルを段階的に分けるためのデータを得ることが、より重要です。少なくとも以下の指標を追跡することをおすすめします。
| 監視指標 | 集計単位 | 用途 |
|---|---|---|
| 日ごとのトークン消費量と費用 | 個人別、チーム別 | 予算が適切かを判断し、異常な呼び出しを発見する |
| モデル別の呼び出し割合 | チーム別、タスクの種類別 | モデルの使い分けが機能しているかを評価する |
| 予算上限への到達頻度 | 個人別、週別 | 予算の区分を見直す必要がある職種を特定する |
| 例外申請の件数と承認率 | チーム別、月別 | 承認基準が緩すぎないか、厳しすぎないかを振り返る |
| タスク当たりの平均コスト | タスクの種類別 | 優先的に最適化すべき高コストなケースを見つける |
技術面では、社内のAIゲートウェイで各リクエストの usage フィールドを記録し、従業員やチームのタグに基づいて集計できます。サードパーティのプラットフォームを利用する場合は、利用量の統計単位が費用配賦のニーズを満たせるか、あらかじめ確認しましょう。サブアカウントやメンバーごとの上限設定、アラートに対応しているかどうかは、各プラットフォームの実際の機能を確認してください。
AIの利用コスト管理を始めよう:予算を考慮したモデルルーティング
まずはシンプルな例で、「ユーザーごとの予算+自動ダウングレード」をコードに落とし込む方法を見ていきます。最初は基本的なモデル呼び出しです。ポイントは、リクエストごとに返されるトークン使用量を読み取ることです。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIの統一インターフェース。1つのキーで複数社のモデルを呼び出せます
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 日常的なタスクには軽量モデルを優先
    messages=[{"role": "user", "content": "把这段会议纪要整理成 5 条要点:..."}]
)
print(resp.choices[0].message.content)
print("本次消耗 tokens:", resp.usage.total_tokens)
完全な実装を見る:役割別予算+自動ダウングレードルーティング
from collections import defaultdict
from datetime import date
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# モデルの階層:プラットフォームで実際に利用できるモデル名に置き換えてください
TIERS = ["your-premium-model", "your-standard-model", "your-light-model"]

# 単価のプレースホルダー(米ドル / 100万トークン)。プラットフォームの最新料金を入力してください
PRICE = {
    "your-premium-model":  {"in": 0.0, "out": 0.0},
    "your-standard-model": {"in": 0.0, "out": 0.0},
    "your-light-model":    {"in": 0.0, "out": 0.0},
}

# 役割ごとの日予算(米ドル)。Appleの階層化の考え方を参考にしています
DAILY_BUDGET = {"engineer": 100, "non_tech": 25}

spent = defaultdict(float)   # (user, date) -> 当日の使用額
exceptions = set()           # 例外が承認された (user, date)


def pick_model(user: str, role: str, preferred: str) -> str:
    key = (user, date.today())
    budget = DAILY_BUDGET[role]
    used = spent[key]
    if key in exceptions:
        return preferred
    if used >= budget:
        return TIERS[-1]                      # 予算を使い切った場合:軽量モデルのみ利用可能
    if used >= budget * 0.8:
        idx = min(TIERS.index(preferred) + 1, len(TIERS) - 1)
        return TIERS[idx]                     # 上限に近づいた場合:1段階下げる
    return preferred


def chat(user: str, role: str, prompt: str, preferred: str = "your-standard-model"):
    model = pick_model(user, role, preferred)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    p = PRICE[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    spent[(user, date.today())] += cost
    print(f"[{user}] model={model} cost=${cost:.4f} today=${spent[(user, date.today())]:.2f}")
    return resp.choices[0].message.content


# 使用例
print(chat("alice", "non_tech", "把这封邮件翻译成英文:..."))
この例では、永続化ストレージ、並行処理、承認フローを省略しています。本番環境では、spent をデータベースやキャッシュに保存し、例外の承認を社内のチケットシステムと連携させることをおすすめします。基本的な考え方は変わりません。呼び出しごとに費用を記録し、ルーティング前に予算を確認します。
🚀 クイックスタート:まず階層別ルーティングの効果を検証したい場合は、APIYI apiyi.com で新規ユーザー向けの無料テスト枠を取得できます。同じキーを使って、実際のタスクで異なる階層のモデルの品質と消費量を比較し、それから各職種のデフォルトモデルを決めましょう。
Appleのtoken予算調整による影響分析
開発者への影響
- コスト意識が基本スキルに:大企業の開発者は、各タスクで消費するtoken数に目を向け、長いコンテキストや繰り返しのリトライなど、消費量の多い操作を控えめに使う必要があります。
- 複数モデルを使い分ける能力がより重要に:タスクに合ったモデルを選び、簡単なタスクを軽量モデルやローカルモデルに任せられる開発者は、予算が引き締められても効率的に作業できます。
- AIゲートウェイとルーティング層への需要が増加:企業には利用状況の記録、利用枠の設定、下位モデルへの切り替えを行うための統一窓口が必要になり、こうした社内インフラの開発が増えるでしょう。
企業の管理者への影響
- 「利用の奨励」から「きめ細かな運用」へ:AIの呼び出しコストが通常の予算管理に組み込まれ、クラウドリソースと同じように費用を部門別に配分し、振り返る必要があります。
- 予算額には根拠が必要:Appleの従業員が従来の利用枠を「緩すぎる」と考えていたことは、利用枠を根拠なく決めると、後になって調整コストが生じることを示しています。
- 組織内のコミュニケーションリスクを軽視しない:報道によると、一部の従業員はコスト削減が人員削減の前兆ではないかと懸念しています。十分な説明なしに予算を引き締めると、より大きな組織変更の兆候だと受け止められかねません。
下表では、企業がAIの呼び出しコストを管理する際によくある組織上のリスクと、その対策をまとめています。
| リスク | 具体的な状況 | 対策 |
|---|---|---|
| 従業員の不安 | 利用枠の制限を人員削減の兆候と受け止める | コスト構造の最適化が目的であると事前に説明し、段階別の基準を公開する |
| 生産性の低下 | 利用枠が足りず、重要なタスクが中断する | 一律に利用を停止するのではなく、下位モデルへの自動切り替えを設定し、例外を迅速に申請できる仕組みを設ける |
| 見えない超過支出 | 従業員が個人アカウントや未承認のツールに切り替える | 社内の利用手段を十分に使いやすいものにするとともに、コンプライアンス要件を徹底する |
| 承認の負担 | 例外申請が多すぎて、管理者が承認に追われる | データに基づいて基本利用枠を定期的に引き上げ、不要な申請を減らす |
| 効果の評価が困難 | 支出だけを見て、成果を見ていない | タスクごとのコストと成果の品質を併せて振り返る |
よくある質問 FAQ
Q1:Apple は今回、token 予算を具体的にいくら引き下げたのですか?
Bloomberg の報道によると、Apple は先月、一部のエンジニアの1日あたりの token 予算を300ドルから200ドルに引き下げました。今後は1日100ドルまで下がる可能性があり、一部の非技術系チームでは25ドルまで抑えられています。より多くの予算が必要な従業員は、管理職に例外を申請できます。
Q2:1人あたりの token 予算は、どのように決めるのが適切ですか?
まず過去1〜3か月の職種ごとの実際の使用量を集計し、役割に応じて段階を設けることをおすすめします。基本予算は使用量の中央値より高く、使用量の多い人の水準より低く設定します。ヘビーユーザーには例外申請で予算を追加し、上限に達した頻度や例外申請の回数に応じて毎月見直します。
Q3:Apple のほかに、社内の AI 支出を制限している企業はありますか?
報道では、Microsoft、Tesla、Uber、Meta も最近、社内の AI 支出に上限を設けたと伝えられています。ただし、各社の具体的な方法や金額は明らかにされていません。
Q4:モデルを段階的に使い分けると、従業員の仕事の品質に影響しませんか?
重要なのは、一律にグレードを下げるのではなく、タスクに応じてモデルを割り当てることです。要約、翻訳、書式の整理などには通常、軽量モデルで十分です。複雑な推論や重要なコードの修正は、フラッグシップモデルに任せます。導入前には実際のタスクで比較テストを行うことをおすすめします。例えば、APIYI apiyi.com で同じ Key を使って複数のグレードのモデルを試し、品質に問題がないことを確認してからデフォルトのグレードを決めましょう。
Q5:社内に AI ゲートウェイがない中小チームは、どうすればすぐに AI 呼び出しのコスト管理を始められますか?
まずは、呼び出しの窓口を統一する、各リクエストの usage をコード内に記録する、タスクごとにデフォルトモデルを設定する、という3ステップから始められます。APIYI apiyi.com のような集約プラットフォームを使えば、1つの Key で OpenAI、Claude、Gemini などのモデルを切り替えられ、従量課金で利用できるため、まずは複数モデルのルーティングを試すのに便利です。メンバーごとの利用上限やアラートに対応しているかどうかは、プラットフォームに直接確認することをおすすめします。
AI呼び出しコスト管理の要点 Key Takeaways
- Appleは予算を引き締め済み:エンジニアの1日あたりのtoken予算を300ドルから200ドルに引き下げ、さらに削減する予定です。
- 一律配分より段階的な設定:技術職と非技術職では利用量に大きな差があり、Appleの目標予算枠には4倍の開きがあります。
- 例外承認で柔軟性を確保:上限は絶対的なものではなく、重要な業務には一時的な追加枠を申請できます。
- モデルの使い分けが節約の鍵:日常業務は軽量モデルやローカルモデルに任せ、フラッグシップモデルは複雑なタスクに使います。
- モニタリングで予算を運用:個人・チームごとにtoken使用量と費用を記録し、データに基づいて予算枠を調整します。
- 組織内のコミュニケーションも不可欠:予算の引き締めは人員削減への不安を招きやすいため、目的を事前に説明する必要があります。
- まずはモデルの振り分けから:APIYI apiyi.com なら、1つのキーで異なるクラスのモデルを比較し、使い分け戦略を検証できます。
まとめ
Appleが従業員の1日あたりのtoken予算を引き下げたことは、大企業のAI活用が「規模の拡大」から「コストの精査」へと移りつつあることを示す明確なシグナルです。企業チームへの示唆は、次の3点にまとめられます。
- 予算を段階的に設定する:役割やタスクの種類に応じて1人あたりの予算枠を設け、直感ではなく過去のデータに基づいて金額を決める;
- 仕組みに柔軟性を持たせる:例外承認と自動的なモデルの切り替えを組み合わせ、利用が突然停止して重要な業務に影響が出るのを防ぐ;
- モデルを使い分ける:タスクに適したモデルを選び、利用状況のモニタリングと併せて継続的に最適化する。
チームでAI呼び出しのコスト管理を検討しているなら、まずは利用頻度の高いシナリオを1〜2つ選び、モデルの使い分けを試してみましょう。実際のコストと品質のデータを集めてから、適用範囲を広げるのがおすすめです。APIYI apiyi.com を使えば、複数モデルのテスト環境をすばやく構築できます。新規ユーザー向けの無料枠で、初期比較を行うことも可能です。
📚 参考資料
- Apple slashes internal AI budgets, with deeper cuts still planned:Bloomberg の報道を The Decoder が紹介した記事
- リンク:
the-decoder.com/apple-slashes-internal-ai-budgets-with-deeper-cuts-still-planned/ - 内容:Apple の1日あたりのトークン予算の調整額、従業員の反応、他社による AI 支出制限の背景情報を掲載
著者:APIYI 技術チーム
技術交流:企業における AI 呼び出しのコスト管理や複数モデルの導入について、APIYI 公式サイトのトップページからお気軽にお問い合わせください


