
Catatan penulis: Indikator reliabilitas apa saja yang perlu diperiksa saat memilih layanan proksi API atau agregator AI API untuk lingkungan produksi? Artikel ini membahas 10 indikator utama, proses validasi selama 7 hari, dan tabel evaluasi.
Banyak tim mulai menggunakan layanan proksi API atau agregator AI API dengan pertimbangan sederhana: “bisa terhubung dan harganya murah”. Masalahnya baru mulai terlihat setelah layanan digunakan di lingkungan produksi: error 429 meningkat pada jam sibuk, output streaming terputus di tengah jalan, jumlah token pada tagihan tidak cocok dengan catatan sendiri, atau perilaku model berubah dalam semalam. Artikel ini merangkum 10 indikator reliabilitas yang wajib diperiksa saat memilih layanan proksi atau agregator AI API untuk lingkungan produksi, lengkap dengan proses validasi selama 7 hari.
Ini bukan artikel perbandingan harga yang menyarankan untuk memilih layanan termurah. Kita hanya membahas satu hal: apakah layanan proksi atau agregator AI API mampu menangani lalu lintas produksi, dan apakah masalah yang muncul bisa dideteksi, dijelaskan, serta diberi kompensasi.
Manfaat utama: Setelah membaca artikel ini, kamu akan mendapatkan daftar periksa reliabilitas layanan proksi AI API yang bisa langsung digunakan untuk menilai, berdasarkan data, apakah suatu platform cocok untuk lingkungan produksi sebelum menandatangani kontrak atau mengalihkan lalu lintas.
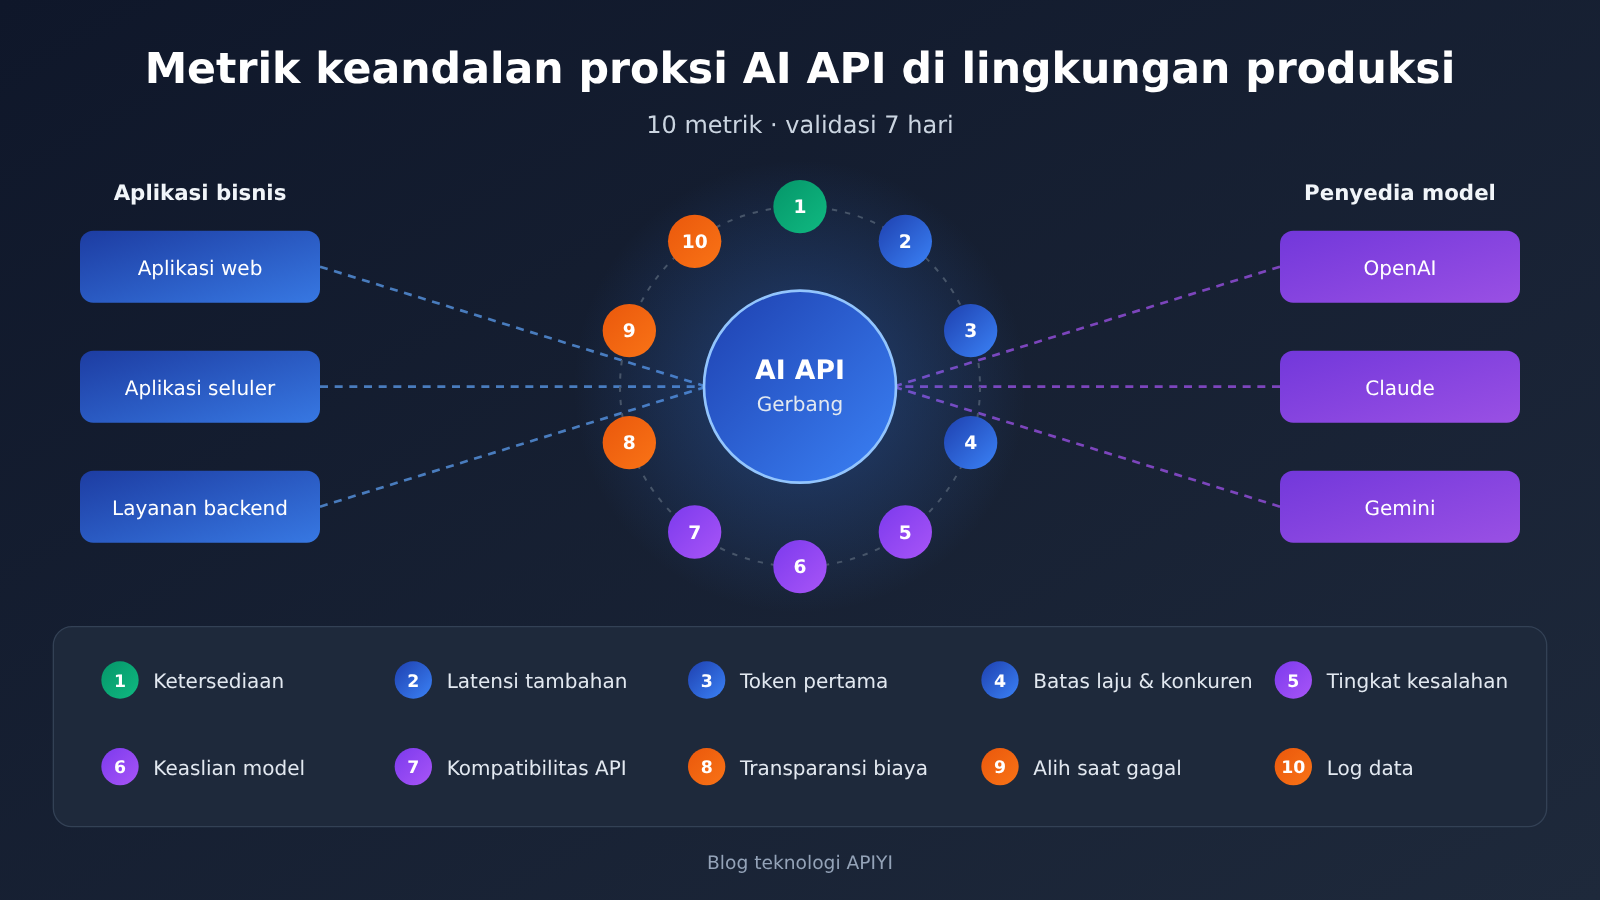
Poin penting keandalan layanan proksi dan agregasi AI API di lingkungan produksi
Sebelum mengevaluasi layanan proksi dan agregasi AI API, kelompokkan dulu metriknya. Keandalan bukan sekadar soal layanan aktif atau mati, tetapi juga apakah latensinya dapat diprediksi, hasilnya bisa dipercaya, dan tagihannya dapat diverifikasi. Tabel berikut membagi 10 metrik ke dalam empat kategori agar evaluasi lebih mudah dibagi.
| Kategori | Metrik utama | Hal yang perlu diperhatikan | Dampak pada produksi |
|---|---|---|---|
| Ketersediaan | Riwayat gangguan, halaman status, komitmen SLA | Frekuensi gangguan, waktu pemulihan, ketersediaan laporan evaluasi insiden | Menentukan apakah layanan bisnis bisa terus beroperasi |
| Kinerja | Latensi tambahan, waktu hingga token pertama, pembatasan laju dan konkurensi | Beban tambahan dari lapisan proksi, performa saat jam sibuk | Langsung memengaruhi pengalaman pengguna dan tingkat timeout |
| Konsistensi | Keaslian versi model, kompatibilitas antarmuka, transparansi kode kesalahan | Penggantian model tanpa pemberitahuan, kelengkapan streaming dan pemanggilan alat | Menentukan kualitas output dan stabilitas kode |
| Tata kelola | Transparansi penagihan, failover, kebijakan data dan log | Tagihan yang dapat diverifikasi, redundansi beberapa penyedia upstream, kepatuhan privasi | Menentukan apakah layanan bisa digunakan dengan tenang dalam jangka panjang |
Penjelasan metrik ketersediaan layanan proksi AI API
Ketersediaan adalah syarat pertama saat memilih layanan proksi AI API untuk lingkungan produksi. Jangan hanya melihat persentase yang dipromosikan platform. Periksa juga apakah ada halaman status publik, apakah riwayat gangguan bisa dilihat, dan apakah setiap gangguan disertai laporan evaluasi. Platform yang bersedia memublikasikan linimasa insiden biasanya lebih layak dipercaya daripada yang hanya mengklaim “ketersediaan tinggi”.
Sumber pihak ketiga bisa menjadi pembanding. Misalnya, dalam evaluasi OpenRouter untuk lingkungan produksi, blog Ofox.ai menyebutkan bahwa OpenRouter mengalami tiga gangguan yang tercatat antara 2025 hingga 2026 dan menambahkan latensi sekitar 25 hingga 40ms (sumber: Ofox.ai Blog, dikutip hanya sebagai pembanding). Data seperti ini bukan untuk menghakimi platform tertentu, melainkan mengingatkan bahwa setiap lapisan proksi memiliki risiko gangguan dan beban tambahan. Yang penting adalah apakah besarannya dapat diterima dan dilaporkan secara transparan.
Penjelasan kinerja dan konsistensi layanan agregasi AI API
Dari sisi kinerja, latensi tambahan pada lapisan proksi perlu dilihat dalam dua bagian: beban tetap akibat jaringan dan autentikasi, serta beban yang berfluktuasi akibat antrean saat jam sibuk. Bagian pertama biasanya stabil dan bisa diukur, sedangkan bagian kedua lebih sering menjadi sumber insiden di lingkungan produksi. Karena itu, lakukan pengujian pada jam sibuk bisnis Anda sendiri, bukan menyimpulkan hasil dari satu pengujian benchmark pada dini hari.
Dari sisi konsistensi, risiko yang paling sulit dideteksi adalah “penggantian” model. Saat kapasitas upstream terbatas, beberapa platform mungkin mengarahkan permintaan ke model yang lebih murah atau versi terkuantisasi. Antarmuka tetap mengembalikan 200, tetapi kualitas output menurun secara nyata. Periksa apakah field model dalam respons sesuai dengan permintaan, lalu lakukan pengujian regresi secara berkala menggunakan kumpulan soal yang sama untuk melihat apakah gaya output dan tingkat akurasi berubah drastis.
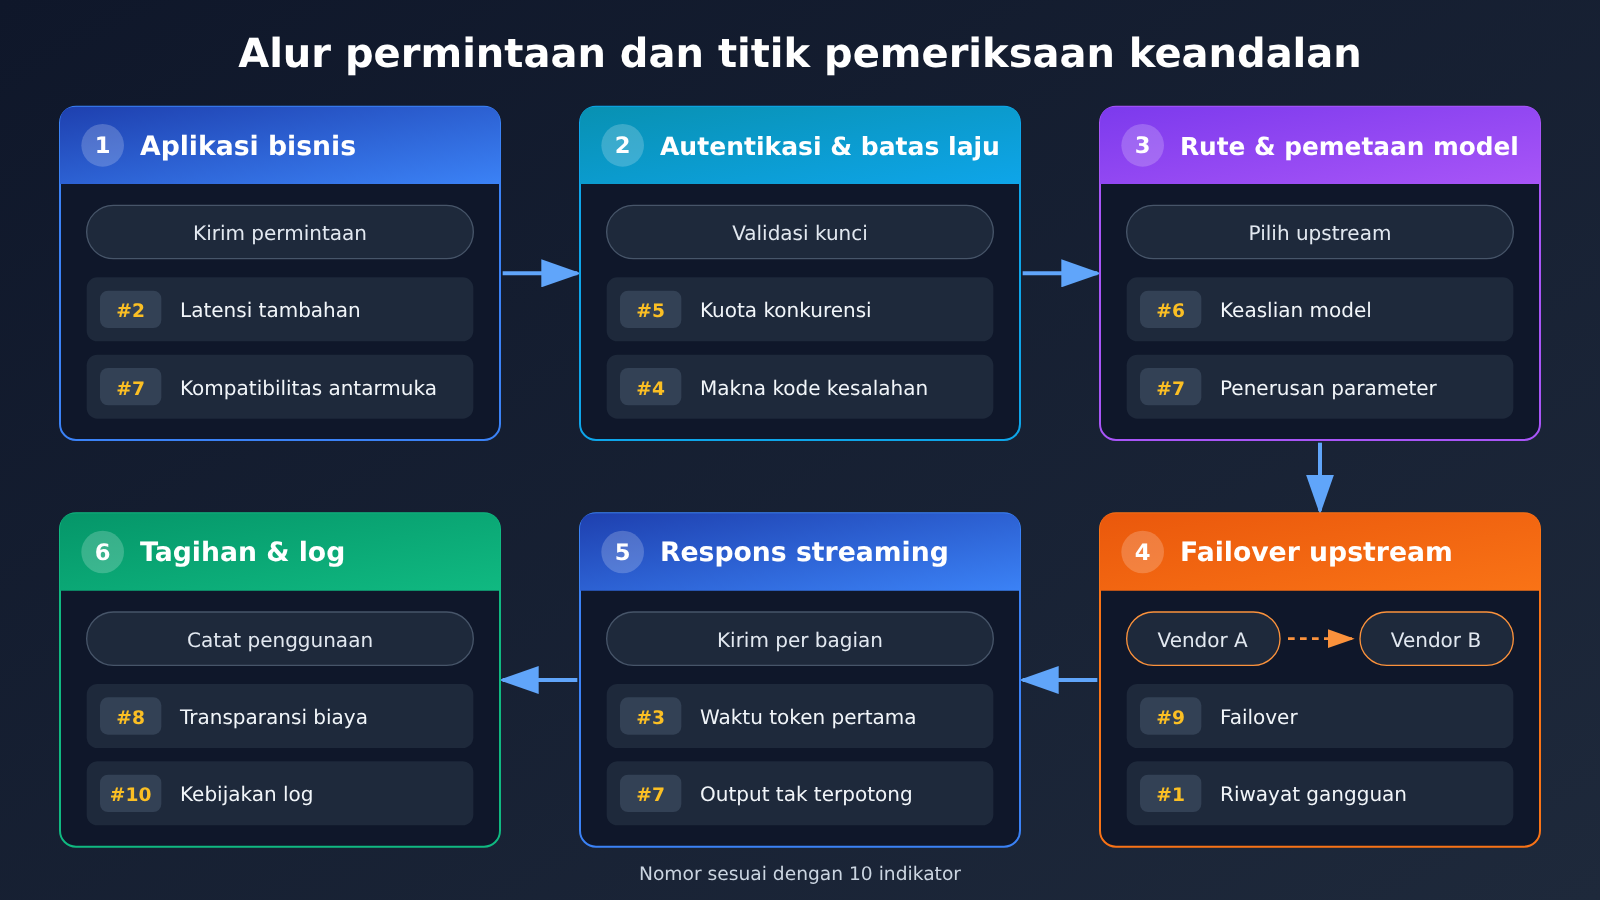
Pemeriksaan 10 indikator keandalan layanan proksi AI API di lingkungan produksi
Tabel berikut adalah daftar pemeriksaan utama dalam artikel ini. Setiap indikator dilengkapi cara pemeriksaan dan standar kelulusan yang disarankan. Kamu bisa langsung menyalinnya ke dokumen evaluasi internal. Standar ini bersifat rekomendasi berdasarkan pengalaman, jadi sesuaikan dengan toleransi risiko bisnismu.
| No. | Indikator keandalan | Cara pemeriksaan | Standar kelulusan yang disarankan |
|---|---|---|---|
| 1 | Riwayat gangguan dan halaman status | Periksa halaman status publik dan laporan evaluasi insiden | Ada halaman status dan laporan evaluasi untuk gangguan besar |
| 2 | Tambahan latensi | Bandingkan permintaan yang sama melalui koneksi langsung dan proksi | Tambahan latensi tetap stabil, tanpa penurunan performa yang signifikan pada jam sibuk |
| 3 | Waktu hingga token pertama | Catat waktu kedatangan paket pertama pada permintaan streaming | Persentil stabil dan penyebab latensi ekstrem dapat dijelaskan |
| 4 | Tingkat kesalahan dan kode kesalahan | Analisis distribusi 4xx dan 5xx | Arti kode kesalahan jelas dan dapat membedakan masalah upstream dari masalah platform |
| 5 | Pembatasan laju dan kuota konkurensi | Naikkan beban secara bertahap dan amati kapan 429 muncul | Kuota jelas dan peningkatannya dapat diajukan |
| 6 | Keaslian versi model | Periksa field model dan jalankan pengujian regresi dengan kumpulan soal tetap | Model yang dikembalikan sesuai permintaan dan output tidak mengalami pergeseran yang tidak wajar |
| 7 | Kompatibilitas antarmuka | Uji streaming, pemanggilan alat, multimodal, dan cache | Parameter umum diteruskan secara utuh, tanpa dibuang diam-diam |
| 8 | Transparansi penagihan | Cocokkan statistik token sendiri dengan tagihan platform | Selisih dapat dijelaskan dan aturan penagihan cache dipublikasikan |
| 9 | Kemampuan failover | Pelajari strategi redundansi upstream dan mekanisme pengalihannya | Gangguan pada satu upstream tidak membuat seluruh layanan tidak tersedia |
| 10 | Kebijakan data dan log | Baca ketentuan privasi dan penjelasan penyimpanan log | Jelas apakah data disimpan, berapa lama, dan apakah penyimpanan bisa dinonaktifkan |
Mengapa transparansi penagihan proksi AI API menjadi indikator keandalan
Banyak orang menganggap penagihan hanya sebagai masalah biaya. Namun, di lingkungan produksi, penagihan yang tidak transparan merupakan risiko keandalan. Tagihan yang tiba-tiba membengkak sering kali menandakan cache tidak digunakan, aturan penghitungan token berubah, atau klien melakukan percobaan ulang secara tidak normal. Semuanya adalah masalah di tingkat sistem. Blog Ofox.ai pernah melaporkan bahwa Anthropic mengonfirmasi adanya pembatasan laju pada jam sibuk serta dua bug cache yang dapat membuat tagihan token membengkak 10 hingga 20 kali lipat (sumber: Ofox.ai Blog, dikutip hanya sebagai pembanding). Ini menunjukkan bahwa sekalipun menggunakan jalur resmi, kamu tetap perlu memeriksa tagihan sendiri.
Sumber yang sama juga menyebutkan bahwa sebagian platform agregator mengenakan biaya isi ulang, misalnya credit fee 5.5% dari OpenRouter (sumber: Ofox.ai Blog, dikutip hanya sebagai pembanding). Saat mengevaluasi layanan proksi API, sebaiknya masukkan biaya transaksi, kurs, jumlah isi ulang minimum, dan harga cache ke dalam perhitungan “harga aktual per unit”, bukan hanya melihat harga input dan output yang tertera di halaman.
Hal penting dalam pemeriksaan kompatibilitas antarmuka layanan agregator AI API
Masalah kompatibilitas biasanya tidak terlihat pada tahap Hello World. Masalah justru sering muncul dalam situasi seperti ini: output streaming terpotong di tengah jalan oleh lapisan proksi, struktur parameter pemanggilan alat diubah, ukuran gambar input dibatasi, atau field kontrol cache dalam format Anthropic dibuang diam-diam. Sebaiknya buat daftar semua parameter yang benar-benar digunakan dalam bisnismu, lalu uji regresi satu per satu menggunakan permintaan nyata.
Jika sistemmu menggunakan format antarmuka OpenAI dan Anthropic sekaligus, pastikan layanan proksi API mendukung keduanya secara native, bukan memaksa permintaan Anthropic menjadi format OpenAI lalu mengubahnya kembali. Semakin banyak konversi format, semakin tinggi kemungkinan field hilang dan perilaku menjadi tidak konsisten.
Panduan cepat layanan proksi API AI di lingkungan produksi: proses verifikasi 7 hari
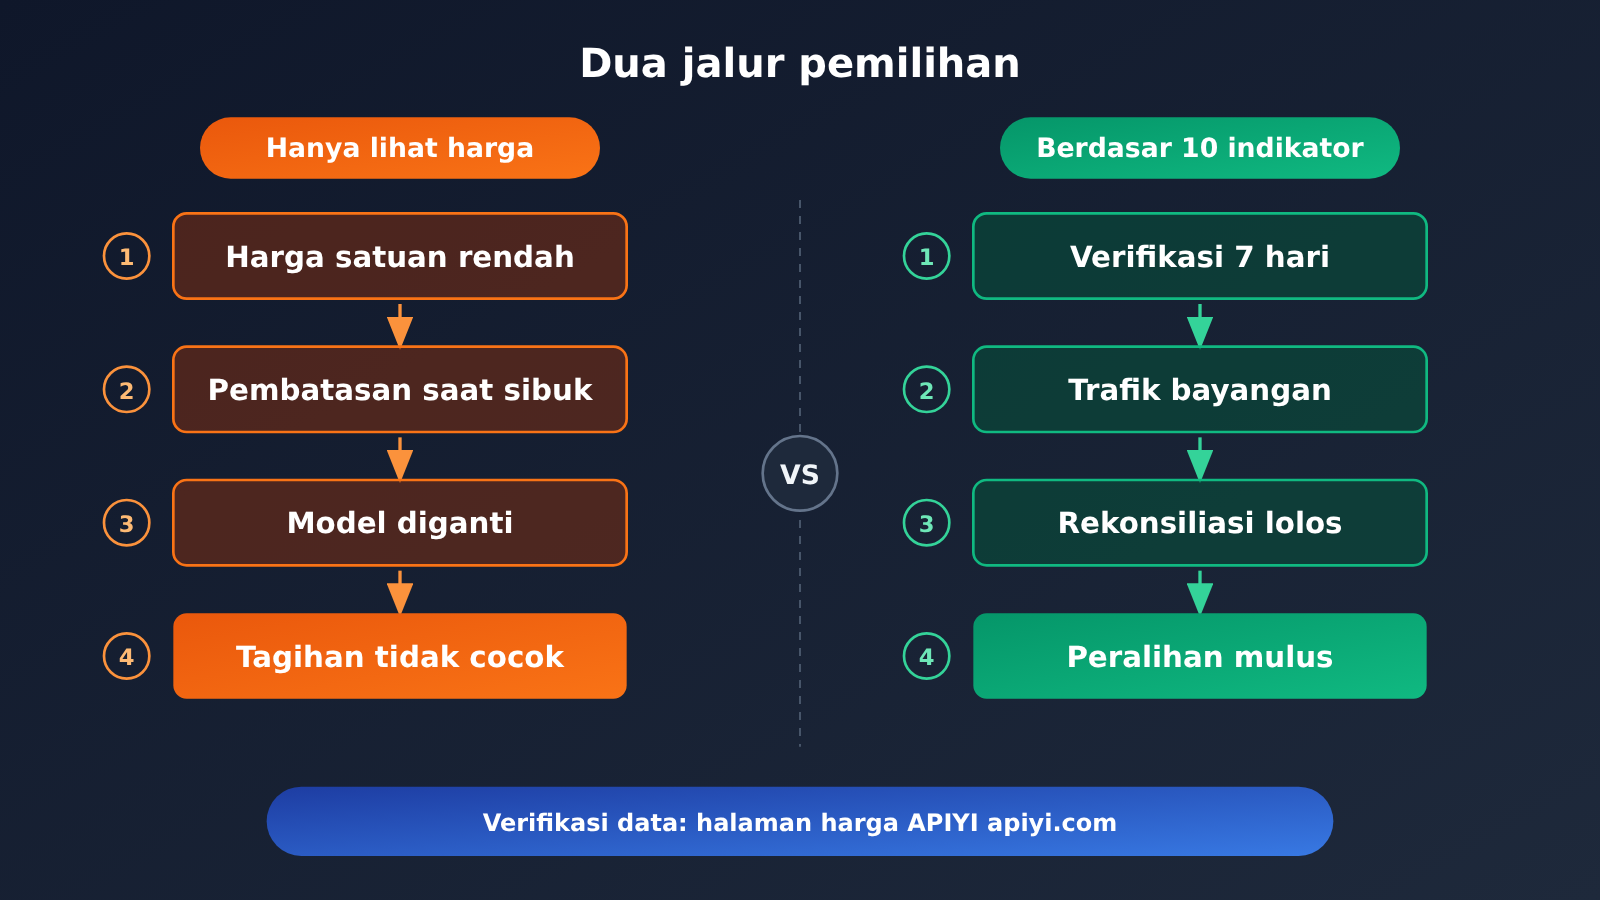
Setelah punya daftar periksa, langkah berikutnya adalah melakukan verifikasi. Kami menyarankan uji coba dengan trafik kecil selama 7 hari agar Anda bisa mencakup jam sibuk pada hari kerja sekaligus mengamati pola trafik akhir pekan. Proses ini tidak memerlukan alat yang rumit: log dan satu tabel saja sudah cukup.
| Tahap | Waktu | Langkah utama | Hasil |
|---|---|---|---|
| Persiapan | Hari ke-1 | Inventarisasi model, parameter, dan QPS puncak yang digunakan aplikasi; siapkan kumpulan soal tetap untuk uji regresi | Daftar parameter dan kumpulan soal |
| Regresi fungsi | Hari ke-2 | Uji streaming, pemanggilan alat, multimodal, dan bidang cache satu per satu | Daftar periksa kompatibilitas |
| Uji beban | Hari ke-3 | Tingkatkan beban secara bertahap hingga 1,5 kali beban puncak, lalu catat titik munculnya 429 dan 5xx | Kurva konkurensi dan pembatasan laju |
| Trafik bayangan | Hari ke-4–6 | Salin sebagian kecil permintaan nyata ke layanan proksi API, lalu bandingkan dengan alur yang ada | Laporan latensi, tingkat kesalahan, dan perbedaan keluaran |
| Rekonsiliasi dan evaluasi | Hari ke-7 | Bandingkan statistik token internal dengan tagihan platform, lalu rangkum 10 metrik | Kesimpulan pemilihan dan rencana peralihan |
Hal penting dalam konfigurasi layanan proksi API AI
Saat integrasi, usahakan cukup mengubah konfigurasi tanpa mengubah kode. Jika proyek Anda menggunakan SDK resmi OpenAI, biasanya Anda hanya perlu mengganti base_url dengan alamat yang disediakan layanan proksi API, lalu mengganti api_key. Sebagai contoh, untuk APIYI, base_url yang kompatibel dengan format OpenAI dapat diatur ke https://api.apiyi.com/v1. Isi nama model dengan ID model yang tercantum di halaman harga.
Jika Anda menggunakan SDK Anthropic atau alat berbasis format Anthropic seperti Claude Code, pastikan platform menyediakan akses dengan format asli Anthropic. Lalu, atur alamat dasar dan variabel lingkungan untuk kunci sesuai dokumentasi. APIYI kompatibel dengan format API OpenAI dan Anthropic. Untuk alamat dan parameter yang tepat, lihat pusat dokumentasi di docs.apiyi.com agar tidak menggunakan alamat lama dari tutorial pihak ketiga.
Saat melakukan integrasi, sebaiknya siapkan juga tiga hal berikut:
- Pisahkan pengaturan waktu tunggu dan percobaan ulang: atur waktu tunggu koneksi agar singkat, sedangkan waktu tunggu pembacaan lebih lama sesuai model dan panjang keluaran. Lakukan percobaan ulang hanya untuk 429 dan 5xx, dengan jeda eksponensial.
- Catat informasi penting: untuk setiap permintaan, catat ID permintaan, nama model, jumlah token masukan dan keluaran, durasi, serta kode status. Data ini menjadi dasar untuk rekonsiliasi dan pemecahan masalah.
- Siapkan jalur cadangan: sediakan setidaknya satu jalur alternatif, baik melalui layanan proksi API lain maupun koneksi langsung ke layanan resmi, yang dapat dipilih melalui konfigurasi.
🚀 Saran untuk mulai cepat: Jika ingin mencoba alur 7 hari di atas dengan volume trafik kecil, Anda dapat mendaftar di APIYI apiyi.com untuk mendapatkan kuota uji coba. Platform ini menyediakan antarmuka API terpadu yang kompatibel dengan format OpenAI dan Anthropic. Cukup ubah base_url untuk mengalihkan trafik bayangan dan membandingkan hasilnya.
Memeriksa Cakupan Model dan Harga Layanan Agregasi API AI
Saat memilih layanan, pastikan model yang kamu butuhkan benar-benar tersedia dan skema harganya jelas. Tabel berikut mencantumkan sebagian model yang saat ini tersedia di APIYI beserta harga satuan yang tercantum di halaman harga. Semua harga mengacu pada data aktual di halaman harga APIYI https://docs.apiyi.com/models. Untuk satuan penagihan dan perubahan terbaru, lihat halaman tersebut; angka dalam artikel ini hanya sebagai referensi untuk pengecekan.
| ID model | Skenario penggunaan | Harga satuan input / output / cache (halaman harga APIYI) | Platform yang tersedia |
|---|---|---|---|
| claude-opus-5-5 | Penalaran kompleks, pemrograman dengan alur panjang | $4 / $20 / $0.2 | APIYI apiyi.com |
| claude-sonnet-5-5 | Pemrograman sehari-hari, model utama untuk Agent | $2 / $10 / $0.1 | APIYI apiyi.com |
| kimi-k3.1-pro | Konteks panjang, skenario berbahasa Mandarin | $2 / $10 / $0.2 | APIYI apiyi.com |
| deepseek-v4.1-flash | Konkruensi tinggi, pemrosesan batch berbiaya rendah | $0.3 / $1.2 / $0.006 | APIYI apiyi.com |
| gpt-image-2.6-flare / sunburst | Pembuatan gambar | Input teks $5, input gambar $8, output $30 | APIYI apiyi.com |
| seri qwen3.8 | Tugas umum berbahasa Mandarin | Lihat halaman harga | APIYI apiyi.com |
Perlu dicatat, jika bisnismu bergantung pada seri Baidu Wenxin ERNIE, APIYI saat ini belum menyediakan model tersebut. Kami akan mengupayakan agar model ini segera tersedia; sementara itu, tetap gunakan metode akses yang sudah ada. Lakukan pemeriksaan yang sama saat mengevaluasi layanan proksi API mana pun: pastikan satu per satu bahwa model yang dibutuhkan benar-benar ada di daftar harga, jangan langsung percaya pada klaim umum seperti “mendukung ratusan model”.
💡 Saran pemilihan: Kalikan harga satuan cache dengan tingkat cache hit aktual, lalu tambahkan biaya input dan output untuk mengetahui biaya sebenarnya. Coba uji model seperti Claude, Kimi, dan DeepSeek di APIYI apiyi.com menggunakan kumpulan permintaan yang sama. Pilih berdasarkan “biaya terendah dengan kualitas yang memenuhi kebutuhan”, bukan sekadar harga satuan.
Pertanyaan Umum (FAQ)
Q1: Apa itu layanan agregasi dan proksi AI API?
Layanan agregasi dan proksi AI API adalah gateway di antara aplikasi Anda dan penyedia model. Layanan ini menyatukan model dari berbagai penyedia dalam satu antarmuka, serta menangani autentikasi, routing, penagihan, dan failover. Keuntungannya, integrasi menjadi mudah dan pergantian model lebih fleksibel. Konsekuensinya, ada satu lapisan dependensi tambahan yang keandalannya perlu dievaluasi.
Q2: Apakah layanan proksi AI API pasti kurang andal dibandingkan koneksi langsung ke API resmi?
Tidak selalu. Koneksi langsung hanya bergantung pada satu penyedia, sehingga Anda tidak punya alternatif saat penyedia tersebut membatasi permintaan atau mengalami gangguan. Sebaliknya, layanan proksi API dengan redundansi dari beberapa penyedia dapat beralih secara otomatis ketika salah satunya bermasalah. Perbedaan utamanya terletak pada kualitas lapisan proksi itu sendiri. Karena itu, gunakan 10 metrik dalam artikel ini untuk memverifikasinya, bukan langsung berasumsi.
Q3: Seberapa sering metrik keandalan layanan proksi AI API perlu ditinjau ulang?
Sebaiknya lakukan validasi penuh selama 7 hari sebelum masuk ke produksi. Setelah itu, tinjau tingkat kesalahan, persentil latensi, dan selisih tagihan setiap bulan. Jalankan kembali pengujian regresi fungsi dan uji beban setiap kali platform memperbarui versi model, menyesuaikan harga, atau trafik Anda meningkat secara signifikan.
Q4: Skenario produksi apa yang paling membutuhkan perhatian terhadap keandalan layanan agregasi AI API?
Terutama beberapa kategori berikut:
– **Percakapan real-time untuk pengguna akhir**: waktu hingga token pertama dan stabilitas streaming berdampak langsung pada pengalaman pengguna.
– **Agent pemrograman dan alur kerja otomatis**: jika field pemanggilan alat diubah, seluruh rangkaian proses bisa gagal.
– **Pemrosesan data secara batch**: kuota konkurensi dan akurasi penagihan menentukan apakah tugas dapat selesai tepat waktu dan sesuai anggaran.
Q5: Bagaimana cara cepat memverifikasi apakah layanan proksi API memenuhi standar?
Cara paling praktis adalah menggunakan platform yang mendukung banyak model untuk membandingkan shadow traffic:
1. Kunjungi APIYI apiyi.com, daftarkan akun, dan dapatkan kuota uji coba
2. Atur base_url ke `https://api.apiyi.com/v1`, atau konfigurasikan format Anthropic sesuai dokumentasi di docs.apiyi.com
3. Salin sebagian kecil permintaan nyata, lalu bandingkan latensi, tingkat kesalahan, dan perbedaan output
APIYI menyediakan pemanggilan API untuk model yang dibahas dalam artikel ini, seperti Claude, Kimi, DeepSeek, GPT Image, dan Qwen, sehingga Anda dapat membandingkannya melalui satu antarmuka.
Q6: Di mana sebaiknya memeriksa harga layanan proksi API?
Gunakan halaman harga resmi platform sebagai acuan, lalu simpan tangkapan layar atau catat tanggal pemeriksaannya. Sebagai contoh, harga input, output, dan cache semua model di APIYI mengacu pada halaman harga https://docs.apiyi.com/models. Harga di blog pihak ketiga hanya bisa menjadi referensi pembanding karena dasar perhitungan dan waktu pembaruannya mungkin berbeda.
Q7: Apa saja keterbatasan layanan agregasi dan proksi AI API yang tidak bisa dihindari?
Setiap lapisan proksi menambah latensi dan satu titik kegagalan. Selain itu, model baru biasanya tersedia di platform proksi lebih lambat daripada rilis resminya, dan beberapa parameter khusus penyedia mungkin perlu menunggu proses adaptasi. Untuk mengantisipasinya, pertahankan koneksi langsung ke penyedia resmi atau layanan kedua sebagai jalur cadangan, serta siapkan rencana penurunan layanan untuk proses bisnis yang penting.
Poin Utama Keandalan Proksi AI API di Lingkungan Produksi
- Keandalan punya empat lapisan: ketersediaan, performa, konsistensi, dan kemampuan pengelolaan sama-sama penting. Jangan hanya melihat apakah layanan mengalami downtime.
- Uji latensi saat beban puncak: overhead tambahan dari lapisan proksi stabil dan bisa diukur, sedangkan fluktuasi antrean saat beban puncak sering menjadi penyebab utama insiden.
- Waspadai pergantian model: periksa field
modeldan jalankan uji regresi dengan kumpulan soal tetap untuk mencegah penurunan kualitas tanpa pemberitahuan. - Penagihan juga bagian dari keandalan: tagihan yang tidak wajar sering mengarah pada kegagalan cache atau lonjakan percobaan ulang. Lakukan rekonsiliasi secara rutin.
- Uji kompatibilitas satu per satu: verifikasi streaming, pemanggilan tool, dan field cache dengan permintaan nyata, bukan hanya menjalankan Hello World.
- Validasi dengan shadow traffic selama 7 hari: bandingkan hasil menggunakan sebagian kecil traffic daripada mengambil keputusan berdasarkan perkiraan semata.
- Cara memulai: gunakan antarmuka terpadu di APIYI apiyi.com untuk membandingkan beberapa model. Harga mengacu pada halaman harga.
Kesimpulan
Saat memilih layanan proksi atau agregasi AI API untuk lingkungan produksi, ada tiga hal utama yang perlu diperhatikan:
- Tentukan metrik sebelum membandingkan harga: gunakan 10 metrik keandalan untuk menyaring platform yang tidak memenuhi syarat, lalu bandingkan biaya platform yang lolos.
- Gunakan data, bukan klaim promosi: jalankan proses validasi selama 7 hari untuk mendapatkan data latensi, tingkat kesalahan, dan tagihan sesuai kondisi bisnis Anda.
- Selalu siapkan jalur cadangan: setiap jalur layanan bisa mengalami masalah. Kanal cadangan dan rencana penurunan layanan adalah perlengkapan standar di lingkungan produksi.
Jika Anda berencana menambahkan gateway AI API ke layanan yang sudah berjalan, coba gunakan tabel evaluasi dalam artikel ini untuk melakukan validasi dengan sebagian kecil traffic. Anda bisa menggunakan APIYI apiyi.com untuk memvalidasi hasil dengan cepat. Platform ini kompatibel dengan format antarmuka OpenAI dan Anthropic. Model dan harga dapat diperiksa langsung di halaman harga https://docs.apiyi.com/models, sedangkan detail integrasi tersedia di pusat dokumentasi docs.apiyi.com.
📚 Referensi
- Halaman harga APIYI: Daftar model serta harga per unit untuk input, output, dan cache
- Tautan:
docs.apiyi.com/models -
Keterangan: Semua data harga APIYI dalam artikel ini mengacu pada halaman tersebut
-
Pusat dokumentasi APIYI: Panduan integrasi dengan format OpenAI dan Anthropic
- Tautan:
docs.apiyi.com -
Keterangan: Mencakup konfigurasi base_url, ID model, dan pertanyaan umum
-
Ofox.ai Blog: Evaluasi keandalan OpenRouter di lingkungan produksi dan laporan masalah penagihan Claude
- Tautan:
ofox.ai/blog/page/39 -
Keterangan: Sumber data pihak ketiga tentang jumlah gangguan, tambahan latensi, dan biaya layanan; dikutip hanya sebagai pembanding
-
Ofox.ai Blog: Laporan tentang pembatasan laju Claude saat jam sibuk dan masalah penagihan cache
- Tautan:
ofox.ai/blog/page/36 - Keterangan: Digunakan untuk menjelaskan pentingnya memeriksa tagihan; dikutip hanya sebagai pembanding
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama APIYI di apiyi.com untuk berbagi pengalaman memilih gateway AI API. Materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com


