
Note de l’auteur : Microsoft-Decision-1.1 est officiellement disponible depuis le 2026-11-17. Il se contente de choisir parmi les options que vous lui fournissez, d’attribuer un score ou de répondre par oui/non — il ne rédige pas de longs textes. Cet article explique à quelle étape d’un pipeline il peut se substituer, quel document consulter pour le prix, et pourquoi les chiffres d’un post ne peuvent pas être recopiés tels quels dans une table de coûts.
Pendant Microsoft Ignite, TestingCatalog a publié un post le 2026-11-17. Le texte parlait de « MAI Decision 1 », mais l’image jointe était le classement Decision 1.1 d’Artificial Analysis. Beaucoup de gens utilisent déjà un grand modèle de langage pour router les requêtes, classer les tickets, ordonner les priorités ou valider les résultats ; en voyant ce post, trois questions leur viennent : quel modèle adopter, quelle étape il remplace, et si le « 10 fois plus rapide, 200 fois moins cher » du post est réellement exploitable.
La conclusion : les décisions à options fixes reviennent à Microsoft-Decision-1.1, la génération de longs textes reste confiée au grand modèle de langage. L’annonce GA de Microsoft datée du 2026-11-17 le déclare officiellement disponible, et les modalités d’appel figurent dans la documentation Microsoft Foundry. Cet article s’appuie sur l’annonce GA et la documentation officielle ; le post ne sert que de piste.
Ceci n’est pas une reprise du post. Les multiplicateurs cités ne précisent pas la référence de comparaison ; l’image et un cas d’usage interne de Microsoft mentionnent chacun un « 2,2 fois », mais les objets de comparaison diffèrent — nous les traiterons séparément. Nous avons vérifié le tableau des modèles et l’API de tarification d’APIYI apiyi.com le 2026-11-18 ; le résultat figure dans la partie consacrée aux prix.
L’essentiel : après lecture, vous saurez quelle étape du pipeline peut être confiée à Microsoft-Decision-1.1, quel document consulter pour le tarif, et vous ne testerez pas avec le mauvais point d’accès un identifiant de modèle qui n’existe pas encore.
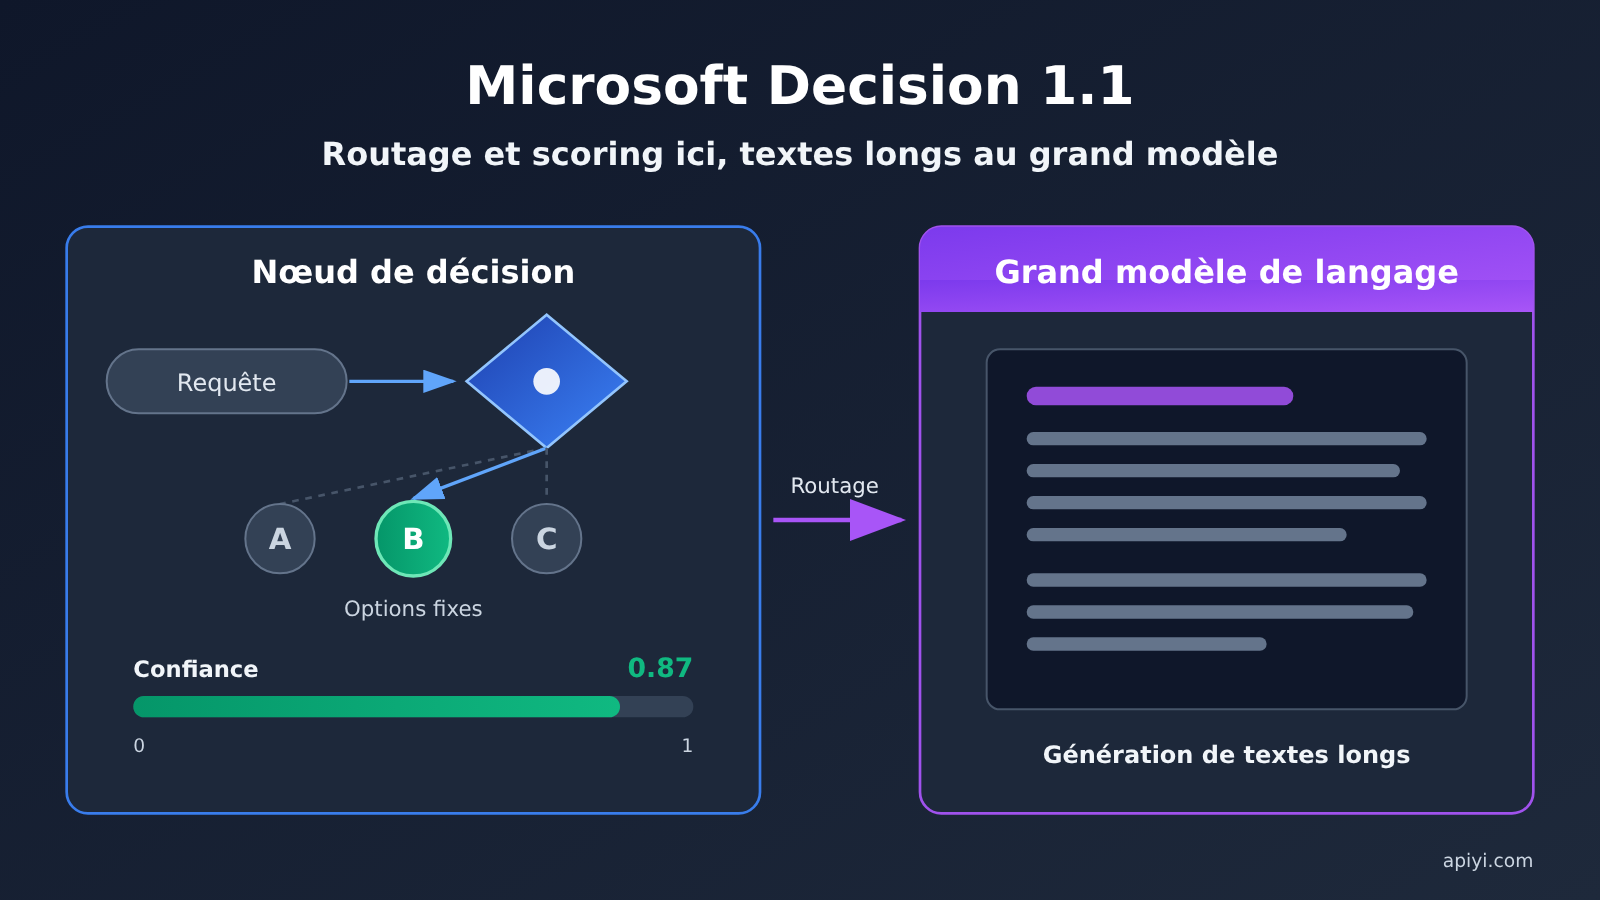
Microsoft Decision 1.1 : l’essentiel en un coup d’œil
Commençons par séparer les informations officielles de ce qui relève des posts relayés. Le tableau ci-dessous ne recense que les éléments vérifiables dans l’article GA de Microsoft, le Book of News d’Ignite et la documentation Foundry.
| Élément d’information | Détails |
|---|---|
| Date de disponibilité générale | 2026-11-17, annoncée dans l’article GA de Microsoft |
| Nom du modèle | Microsoft-Decision-1.1 |
| Modèle de base | Gemma 4 26B A4B (formulation identique dans l’article GA et le Book of News d’Ignite) |
| Usage | Routage, classification, priorisation, validation, contrôle de flux |
| Fonctionnement | Choisit parmi les options fournies par le développeur, renvoie un score de confiance calibré et peut s’abstenir de décider en cas d’incertitude |
| Par rapport à la première version | Vitesse plus de deux fois supérieure, prix maintenu bas, ajout de l’entrée image |
| Canaux officiels | Microsoft Foundry, OpenRouter, Vercel AI Gateway |
| Statut sur APIYI apiyi.com | Lors de la vérification du 2026-11-18, ni le tableau des modèles ni l’interface de tarification ne le référencent |
« Choisir parmi des options données » : voilà la clé pour comprendre ce modèle. Il n’écrit pas de paragraphes, n’explique pas ses raisons, il se contente de répondre à la question que vous avez conçue à l’avance. Ce type de travail était auparavant souvent confié, en complément, aux grands modèles de langage ; il peut désormais être pris en charge par un petit modèle spécialisé.
Microsoft-Decision-1.1 et Microsoft-Decision-1 ne sont pas le même modèle
Le texte du post parle de Decision 1, mais l’illustration montre Decision 1.1 : on peut donc vite croire qu’il s’agit d’un seul et même modèle. En réalité, leurs modèles de base sont différents, tout comme leurs dates de publication. Avant de l’intégrer, vérifiez bien lequel vous déployez.
| Élément de comparaison | Microsoft-Decision-1 | Microsoft-Decision-1.1 |
|---|---|---|
| Date de publication | 2026-10 | 2026-11-17, disponibilité générale |
| Modèle de base | Qwen3.5-9B | Gemma 4 26B A4B |
| Prix d’entrée (Foundry) | 0,042 USD / million de tokens | Tarification par zone, voir le tableau des prix ci-dessous |
| Prix de sortie | Gratuit | Gratuit |
| Entrée d’images | Non mentionné dans la documentation | La note de disponibilité générale (GA) indique que c’est nouveau |
| Canaux de distribution | Foundry, OpenRouter | Foundry, OpenRouter, Vercel AI Gateway |
| Autres informations | La page OpenRouter indique une fenêtre de contexte d’environ 33K | Microsoft affirme qu’il est plus de deux fois plus rapide que la première version |
Si vous avez déjà rédigé votre script d’évaluation pour Microsoft-Decision-1 en octobre, il faudra redéployer en passant à la version 1.1 et renommer le déploiement. Comme les deux versions n’ont pas le même modèle de base, les seuils de confiance que vous aviez réglés devront eux aussi être revalidés.
Comment appeler Microsoft Decision 1.1 : ce n’est pas une API de complétion de chat
C’est le point le plus facile à rater. D’après la documentation Microsoft Foundry, le type d’API de Microsoft-Decision-1.1 est Decision, et non les habituelles chat completions. La requête est envoyée au chemin /providers/microsoft/v1/systemone sur la ressource Foundry, et le champ model du corps de la requête doit contenir le nom de votre propre déploiement, pas le nom du modèle. Lors du déploiement, choisissez la version 1 ; le type de déploiement peut être GlobalStandard, et dans certaines régions, DataZoneStandard est également disponible.
Il ne prend en charge que trois types de questions ; il renvoie une réponse et une probabilité, mais ni texte libre ni justification :
| Type de question | Usage | Contenu renvoyé | Cas d’usage typique |
|---|---|---|---|
noul |
Déterminer si c’est oui ou non | Probabilité entre 0 et 1 | Cette sortie est-elle conforme ? Ce document doit-il être revu manuellement ? |
choice |
Choisir une option parmi un ensemble fixe | L’option choisie | À quel modèle en aval envoyer la requête, dans quelle catégorie classer le ticket |
score |
Attribuer une note sur une échelle croissante | Valeur sur l’échelle | Classer le niveau d’urgence, noter la qualité d’une réponse |
Ainsi, l’invite qui demandait auparavant à un grand modèle de langage « Veuillez choisir parmi les trois catégories suivantes et expliquer la raison » doit, lors de la migration, devenir une question de type choice avec la liste des options, et la partie justification doit être supprimée. Si l’aval a réellement besoin d’un texte explicatif à présenter à l’utilisateur, confiez-le à un grand modèle de langage.
Tarification de Microsoft Decision 1.1 : se référer aux prix par zone du document GA de Microsoft
Voici les tarifs publiés dans le document GA de Microsoft, daté du 2026-11-17. Il s’agit des prix de Microsoft Foundry, et non de ceux d’APIYI.
| Zone de déploiement | Prix d’entrée (par million de tokens) | Prix de sortie |
|---|---|---|
| Global Standard | 0.042 USD | Gratuit |
| US Data Zone | 0.046 USD | Gratuit |
| EU Data Zone | 0.05 USD | Gratuit |
| APAC Data Zone | 0.05 USD | Gratuit |
L’Ignite Book of News indique des « prix aussi compétitifs que la première version ». Or, seul Global Standard correspond aux 0.042 USD de la première version ; les trois zones de données sont plus chères. Il faut donc, pour établir le tableau de coûts, se baser sur les prix par zone du document GA. Par ailleurs, la sortie est gratuite parce que ce modèle ne renvoie que la réponse et les probabilités ; la sortie elle-même est très courte, et le coût dépend surtout de la longueur du contexte que vous envoyez à chaque appel.
Parlons maintenant de l’appel via APIYI. APIYI (apiyi.com) propose une interface unifiée compatible avec OpenAI à l’adresse https://api.apiyi.com/v1 ; il s’agit d’une API de type complétion de chat. Le modèle Decision utilise une autre API qui ne renvoie que la réponse et les probabilités. Donc, même s’il est référencé plus tard, vous ne pourrez pas le tester en mettant l’ID du modèle dans une requête de chat classique. Nous avons consulté la liste des modèles et l’endpoint de tarification d’APIYI le 2026-11-18 : elle comptait alors 283 modèles, et aucun Microsoft-Decision-1, Microsoft-Decision-1.1 ni aucun ID lié à decision n’y figurait. Dans la liste des modèles, les seuls éléments contenant MAI étaient les modèles d’image MAI-Image-2.6 et MAI-Image-2.6-Flash, qui ne relèvent pas du même produit que ce modèle de décision. Il n’est pas encore disponible sur la plateforme ; nous le référencerons dès que possible. Les identifiants de modèle et les prix font foi dans la liste des modèles de la plateforme.
Comment lire les chiffres du post : trois séries de multiples, trois objets de comparaison
Le post de TestingCatalog évoque « 10 fois plus rapide, 200 fois moins cher », et l’on trouve en plus deux autres « 2.2 fois », provenant respectivement de la capture du classement et d’un cas d’usage interne chez Microsoft. Leurs objets de comparaison sont tous différents : impossible de les fondre en une seule phrase.
| Chiffre | Source | Objet de comparaison | Inscriptible dans un tableau de coûts |
|---|---|---|---|
| 10 fois plus rapide, 200 fois moins cher | Corps du post TestingCatalog | Un modèle générique non nommé ; aucune comparaison correspondante dans l’article GA | Non |
| Score de 68, 6 points de plus que Decision 1, 2.2 fois plus rapide | Illustration du post, à savoir la capture du classement Artificial Analysis | Microsoft-Decision-1 | Seulement comme référence de classement |
| 2.2 fois plus rapide, coût d’environ 1/4.4 de celui de l’autre | Article GA de Microsoft, cas d’usage interne à Copilot | Un grand modèle de langage | Seulement comme déclaration de Microsoft |
La partie classement vient de l’Artificial Analysis Decision Index v2.1 tel que relayé par Microsoft. D’après cette reprise, Microsoft-Decision-1.1 obtient un score de 68, soit 6 points de plus que la première version, et devance Jev 1.14, Google Gemini Decision 1 et OpenAI GPT-6 Luna (Decisions). L’article GA précise en même temps : « plus de deux fois plus rapide que la première version, à coût identique ». Ce sont des résultats de classement relayés officiellement, pas nos propres données de test. Et le rang dans un classement ne correspond pas non plus au prix que vous allez payer.
L’exemple Copilot, c’est une autre histoire. Microsoft l’utilise dans Copilot pour déterminer si une requête doit être confiée à Copilot ou à Cowork : la précision est comparable à celle d’un grand modèle de langage, la vitesse 2.2 fois supérieure, et le coût d’environ 1/4.4 de celui de ce grand modèle. Ici, le « 2.2 fois » se compare à « un grand modèle de langage » ; sur l’illustration, le « 2.2 fois » se compare à Decision 1. Les deux chiffres ne coïncident que par hasard.
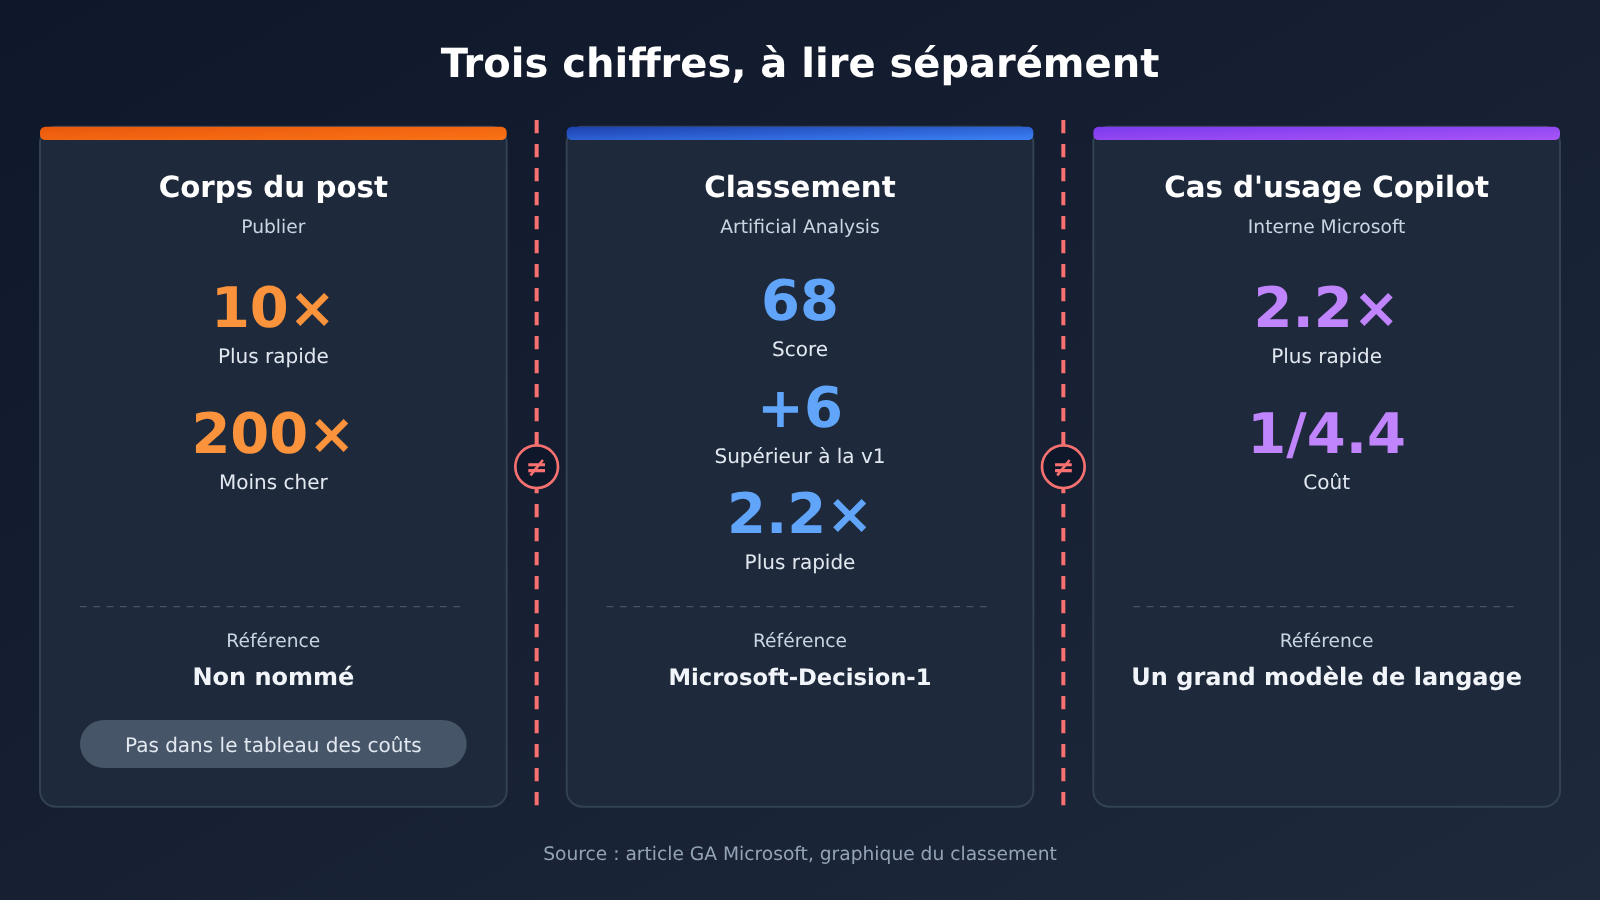
L’image ci-dessus sépare les trois séries de chiffres. Les sources sont l’article GA de Microsoft et la reprise de la capture du classement ; la compilation a été réalisée par l’équipe technique d’APIYI apiyi.com, et elle ne contient aucun résultat de test maison.
Analyse d’impact de Microsoft Decision 1.1
Impact pour les développeurs : le routage et le scoring lui reviennent, les textes longs restent aux grands modèles de langage
Si vous utilisez déjà un grand modèle de langage pour le routage, la classification, la priorisation et la vérification, c’est l’étape « décider » que vous pouvez remplacer ici ; celle qui génère le contenu, elle, ne change pas. Microsoft-Decision-1.1 ne donne une réponse et un niveau de confiance que dans un ensemble d’options fixes, et c’est précisément ce qui détermine où le placer. À l’intégration, on peut découper le travail dans cet ordre :
- Lister les options autorisées : remplacez le « veuillez juger » de votre invite par une liste explicite d’options, par exemple le nom du modèle en aval, la catégorie du ticket, le niveau de risque. Si vous n’arrivez pas à écrire ces options, c’est que cette étape n’est pas encore un bon candidat pour lui.
- Choisir le type de question : les questions oui/non passent par
noul, le choix unique parchoice, la gradation parscore. Ne cherchez pas à lui faire produire un paragraphe. - Définir un seuil de confiance : il fournit une confiance calibr able, et peut aussi refuser de trancher. Au-dessus du seuil, on exécute directement ; en dessous, on bascule sur le circuit de secours.
- En cas de doute, rendre la main à un humain ou au grand modèle de langage : les requêtes à faible confiance partent en revue humaine, ou repassent au grand modèle pour un nouvel arbitrage. Cette étape doit figurer dans le processus, on ne peut pas la sauter.
- Le texte explicatif revient au grand modèle de langage : les réponses destinées aux utilisateurs, les textes longs, le code et les explications sont générés par le grand modèle. Le modèle Decision se contente de décider qui doit écrire ce contenu et par quel chemin il passe.
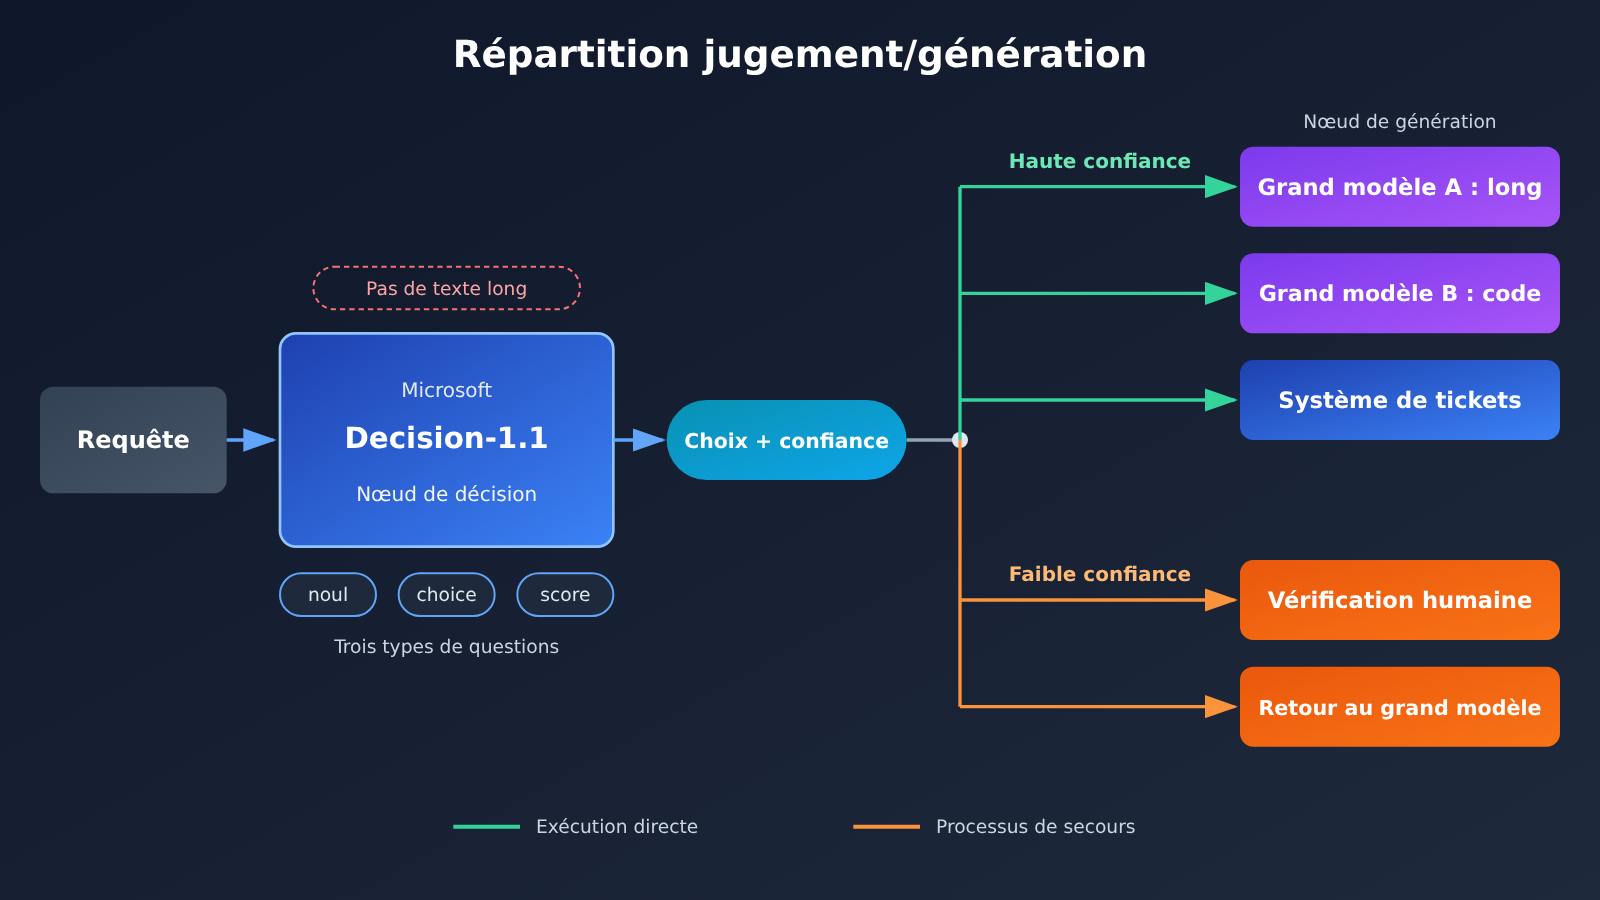
Une fois le découpage fait dans cet ordre, les responsabilités du nœud de décision et du nœud de génération sont séparées, et le diagnostic devient plus simple : un routage erroné ? Regardez le nœud de décision. Un contenu mal rédigé ? Regardez le grand modèle de langage. Côté grand modèle, rien n’est à modifier : le modèle conversationnel que vous appeliez déjà via APIYI apiyi.com peut continuer à servir à générer des textes longs.
Impact sur la chaîne existante : quelles étapes sont candidates au remplacement
Tous les « jugements » ne sont pas bons à migrer. Voici une distinction simple selon les scénarios courants :
- Bon candidat à la migration : le routage des requêtes vers différents modèles, la classification des tickets de support, la question de savoir si un contenu doit passer par une revue humaine, la gradation du niveau d’urgence, la validation de la conformité du format de sortie. Tous ces cas ont des options fixes et le résultat est directement exploitable par le programme.
- À migrer avec prudence : les classifications aux nombreuses options et souvent changeantes, les jugements qui demandent de mobiliser beaucoup de contexte. Dans la première version, le contexte annoncé chez OpenRouter est d’environ 33K ; pour la longueur de contexte exacte de la 1.1, référez-vous à la documentation Foundry, et les entrées trop longues doivent d’abord être tronquées ou résumées.
- Pas adapté à la migration : les avis de revue qui doivent fournir une justification, les contenus à réécrire ou à compléter, les questions-réponses ouvertes. Tout cela reste le travail du grand modèle de langage.
Un autre point à garder en tête : il ne renvoie que la réponse et la probabilité, si bien que les journaux ou les enregistrements d’audit qui comptaient sur le grand modèle pour « donner une justification au passage » perdront cette partie. Si la conformité exige de conserver la justification, vous pouvez rappeler le grand modèle une seule fois pour générer l’explication, uniquement sur les échantillons à faible confiance ou rejetés — inutile ainsi de payer le coût d’un long texte à chaque fois.
Impact sur le secteur : des petits modèles spécialisés pour décharger les grands modèles du travail de jugement
Cette annonce laisse entrevoir une tendance : les requêtes de jugement sont séparées des grands modèles généralistes et confiées à de petits modèles spécialisés. Les noms de concurrents cités dans le post, ainsi que Google Gemini Decision 1 et OpenAI GPT-6 Luna (Decisions) dans le classement, montrent qu’il s’agit désormais d’une catégorie à part.
Pour les développeurs, cela entraîne deux changements :
- Structure de coûts : les requêtes de jugement sont facturées à l’entrée et gratuites en sortie ; le coût dépend surtout de la longueur de l’invite. Réduire le contexte rapporte plus qu’avant.
- Méthode d’évaluation : un nœud de jugement doit être évalué séparément sur son taux de précision et la calibration de sa confiance ; on ne peut pas se contenter de juger la qualité de la réponse finale. Les scores du classement peuvent servir de pré-filtrage, mais il faut au final valider avec ses propres échantillons métier.
Pour les équipes qui veulent d’abord comparer les résultats côté grands modèles, l’interface unifiée d’APIYI (apiyi.com) permet de tester en basculant entre plusieurs modèles conversationnels. Une fois le nœud de jugement opérationnel sur Foundry, il ne reste plus qu’à combiner les deux côtés.
Microsoft Decision 1.1 : points clés (Key Takeaways)
- Ne mélangez pas les versions : la base de la version 1.1 est Gemma 4 26B A4B ; celle de Decision 1 d’octobre est Qwen3.5-9B.
- Uniquement des jugements avec options : routage, classification, priorité et validation lui sont confiés ; les textes longs restent générés par le grand modèle.
- Trois types de requête :
noul,choiceetscore; il renvoie seulement la réponse et la probabilité, pas la justification. - Chemin d’appel différent : les requêtes sont envoyées à
/providers/microsoft/v1/systemone, et le champmodelcontient le nom du déploiement. - Prix : voir l’annonce GA : chez Foundry, le prix d’entrée varie de 0,042 à 0,05 USD par million de tokens ; la sortie est gratuite.
- Les multiplicateurs cités dans le post n’entrent pas dans le tableau de coûts : les 10x et 200x ne précisent pas à quoi ils sont comparés, et les deux mentions de 2,2x doivent également être comprises séparément.
- Statut chez APIYI : à la date du 2026-11-18, le tableau des modèles d’APIYI (apiyi.com) ne contient pas cet ID ; ne le testez pas avec l’interface de chat.
Résumé
Le positionnement de Microsoft-Decision-1.1 est limpide : c’est un nœud de décision dans la chaîne, pas un outil de rédaction.
- Usage : assurer le routage, la classification, le scoring et la validation parmi les options fournies par le développeur, en renvoyant un score de confiance, avec la possibilité de ne pas trancher en cas d’incertitude.
- Périmètre : pas de texte libre, pas de justification. Les textes longs, le code et les explications restent confiés au grand modèle de langage, et les résultats à faible confiance sont repris par un humain ou par le modèle en secours.
- Base de coût : on se réfère au tarif par région Foundry daté du 2026-11-17 dans l’annonce GA de Microsoft. Les multiplicateurs et les places dans les classements cités dans les posts ne constituent en rien un devis.
Je conseille de commencer par une étape de décision dont les options sont fixes et les logs complets, de tester la précision et les seuils sur Foundry avec vos propres échantillons, puis de décider si l’on élargit le périmètre. Côté génération de contenu, vous pouvez continuer à appeler les différents modèles de conversation via APIYI apiyi.com. Pour la disponibilité du modèle Decision, référez-vous à la liste des modèles de la plateforme.
📚 Références
-
Annonce de disponibilité générale de Microsoft Microsoft-Decision-1.1 : annonce GA, avec usage, tarifs par région, reprise des classements et cas d’usage internes chez Copilot
- Lien :
aka.ms/decision-model-ga - Note : les prix et les déclarations officielles de performance de cet article font référence
- Lien :
-
Microsoft Ignite 2026 Book of News : modèle de base et formulation des prix
- Lien :
news.microsoft.com/events/ignite/2026/book-of-news/ - Note : la base est Gemma 4 26B A4B, le détail des prix reste celui de l’annonce GA
- Lien :
-
Doc Microsoft Foundry : utiliser les modèles Microsoft Decision : déploiement et invocation
- Lien :
learn.microsoft.com/en-us/azure/foundry/foundry-models/how-to/use-foundry-models-microsoft-decision - Note : type d’API Decision, chemin de requête et description officielle des trois types de tâches
- Lien :
-
Article de lancement de Microsoft-Decision-1 (2026-10) : informations de la version précédente
- Lien :
commandline.microsoft.com/microsoft-decision-1-model-foundry - Note : sert à distinguer Decision 1 de la version 1.1
- Lien :
-
Page modèle OpenRouter : page d’accès tiers pour les deux versions
- Lien :
openrouter.ai/microsoft/microsoft-decision-1.1 - Note : la page de la première version indique une fenêtre de contexte d’environ 33K
- Lien :
-
Post TestingCatalog : point de départ de cette discussion
- Lien :
x.com/testingcatalog/status/2122759893174178173 - Note : il s’agit d’une reprise, les multiplicateurs qui y figurent ne servent pas de base tarifaire
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI, et retrouvez plus de ressources dans le centre de documentation docs.apiyi.com


