
Nota del autor: d1.2-ultra aparece en el puesto 1 del Decision Index v2.1. Este artículo te ayuda a identificar primero si tu caso consiste en extraer documentos, llamar a herramientas o responder preguntas difíciles; luego mirar solo el subapartado que corresponda y, por último, usar entre 20 y 50 muestras propias para decidir si cambiar o no.
El 2026-11-16, Liquid AI lanzó d1.2 y d1.2-ultra. Según su blog oficial, d1.2-ultra obtiene 75 puntos en el Artificial Analysis Decision Index v2.1, la puntuación más alta entre los modelos de decisión. Muchos desarrolladores que están integrando la API ven «puesto 1» y su primera reacción es sustituir el modelo en producción. No te precipites: la puntuación global de 75 es solo el pretexto; lo que de verdad importa es la puntuación del subapartado que coincide con tu negocio.
Este artículo no busca hundir al modelo ni venderlo como la panacea. El mismo modelo queda primero en extracción de documentos, pero su precisión bruta en preguntas de opción múltiple muy difíciles es la más baja de los 24 modelos de decisión. Ambas cosas son ciertas a la vez, y la puntuación global las diluye.
Valor principal: al terminar de leer, sabrás qué subapartado mirar, cómo interpretar la puntuación de decisión y la precisión bruta, y cómo usar tus propias 20 a 50 muestras para decidir en una tarde si conviene cambiar o no.
Puntos clave de d1.2-ultra, número uno en el índice global
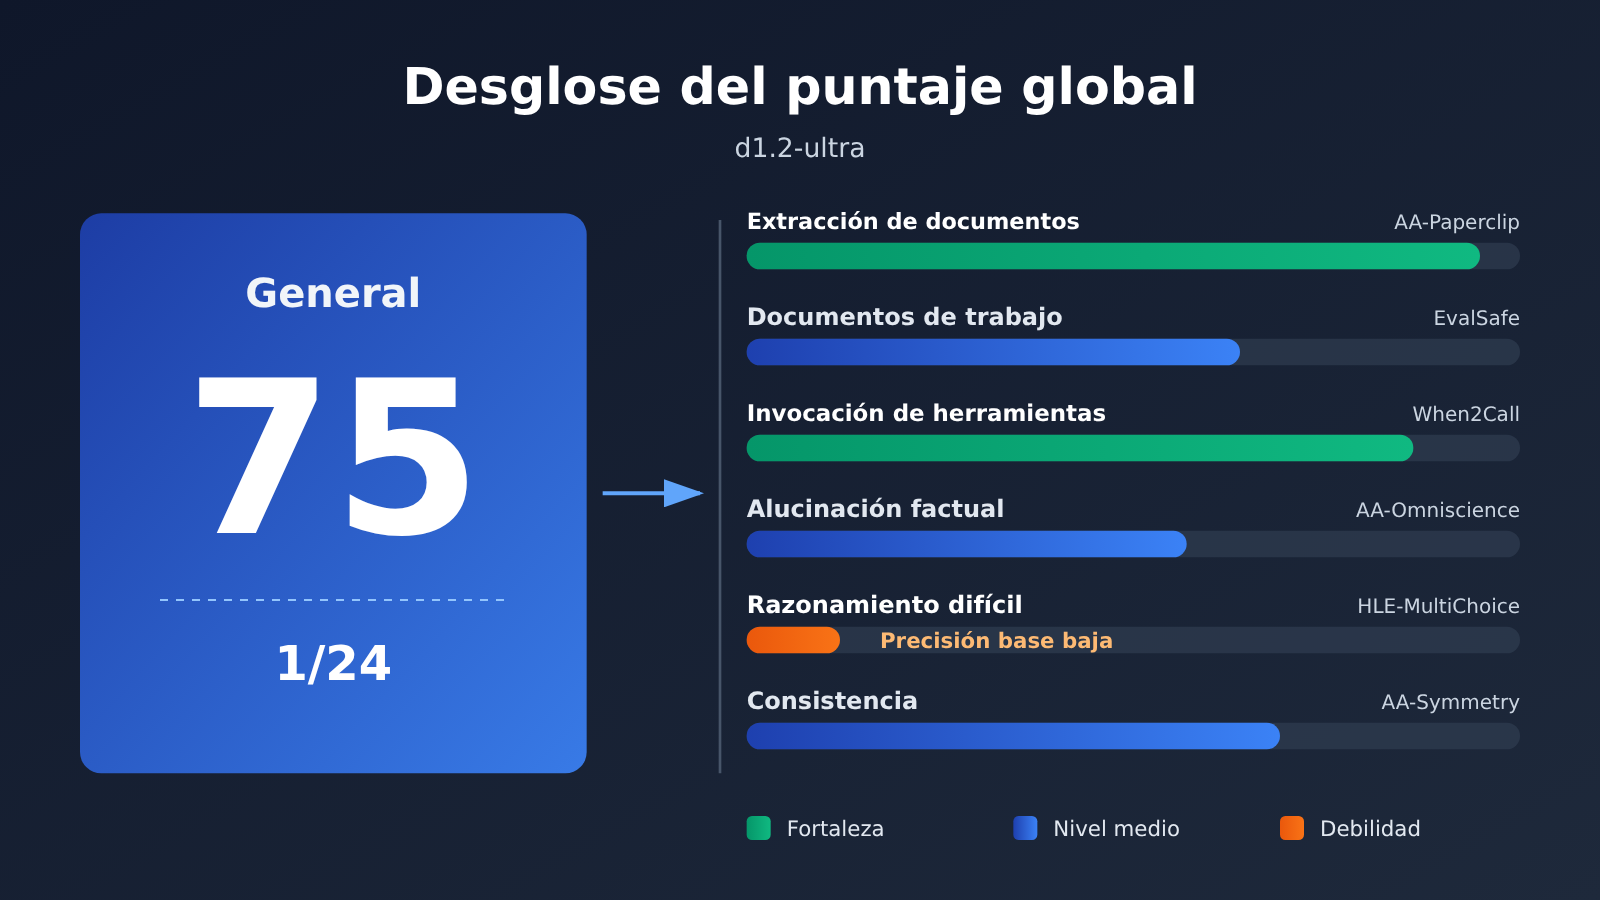
Primero, dejemos claros los números que aparecen en la página de la clasificación. Los siguientes datos provienen de la página del modelo d1.2-ultra en Artificial Analysis, consultada el 2026-11-17; en la comparación participan 24 modelos de decisión.
| Elemento | Datos de la página de clasificación | Cómo interpretarlo |
|---|---|---|
| Índice global | 74.85; la página muestra 75; puesto 1/24 | El segundo puesto, Drex Max v1.1, obtiene 72.62, una diferencia de unos 2.2 puntos; es lo mismo que los «dos puntos» oficiales, redondeado |
| Latencia | 218 ms/tarea; puesto 14/24 | La mediana de la página es 209 ms, lo que lo deja en la zona media |
| Costo de completar el índice | 133 USD por millón de tareas; puesto 11/24 | Es el costo por tarea, no el precio de lista por millón de tokens |
| Precio de entrada | 0.042 USD por millón de tokens | Coincide con el blog oficial de Liquid; oficialmente solo se cuenta la entrada |
| Brier | 0.150, el más bajo de los 24 | Cuanto más bajo, mejor; indica que las probabilidades que ofrece son bastante «honestas» |
¿Cómo se calcula la puntuación global de d1.2-ultra?
Decision Index v2.1 es la media ponderada de seis componentes. La página del modelo define la puntuación de decisión como la exactitud menos la puntuación Brier de la probabilidad de la respuesta elegida, en una escala de 0 a 100, donde más alto es mejor. En otras palabras, equivocarse con seguridad resta más puntos que equivocarse con dudas. La exactitud bruta, en cambio, es la proporción de preguntas en las que el modelo asigna la probabilidad más alta a la opción correcta, y no es el mismo número que la puntuación de decisión.
Esta diferencia influye directamente en cómo interpretas d1.2-ultra. Un modelo puede obtener una puntuación de decisión bastante decente absteniéndose a menudo y cometiendo menos errores por exceso de confianza, mientras que su exactitud bruta es muy baja. Si tu negocio necesita «dar una respuesta obligatoriamente», deberías fijarte en la exactitud bruta; si el negocio permite «si no está seguro, se deriva a una persona», la puntuación de decisión tiene más valor como referencia.
| Componente | Peso | Qué mide | Categoría en AA |
|---|---|---|---|
| AA-Paperclip | 30% | Juicio y extracción de documentos; 15 respuestas de un mismo documento cuentan como un solo juicio | Documento |
| EvalSafe-O*NET-AA | 15% | Juicio sobre documentos de trabajo | Documento |
| When2Call | 10% | Invocación de herramientas | Herramienta |
| AA-Omniscience-Decision v1.1 | 15% | Conocimiento y alucinaciones | Conocimiento |
| HLE-MultiChoice v1.1 | 15% | Preguntas de opción múltiple en texto de Humanity’s Last Exam; se puede rechazar responder | Razonamiento |
| AA-Symmetry v1.1 | 15% | Si el juicio se mantiene igual al cambiar la formulación, el orden de las opciones o la negación | Consistencia |
Ojo: en AA, HLE-MultiChoice está etiquetado como razonamiento, no como conocimiento. Por eso, cuando se menciona más abajo, no hay que describirlo como una «prueba de conocimiento».
Cómo encontrar la puntuación de d1.2-ultra que corresponde a tu tarea
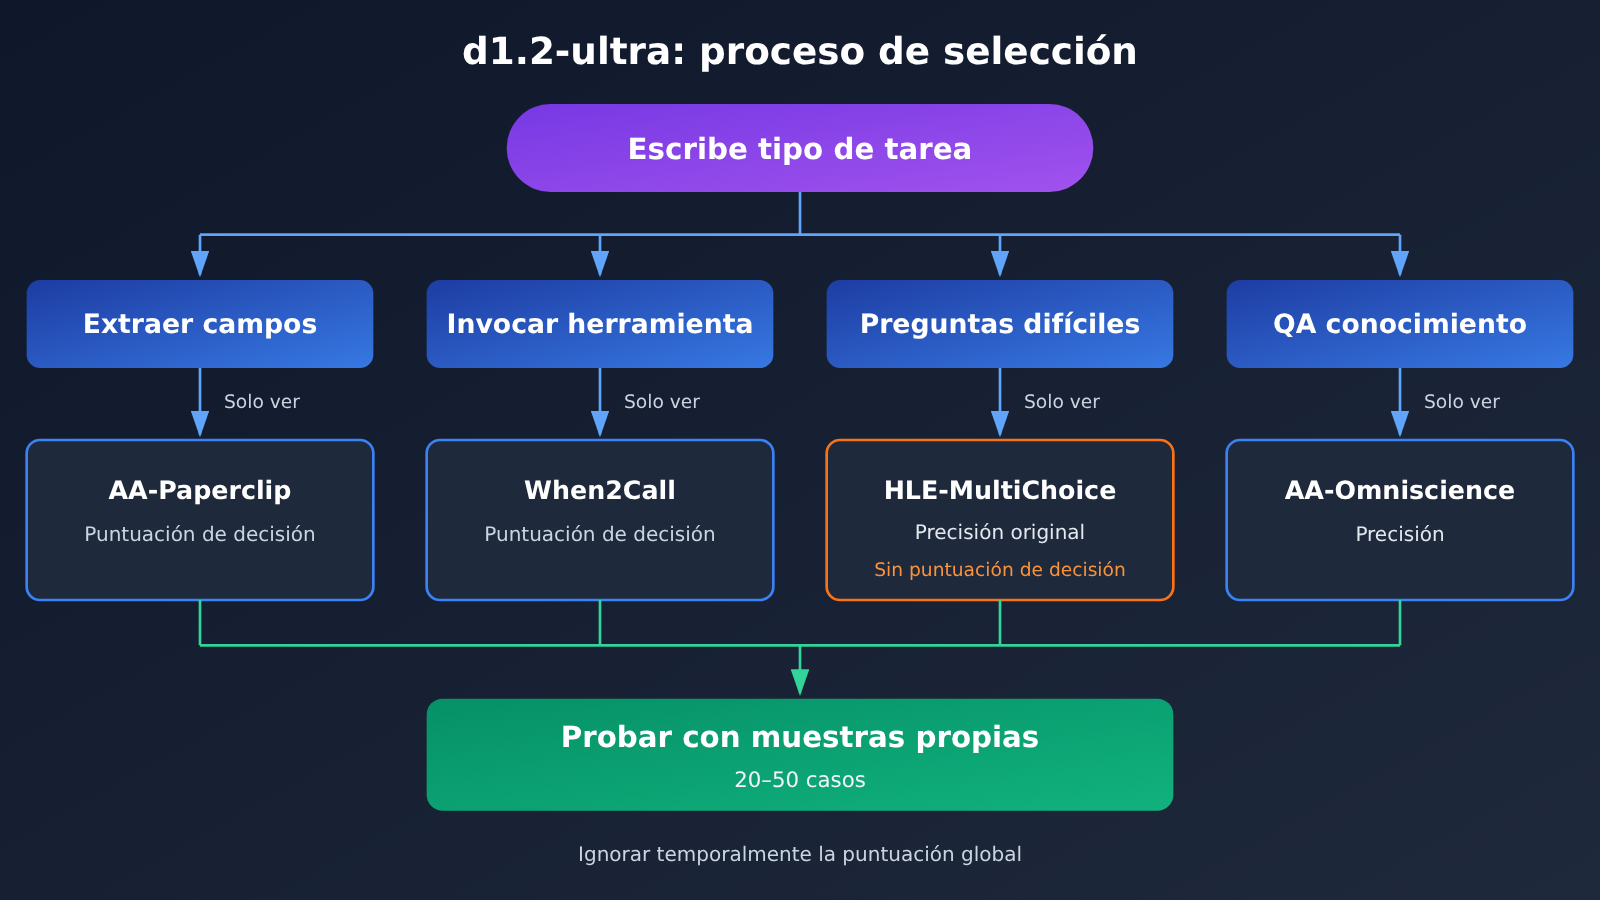
El primer paso no es mirar el ranking, sino tomar una hoja de papel y escribir a qué categoría pertenece realmente tu trabajo: extraer datos de documentos, invocar herramientas, responder preguntas difíciles o responder preguntas de conocimiento. Cuando lo tengas escrito, mira solo la métrica que coincide; por ahora, deja de lado las demás subpuntuaciones y la puntuación global de 75.
| Lo que necesitas hacer | Mira solo esta métrica | Datos de la página de ranking de d1.2-ultra | Cómo interpretarlo |
|---|---|---|---|
| Extraer campos de facturas, currículums y artículos | AA-Paperclip | Puntuación de decisión 75.81, tasa de documentos completamente correctos 67.7%, ambas en el puesto 1/24 | El segundo puesto, Drex Max v1.1, obtiene 72.82 y 63.0%; la ventaja es bastante clara |
| Invocar herramientas y decidir si conviene hacerlo | When2Call | Puntuación de decisión 96.49, puesto 1 | SubQ Snap 1.2 obtiene 96.10, d1.2 obtiene 96.09; los primeros puestos están agrupados en alrededor de 1 punto |
| Evaluación de documentos laborales | EvalSafe-O*NET-AA | Puntuación de decisión 89.53, puesto 3 | Por delante están Jev 1.14 (91.14) y GLiDE v1.2 (89.67) |
| Responder preguntas de opción múltiple muy difíciles | Precisión bruta de HLE-MultiChoice | 2.36%, la más baja entre los 24 modelos de decisión | La puntuación de decisión 46.36 no está en último lugar; la tasa de no alucinación es 76.1%, y a menudo opta por no adivinar |
| Preguntas y respuestas de conocimiento | Precisión de AA-Omniscience | Precisión bruta 23.6%, puesto 20/24 | La puntuación de decisión 60.80 ocupa el puesto 6; tasa de no alucinación 83.8% |
| Estabilidad de la respuesta al reformular | Tasa de aprobación completa de AA-Symmetry | Puntuación 86.34, puesto 2; tasa de aprobación completa 56.7%, puesto 5 | Ser segundo en puntuación no equivale a ser segundo en estabilidad |
Los dos puntos de d1.2-ultra que más fácilmente se malinterpretan
El primero es HLE-MultiChoice. El 2.36% de precisión bruta sí es el más bajo entre los 24 modelos de decisión, pero su puntuación de decisión de 46.36 no queda en último lugar; en la misma página hay puntuaciones más bajas, por ejemplo Mercury Decide con 34.79. Sumado a una tasa de no alucinación del 76.1%, una lectura razonable es: ante preguntas de opción múltiple de razonamiento muy difíciles, d1.2-ultra tiende a no dar respuestas de alta confianza. AA clasifica esta prueba dentro de razonamiento, así que no se puede decir que sea “el último en la prueba de conocimiento”.
El segundo es AA-Omniscience. Su 23.6% de precisión lo coloca en el puesto 20/24, no en último lugar. Lo curioso es que el d1.2 más pequeño, en la misma página, obtiene 30.0% en esta prueba, y también tiene 5.30% de precisión bruta en HLE; ambas cifras superan a ultra. Pero el índice compuesto de d1.2 es 68.69 y ocupa el puesto 9/24, así que “la ultra más cara tiene peor conocimiento” solo aplica a estas dos pruebas, no se puede generalizar a que sea peor en todo.
🎯 Consejo para leer el ranking: si tu trabajo consiste en extraer información de recibos/facturas, el primer puesto de
d1.2-ultraen AA-Paperclip merece tomárselo en serio; si es invocación de herramientas, el primer puesto es real, pero la diferencia con los siguientes clasificados está dentro de 1 punto, así que si cambiarlo o no depende de tus propias muestras.
Cómo usar los datos autodeclarados oficialmente por d1.2-ultra
Liquid también presentó en el mismo blog cinco tipos de tareas nuevas y resultados de pruebas internas. El proveedor indica que estas nuevas tareas todavía no están cubiertas por benchmarks públicos; todos los datos siguientes son autodeclarados por el fabricante, proceden de un conjunto interno reservado y no son resultados de Artificial Analysis.
| Nueva tarea (autodeclarada) | d1.2-ultra | d1.2 | Notas |
|---|---|---|---|
| Lectura de recibos (CORD, SROIE) | 98% | 96% | Si no hay valor, responder not found |
| Fragmentos de información sensible (Nemotron PII), precisión/recall | 94% / 93% | 92% / 88% | Indica la posición de cada fragmento |
| Delimitar objetos según descripción (serie RefCOCO) | 94% | 94% | Ambos empatan |
| Conteo de objetos, tolerancia de 1 (COCO) | 93% | 92% | Estimar un número y dar un rango |
| Identificar cada objeto de la imagen (COCO) | 87% | 90% | En esta fila, el d1.2 más económico obtiene mejor resultado |
En audio, el proveedor afirma que, al clasificar categorías de sonido (ESC-50) y idiomas (FLEURS, 43 idiomas) en grabaciones reservadas, ambos modelos rondan entre el 95% y el 97%. En cuanto al error de calibración, Liquid midió en 13 benchmarks y 22 505 preguntas que d1.2-ultra obtiene 0.8, d1.2 obtiene 1.2, Jev 1.14 obtiene 2.7, Perplexity Decider v1.3 obtiene 3.7 y la Decisions API de GPT-6 Luna obtiene 7.2.
Aquí conviene distinguir con especial cuidado: GPT-6 Luna (Decisions) tiene un índice compuesto de 60.25 en la tabla de decisiones de Artificial Analysis, ocupa el puesto 22/24 y registra una precisión bruta en HLE del 7.86%. Todos estos son resultados de la interfaz Decisions, y no deben tomarse como resultados de la interfaz de chat gpt-6-luna. El blog oficial también menciona «Coming to OpenRouter and Vercel soon» (próximamente en OpenRouter y Vercel); se trata de un avance del proveedor y no implica que ya esté disponible.
d1.2-ultra: inicio rápido y verificación con tus propias muestras
Después de ver el ranking, lo que realmente decide si cambiar o no son tus propios datos. Basta con preparar entre 20 y 50 muestras reales, por ejemplo 30 facturas o 30 currículums, y etiquetar de antemano los campos correctos de cada una; mejor si algunas omiten a propósito algún campo.
Pasos mínimos
- Selecciona entre 20 y 50 muestras de tu negocio, marca manualmente el valor correcto de cada campo y etiqueta como
not foundlos campos ausentes. - Redacta una indicación fija: pide al modelo que genere en JSON los campos indicados y que, para los campos que no encuentre, escriba obligatoriamente
not found, sin hacer conjeturas. - Con el SDK compatible con OpenAI, configura
base_urlcomohttps://api.apiyi.com/v1; primero usagpt-6-lunaenmodely luego cambia agpt-6.1-sol, ejecutando una pasada con cada uno. - Compara muestra por muestra y registra tres cifras: precisión a nivel de campo, tasa de documentos completamente correctos y número de veces que se rellenaron con invenciones campos ausentes.
- Cuando el modelo objetivo pueda invocarse, ejecuta otra pasada con el mismo lote de muestras y la misma indicación, y compara directamente las tres cifras.
Ver el enfoque completo de comparación
– **Entrada**: un archivo de muestras donde cada línea contiene el texto original (o una imagen) y un diccionario de campos etiquetados manualmente.
– **Invocación**: recorre las muestras en un bucle, llama a `client.chat.completions.create` o al endpoint `responses`, establece `temperature` en 0 y exige una salida JSON estricta.
– **Parseo**: cuenta por separado los fallos de parseo de la salida; esto en sí ya es un indicador de usabilidad.
– **Comparación**: compara campo por campo después de normalizar (eliminar espacios, unificar el formato de fecha y conservar dos decimales en los valores monetarios).
– **Conteo de alucinaciones**: los campos etiquetados como not found a los que el modelo sí les asignó un valor se registran por separado como «conjeturas».
– **Resumen**: muestra la precisión por campo, la tasa de documentos completamente correctos, el número de conjeturas y el uso promedio de tokens, para calcular costos más adelante.
Ejecuta primero una línea base con APIYI
Esto consume tokens. d1.2 y d1.2-ultra no están en la lista de modelos de APIYI, así que por ahora puedes usar en APIYI (apiyi.com) los modelos ya disponibles gpt-6.1-sol o gpt-6-luna, con la URL de invocación https://api.apiyi.com/v1, y ejecutar una pasada con el mismo lote de facturas o currículums para ver si los campos son correctos y si inventa valores en campos ausentes. Así tendrás una línea base cuantificable.
Aún no está disponible; pondremos este modelo a disposición lo antes posible. Los modelos y precios se rigen por la lista de modelos de la plataforma.
| Elemento de autoevaluación | Cómo registrarlo | Criterio |
|---|---|---|
| Precisión por campo | Campos correctos / total de campos | Comparar con el modelo actual en producción |
| Tasa de documentos completamente correctos | Proporción de documentos con todos los campos correctos | Corresponde a la «tasa de documentos completamente correctos» de AA-Paperclip |
| Número de conjeturas | Veces en que se rellenó un campo marcado como not found | Cuanto menor, mejor; se alinea con la idea de la tasa de no alucinación |
| Fallos de parseo | Cantidad de entradas cuyo JSON no se puede parsear | Impacta directamente el costo de puesta en producción |
| Uso de tokens | Promedio de tokens de entrada y salida por muestra | Sirve para calcular el costo real |
🚀 Sugerencia para empezar: primero ejecuta 20 muestras con el crédito de prueba gratuito para nuevos usuarios de APIYI (apiyi.com); confirma que la indicación y el script de comparación funcionan bien, y luego amplía a 50 muestras para no gastar el crédito en depuración desde el principio.
d1.2-ultra: precios y modo de invocación
En los precios hay que distinguir las unidades. Los 133 USD del ranking son el coste de ejecución del benchmark “por millón de tareas”; el precio oficial de Liquid es “por millón de tokens de entrada”: d1.2 cuesta 0.02 USD y d1.2-ultra cuesta 0.042 USD, contando solo la entrada. Las imágenes se calculan a 1.5 tokens por cada 32×32 píxeles, al precio de texto; 1024×1024 equivale aproximadamente a 1536 tokens. El texto y las imágenes de una solicitud se cuentan una sola vez; si se hace una pregunta adicional, solo se suma el texto de esa pregunta.
La forma oficial de invocación también difiere de las interfaces de chat habituales: los ID de modelo son d1.2-ultra y d1.2, la dirección es https://api.liquid.ai/decisions/v1/systemone y la clave API se solicita en la consola de Liquid. El blog oficial menciona entradas de texto, imagen y audio; la ficha técnica de la página de Artificial Analysis indica texto e imagen, con una ventana de contexto de 66k. Ese dato de ventana aparece solo en la página del ranking y no es una especificación publicada en el blog de Liquid.
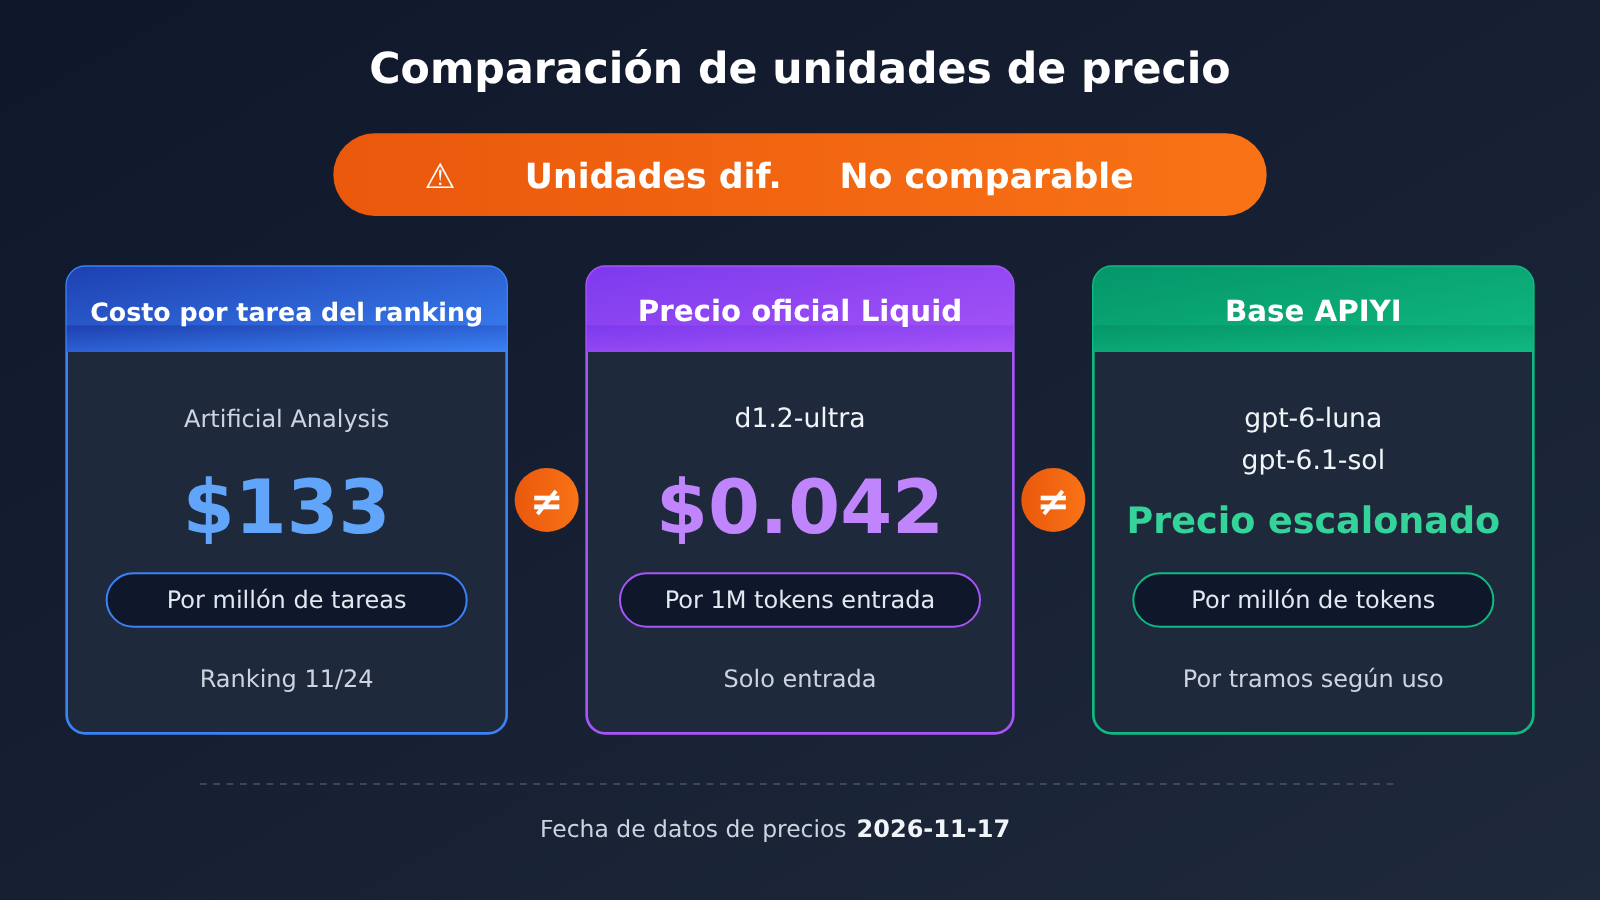
Los modelos de APIYI usados para ejecutar la línea base tienen estos precios (unidad: USD por millón de tokens, por tramos según la cantidad de tokens de cada solicitud; datos del endpoint de tarifas del 2026-11-17, coherentes con la actualización del 2026-11-16 de la tabla general de modelos):
| Modelo | Tramo | Entrada | Salida | Lectura de caché | Endpoint |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses preferente; también chat |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | no listado por separado | igual que arriba |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses preferente; también chat |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | no listado por separado | igual que arriba |
💰 Aviso de coste: para comparar 50 muestras,
gpt-6-lunaes adecuado para ejecutar primero en volumen ygpt-6.1-solpara usarlo como referencia de alta calidad. En APIYI apiyi.com, la recarga se calcula a 1:7, los descuentos por grupo se pueden acumular y el cargo real se rige por lo que indique la consola.
Preguntas frecuentes (FAQ)
P1: ¿Qué modelo es d1.2-ultra?
Es un modelo de decisión publicado por Liquid AI el 2026-11-16, lanzado al mismo tiempo que el modelo más pequeño d1.2. La característica de un modelo de decisión es que asigna una probabilidad a cada opción; destaca en tareas de «tomar decisiones», como extracción de documentos, decisión de invocación de herramientas y clasificación, más que en la redacción de textos largos.
P2: d1.2-ultra ocupa el primer lugar general, ¿es el más fuerte en todos los aspectos?
No. El índice general es 74.85 y ocupa el puesto 1/24, pero EvalSafe-O\*NET-AA queda en el 3.er puesto, la tasa de aprobación total de AA-Symmetry está en el 5.º puesto, la precisión bruta de AA-Omniscience está en el 20.º puesto, y la precisión bruta de HLE-MultiChoice es la más baja entre 24. La puntuación general solo indica que lidera después de la ponderación.
P3: ¿El ítem HLE-MultiChoice cuenta como el último lugar en la prueba de conocimiento?
No. El último lugar lo ocupa la precisión bruta de HLE-MultiChoice, con 2.36%, que es la precisión bruta entre los 24 modelos de decisión; su puntuación de decisión de 46.36 no está en el último lugar, y además AA clasifica este ítem como razonamiento, no como conocimiento.
P4: ¿Para qué escenarios es más adecuado d1.2-ultra?
Según la página de clasificación, lo que mejor encaja es la extracción de campos de facturas, currículos y artículos académicos (la puntuación de decisión y la tasa de acierto total de AA-Paperclip ocupan ambas el 1.er lugar) y la decisión de invocación de herramientas (When2Call ocupa el 1.er lugar, pero los primeros puestos están separados por cerca de 1 punto). Para responder preguntas de opción múltiple difíciles y preguntas de conocimiento, su precisión bruta no lleva ventaja.
P5: ¿Ahora se puede invocar d1.2-ultra en APIYI?
Actualmente, d1.2 y d1.2-ultra no aparecen en la lista de modelos de APIYI. Aún no están disponibles en la plataforma; incorporaremos estos modelos lo antes possible. Las variantes y los precios se rigen por la lista de modelos de la plataforma. Te recomendamos generar primero una línea base con tus propias muestras en APIYI apiyi.com usando `gpt-6-luna` o `gpt-6.1-sol`, y luego cambiar directamente de modelo para comparar.
P6: ¿Se puede confiar directamente en el error de calibración de 0.8 publicado por Liquid?
Es una prueba que Liquid realizó por su cuenta sobre 13 benchmarks y 22505 preguntas, y constituye un dato autodeclarado por la empresa. Lo que la página de clasificación permite corroborar de forma cruzada es que el Brier de 0.150 es el más bajo entre 24, lo cual apunta en la misma dirección; pero, para tu negocio en concreto, aún debes comprobar si en tus propias muestras realmente se adivina menos al azar.
P7: ¿El 7.2 de GPT-6 Luna y el gpt-6-luna de APIYI son lo mismo?
No son lo mismo. El 7.2 es el error de calibración de Decisions API de GPT-6 Luna en las pruebas de Liquid, y el 60.25 de la clasificación también es el resultado de la interfaz Decisions. El `gpt-6-luna` que ofrece APIYI es una interfaz de chat, así que su rendimiento debe medirse con tus propias muestras.
P8: ¿Cuántas muestras hacen falta realmente?
Con 20 a 50 muestras basta para ver diferencias evidentes; la clave es cubrir la distribución real: debe haber muestras de formatos comunes, formatos poco frecuentes y campos faltantes. Si en 50 muestras la diferencia entre ambos modelos es de una o dos unidades, significa que da igual cambiar o no; prioriza el precio y la latencia.
d1.2-ultra Puntos clave
- El 75 compuesto es solo un pretexto: 74.85 ocupa el puesto 1 de 24, con unos 2.2 puntos de ventaja sobre el segundo, pero eso no significa que sea primero en todas las categorías.
- Para extraer documentos, mira AA-Paperclip: puntaje de decisión 75.81 y tasa de acierto total 67.7%, ambos en el puesto 1.
- Para llamar herramientas, mira When2Call: 96.49, puesto 1, pero los primeros puestos están apiñados en torno a 1 punto.
- Para problemas difíciles, mira la precisión bruta: HLE-MultiChoice 2.36% es la más baja; el puntaje de decisión no está en el fondo, y AA lo etiqueta como razonamiento.
- Para preguntas de conocimiento, mira la precisión de Omniscience: 23.6%, puesto 20 de 24; no es el último.
- No mezcles unidades: 133 dólares es por millón de tareas; 0.042 dólares es por millón de tokens de entrada.
- Decide con muestras: primero corre 20 a 50 casos con los modelos disponibles en APIYI apiyi.com, anotando la precisión por campo y cuántas veces adivinó a ciegas.
Resumen
Leer la tabla de clasificación de d1.2-ultra gira en torno a tres pasos:
- Anota el tipo de tarea: extraer documentos, llamar herramientas, responder problemas difíciles o preguntas de conocimiento, y mira solo la subpuntuación que corresponda.
- Distingue los dos números: el puntaje de decisión premia «no adivinar cuando no estás seguro»; la precisión bruta mide «cuánto acertaste»; según la necesidad del negocio eliges cuál mirar.
- Decide con tus propias muestras: 20 a 50 datos reales etiquetados esclarecen más que cualquier puntuación compuesta.
Si tu trabajo es justamente la extracción de documentos, d1.2-ultra merece entrar en la lista de candidatos; si es razonamiento de problemas difíciles o preguntas de conocimiento, no cambies solo porque es primero en la puntuación compuesta. Te recomiendo crear desde ya la línea base en APIYI apiyi.com con gpt-6-luna y gpt-6.1-sol, y comparar con un clic cuando el modelo objetivo esté disponible.
📚 Referencias
-
Blog oficial de Liquid AI – lanzamiento de d1.2: información del lanzamiento, precios oficiales y pruebas autoinformadas
- Enlace:
liquid.ai/blog/d1-2 - Nota: la precisión en las nuevas tareas y el error de calibración son datos autoinformados por el fabricante
- Enlace:
-
Documentación de modelos de decisión de Liquid AI: ID de modelo y dirección de invocación
- Enlace:
docs.liquid.ai/lfm/models/decision-models - Nota: descripción oficial del modo de invocación
- Enlace:
-
Artificial Analysis – página del modelo d1.2-ultra: índice global y desglose por categorías
- Enlace:
artificialanalysis.ai/decision-models/d1-2-ultra - Nota: los datos de la tabla de este artículo se consultaron el 2026-11-17
- Enlace:
-
Artificial Analysis – página de metodología del Decision Index: definición de pesos y puntuaciones
- Enlace:
artificialanalysis.ai/methodology/decision-index - Nota: diferencia entre la puntuación de decisión y la precisión bruta
- Enlace:
-
Tabla general de modelos de APIYI: modelos disponibles y precios
- Enlace:
docs.apiyi.com/models - Nota: los modelos y precios se rigen por la lista de modelos de la plataforma
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: si tienes dudas sobre la selección de modelos o los scripts de comparación, escríbenos desde la página principal del sitio de APIYI; encontrarás más instrucciones de integración en el centro de documentación


