
Anmerkung der Autorin bzw. des Autors: Ein Anteil KI-generierten Codes von über 30 % bedeutet nicht automatisch, dass schneller geliefert wird. Dieser Artikel erklärt, wie die „theoretische Obergrenze von 7 %“ zustande kommt, analysiert fünf Engpässe im Prozess und bietet eine Checkliste für Teams.
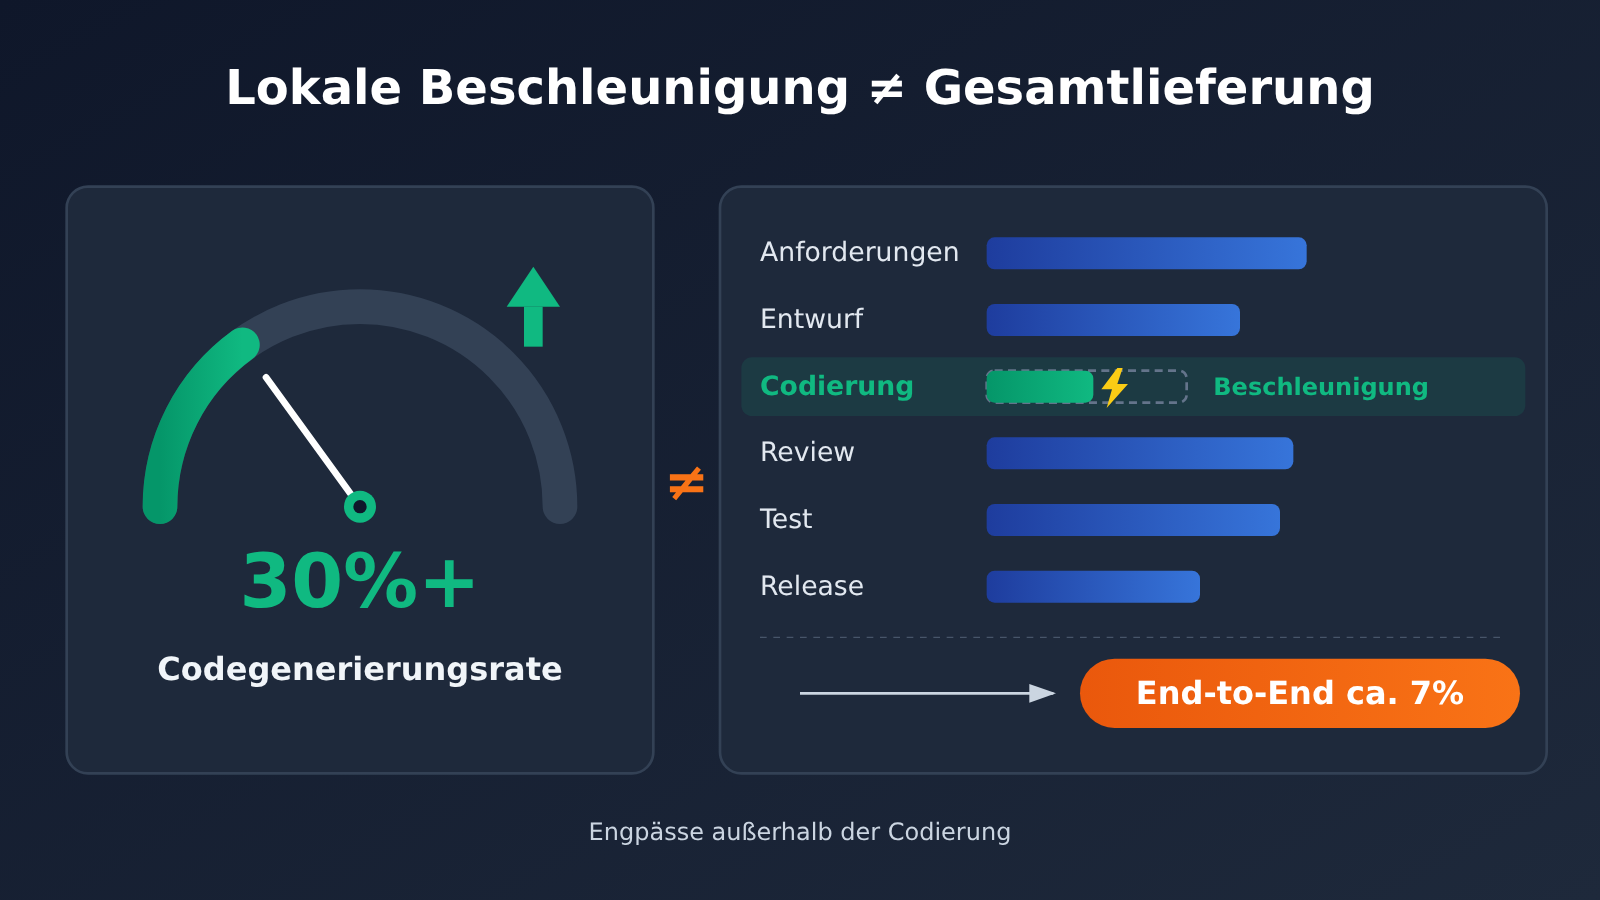
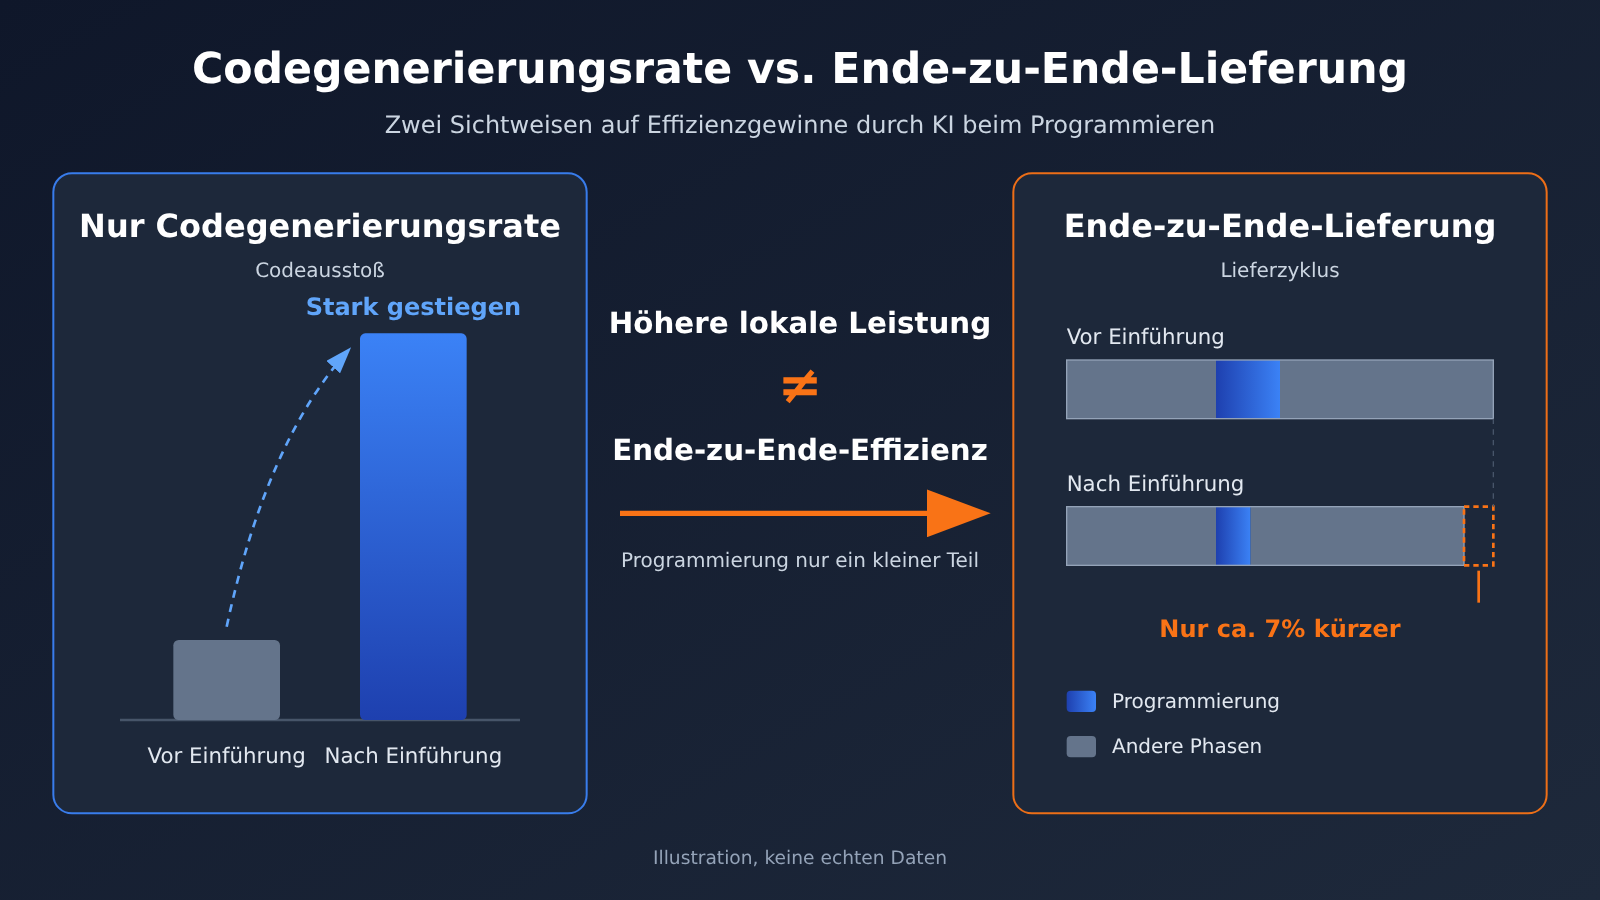
Das Wichtigste zuerst: Der Anteil KI-generierten Codes ist nicht gleichbedeutend mit der Liefergeschwindigkeit. Steigt dieser Anteil von einem einstelligen Wert auf über 30 %, erhöht sich zunächst nur der Output beim Schreiben von Code. Zur End-to-End-Lieferzeit gehören aber auch die Klärung der Anforderungen, das Design, Reviews, Tests, Integrationstests, die Veröffentlichung und die Abnahme. Das Codieren macht oft nur einen Teil dieser Kette aus. Selbst wenn es deutlich schneller geht, lässt sich der Lieferzyklus deshalb nur um den Anteil verkürzen, den das Codieren am Gesamtprozess ausmacht.
Das erklärt auch, warum viele technische Führungskräfte ratlos sind: Die Tools sind eingeführt, die Berichte zum Anteil KI-generierten Codes sehen gut aus – doch der Lieferzyklus hat sich kaum verändert. Eine Branchenveröffentlichung hat anhand der Zeitaufteilung eines Teams errechnet, dass die maximale End-to-End-Effizienzsteigerung in der Größenordnung von 7 % liegt. Das ist keine Absage an KI-gestützte Programmierung, sondern ein Hinweis darauf, dass fünf Engpässe außerhalb des Codierens die Lieferung ausbremsen. Dieser Artikel erklärt, wie die 7 % berechnet werden, wo die Grenzen dieser Rechnung liegen und wie Teams ihre eigene Situation prüfen können.
Über 30 % KI-generierter Code und eine Obergrenze von 7 %: das Wichtigste im Überblick
Bevor wir in die Herleitung einsteigen, zeigt die folgende Tabelle die wichtigsten Aussagen und ihre jeweiligen Grenzen. Besonders wichtig sind die Herkunft und Verlässlichkeit der Zahlen: Die gesamte weitere Analyse baut darauf auf.
| Information | Wert | Einordnung |
|---|---|---|
| Anteil KI-generierten Codes | Über 30 % | Anteil des von KI generierten Codes; erfasst nur das Ergebnis der Codierung |
| Obergrenze für den End-to-End-Effizienzgewinn | Grössenordnung von etwa 7 % | Schätzung auf Basis der Zeitverteilung in einem bestimmten Team, kein allgemeingültiges Gesetz |
| Wert aus Branchengesprächen | Etwa 3–5 % | Beruht auf Gesprächen, ohne überprüfbare Stichprobe |
| Effektiver Code-Durchsatz | Zwei- bis dreifach | Daten aus einem Teamrückblick; Definition und Vergleichsmethode wurden nicht offengelegt |
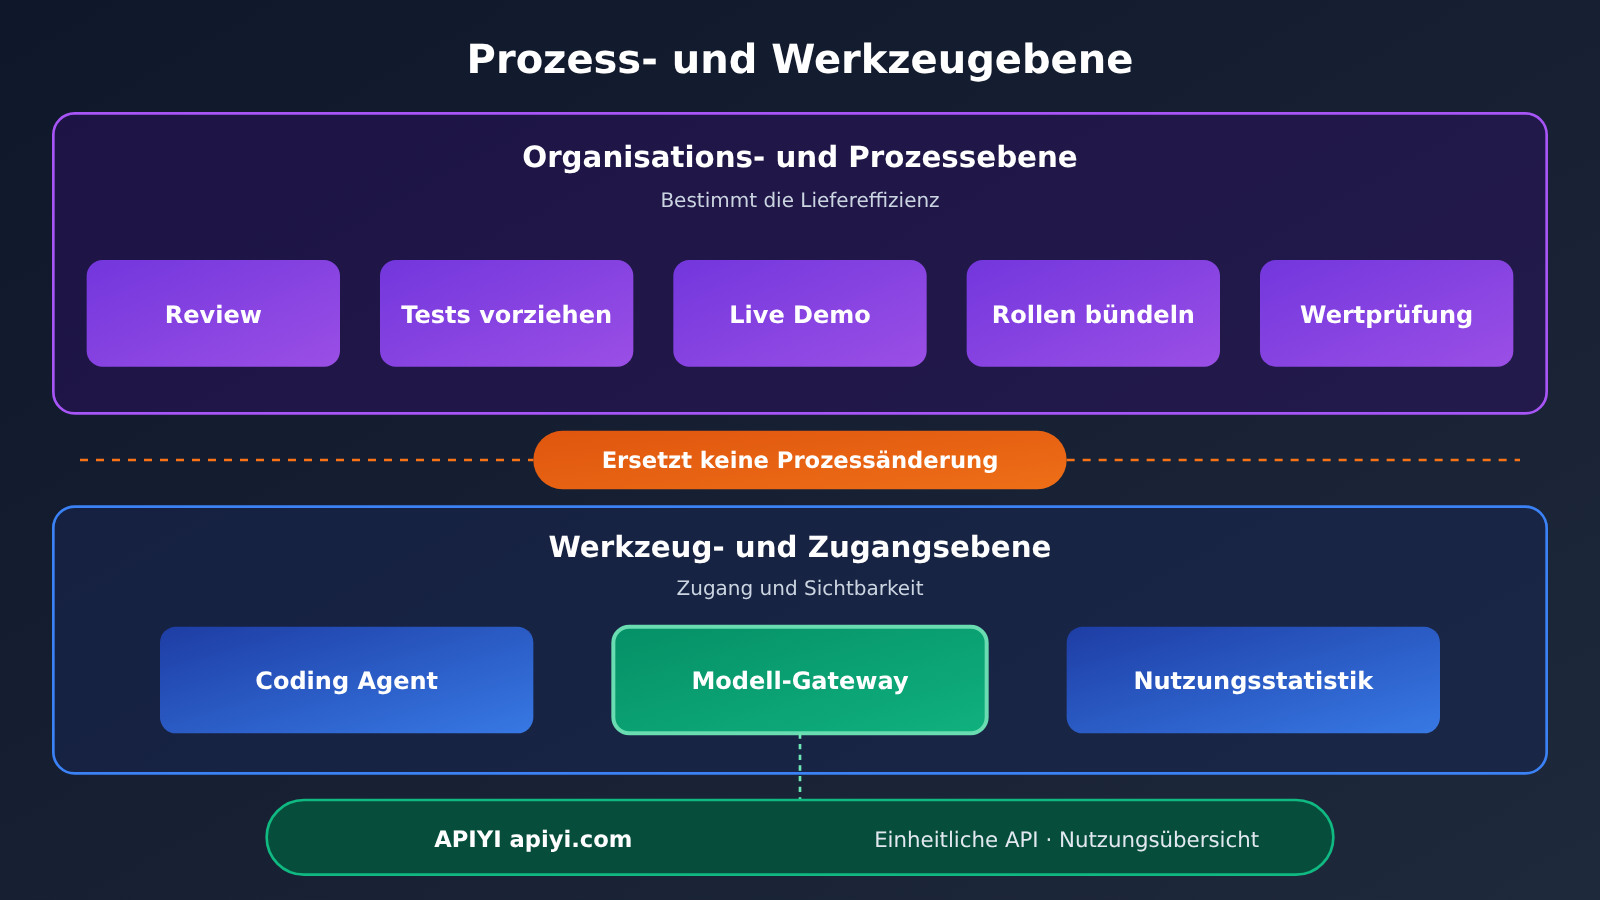
| Fünf Engpässe | Warteschlangen beim Review, frühere Tests und Observability, Live Demo, Zusammenlegung von Rollen, Bewertung des Nutzens | Probleme auf Organisations- und Prozessebene |
| Anbindung von Coding Agents | Einheitlich über aggregierte Schnittstellen wie APIYI apiyi.com möglich | Erleichtert die Anbindung und die Beobachtung der Nutzung, löst aber keine Prozessengpässe |
Diese Zahlen widersprechen sich nicht. Der „zwei- bis dreifache effektive Code-Durchsatz“ beschreibt das Ergebnis der Codierung. Die Werte „7 %“ und „3–5 %“ beziehen sich dagegen auf die End-to-End-Auslieferung. Der erste Wert ist eine lokale Kennzahl, die anderen beziehen sich auf den Gesamtprozess – dazwischen liegt die gesamte Auslieferungskette.
Wie die 7-%-Obergrenze zustande kommt: Anteil des KI-generierten Codes und Anteil der Codierzeit
Die Formel für die End-to-End-Zeitersparnis
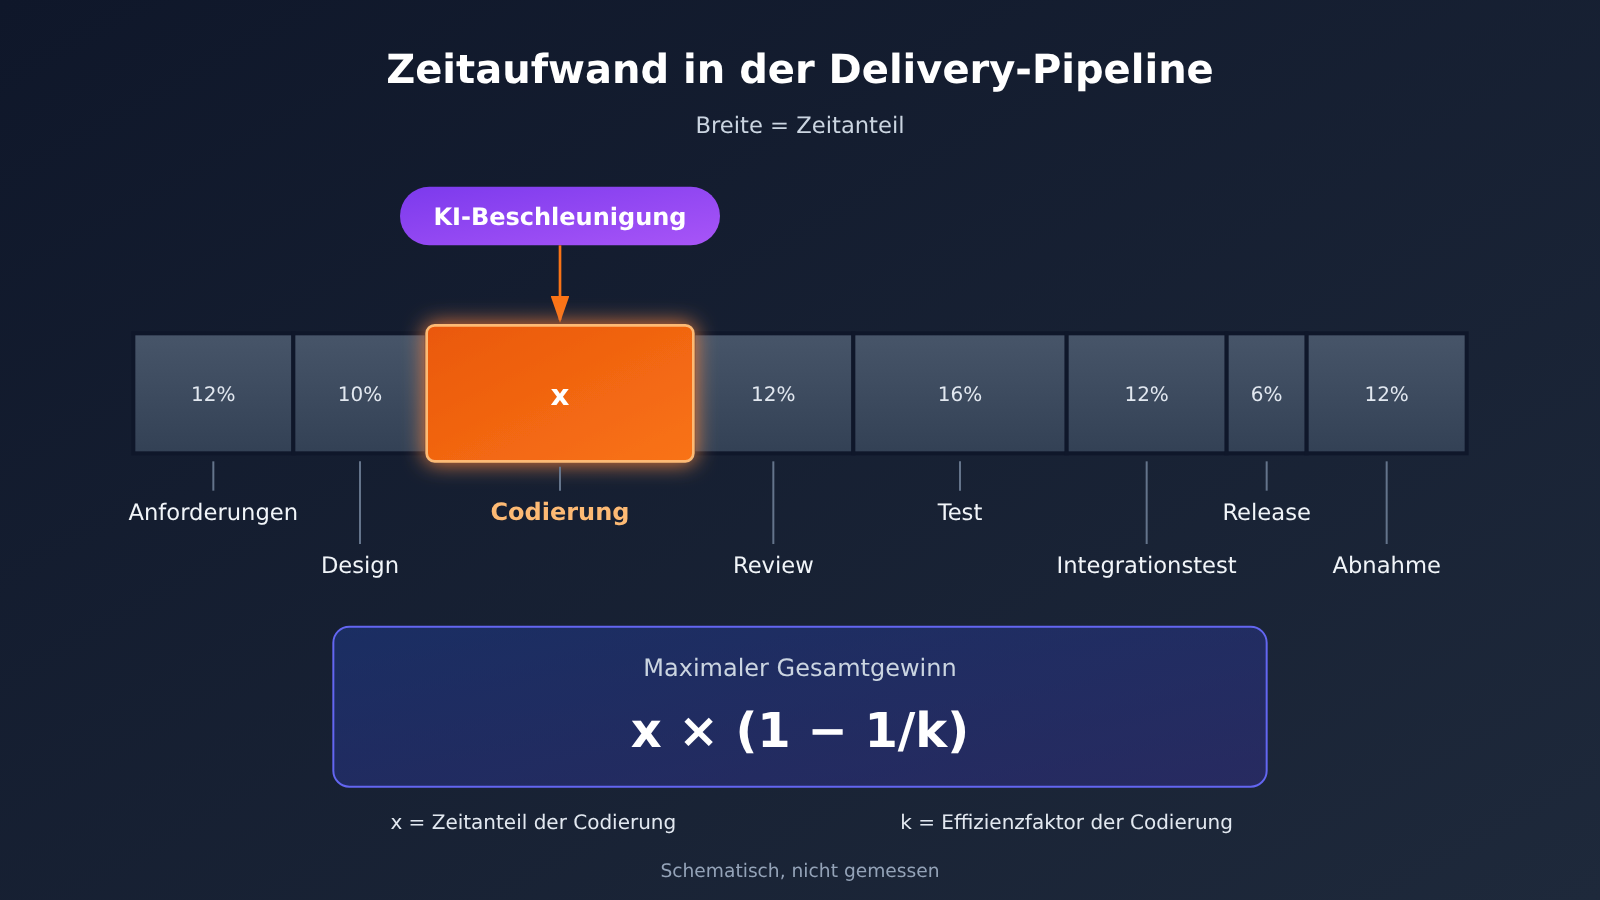
Die Obergrenze der End-to-End-Zeitersparnis lässt sich mit einer einfachen Formel abschätzen: Obergrenze der End-to-End-Zeitersparnis ≈ x × (1 - 1/k). Dabei ist x der Anteil der Codierung an der gesamten Lieferzeit und k der Beschleunigungsfaktor bei der Codierung. Im Grunde ist das eine Anwendung des Amdahlschen Gesetzes auf den Entwicklungsprozess: Wird nur ein Teil des Systems beschleunigt, begrenzt dessen Anteil den Gesamtgewinn.
Ein anschauliches Beispiel: Beträgt der Anteil der Codierung an der Lieferzeit 14 % und verdoppelt KI das Codiertempo (k = 2), ergibt sich 14% × (1 - 1/2) = 7%. Selbst wenn die Codierzeit auf null sinken würde (k geht gegen unendlich), ließe sich die End-to-End-Zeit um höchstens 14 % verkürzen. Die folgende Tabelle zeigt Ergebnisse für verschiedene Annahmen. Sie dienen nur zur Veranschaulichung der Formel und sind keine Messdaten eines Teams.
Anteil der Codierzeit x |
Beschleunigungsfaktor k |
Obergrenze der End-to-End-Zeitersparnis | Einordnung |
|---|---|---|---|
| 10 % | 3 | ca. 6,7 % | Dreimal schneller codiert, insgesamt aber weniger als 7 % gespart |
| 14 % | 2 | 7 % | Ein Beispiel in einer ähnlichen Größenordnung wie die Berechnung im Ausgangsmaterial |
| 20 % | 1,5 | ca. 6,7 % | Bei einem niedrigen Beschleunigungsfaktor fällt der Gesamtgewinn schnell geringer aus |
| 20 % | 2 | 10 % | Teams mit einem hohen Codieranteil haben mehr Spielraum |
| 30 % | 2 | 15 % | Beispiel für ein Team mit hohem Codieraufwand |
| 20 % | Gegen unendlich | 20 % | Theoretische Obergrenze, wenn die Codierzeit auf null sinkt |
30 % KI-generierter Code bedeutet nicht 30 % schnelleres Codieren
Ein weiteres häufiges Missverständnis: Der Anteil des KI-generierten Codes und k sind nicht dasselbe. Der erste Wert beschreibt, wie viel Code die KI schreibt; k gibt an, um welchen Faktor die Codierung schneller wird. KI-generierter Code muss weiterhin gelesen, debuggt und angepasst werden. Auch das Formulieren der Eingabeaufforderung, das Warten und die Fehlerkorrektur kosten Zeit.
Selbst unter der extrem vereinfachten Annahme, dass die KI-generierten 30 % des Codes überhaupt keine Zeit kosten, beträgt der Beschleunigungsfaktor beim Codieren nur 1 / (1 - 0.3) ≈ 1.43. Berücksichtigt man zusätzlich den Anteil der Codierung an der Lieferzeit, fällt die End-to-End-Zeitersparnis noch geringer aus. Die Größenordnung von 7 % im Ausgangsmaterial überrascht daher nicht. Sie zeigt vielmehr, dass der Schlüssel nicht darin liegt, mehr Code zu generieren, sondern in den Schritten außerhalb der Codierung.
Noch einmal zur Einordnung: Die 7 % sind eine Schätzung auf Grundlage der Zeitaufteilung eines bestimmten Teams. Der Codieranteil, die Stabilität der Anforderungen und das Testsystem unterscheiden sich von Team zu Team. Das Ergebnis kann daher höher oder niedriger ausfallen. Der Wert bietet einen Denkrahmen, keine Schlussfolgerung, die sich direkt auf jedes Team übertragen lässt.
5 Engpässe, die die Auslieferung bremsen: die wahren Probleme jenseits der Codegenerierung
Wenn das Schreiben von Code schneller geht, verlagert sich der Druck auf die nachfolgenden Schritte. Einige der folgenden fünf Engpässe werden durch KI-gestützte Programmierung verstärkt. Andere gab es schon immer, sie wurden bisher nur durch das langsamere Codieren verdeckt.
Engpass 1: Code-Reviews stauen sich bei den Schlüsselpersonen
Je mehr Code KI erzeugt, desto mehr Code muss geprüft werden. Die Reviews konzentrieren sich oft auf wenige Schlüsselpersonen. Sie müssen sowohl den fachlichen Kontext verstehen als auch Grenzfälle und potenzielle Risiken des KI-Codes beurteilen. Ein großer Teil der beim Codieren eingesparten Zeit geht dadurch beim Warten auf ein Review wieder verloren.
Erschwerend kommt hinzu: KI-generierter Code „sieht oft richtig aus“. Die prüfenden Personen müssen daher besonders genau lesen, und der Review-Aufwand pro Codeeinheit sinkt nicht unbedingt. Ohne Anpassungen am Review-Prozess werden die Schlüsselpersonen zum größten Engpass der gesamten Kette. Helfen können etwa abgestufte Reviews, klare Regeln dafür, welche Änderungen auch andere Teammitglieder freigeben dürfen, und automatisierte Prüfungen von Standards.
Engpass 2: Tests und Observability früher einbeziehen
In vielen Teams kommen Tests, Monitoring und Observability erst spät in der Entwicklung ins Spiel. Wenn schneller programmiert wird, sammeln sich Probleme umso schneller in der Testphase an – und die Nacharbeit ballt sich am Ende. Werden Testfälle, Instrumentierung und Alarmregeln nicht schon vor oder während der Implementierung mitgedacht, können spätere Integrationstests und Fehlerbehebungen den Zeitgewinn wieder aufzehren.
Tests und Observability früher einzubeziehen bedeutet vor allem, dass „Überprüfen“ und „Programmieren“ parallel stattfinden. Bei KI-generiertem Code ist das besonders wichtig: Sie brauchen ausführbare Tests, um schnell zu prüfen, ob das Ergebnis korrekt ist, statt jede Zeile von Hand durchzugehen.
Engpass 3: Anforderungen mit einer Live-Demo klären und Nacharbeit reduzieren
Das Teuerste im Lieferzyklus ist oft nicht das Schreiben von Code, sondern das nachträgliche Korrigieren einer falschen Umsetzung. Missverständnisse bei den Anforderungen können dazu führen, dass Implementierung, Review und Tests von vorne beginnen. Wenn KI das Programmieren günstiger macht, bietet sich ein besserer Weg an: schnell eine lauffähige Live-Demo erstellen, anhand derer die Anfordernden durch echte Interaktion prüfen können: „Ist es das, was wir gemeint haben?“
Damit wird aus der Prüfung eines Anforderungsdokuments die Prüfung eines Prototyps. Dokumente lassen Raum für unterschiedliche Interpretationen; eine lauffähige Demo deckt solche Unterschiede früh auf. Der eigentliche Vorteil sinkender Programmierkosten liegt deshalb vielleicht nicht darin, den endgültigen Code schneller fertigzustellen, sondern günstiger experimentieren und aus Fehlern lernen zu können.
Engpass 4: Rollen verschmelzen – PDFE und ABE im Wandel
In herkömmlichen Abläufen gibt es zahlreiche Übergaben zwischen Produktmanagement, Design, Frontend, Backend und Testing. Jede Übergabe bedeutet Wartezeit, Kontextverlust und erneuten Abstimmungsbedarf. Die im Material angesprochene Zusammenlegung von Rollen wie PDFE und ABE zielt im Kern darauf ab, dass eine Person oder ein kleines Team einen größeren Teil der Prozesskette abdeckt und so weniger Übergaben nötig sind.
Wenn KI mehr Programmierarbeit übernimmt, haben Entwicklerinnen und Entwickler Kapazitäten, sich stärker mit Anforderungen und Tests zu befassen. Erst dadurch wird die Zusammenlegung von Rollen praktikabel. Allerdings gilt: Für die Voraussetzungen und Kosten einer solchen Umstellung in Teams unterschiedlicher Größe fehlen derzeit belastbare Belege. Für kleine Teams kann sie sich anbieten; in großen Organisationen erfordert sie dagegen grundlegende Änderungen bei Zuständigkeiten, Leistungsbewertung und Zusammenarbeit. Sie lässt sich daher nicht einfach übernehmen.
Engpass 5: Wertprüfung, Begriffswörterbuch und SDD
Sind Begriffe und Datendefinitionen nicht aufeinander abgestimmt, macht die KI umso schneller Fehler, je schneller sie Code schreibt. Wenn derselbe Fachbegriff in verschiedenen Modulen Unterschiedliches bedeutet oder Schnittstellenfelder uneinheitlich definiert sind, treten diese Probleme bei der Integration und Abnahme geballt zutage. Das Material beschreibt deshalb folgendes Vorgehen: zunächst eine Wertprüfung durchführen, dann Begriffe und Daten mithilfe eines Begriffswörterbuchs und SDD (spezifikationsgetriebener Entwicklung) abstimmen und erst danach Code schreiben.
Die Wertprüfung beantwortet die Frage: „Lohnt es sich, das zu tun?“ Das Begriffswörterbuch und SDD klären dagegen: „Sprechen wir über dasselbe?“ Beide Schritte erhöhen zunächst den Aufwand, geben der KI aber einen klaren, konsistenten Kontext. So lässt sich der erzeugte Code leichter von Anfang an auf die Anforderungen abstimmen.
5 Engpässe und passende Maßnahmen
| Engpass | Typische Symptome | Empfohlene Maßnahme | Kennzahl |
|---|---|---|---|
| Review-Warteschlange bei Schlüsselpersonen | PRs warten länger, Schlüsselpersonen sind überlastet | Reviews nach Priorität staffeln, Richtlinienprüfungen automatisieren | Durchschnittliche Wartezeit von PRs |
| Tests und Observability früher einbinden | Nacharbeit fällt vor allem in der Testphase an | Testfälle und Instrumentierung frühzeitig planen | Anzahl der wegen Fehlern zurückgewiesenen Änderungen in der Testphase |
| Anforderungen per Live-Demo bestätigen | Bei der Abnahme stellt sich heraus: „Das war nicht gewollt“ | Anforderungen anhand eines lauffähigen Prototyps bestätigen | Anzahl der Anforderungsänderungen und Nacharbeiten |
| Rollen bündeln | Viele Übergaben und Wartezeiten, Kontext geht verloren | Übergabepunkte reduzieren, Verantwortungsbereiche einzelner Personen erweitern | Anzahl der Übergaben zwischen Prozessschritten |
| Nutzenbewertung und Begriffslexikon/SDD | Bei gemeinsamen Integrationstests gibt es unterschiedliche Interpretationen | Begriffe und Daten vor der Implementierung abstimmen | Anzahl der Probleme in der gemeinsamen Integrationstestphase |
Team-Check: Lieferzeiten und Nutzen der Codegenerierungsrate aufschlüsseln
Statt darüber zu streiten, ob es 7 % oder 3–5 % sind, lohnt es sich, die Zahlen für das eigene Team zu berechnen. Die folgende Methode lässt sich direkt anwenden. Am besten probiert ihr sie zunächst an einem kleinen Projekt aus.
- Phasen aufschlüsseln: Teilt den Weg einer Anforderung bis zum Release in Anforderungsklärung, Design, Programmierung, Review, Test, Integrationstest, Release und Abnahme auf. Erfasst für jede Phase die tatsächliche Bearbeitungs- und Wartezeit.
- Anteil der Programmierung berechnen: Teilt die Zeit für die Programmierung durch die gesamte Lieferzeit. Das Ergebnis ist euer
x. Viele Teams werden feststellen, dass dieser Anteil kleiner ist als gedacht. - Wartezeiten und Nacharbeit ermitteln: Erfasst separat, wie lange Reviews auf ihre Bearbeitung warten, wie oft nach Tests nachgebessert wird und wie häufig sich Anforderungen ändern. Hier verstecken sich oft besonders große Zeitfresser.
- Output und Nutzen unterscheiden: Betrachtet „Code-Output“ und „lieferbaren Nutzen“ getrennt. Codegenerierungsrate und Anzahl der committeten Zeilen gehören zur ersten Kategorie, veröffentlichte Funktionen und Lieferzyklus zur zweiten.
- Im kleinen Rahmen vergleichen: Führt mit einem kleinen Projekt einen Vorher-nachher-Vergleich durch, statt nur auf Berichte zur Codegenerierungsrate zu schauen.
- Zuerst den größten Engpass beheben: Kümmert euch vorrangig um die Phase, die am längsten dauert. Führt nicht alle Werkzeuge und Prozessänderungen gleichzeitig ein.
Die folgende beispielhafte Vorlage zur Zeitaufschlüsselung zeigt, wie ihr eure Daten eintragen könnt. Sie stellt keine echten Teamdaten dar. Tragt eure eigenen Werte ein und prüft, wie groß der Anteil der Programmierung tatsächlich ist.
| Lieferphase | Beispielanteil (angenommen) | Hauptursachen für den Zeitaufwand | Kann KI-gestützte Programmierung direkt beschleunigen? |
|---|---|---|---|
| Anforderungs- und Nutzenbewertung | 15% | Wiederholte Abstimmungen, gemeinsames Verständnis herstellen | Indirekt (Live-Demo) |
| Design | 10% | Lösungsdiskussionen, Reviews | Teilweise |
| Programmierung | 15% | Schreiben, Debugging | Direkt |
| Review | 15% | Wartezeiten, Prüfung | Teilweise (unterstützte Prüfung) |
| Test und Integrationstest | 25% | Ausführung von Testfällen, Nacharbeit | Teilweise (Testfallgenerierung) |
| Release und Abnahme | 20% | Freigaben, Feedback zur Abnahme | Kaum |
Die Vorlage macht die Struktur sichtbar: Wenn die Programmierung nur gut zehn Prozent ausmacht, bleibt der End-to-End-Gewinn selbst bei einer weiteren Verdopplung der Codegenerierungsrate begrenzt. Das eigentliche Potenzial zur Effizienzsteigerung liegt bei Review, Test und Anforderungsklärung.
Coding Agents anbinden und Nutzung beobachten: Was APIYI kann – und was nicht
Bei der Einführung von KI-Programmiertools führen an Anbindung und Kostenüberblick kaum Wege vorbei. APIYI apiyi.com unterstützt die Anbindung von Tools wie Cursor und Cline und bietet eine einheitliche, OpenAI-kompatible Schnittstelle. Mit einem einzigen API-Schlüssel lassen sich gängige Modelle von OpenAI, Claude, Gemini und anderen Anbietern aufrufen. Für die Anbindung genügt es, im jeweiligen Tool base_url auf https://api.apiyi.com/v1 zu setzen.
Für Teams, die die Effektivität der Entwicklung verbessern wollen, sind die Nutzungsdaten besonders wertvoll. Über die Nutzungsstatistik in der Konsole lässt sich beobachten, wie viele Tokens Coding Agents verbrauchen und wie sich die Aufrufe auf verschiedene Modelle verteilen. So kannst du einschätzen, für welche Aufgaben stärkere Modelle sinnvoll sind und wo leichte Modelle ausreichen. Zusammen mit der zuvor betrachteten Aufschlüsselung der Lieferzeiten helfen diese Daten dabei, das Verhältnis zwischen Aufwand und Nutzen beim KI-gestützten Programmieren zu bewerten.
💡 Tipp zur Anbindung: Wenn dein Team mehrere Programmiermodelle evaluiert, kann es diese über APIYI apiyi.com einheitlich anbinden und die Nutzung vergleichen. Neue Nutzer erhalten ein kostenloses Testguthaben – ideal für einen ersten Vergleich in einem kleinen Projekt. Die aktuellen Preise und die Verfügbarkeit der Modelle findest du in der Konsole und in der Dokumentation.
Eines muss aber klar sein: Das Gateway allein verbessert nicht die Effizienz des gesamten Lieferprozesses. Es erleichtert die Anbindung und den Modellwechsel und macht die Nutzung sichtbar. Prozessengpässe wie Wartezeiten bei Reviews, Nacharbeit nach Tests oder Abweichungen von den Anforderungen lassen sich dagegen nur organisatorisch lösen. Wer das Gateway für eine Effizienzlösung hält, begeht denselben Fehler wie jemand, der die Menge des generierten Codes als Lieferkennzahl betrachtet.
Häufig gestellte Fragen (FAQ)
Q1: Warum wird die End-to-End-Auslieferung nur um etwa 7 % schneller, obwohl der Anteil generierten Codes über 30 % liegt?
Weil sich der Anteil generierten Codes nur auf die Codierung auswirkt. Die mögliche End-to-End-Effizienzsteigerung liegt bei etwa `x × (1 – 1/k)`. Macht die Codierung selbst nur einen kleinen Teil der Gesamtzeit aus, begrenzt das den möglichen Nutzen. Die 7 % sind eine Schätzung auf Basis der Zeitaufteilung eines bestimmten Teams, keine allgemeingültige Aussage. Für dein Team solltest du mit eigenen Daten nachrechnen.
Q2: Sind die Angaben von 3–5 % und dem Zwei- bis Dreifachen glaubwürdig?
Beide Angaben sind mit Vorsicht zu betrachten. Die End-to-End-Effizienzsteigerung von 3–5 % stammt aus Gesprächen innerhalb der Branche; überprüfbare Stichproben fehlen. Der zwei- bis dreifache Durchsatz an effektiv nutzbarem Code stammt aus einer Team-Retrospektive, wobei weder die Messgrundlage noch die Vergleichsmethode offengelegt wurden. Die Werte können als Orientierung dienen, eignen sich aber nicht unmittelbar als Entscheidungsgrundlage.
Q3: Welchen der fünf Engpässe sollte man zuerst angehen?
Analysiere zuerst, wie sich die Auslieferungszeit in deinem Team aufteilt, und kümmere dich vorrangig um den zeitaufwendigsten Schritt. In vielen Teams machen Wartezeiten bei Reviews und Nacharbeiten nach Tests den grössten Anteil aus; bei anderen sind häufige Anforderungsänderungen das grösste Problem. Statt alle Änderungen gleichzeitig einzuführen, solltest du jeweils nur den grössten Engpass angehen. So lässt sich die Wirkung leichter beobachten.
Q4: Wie lassen sich Modellnutzung und Kosten von Coding Agents im Team beobachten?
Du kannst die Programmierwerkzeuge über einen gemeinsamen API-Zugang anbinden und dann in der Konsole den Token-Verbrauch und die Verteilung auf die Modelle einsehen. Bindest du beispielsweise Cursor, Cline und andere Tools über APIYI apiyi.com an, kannst du die Nutzungsdaten zentral einsehen. Diese Daten unterstützen die Entscheidungsfindung, lösen aber keine Engpässe in den Arbeitsabläufen – dafür sind organisatorische Massnahmen nötig.
Q5: Eignet sich die Zusammenlegung von Rollen für alle Teams?
Nicht unbedingt. Die Zusammenlegung von Rollen wie PDFE und ABE soll Übergaben reduzieren. Es fehlen jedoch Belege dafür, unter welchen Bedingungen und zu welchen Kosten Teams unterschiedlicher Grösse diese Veränderung übernehmen können. Erprobe den Ansatz zunächst in einer kleinen Gruppe und beobachte, wie sich die Zahl der Übergaben und die Auslieferungszeit verändern. Danach kannst du entscheiden, ob eine breitere Einführung sinnvoll ist.
Codegenerierungsrate und End-to-End-Delivery: Das Wichtigste in Kürze
- Codegenerierungsrate ist nicht gleich Liefergeschwindigkeit: Sie zeigt nur den Output beim Programmieren, nicht die Effizienz der gesamten Delivery.
- Die 7 % ergeben sich aus einer Formel:
x × (1 - 1/k). Der Anteil der Programmierung an der Gesamtzeit begrenzt den möglichen Gewinn. - Zahlen richtig einordnen: Die 7 % wurden für ein bestimmtes Team berechnet, die 3–5 % stammen aus Gesprächen und die Grundlage für die Angabe „2- bis 3-fach“ wurde nicht offengelegt.
- Die Engpässe liegen außerhalb der Programmierung: Reviews, Tests, Anforderungsabstimmung, Übergaben und die Abstimmung von Konzepten machen den größten Teil aus.
- Erst Zeiten aufschlüsseln, dann Prozesse ändern: Kleine Projekte zum Vergleich nutzen und jeweils nur den größten Engpass beheben.
- Tools helfen beim Zugriff und bei der Beobachtung: APIYI apiyi.com ermöglicht den einheitlichen Zugriff auf Coding Agents und die Einsicht in die Nutzung, löst aber keine Prozessprobleme.
Fazit: Was Teams tun sollten, wenn die Codegenerierungsrate über 30 % liegt
Eine Codegenerierungsrate von über 30 % ist ein echter Fortschritt, aber erst der Anfang. Die End-to-End-Delivery hängt von der gesamten Prozesskette ab; die Programmierung macht nur einen Teil davon aus. Die Formel x × (1 - 1/k) zeigt deutlich, wie begrenzt der Effekt einer lokalen Beschleunigung ist. Die 7 % sind nicht deshalb wichtig, weil sie exakt zutreffen, sondern weil sie uns daran erinnern, den Blick von „Wie viel Code wurde geschrieben?“ auf „Wie viel Wert wurde geliefert?“ zu richten.
Das eigentliche Potenzial liegt in Review-Prozessen, der frühzeitigen Einbindung von Tests und Observability, der Anforderungsabstimmung anhand von Live-Demos, der Zusammenführung von Rollen sowie der Bewertung des Nutzens und der Abstimmung von Konzepten. Das sind Aufgaben auf Organisations- und Prozessebene, die kein Tool ersetzen kann. Auf der Tool-Ebene empfiehlt sich APIYI apiyi.com, um einheitlich auf Programmiermodelle zuzugreifen und die Nutzung zu beobachten. Nutzungsdaten und Delivery-Zeiten lassen sich dann gemeinsam auswerten, um Aufwand und Nutzen zu beurteilen.
Checkliste für Teams
- [ ] Habt ihr die gesamte Zeit vom Einreichen einer Anforderung bis zur Veröffentlichung aufgeschlüsselt?
- [ ] Habt ihr den Anteil
xder Programmierung an der gesamten Delivery-Zeit berechnet? - [ ] Erfasst ihr die Wartezeit auf Reviews und die Auslastung von Schlüsselpersonen separat?
- [ ] Werden Testfälle, Instrumentierung und Alerts vor oder während der Programmierung mitgeplant?
- [ ] Nutzt ihr zur Anforderungsabstimmung eine lauffähige Demo statt nur Dokumente?
- [ ] Wie oft wird eine Anforderung auf ihrem Weg bis zur Veröffentlichung zwischen Rollen übergeben?
- [ ] Stimmt ihr vor der Programmierung zentrale Konzepte und Datendefinitionen ab (Begriffsverzeichnis/SDD)?
- [ ] Unterscheiden eure Berichtskennzahlen zwischen „Code-Output“ und „lieferbarem Wert“?
- [ ] Habt ihr Vorher-nachher-Vergleiche mit kleinen Projekten durchgeführt, statt nur Berichte zur Codegenerierungsrate anzusehen?
- [ ] Geht ihr zuerst nur den größten Engpass an, statt alle Tools gleichzeitig einzuführen?
Quellen
- Branchenmaterialien zur Codegenerierungsrate und End-to-End-Delivery: Grundlage für die 7-%-Berechnung, die fünf Engpässe und die Einordnung der Zahlen in diesem Artikel
- Hinweis: Das Material war abgeschnitten. Dieser Artikel basiert ausschließlich auf dem sichtbaren Teil; nicht sichtbare Inhalte wurden nicht berücksichtigt.
- APIYI-Dokumentationszentrum: Informationen zur Anbindung von Programmierwerkzeugen und zu Nutzungsstatistiken
- Link:
docs.apiyi.com - Hinweis: Preise und Modellverfügbarkeit sind der Konsole und der Dokumentation zu entnehmen.
Autor: APIYI-Technikteam
Technischer Austausch: Über die Startseite von APIYI apiyi.com könnt ihr uns kontaktieren. Weitere Informationen zur Anbindung findet ihr im Dokumentationszentrum unter docs.apiyi.com.


