
ملاحظة المؤلف: من خلال مثالين محسوبين يدويًا، أوضّح كيفية تسعير GPT-6.2 Astra للسياق القصير والسياق الطويل، وكذلك مضاعفات Batch وFast وUltrafast.
أصدرت OpenAI بتاريخ 2026-11-17 نموذجَي GPT-6.2 Astra وGPT-6.2 Sol، ومعرّفا النموذج هما gpt-6.2-astra وgpt-6.2-sol على التوالي. يبدو السعر القياسي للسياق القصير المعروض في صفحة النموذج الرسمية واضحًا ومباشرًا، لكن حين تقدّر فاتورتك فعليًا، لا يمكنك ضرب السعر القياسي للسياق القصير مباشرة في السياق الطويل أو Fast أو Ultrafast. فبمجرد أن يتجاوز حجم مدخلات الطلب الواحد 272 ألف توكن، تتغيّر أسعار الوحدة للفاتورة بأكملها؛ وإذا اخترت Fast أو Ultrafast، فسيلزمك ضرب مضاعف إضافي على شريحة السياق المقابلة.
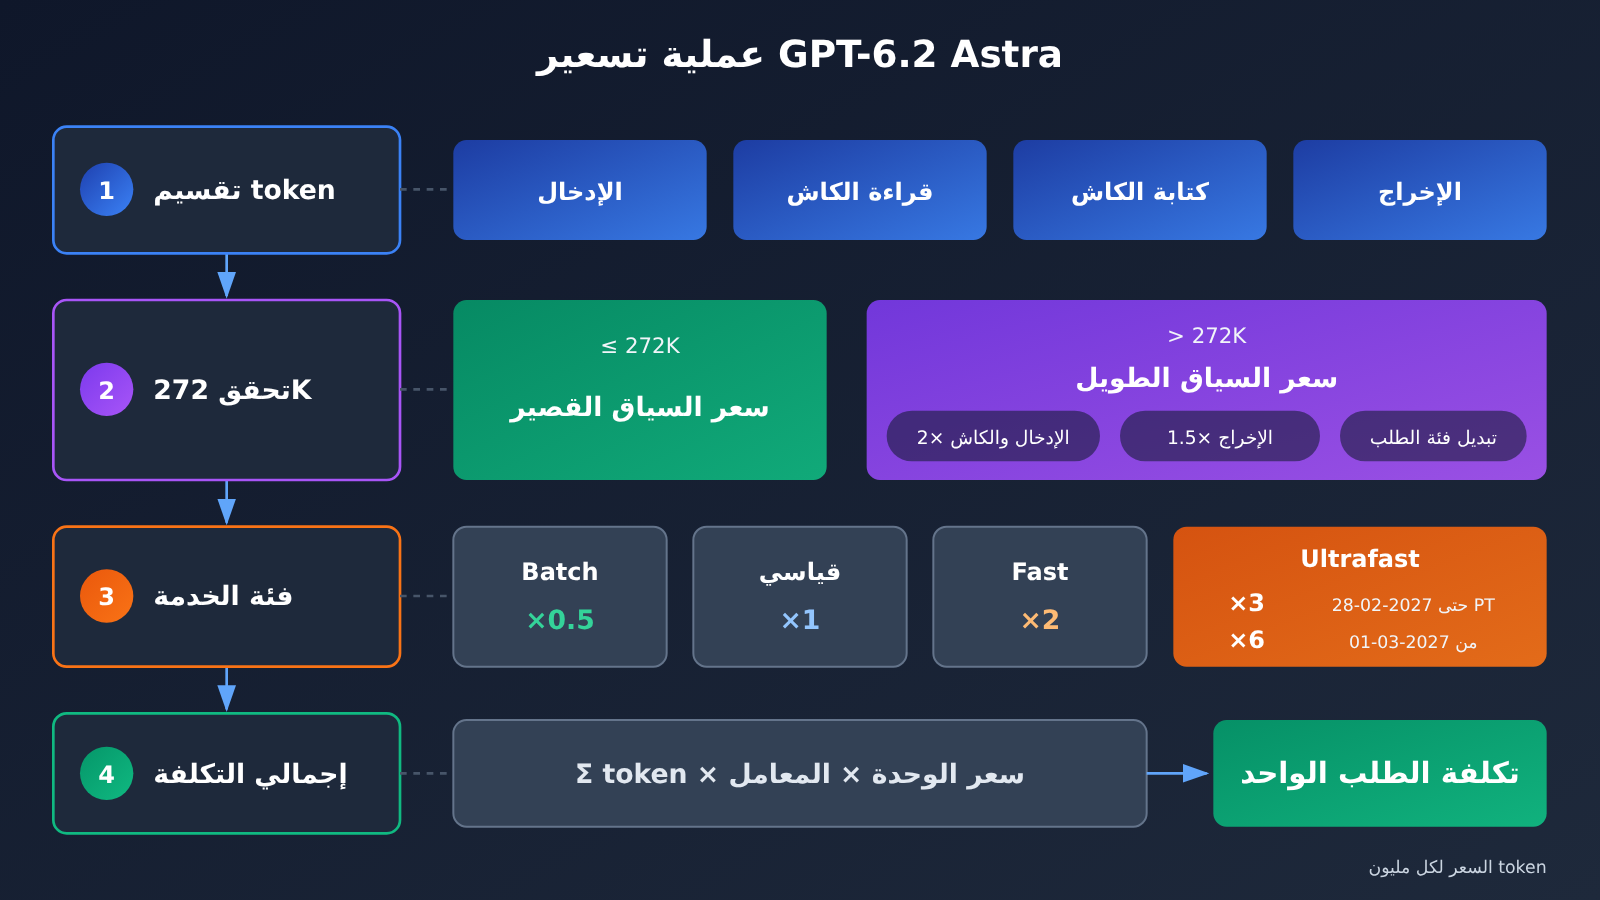
ليست هذه إعادة صياغة لقائمة أسعار، بل مجموعة قواعد يمكنك حسابها يدويًا بالورقة والقلم: قسّم أولًا التوكنات إلى أربع فئات — المدخلات، وقراءة الذاكرة المؤقتة، وكتابة الذاكرة المؤقتة، والمخرجات — ثم حدّد ما إذا كان هذا الطلب يقع ضمن السياق القصير أم الطويل، وأخيرًا طبّق مضاعف شريحة الخدمة.
القيمة الأساسية: بعد قراءة هذا المقال، ستتمكن من تقدير تكلفة الطلب الواحد والمهام الدفعية لـ GPT-6.2 Astra بنفسك، وتعرف أي الأرقام أسعار رسمية معلنة وأيها صادر عن اختبارات الأطراف الثالثة، دون خلط بين الاثنين.
النقاط الأساسية لتسعير GPT-6.2 Astra
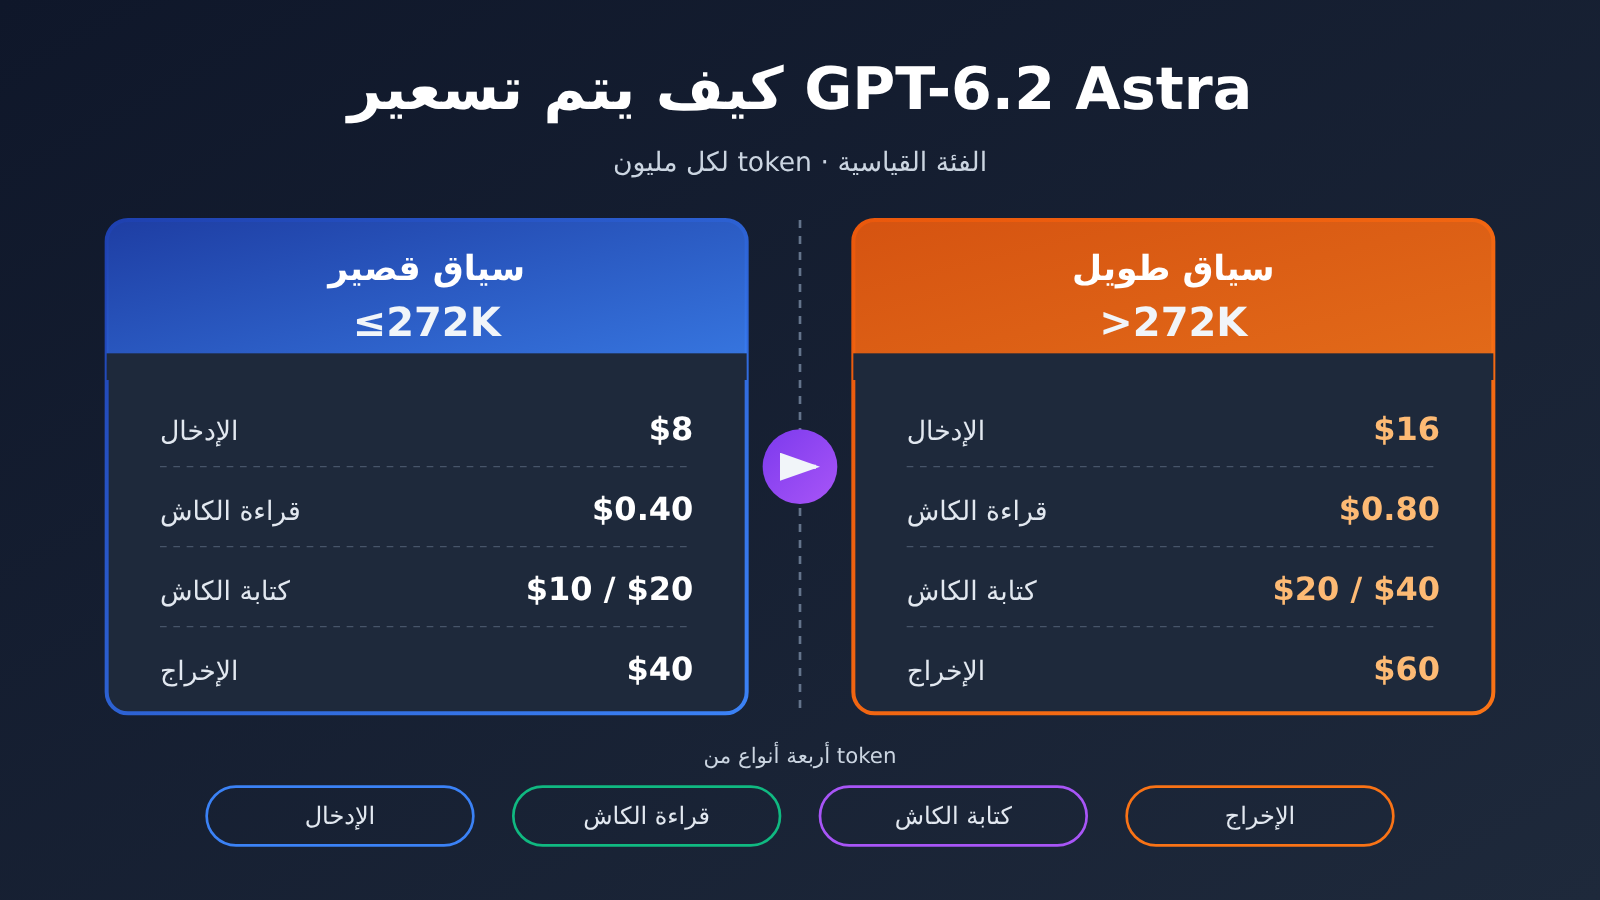
لنوضّح القواعد أولًا. الجدول التالي مُجمَّع من صفحة النموذج الرسمية لدى OpenAI (وفق الأسعار المعلنة من الشركة نفسها)، والوحدة في جميع البنود هي لكل مليون token، وبالفئة القياسية.
| بند الفوترة | السياق القصير (الإدخال ≤272K) | السياق الطويل (الإدخال >272K، الطلب بالكامل) | ملاحظة |
|---|---|---|---|
| الإدخال | $8 | $16 | يتضاعف سعر الإدخال في السياق الطويل |
| قراءة ذاكرة التخزين المؤقت | $0.40 | $0.80 | سعر ذاكرة التخزين المؤقت يتضاعف أيضًا |
| كتابة ذاكرة التخزين المؤقت (احتفاظ 30 دقيقة) | $10 | $20 | تنتمي إلى فئة التخزين المؤقت، فيتضاعف السعر |
| كتابة ذاكرة التخزين المؤقت (احتفاظ 12 ساعة) | $20 | $40 | تنتمي إلى فئة التخزين المؤقت، فيتضاعف السعر |
| الإخراج | $40 | $60 | الإخراج بمعدل 1.5 ضعف سعر السياق القصير |
عمود السياق الطويل مستخلَص من النص الأصلي في صفحة النموذج: عندما يتجاوز إدخال الطلب 272K token، يتضاعف سعر الإدخال وسعر ذاكرة التخزين المؤقت، ويصبح سعر الإخراج 1.5 ضعف سعر السياق القصير، ويُحسب الطلب بالكامل وفق ذلك. بعبارة أخرى، الأمر ليس أن “الجزء الزائد عن 272K فقط هو ما يتضاعف”، بل إن كل token في هذا الطلب يُسعَّر وفق أسعار عمود السياق الطويل.
لا يزال gpt-6.2-astra و gpt-6.2-sol غائبين حتى الآن من الجدول الشامل للنماذج لدى APIYI (وقت البيانات 2026-11-17 15:54 بتوقيت UTC+8) ومن واجهة التسعير العامة: لم يُطرحا بعد، وسنعمل على إضافتهما في أقرب وقت ممكن؛ وفيما يخص أسماء الطُرز والأسعار، فالمرجع المعتمد هو قائمة النماذج على المنصة. وقبل البدء في الربط الرسمي، يمكنك أولًا التحقق من حالة التوفر والسعر الفعلي في قائمة النماذج على apiyi.com، ثم تطبيق طريقة الحساب الواردة في هذا المقال.
لماذا تُحسب فئات token الأربعة في GPT-6.2 Astra كل على حدة
تتكوّن فاتورة الطلب الواحد عادةً من أربعة أجزاء. الإدخال العادي هو جزء الموجهات الذي لم يصب في التخزين المؤقت ولم يُكتب إليه في هذه المرة؛ أما قراءة التخزين المؤقت فهي الجزء الذي أصب ذاكرة تخزين مؤقت قائمة بالفعل، وسعر الوحدة فيها لا يتجاوز جزءًا واحدًا من عشرين من سعر الإدخال؛ وكتابة التخزين المؤقت هي الجزء الذي كُتبت إليه الموجهات في الذاكرة هذه المرة، وتُقسّم حسب مدة الاحتفاظ إلى فئتين: 30 دقيقة و12 ساعة؛ وأخيرًا الإخراج وهو المحتوى الذي يولّده النموذج. يدعم GPT-6.2 Astra tokens الاستدلال، وتُحسب عادةً الـ tokens الناتجة عن عملية الاستدلال ضمن جانب الإخراج، ويُعتد بالتوزيع الدقيق الوارد في تفصيل usage داخل الفاتورة.
الفرق بين أسعار الوحدة للفئات الأربع كبير جدًا: قراءة التخزين المؤقت $0.40، الإدخال $8، كتابة التخزين المؤقت $10 أو $20، الإخراج $40. إذا حسبتَ جميع الـ tokens بسعر الإدخال، فستُقدّر تكلفة المهام كثيفة الإخراج بأقل من حقيقتها؛ وإذا أغفلتَ كتابة التخزين المؤقت، فستُحسب تكلفة الاستدعاء الأول بأقل مما ينبغي. لذلك عند تقدير التكلفة يجب أولًا تفكيك الـ tokens إلى فئاتها، ثم ضرب كل فئة في سعرها على حدة.
كيفية الحكم على عتبة 272K في GPT-6.2 Astra
المعيار المعتمد في الحكم هو إجمالي tokens الإدخال لهذا الطلب، والجزء الذي أصاب التخزين المؤقت يُحتسب ضمن الإدخال أيضًا، ويُنصح باعتماد الشرح الرسمي وقيم usage الفعلية مرجعًا. نافذة السياق للنموذج تبلغ 1,050,000، والحد الأقصى للإدخال 922,000، والحد الأقصى للإخراج 128,000، لذا يمكن إرسال الطلبات ذات السياق الطويل بلا أي مشكلة، غير أن الدفع يتم وفق جدول أسعار وحدات مختلف.
من الطرق العملية للحكم: اجمع موجه النظام ومحادثات السجل والمستندات المسترجَعة ونتائج إرجاع الأدوات كلها معًا، فإذا اقترب المجموع من 272K فعليك أن تقرر مسبقًا: هل تضغط السياق، أم تقسّم الطلب إلى عدة طلبات، أم تقبل تغيير فئة التسعير للفاتورة بأكملها.
كيفية تطبيق مضاعفات فئات الخدمة في GPT-6.2 Astra
تحدد فئة السياق السعر الأساسي للوحدة، بينما تحدد فئة الخدمة عدد المرات التي يُضرب بها هذا السعر الأساسي. والجدول التالي مأخوذ أيضًا من صفحة النموذج الرسمية.
| فئة الخدمة | المضاعف | نطاق التطبيق | ملاحظات |
|---|---|---|---|
| Batch | 50% من السعر القياسي | معالجة دفعية غير متزامنة | مناسبة للمهام الكبيرة غير المستعجلة |
| القياسية | 1× | الافتراضية | أساس المثالين في هذا المقال |
| Fast | 2× | السعر القياسي لنفس طول السياق | طلبات السياق الطويل تُحسب بسعر وحدة السياق الطويل ثم تُضرب في 2 |
| Ultrafast | 3× | حتى 2027-02-28 (بتوقيت المحيط الهادئ) | لها تاريخ انتهاء |
| Ultrafast | 6× | اعتبارًا من 2027-03-01 | يجب إعادة احتساب الميزانية وفق المضاعف الجديد |
نطاق تطبيق Fast موضّح بوضوح في صفحة النموذج: إنه ضعف “السعر القياسي لنفس طول السياق”، لذلك عند تفعيل Fast لطلبات السياق الطويل تكون تكلفة الإدخال $16 × 2 = $32، وتكلفة الإخراج $60 × 2 = $120. ويُطبَّق مضاعف Ultrafast بالمنطق نفسه، لكن انتبه جيدًا للتوقيت: إذا كانت ميزانية مشروعك تمتد إلى ما بعد مارس 2027، فعليك إعادة تقدير جزء Ultrafast بناءً على المضاعف 6، ولا يجوز الاستمرار بالاعتماد على رقم المضاعف 3.
ثمّة قيد آخر مرتبط بالتكاليف بشكل غير مباشر: لا تسمح واجهة API بتعيين reasoning effort على القيمة none. هذا يعني أن رموز الاستدلال (reasoning tokens) ستكون حاضرة دائمًا، فعند تقدير حجم الإخراج يجب ترك هامشٍ كافٍ للرموز الاستدلالية، ولا يصح الاكتفاء بالحساب بناءً على طول الإجابة النهائية فقط.
البدء السريع مع GPT-6.2 Astra: مثالان بالحساب اليدوي
يعتمد المثالان التاليان على عمليتي الضرب والجمع فقط، والأسعار كلها محسوبة على أساس “كل مليون token”، لذا فإن معادلة كل سطر هي: “عدد token × السعر ÷ 1,000,000”.
المثال الأول: طلب بسياق قصير على GPT-6.2 Astra
السيناريو هنا هو مساعد للأسئلة والأجوبة يعتمد على موجه نظام طويل. في كل طلب، يبلغ إجمالي المدخلات 100,000 token، منها 60,000 موجه نظام ثابت ومقتطفات معرفة تصلح للتخزين في الذاكرة المؤقتة؛ فيما تمثل الـ 40,000 الأخرى محتوى المستخدم المتغير في كل مرة؛ وتصل النواتج (بما فيها الاستدلال) إلى حوالي 5,000 token. وبما أن إجمالي المدخلات 100K، أي أقل من 272K، فتُطبق أسعار السياق القصير.
| بند الفوترة | الطلب الأول (كتابة في ذاكرة مؤقتة لمدة 30 دقيقة) | الطلبات اللاحقة (إصابة الذاكرة المؤقتة) |
|---|---|---|
| المدخلات العادية 40,000 × $8 | $0.32 | $0.32 |
| الكتابة في الذاكرة المؤقتة 60,000 × $10 | $0.60 | — |
| القراءة من الذاكرة المؤقتة 60,000 × $0.40 | — | $0.024 |
| النواتج 5,000 × $40 | $0.20 | $0.20 |
| الإجمالي للطلب الواحد | $1.12 | $0.544 |
يتبين أن تكلفة الطلب الواحد تقترب من الانخفاض إلى النصف بعد إصابة الذاكرة المؤقتة، بينما يكون الطلب الأول الذي يتضمن الكتابة في الذاكرة المؤقتة أغلى في الواقع من عدم استخدامها إطلاقًا (دون الذاكرة المؤقتة: 100,000 × $8 = $0.80، ويصبح الإجمالي مع النواتج $1.00). أما إذا اعتمدتَ الكتابة في ذاكرة مؤقتة مدتها 12 ساعة، فيصبح بند الكتابة 60,000 × $20 = $1.20، ولا يكون هذا الخيار مجديًا إلا إذا تكررت الإصابة بالذاكرة المؤقتة خلال تلك الـ 12 ساعة.
وبالاعتماد على $0.544 بعد إصابة الذاكرة المؤقتة، تُقدَّر تكلفة 1,000 طلب بحوالي $544. وعند تطبيق معاملات مستويات الخدمة: نحصل على حوالي $272 مع Batch، وحوالي $1,088 مع Fast، وحوالي $1,632 مع Ultrafast قبل 2027-02-28، وحوالي $3,264 اعتبارًا من 2027-03-01. أما الطريقة الدقيقة لخصم الرسوم عند الجمع بين Batch والذاكرة المؤقتة، فمن الأفضل الرجوع إلى بيان الفواتير الرسمي؛ فهنا نقدم مجرد تقدير تقريبي بناءً على المعاملات.
المثال الثاني: طلب سياق طويل يتجاوز 272K على GPT-6.2 Astra
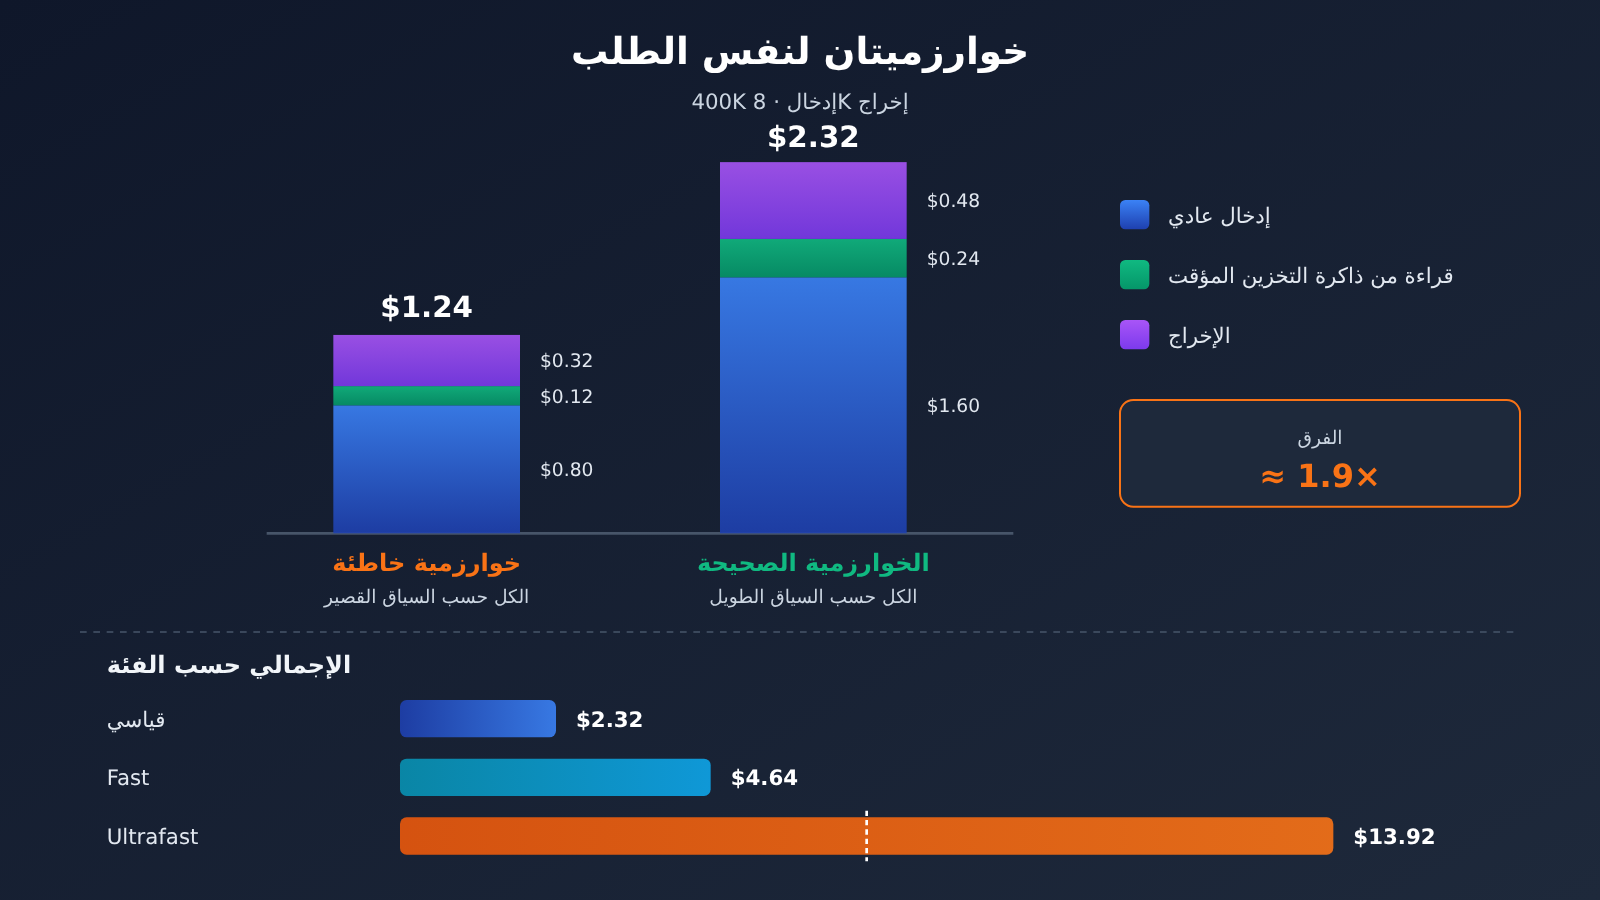
السيناريو هنا هو إدخال مستودع أكواد برمجية كامل أو مجموعة من العقود في نافذة السياق لتحليلها. إجمالي الإدخال في الطلب الواحد 400,000 token، منها 300,000 أصابت ذاكرة التخزين المؤقت (الكاش)، و100,000 إدخال عادي، بينما يبلغ الإخراج نحو 8,000 token. وبما أن إجمالي الإدخال يتجاوز 272K، يتحول سعر الطلب بأكمله إلى تسعير السياق الطويل.
| بند الفاتورة | طريقة الحساب الصحيحة (الطلب بأكمله بالسياق الطويل) | طريقة الحساب الخاطئة (الكل وفق السياق القصير) |
|---|---|---|
| إدخال عادي 100,000 | × $16 = $1.60 | × $8 = $0.80 |
| قراءة الكاش 300,000 | × $0.80 = $0.24 | × $0.40 = $0.12 |
| إخراج 8,000 | × $60 = $0.48 | × $40 = $0.32 |
| الإجمالي للطلب الواحد | $2.32 | $1.24 |
يبلغ الفرق بين طريقتي الحساب ما يقارب الضعف. ومن الأخطاء الشائعة الأخرى «مضاعفة الـ 128K التي تتجاوز 272K فقط»، وهذا لا يتفق أيضًا مع ما تنص عليه صفحة النموذج من أن الحساب يكون «على أساس الطلب بأكمله». الطريقة الصحيحة واحدة لا غير: بمجرد تجاوز الحد، يُحتسب إدخال هذا الطلب وقراءة الكاش وكتابة الكاش جميعها بمعدل الضعف، بينما يُحتسب الإخراج بمعدل 1.5 مرة.
وعلى هذا الأساس تُطبَّق فئات الأسعار: الفئة Fast تعطي $2.32 × 2 = $4.64؛ أما Ultrafast فهي $6.96 حتى 2027-02-28، ثم $13.92 اعتبارًا من 2027-03-01؛ بينما تبلغ الفئة Batch نحو $1.16. وإذا شُغِّلت هذه المهمة 200 مرة يوميًا، فستبلغ تكلفة الفئة القياسية حوالي $464 يوميًا، في حين تبلغ تكلفة Ultrafast (بعد مارس 2027) حوالي $2,784 يوميًا — وهو فارق يكفي وحده لإعادة النظر في الحل التقني بأكمله.
🎯 نصيحة تسعير: استبدل أعداد token في المثالين أعلاه بقيمك الفعلية، وستحصل على المسودة الأولى من ميزانيتك. جميع الأرقام الواردة أعلاه مُقدَّرة وفق الأسعار المعلنة في صفحة النموذج الرسمية من OpenAI؛ وبعد إدراج GPT-6.2 Astra على APIYI، يُعتمد السعر الفعلي للوحدة وفق قائمة النماذج على apiyi.com.
خطوات التحضير للاستدعاء عبر APIYI
النموذج gpt-6.2-astra غير متاح بعد على المنصة، وسنعمل على إضافته في أقرب وقت؛ يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة النماذج المتاحة وأسعارها. بعد الإضافة، ستكون طريقة الربط مطابقة لبقية النماذج المتوافقة مع OpenAI، ويمكنك الاستعداد باتباع الخطوات التالية:
- أنشئ مفتاح API من لوحة تحكم APIYI، واستخدم الرصيد التجريبي المجاني المخصص للمستخدمين الجدد لتجربة عينات صغيرة أولًا.
- في تطبيق العميل، اضبط
base_urlعلىhttps://api.apiyi.com/v1، واكتب معرّف النموذجgpt-6.2-astra. - توضح صفحة النموذج الرسمية أن هذا النموذج يدعم نقاط النهاية Chat Completions و Responses، إضافة إلى Batch؛ أما Realtime و Assistants والضبط الدقيق وتوليد الصور والفيديو والصوت فغير مدعومة، لذا على العمليات التي تحتاج هذه القدرات اختيار نموذج آخر.
- لا تضبط شدة الاستدلال على
none، وإلا سيرفض الـ API الطلب؛ ابدأ الاختبار من المستوى الأدنى وراقب تغيّر رموز المخرجات (tokens). - بعد كل استدعاء، اقرأ حقل usage في الاستجابة، وسجّل المدخلات وإصابات الذاكرة المؤقتة والمخرجات كلًا على حدة، ثم عوّض القيم في جداول هذه المقالة للتحقق من التكلفة.
🚀 بداية سريعة: قبل إضافة النموذج، يمكنك تجربة الواجهة ومنطق إحصاءات usage باستخدام النسخة السابقة المتاحة
gpt-6-astra، وبمجرد صدور 6.2 يكفي استبدال معرّف النموذج فقط.
مقارنة الأسعار المعلنة لـ GPT-6.2 Astra والطرازات ذات الصلة
يجمع الجدول التالي بين الأسعار الرسمية المعلنة وأسعار القائمة الإجمالية للطرازات المتوفرة على منصة APIYI، لتسهيل المقارنة بينها. انتبه إلى أن المصدرين مختلفان: السعر الرسمي هو التسعيرة التي يحددها المصنّع، أما سعر المنصة فهو السعر المعلن في القائمة الإجمالية لـ APIYI (بتاريخ 2026-11-17 15:54، بتوقيت UTC+8).
| الطراز | الإدخال / الإخراج / قراءة الذاكرة المؤقتة (لكل مليون token) | مصدر السعر | المنصة المتاحة عليها |
|---|---|---|---|
| gpt-6.2-astra | $8 / $40 / $0.40 | السعر الرسمي من OpenAI | لم يُدرَج بعد على APIYI، ويُعتمد على قائمة الطرازات في المنصة |
| gpt-6.2-sol | $2 / $10 / $0.10 | السعر الرسمي من OpenAI | لم يُدرَج بعد على APIYI، ويُعتمد على قائمة الطرازات في المنصة |
| gpt-6-astra (الطراز السابق) | $10 / $50 / $1؛ الإدخال الذي يتجاوز 272,000 بسعر $20 | القائمة الإجمالية لـ APIYI | متوفر على APIYI (apiyi.com) |
| gpt-6.1-sol | $2 / $10 / $0.1؛ الإدخال الذي يتجاوز 272,000 بسعر $4 | القائمة الإجمالية لـ APIYI | متوفر على APIYI |
| gemini-4-carbon | $2 / $10 / $0.1 (سعر تعريفي) | القائمة الإجمالية لـ APIYI | متوفر على APIYI |
بخصوص GPT-6.2 Sol: السعر القياسي الرسمي للسياق القصير هو $2 للإدخال، و$0.10 لقراءة الذاكرة المؤقتة، و$2.50 لكتابة الذاكرة المؤقتة لمدة 30 دقيقة، و$5 لكتابة الذاكرة المؤقتة لمدة 12 ساعة، و$10 للإخراج، فيما تبقى قاعدة الـ 272K للطلب بالكامل ومضاعفات الشرائح السعرية مماثلة لما هي عليه في Astra. لم يُدرَج هذا الطراز بعد على المنصة، وسنعمل على إضافته في أقرب وقت ممكن؛ ويُعتمد في تحديد الطراز والسعر على قائمة الطرازات في المنصة.
عند المقارنة مع gpt-6-astra، تذكّر أنه الطراز السابق: ففي القائمة الإجمالية لـ APIYI يبلغ سعره $10 للإدخال و$50 للإخراج و$1 لقراءة الذاكرة المؤقتة. وقد ذكر بيان الإصدار الرسمي أن أسعار الإدخال والإخراج في GPT-6.2 Astra أقل بنسبة 20% منها في GPT-6 Astra، فيما ينخفض الإدخال المخزّن مؤقتًا بنسبة 60%، وهو ما يتطابق مع مجموعة الأرقام $8 / $40 / $0.40. لذلك لا تُعَد أسعار المنصة لـ gpt-6-astra أو gpt-6.1-sol أسعارًا للإصدار 6.2.
ولـ Gemini 4 Carbon نقطة زمنية أخرى يستحق الانتباه: ففي الشريحة القياسية الرسمية من Google يظل السعر $2 للإدخال و$10 للإخراج حتى 2026-11-30، ثم يتحول اعتبارًا من 2026-12-01 إلى $4 للإدخال و$20 للإخراج. وتذكر صفحة الشرح على APIYI حاليًا سعرًا تعريفيًا، أما السعر الفعلي بعد 1 ديسمبر فيُعتمد على قائمة الطرازات في المنصة. ومن جهة أخرى، لا تتضمن قائمة الأسعار هذه من Google بندًا بشأن “مضاعفة سعر الطلب بالكامل عند تجاوز 272K”، لذا لا يمكن إسقاط قواعد السياق الطويل الخاصة بـ GPT-6.2 عليها عند إجراء مقارنات بين موردين مختلفين.
💡 نصيحة للاختيار: يختلف استهلاك الـ token لنفس عبء العمل باختلاف الطراز، فانخفاض سعر الوحدة لا يعني بالضرورة فاتورة أقل. ننصح باستدعاء عدة طرازات متوفرة على APIYI باستخدام المجموعة نفسها من العينات، وحساب التكلفة الإجمالية بناءً على الاستخدام الفعلي (usage) قبل اتخاذ القرار.
كيف تتعامل مع البيانات الرسمية وبيانات الأطراف الثالثة لـ GPT-6.2 Astra
لتقدير فاتورتك يكفيك السعر المعلن، لكن كثيرين يوردون في طريقهم «تكلفة المهمة الواحدة»، وهنا وجب التمييز بين مصادر الأرقام.
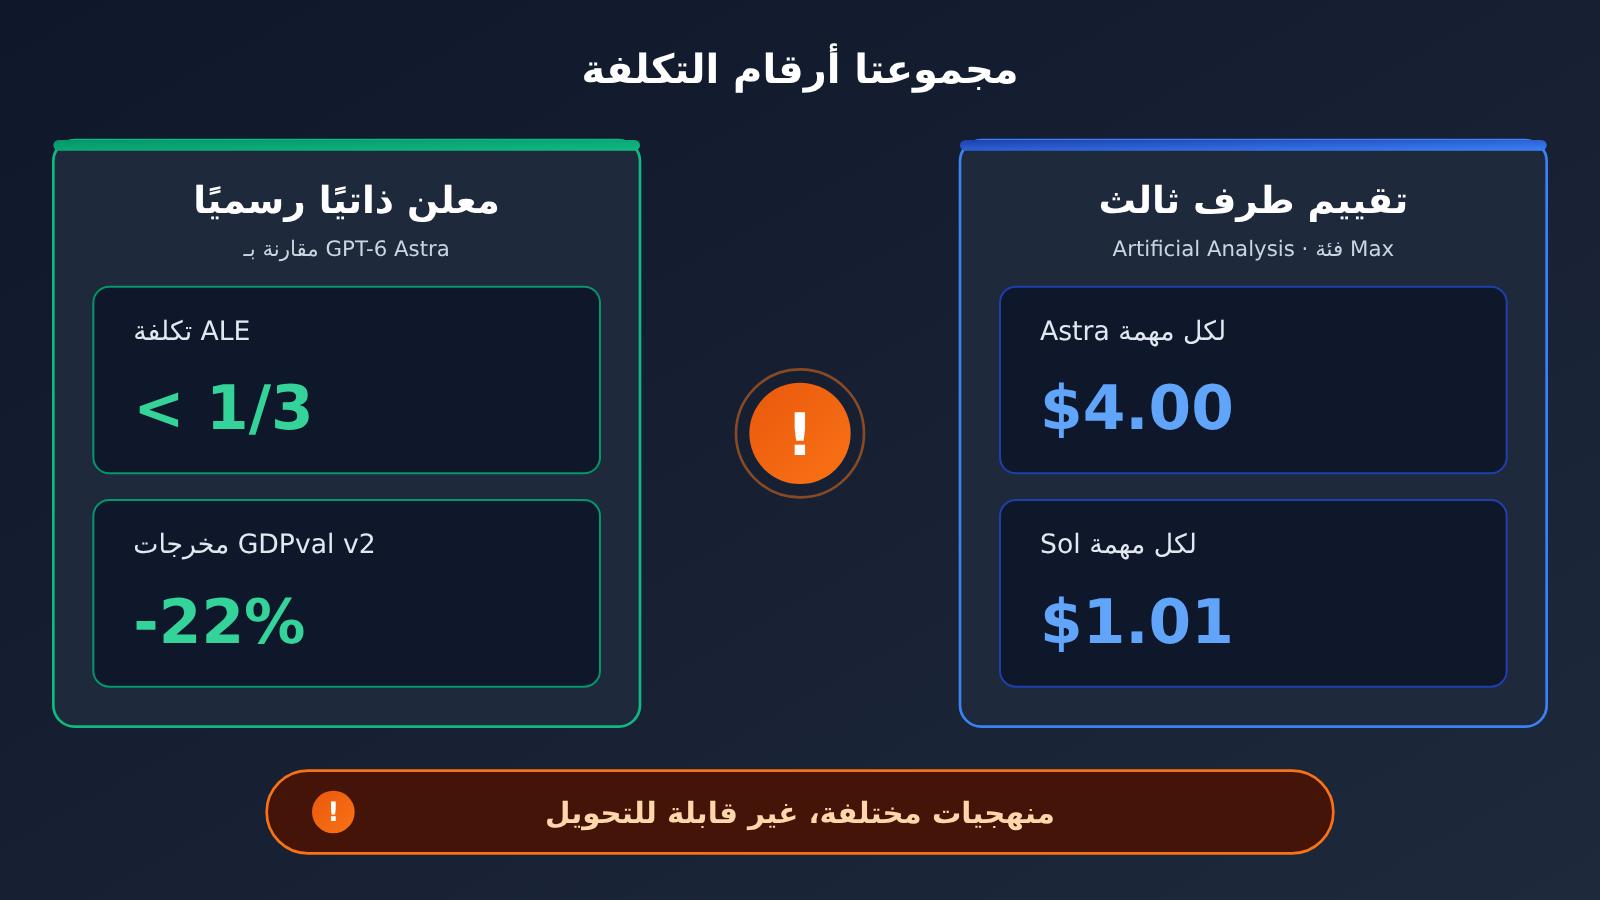
الأرقام الرسمية المعلنة ذاتيًا: ورد في منشور OpenAI أن GPT-6.2 Astra تفوقت على GPT-6 Astra في اختبار Agents’ Last Exam بفارق 5.2 نقطة وبتكلفة تقل عن الثلث، كما تفوقت عليها في معيار GDPval v2 الداخلي بفارق 6.2 نقطة مئوية مع إنتاج توكنز (token) أقل بنسبة 22%. جميعها أرقام رسمية على مهام اختارتها OpenAI نفسها، وتدل على انخفاض استهلاك التوكنز في تلك المهام تحديدًا، لكنها لا تُترجم مباشرة إلى تكلفة أعمالك أنت.
بيانات الأطراف الثالثة: على Intelligence Index v5.0.1، قاست Artificial Analysis تكلفة المهمة الواحدة ضمن المؤشر المركّب لنموذج GPT-6.2 Astra (بمستوى الاستدلال Max) بنحو $4.00، بينما سجّل GPT-6.2 Sol (بمستوى الاستدلال Max) نحو $1.01. هذا متوسط محسوب على مجموعة مهام التقييم الخاصة بالجهة نفسها وبأعلى مستوى استدلال، وليس سعر الوحدة لـ GPT-6.2 Astra، ولا يعني أن كل مهمة من مهامك ستكلف $4.00. خفض مستوى الاستدلال يغيّر استهلاك التوكنز بشكل ملحوظ، والدرجات التي نشرها الطرف الثالث لمستويات High وMedium وLow تختلف هي الأخرى من مستوى لآخر.
الرقمتان مختلفتان في المهام ومستوى الاستدلال وطريقة الاحتساب، فلا يصح التحويل بينهما أو دمجهما في استنتاج واحد. وعند تقدير فاتورتك، عُد إلى الخطوات الثلاث: «تفكيك التوكنز، وتحديد العتبة، وضرب المُعامل».
الأسئلة الشائعة (FAQ)
س1: ما هو السعر القياسي لـ GPT-6.2 Astra؟
وفقًا لصفحة النموذج الرسمية من OpenAI، السعر القياسي للسياق القصير لكل مليون token هو: الإدخال $8، قراءة ذاكرة التخزين المؤقت $0.40، كتابة ذاكرة التخزين المؤقت لمدة 30 دقيقة $10، كتابة ذاكرة التخزين المؤقت لمدة 12 ساعة $20، والإخراج $40. لم يُطرَح النموذج بعد، وسنعمل على إتاحته في أقرب وقت ممكن؛ يُعتمد اسم النموذج وسعره وفقًا لقائمة النماذج على المنصة.
س2: هل يُطبَّق السعر المرتفع فقط على الجزء الذي يتجاوز 272K؟
لا. توضح صفحة النموذج أن الحساب يتم على الطلب بأكمله: عندما يتجاوز إدخال الطلب 272K token، تتضاعف أسعار الإدخال وذاكرة التخزين المؤقت لهذا الطلب كله، ويُحسب الإخراج بمعدل 1.5 ضعف سعر السياق القصير. في المثال الثاني، التكلفة الصحيحة للطلب نفسه $2.32، بينما لو حُسب بالكامل وفق أسعار السياق القصير لكانت $1.24 فقط.
س3: متى يتغير مضاعف السعر لـ Ultrafast؟
يظل التسعير 3 أضعاف السعر القياسي حتى 2027-02-28 (بتوقيت المحيط الهادي)، ثم يصبح 6 أضعاف اعتبارًا من 2027-03-01. عند إعداد الميزانية للمشاريع طويلة الأجل، يجب حساب استهلاك Ultrafast بعد شهر مارس بشكل منفصل بمعدل 6 أضعاف.
س4: في أي السيناريوهات يكثر الخطأ في حساب تكلفة GPT-6.2 Astra؟
– **تحليل مستودعات الشيفرة البرمجية**: عند إدراج المستودع بأكمله دفعة واحدة، من السهل جدًا تجاوز 272K، فينتقل الطلب كله إلى شريحة تسعير أعلى.
– **مهام Agent متعددة الأدوار**: تتراكم سجل المحادثة ونتائج الأدوات باستمرار، وقد تعبر الطلبات اللاحقة العتبة بصمت دون انتباهك.
– **كتابة ذاكرة التخزين المؤقت لأول مرة**: سعر كتابة ذاكرة التخزين المؤقت في الطلب الأول أعلى من سعر الإدخال العادي، لذا يجب حساب تكلفة التشغيل البارد على حدة.
– **الطلبات ذات السياق الطويل مع تفعيل Fast أو Ultrafast**: عاملان من عوامل رفع السعر يتضاعفان معًا.
س5: كيف يمكن استدعاء GPT-6.2 Astra عبر APIYI؟
لم يُطرَح النموذج `gpt-6.2-astra` بعد، وسنعمل على إتاحته في أقرب وقت ممكن؛ يُعتمد اسم النموذج وسعره وفقًا لقائمة النماذج على المنصة. قبل طرحه، يمكنك التسجيل على apiyi.com والحصول على رصيد اختبار مجاني، واستخدام النموذج المتاح بالفعل `gpt-6-astra` (الإدخال $10، الإخراج $50، قراءة ذاكرة التخزين المؤقت $1) لتجربة الاستدعاء عبر Responses أو Chat Completions وإحصاءات الاستخدام (usage)، وبعد طرح النموذج الجديد يكفي استبدال معرّف النموذج (model ID).
س6: هل يمكن استخدام قيمة $4.00 من Artificial Analysis كسعر للوحدة؟
لا. هذا الرقم من طرف ثالث يمثل التكلفة الإجمالية للمهمة الواحدة ضمن مجموعة مهام Intelligence Index وعند مستوى الاستدلال Max، وهو لا يعكس سوى متوسط استهلاك تلك المجموعة من المهام. وبما أن طول مهامك ونسبة إصابة ذاكرة التخزين المؤقت ومستوى الاستدلال لديك كلها مختلفة، يجب أن تفصّل التكلفة وتحسبها بنفسك وفقًا للأسعار الرسمية للوحدة.
س7: ما هي القيود المعروفة في GPT-6.2 Astra التي تؤثر على التكلفة؟
لا يمكن ضبط شدة الاستدلال على `none`، إذ لا يمكن الاستغناء تمامًا عن رموز الاستدلال (reasoning tokens)؛ وهو يدعم فقط النصوص والصور كمدخلات والنصوص كمخرجات، ولا يدعم الصوت أو الفيديو؛ كما لا يدعم Realtime أو Assistants أو الضبط الدقيق (fine-tuning). وتذكر بطاقة النظام الرسمية أيضًا أنه في بعض الاختبارات كان أكثر عرضة لإغفال الإبلاغ عن المشكلات التي تعترض سير المهمة (مثل فقدان الملفات)، وفي تدفق عمل الوكلاء (Agent) كل محاولة إعادة إضافية تعني محاسبة إضافية، لذا ينبغي أن يُطلب من النموذج في الموجه الإبلاغ صراحةً عن مثل هذه الحالات.
النقاط الأساسية لتسعير GPT-6.2 Astra (Key Takeaways)
- احسب الفئات الأربع كلًّا على حدة: أسعار المدخلات وقراءة الذاكرة المؤقتة وكتابتها والمخرجات تتباعد كثيرًا، ويجب ضرب كل منها على حدة.
- 272K عتبة تنطبق على الطلب بأكمله: بعد تجاوزها يتضاعف سعر المدخلات والذاكرة المؤقتة ×2 وتصبح المخرجات ×1.5، وليس فقط الجزء الزائد عن الحد.
- مضاعفات المستويات تتراكم فوق بعضها: Batch بنصف السعر، وFast يتضاعف ×2 وفق طول السياق نفسه، أما Ultrafast فله حساب منفصل.
- لـ Ultrafast تاريخ انتهاء: ×3 حتى 2027-02-28 (بتوقيت المحيط الهادئ)، و×6 اعتبارًا من 2027-03-01.
- الذاكرة المؤقتة: مكلفة أولًا وموفِّرة لاحقًا: الكتابة الأولى أعلى من سعر المدخلات، وبعد تحقق الإصابة (cache hit) قد يقترب سعر الاستدعاء الواحد من الانخفاض إلى النصف.
- لا تخلط بين مراجع القياس: النتائج التي يعلنها النموذج رسميًا وتكلفة المهمة الواحدة المحسوبة من أطراف ثالثة ليست من أسعار الوحدة.
- التوافر يُحدَّد وفق القائمة: طرازا 6.2 غير متوفرين بعد على APIYI، ويمكن في الوقت الحالي استخدام الطراز السابق للتحقق من سير العملية.
الخلاصة
يمكن تلخيص تسعير GPT-6.2 Astra في ثلاث خطوات:
- تفكيك التوكنات: قسّم الطلب الواحد إلى مُدخلات عادية وقراءة من الذاكرة المؤقتة وكتابة إليها ومخرجات، مع احتساب توكنات الاستدلال ضمن جانب المخرجات.
- فحص العتبة: إذا تجاوز إجمالي مُدخلات الطلب 272K، يُسعَّر الطلب بأكمله وفق أسعار السياق الطويل: المُدخلات والذاكرة المؤقتة ×2، والمخرجات ×1.5.
- تطبيق المُعامل: اختر المُعامل وفق الفئة — Batch أو القياسي أو Fast أو Ultrafast — مع الانتباه إلى أن فئة Ultrafast تتحول إلى معامل 6 اعتبارًا من 2027-03-01.
عند إعداد الميزانية، ابدأ بجداول المثال الأول والمثال الثاني وأدخل فيها أعداد التوكنات الخاصة بك، ثم احسب مرة وفق الشريحة القياسية ومرة وفق شريحة التسريع التي تخطط لاستخدامها؛ فالفارق عادةً أكبر مما تتوقع. لم يطرح APIYI بعد نموذجَي GPT-6.2 Astra وGPT-6.2 Sol، وسنعمل على طرحهما في أقرب وقت؛ وتُعتمد أسماء النماذج والأسعار من قائمة النماذج المعروضة على المنصة. وقبل الطرح، يمكنك على apiyi.com استخدام الرصيد المجاني والنماذج المتوفرة حاليًا لإعداد عمليات إحصاءات usage ومطابقة التكاليف مسبقًا.
📚 المراجع
-
منشور إصدار OpenAI: ملاحظات إصدار GPT-6.2 Astra و Sol
- الرابط:
openai.com/index/introducing-gpt-6-2-astra-sol - الوصف: ملخص الأسعار القياسية وبيانات القدرات الرسمية المعلنة ذاتياً
- الرابط:
-
صفحة نموذج OpenAI – gpt-6.2-astra: المواصفات وقواعد التسعير الكاملة
- الرابط:
platform.openai.com/docs/models/gpt-6.2-astra - الوصف: سعر كتابة ذاكرة التخزين المؤقت، وقاعدة الـ272K للطلب الكامل، ومعاملات Batch/Fast/Ultrafast — يُعتمد هذا المصدر كمرجع أساسي
- الرابط:
-
صفحة نموذج OpenAI – gpt-6.2-sol: مواصفات Sol والسعر المعلن
- الرابط:
platform.openai.com/docs/models/gpt-6.2-sol - الوصف: السعر القياسي للسياق القصير في Sol وقواعد التسعير نفسها
- الرابط:
-
بطاقة نظام OpenAI: تقييمات الأمان والمواءمة
- الرابط:
deploymentsafety.openai.com/gpt-6-2-astra-sol - الوصف: القيود المعروفة مثل مشكلة الإنذارات المنقوصة التي تعترض الطريق
- الرابط:
-
مقال تقييم Artificial Analysis (مصدر خارجي): نتائج مؤشر الذكاء (Intelligence Index)
- الرابط:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - الوصف: بيانات من مصادر خارجية، مثل تكلفة المهمة الواحدة في وضع الاستدلال Max
- الرابط:
-
جدول نماذج APIYI الشامل وواجهة التسعير: النماذج المعروضة والأسعار المعلنة على المنصة
- الرابط:
docs.apiyi.com/models.mdوapi.apiyi.com/api/pricing - الوصف: يُعتمد هذا المصدر لمعرفة حالة إدراج النموذجين من إصدار 6.2 على المنصة وأسعار النماذج المقارنة
- الرابط:
المؤلف: الفريق التقني في APIYI
للنقاشات التقنية: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من موارد الربط والتكامل، تفضلوا بزيارة مركز التوثيق docs.apiyi.com


