
ملاحظة المؤلف: يظهر d1.2-ultra في المركز الأول على Decision Index v2.1. يعلّمك هذا المقال أولاً أن تحدد ما إذا كان عملك يندرج تحت استخراج المستندات أو استدعاء الأدوات أو الإجابة عن الأسئلة الصعبة، ثم تنظر فقط إلى البند الفرعي المطابق، وبعد ذلك تستخدم من 20 إلى 50 عينة من بياناتك لتقرر ما إذا كنت ستستبدل النموذج أم لا.
في 2026-11-16، أصدرت Liquid AI الإصدارين d1.2 وd1.2-ultra. وتذكر المدونة الرسمية أن d1.2-ultra حصل على 75 في Artificial Analysis Decision Index v2.1، وهو الأعلى بين نماذج اتخاذ القرار. كثير من المطورين الذين يعملون على استدعاء واجهات API، حين يرون «المركز الأول»، تكون ردة فعلهم الأولى استبدال نموذج الإنتاج.لا تتسرع في الاستبدال؛ فالدرجة الإجمالية 75 ليست سوى نقطة انطلاق، وما ينبغي أن تنظر إليه حقًا هو درجة البند الفرعي الذي يتوافق مع عملك.
هذا ليس مقالاً للتقليل من شأن النموذج أو للترويج له. النموذج نفسه يحتل المركز الأول في استخراج المستندات، لكن دقته الخام في أسئلة الاختيار من متعدد الصعبة هي الأدنى بين 24 نموذج اتخاذ قرار. الحقيقتان صحيحتان في الوقت نفسه، والدرجة الإجمالية تطمس الفرق بينهما.
القيمة الأساسية: بعد قراءة هذا المقال، ستعرف أي بند فرعي يجب أن تنظر إليه، وكيف تقرأ درجة القرار والدقة الخام، وكيف تستخدم من 20 إلى 50 عينة من بياناتك للوصول إلى خلاصة حول الاستبدال أو عدمه خلال فترة بعد الظهر.
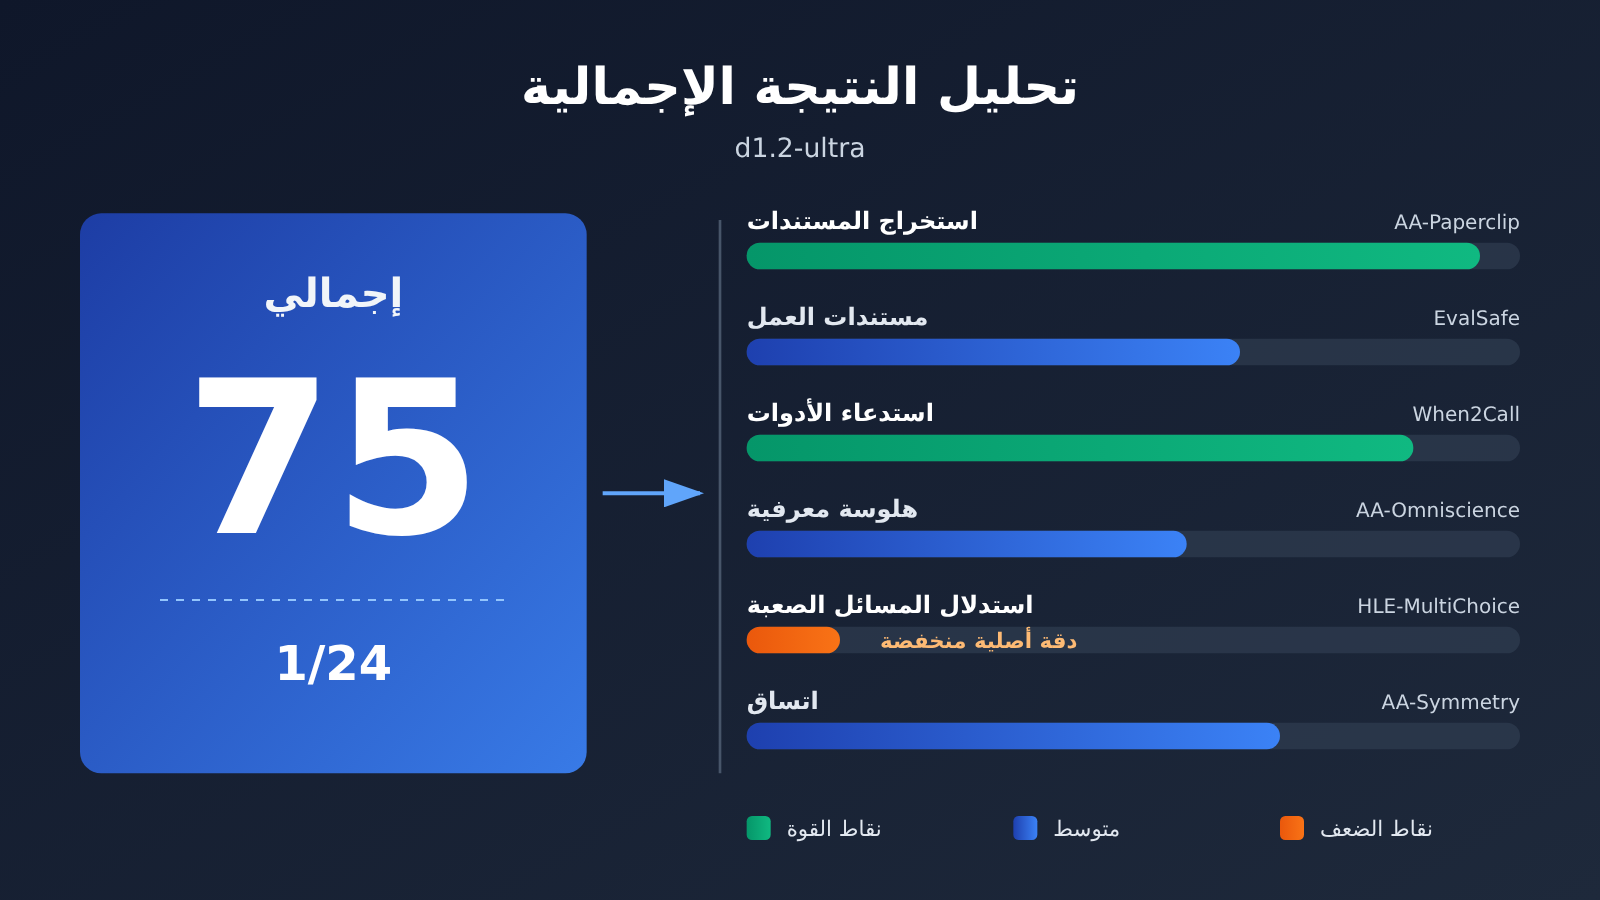
النقاط الرئيسية لاحتلال d1.2-ultra المركز الأول في التصنيف العام
لنبدأ بتوضيح الأرقام الموجودة على صفحة لوحة الترتيب. البيانات التالية مأخوذة من صفحة نموذج d1.2-ultra على Artificial Analysis، بتاريخ قراءة 17 نوفمبر 2026، ويبلغ عدد نماذج اتخاذ القرار المشاركة في المقارنة 24 نموذجًا.
| البند | بيانات صفحة لوحة الترتيب | طريقة القراءة |
|---|---|---|
| المؤشر المركب | 74.85، وتعرض الصفحة 75، المرتبة 1/24 | المركز الثاني Drex Max v1.1 عند 72.62، أي فارق نحو 2.2 نقطة، وهو نفسه ما تسميه الجهة الرسمية «نقطتين» بعد التقريب |
| زمن التنفيذ | 218 مللي ثانية/مهمة، المرتبة 14/24 | الوسيط في الصفحة 209 مللي ثانية، أي في المدى المتوسط |
| تكلفة إكمال المؤشر | 133 دولارًا لكل مليون مهمة، المرتبة 11/24 | هذه تكلفة المهمة، وليست السعر المعلن لكل مليون توكن |
| سعر الإدخال | 0.042 دولار لكل مليون توكن | متوافق مع مدونة Liquid الرسمية؛ فالجهة الرسمية تحتسب الإدخال فقط |
| Brier | 0.150، وهو الأدنى بين 24 | كلما انخفض كان أفضل، فهو يشير إلى أن الاحتمالات المقدمة «صادقة» نسبيًا |
كيف تُحسب الدرجة الإجمالية لـ d1.2-ultra؟
Decision Index v2.1 هو متوسط مرجح لستة بنود فرعية. وتعريف صفحة النموذج لدرجة القرار هو: درجة الدقة مطروحًا منها درجة Brier لاحتمال الإجابة المختارة، بنطاق من 0 إلى 100، وكلما زادت كان أفضل. أي أن الإجابة الخاطئة بثقة تُخصم منها نقاط أكثر من الإجابة الخاطئة بتردد. أما الدقة الخام فهي نسبة الأسئلة التي منح فيها النموذج أعلى احتمال للخيار الصحيح، وليست الرقم نفسه الذي تمثله درجة القرار.
هذا الفرق يؤثر مباشرة في طريقة قراءتك لـ d1.2-ultra. يمكن لنموذج أن يحصل على درجة قرار ليست منخفضة بفضل كثرة الامتناع عن التخمين وقلة الأخطاء الواثقة، بينما تكون دقته الخام منخفضة جدًا. إذا كان عملك يتطلب «تقديم إجابة إلزامية»، فعليك النظر إلى الدقة الخام؛ أما إذا كان يسمح بـ «التحويل إلى موظف بشري عند عدم اليقين»، فدرجة القرار أكثر فائدة كمرجع.
| البند الفرعي | الوزن | ما الذي يقيسه | تصنيف AA |
|---|---|---|---|
| AA-Paperclip | 30% | الحكم على المستندات واستخراج البيانات؛ مستند واحد فيه 15 إجابة يُحتسب حكمًا واحدًا | مستندات |
| EvalSafe-O*NET-AA | 15% | الحكم على مستندات العمل | مستندات |
| When2Call | 10% | استدعاء الأدوات | أدوات |
| AA-Omniscience-Decision v1.1 | 15% | المعرفة والهلوسة | معرفة |
| HLE-MultiChoice v1.1 | 15% | أسئلة Humanity’s Last Exam النصية متعددة الخيارات، مع إمكانية رفض الإجابة | استدلال |
| AA-Symmetry v1.1 | 15% | إعادة الصياغة وتغيير ترتيب الخيارات والنفي، ثم الحكم على ثبات الإجابة | اتساق |
لاحظ أن HLE-MultiChoice مصنف لدى AA على أنه استدلال، وليس معرفة. لذلك عند ذكره لاحقًا، لا يجوز وصفه بأنه «اختبار معرفة».
كيف تعرف البند الذي ينطبق عليك في d1.2-ultra
الخطوة الأولى ليست النظر إلى لوحة الترتيب، بل إحضار ورقة وكتابة نوع العمل الذي تقوم به فعلاً: استخراج البيانات من المستندات، أم استدعاء الأدوات، أم الإجابة عن أسئلة صعبة، أم الإجابة عن أسئلة معرفية. بعد الكتابة، انظر فقط إلى البند المطابق، وتجاهل مؤقتًا بقية البنود والدرجة الإجمالية 75.
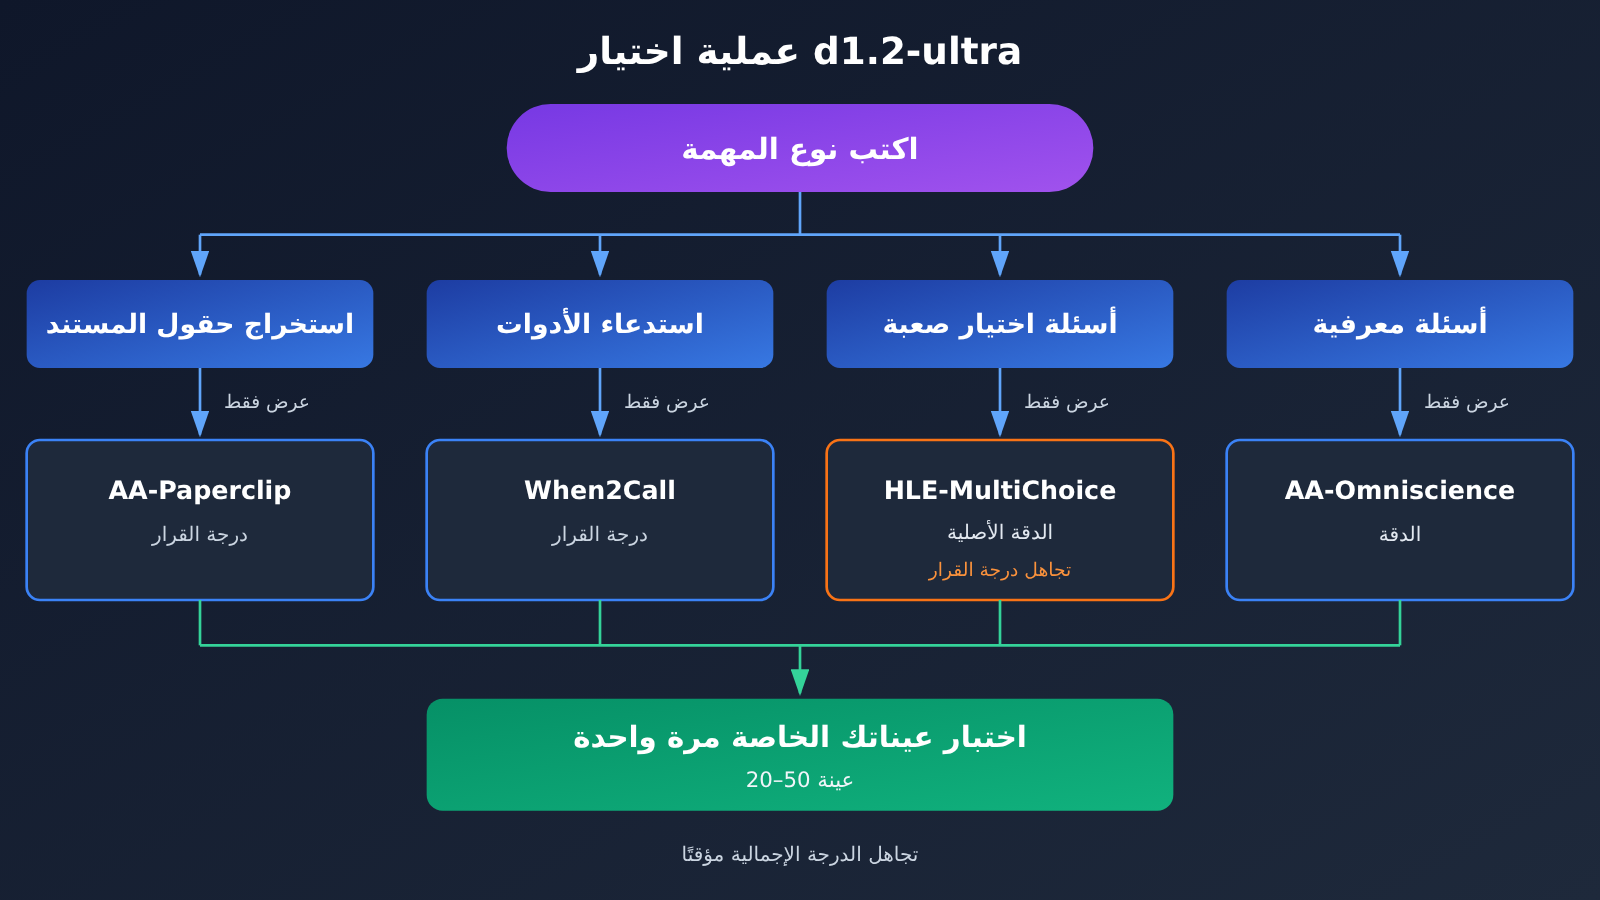
| ما تريد القيام به | ما تنظر إليه فقط | بيانات صفحة ترتيب d1.2-ultra | كيف تفهمها |
|---|---|---|---|
| استخراج حقول الفواتير والسير الذاتية والأوراق البحثية | AA-Paperclip | درجة القرار 75.81، ونسبة المستندات المطابقة بالكامل 67.7%، وكلتاهما في المركز 1/24 | صاحب المركز الثاني Drex Max v1.1 سجل 72.82 و63.0%، لذا التقدم واضح نسبيًا |
| استدعاء الأدوات وتحديد ما إذا كان ينبغي استدعاؤها | When2Call | درجة القرار 96.49، المركز الأول | SubQ Snap 1.2 عند 96.10، وd1.2 عند 96.09، والمراكز الأولى متقاربة ضمن نحو نقطة واحدة |
| تقييم مستندات العمل | EvalSafe-O*NET-AA | درجة القرار 89.53، المركز الثالث | يسبقه Jev 1.14 (91.14) وGLiDE v1.2 (89.67) |
| الإجابة عن أسئلة اختيار من متعدد صعبة جدًا | الدقة الخام في HLE-MultiChoice | 2.36%، وهي الأدنى بين 24 نموذج قرار | درجة القرار 46.36 ليست الأدنى، ومعدل عدم الهلوسة 76.1%، إذ يختار كثيرًا عدم التخمين |
| أسئلة معرفية | دقة AA-Omniscience | الدقة الخام 23.6%، المركز 20/24 | درجة القرار 60.80 في المركز السادس، ومعدل عدم الهلوسة 83.8% |
| هل يظل الجواب مستقرًا بعد إعادة الصياغة؟ | معدل النجاح الكامل في AA-Symmetry | النتيجة 86.34 في المركز الثاني؛ ومعدل النجاح الكامل 56.7% في المركز الخامس | المركز الثاني في النتيجة لا يعني المركز الثاني في الاستقرار |
البندان الأكثر عرضة لسوء الفهم في الفئات الفرعية لـ d1.2-ultra
البند الأول هو HLE-MultiChoice. صحيح أن الدقة الخام البالغة 2.36% هي الأدنى بين 24 نموذج قرار، لكن درجة القرار فيه 46.36 ليست في المؤخرة؛ ففي الصفحة نفسها توجد درجات أدنى، مثل 34.79 لـ Mercury Decide. وإضافة إلى معدل عدم الهلوسة البالغ 76.1%، فإن القراءة المعقولة هي: عند مواجهة سؤال اختيار من متعدد صعب في الاستدلال، يميل d1.2-ultra إلى عدم تقديم إجابة عالية الثقة. يصنّف AA هذا البند ضمن الاستدلال، لذلك لا يصح وصفه بأنه «الأخير في اختبار المعرفة».
البند الثاني هو AA-Omniscience. دقة 23.6% تضعه في المرتبة 20/24، وليس الأخير. المثير للاهتمام أن d1.2 الأصغر في الصفحة نفسها يسجل 30.0% في هذا البند، كما أن دقته الخام في HLE تبلغ 5.30%، أي أن الرقمين أعلى من ultra. لكن المؤشر المركب لـ d1.2 هو 68.69، والمرتبة 9/24، لذا فإن «نسخة ultra الأكثر تكلفة أضعف معرفيًا» ينطبق فقط على هذين البندين، ولا يمكن تعميمه ليقول إنها أسوأ بشكل شامل.
🎯 نصيحة لقراءة الترتيب: إذا كان عملك هو استخراج المستندات/الفواتير، فإن المرتبة الأولى لـ
d1.2-ultraفي AA-Paperclip تستحق النظر بجدية؛ وإذا كان الأمر يتعلق باستدعاء الأدوات، فالمرتبة الأولى صحيحة فعلًا، لكن الفرق بينها وبين المراتب التالية لا يتجاوز نقطة واحدة، وقرار التبديل يعتمد على عيناتك أنت.
كيف تستخدم البيانات التي أعلنتها d1.2-ultra بنفسها
في المنشور نفسه، عرضت Liquid خمس فئات من المهام الجديدة ونتائج اختباراتها الداخلية. وقد ذكرت الشركة صراحةً أن هذه المهام الجديدة لا يغطيها أي معيار تقييم عام، وأن البيانات التالية كلها من إعلان الشركة عن نفسها، جُمعت من مجموعة بيانات داخلية محتجزة، وليست نتائج Artificial Analysis.
| المهمة الجديدة (إعلان الشركة عن نفسها) | d1.2-ultra | d1.2 | ملاحظات |
|---|---|---|---|
| قراءة قيم الإيصالات (CORD، SROIE) | 98% | 96% | القيم غير الموجودة يُجاب عنها بـ not found |
| نطاقات المعلومات الحساسة (Nemotron PII): الدقة/الاستدعاء | 94% / 93% | 92% / 88% | يحدد موضع كل مقطع |
| تحديد الأجسام حسب الوصف (سلسلة RefCOCO) | 94% | 94% | متساويان |
| عدّ الأجسام بسماح فرق 1 (COCO) | 93% | 92% | يقدّر رقمًا ويعطي نطاقًا |
| إبراز كل جسم في الصورة (COCO) | 87% | 90% | في هذا الصف يتفوق d1.2 الأرخص |
أما الصوت، فتذكر الشركة أنه عند الحكم على فئة الصوت (ESC-50) واللغة (FLEURS، 43 لغة) على تسجيلات محتجزة، كان النموذجان كلاهما عند نحو 95% إلى 97%. وفي خطأ المعايرة، قاست Liquid على 13 معيارًا و22505 سؤالًا، فكانت النتيجة d1.2-ultra عند 0.8، وd1.2 عند 1.2، وJev 1.14 عند 2.7، وPerplexity Decider v1.3 عند 3.7، وواجهة Decisions من GPT-6 Luna عند 7.2.
وهنا يجب التمييز بدقة: GPT-6 Luna (Decisions) يحقق مؤشرًا مركبًا 60.25 في لوحة القرارات لدى Artificial Analysis، ويحتل المرتبة 22/24، ودقته الخام في HLE هي 7.86%. هذه كلها نتائج واجهة Decisions، ولا يصح اعتبارها نتائج واجهة المحادثة gpt-6-luna. كما كتب المنشور الرسمي أيضًا «Coming to OpenRouter and Vercel soon»، وهذا إعلان مسبق من الشركة، ولا يعني أن الخدمة متاحة بالفعل.
d1.2-ultra بداية سريعة: جرّب نموذجك الخاص على عيناتك
بعد الاطلاع على التصنيفات، ما يحدد فعلاً هل تنتقل إلى النموذج الجديد أم لا هو بياناتك أنت. يكفي تجهيز 20 إلى 50 عينة حقيقية، مثل 30 فاتورة أو 30 سيرة ذاتية، مع تسمية الحقول الصحيحة مسبقًا لكل عينة، ويُفضّل أن تكون بعضها ناقصة الحقول عمدًا.
خطوات العمل المبسّطة
- اختر من أعمالك 20 إلى 50 عينة، وضع يدويًا القيمة الصحيحة لكل حقل، وعلّم الحقول الناقصة بـ not found.
- اكتب موجهًا ثابتًا: اطلب من النموذج إخراج الحقول المحددة بصيغة JSON، وأن يملأ الحقول غير الموجودة بـ
not foundإلزاميًا، دون أي تخمين. - استخدم SDK متوافقًا مع OpenAI، واضبط
base_urlعلىhttps://api.apiyi.com/v1، واملأmodelأولاً بـgpt-6-luna، ثم بدّله إلىgpt-6.1-solوشغّل كلًا منهما مرة. - قارن عينة بعينة، وسجّل ثلاثة أرقام: دقة مستوى الحقل، ونسبة المستندات الصحيحة بالكامل، وعدد مرات ملء الحقول الناقصة بقيم عشوائية.
- عندما يصبح النموذج المستهدف متاحًا للاستدعاء، شغّله مرة أخرى على نفس العينات ونفس الموجه، وقارن الأرقام الثلاثة مباشرة.
عرض منهجية المقارنة الكاملة
– **الإدخال**: ملف عينات، يحتوي كل سطر على النص الأصلي (أو الصورة) وقاموس الحقول المعلّمة يدويًا.
– **الاستدعاء**: اقرأ العينات في حلقة، واستدعِ `client.chat.completions.create` أو نقطة النهاية `responses`، واضبط `temperature` على 0، واطلب إخراجًا JSON صارمًا.
– **التحليل**: احسب حالات فشل تحليل الإخراج على حدة، فهي بذاتها مؤشر على مدى قابلية الاستخدام.
– **المقارنة**: قارن حقلًا بحقل بعد التطبيع (إزالة المسافات، توحيد صيغة التاريخ، وإبقاء المبالغ بمنزلتين عشريتين).
– **عدّ الهلوسة**: الحقول المعلّمة بـ not found والتي ملأها النموذج بقيمة، تُسجّل على حدة باسم «تخمين عشوائي».
– **التجميع**: أخرج دقة الحقول، ونسبة المستندات الصحيحة بالكامل، وعدد التخمينات العشوائية، ومتوسط استهلاك الـ token، لتسهيل حساب التكلفة لاحقًا.
تشغيل خط الأساس أولاً باستخدام APIYI
ستهلك هذه العملية tokens. لا يظهر الطرازان d1.2 وd1.2-ultra في قائمة طرازات APIYI، لذا يمكنك الآن على APIYI (apiyi.com) استخدام gpt-6.1-sol أو gpt-6-luna المتاحين بالفعل، عبر عنوان الاستدعاء https://api.apiyi.com/v1، وتشغيل الدفعة نفسها من الفواتير أو السير الذاتية للتحقق من صحة الحقول، وما إذا كان النموذج سيخمّن الحقول غير الموجودة. بهذه الطريقة تصبح لديك قاعدة أساس قابلة للقياس.
لم يُطرح هذا النموذج بعد، وسنطرحه في أقرب وقت؛ الطرازات والأسعار وفقًا لقائمة الطرازات على المنصة.
| بند الفحص الذاتي | طريقة التسجيل | معيار الحكم |
|---|---|---|
| دقة الحقول | عدد الحقول الصحيحة / إجمالي عدد الحقول | مقارنة بنموذج الإنتاج الحالي |
| نسبة المستندات الصحيحة بالكامل | نسبة المستندات التي تكون جميع حقولها صحيحة | يقابل «نسبة صحة المستند بالكامل» لدى AA-Paperclip |
| عدد مرات التخمين | عدد مرات ملء قيمة في حقل حالته not found | كلما قلّ كان أفضل، بما يتسق مع فكرة معدل عدم الهلوسة |
| فشل التحليل | عدد العناصر التي تعذّر تحليل JSON فيها | يؤثر مباشرة في تكلفة الإطلاق |
| استهلاك token | متوسط عدد tokens للإدخال والإخراج لكل عنصر | يُستخدم لحساب التكلفة الفعلية |
🚀 اقتراح للبدء: استخدم أولاً حصة الاختبار المجانية المخصصة للمستخدمين الجدد على APIYI apiyi.com لتشغيل 20 عنصرًا، وتأكد من أن الموجه وسكربت المقارنة يعملان بلا مشكلات، ثم وسّع إلى 50 عنصرًا، لتجنب إنفاق الحصة على التصحيح من البداية.
d1.2-ultra: الأسعار وطريقة الاستدعاء
يجب التفريق جيدًا بين وحدات القياس عند الحديث عن السعر. الرقم 133 دولارًا المذكور في لوحة الترتيب هو تكلفة تشغيل «لكل مليون مهمة»، أما سعر Liquid الرسمي فهو «لكل مليون token إدخال»: d1.2 بسعر 0.02 دولار، وd1.2-ultra بسعر 0.042 دولار، ويُحتسب الإدخال فقط. تُحسب الصورة بـ 1.5 token لكل 32×32 بكسل وبسعر النص نفسه، أي أن صورة 1024×1024 تعادل نحو 1536 token؛ ويُحتسب نص الطلب وصوره مرة واحدة فقط، وأي سؤال إضافي يضيف نص ذلك السؤال وحده.
طريقة الاستدعاء الرسمية تختلف أيضًا عن واجهات المحادثة الشائعة: معرّف النموذج هو d1.2-ultra وd1.2، والعنوان هو https://api.liquid.ai/decisions/v1/systemone، ويُطلب المفتاح من لوحة تحكم Liquid. ذكرت المدونة الرسمية إدخالات النص والصورة والصوت، بينما تنص المواصفات التقنية في صفحة Artificial Analysis على النص والصورة، بنافذة سياق 66k، وهذا الرقم يظهر فقط في صفحة لوحة الترتيب وليس ضمن المواصفات التي نشرتها مدونة Liquid.
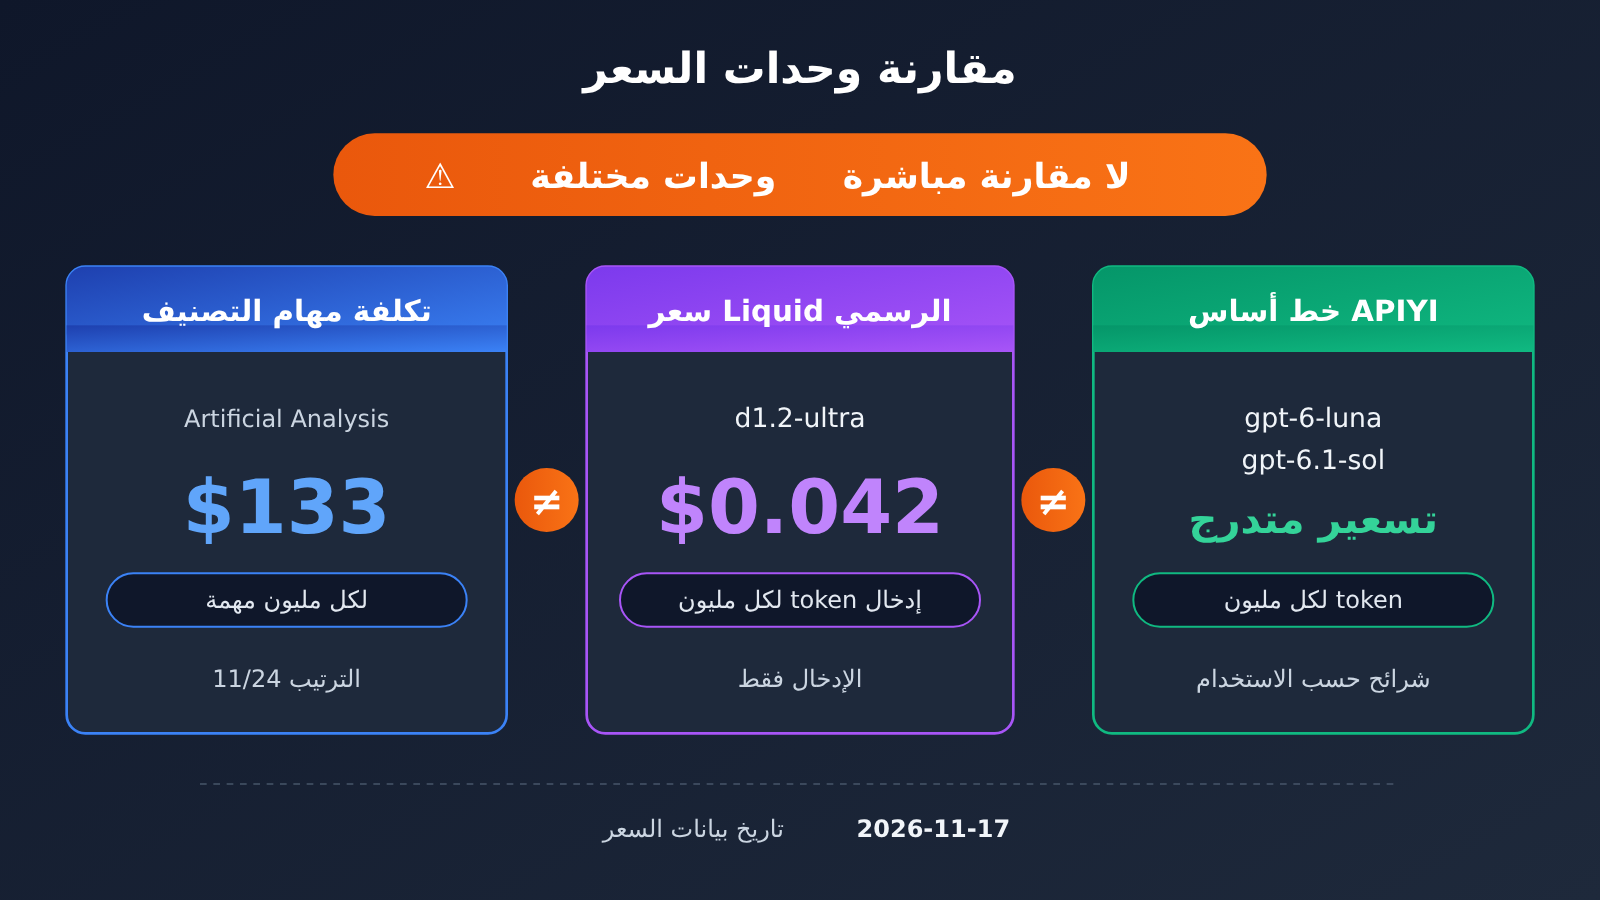
أما طرازات APIYI المستخدمة عند تشغيل خط الأساس فأسعارها كالتالي (الوحدة: دولار/لكل مليون token، متدرجة حسب حجم token في الطلب الواحد، والبيانات من واجهة قائمة الأسعار بتاريخ 2026-11-17، ومتوافقة مع تحديث جدول النماذج العام بتاريخ 2026-11-16):
| الطراز | الفئة | الإدخال | الإخراج | قراءة الذاكرة المؤقتة | نقطة النهاية |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses مفضّل، وchat متاح أيضًا |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | غير مُدرج بشكل منفصل | نفسه |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses مفضّل، وchat متاح أيضًا |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | غير مُدرج بشكل منفصل | نفسه |
💰 ملاحظة عن التكلفة: عند إجراء مقارنة على 50 عينة، يكون
gpt-6-lunaمناسبًا لتشغيل الحجم أولًا، بينما يكونgpt-6.1-solمناسبًا كمرجع عالي الجودة. شحن الرصيد في APIYI عبر apiyi.com يُحتسب بنسبة 1:7، ويمكن تراكم خصومات المجموعات، والخصم الفعلي يُعمل به حسب ما يظهر في لوحة التحكم.
الأسئلة الشائعة
س1: ما هو نموذج d1.2-ultra؟
إنه نموذج قرار أعلنت عنه Liquid AI في 2026-11-16، وصدر بالتزامن مع النموذج الأصغر d1.2. سمة نموذج القرار أنه يعطي احتمالاً لكل خيار، ويتميز في استخراج المستندات وتحديد استدعاء الأدوات والتصنيف وغيرها من مهام «اتخاذ القرار»، لا في كتابة النصوص الطويلة.
س2: d1.2-ultra حلّ أولاً في الترتيب العام، فهل هو الأقوى في كل شيء؟
لا. مؤشر الترتيب العام 74.85 والمرتبة 1/24، لكنه في EvalSafe-O\*NET-AA في المرتبة 3، وفي معدل النجاح الكامل لـ AA-Symmetry في المرتبة 5، وفي الدقة الخام لـ AA-Omniscience في المرتبة 20، والدقة الخام لـ HLE-MultiChoice هي الأدنى بين الـ 24. درجة الترتيب العام لا تعني إلا التقدم بعد الترجيح.
س3: هل يُعدّ بند HLE-MultiChoice آخر مرتبة في اختبار المعرفة؟
لا. الأخير هو الدقة الخام لـ HLE-MultiChoice البالغة 2.36%، وهي الدقة الخام بين 24 نموذج قرار؛ أما درجة القرار فيه 46.36 فليست في القاع، كما أن AA تصنّف هذا البند كاستدلال لا كمعرفة.
س4: ما السيناريو الأنسب لـ d1.2-ultra؟
بحسب صفحة الترتيب، الأنسب هو استخراج حقول الفواتير والسير الذاتية والأوراق البحثية (درجة القرار ومعدل الإجابة الصحيحة الكامل في AA-Paperclip كلاهما الأول) وتحديد استدعاء الأدوات (When2Call الأول، لكن الفارق بين المتصدرين نحو نقطة واحدة). أما الإجابة عن أسئلة الاختيار الصعبة وأسئلة المعرفة، فدقته الخام ليست متفوقة.
س5: هل يمكن الآن استدعاء d1.2-ultra عبر APIYI؟
حالياً لا يوجد d1.2 وd1.2-ultra في قائمة طرازات APIYI. لم يُطرحا بعد، وسنطرح هذا النموذج في أقرب وقت؛ والطراز والسعر يُعتمدان على قائمة طرازات المنصة. ننصح أولاً بتشغيل `gpt-6-luna` أو `gpt-6.1-sol` على APIYI عبر apiyi.com للحصول على خط أساس لعيناتك الخاصة، ثم تبديل الطراز للمقارنة عند توفره.
س6: هل يمكن الاعتماد مباشرة على خطأ المعايرة 0.8 الذي أعلنته Liquid؟
هذا اختبار أجرته Liquid بنفسها على 13 معياراً و22505 سؤالاً، وهو إقرار رسمي من الشركة. ما يمكن التحقق منه متقاطعاً في صفحة الترتيب هو أن Brier 0.150 هو الأدنى بين الـ 24، والاتجاه متوافق، لكن على مستوى عملك تحديداً يبقى عليك أن ترى هل «عدد التخمينات العشوائية» في عيناتك الخاصة أقل فعلاً.
س7: هل 7.2 في GPT-6 Luna وgpt-6-luna على APIYI شيء واحد؟
ليس الأمران متطابقين. الرقم 7.2 هو خطأ المعايرة في Decisions API الخاص بنموذج GPT-6 Luna أثناء اختبار Liquid، ودرجة 60.25 في القائمة هي أيضًا نتيجة واجهة Decisions. أما `gpt-6-luna` الذي تقدمه APIYI فهو واجهة دردشة، وأداؤه لا يُقاس إلا بعيناتك الخاصة.
س8: كم عدد العينات الذي يكفي فعلًا؟
من 20 إلى 50 عينة تكفي لرؤية فرق واضح، والمهم أن تغطي التوزيع الحقيقي: يجب أن تضم تنسيقات شائعة وأخرى نادرة وعينات ناقصة الحقول. وإذا كان الفرق بين النموذجين في 50 عينة لا يتجاوز عينة أو عينتين، فهذا يعني أن التبديل أو عدمه سيان، والأولى عندها النظر إلى السعر وزمن الاستجابة.
أهم النقاط في d1.2-ultra (Key Takeaways)
- الدرجة الإجمالية 75 ليست سوى مدخل: 74.85 والمرتبة الأولى من 24، بفارق نحو 2.2 نقطة عن الثاني، وهذا لا يعني أنه الأول في كل بند.
- لاستخراج البيانات من المستندات، انظر AA-Paperclip: درجة القرار 75.81 ونسبة الإجابات الصحيحة كليًا 67.7%، وكلتاهما في المرتبة الأولى.
- لاستدعاء الأدوات، انظر When2Call: 96.49 والمرتبة الأولى، لكن المتصدرين متقاربون ضمن نحو نقطة واحدة.
- للأسئلة الصعبة، انظر الدقة الخام: HLE-MultiChoice عند 2.36% وهي الأدنى، لكن درجة القرار ليست في المؤخرة، وAA يصنّفه ضمن الاستدلال.
- للأسئلة المعرفية، انظر دقة Omniscience: 23.6% والمرتبة 20 من 24، وليس الأخير.
- لا تخلط بين الوحدات: 133 دولارًا لكل مليون مهمة، و0.042 دولار لكل مليون token مدخل.
- اتخذ قرارك بالعينات: شغّل أولًا من 20 إلى 50 عينة على النماذج المتاحة عبر APIYI على apiyi.com، وسجّل دقة الحقول وعدد مرات التخمين العشوائي.
الخلاصة
عند قراءة لوحة ترتيب d1.2-ultra، يكفي اتباع ثلاث خطوات:
- حدّد نوع المهمة: استخراج المستندات، أو استدعاء الأدوات، أو الإجابة عن الأسئلة الصعبة، أو الأسئلة المعرفية؟ انظر فقط إلى الدرجات الفرعية المطابقة.
- ميّز بين الرقمين: درجة القرار تكافئ مبدأ “لا تخمّن إن لم تكن واثقًا”، بينما تقيس الدقة الخام “كم مرة جاء تخمينك صحيحًا”. اختر الرقم الذي تراقبه حسب متطلبات عملك.
- احسم القرار بعيناتك الخاصة: 20 إلى 50 عينة حقيقية مُعلّمة تُجيب عن سؤالك أفضل من أي درجة إجمالية.
إذا كان عملك هو استخراج المستندات تحديدًا، فإن d1.2-ultra يستحق أن يُدرج في قائمتك المختصرة. أما إذا كان الأمر يتعلق بالاستدلال على المسائل الصعبة أو الأسئلة المعرفية، فلا تستبدله لمجرد أنه الأول في التقييم الإجمالي. نوصي الآن بإنشاء خط أساس على منصة APIYI عبر apiyi.com باستخدام gpt-6-luna وgpt-6.1-sol، ثم المقارنة بنقرة واحدة عند توفر النموذج المستهدف.
📚 المراجع
-
مدونة Liquid AI الرسمية – إصدار d1.2: معلومات الإصدار والأسعار الرسمية والاختبارات المعلنة ذاتيًا
- الرابط:
liquid.ai/blog/d1-2 - ملاحظة: دقة المهام الجديدة وخطأ المعايرة كلاهما معلن ذاتيًا من الشركة
- الرابط:
-
وثائق نماذج القرار من Liquid AI: معرّفات النماذج وعناوين الاستدعاء
- الرابط:
docs.liquid.ai/lfm/models/decision-models - ملاحظة: شرح طريقة الاستدعاء الرسمية
- الرابط:
-
Artificial Analysis – صفحة نموذج d1.2-ultra: المؤشر الإجمالي والدرجات الفرعية
- الرابط:
artificialanalysis.ai/decision-models/d1-2-ultra - ملاحظة: جميع بيانات لوحة الترتيب في هذا المقال قُرئت في 2026-11-17
- الرابط:
-
Artificial Analysis – صفحة منهجية Decision Index: تعريفات الأوزان والدرجات
- الرابط:
artificialanalysis.ai/methodology/decision-index - ملاحظة: الفرق بين درجة القرار والدقة الخام
- الرابط:
-
الجدول العام لنماذج APIYI: النماذج المتاحة والأسعار
- الرابط:
docs.apiyi.com/models - ملاحظة: تُعتمد النماذج والأسعار وفق قائمة النماذج في المنصة
- الرابط:
المؤلف: فريق APIYI التقني
للتواصل التقني: إذا كانت لديك أسئلة حول اختيار النموذج أو سكربتات المقارنة، يسعدنا أن تتواصل معنا عبر الصفحة الرئيسية لموقع APIYI. ولمزيد من تعليمات التكامل، راجع مركز الوثائق.


