
ملاحظة الكاتب: هذا المقال قراءة في آلية Claude Dreaming التي كشفت عنها مدونة Anthropic الهندسية. يغطي بنية الذاكرة ذات الطبقات الأربع، وبيانات تجارب CL-Bench وWiki، وحالات تصحيح الأخطاء، والمخاطر الهندسية، ويشرح كيف يمكن للمطورين الاستفادة من فكرة «ترتيب الذاكرة بين الجلسات» لبناء نظام ذاكرة خاص بوكلائهم (Agents).
في 6 نوفمبر 2026 نشرت Anthropic على مدونتها الهندسية مقالًا بعنوان The components of agent memory. شرحت فيه لأول مرة بصورة منهجية كيف يصحّح Claude Dreaming الأخطاء بين الجلسات، ويرتّب الذاكرة، ويبني قاعدة معرفية. ونشر الحساب الرسمي على X المقال نفسه، كما ظهرت واجهة Dreams بوصفها معاينة بحثية في وثائق Claude Managed Agents.
هذه ليست مجرد فكرة أخرى من نوع «أضف قاعدة متجهات إلى الوكيل». فقد استعانت Anthropic بعدة مجموعات من التجارب لتوضح أن الوكيل الذي يعمل لفترات طويلة لا يكفيه أن يحتفظ بالسجل التاريخي، بل عليه أيضًا أن يتحقق من ذاكرته ويصحّحها ويدمجها وينظّمها باستمرار، حتى تنفع المعلومات القديمة المهمة التالية فعلًا.
القيمة الأساسية: بعد قراءة هذا المقال ستتعرف على بنية الذاكرة ذات الطبقات الأربع في Claude Dreaming وأهم بيانات التجارب. وستعرف أيضًا متى تكون هذه الآلية مفيدة ومتى تضر، وكيف تستفيد منها في وكيلك الخاص.
نظرة سريعة على أهم معلومات Claude Dreaming
| البند | التفاصيل |
|---|---|
| تاريخ النشر | 2026-11-06، مدونة Anthropic Engineering |
| المفهوم الأساسي | Dreaming: عملية تعمل في الخلفية بين الجلسات، تستفيد من السجل التاريخي لإعادة تنظيم الذاكرة وصيانتها |
| طبقات الذاكرة | 4 طبقات: Transcripts وMemory notes وMemory representations وInjected context |
| شكل المنتج | Dreams ضمن Claude Managed Agents، وهي حاليًا في مرحلة Research Preview وتتطلب تقديم طلب للوصول |
| المواد المرافقة | الدليل العملي الرسمي (Cookbook) بعنوان «Dreaming with a dynamic workflow»، نُشر في 2026-11-02 |
| نطاق التأثير | الوكلاء (Agents) طويلة التشغيل، والمهام العابرة للجلسات، وبناء قواعد المعرفة الداخلية في الشركات |
قبل أن نفهم Dreaming، من المفيد أن نوضح بعض المصطلحات. الـ Transcript هو السجل الكامل للجلسة، ويشمل مدخلات المستخدم ومخرجات الوكيل واستدعاءات الأدوات ونتائجها. أما الـ Memory Note فهي حقائق وقواعد وخبرات دائمة جرى استخلاصها من التجارب السابقة. والـ Memory Store هو مساحة تخزين دائمة تحفظ ملفات الذاكرة عبر الجلسات. وتقترب فكرة Dreaming من Sleep-time Compute، أي استغلال القدرة الحاسوبية الفائضة خارج التفاعل الرئيسي لمعالجة السياق الموجود أصلًا.
لماذا لا يكفي أن تعتمد ذاكرة الوكيل (Agent) على تخزين المحادثات السابقة
أول ما يخطر في بال كثير من الفرق عند بناء ذاكرة لوكيل (Agent) أن تحفظ كل المحادثات، ثم تبحث فيها عند الحاجة. لكن سجلات التاريخ وملخصات الجلسات والمعرفة القابلة للاسترجاع ثلاثة أشياء مختلفة. السجل مجرد تراكم للأحداث الخام، والملخص قد يُسقط تفاصيل جوهرية، أما المعرفة التي خضعت للتحقق والتنظيم فهي وحدها التي تفيد المهمة التالية بشكل مستقر.
حفظ المحادثات كلها يجلب ثلاث مشكلات: تكرار المعلومات، وتقادم الحالات القديمة، وتراكم الأخطاء. فالسجل الخاطئ الواحد تقرؤه الجلسات اللاحقة مرارًا، فيُعامَل الخطأ كأنه حقيقة ويُبنى عليه التنفيذ. وخلاصة Anthropic واضحة: الذاكرة ليست كلما زادت كان أفضل، بل تحتاج إلى انتقاء وتحقق وتنظيم.
وتُظهر تجربة Pokémon Red هذا الفرق بوضوح. فعند نحو 10,000 خطوة، أنشأ Sonnet 3.7 عدد 413 ملفًا و225 مجلدًا، ومع ذلك حصل على شارة واحدة فقط. أما Fable 5 فلم ينشئ سوى 9 ملفات ذاكرة عادية ومجلدين وملف global.md واحد، ومع ذلك حصل على 4 شارات.
مصدر الفرق هو “ماذا نحفظ”. فقد حفظ Sonnet 3.7 كمًا كبيرًا من حالة اللعبة المتغيرة باستمرار، وسرعان ما تقادمت هذه السجلات. أما Fable 5 فاهتم أكثر بالاستراتيجيات والقواعد التي ثبتت صحتها وخطط العمل. ومن هنا ينشأ مبدأ تصميمي: ينبغي أن تحتفظ الذاكرة طويلة الأمد أولًا بالمعرفة التي يصعب استعادتها من البيئة الحالية، أما الحالة الآنية التي يمكن قراءتها مباشرة في كل مرة فلا حاجة إلى تسجيلها.
طبقات ذاكرة Claude الأربع
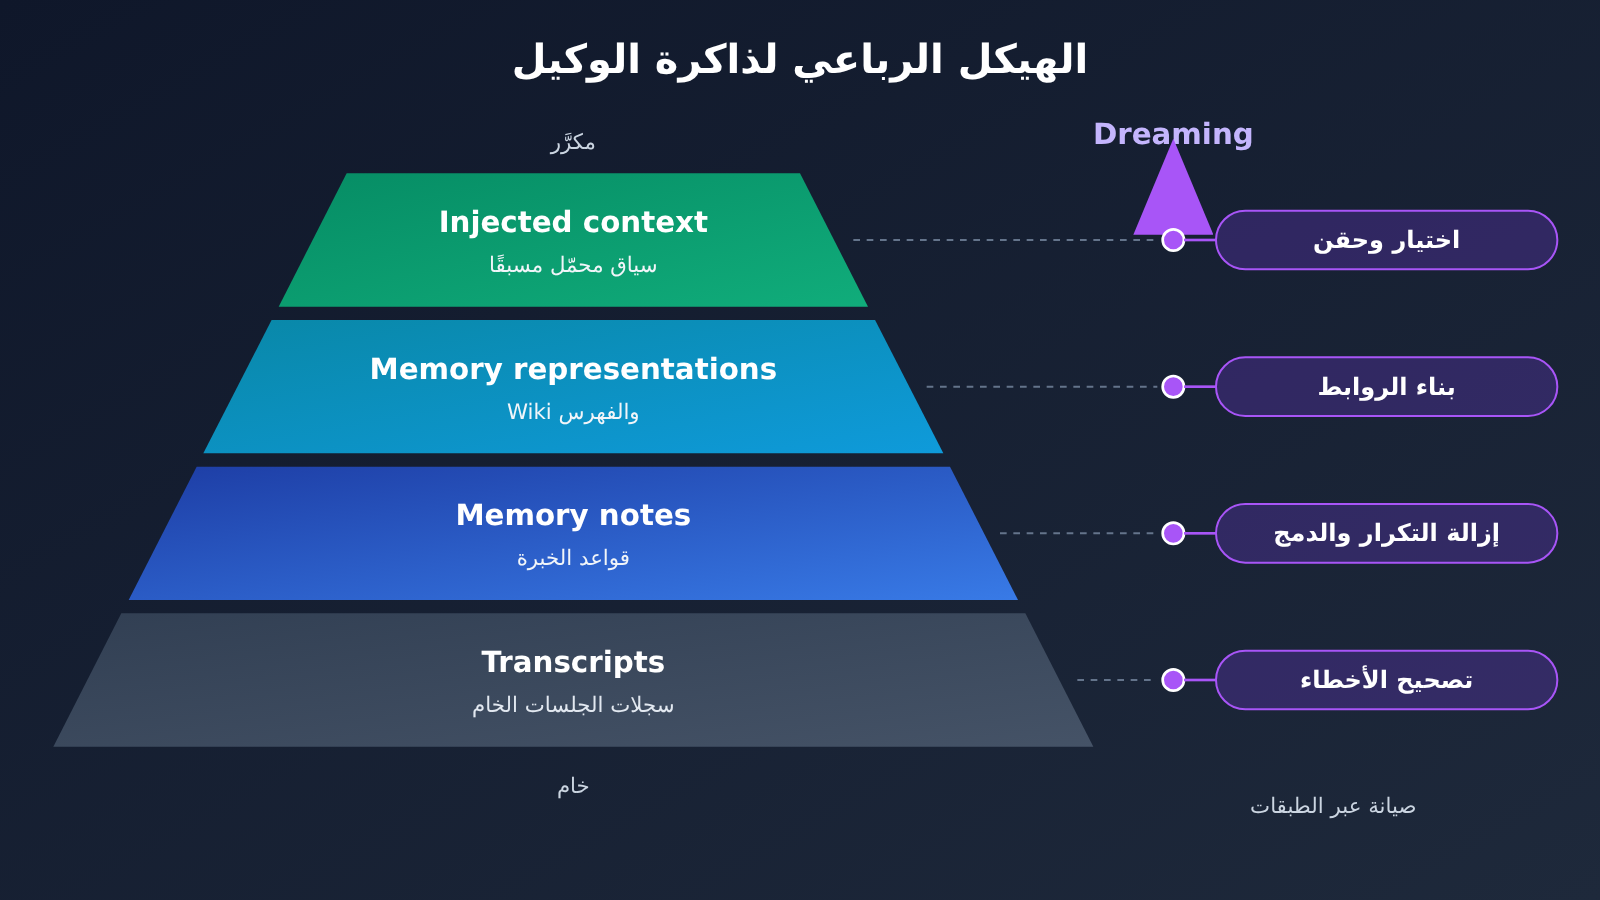
قسّمت Anthropic ذاكرة الوكيل (Agent) إلى 4 طبقات. لكل طبقة دورها، وتختلف في وتيرة الكتابة وتكلفة القراءة.
| الطبقة | المحتوى | الوظيفة | طريقة القراءة |
|---|---|---|---|
| Transcripts (سجلات الجلسات) | السجل الكامل للجلسات | سجل أحداث قابل للبحث، وهو الدليل الأصلي لتتبّع الوقائع | استرجاع عند الحاجة |
| Memory notes (ملاحظات الذاكرة) | وقائع وخبرات وقواعد مهمة تُدوَّن أثناء المهام | ترسيخ الخبرات القابلة لإعادة الاستخدام | قراءة عند الحاجة |
| Memory representations (تمثيلات الذاكرة) | تمثيلات منظَّمة مثل Wiki والفهارس والروابط | تنظيم العلاقات بين المعارف ودعم البحث عبر المستندات | التنقّل والاسترجاع |
| Injected context (السياق المحقون) | عدد قليل من الذكريات عالية القيمة | تُحمَّل مسبقًا عند بدء جلسة جديدة | حقن تلقائي |
تمثّل هذه الطبقات الأربع انتقالًا تدريجيًا من المادة «الخام» إلى المادة «المكرَّرة». سجلات Transcripts أشمل الطبقات معلوماتٍ، لكنها كبيرة الحجم وكثيرة الضوضاء. أما Injected context فهي أكثرها تكريرًا، ومع ذلك يستهلك كل عنصر فيها جزءًا من نافذة السياق في الجلسة الجديدة، ولذلك لا يُترك فيها إلا ما بلغ أعلى درجات الأهمية البارزة (Salience).
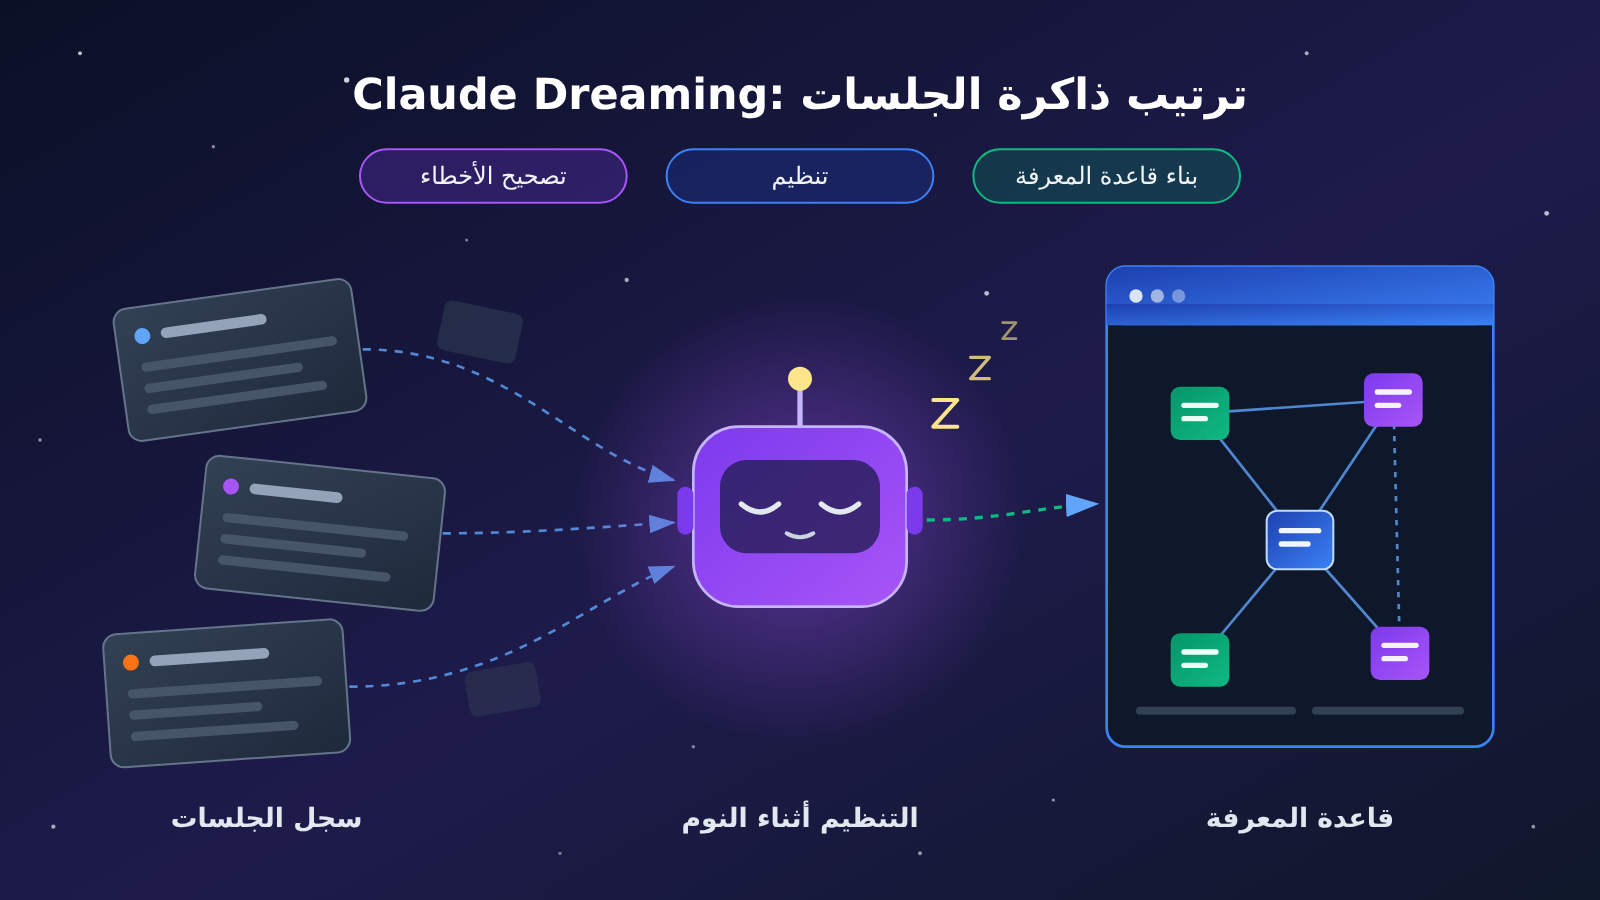
يقوم Dreaming بدور الصيانة عبر الطبقات. فهو يعود إلى Transcripts لتصحيح السجلات القديمة، ويدمج المعلومات المكررة في Memory notes، ويبني Wiki والفهارس، ويقرر أي المحتويات تستحق الحقن المسبق عند بداية الجلسة الجديدة (Context Injection).
كيف يصحّح Claude Dreaming الأخطاء وينظّم المعرفة ويبني قاعدة معرفية
تصحيح الأخطاء في Dreaming: حالة التنقّل عند Mt. Moon
سجّلت Anthropic خطأً في التنقّل. فقد دوّن الوكيل (Agent) موقع Pokémon Center القريب من Mt. Moon بشكل خاطئ، فظلّت الجلسات اللاحقة تكرّر المحاولة على المسار الخاطئ نفسه.
أعاد Dreaming فحص سجلات Transcript التاريخية، فعثر على التدوينة الخاطئة الأولى وصحّح ملف الذاكرة. ووصل الوكيل الذي اعتمد الذاكرة المصحَّحة إلى Cerulean City عند الإجراء رقم 1,935. أما النسخة التي لم تُصحَّح ذاكرتها، فقد كرّرت الفشل مرات عدة ولم تتمكن في النهاية من إنجاز الهدف.
تبيّن هذه الحالة أن Dreaming لا يكتفي بالتلخيص. فهو يستطيع العودة إلى التجربة الأصلية ليتحقق مما إذا كانت الذاكرة لا تزال صحيحة. وبهذا صار لسجلات Transcript المحفوظة استخدام جديد: فهي مخزن أدلة يمكن الرجوع إليه ومراجعته مرارًا.
تأثير الذاكرة في Claude: بيانات تجارب CL-Bench
اختبرت Anthropic تأثير الذاكرة باستخدام مهام قواعد البيانات من CL-Bench 1.0. يعرض الجدول التالي متوسط المكافأة (mean reward) كما ورد في التقرير الرسمي.
| النموذج | بدون ذاكرة | مع الذاكرة | مقدار التحسن |
|---|---|---|---|
| Opus 5.5 | 0.655 | 0.838 | +0.183 |
| Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
| Opus 5 | 0.564 | 0.828 | +0.264 |
| Opus 4.7 | 0.383 | 0.700 | +0.317 |
| Sonnet 5 | 0.306 | 0.610 | +0.304 |
| Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
يجب الانتباه إلى أن هذه البيانات تخص هذه المهمة وحدها، وليست تقييمًا عامًا لقدرة الوكلاء (Agents) على استخدام الذاكرة. أما الملاحظة الأجدر بالاهتمام فهي أنه كلما كان النموذج أقوى، مال أكثر إلى تسجيل القواعد التي ثبتت صحتها وأسباب الأخطاء والمزالق التي قد تواجهه لاحقًا، بدلًا من نسخ المحادثات السابقة كما هي. أما تحسن Sonnet 4.6 فكان محدودًا جدًا، وهذا يدل على أن فعالية نظام الذاكرة ترتبط ارتباطًا وثيقًا بـ«جودة التدوين» لدى النموذج نفسه.
نتائج بناء قاعدة معرفة Wiki عبر Dreaming
استخدمت أكبر تجربة نحو 350,000 ملف داخلي، بإجمالي يقارب 420 مليون توكن. بنت Anthropic من خلال 128 جلسة Dreaming ويكي معرفيًا بصورة تدريجية، ثم قيّمت النتائج بمهام أسئلة وأجوبة.
| طريقة الاسترجاع | التقييم | ملاحظات |
|---|---|---|
| Wiki وحده (قبل البناء ← بعده) | 13% ← 48% | تحسّن الأداء بوضوح مع اكتمال الـ Wiki تدريجيًا |
| Search وحده | 53% | خط الأساس |
| Search + Wiki (قبل البناء ← بعده) | 54% ← 61% | توفير نحو 20,000 توكن في المتوسط لكل سؤال |
| مهام التجميع عبر ملفات متعددة (الاستحواذ والاندماج) | Wiki بنسبة 87% مقابل 73% لـ Search وحده | أوضح ميزة تظهر في تجميع المعلومات عبر المستندات |
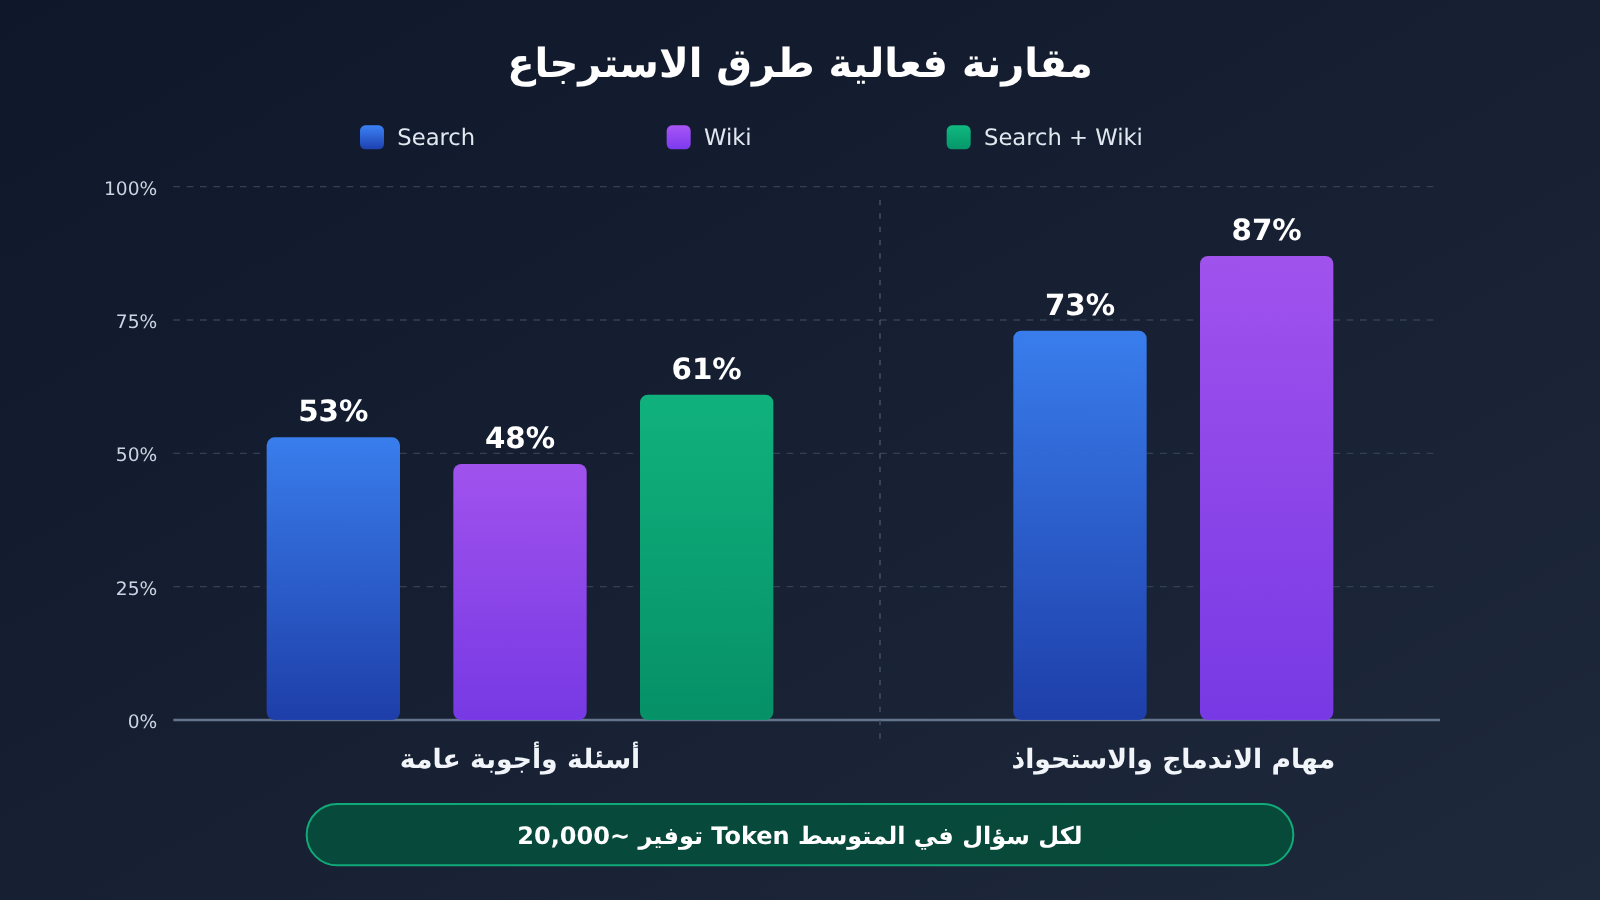
📊 توضيح للمخطط: جميع البيانات أعلاه مأخوذة من تجارب منشورة في مدونة Anthropic الهندسية. إذا أردت إجراء تحقق مشابه بحجم صغير على بياناتك الخاصة، فيمكنك استدعاء نماذج Claude عبر APIYI على apiyi.com، ثم مقارنة النتائج واستهلاك التوكن بين أسلوبين: «الاسترجاع وحده» و«الاسترجاع + Wiki منظَّم».
تتلخص قيمة الذاكرة المنظَّمة في نقطتين. الأولى بناء الروابط والفهارس، بحيث يمكن تجميع المعلومات الموزعة على عدة ملفات. والثانية تقليل حجم النصوص الأصلية التي يجب إعادة قراءتها عند كل عملية استرجاع، وبالتالي خفض تكلفة التوكن.
تحليل الأثر: لماذا تنجح عملية تنظيم الذاكرة في Claude Dreaming أحيانًا وتضر أحيانًا أخرى
لم تقدّم Anthropic ميزة Dreaming على أنها حل سحري، بل ذكرت في مقالها عدة أمثلة سلبية. وقد تكون القيمة العملية لهذا الجزء في الهندسة أكبر من قيمة الأرقام الإيجابية.
5 أنواع من المخاطر الهندسية في تنظيم الذاكرة
- الإفراط في التسجيل: كما حدث مع Sonnet 3.7، الذي حفظ كمية كبيرة من الحالات المتغيرة، فتضخّمت الذاكرة بسرعة، وصارت المعلومات قديمة بالسرعة نفسها.
- تقادم المعلومات: تتغير البيئة بينما تبقى الذاكرة عالقة عند نسخة قديمة، وإذا لم يُتحقَّق من المصدر فستظل تضلّل الـ Agent باستمرار.
- الكتابة المشتركة والاستبدال: في تجربة تنظيم العقود، كتبت عدة وكلاء (Agents) في الوقت نفسه على جدول ملخّص واحد، فلم يُحتفظ إلا بـ 41 من أصل 57 حقيقة أساسية، أي نحو 72%. وبعد التحول إلى صفحة مستقلة لكل عقد، يكتب فيها Agent واحد فقط مع الاحتفاظ بالبنود الأصلية، بقيت الحقائق الـ 57 كلها.
- تضخّم حجم الـ Wiki: في أحد الاختبارات لم يتجاوز حجم الملفات الأصلية 115 KB، لكن الـ Wiki الناتج ارتفع إلى 203 KB، أي إن التنظيم زاد المعلومات بدل أن يختصرها.
- لا فائدة في المهام البسيطة: حين يمكن العثور على الإجابة مباشرة في ملف واحد، لم يحقق الـ Wiki تحسنًا ملحوظًا، وكل ما فعله هو زيادة تكلفة الصيانة.
الأثر على المطورين
- الذاكرة تحتاج إلى طبقات: تُخزَّن السجلات الأولية، وقواعد الخبرة، والمعرفة المنظّمة، والسياق المُحقَن مسبقًا كلٌّ على حدة، ولكل منها سياسة كتابة وقراءة مختلفة.
- يجب أن يكون المصدر قابلًا للتتبع: ينبغي أن تُرجَع كل معلومة في الذاكرة إلى Transcript المقابل لها، وهذا شرط أساسي لتصحيح الأخطاء.
- اجعل الكتابة تسلسلية أو مقسّمة: تجنّب أن يكتب عدة Agents في الملف نفسه في وقت واحد، وفضّل بنية «صفحة واحدة لكل كيان».
- التنظيف الدوري: تحتاج ملفات الـ Wiki وملاحظات Memory إلى إزالة التكرار والدمج والحذف، وإلا فلن يزداد حجمها إلا مع الوقت.
الأثر على القطاع
- يتحول تركيز أبحاث ذاكرة الـ Agent من «دقة الاسترجاع» إلى سؤال آخر: هل الذاكرة نفسها صحيحة، وهل تتم صيانتها فعلًا؟
- من المتوقع أن يصبح Sleep-time Compute بنية معتادة، إذ تُنقل تكلفة التنظيم إلى أوقات الخمول، فيخف عبء السياق أثناء التفاعل الرئيسي.
- الذاكرة المنظّمة أنسب للمهام التي تمتد عبر ملفات متعددة وجولات كثيرة وتتراكم على المدى الطويل. أما الأسئلة البسيطة ذات الإجابة الواحدة، فيبقى الاسترجاع المجرد فيها الخيار الأوفر.
كيف يطبّق المطوّرون فكرة Claude Dreaming على وكلاء Agent الخاصين بهم
شروط استخدام معاينة Dreams البحثية الرسمية
وفقًا لوثائق Anthropic الحالية، تُعدّ Dreams ميزة ضمن Claude Managed Agents، وهي في مرحلة Research Preview، ويتطلب استخدامها تقديم طلب للحصول على صلاحية الوصول. وعند الاستدعاء، يلزم إرسال ترويستَي Beta Header هما managed-agents-2026-04-01 وdreaming-2026-04-21.
مدخلات الميزة هي Memory Store موجود مسبقًا مع عدد من جلسات Session السابقة يتراوح بين 1 و100 جلسة، ومخرجاتها Memory Store جديد، أما المخزن الأصلي فلا يتغيّر. تعمل المهمة بشكل غير متزامن، وتستغرق عادةً من بضع دقائق إلى عدة ساعات، وتُحتسب تكلفتها وفق سعر Token القياسي للنموذج المختار. والنماذج المدعومة هي في الأساس Opus 5.5 وSonnet 5.5. كما أن الميزة لا تستوفي حاليًا شروط Zero Data Retention أو HIPAA، لذا يجب تقييم الوضع قبل معالجة أي بيانات حساسة.
تصميم سير عمل ديناميكي في Cookbook
يقدّم الـ Cookbook الرسمي مجموعة من سير عمل الوكلاء المتعددين التي يمكنك بناؤها بنفسك. الوضع الافتراضي أن يتولّى وكيل Lead تنسيق المسار، فيعالج كل وكيل Analyzer نسخة واحدة من الـ Transcript، بينما يتولّى وكيل Organizer إزالة التكرار وإصلاح الروابط وصيانة الفهرس. ثم يُركَّب مخزن الذاكرة Memory Store المُنظَّم في الجلسة التالية، ويكون ذلك عادةً بأسلوب القراءة فقط، ويمكن أيضًا تشغيله بجدولة Cron، مثل تنظيم جلسات اليوم السابق كل ليلة.
ويقدّم الـ Cookbook أيضًا أمثلة على التكلفة. إحدى عشرة نسخة Transcript نموذجية بحجم 283 كيلوبايت تُعالَج في نحو دقيقتين ونصف بتكلفة تقارب 0.36 دولارًا. وخمسون نسخة Transcript طويلة بحجم يقارب 12 ميغابايت تكلّف نحو 8 دولارات مع إعدادات تحسين التكلفة، وتستغرق قرابة 10 دقائق. هذه مجرّد نتائج تجارب محددة، وليست تسعيرة ثابتة.
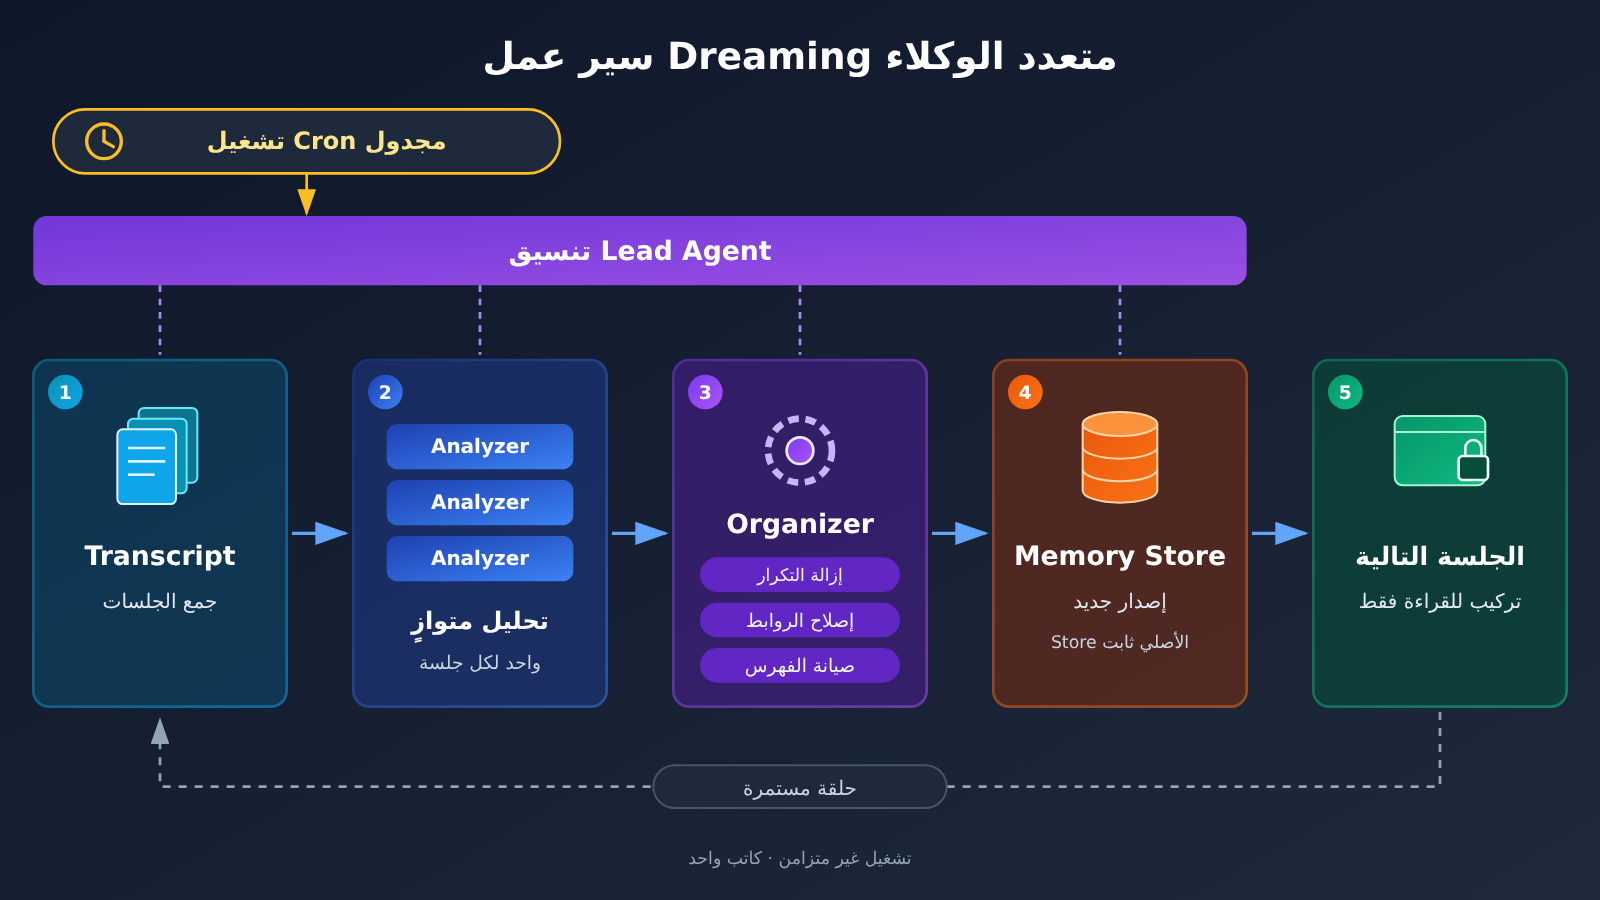
بناء عملية تنظيم ذاكرة بين الجلسات بنفسك باستخدام نماذج Claude
يلزم التوضيح أولًا: ما يقدّمه APIYI هو واجهة استدعاء لنماذج عائلة Claude، وليس خدمة Managed Agents أو Memory Stores أو Dreams API. لكن الفكرة الجوهرية في Dreaming، أي «قراءة الـ Transcript في الخلفية، واستخلاص القواعد المُتحقَّق منها، وتسليمها إلى كاتب واحد يتولّى التنظيم»، يمكن تنفيذها بالكامل باستخدام استدعاءات النموذج العادية. وفيما يلي مثال بسيط يجعل Claude يحلّل سجل جلسة واحدة ويُخرج ذكريات مرشّحة.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # استبدله بنموذج Claude المتاح في قائمة النماذج
    messages=[
        {"role": "system", "content": "استخلص فقط القواعد المُتحقَّق منها وأسباب الأخطاء والمزالق المستقبلية، وتجاهل الحالات المتغيّرة، واذكر رقم السطر المصدر لكل عنصر."},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
عرض كود التنفيذ الكامل (Analyzer + Organizer بكاتب واحد)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是记忆分析器。阅读会话记录,输出 JSON 数组,每项包含:
topic(实体或主题名), rule(经过验证的规则/错误原因/陷阱), evidence(原文出处)。
不要记录每次都能直接从环境读取的实时状态。"""

ORGANIZER_PROMPT = """你是记忆整理器。给定某个主题的旧记忆页面和新候选条目:
1. 与旧记录冲突时,以 evidence 更可靠者为准,并注明修正原因;
2. 合并重复条目;
3. 保留原始证据引用;
输出更新后的 Markdown 页面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # صفحة واحدة لكل موضوع، وتُكتب بالتسلسل عبر مسار واحد لتجنّب الكتابة المتزامنة التي تطمس البيانات
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"旧页面:\n{old}\n\n新条目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# يمكن تشغيلها كل ليلة عبر Cron؛ وفي الجلسة التالية تُحمَّل صفحات الفهرس من memory_store للقراءة فقط
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 نصيحة للبدء السريع: عند بناء النموذج الأولي، يمكنك عبر APIYI (apiyi.com) استخدام مفتاح API واحد لتجربة نماذج Claude مختلفة في دور المحلِّل (Analyzer) والمنظِّم (Organizer). قارن أي مزيج يستخلص قواعد أدق ويستهلك رموزًا (Tokens) أقل، ثم قرّر الإعداد المناسب لبيئة الإنتاج.
يمكن تلخيص الفرق بين المسارين في الجدول التالي:
| وجه المقارنة | Anthropic Managed Agents Dreams | بناء تنظيم الذاكرة بنفسك عبر واجهة النموذج |
|---|---|---|
| طريقة الوصول | معاينة بحثية، تتطلب طلب وصول وترويسة Beta Header | استدعاء واجهة نماذج Claude مباشرة |
| تخزين الذاكرة | Memory Store الرسمي، والمخرجات تكون Store جديدًا | تنفّذه بنفسك: ملفات أو قاعدة بيانات أو Wiki |
| الجدولة والتزامن | مهام غير متزامنة رسمية | تنفّذ بنفسك Cron وطوابير التنفيذ والتحكم بكاتب واحد |
| تصحيح الأخطاء والصلاحيات | مدمجان في المسار الرسمي | تصمّم بنفسك التحقق من المصادر والصلاحيات |
| المنصات المتاحة | Anthropic الرسمية | APIYI (apiyi.com) لاستدعاء النماذج، وواجهة API الرسمية |
الأسئلة الشائعة حول Claude Dreaming
س1: ما هو Claude Dreaming؟
Dreaming هي عملية صيانة للذاكرة تعمل في الخلفية بين الجلسات، اقترحتها Anthropic. تعتمد على سجلات المحادثات التاريخية (Transcript) لتصحيح السجلات القديمة، ودمج المعلومات المكررة، وبناء Wiki وفهارس، ثم تنتقي السياق عالي القيمة الذي يجب حقنه مسبقًا في الجلسات الجديدة.
س2: ما الفرق بين Dreaming وتلخيص الجلسات العادي أو البحث المتجهي؟
التلخيص يضغط المعلومات فقط، والبحث يكتفي بالعثور عليها. أما Dreaming فيعود إلى سجل المحادثة الأصلي (Transcript) ليتحقق من أن الذاكرة ما زالت صحيحة. ففي مثال Mt. Moon مثلًا جرى تصحيح اتجاه خاطئ. كما يبني روابط بين المستندات، ففي المهام التي تتطلب تجميع المعلومات من ملفات متعددة حقق الـ Wiki نسبة 87%، مقابل 73% للبحث وحده.
س3: هل يمكن استخدام Claude Dreaming الآن؟
نُشرت مدونة الهندسة المتعلقة به في 6 نوفمبر 2026. تظهر Dreams حاليًا بصيغة Research Preview ضمن Claude Managed Agents، وتحتاج إلى طلب وصول، كما يلزم إرسال ترويستي Beta Header لاستدعائها.
س4: هل أستطيع الاستفادة من فكرة Dreaming دون صلاحية الوصول إلى Managed Agents؟
نعم. يمكنك تنفيذ نسخة مبسطة باستدعاءات النموذج العادية، باتباع هذه الخطوات: جمع سجلات المحادثات (Transcript)، والتحليل في الخلفية، والترتيب بكاتب واحد فقط، والتركيب للقراءة فقط، والصيانة الدورية. ومن خلال APIYI على apiyi.com يمكنك استدعاء نماذج Claude عبر واجهة متوافقة مع OpenAI لتنفيذ التحليل والترتيب. أما التخزين والجدولة والصلاحيات فعليك تنفيذها بنفسك.
س5: هل توفر APIYI ميزة Claude Dreaming مباشرةً؟
لا. توفر APIYI على apiyi.com واجهات استدعاء لنماذج مثل Claude، ولا تشمل Managed Agents أو Memory Stores أو Dreams API من Anthropic. وهي مناسبة لاستدعاء النماذج وبناء مسار ترتيب الذاكرة بنفسك، ويمكن للمستخدمين الجدد البدء بالرصيد التجريبي المجاني للتحقق من الفكرة.
س6: ما القيود المعروفة لـ Dreaming؟
في الأسئلة البسيطة التي يكفي ملف واحد للإجابة عنها، لا يحقق الـ Wiki فائدة واضحة. وقد تؤدي عملية الترتيب إلى تضخم الحجم، فمثلًا تحوّل نص أصلي حجمه 115 KB إلى Wiki حجمه 203 KB. كما أن الكتابة المشتركة من عدة وكلاء (Agents) تؤدي إلى ضياع بعض الحقائق. وما زالت Dreams الرسمية غير مؤهلة لمعيار ZDR ولا HIPAA، وتتراوح مدة المهمة بين بضع دقائق وعدة ساعات.
أبرز النقاط في Claude Dreaming (Key Takeaways)
- الذاكرة ليست مجرد تخزين: حفظ كل المحادثات يراكم معلومات مكررة وقديمة وخاطئة، ولذلك تحتاج الذاكرة إلى تحقق وتنظيم.
- بنية ذاكرة من 4 طبقات: لكل طبقة دورها، وهي Transcripts وMemory notes وMemory representations وInjected context.
- تصحيح الأخطاء يعتمد على السجلات الأصلية: يعود Dreaming إلى Transcript للتحقق، وبذلك صحّح اتجاهًا خاطئًا كان يسبب فشلًا متكررًا.
- Wiki يتفوق في المهام العابرة للمستندات: في مهمة الاستحواذ والدمج حصل Wiki على 87% مقابل 73% للاسترجاع وحده، مع توفير نحو 20 ألف Token في المتوسط لكل سؤال.
- للتنظيم آثار جانبية أيضًا: الكتابة المتزامنة قد تُضيّع بعض الحقائق، وقد يتضخم Wiki، كما أنه لا يفيد في المهام البسيطة.
- البناء الذاتي ممكن: يمكنك استدعاء نماذج Claude عبر APIYI على apiyi.com لتنفيذ نسخة مبسطة من تنظيم الذاكرة بين الجلسات.
الخلاصة
يمكن تلخيص ما نتعلمه من Claude Dreaming في ثلاث نقاط:
- جوهر الذاكرة طويلة المدى هو الصيانة: الذاكرة التي خضعت للتحقق وإزالة التكرار والتنظيم هي وحدها التي تساعد المهمة التالية بثبات.
- ما تسجله أهم من حجم ما تسجله: ابدأ بتسجيل ما يصعب استرجاعه من البيئة، مثل القواعد وأسباب الأخطاء والمزالق، وتجنب تسجيل الحالات سريعة التغير.
- تحديد بنية الذاكرة يعتمد على السيناريو: المهام التي تمتد عبر ملفات وجولات متعددة وتتراكم معلوماتها طويلًا تستحق Wiki، أما مهام الاسترجاع البسيطة فلا داعي لإضافة تكلفة صيانة لها.
إذا كان الـ Agent لديك يعمل أصلًا عبر جلسات متعددة، فابدأ بأصغر حلقة متكاملة: “احتفظ بـ Transcript، ونظّم الذاكرة مرة كل ليلة بشكل تسلسلي، وركّب صفحة الفهرس للقراءة فقط”. ننصحك باستدعاء نماذج Claude عبر APIYI على apiyi.com لتجربة هذا المسار بسرعة. توفر المنصة واجهة متوافقة مع OpenAI ورصيدًا تجريبيًا مجانيًا للمستخدمين الجدد.
📚 المراجع
- The components of agent memory: المقال الأصلي في مدونة Anthropic الهندسية، ويعرض بنية الذاكرة ذات الطبقات الأربع وتجربة Dreaming
- الرابط:
anthropic.com/research/components-of-agent-memory -
ملاحظة: المصدر الأصلي لبيانات التجارب، ومنها CL-Bench وPokémon وWiki وتنظيم العقود
-
Dreaming with a dynamic workflow: دليل Claude الرسمي (Cookbook)
- الرابط:
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
ملاحظة: مثال على سير عمل متعدد الوكلاء (Lead وAnalyzer وOrganizer)، مع مرجع للتكاليف
-
منشور Anthropic الرسمي على X: إعلان إصدار مقال Dreaming الهندسي
- الرابط:
x.com/AnthropicAI/status/2118814753154064501 - ملاحظة: يؤكد تاريخ النشر والتوجه الرسمي
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI الرسمي، وللمزيد من المواد يمكنكم زيارة مركز التوثيق docs.apiyi.com


