
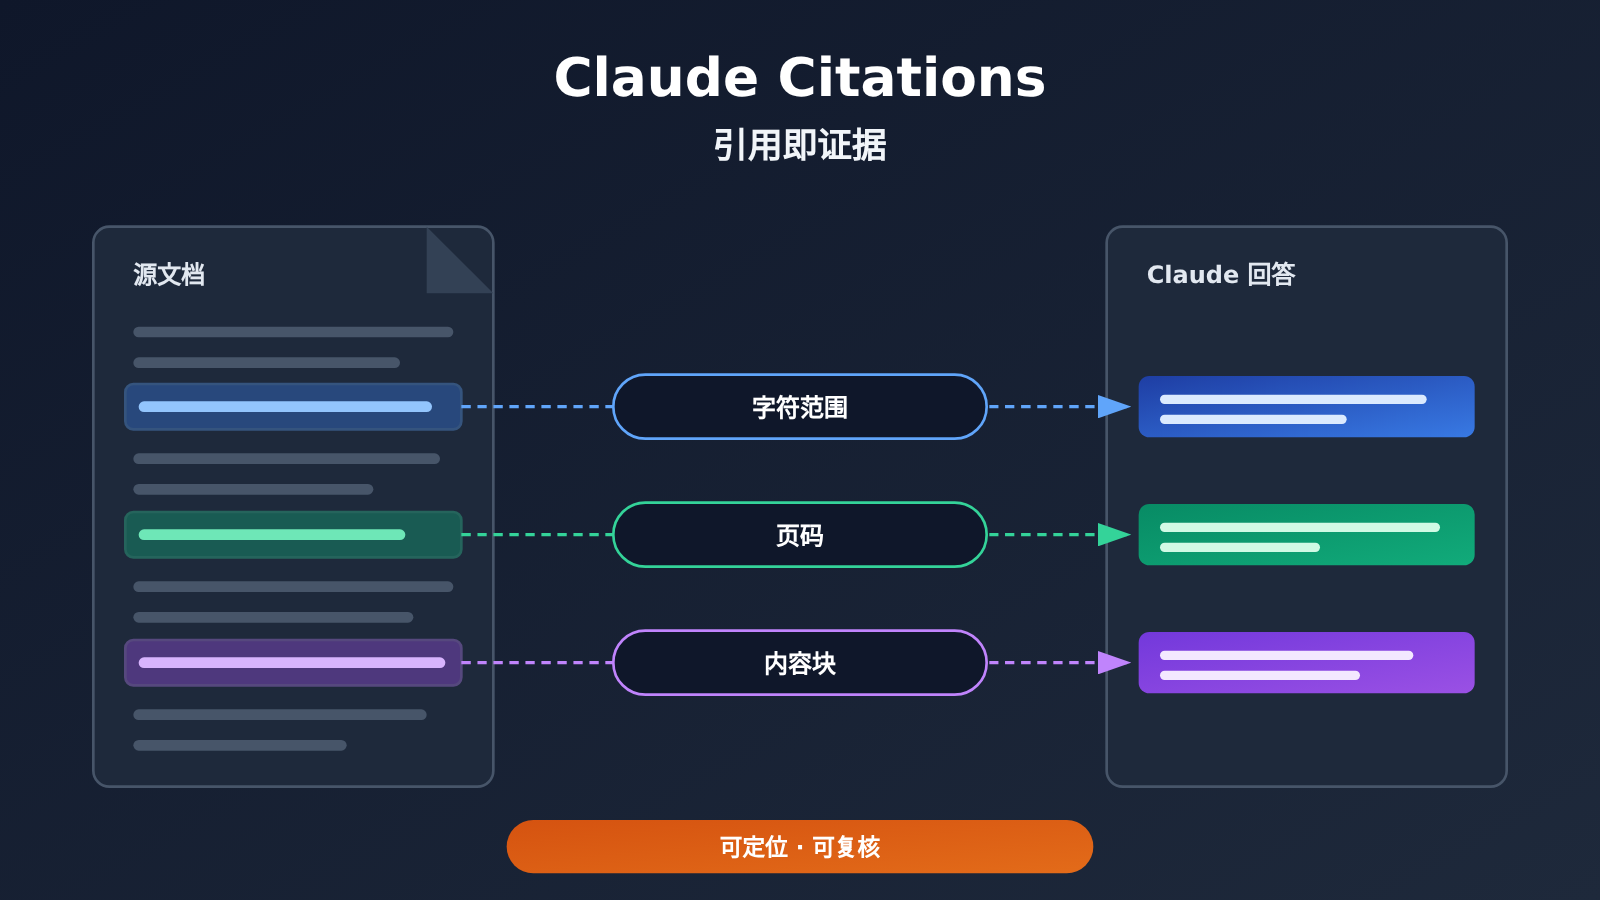
直接回答:Claude Citations 能让模型的回答指向你提供的文档中的具体片段和位置。 纯文本按字符范围定位,PDF 按页定位,自定义内容按块定位。要让引用真正可以复核,关键在应用侧:把每个结论的字段值、对应的引用对象和限定条件一起保存。在转换成结构化数据的过程中,引用不能丢失。
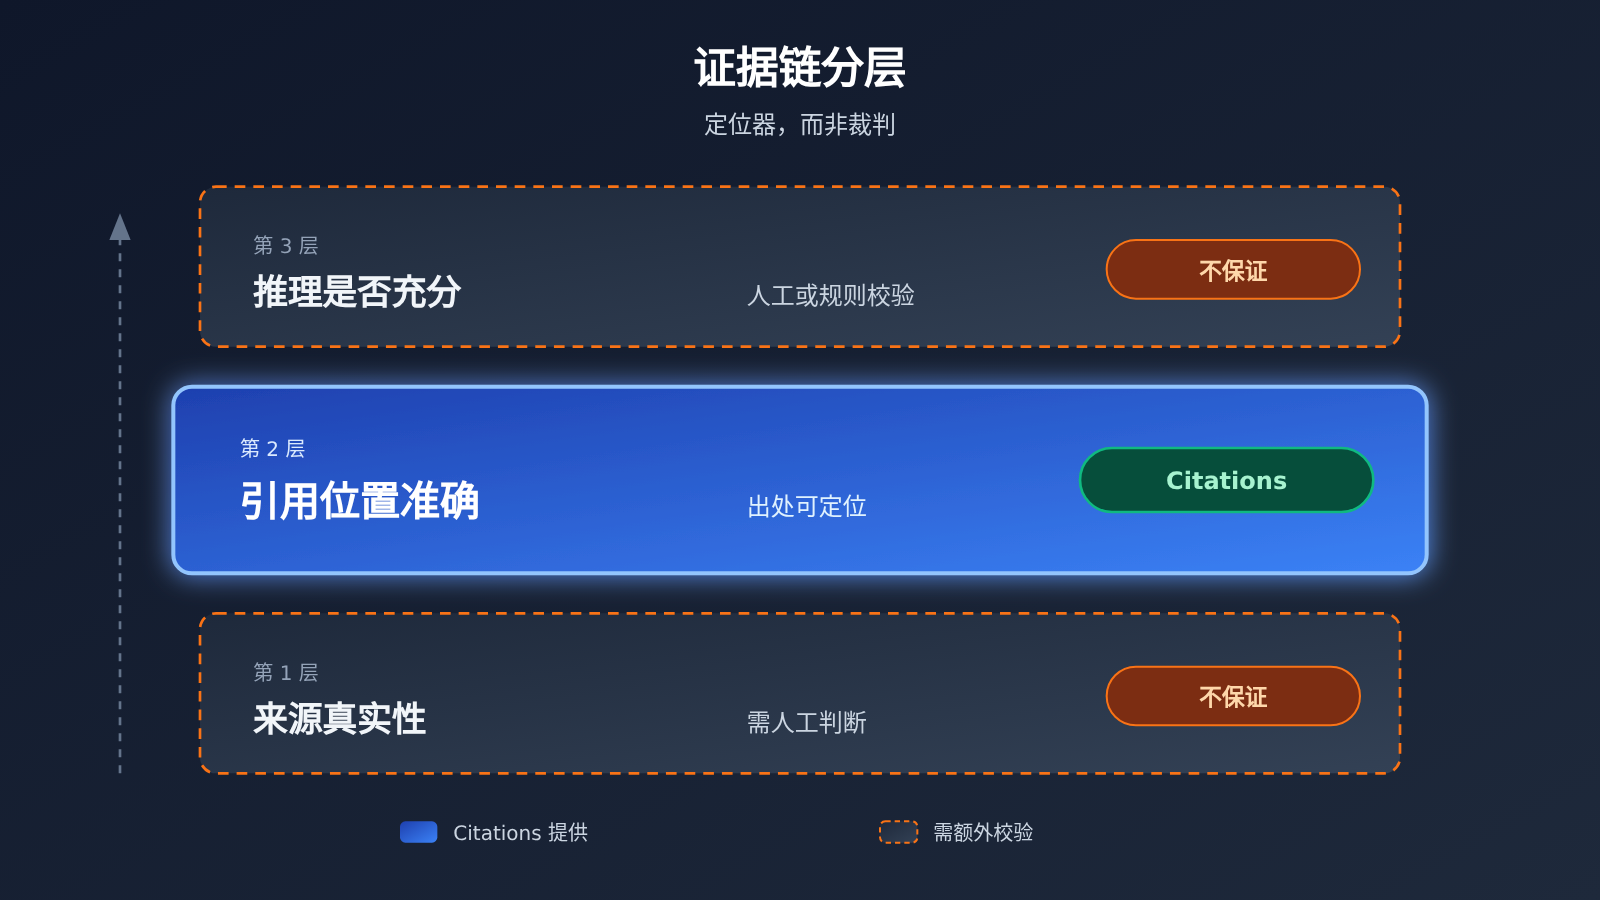
需要说明的是,引用位置正确只代表“这句话在文档里能找到”,并不代表来源本身真实,也不代表推理充分。Citations 是让人复核的工具,不能替代复核。
您读完此文能了解到什么?
- Claude Citations 对哪些输入有效,以及三种定位方式分别是什么。
- 为什么开启引用后不能同时使用严格结构化输出
output_config.format,以及官方建议的替代做法。 - 扫描 PDF 和图片在引用能力上的限制,以及应用侧可以采取的补救方式。
- 如何设计“字段值+引用+限定条件”的数据结构,让价格、上下文长度、地区等信息经得起核对。
索引: 正文前导部分先用一张概念表解释相关术语,再说明这项能力对不同人群的影响。“客观事实”部分依据官方文档整理定位方式、兼容性冲突和输入限制。“分析判断”部分讨论如何把引用落成可复核的证据,以及哪些说法不能对外宣称。
Claude Citations 需要先知道的概念
| 概念 | 简要解释 |
|---|---|
| Citations(引用) | Claude API 的一项能力,在回答中返回来自用户所提供文档的引用片段及其位置 |
| 字符范围定位 | 纯文本文档的引用方式,以字符起止位置标出被引用的原文 |
| 页码定位 | PDF 文档的引用方式,以页为单位标出出处 |
| 内容块定位 | 自定义内容的引用方式,以开发者自行划分的块为单位 |
| 严格结构化输出 | 通过 output_config.format 约束模型按指定格式输出,与引用功能不能同时启用 |
| 可提取文本 | PDF 中能被直接读取的文字层,扫描件往往没有这一层 |
| OCR | 光学字符识别,把图片中的文字转成文本,属于应用侧处理,不是 Claude 的引用能力 |
| 限定条件 | 让一个数值成立的前提,例如计费单位、模型版本、适用地区 |
Claude Citations 影响速览
| 人群 | 影响 |
|---|---|
| 开发者 | 可以为问答、检索增强和资料抽取类应用加上可定位的出处;但需要在结构化输出和引用之间做取舍,并自行设计解析逻辑 |
| 内容与研究人员 | 核对时能直接跳到原文片段或页码,减少逐页翻找;但仍需自己判断来源是否可信、结论是否成立 |
| 产品与运营 | 适合做“价格、规格、政策”这类必须给出出处的信息展示;扫描件资料需要先完成文字化和核验 |
| 普通用户 | 看到带出处的回答更便于自查,但不应把“有引用”理解为“一定正确” |
Claude Citations 客观事实
以下事实依据 Claude 官方文档整理(来源:platform.claude.com/docs/en/build-with-claude/citations),核查日期为 2026-11-17。该页面属于持续维护的文档,本文未能核实这项功能最早的发布日期,因此不给出首发时间。
Claude Citations 的三种定位方式
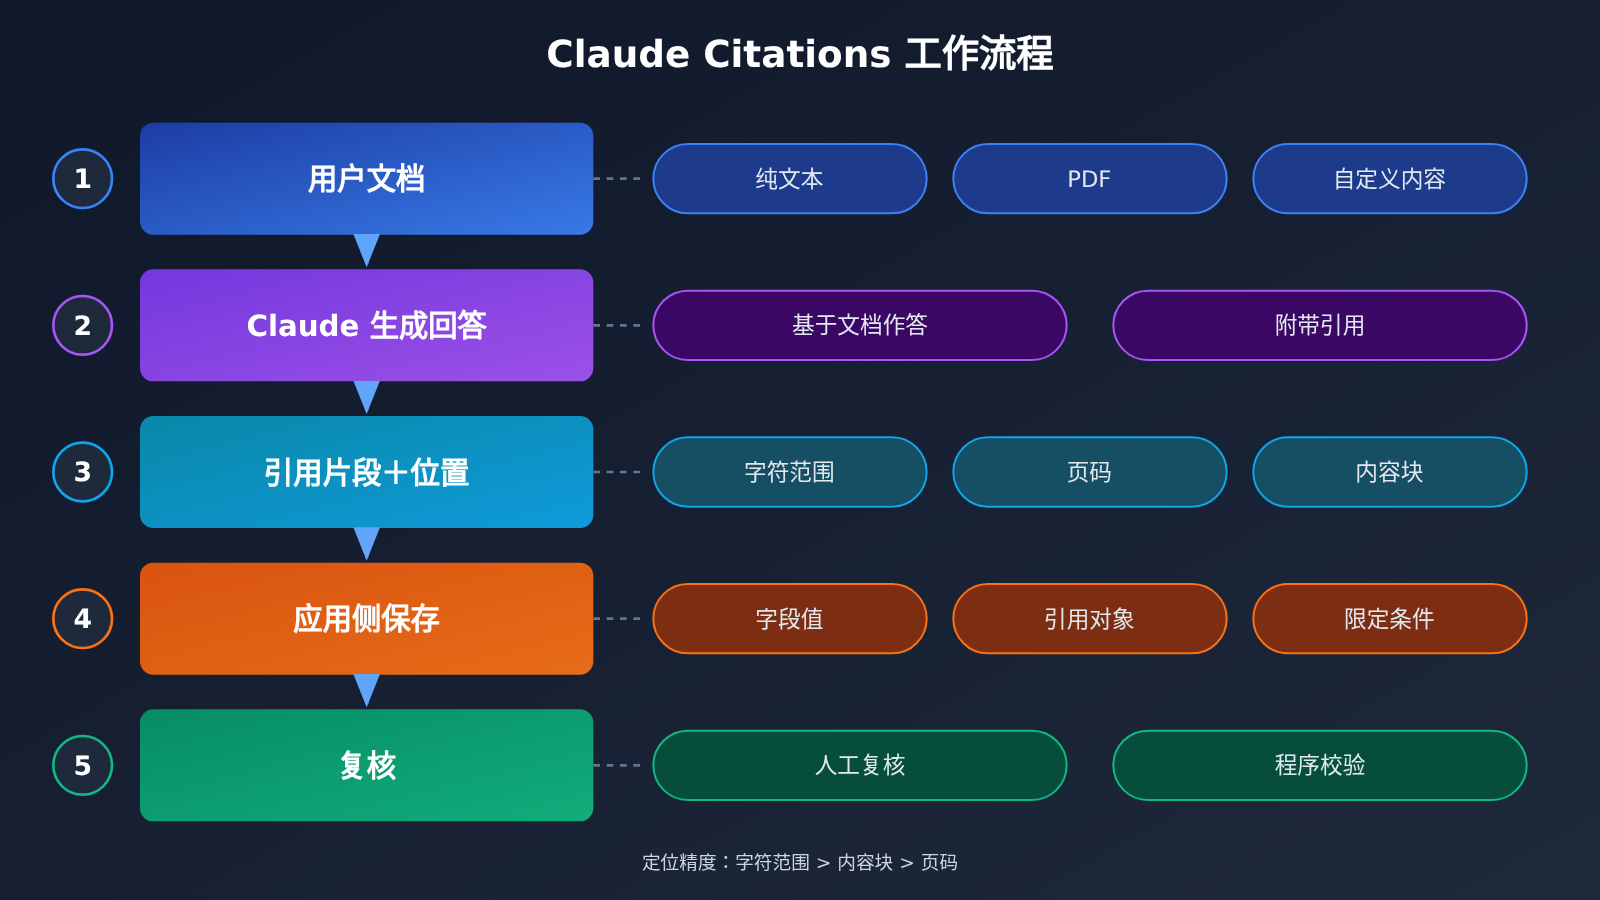
Citations 针对的是用户自己提供的文档。模型回答时,会返回被引用的原文片段以及它在文档中的位置。定位粒度取决于文档类型:
| 文档类型 | 定位方式 | 复核时怎么用 |
|---|---|---|
| 纯文本 | 字符范围 | 按起止位置截取原文,可以逐字比对 |
| 页码 | 跳到对应页人工查看,需要在页内自行找到具体位置 | |
| 自定义内容 | 内容块 | 按开发者划分的块回查,粒度由切分方式决定 |
可以看出,三种方式的精度并不一样。字符范围最细,适合程序化校验;页码定位需要人工在页内查找;内容块的精度完全取决于开发者如何切分。如果块切得太大,引用虽然“正确”,复核成本却会明显上升。
Claude Citations 与严格结构化输出不兼容
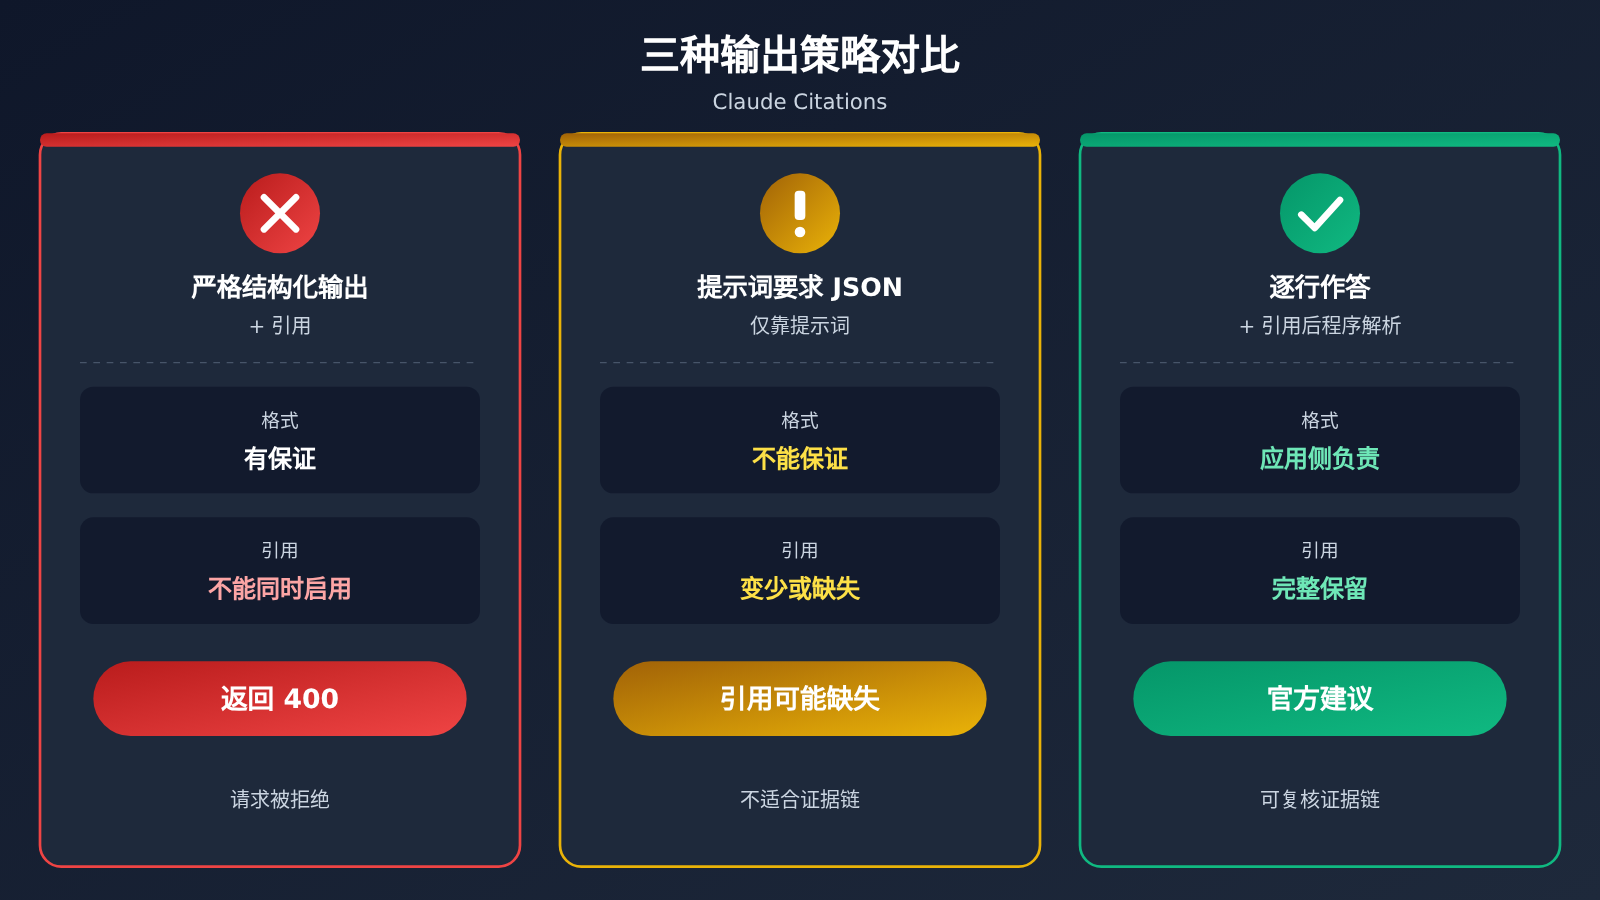
这是落地时最容易踩的坑。官方文档写明:启用引用后,不能同时使用严格结构化输出 output_config.format,两者同时开启时请求会返回 400 错误。
官方给出的替代思路是:让模型逐字段、逐行作答并附上引用,再由程序解析成需要的结构。还有一种看起来可行的做法,是只在提示词里要求模型输出 JSON。这样有时确实能得到 JSON,但引用可能变少,甚至完全没有。两种做法要分清楚:
- 严格结构化输出:格式有保证,但不能与引用同时启用。
- 仅靠提示词要求 JSON:格式不能保证,引用也可能缺失,不适合做证据链。
- 逐字段逐行回答+引用,再程序解析:官方建议的方式,格式由应用侧负责,引用得以保留。
Claude Citations 的输入限制
| 输入情况 | 能否直接引用 | 说明 |
|---|---|---|
| 带文字层的 PDF | 可以 | 按页定位 |
| 没有可提取文本的扫描 PDF | 不能直接引用 | 缺少文字层,无法定位文本 |
| 图片 | 不支持 | 引用能力不覆盖图片内容 |
| 经 OCR 转出的文本 | 取决于应用侧处理 | OCR 是应用侧的建议做法,不是图片引用能力 |
这里要准确理解“不能直接引用”。它说的是扫描 PDF 在缺少可提取文本时不能被直接引用,并不意味着所有扫描资料永远无法处理。开发者可以先在应用侧取得文字,再把文本作为文档交给模型。
关于效果提升的说法
厂商对引用功能给出过约 20% 提升的表述。这个数字只能归因于厂商自己的声明,本文没有独立验证。本文也没有进行任何性能测试,因此不提供量化收益结论。
Claude Citations 分析判断
以下是基于上述事实的解读与建议,属于作者判断,不是官方结论。
把 Claude Citations 落成“字段值+引用+限定条件”
引用真正的价值,在于让每个结论都能被追溯和核对。如果最终入库的只有一个数值,比如“128K”或“3 美元”,引用就在数据转换中丢失了,事后没人能确认它来自哪里、在什么条件下成立。
比较稳妥的做法,是为每个事实型字段保存三部分:字段值、引用对象、限定条件。下面是一个应用侧的数据结构示例。字段命名由开发者自行决定,不是 Claude API 的返回格式:
{
  "field": "input_price",
  "value": "3",
  "qualifiers": {
    "unit": "USD per million input tokens",
    "model_version": "<文档中标注的版本>",
    "region": "<适用地区,如文档未提及则为 null>"
  },
  "citation": {
    "doc_id": "pricing-2026-11",
    "location_type": "page",
    "location": "<模型返回的页码或字符范围>",
    "quoted_text": "<模型返回的原文片段>"
  },
  "verified": false
}
示例中的价格数值只用来演示结构,不代表任何真实价格。设计时有几个要点:
- 价格必须保留计费单位:同一个数字,按每千 token 和按每百万 token 计费,含义相差千倍。
- 能力必须保留版本:上下文长度、功能支持情况会随模型版本变化,脱离版本的数字很快就会失效。
- 地区类信息要写明适用范围:文档没有提到时记为空,不要自行推断补全。
- 保留原文片段:复核时可以直接比对,不必重新调用模型。
用逐行作答代替严格结构化输出
既然引用与 output_config.format 不能同时启用,工程上就需要接受“格式由自己负责”。可行的流程如下:
- 在提示词中把要抽取的字段逐一列出,要求模型每行只回答一个字段,并为该行附上引用。
- 应用侧按行解析,把每行的回答文本与它携带的引用对象一一对应。
- 用固定规则把文本转换成目标结构,同时把引用原样写入
citation字段。 - 对没有引用的行打上标记,进入人工复核或直接丢弃,不作为已确认事实入库。
这样做比直接拿 JSON 多了一道解析步骤,但换来的是每个字段都有出处。对于价格、合规条款这类出错代价高的信息,这道工序值得付出。
扫描资料:先取得文字,再做二次核验
面对扫描 PDF,应用侧可以先用 OCR 取得文字,再交给模型引用。但 OCR 本身也会引入误差,至少需要核验以下几项:
- 数字与单位:小数点、千分位、货币符号最容易识别错,而它们恰恰是价格类信息的核心。
- 表格结构:行列错位会让数值对应到错误的项目上,引用位置再准确也没有意义。
- 页码映射:OCR 文本中的位置要能映射回原始扫描页,否则复核人员找不到出处。
也就是说,在这条链路上,引用定位的是 OCR 文本,而不是原始扫描图像。可信度上限取决于 OCR 的质量。
Claude Citations 不能证明什么
有了引用,回答的可核查程度会提高,但对外描述时需要克制。以下几种说法缺少依据,不应使用:
- “自动联网查证”:Citations 针对的是用户提供的文档,不涉及联网检索。
- “零幻觉”:引用位置正确,不等于模型的概括、推理没有偏差。
- “来源一定可靠”:如果原文档本身有误,引用只会把错误准确地指出来。
- “所有扫描 PDF 都无法处理”:限制在于没有可提取文本时不能直接引用,应用侧仍有补救手段。
更准确的定位是:Claude Citations 把“这句话出自哪里”的举证成本降低了,而“这句话对不对”仍然需要人或规则来判断。
后续值得关注的方向
以下内容属于预测或待观察事项,并非已经确认的事实:
- 引用与严格结构化输出能否在后续版本中兼容。一旦兼容,前文的逐行解析方案可以大幅简化。
- 引用能力是否会扩展到图片或扫描页的视觉定位。目前文档明确不支持图片引用。
- 厂商宣称的效果提升在不同类型文档上是否成立,需要第三方或自有业务数据验证。
在这些问题有明确答案之前,比较稳妥的策略是把 Claude Citations 当作证据链中的“定位器”,而不是“裁判”。
尽信书,则不如无书。——《孟子·尽心下》


