
摘要:Gemini Omni 1.2 Flash 能生成 3~15 秒、带原生音频的视频。走 Google 官方需要付费档和受支持地区。按公开价格换算,720p 每秒约 $0.07,10 秒一段约 $0.70。
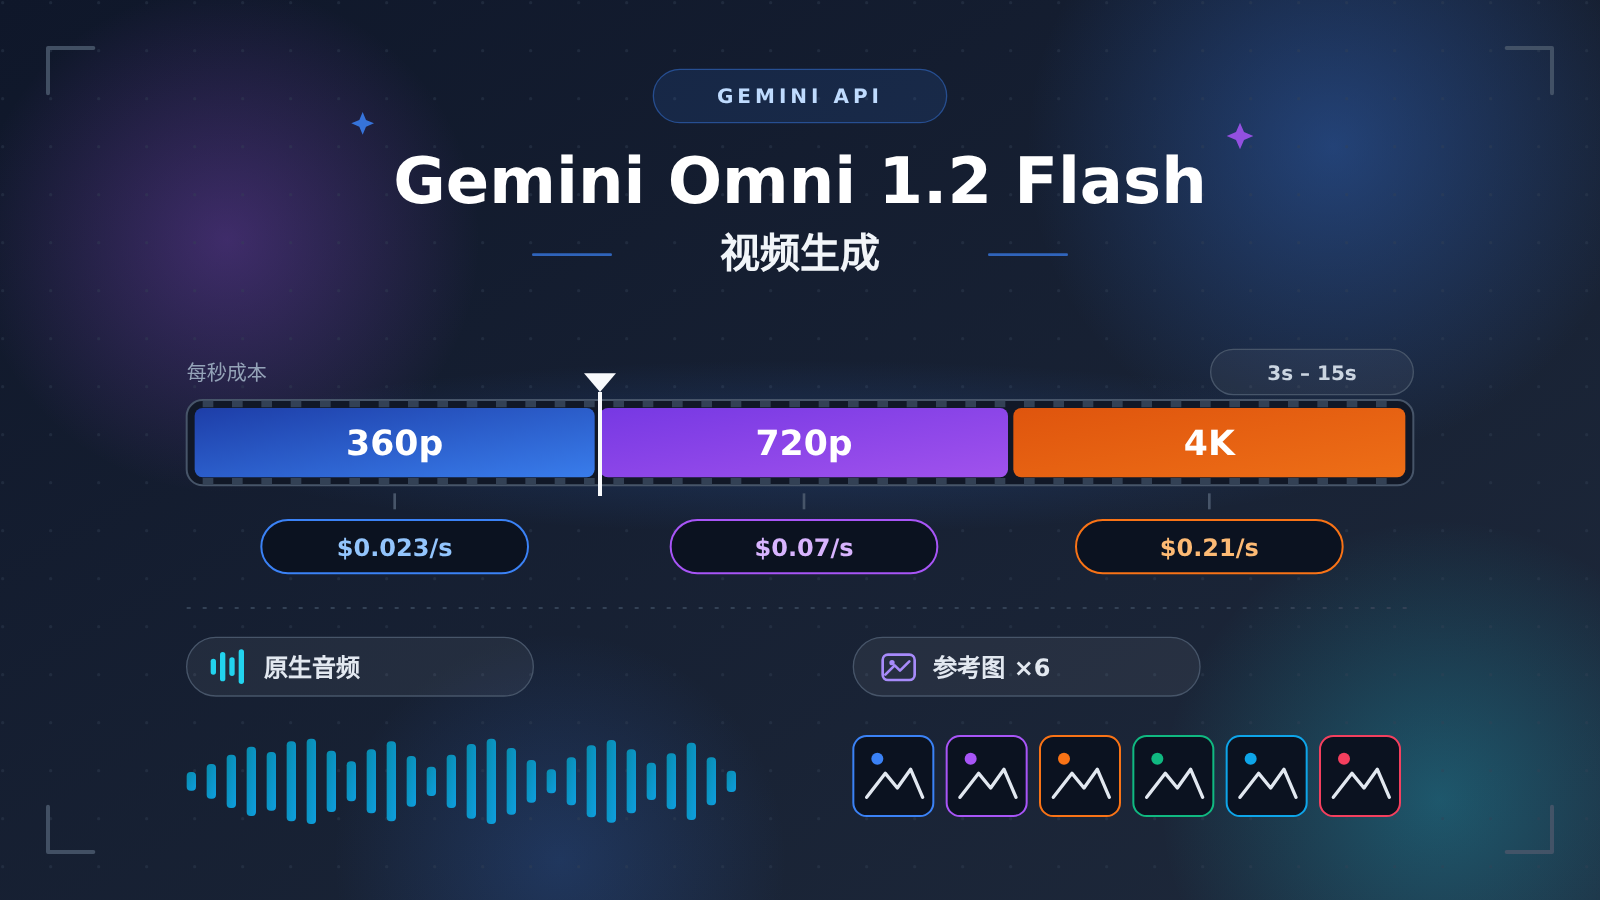
结论先行:Gemini Omni 1.2 Flash 是 Google 于 2026 年 11 月 5 日发布的视频模型,支持 3~15 秒时长、360p 到 4K 分辨率、最多 6 张参考图,并直接输出原生音频。它在 Gemini API 上没有免费档,调用前必须拥有开通结算的付费项目,且所在地区要在 Google AI Studio 与 Gemini API 的支持列表内。按视频输出每百万 token $12.00 计算,360p 每秒约 $0.023,720p 每秒约 $0.07,超分 4K 每秒约 $0.21。对多数试用场景来说,一段 8 秒 720p 视频约 $0.56,单次试错成本较低,真正的门槛在账号、结算和地区。
下文先用一张术语表扫清基础概念,再拆解模型能力和官方门槛,接着给出不同分辨率、时长组合的成本对照表和估算方法,然后说明“创建、轮询、下载”这一异步视频任务的调用形态,最后列出接入前需要逐项核实的事项。读完这些内容,你可以判断这个模型值不值得放进自己的应用或内容生产流程。
To Know:Gemini Omni 1.2 Flash 相关术语
| 术语 | 解释 |
|---|---|
| Gemini API | Google 面向开发者的模型调用接口,按 token 计费 |
| Google AI Studio | Google 的网页端调试控制台,可创建 API Key、试用模型 |
| 付费档(Paid Tier) | 绑定 Cloud 结算账户后才能使用的计费等级,与免费档相对 |
| Cloud 结算 | Google Cloud 的计费账户,通常需要绑定信用卡 |
| token | 模型计量单位;视频输出也会按分辨率和时长折算成 token |
| 原生音频 | 模型在生成画面时同步生成声音,无需额外配音步骤 |
| 参考图 | 生成时提供的图片,用来约束人物、物体或风格的一致性 |
| 文生视频 / 图生视频 | 分别以文字提示词、图片加提示词作为输入生成视频 |
| 超分 4K | 先生成较低分辨率再放大到 4K 的处理方式,计费按 4K 档 |
| 异步任务 | 提交请求后先拿到任务 ID,等后台生成完成再取结果 |
| 轮询 | 每隔一段时间查询任务状态,直到完成或失败 |
| Interactions API | Google 自有接口,提供视频对话式编辑、续写等能力 |
| OpenAI 兼容接口 | 第三方平台按 OpenAI SDK 的请求格式封装的接口,便于复用代码 |
1 Gemini Omni 1.2 Flash 核心要点:能做什么
1.1 Gemini Omni 1.2 Flash 能力边界
下表汇总目前公开资料中的核心参数。这些参数来自第三方平台对 Google 发布信息的整理,正式接入前应在 Google 官方发布页再核对一次。
| 维度 | 参数 | 对开发者的意义 |
|---|---|---|
| 发布时间 | 2026 年 11 月 5 日 | 属于新模型,价格与可用性仍可能调整 |
| 视频时长 | 3~15 秒 | 适合短视频片段、广告镜头、产品演示,长视频需拼接 |
| 分辨率 | 360p 到 4K(4K 为超分) | 预览用低分辨率,成片再用高分辨率,可控成本 |
| 参考图 | 最多 6 张 | 可锁定角色外观、商品细节或画面风格 |
| 音频 | 原生音频 | 环境音、音效与画面同步生成,减少后期工序 |
| 免费档 | 无 | 必须先开通付费项目才能调用 |
1.2 Gemini Omni 1.2 Flash 的能力归属:哪些只在 Google 自有接口
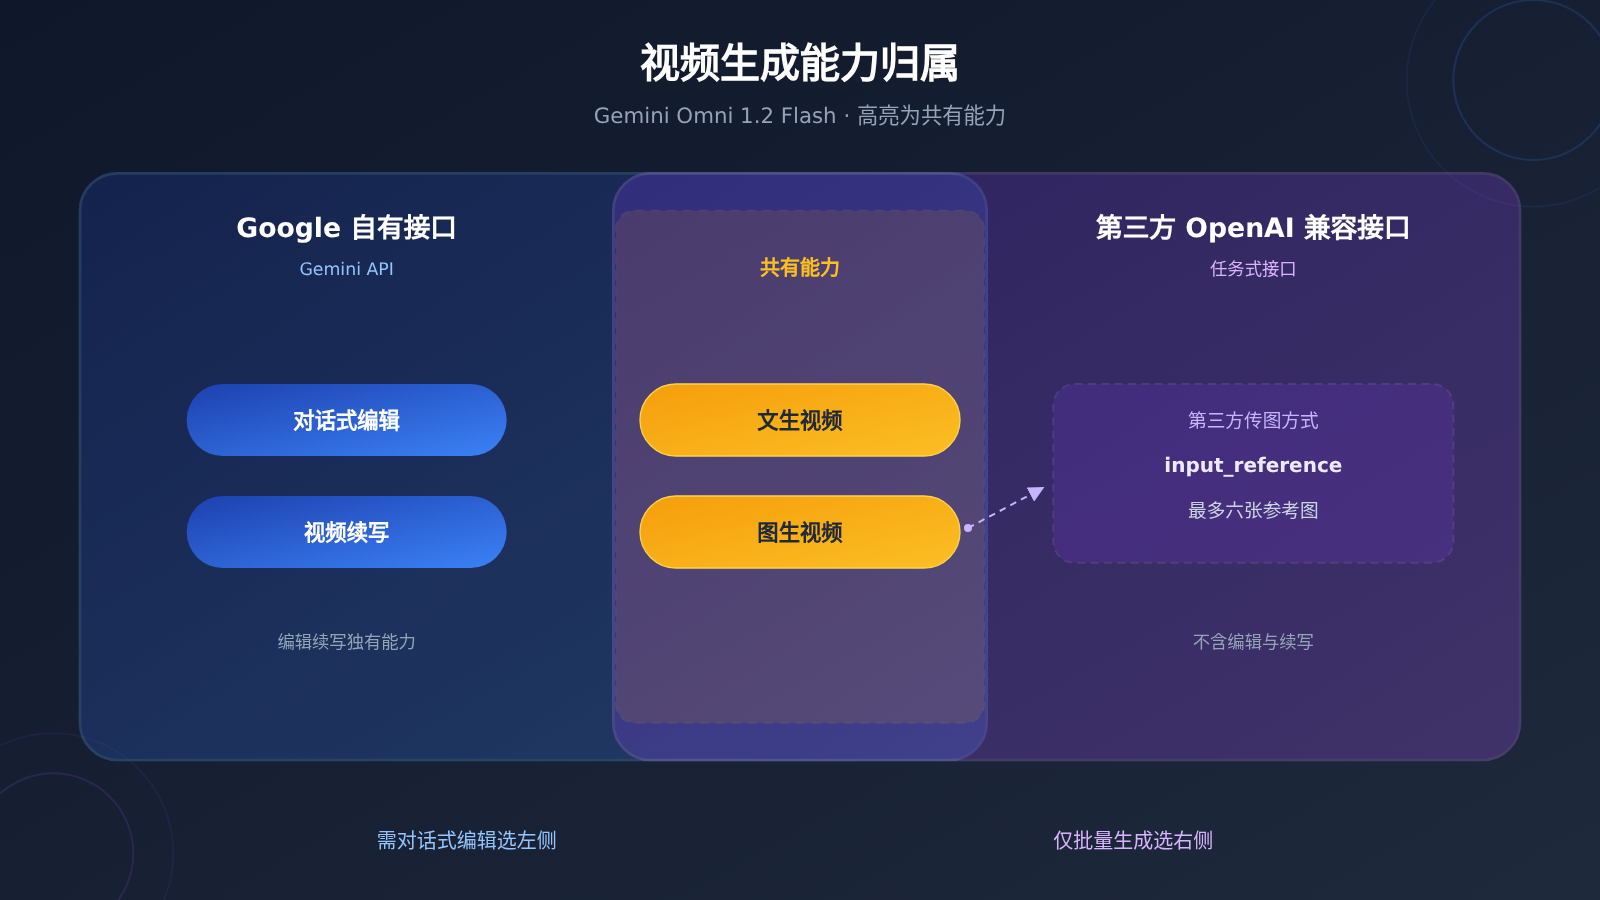
文生视频和图生视频是最基础的两种模式,第三方 OpenAI 兼容平台通常也会覆盖。对话式编辑(基于上一段视频继续用自然语言修改)和视频续写属于 Google Interactions API 的功能。
这一区分对选型影响很大。如果你的产品需要“生成后让用户一句话改镜头”,就要直接使用 Google 自有接口;如果只是批量生成独立片段,任务式接口已经足够。
2 Gemini Omni 1.2 Flash 官方门槛:走 Google 要满足的条件
2.1 付费档与 Cloud 结算
Google 价格页上 Gemini Omni 1.2 Flash 的免费档标注为“Not available”。调用前需要一个开启结算的 Gemini API 项目,也就是开通 Google Cloud 结算并绑定信用卡。
对国内开发者而言,这一步的实际难点通常是可用的境外支付方式和 Google 账号。团队使用时,还要提前规划谁持有结算账户、如何设置预算告警,避免测试脚本循环调用产生意外账单。
2.2 地区限制与报错识别
Google AI Studio 和 Gemini API 只在支持的地区开放。不在支持列表内的地区,AI Studio 无法打开,API 调用会返回“User location is not supported for the API use”。
遇到这个报错时,问题出在请求来源地区,更换 Key 或修改参数都无法解决。Google 的支持地区列表会动态更新,接入前请以官方文档中的最新列表为准。
2.3 Gemini Omni 1.2 Flash 官方事实与第三方自述的区分
市面上已有第三方平台宣布将接入该模型,它们的介绍里混合了 Google 的官方信息和平台自身的服务说明。下表把两类信息拆开,方便你判断哪些可以直接引用,哪些要向平台本身确认。
| 信息 | 类别 | 说明 |
|---|---|---|
| 发布日期、时长、分辨率、参考图数量、原生音频 | Google 官方信息(经第三方转述) | 以 Google 发布页为准 |
| 无免费档、需付费项目 | Google 官方价格页 | 以 Gemini API 价格页为准 |
| 每百万 token 价格、每秒 token 折算 | Google 官方价格页 | 以 Gemini API 价格页为准 |
| 对话式编辑、续写归属 Interactions API | Google 自有接口能力 | 以 Google 文档为准 |
模型 ID gemini-omni-1.2-flash |
第三方平台自述 | 各平台命名可能不同,需逐一确认 |
/v1/videos 任务接口、seconds / size 参数 |
第三方平台自述 | 属于 OpenAI 兼容封装,非 Google 原生格式 |
| 充值方式、起充金额、余额不足返回 402 | 第三方平台自述 | 仅适用于该平台 |
| “已上线 / 即将上线” | 第三方平台自述 | 截至该平台发文时尚未上线,需实时确认 |
3 Gemini Omni 1.2 Flash 成本估算:按秒、按段换算
3.1 官方计价结构
Gemini API 对该模型按 token 计价,每百万 token 的价格如下:输入 $1.50,视频输出 $12.00,文字输出 $9.00。视频输出 token 按分辨率和秒数折算:
- 360p:每秒 1,931 token,约每秒 $0.023
- 720p:每秒 5,792 token,约每秒 $0.07
- 超分 4K:每秒 17,376 token,约每秒 $0.209
换算公式很直接:单段视频输出成本 = 每秒 token 数 × 秒数 × $12 ÷ 1,000,000。以 720p、10 秒为例,5,792 × 10 × 12 ÷ 1,000,000 ≈ $0.695。
3.2 Gemini Omni 1.2 Flash 分辨率 × 时长成本对照表
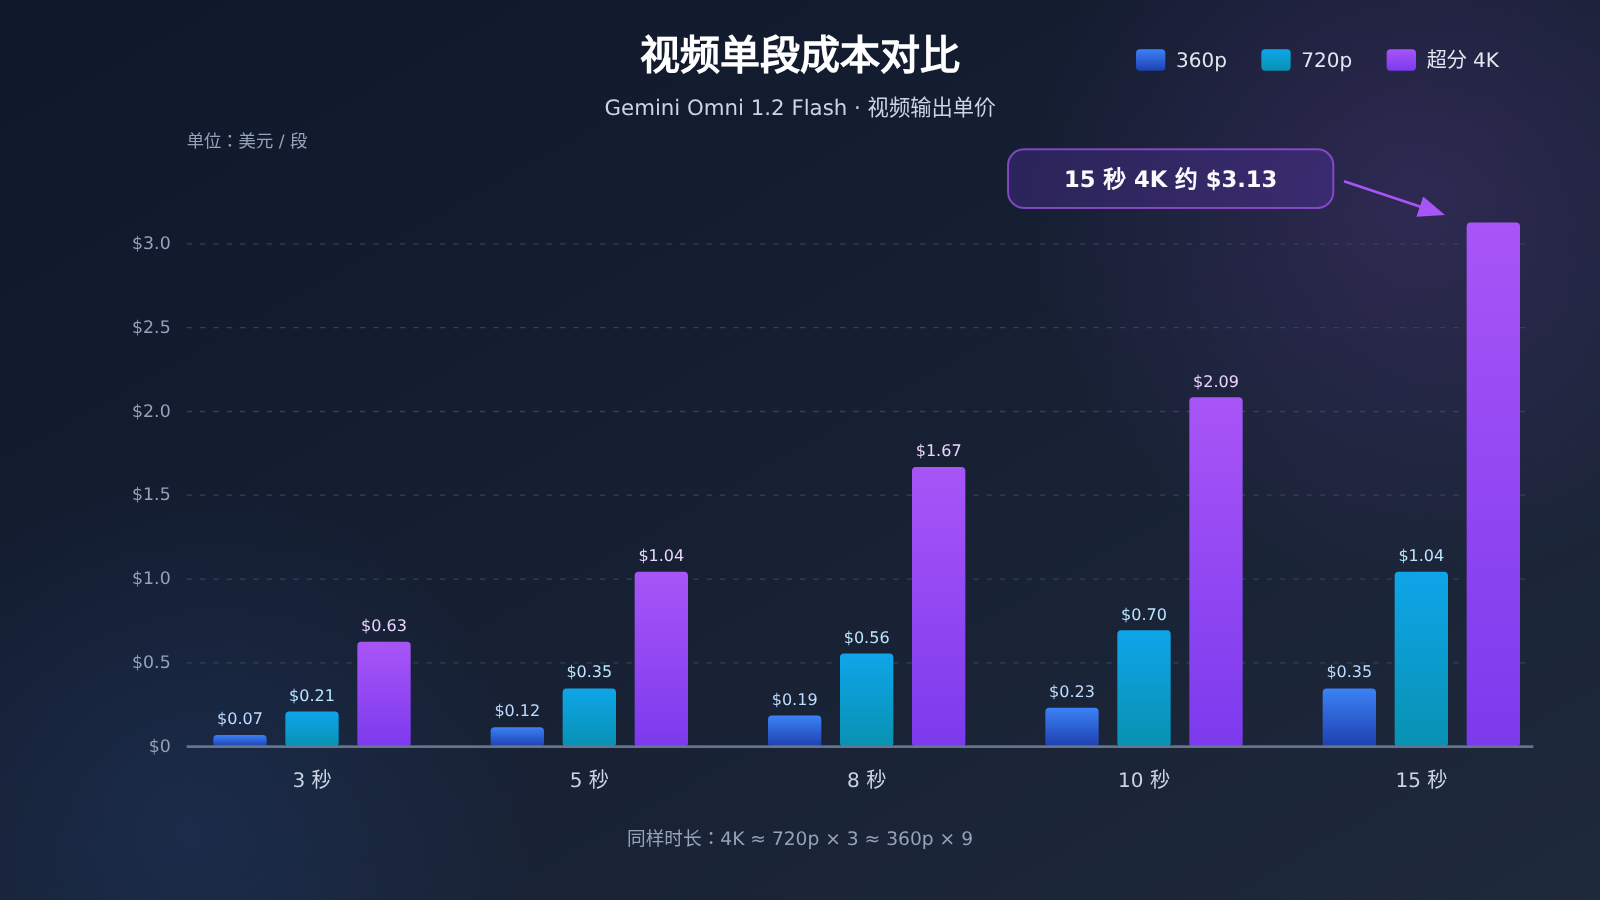
下表按官方视频输出单价计算,只含视频输出部分,四舍五入到小数点后三位。
| 时长 | 360p(1,931 token/秒) | 720p(5,792 token/秒) | 超分 4K(17,376 token/秒) |
|---|---|---|---|
| 3 秒 | $0.070 | $0.209 | $0.626 |
| 5 秒 | $0.116 | $0.348 | $1.043 |
| 8 秒 | $0.185 | $0.556 | $1.668 |
| 10 秒 | $0.232 | $0.695 | $2.085 |
| 15 秒 | $0.348 | $1.043 | $3.128 |
可以看到,同样时长下 4K 约为 720p 的 3 倍、360p 的 9 倍。公开资料中没有给出 1080p 的 token 折算值,需要该档位时请查官方价格页。
3.3 估算时容易漏掉的三项开销
上表只覆盖视频输出。实际账单还要考虑以下几部分:
- 输入 token:提示词和参考图按每百万 token $1.50 计费。最多 6 张参考图的 token 数取决于官方的图片折算规则,公开资料未给出具体数值。
- 重试成本:生成结果不满意需要重跑,预算应按“单段成本 × 平均尝试次数”计算。目前没有公开的失败率或采纳率数据,建议先用小批量任务实测。
- 分辨率策略:先用 360p 调提示词和镜头,确定后再出 720p 或 4K,能明显压低试错费用。8 秒片段在 360p 下试 5 次约 $0.93,接近 720p 跑 2 次的花费。
4 Gemini Omni 1.2 Flash 快速上手:异步视频任务调用流程
4.1 异步任务的三个阶段
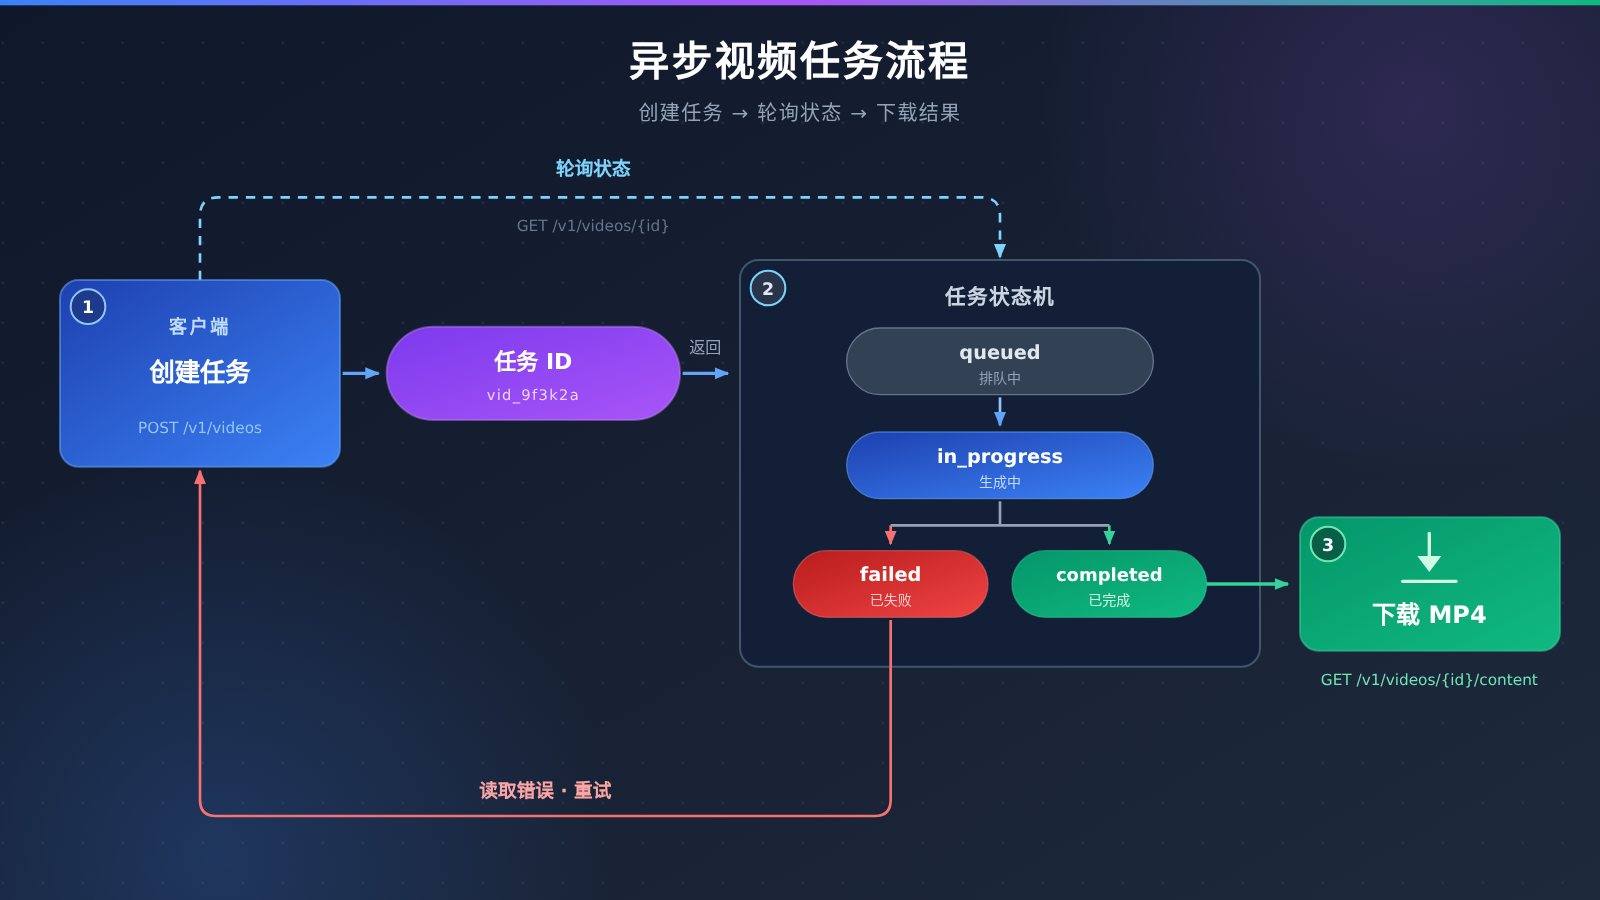
视频生成耗时远长于文本补全,因此普遍采用异步任务形态。一次完整调用分三步:
- 创建任务:提交模型、提示词、时长、分辨率等参数,接口立即返回任务 ID 和初始状态(如
queued)。 - 轮询状态:按固定间隔查询任务,状态依次经历
queued、in_progress,最终变为completed或failed。 - 下载结果:状态为
completed后,通过内容接口取回视频文件。
4.2 OpenAI 兼容格式的调用示例
下面的代码使用 OpenAI SDK 的 videos 接口,参数名来自第三方平台公开的 OpenAI 兼容格式。base_url 和模型 ID 请替换为你实际使用的服务所提供的值,并先确认该服务已上线 Gemini Omni 1.2 Flash。
import os, time
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["VIDEO_API_KEY"],
    base_url=os.environ["VIDEO_API_BASE_URL"],  # 替换为实际服务地址
)

video = client.videos.create(
    model="gemini-omni-1.2-flash",   # 以服务方公布的模型 ID 为准
    prompt="一只穿着迷你宇航服的猫在空间站里漂浮,背景有轻微的环境音",
    seconds="8",
    size="1280x720",
)

while video.status in ("queued", "in_progress"):
    time.sleep(5)
    video = client.videos.retrieve(video.id)

if video.status == "failed":
    raise RuntimeError(video.error)

client.videos.download_content(video.id).write_to_file("omni.mp4")
不使用 SDK 时,对应的 HTTP 流程是:POST /v1/videos 创建任务,GET /v1/videos/{id} 轮询状态,GET /v1/videos/{id}/content 下载视频。图生视频通过 input_reference 字段传入参考图。部分服务还提供 GET /v1/models?type=video,可列出各模型支持的时长和尺寸。
查看带超时、预算预估与错误处理的完整实现
import os, time
from openai import OpenAI

# 官方视频输出折算(每秒 token),用于提交前预估成本
TOKENS_PER_SECOND = {"640x360": 1931, "1280x720": 5792}
VIDEO_OUTPUT_PRICE_PER_M = 12.00  # 美元 / 百万 token

def estimate_cost(size: str, seconds: int) -> float:
    tps = TOKENS_PER_SECOND.get(size)
    if tps is None:
        raise ValueError(f"未登记的分辨率: {size}")
    return tps * seconds * VIDEO_OUTPUT_PRICE_PER_M / 1_000_000

def generate_video(
    prompt: str,
    seconds: int = 8,
    size: str = "1280x720",
    out_path: str = "output.mp4",
    poll_interval: float = 5.0,
    timeout: float = 600.0,
    budget_usd: float = 1.0,
) -> str:
    cost = estimate_cost(size, seconds)
    if cost > budget_usd:
        raise ValueError(f"预估 ${cost:.3f} 超出单段预算 ${budget_usd}")
    print(f"预估视频输出成本: ${cost:.3f}")

    client = OpenAI(
        api_key=os.environ["VIDEO_API_KEY"],
        base_url=os.environ["VIDEO_API_BASE_URL"],
    )

    video = client.videos.create(
        model=os.environ.get("VIDEO_MODEL_ID", "gemini-omni-1.2-flash"),
        prompt=prompt,
        seconds=str(seconds),
        size=size,
    )
    print(f"任务已创建: {video.id}")

    start = time.time()
    while video.status in ("queued", "in_progress"):
        if time.time() - start > timeout:
            raise TimeoutError(f"任务 {video.id} 超时,可稍后用 ID 继续查询")
        time.sleep(poll_interval)
        video = client.videos.retrieve(video.id)
        print(f"状态: {video.status}")

    if video.status == "failed":
        raise RuntimeError(f"生成失败: {video.error}")

    client.videos.download_content(video.id).write_to_file(out_path)
    return out_path

if __name__ == "__main__":
    path = generate_video(
        prompt="清晨的咖啡店,蒸汽从杯口升起,背景有轻柔的人声与杯碟碰撞声",
        seconds=8,
        size="640x360",   # 先用 360p 调提示词
        budget_usd=0.5,
    )
    print(f"已保存: {path}")
4.3 轮询与存储的工程建议
轮询间隔设置在 5 秒左右即可,过于频繁会增加无效请求。生产环境建议把任务 ID 写入数据库,由后台任务统一轮询,这样前端刷新或进程重启都不会丢失已付费的任务。
下载后的视频应尽快转存到自己的对象存储。如果需要批量生成,可以用队列控制并发,并在提交前用 estimate_cost 一类的函数做预算校验,超额任务直接拦截。
5 Gemini Omni 1.2 Flash 接入前需确认的事
5.1 Gemini Omni 1.2 Flash 接入确认清单
| 确认项 | 走 Google 官方 | 走第三方兼容平台 |
|---|---|---|
| 账号与支付 | Google 账号、Cloud 结算、信用卡 | 平台账号与充值方式 |
| 地区 | 所在地区在 Google 支持列表内 | 平台自身的服务范围 |
| 模型是否可用 | 价格页与模型列表中已列出 | 平台模型列表中已上线,模型 ID 确认 |
| 功能范围 | 含 Interactions API 的对话式编辑与续写 | 通常为文生视频、图生视频任务 |
| 价格 | 官方 token 单价 | 平台标价,与官方价对比 |
5.2 用小样本验证质量与耗时
目前公开资料中没有生成质量、耗时和失败率的实测数据。建议准备 5~10 条覆盖你核心场景的提示词,先在 360p、5~8 秒下跑一轮,记录每条的耗时、是否成功和是否可用,再决定高分辨率批量生成的预算。这一轮测试的视频输出成本在 $1~$2 之间。
6 常见问题 FAQ
Q1:Gemini Omni 1.2 Flash 是什么模型?
它是 Google 于 2026 年 11 月 5 日发布的视频生成模型,可生成 3~15 秒、带原生音频的视频,分辨率覆盖 360p 到 4K,最多支持 6 张参考图。
Q2:Gemini Omni 1.2 Flash 有免费额度吗?
Gemini API 价格页上该模型的免费档标注为“Not available”,需要开启结算的付费项目才能调用。
Q3:生成一段 Gemini Omni 1.2 Flash 视频大概多少钱?
按官方视频输出价,720p 每秒约 $0.07:8 秒约 $0.56,10 秒约 $0.70,15 秒约 $1.04。360p 约为其三分之一,超分 4K 约为其 3 倍。提示词和参考图的输入 token 另计。
Q4:调用时报“User location is not supported for the API use”怎么办?
这表示请求来源地区不在 Gemini API 支持列表内,与 Key 和参数无关。需要在受支持地区发起调用,或改用已上线该模型的合规服务。
Q5:能不能在生成后用对话方式修改 Gemini Omni 1.2 Flash 视频?
对话式编辑和续写是 Google Interactions API 的功能。第三方 OpenAI 兼容的 `/v1/videos` 接口一般只负责文生视频和图生视频任务,需要多轮编辑时应使用 Google 自有接口。
Q6:Gemini Omni 1.2 Flash 适合哪些场景?
适合需要声画同步的短片段:电商商品展示镜头、社交媒体短视频素材、App 内的动态封面、广告分镜预演。依赖参考图锁定角色或商品外观的场景也较为合适。
Q7:Gemini Omni 1.2 Flash 目前有哪些限制?
单段最长 15 秒,长内容需要拼接;4K 为超分输出,成本较高;没有免费档;Google 官方渠道受地区限制。生成质量、耗时和失败率暂无公开实测数据,需要自行小样本验证。
7 Gemini Omni 1.2 Flash 核心要点 Key Takeaways
- 能力边界:3~15 秒、360p 到 4K、最多 6 张参考图、原生音频
- 官方门槛:无免费档,需付费 Gemini API 项目与受支持地区
- 按秒成本:360p 约 $0.023、720p 约 $0.07、超分 4K 约 $0.209
- 常用基准:8 秒 720p 约 $0.56,10 秒 720p 约 $0.70
- 调用形态:异步任务,创建、轮询、下载三步完成
- 能力归属:对话式编辑与续写属于 Google Interactions API
- 省钱策略:先 360p 调提示词,确认后再出高分辨率
8 总结:Gemini Omni 1.2 Flash 值不值得试用
Gemini Omni 1.2 Flash 的单段成本处于可以放心试错的区间,720p 一段 10 秒视频不到 1 美元,原生音频还能省掉一道配音工序。对国内开发者来说,主要障碍集中在 Google 付费档的结算要求和地区限制,以及对话式编辑只在 Google 自有接口提供。
建议的决策路径是:先确认自己能满足官方门槛,或找到已正式上线该模型的服务;再用本文的成本对照表做预算;最后以 360p 小样本测试质量和耗时,数据达标后再扩大到生产规模。模型刚发布不久,价格与可用性可能变化,每次接入前都应重新核对 Google 官方价格页。
参考资料
- TeamoRouter 博客:Gemini Omni 1.2 Flash 使用说明:第三方平台对发布信息、官方价格的整理及其接口说明
- 链接:
teamorouter.com/zh/blogs/use-gemini-omni-1-2-flash-without-google-account -
说明: 本文的能力参数与 token 折算数据来源,其中平台接口、充值相关内容属于平台自述
-
Gemini API 官方价格页:Google 发布的模型计费标准
- 链接:
ai.google.dev/gemini-api/docs/pricing - 说明: 用于核对免费档状态、每百万 token 单价与分辨率折算


