
作者注:借腾讯全球数字生态大会提出的“个人提效不等于组织变强”,拆解团队用 AI 时模型调用层要先建立的 5 项管理机制。
2026 年 11 月初,腾讯全球数字生态大会设置了专门的 AI 产品发布台,两天里集中进行了 40 多场产品发布。其中有一个判断值得关注:个人提效并不等于组织变强,两者之间隔着一整套组织能力。这句话出自腾讯云副总经理、WorkBuddy 企业产品负责人张曦耀。
这不是又一篇 Agent 产品发布的复述。本文想讨论的是一个更底层的问题:从个人用 AI 走到团队用 AI 时,大家共用的是同一批模型能力。谁能调用、每个人用了多少、钱花在哪个项目上,这些都要在模型调用层先管好。
核心价值:读完本文,你会得到一份团队推广 AI 之前的检查思路。它覆盖模型接入、密钥与权限、成本归集、调用追踪和经验复用,并且明确了统一网关能解决哪些问题、解决不了哪些问题。
团队用 AI 的核心信息速览
先整理这次讨论的事实背景。下表信息均来自极客公园对大会的报道。
| 信息项 | 详情 |
|---|---|
| 事件 | 腾讯全球数字生态大会 AI 产品发布台,两天、七场议题、40 多场产品发布 |
| 核心判断 | 个人提效不等于组织变强,中间隔着一整套组织能力 |
| 企业版升级重点 | 开放平台连接业务系统;企业级安全方案与可观测中心,用于管理权限、执行过程和使用成本;托管智能体支持 7×24 小时运行 |
| 配套套件 | Buddy One 提供统一账号、共享 Credit 池和集中管理,目标是降低企业配置和推广 AI 的复杂度 |
| 落地案例 | 苏宁建立组织级智能体平台,覆盖 14 个部门、48 个协作场景,沉淀 36 个可复用智能体 |
| 规模挑战 | 若每个 Agent 都需要独立执行环境,运行 10 万个数字员工可能意味着 10 万个沙箱 |
团队用 AI 的三个现实问题
报道里提到,企业在推广 Agent 时要回答三个问题:Agent 能否接入原有系统、访问所需数据?不同员工和 Agent 的权限如何管理?一个人摸索出的好方法,怎样让其他人直接使用?这三个问题对所有准备推广 AI 的团队都适用,不论你用的是哪家的产品。
值得注意的是,企业版升级中“权限、执行过程和使用成本”被放在同一个模块里讨论,共享 Credit 池也被当作降低推广复杂度的手段。这说明当 AI 从个人工具变成团队资源时,访问控制和成本归集已经是基础设施问题,而不是事后补丁。
为什么模型调用层是团队用 AI 的第一道关口
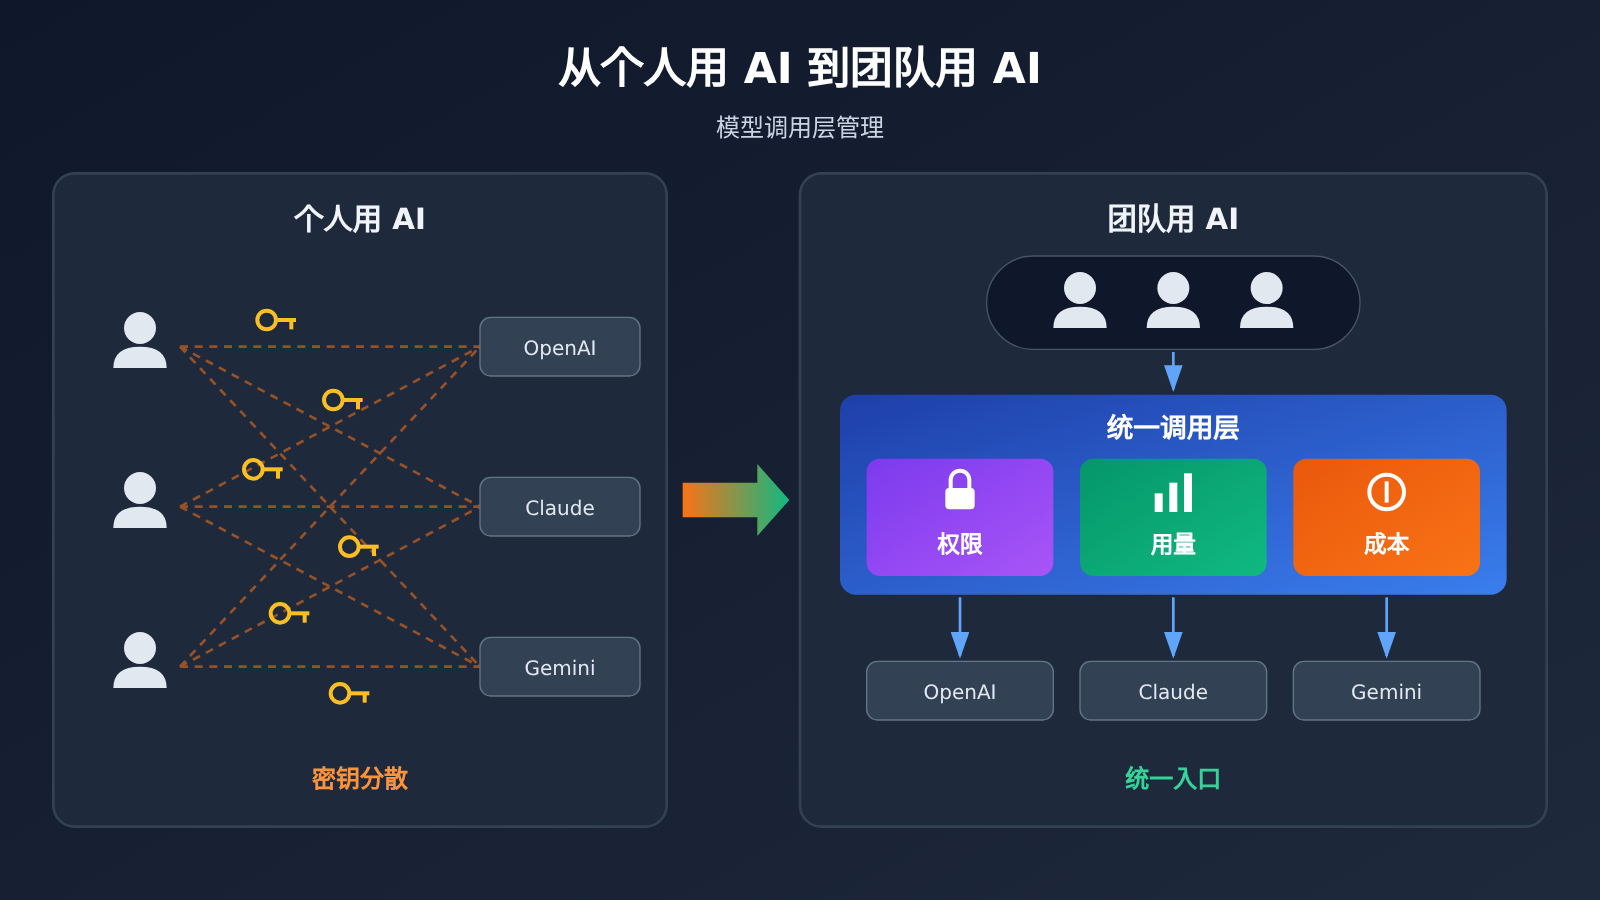
个人用 AI 的典型状态是:每个人各自注册几个模型服务,各自绑卡、各自保管 API Key,在自己的脚本或工具里写死调用地址。这种方式在探索阶段效率很高,但团队人数一多,问题就会集中出现。
常见的混乱包括:密钥散落在个人电脑和聊天记录里,离职交接时没人说得清有多少个 Key 在用;月底账单只能看到总额,分不清是哪个项目、哪个人用掉的;某个模型突然报错或涨价,所有写死调用的地方都要逐个修改。这些问题和 Agent 能力强弱无关,本质上是模型调用层缺少统一管理。
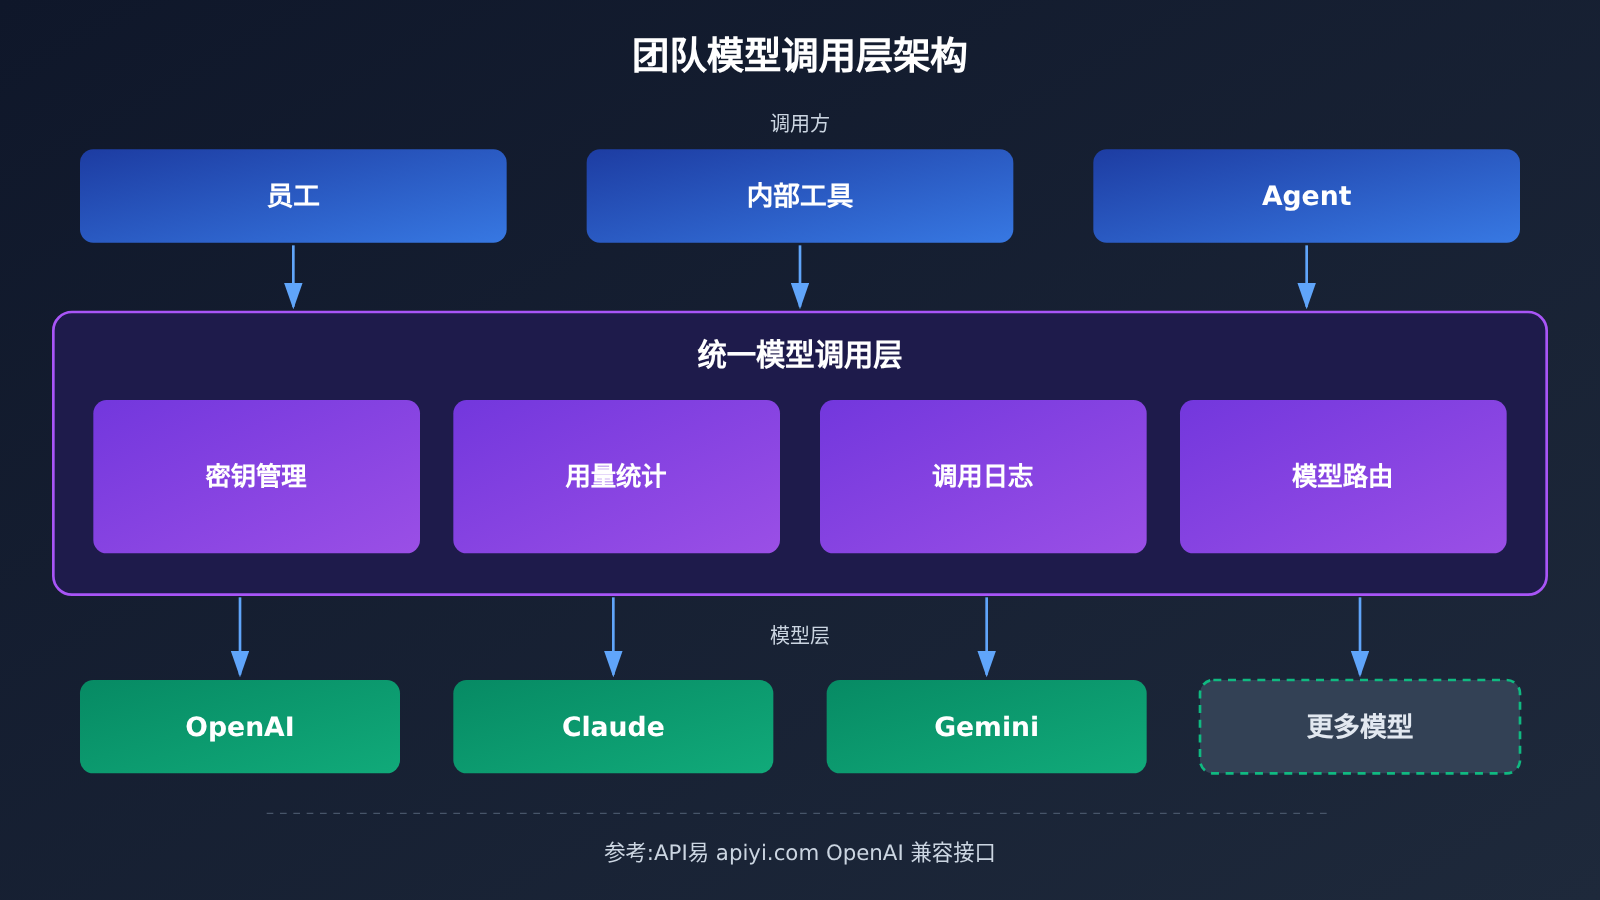
把调用收敛到一层之后,团队才有一个可以统一施加规则的位置。所谓“先管好”,不是一上来就做复杂的审批流程,而是先保证所有调用都经过同一个入口,后续的权限、用量和成本管理才有落脚点。
团队用 AI 前的模型调用层 5 项检查清单
下面这份清单不绑定任何厂商。你可以拿它去评估自建网关、云厂商方案或第三方聚合平台。
| 检查项 | 要回答的问题 | 最低可行做法 |
|---|---|---|
| 1. 模型接入 | 团队需要哪些模型?切换模型要改多少代码? | 统一使用 OpenAI 兼容接口,模型名做成配置项 |
| 2. 密钥与权限 | 谁持有密钥?离职、泄露时能否快速吊销? | 按项目或服务分发密钥,禁止个人密钥进入生产代码 |
| 3. 成本归集 | 每个项目、每个团队花了多少钱? | 至少做到按密钥或项目区分用量,每月出账单明细 |
| 4. 调用追踪 | 出问题时能否定位是哪次调用、哪个模型? | 记录请求时间、模型、Token 数、调用方标识 |
| 5. 经验复用 | 好的提示词和流程能否被别人直接用? | 把验证过的提示词、参数沉淀为共享模板或内部服务 |
检查项 1-2:模型接入与密钥权限
模型接入的关键是“可替换”。不同模型擅长的任务不同,价格和稳定性也会变化。如果业务代码只依赖一个兼容接口,模型名放在配置里,那么从一个模型切到另一个模型就只是改配置,不需要重新开发。
密钥权限的关键是“可回收”。建议的原则是一项服务一个密钥,一个项目一个额度,而不是全团队共用一个超级 Key。这样某个 Key 泄露时,影响范围只限于这一项服务,吊销后其他业务不受影响。
检查项 3-5:成本归集、调用追踪与经验复用
成本归集决定了 AI 投入能不能被业务方认可。如果只能看到总账单,就无法判断哪个场景真的产生了价值,也很难向管理层申请预算。调用追踪则是排查问题的前提,当用户反馈“AI 回答出错”时,你需要能找到那次调用用的是哪个模型、输入了什么。
经验复用对应的正是苏宁案例里的思路:把新品发布的流程整理成模板、把过程文件纳入知识库,筹备时间从 3 个工作日缩短到 4 小时,方法也被保留下来,下次可以直接用。在模型调用层,这意味着把验证过的提示词、模型选择和参数组合封装起来,而不是留在某个人的脑子里。
团队用 AI 的统一调用示例
下面是一个最小示例:通过 OpenAI 兼容接口调用模型,模型名从环境变量读取,方便团队统一切换。
import os
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),      # 按项目分发的密钥
    base_url="https://api.apiyi.com/v1"          # API易 统一接口
)

resp = client.chat.completions.create(
    model=os.getenv("DEFAULT_MODEL", "gpt-4o-mini"),
    messages=[{"role": "user", "content": "总结本周项目进展"}]
)
print(resp.choices[0].message.content)
查看带调用记录的团队封装版本
import os
import time
import json
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),
    base_url="https://api.apiyi.com/v1"  # 一个 Key 调用多家模型
)

def team_chat(prompt: str, project: str, caller: str,
              model: str = None, max_tokens: int = 1000) -> str:
    """团队统一调用入口:记录项目、调用方、模型和 Token 用量"""
    model = model or os.getenv("DEFAULT_MODEL", "gpt-4o-mini")
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    usage = resp.usage
    record = {
        "ts": int(start),
        "project": project,
        "caller": caller,
        "model": model,
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "latency_ms": int((time.time() - start) * 1000),
    }
    # 写入本地日志,后续可导入报表按项目归集成本
    with open("ai_usage.log", "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.choices[0].message.content

print(team_chat("生成一份周报大纲", project="marketing", caller="alice"))
这个封装在应用侧补上了“项目”和“调用方”两个维度。即使平台侧已经提供用量统计,应用侧保留自己的调用记录也很有价值,因为只有你的系统知道这次调用属于哪个业务场景。
🚀 快速开始:如果团队还处在“每人一套密钥”的阶段,可以先通过 API易 apiyi.com 用一个 API Key 统一接入 OpenAI、Claude、Gemini 等主流模型。平台采用 OpenAI 兼容接口、按量计费,新用户有免费测试额度,适合先跑通统一调用入口。
统一模型调用层能解决什么、不能解决什么
很多团队容易把统一网关想象成“AI 治理的全部答案”。实际上,它只管模型调用这一层。下面这张表把边界说清楚。
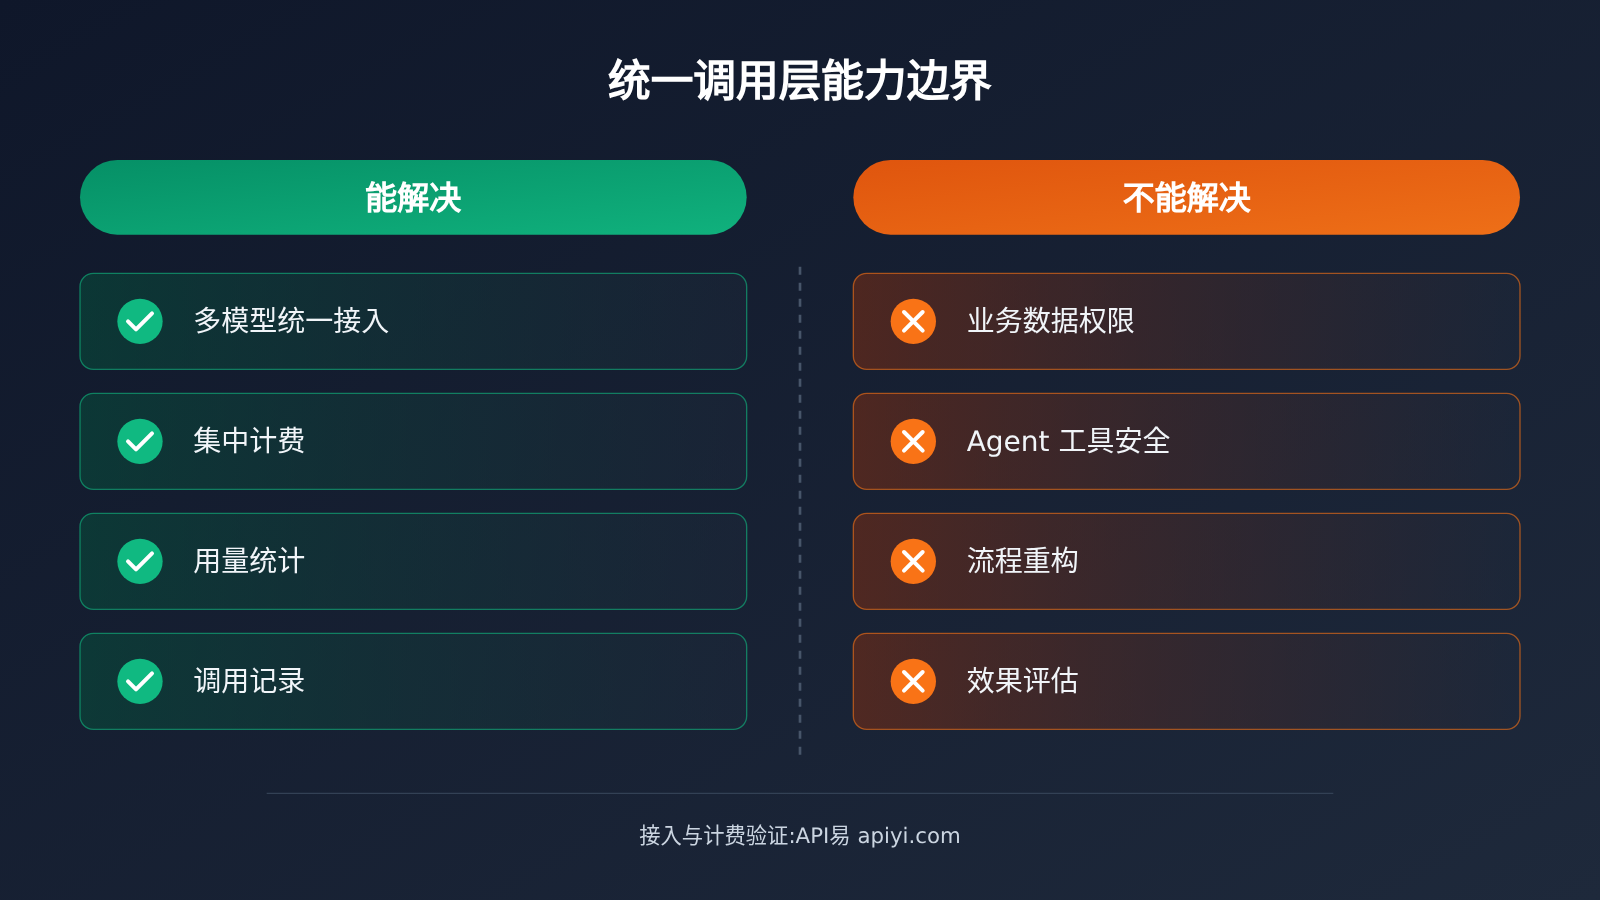
| 维度 | 统一调用层能做到 | 仍需其他环节负责 |
|---|---|---|
| 模型接入 | 一个接口调用多家模型,切换成本低 | 判断哪个模型适合哪个业务 |
| 成本 | 集中余额与按量计费,便于汇总 | 把成本与业务产出挂钩、评估 ROI |
| 权限 | 管控“谁能调模型” | 管控“Agent 能读哪些数据、执行哪些操作” |
| 追踪 | 记录调用层面的模型、Token、时间 | 追踪 Agent 完整执行链路与结果质量 |
| 复用 | 提供稳定的调用入口 | 沉淀提示词、流程模板和知识库 |
这也解释了为什么大会上腾讯要同时发布安全方案、可观测中心、Agent Runtime 和知识产品。报道提到,Agent 可以自主调用工具、访问数据甚至执行代码,如何限制操作范围、保护敏感信息、出现问题时追溯原因都很重要。这些属于 Agent 运行层和数据层的问题,模型网关管不到。
所以合理的顺序是:先把模型调用层统一起来,让访问和花费可见;再在上面叠加数据权限、Agent 安全和流程改造。底层看不清,上层的治理就无从谈起。
团队用 AI 的影响分析
对技术负责人的影响
- 架构上要预留统一入口:新项目接入大模型时,不要再允许直接写死某家官方地址,统一走团队约定的兼容接口。
- 密钥管理进入运维范畴:API Key 应当像数据库密码一样纳入密钥管理流程,有发放、轮换和吊销记录。
- 日志字段要提前设计:项目、调用方、模型、Token 用量至少要能关联起来,否则月底对账时很难补救。
对业务决策者与采购的影响
团队采购 AI 能力时,评估维度会从“哪个模型最强”转向“能不能管得住”。下表按团队所处阶段给出关注重点,供推广规划参考。
| 团队阶段 | 典型状态 | 模型调用层优先事项 |
|---|---|---|
| 个人探索 | 少数人自费试用,各自持有密钥 | 选定统一接口,收拢分散账号 |
| 小组试点 | 一两个项目开始依赖 AI | 按项目分发密钥,建立基础用量统计 |
| 部门推广 | 多个业务线同时调用 | 成本按项目归集,调用记录可检索 |
| 组织级应用 | Agent 进入核心业务流程 | 叠加数据权限、Agent 安全与效果评估 |
对采购而言,还需要关注付款与票据流程是否符合公司财务要求,以及平台的权限粒度、日志字段、保留时长和导出方式。这些细节各家平台差异较大,建议在签约前逐项向服务方确认,并以对方的正式文档为准。
对行业的影响
大会上 Buddy One 提出共享 Credit 池和集中管理,说明“把模型额度当作团队共享资源统一分配”正在成为企业 AI 产品的标配思路。可以预见,无论是大厂套件还是独立的模型聚合平台,用量可见、成本可归集都会成为企业客户的基本诉求,而不是加分项。
💡 选择建议:在正式推广前,建议用真实业务数据做一次小范围试点。你可以通过 API易 apiyi.com 同时调用多家模型,对比同一任务在不同模型上的效果和 Token 消耗,再决定团队默认模型。
常见问题 FAQ
Q1:什么是团队用 AI 时的“模型调用层治理”?
它指的是对团队如何访问大模型进行统一管理,包括用哪些模型、谁持有密钥、每个项目用了多少、每次调用能否追溯。它不负责 Agent 的业务逻辑,而是保证所有调用都经过一个可管理的入口。
Q2:统一模型调用层和企业 Agent 平台有什么区别?
企业 Agent 平台关注 Agent 如何连接业务系统、访问数据、协同工作和长时间运行;模型调用层只关注“调模型”这一步。前者覆盖面更广,但同样依赖底层模型访问的稳定和可控。两者是上下层关系,不是替代关系。
Q3:小团队有必要现在就做这些吗?
有必要,但可以做轻量版本。小团队最值得先做的两件事是:统一调用接口,以及不让个人密钥进入生产代码。这两步成本很低,等团队扩大后再补救会麻烦得多。
Q4:如何快速搭建团队统一的模型调用入口?
一种简单做法是选用 OpenAI 兼容的聚合平台。比如在 API易 apiyi.com 注册后获取 API Key,把代码中的 base_url 替换为 `https://api.apiyi.com/v1`,即可用同一套代码调用 OpenAI、Claude、Gemini 等模型,再配合本文的封装函数记录项目维度的用量。
Q5:聚合平台能直接替代团队的权限系统吗?
不能完全替代。平台能管控模型访问和计费,但成员级、项目级的权限粒度、额度上限和日志保留策略各平台不同,需要以平台文档为准。业务数据权限和 Agent 操作权限则必须由企业自己的系统负责。具体能力可以在 API易 apiyi.com 文档中心核对后再规划。
团队用 AI 模型调用层核心要点 Key Takeaways
- 个人提效不等于组织变强:团队共用模型能力时,管理问题比模型能力更早暴露。
- 先统一入口再谈治理:所有调用经过同一层,权限和成本规则才有落点。
- 密钥按项目分发:一项服务一个 Key,泄露或离职时能快速吊销。
- 成本要能归集到项目:应用侧补充项目和调用方字段,月底才能对账。
- 网关有边界:数据权限、Agent 安全和流程改造需要其他环节负责。
- 低成本起步:可借助 API易 apiyi.com 用一个 Key 统一接入多模型,先跑通试点。
总结
腾讯大会上关于企业 Agent 的讨论,核心落点并不在某个 Agent 有多强,而在于组织如何承接这些能力。对于准备推动团队用 AI 的负责人,模型调用层是最先能落地、也最容易被忽视的一层:
- 模型接入要可替换:统一兼容接口,模型名做成配置。
- 权限与成本要可见:按项目分发密钥、归集用量,避免一本糊涂账。
- 经验要可复用:把验证过的提示词和流程沉淀成团队资产。
热度会过去,但这份检查清单在任何规模的团队推广 AI 时都适用。建议先选一两个业务场景做试点,把调用入口和用量记录跑通,再逐步扩大范围。推荐通过 API易 apiyi.com 快速验证多模型统一接入的效果,平台提供免费测试额度和按量计费方式。
📚 参考资料
- 极客公园 – 一个人用得好 AI,为什么一家公司却用不好?:腾讯全球数字生态大会企业 Agent 相关发布的报道
- 链接:
geekpark.net/news/373541 -
说明: 包含 WorkBuddy 企业版升级、Buddy One、苏宁案例及 Agent Runtime 等信息
-
OpenAI API 文档:Chat Completions 接口与 usage 字段说明
- 链接:
platform.openai.com/docs - 说明: 理解兼容接口的请求结构与 Token 统计方式
作者: APIYI 技术团队
技术交流: 欢迎在 API易 官网 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心


