
作者注:腾讯 Hy4 正式发布,首次支持图像理解和电脑操作。本文把厂商宣传、合作方自测和第三方独立评测放在一起对照,帮你看清它的能力边界和适用场景。
腾讯在预览版发布约两个月后推出了正式版 Hy4,首次支持图像理解与自主操作电脑软件,定价与预览版保持一致。腾讯称它首次跻身最强开放权重模型之列,但权重要到一个尚未公布的日期才会开放。
这不是一篇转述发布会的通稿。腾讯的自测、合作方的反馈和 Artificial Analysis 的独立评测并不完全一致,有几处差别还比较大。本文把三方说法逐条对照,分清楚哪些是厂商声称,哪些是独立结论。
核心价值:读完你会知道 Hy4 新增了哪些能力、价格是多少、在哪些任务上明显落后,以及在编程、金融和办公场景里该怎么用才稳妥。
腾讯 Hy4 核心信息速览
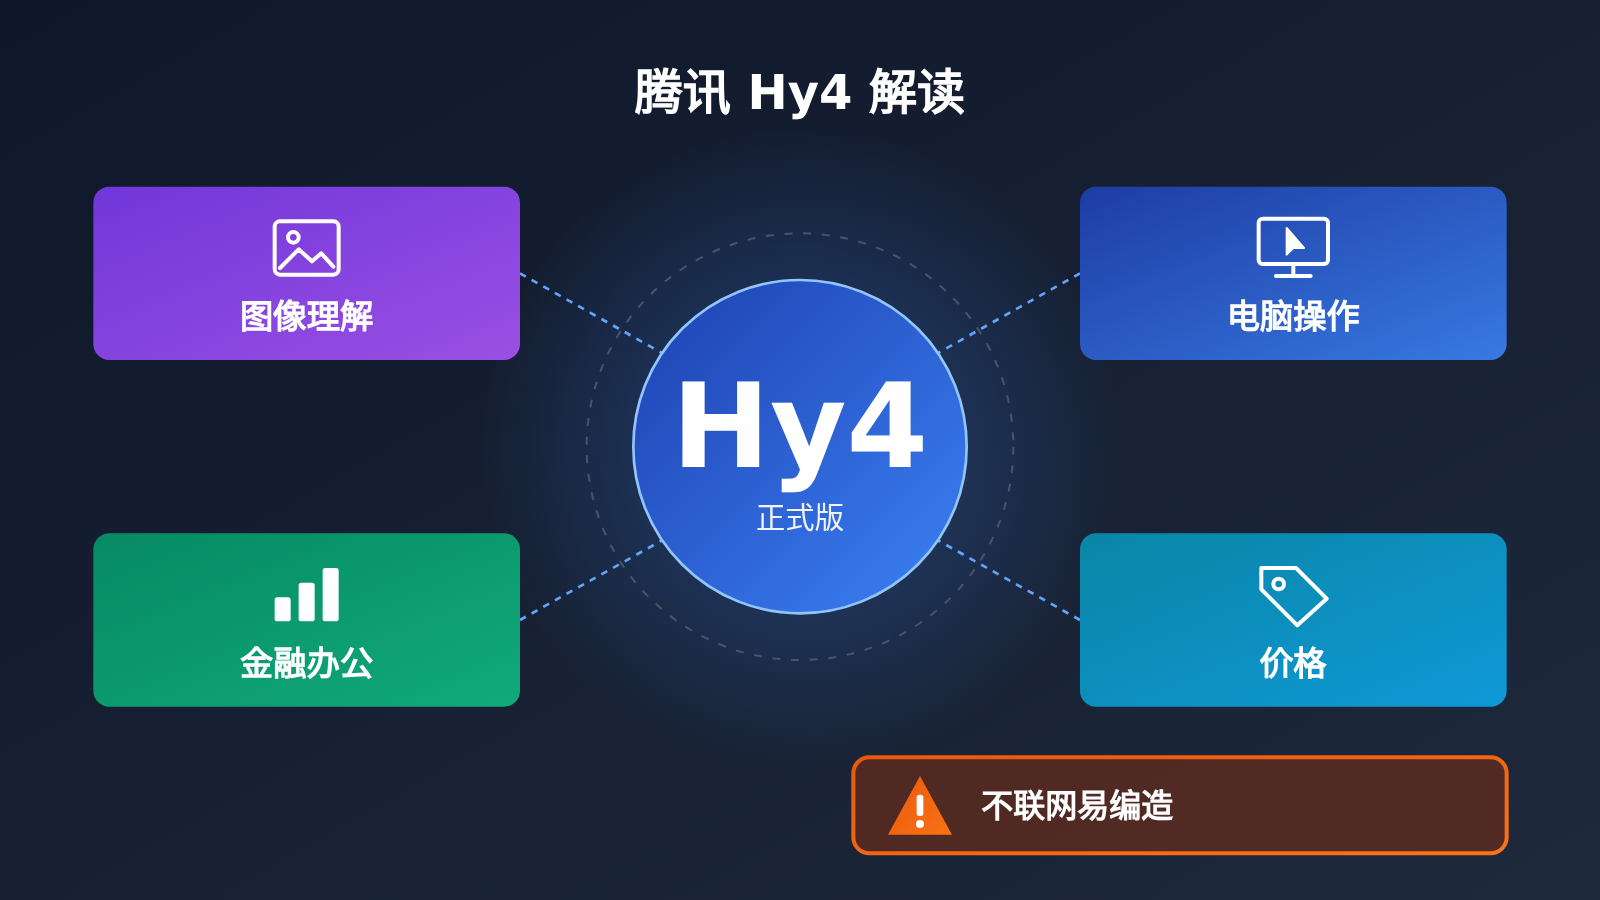
先把已经确认的事实放在一张表里。表中能力描述多数来自腾讯官方,第三方数据会在后文单独标注。
| 信息项 | 详情 |
|---|---|
| 发布方 | 腾讯 |
| 发布节奏 | 预览版发布约两个月后推出正式版 |
| 当前获取方式 | 腾讯云、OpenRouter,以及元宝等腾讯自家应用 |
| 模型权重 | 计划开放,具体日期未公布,安全报告将随权重一起发布 |
| 核心新能力 | 首次支持图像理解,首次支持自主操作电脑软件 |
| 重点优化方向 | 编程、金融、办公 |
| 定价 | 每百万输入 Token 约 0.83 美元,每百万输出 Token 约 2.50 美元,与预览版相同 |
| 后续计划 | 推出更快、更便宜的 Hy4 flash 版本,时间和价格未定 |
腾讯 Hy4 的发布背景
腾讯上一代 Hy3 拥有 2950 亿参数,按 Apache 2.0 许可证开放。此后几个月里,智谱发布了 GLM-5.3,DeepSeek 发布了 V4.1-Flash-1017,月之暗面推出了 Kimi K3.1 Pro,国产模型之间的竞争相当激烈。Hy4 的定位,就是在这一轮竞争中把腾讯重新拉回第一梯队。
另一个值得注意的背景是评测口径的变化。Artificial Analysis 在 10 月下旬改版了综合指数,现在有 60% 基于不公开的私有测试集。按新口径计算,开放模型与顶尖模型的差距从 3 分扩大到了 12 分。因此 Hy4 的分数不宜和改版前的旧榜单直接比较。
腾讯 Hy4 多模态与电脑操作能力解读
图像理解和电脑操作是 Hy4 这一代最大的两项变化。前者让模型能看图,后者让模型能动手,两者结合之后才可能胜任真实的办公和开发流程。
Hy4 图像理解:靠代码裁图找细节
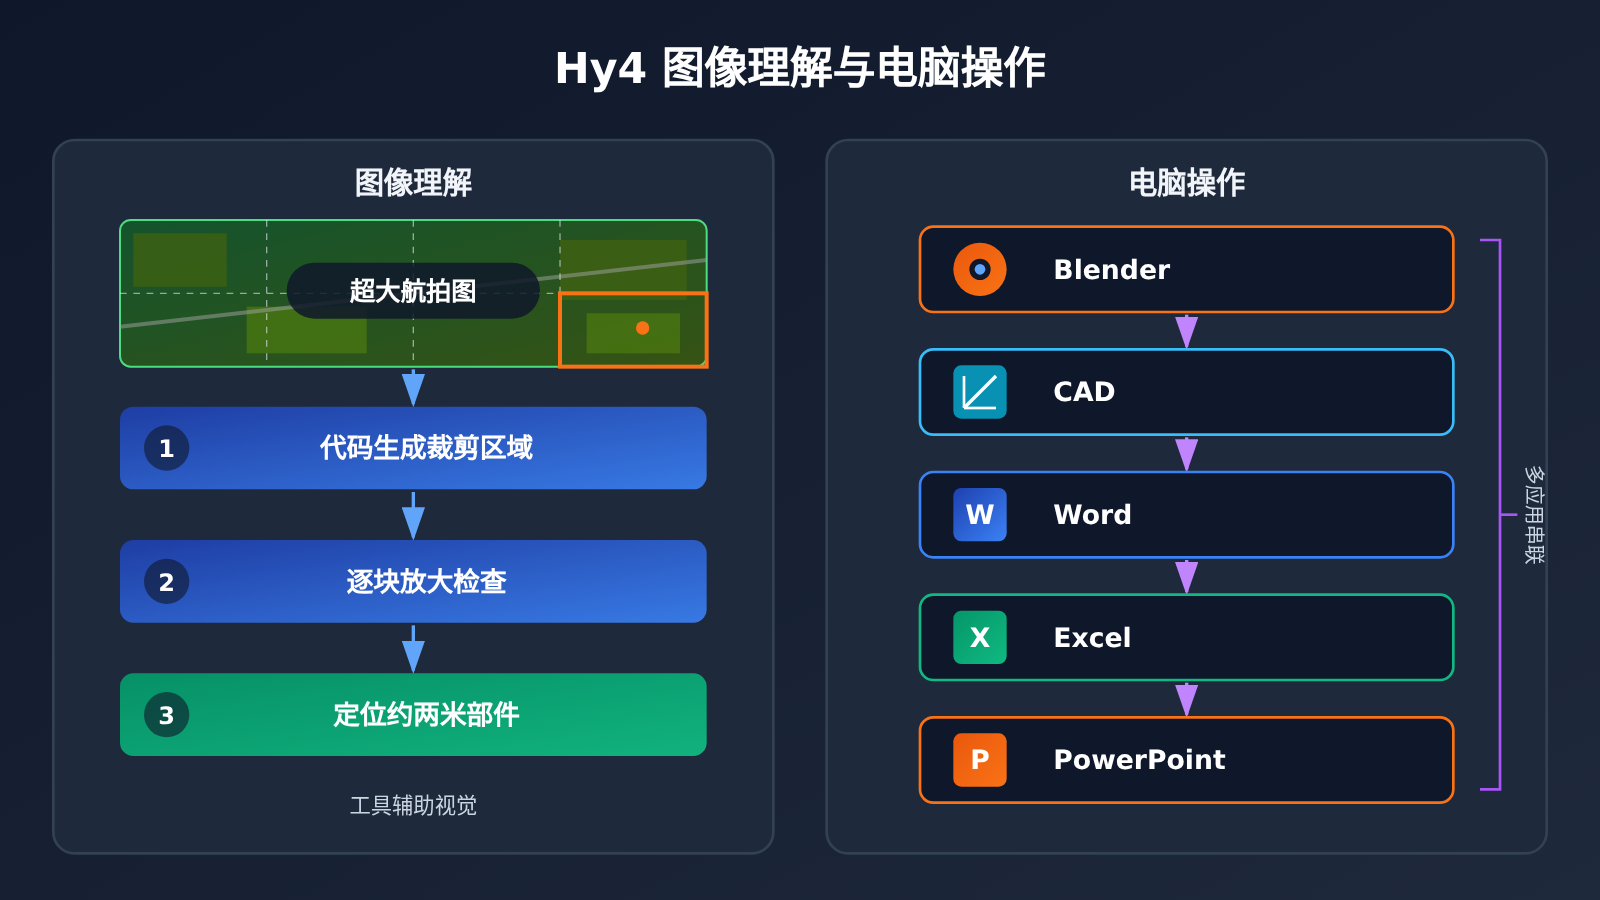
腾讯的演示里,Hy4 要在一张 28 亿像素的航拍图中,找出某个仓库屋顶上一个约两米大小的部件。它的做法是用代码生成裁剪区域,一块一块放大检查,而不是一次性”看完”整张图。这种”工具辅助看图”的思路,对处理超大尺寸图纸、遥感图像和复杂图表比较有参考价值。
腾讯还说图像理解能帮到编程,比如根据设计图搭建网站和游戏。在游戏开发上,腾讯与自家游戏工作室合作,针对 Unreal、Unity 和 Godot 等主流引擎做了适配。据《王者荣耀》开发团队反馈,Hy4 处理配置类任务几乎没有差错,定位 Bug 根因的成功率也比以前高得多。不过这属于腾讯内部团队的反馈,没有公开的测试方法。
Hy4 电脑操作:面向专业软件和多应用串联
Hy4 首次具备自主操作电脑的能力,可以直接控制软件完成任务。腾讯专门用 Blender、CAD 等专业工具做了训练,也覆盖了需要依次使用多个应用的任务。在办公场景,Hy4 可以和人实时协作处理 Word、Excel 和 PowerPoint 文件。
这里有一个重要的参照。同一天,分析机构 SemiAnalysis 发布了 GDPx 基准,让 AI Agent 在模拟的真实工作环境里操作 Siemens NX 等专业软件,单个任务最长持续 8 小时。结果没有任何模型得分超过 12%,排名第一的 Claude Opus 5.5 也只有 12%。Hy4 没有出现在这份榜单里,但这个结果提醒我们:电脑操作能力在整个行业里都还很初级,”能操作软件”和”能独立完成专业工作”之间仍有很大差距。
Hy4 参与训练自己的”后代”
腾讯还展示了一个比较特别的方向:用 Hy4 改进 AI 开发本身。在七个领域的内部研究任务测试中,腾讯称 Hy4 在开放模型中排名第一。Hy4 搭配 Agent 系统 Hyra 2.0,在六个步骤中把腾讯内部训练基础设施的吞吐量提升了约 20%。
之后,Hy4 又自主训练了美国初创公司 TypeSafe AI 的决策模型 Jev 的一个版本,这个 Hyra-Jev 变体在 8 项基准中的 6 项超过了原版 Jev。腾讯还会把用这种方式产出的两个生物学和物理学专用模型作为开放模型发布。这些都是腾讯自测,但能看出它的长期意图:让 Hy4 成为内部 AI 研发的加速器。
腾讯 Hy4 三方评测对照:厂商、合作方与独立机构
这一节是全文重点。同一个模型,三方给出的画像差异明显,选型时一定要先分清说话的人是谁。
| 信息来源 | 核心结论 | 性质 | 可信度提示 |
|---|---|---|---|
| 腾讯官方 | 200 多位金融从业者评估近 600 个真实任务,Hy4 排在 DeepSeek V4.1 Flash、Kimi K3.1 Pro、GLM-5.3 Flash 之前 | 厂商自测 | 测试方法细节未公开 |
| 腾讯官方 | 改版搜索功能后,联网检索时幻觉率从近 16% 降到约 5% | 厂商内部测试 | 仅限联网检索场景 |
| 腾讯官方 | 在自家 12 项基准中,Claude Opus 5.5 全部领先 Hy4,GPT 6.1 Sol 有 8 项领先 | 厂商自测 | 腾讯自己承认差距,参考价值较高 |
| 合作方 Comein | Hy4 是唯一与 Claude Opus 5.5 并列第二的国产模型,数据查询上明显领先 GPT-6.1 Sol | 合作方自测 | 只针对其金融数据查询场景 |
| 合作方 Manus | Hy4 几乎能成功完成全部文档类任务 | 合作方自测 | 任务难度与范围未公开 |
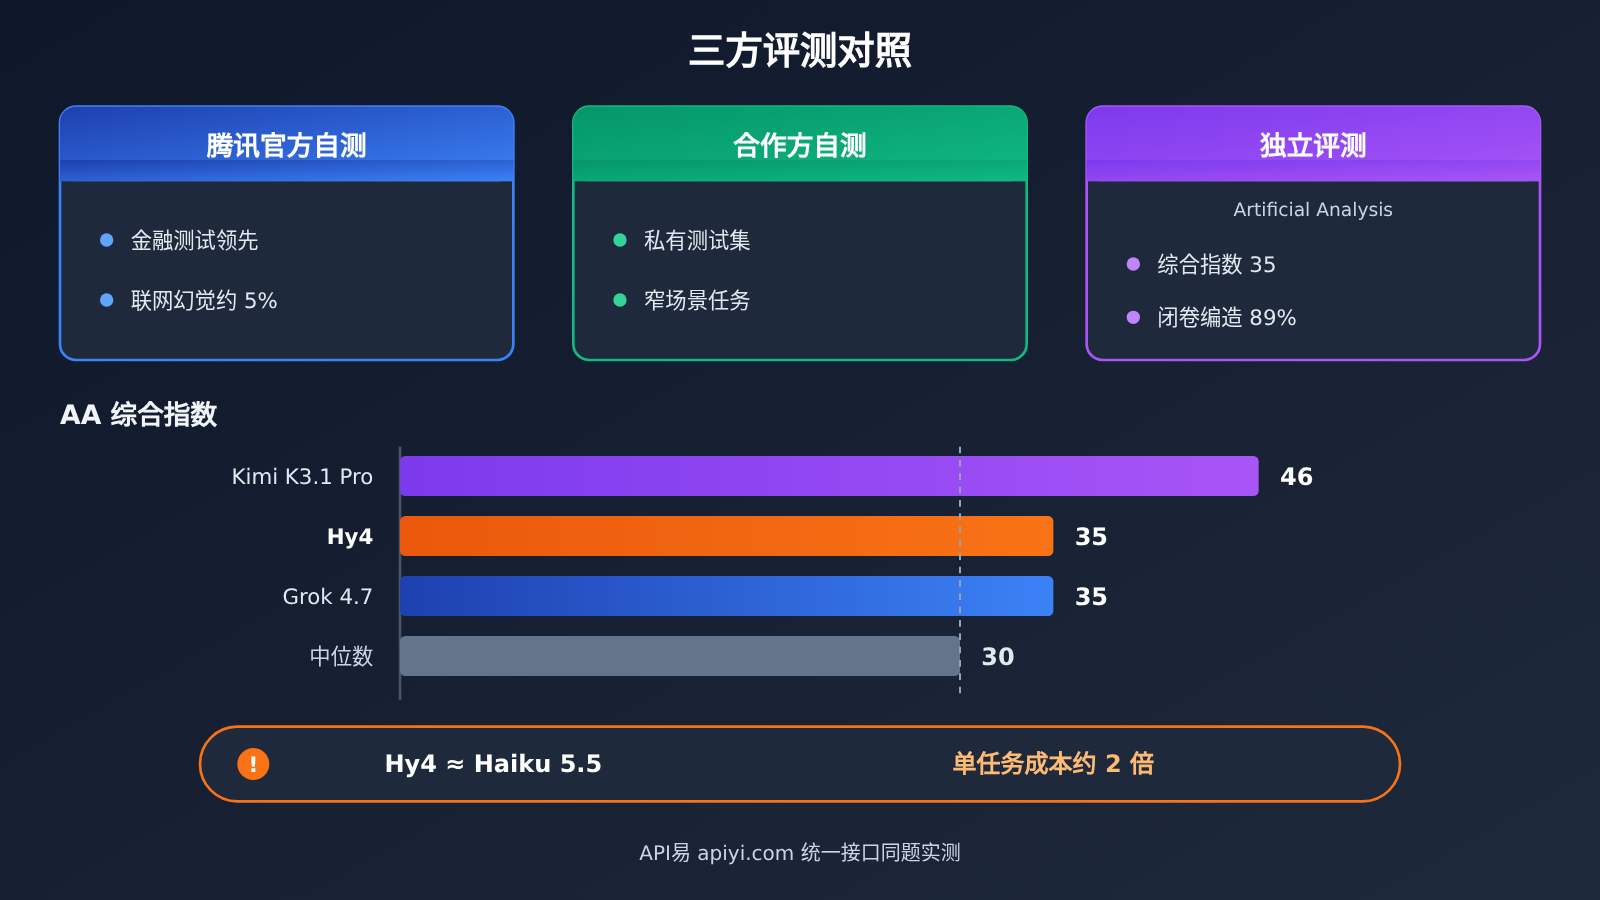
| Artificial Analysis | 综合指数 35 分,高于 30 分中位数,与 Grok 4.7 持平,国产模型第二,落后 Kimi K3.1 Pro 的 46 分 | 第三方独立评测 | 60% 为私有测试集,较难被针对性优化 |
| Artificial Analysis | 不联网时约一半事实题能答对,不知道答案时有 89% 的情况会编造 | 第三方独立评测 | 闭卷知识准确性测试 |
腾讯 Hy4 自测与独立评测的关键分歧
最明显的分歧出在 Hy4 和 Kimi K3.1 Pro 的比较上。腾讯的金融测试里 Hy4 排在 Kimi 之前,但在 Artificial Analysis 的综合指数上,Hy4 落后 Kimi 达 11 分。两者并不一定矛盾:金融测试是窄场景,综合指数覆盖知识工作、编程、科学和常识等多个维度。可以理解为 Hy4 在腾讯重点打磨的金融场景里有优势,但整体能力并不领先。
性价比上也有一个需要注意的点。Artificial Analysis 的数据显示,Hy4 的综合得分与 Anthropic 最小的 Haiku 5.5 大致持平,而 Haiku 5.5 在该基准上的单任务成本几乎只有 Hy4 的一半。也就是说,单看 Token 单价不能得出”Hy4 更便宜”的结论,还要算上完成任务实际消耗的 Token 量。
腾讯 Hy4 高难任务的能力短板
腾讯自己坦承,Hy4 在高等数学、较长的编程项目和复杂图像分析上,仍明显落后于最好的商用模型。差距最大的是 Hy-FrontierMath T5,数据如下。
| 基准 / 维度 | Hy4 | GPT 6.1 Sol | Claude Opus 5.5 | 来源 |
|---|---|---|---|---|
| Hy-FrontierMath T5 | 13.0 | 97.5 | 91.3 | 腾讯官方 |
| 腾讯 12 项自家基准 | 全部落后 Opus 5.5 | 8 项领先 Hy4 | 12 项全部领先 | 腾讯官方 |
| AA 综合指数 | 35 | 未在资料中给出 | 未在资料中给出 | Artificial Analysis |
| 不联网事实准确性 | 约一半答对,不知道时 89% 编造 | 未在资料中给出 | 未在资料中给出 | Artificial Analysis |
13.0 对 90 以上,这已经不是”稍弱一些”,而是完全不在一个档次。如果你的业务涉及竞赛级数学推理、长周期工程代码或高精度图像分析,Hy4 目前不适合作为主力模型。
腾讯 Hy4 影响分析:对开发者和产品团队意味着什么
对开发者的影响:联网与不联网是两个模型
“联网幻觉率约 5%”和”不联网时 89% 编造”这两个数字放在一起看,结论很清楚:Hy4 的事实可靠性高度依赖外部检索。腾讯的 5% 是联网检索场景的内部测试,而 89% 是 Artificial Analysis 在闭卷条件下测出的编造倾向。在产品里接入 Hy4 时,基本可以把它当作”必须配检索的模型”来设计。
具体落地时,可以参考下面几条做法:
- 事实类问题一律走检索:先用搜索或 RAG 召回资料,再让模型基于资料回答,不要让它凭记忆作答。
- 在提示词里明确”允许说不知道”:要求资料中没有的内容直接回答”资料未提及”,降低编造概率。
- 要求标注出处:让模型说明每条结论来自哪段资料,便于人工抽查。
- 关键数值二次校验:金融、报表类输出中的数字,用程序或规则再核对一遍。正如 GDPx 评测指出的,表格里一个错误数值就可能让整份输出失去价值。
下面是一个”检索增强 + 允许拒答”的极简调用示例。模型名请替换为你实际可用的模型,Hy4 在各平台的具体模型 ID 以平台控制台为准。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "(这里放检索召回的资料片段)"
resp = client.chat.completions.create(
    model="your-model-name",
    messages=[
        {"role": "system", "content": "只依据给定资料回答;资料没有的内容回答“资料未提及”,并标注出处段落。"},
        {"role": "user", "content": f"资料:{context}\n\n问题:该公司三季度营收是多少?"}
    ],
    temperature=0
)
print(resp.choices[0].message.content)
查看完整实现:多模型同题对比 + 拒答率统计
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "只依据给定资料回答问题。"
    "如果资料中没有答案,必须只回答:资料未提及。"
    "回答时注明依据的资料段落编号。"
)

def ask(model: str, context: str, question: str) -> str:
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": f"资料:\n{context}\n\n问题:{question}"}
            ],
            temperature=0,
            max_tokens=500
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

def evaluate(models: List[str], cases: List[Dict]) -> None:
    """cases 中 answerable=False 的题目,资料里故意不含答案,用来测试编造倾向"""
    for m in models:
        refused, fabricated = 0, 0
        for c in cases:
            out = ask(m, c["context"], c["question"])
            if not c["answerable"]:
                if "资料未提及" in out:
                    refused += 1
                else:
                    fabricated += 1
        print(f"{m}: 正确拒答 {refused},疑似编造 {fabricated}")

cases = [
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "三季度营收是多少?", "answerable": False},
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "二季度营收是多少?", "answerable": True},
]

# 将列表替换为你要对比的模型 ID
evaluate(["model-a", "model-b"], cases)
🎯 选型建议:评估 Hy4 这类新模型时,最可靠的办法是用自己的业务样本做同题对比,而不是只看榜单。API易 apiyi.com 提供 OpenAI 兼容的统一接口,一个 API Key 即可调用 Claude、GPT、Gemini 以及多家国产模型,便于把候选模型放在同一套测试集上跑一遍。Hy4 是否已在平台上线,请以控制台模型列表为准。
对产品负责人的影响:Hy4 适合与不适合的任务
结合三方信息,可以把 Hy4 的任务适配度大致整理如下。
| 任务类型 | 适配度 | 依据 | 使用建议 |
|---|---|---|---|
| 金融数据查询、研报整理 | 较适合 | 腾讯金融测试与 Comein 反馈,均为自测 | 必须配检索,关键数值程序校验 |
| Word、Excel、PPT 文档处理 | 较适合 | 腾讯实时协作能力,Manus 反馈文档任务完成率高 | 先从低风险文档任务试点 |
| 游戏引擎配置、Bug 定位 | 可以尝试 | 腾讯内部游戏团队反馈 | 适合配置类和排错类,不宜承担长项目 |
| 网页、小游戏原型搭建 | 可以尝试 | 图像理解辅助编程 | 作为原型工具,生产代码需人工审阅 |
| 联网检索问答 | 可以尝试 | 联网幻觉率内部测试约 5% | 开启检索并要求标注出处 |
| 不联网的知识问答 | 不建议 | 不知道时 89% 编造 | 避免让模型凭记忆回答事实问题 |
| 高等数学、竞赛推理 | 不建议 | Hy-FrontierMath T5 仅 13.0 分 | 选用顶级商用模型 |
| 长周期编程项目、复杂图像分析 | 不建议 | 腾讯官方承认明显落后 | 选用更强模型或拆分任务 |
对行业的影响:开放权重与监管同步收紧
Hy4 计划开放权重,这意味着企业未来可能获得私有化部署的选项。不过权重开放日期、许可证都还未公布,暂时不宜把它写进需要确定交付时间的方案里。
政策层面也有变化。中国商务部和科技部在 10 月发布了出口管制框架草案,覆盖全球排名前十或参数超过两万亿的模型权重,但对开源发布设有自动批准的快速通道。安全方面,腾讯称训练时有意过滤了黑客相关材料,自家安全实验室未发现滥用风险升高,生物危害也远低于其风险阈值,详细安全报告会随权重一起发布。
腾讯 Hy4 常见问题 FAQ
Q1:腾讯 Hy4 是什么?
Hy4 是腾讯在预览版之后推出的正式版大语言模型,首次支持图像理解和自主操作电脑软件,重点针对编程、金融和办公场景优化。目前可通过腾讯云、OpenRouter 和元宝等应用使用,权重将在之后开放。
Q2:Hy4 和 Kimi K3.1 Pro、Claude Opus 5.5 相比怎么样?
腾讯的金融自测中 Hy4 排在 Kimi K3.1 Pro 之前,但 Artificial Analysis 独立评测里 Hy4 得 35 分,落后 Kimi 的 46 分。和 Claude Opus 5.5 相比,腾讯自家 12 项基准全部落后。如果想在自己的场景里直接对比,可以通过 API易 apiyi.com 用统一接口调用多个模型做同题测试。
Q3:Hy4 的权重和 Hy4 flash 什么时候发布?
截至 2026 年 11 月 6 日,腾讯尚未公布权重开放的具体日期和许可证,只说明安全报告会随权重同步发布。更快、更便宜的 Hy4 flash 也只确认在计划中,发布时间和价格都未公开,后续需要持续关注官方信息。
Q4:Hy4 的价格贵不贵?
Hy4 每百万输入 Token 约 0.83 美元,每百万输出 Token 约 2.50 美元,与预览版相同。但 Artificial Analysis 的数据显示,与它得分相近的 Haiku 5.5 单任务成本几乎只有其一半,所以要结合实际任务消耗来算总成本。
Q5:如何降低 Hy4 编造事实的风险?
核心是不要让它凭记忆回答事实问题:开启联网检索或接入 RAG,在提示词中允许它回答”资料未提及”,并要求标注出处。上文的对比脚本可以帮你统计不同模型的拒答和编造情况,配合 API易 apiyi.com 的新用户免费测试额度,能低成本先做一轮验证。
Q6:Hy4 有哪些已知的限制?
主要有三点:一是高难任务差距大,Hy-FrontierMath T5 仅 13.0 分;二是不联网时知识可靠性差,不知道答案时 89% 会编造;三是多项正面结论来自腾讯或合作方自测,方法细节未公开,需要用自己的数据复核。
腾讯 Hy4 核心要点 Key Takeaways
- 两项首次:Hy4 首次支持图像理解和自主操作电脑,覆盖 Blender、CAD 和 Office 文档。
- 定价未涨:每百万输入约 0.83 美元、输出约 2.50 美元,与预览版一致。
- 独立评测居中上:AA 综合指数 35 分,国产模型第二,明显落后 Kimi K3.1 Pro。
- 必须配检索:联网幻觉率约 5%,不联网时不知道答案有 89% 会编造。
- 高难任务落后:高等数学、长编程项目、复杂图像分析与顶级商用模型差距明显。
- 自测要复核:金融排名和合作方结论多为自测,上线前应用自家样本验证。
- 对比更稳妥:可借助 API易 apiyi.com 的统一接口,把 Hy4 的替代或对照模型放在同一测试集里比较。
总结
腾讯 Hy4 的核心要点:
- 能力有明显进步:图像理解和电脑操作是这一代最大的新增能力,在金融和办公场景做了重点打磨。
- 三方说法要分开看:厂商和合作方的自测偏乐观,Artificial Analysis 的独立评测把它放在国产第二、与 Haiku 5.5 相近的位置。
- 短板很具体:不联网易编造、高难数学和长编程项目明显落后,这些都直接影响选型。
如果你在做金融数据查询、文档处理或游戏配置这类任务,Hy4 值得配合检索做一轮试点;如果场景依赖闭卷知识或高难推理,现阶段更适合选择更强的模型。建议先通过 API易 apiyi.com 用统一接口对候选模型做同题实测,再结合成本和准确率做决定。
📚 参考资料
- THE DECODER – Tencent releases Hy4 with vision and computer use:Hy4 发布报道
- 链接:
the-decoder.com/tencent-releases-hy4-with-vision-and-computer-use-claims-second-place-among-chinese-ai-models -
说明:包含腾讯官方数据、合作方反馈和 Artificial Analysis 独立评测结果
-
THE DECODER – SemiAnalysis GDPx 基准报道:AI Agent 真实工作场景评测
- 链接:
the-decoder.com/no-ai-agent-scores-above-12-percent-on-semianalysis-new-real-world-work-benchmark -
说明:了解电脑操作类 Agent 在专业软件中的整体水平
-
Artificial Analysis:独立模型评测机构
- 链接:
artificialanalysis.ai - 说明:可查看 Intelligence Index 和 AA-Omniscience 等评测的最新数据
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心


