
直接回答:Claude Citations 能讓模型的回答指向你提供的文檔中的具體片段和位置。 純文本按字符範圍定位,PDF 按頁定位,自定義內容按塊定位。要讓引用真正可以複覈,關鍵在應用側:把每個結論的字段值、對應的引用對象和限定條件一起保存。在轉換成結構化數據的過程中,引用不能丟失。
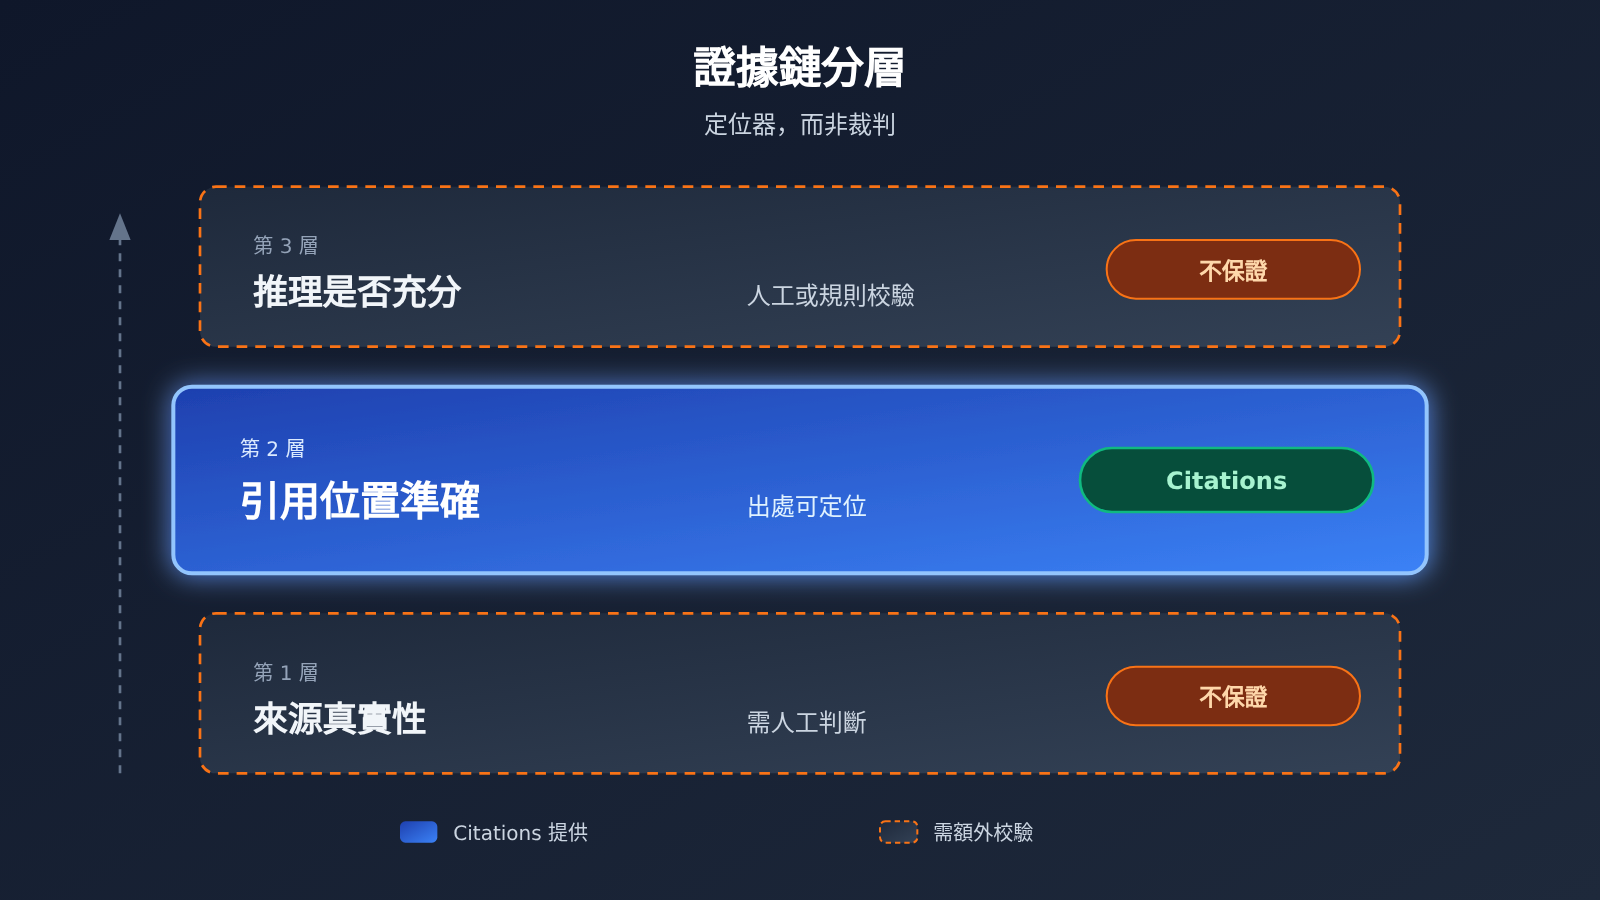
需要說明的是,引用位置正確只代表“這句話在文檔裏能找到”,並不代表來源本身真實,也不代表推理充分。Citations 是讓人複覈的工具,不能替代複覈。
您讀完此文能瞭解到什麼?
- Claude Citations 對哪些輸入有效,以及三種定位方式分別是什麼。
- 爲什麼開啓引用後不能同時使用嚴格結構化輸出
output_config.format,以及官方建議的替代做法。 - 掃描 PDF 和圖片在引用能力上的限制,以及應用側可以採取的補救方式。
- 如何設計“字段值+引用+限定條件”的數據結構,讓價格、上下文長度、地區等信息經得起覈對。
索引: 正文前導部分先用一張概念表解釋相關術語,再說明這項能力對不同人羣的影響。“客觀事實”部分依據官方文檔整理定位方式、兼容性衝突和輸入限制。“分析判斷”部分討論如何把引用落成可複覈的證據,以及哪些說法不能對外宣稱。
Claude Citations 需要先知道的概念
| 概念 | 簡要解釋 |
|---|---|
| Citations(引用) | Claude API 的一項能力,在回答中返回來自用戶所提供文檔的引用片段及其位置 |
| 字符範圍定位 | 純文本文檔的引用方式,以字符起止位置標出被引用的原文 |
| 頁碼定位 | PDF 文檔的引用方式,以頁爲單位標出出處 |
| 內容塊定位 | 自定義內容的引用方式,以開發者自行劃分的塊爲單位 |
| 嚴格結構化輸出 | 通過 output_config.format 約束模型按指定格式輸出,與引用功能不能同時啓用 |
| 可提取文本 | PDF 中能被直接讀取的文字層,掃描件往往沒有這一層 |
| OCR | 光學字符識別,把圖片中的文字轉成文本,屬於應用側處理,不是 Claude 的引用能力 |
| 限定條件 | 讓一個數值成立的前提,例如計費單位、模型版本、適用地區 |
Claude Citations 影響速覽
| 人羣 | 影響 |
|---|---|
| 開發者 | 可以爲問答、檢索增強和資料抽取類應用加上可定位的出處;但需要在結構化輸出和引用之間做取捨,並自行設計解析邏輯 |
| 內容與研究人員 | 覈對時能直接跳到原文片段或頁碼,減少逐頁翻找;但仍需自己判斷來源是否可信、結論是否成立 |
| 產品與運營 | 適合做“價格、規格、政策”這類必須給出出處的信息展示;掃描件資料需要先完成文字化和核驗 |
| 普通用戶 | 看到帶出處的回答更便於自查,但不應把“有引用”理解爲“一定正確” |
Claude Citations 客觀事實
以下事實依據 Claude 官方文檔整理(來源:platform.claude.com/docs/en/build-with-claude/citations),覈查日期爲 2026-11-17。該頁面屬於持續維護的文檔,本文未能覈實這項功能最早的發佈日期,因此不給出首發時間。
Claude Citations 的三種定位方式
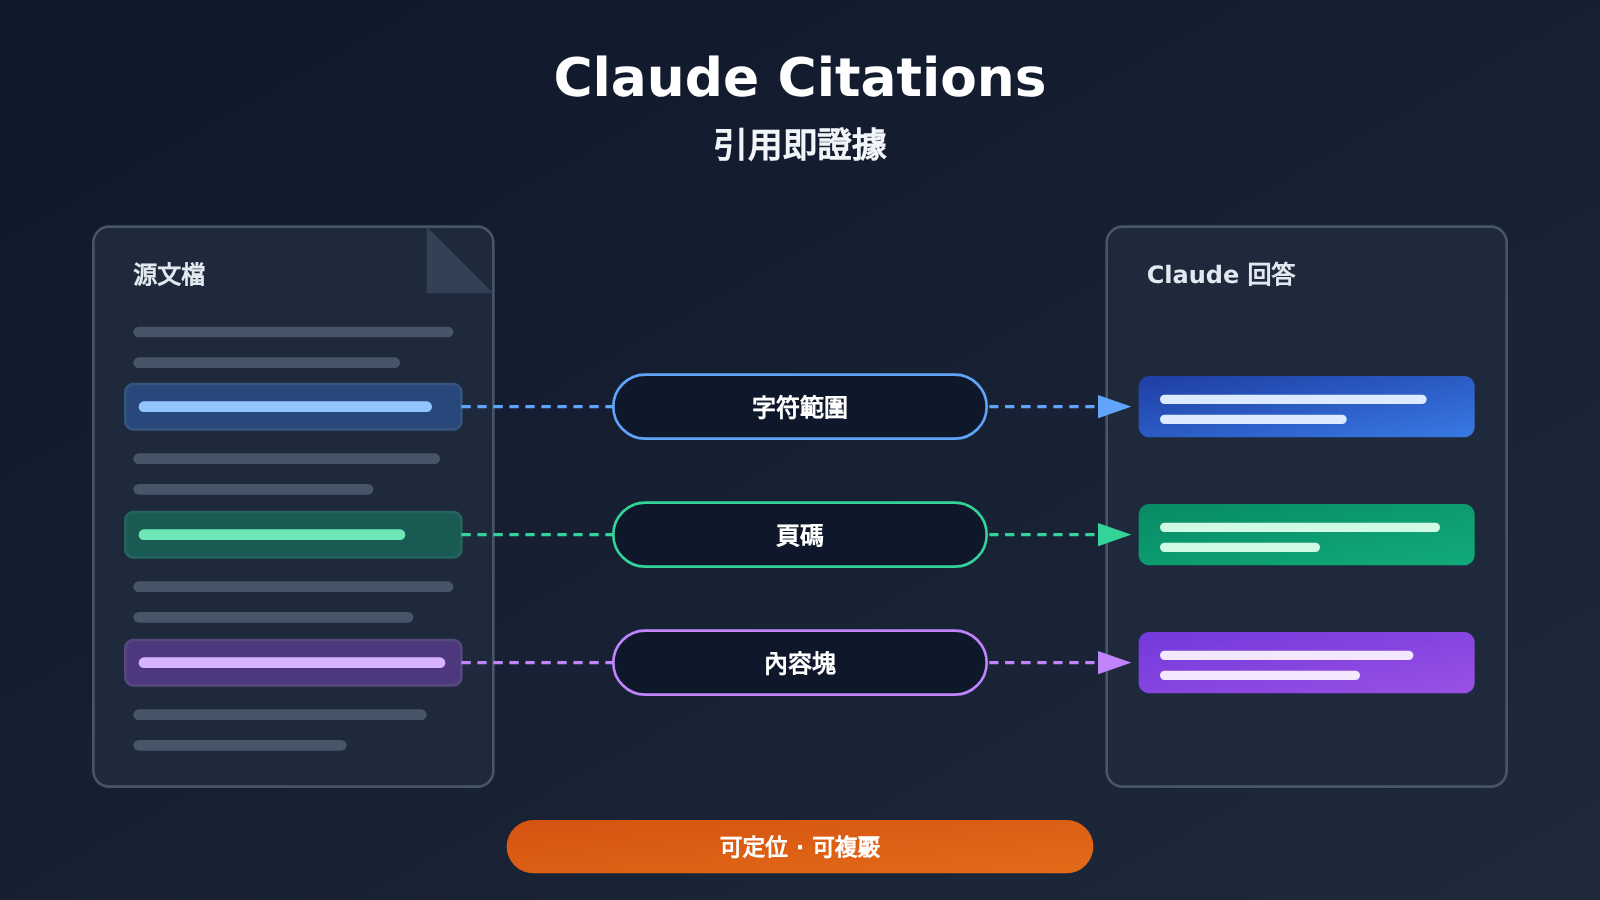
Citations 針對的是用戶自己提供的文檔。模型回答時,會返回被引用的原文片段以及它在文檔中的位置。定位粒度取決於文檔類型:
| 文檔類型 | 定位方式 | 複覈時怎麼用 |
|---|---|---|
| 純文本 | 字符範圍 | 按起止位置截取原文,可以逐字比對 |
| 頁碼 | 跳到對應頁人工查看,需要在頁內自行找到具體位置 | |
| 自定義內容 | 內容塊 | 按開發者劃分的塊回查,粒度由切分方式決定 |
可以看出,三種方式的精度並不一樣。字符範圍最細,適合程序化校驗;頁碼定位需要人工在頁內查找;內容塊的精度完全取決於開發者如何切分。如果塊切得太大,引用雖然“正確”,複覈成本卻會明顯上升。
Claude Citations 與嚴格結構化輸出不兼容
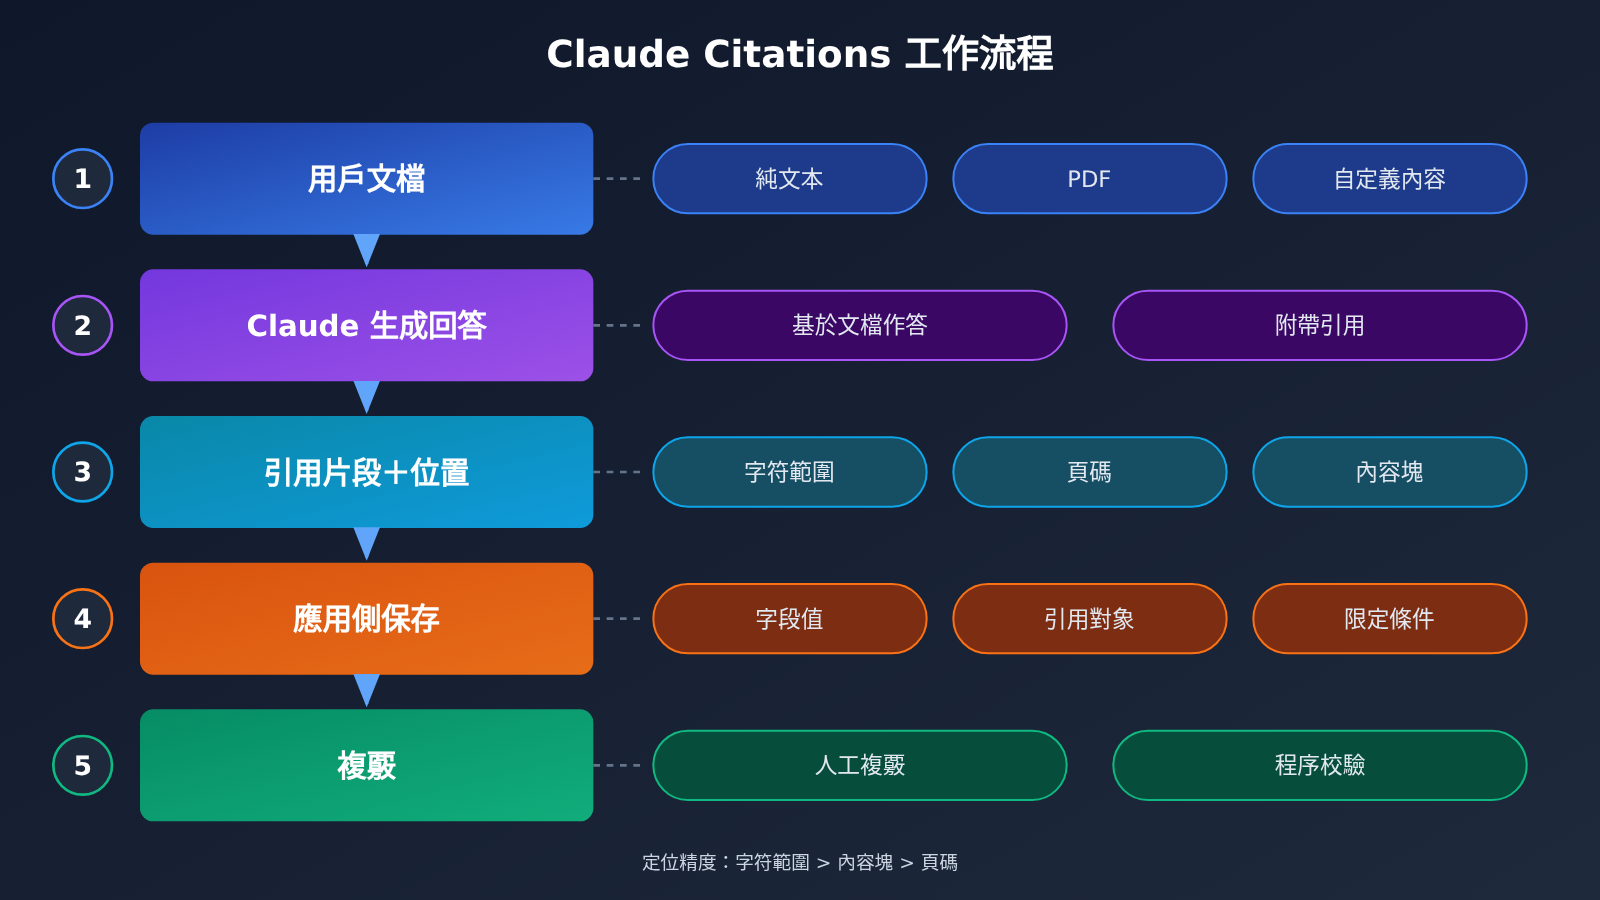
這是落地時最容易踩的坑。官方文檔寫明:啓用引用後,不能同時使用嚴格結構化輸出 output_config.format,兩者同時開啓時請求會返回 400 錯誤。
官方給出的替代思路是:讓模型逐字段、逐行作答並附上引用,再由程序解析成需要的結構。還有一種看起來可行的做法,是隻在提示詞裏要求模型輸出 JSON。這樣有時確實能得到 JSON,但引用可能變少,甚至完全沒有。兩種做法要分清楚:
- 嚴格結構化輸出:格式有保證,但不能與引用同時啓用。
- 僅靠提示詞要求 JSON:格式不能保證,引用也可能缺失,不適合做證據鏈。
- 逐字段逐行回答+引用,再程序解析:官方建議的方式,格式由應用側負責,引用得以保留。
Claude Citations 的輸入限制
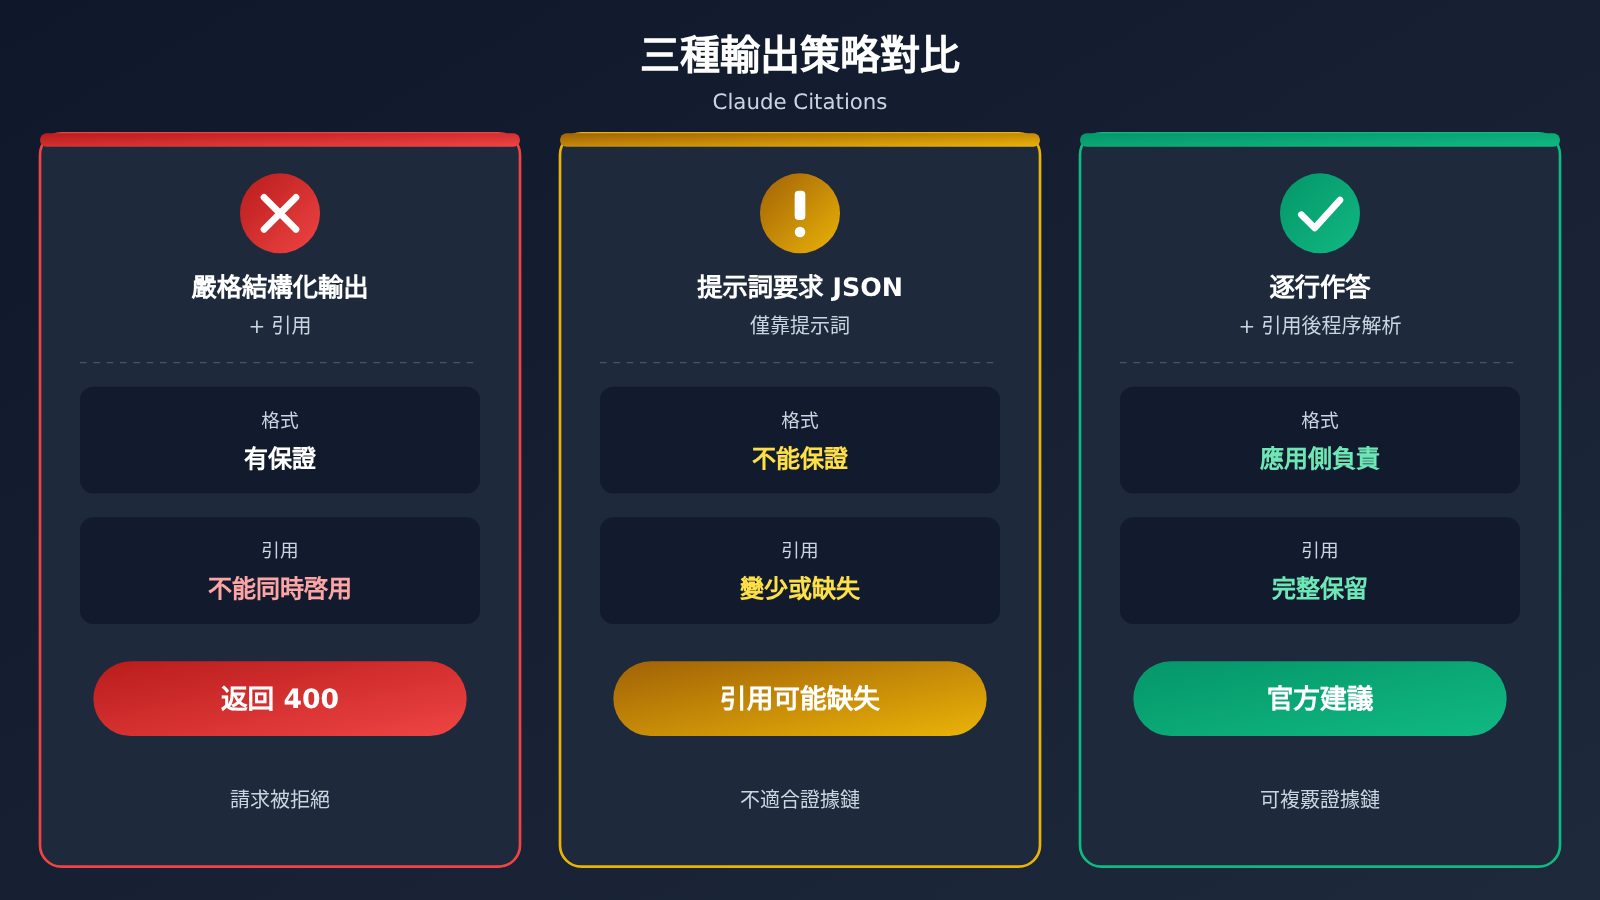
| 輸入情況 | 能否直接引用 | 說明 |
|---|---|---|
| 帶文字層的 PDF | 可以 | 按頁定位 |
| 沒有可提取文本的掃描 PDF | 不能直接引用 | 缺少文字層,無法定位文本 |
| 圖片 | 不支持 | 引用能力不覆蓋圖片內容 |
| 經 OCR 轉出的文本 | 取決於應用側處理 | OCR 是應用側的建議做法,不是圖片引用能力 |
這裏要準確理解“不能直接引用”。它說的是掃描 PDF 在缺少可提取文本時不能被直接引用,並不意味着所有掃描資料永遠無法處理。開發者可以先在應用側取得文字,再把文本作爲文檔交給模型。
關於效果提升的說法
廠商對引用功能給出過約 20% 提升的表述。這個數字只能歸因於廠商自己的聲明,本文沒有獨立驗證。本文也沒有進行任何性能測試,因此不提供量化收益結論。
Claude Citations 分析判斷
以下是基於上述事實的解讀與建議,屬於作者判斷,不是官方結論。
把 Claude Citations 落成“字段值+引用+限定條件”
引用真正的價值,在於讓每個結論都能被追溯和核對。如果最終入庫的只有一個數值,比如“128K”或“3 美元”,引用就在數據轉換中丟失了,事後沒人能確認它來自哪裏、在什麼條件下成立。
比較穩妥的做法,是爲每個事實型字段保存三部分:字段值、引用對象、限定條件。下面是一個應用側的數據結構示例。字段命名由開發者自行決定,不是 Claude API 的返回格式:
{
  "field": "input_price",
  "value": "3",
  "qualifiers": {
    "unit": "USD per million input tokens",
    "model_version": "<文檔中標註的版本>",
    "region": "<適用地區,如文檔未提及則爲 null>"
  },
  "citation": {
    "doc_id": "pricing-2026-11",
    "location_type": "page",
    "location": "<模型返回的頁碼或字符範圍>",
    "quoted_text": "<模型返回的原文片段>"
  },
  "verified": false
}
示例中的價格數值只用來演示結構,不代表任何真實價格。設計時有幾個要點:
- 價格必須保留計費單位:同一個數字,按每千 token 和按每百萬 token 計費,含義相差千倍。
- 能力必須保留版本:上下文長度、功能支持情況會隨模型版本變化,脫離版本的數字很快就會失效。
- 地區類信息要寫明適用範圍:文檔沒有提到時記爲空,不要自行推斷補全。
- 保留原文片段:複覈時可以直接比對,不必重新調用模型。
用逐行作答代替嚴格結構化輸出
既然引用與 output_config.format 不能同時啓用,工程上就需要接受“格式由自己負責”。可行的流程如下:
- 在提示詞中把要抽取的字段逐一列出,要求模型每行只回答一個字段,併爲該行附上引用。
- 應用側按行解析,把每行的回答文本與它攜帶的引用對象一一對應。
- 用固定規則把文本轉換成目標結構,同時把引用原樣寫入
citation字段。 - 對沒有引用的行打上標記,進入人工複覈或直接丟棄,不作爲已確認事實入庫。
這樣做比直接拿 JSON 多了一道解析步驟,但換來的是每個字段都有出處。對於價格、合規條款這類出錯代價高的信息,這道工序值得付出。
掃描資料:先取得文字,再做二次覈驗
面對掃描 PDF,應用側可以先用 OCR 取得文字,再交給模型引用。但 OCR 本身也會引入誤差,至少需要覈驗以下幾項:
- 數字與單位:小數點、千分位、貨幣符號最容易識別錯,而它們恰恰是價格類信息的核心。
- 表格結構:行列錯位會讓數值對應到錯誤的項目上,引用位置再準確也沒有意義。
- 頁碼映射:OCR 文本中的位置要能映射回原始掃描頁,否則複覈人員找不到出處。
也就是說,在這條鏈路上,引用定位的是 OCR 文本,而不是原始掃描圖像。可信度上限取決於 OCR 的質量。
Claude Citations 不能證明什麼
有了引用,回答的可覈查程度會提高,但對外描述時需要剋制。以下幾種說法缺少依據,不應使用:
- “自動聯網查證”:Citations 針對的是用戶提供的文檔,不涉及聯網檢索。
- “零幻覺”:引用位置正確,不等於模型的概括、推理沒有偏差。
- “來源一定可靠”:如果原文檔本身有誤,引用只會把錯誤準確地指出來。
- “所有掃描 PDF 都無法處理”:限制在於沒有可提取文本時不能直接引用,應用側仍有補救手段。
更準確的定位是:Claude Citations 把“這句話出自哪裏”的舉證成本降低了,而“這句話對不對”仍然需要人或規則來判斷。
後續值得關注的方向
以下內容屬於預測或待觀察事項,並非已經確認的事實:
- 引用與嚴格結構化輸出能否在後續版本中兼容。一旦兼容,前文的逐行解析方案可以大幅簡化。
- 引用能力是否會擴展到圖片或掃描頁的視覺定位。目前文檔明確不支持圖片引用。
- 廠商宣稱的效果提升在不同類型文檔上是否成立,需要第三方或自有業務數據驗證。
在這些問題有明確答案之前,比較穩妥的策略是把 Claude Citations 當作證據鏈中的“定位器”,而不是“裁判”。
盡信書,則不如無書。——《孟子·盡心下》


