
作者注:解讀 Anthropic 工程博客披露的 Claude Dreaming 機制。本文涵蓋 4 層記憶結構、CL-Bench 與 Wiki 實驗數據、糾錯案例和工程風險,並說明開發者如何借鑑“會話間整理記憶”的思路,搭建自己的 Agent 記憶系統。
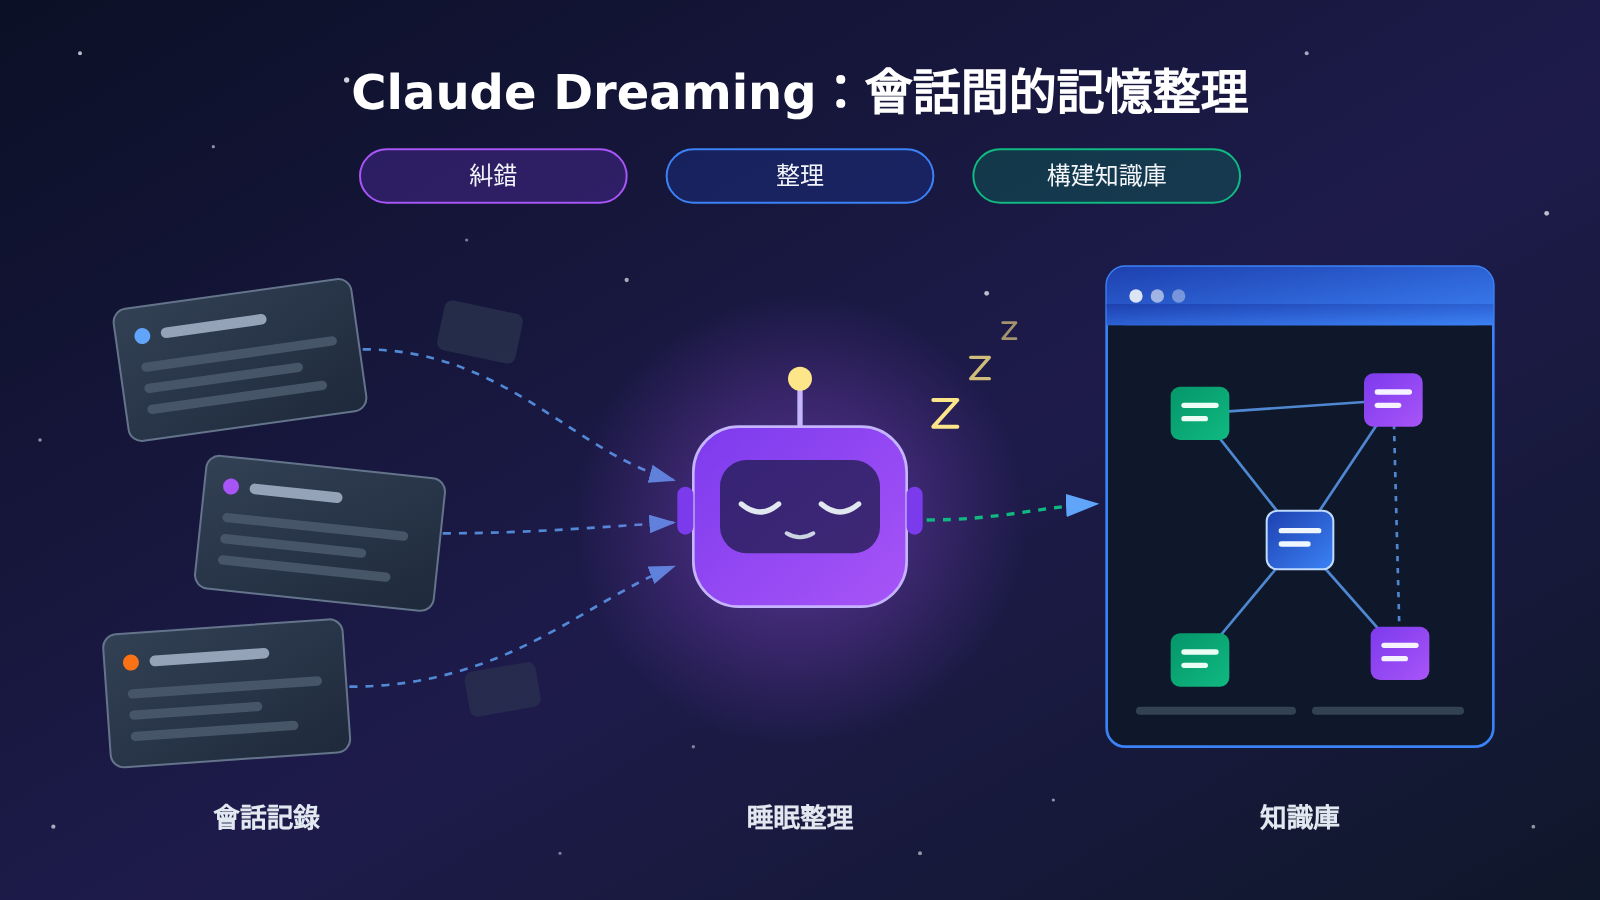
2026 年 11 月 6 日,Anthropic 在工程博客發佈了 The components of agent memory。文章首次系統說明了 Claude Dreaming 如何在會話之間糾錯、整理記憶並構建知識庫。官方 X 賬號同步發佈了這篇文章,Claude Managed Agents 文檔中也已經出現 Dreams 的研究預覽接口。
這不是又一個“給 Agent 加個向量庫”的概念。Anthropic 用多組實驗說明:長期運行的 Agent 光保存歷史還不夠,還要持續驗證、糾錯、整合和組織記憶,舊信息才能真正幫到下一次任務。
核心價值:讀完本文,你會了解 Claude Dreaming 的 4 層記憶結構和關鍵實驗數據。你也會知道它在什麼情況下有效、什麼情況下有害,以及在自己的 Agent 裏該如何借鑑。
Claude Dreaming 核心信息速覽
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026-11-06,Anthropic Engineering 博客 |
| 核心概念 | Dreaming:在會話之間利用歷史記錄重新組織和維護記憶的後臺過程 |
| 記憶分層 | Transcripts、Memory notes、Memory representations、Injected context 共 4 層 |
| 產品形態 | Claude Managed Agents 中的 Dreams,目前爲 Research Preview,需申請訪問 |
| 配套資料 | 官方 Cookbook《Dreaming with a dynamic workflow》,發佈於 2026-11-02 |
| 影響範圍 | 長期運行的 Agent、跨會話任務、企業內部知識庫構建 |
理解 Dreaming 之前,先明確幾個術語。Transcript 是完整會話記錄,包括用戶輸入、Agent 輸出、工具調用和結果。Memory Note 是從歷史經歷中提煉出來的持久事實、規則和經驗。Memory Store 是跨會話保存記憶文件的持久化存儲空間。Dreaming 的思路接近 Sleep-time Compute,也就是在主要交互之外,利用空閒算力處理已有上下文。
爲什麼 Agent 記憶不能只靠存歷史對話
很多團隊做 Agent 記憶的第一反應,是把所有對話存下來,需要時再檢索。問題在於,歷史日誌、會話摘要和可檢索的知識是三種不同的東西。日誌只是原始事件的堆積,摘要可能丟掉關鍵細節,只有經過驗證和組織的知識,才能穩定地幫到下一次任務。
直接保存全部對話,會帶來三類隱患:信息重複,舊狀態過時,錯誤不斷累積。一條寫錯的記錄會被後續會話反覆讀取,錯誤也就被當成事實繼續執行。Anthropic 的結論很直接:記憶不是越多越好,而是需要選擇、驗證和組織。
Pokémon Red 實驗把這個差別展示得很清楚。大約 10,000 步時,Sonnet 3.7 創建了 413 個文件、225 個文件夾,只拿到 1 個徽章。Fable 5 只創建了 9 個普通記憶文件、2 個文件夾和一個 global.md,卻拿到了 4 個徽章。
差距來自“記什麼”。Sonnet 3.7 大量保存不斷變化的遊戲狀態,這些記錄很快過時。Fable 5 更注重策略、已驗證的規則和行動計劃。由此得出一個設計原則:長期記憶應優先保留難以從當前環境重新獲得的知識,每次都能直接讀取的實時狀態不需要記。
Claude 記憶體系的 4 個層次
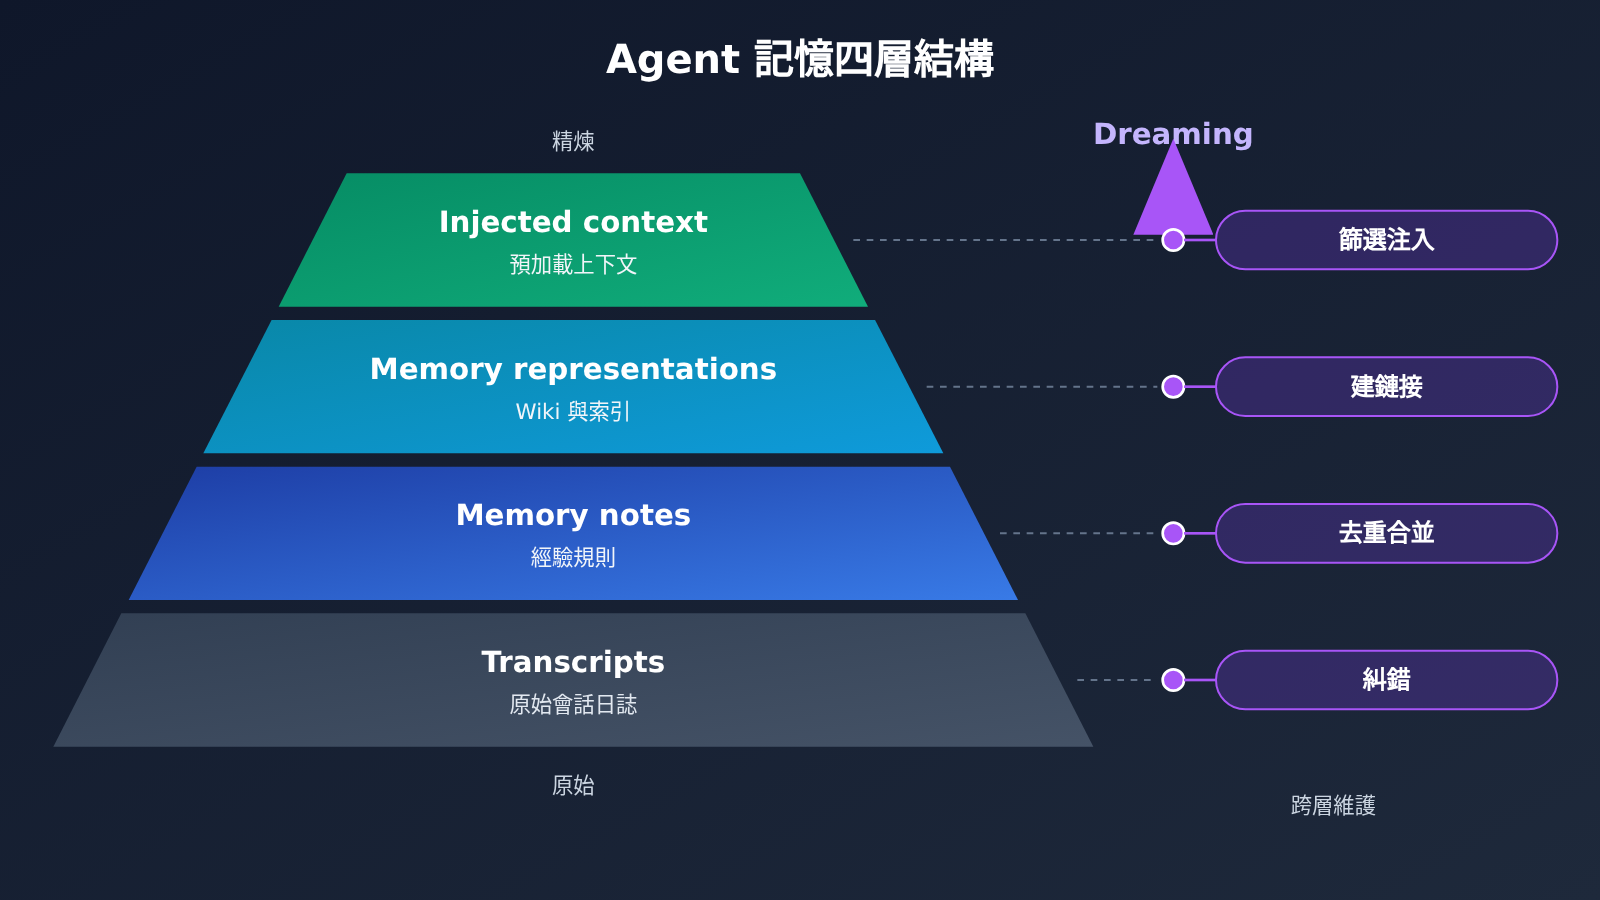
Anthropic 把 Agent 記憶拆成 4 層。每一層的職責、寫入頻率和讀取成本都不一樣。
| 層次 | 內容 | 作用 | 讀取方式 |
|---|---|---|---|
| Transcripts | 完整會話記錄 | 可搜索的事件日誌,是追溯事實的原始證據 | 按需檢索 |
| Memory notes | 任務中記下的重要事實、經驗、規則 | 沉澱可複用的經驗 | 按需讀取 |
| Memory representations | Wiki、索引、鏈接等結構化表示 | 組織知識之間的關係,支持跨文檔檢索 | 導航與檢索 |
| Injected context | 少量高價值記憶 | 新會話啓動時預先加載 | 自動注入 |
這 4 層是從“原始”逐步走向“精煉”的過程。Transcript 信息最全,但體量大、噪聲多。Injected context 最精煉,可每一條都會佔用新會話的上下文窗口,所以只能留給顯著性(Salience)最高的信息。
Dreaming 的定位是跨層維護。它會回到 Transcript 中糾正舊記錄,合併 Memory notes 裏的重複信息,構建 Wiki 和索引,並決定哪些內容值得在新會話開始時預先注入(Context Injection)。
Claude Dreaming 如何糾錯、整理和構建知識庫
Dreaming 糾錯:Mt. Moon 導航案例
Anthropic 記錄過一個導航錯誤。Agent 把 Mt. Moon 附近 Pokémon Center 的方位記錯了,後續會話一直沿着錯誤路線重複嘗試。
Dreaming 重新檢查歷史 Transcript 後,找到了最初那條錯誤記錄,並修正了記憶文件。用修正後記憶的 Agent,在第 1,935 次操作時抵達 Cerulean City。沒有糾錯的版本多次重複失敗,最終沒能完成目標。
這個案例說明,Dreaming 做的不只是摘要。它能回到原始經歷,覈對記憶是否仍然成立。保存的 Transcript 也因此有了新的用途:它是可以反覆複覈的證據庫。
Claude 記憶效果:CL-Bench 實驗數據
Anthropic 用 CL-Bench 1.0 中的數據庫任務測試記憶效果。下表是官方報告的 mean reward。
| 模型 | 無記憶 | 使用記憶 | 提升幅度 |
|---|---|---|---|
| Opus 5.5 | 0.655 | 0.838 | +0.183 |
| Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
| Opus 5 | 0.564 | 0.828 | +0.264 |
| Opus 4.7 | 0.383 | 0.700 | +0.317 |
| Sonnet 5 | 0.306 | 0.610 | +0.304 |
| Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
需要注意,這組數據只針對該任務,不是通用的 Agent 記憶能力評分。更值得關注的是一個現象:模型越強,越傾向於記錄經過驗證的規則、錯誤原因和未來可能遇到的陷阱,而不是照搬歷史對話。Sonnet 4.6 的提升很有限,說明記憶系統的效果和模型本身的“記錄質量”密切相關。
Dreaming 構建 Wiki 知識庫的效果
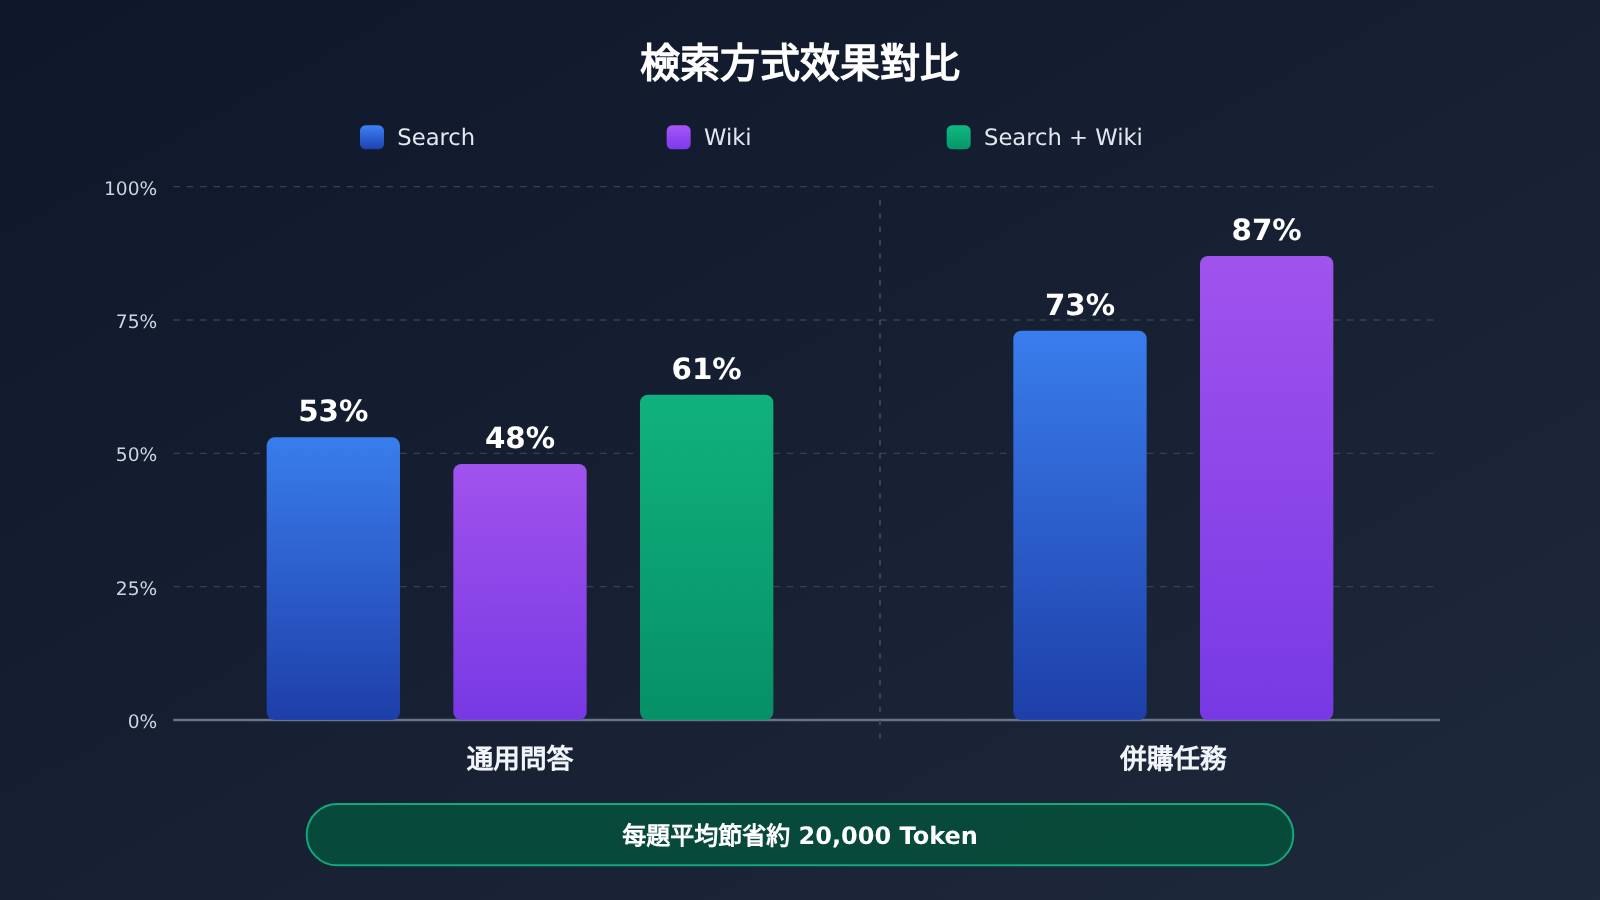
最大規模的實驗使用了約 350,000 份內部文件,總量約 420M Token。Anthropic 通過 128 次 Dreaming 會話逐步構建出一個知識 Wiki,再用問答任務評估效果。
| 檢索方式 | 評分 | 備註 |
|---|---|---|
| Wiki 單獨使用(構建前 → 構建後) | 13% → 48% | Wiki 逐步成型後效果明顯 |
| Search 單獨使用 | 53% | 基線 |
| Search + Wiki(構建前 → 構建後) | 54% → 61% | 每題平均節省約 20,000 Token |
| 併購類跨文件綜合任務 | Wiki 87% vs 純 Search 73% | 跨文檔綜合優勢最明顯 |
📊 圖表說明:以上數據均來自 Anthropic 工程博客的公開實驗。如果想在自己的語料上做類似的小規模驗證,可以通過 API易 apiyi.com 調用 Claude 模型,比較“純檢索”和“檢索 + 整理後的 Wiki”兩種方案的效果與 Token 消耗。
結構化記憶的價值主要體現在兩點。一是建立鏈接和索引,讓跨多份文件的信息能夠被綜合起來。二是減少每次檢索時需要重新讀取的原文量,從而降低 Token 成本。
影響分析:Claude Dreaming 記憶整理爲什麼有時有效、有時有害
Anthropic 沒有把 Dreaming 說成萬能方案,文中給出了好幾個反例。這部分對工程實踐的參考價值,可能比正面數據還要大。
記憶整理的 5 類工程風險
- 過度記錄:像 Sonnet 3.7 那樣大量保存易變狀態,記憶膨脹很快,過時也很快。
- 信息過時:環境變了,記憶還停留在舊版本,沒有來源覈對就會持續誤導 Agent。
- 共享寫入覆蓋:在合同整理實驗中,多個 Agent 同時寫同一張彙總表,57 項關鍵事實只保留了 41 項,約 72%。改爲每份合同一個獨立頁面、由單一 Agent 寫入並保留原始條款後,57 項事實全部保留。
- Wiki 體積膨脹:某次測試中原始文件只有 115 KB,生成的 Wiki 卻漲到 203 KB,整理反而讓信息變多了。
- 簡單任務無收益:單個文件就能直接檢索到答案的問題,Wiki 沒有帶來明顯提升,只增加了維護成本。
對開發者的影響
- 記憶需要分層:原始日誌、經驗規則、結構化知識、預注入上下文分開存放,各自有不同的寫入和讀取策略。
- 來源必須可追溯:每條記憶都應能回溯到對應的 Transcript,這是糾錯的前提。
- 寫入要串行化或分區:避免多個 Agent 併發寫同一份文件,優先採用“一實體一頁面”的結構。
- 定期清理:Wiki 和 Memory notes 也需要去重、合併和淘汰,不然體積只會越來越大。
對行業的影響
- Agent 記憶的研究重心正在從“檢索得準”轉向“記憶本身是否正確、是否在維護中”。
- Sleep-time Compute 有望成爲常規架構,把整理成本放到空閒時段,減少主交互時的上下文負擔。
- 結構化記憶更適合跨文件、多輪次、長期積累的任務。對於一次性簡單問答,純檢索依然是更經濟的選擇。
開發者如何把 Claude Dreaming 思路用在自己的 Agent
官方 Dreams 研究預覽的使用條件
根據 Anthropic 當前文檔,Dreams 屬於 Claude Managed Agents 的功能,狀態爲 Research Preview,需要申請訪問。調用時需要攜帶 managed-agents-2026-04-01 和 dreaming-2026-04-21 兩個 Beta Header。
它的輸入是一個已有的 Memory Store 加上 1 到 100 個歷史 Session,輸出是一個新的 Memory Store,原始 Store 不會被修改。任務異步運行,通常需要幾分鐘到數小時,按所選模型的標準 Token 價格計費。支持的模型以 Opus 5.5 和 Sonnet 5.5 爲主。另外,它目前不具備 Zero Data Retention 或 HIPAA 資格,處理敏感數據前需要評估。
Cookbook 中的動態工作流設計
官方 Cookbook 給出了一套可以自行搭建的多 Agent 工作流。默認由 Lead Agent 編排流程,每個 Analyzer Agent 處理一份 Transcript,Organizer Agent 負責去重、修復鏈接和維護索引。整理好的 Memory Store 掛載到下一次 Session,通常是隻讀方式,也可以用 Cron 定時執行,比如每晚整理過去一天的 Session。
Cookbook 也給出了成本示例。11 份示例 Transcript 共 283 KB,運行約 2.5 分鐘,費用約 $0.36。50 份長 Transcript 約 12 MB,在成本優化設置下大約 $8,耗時約 10 分鐘。這些只是特定實驗的結果,不是固定報價。
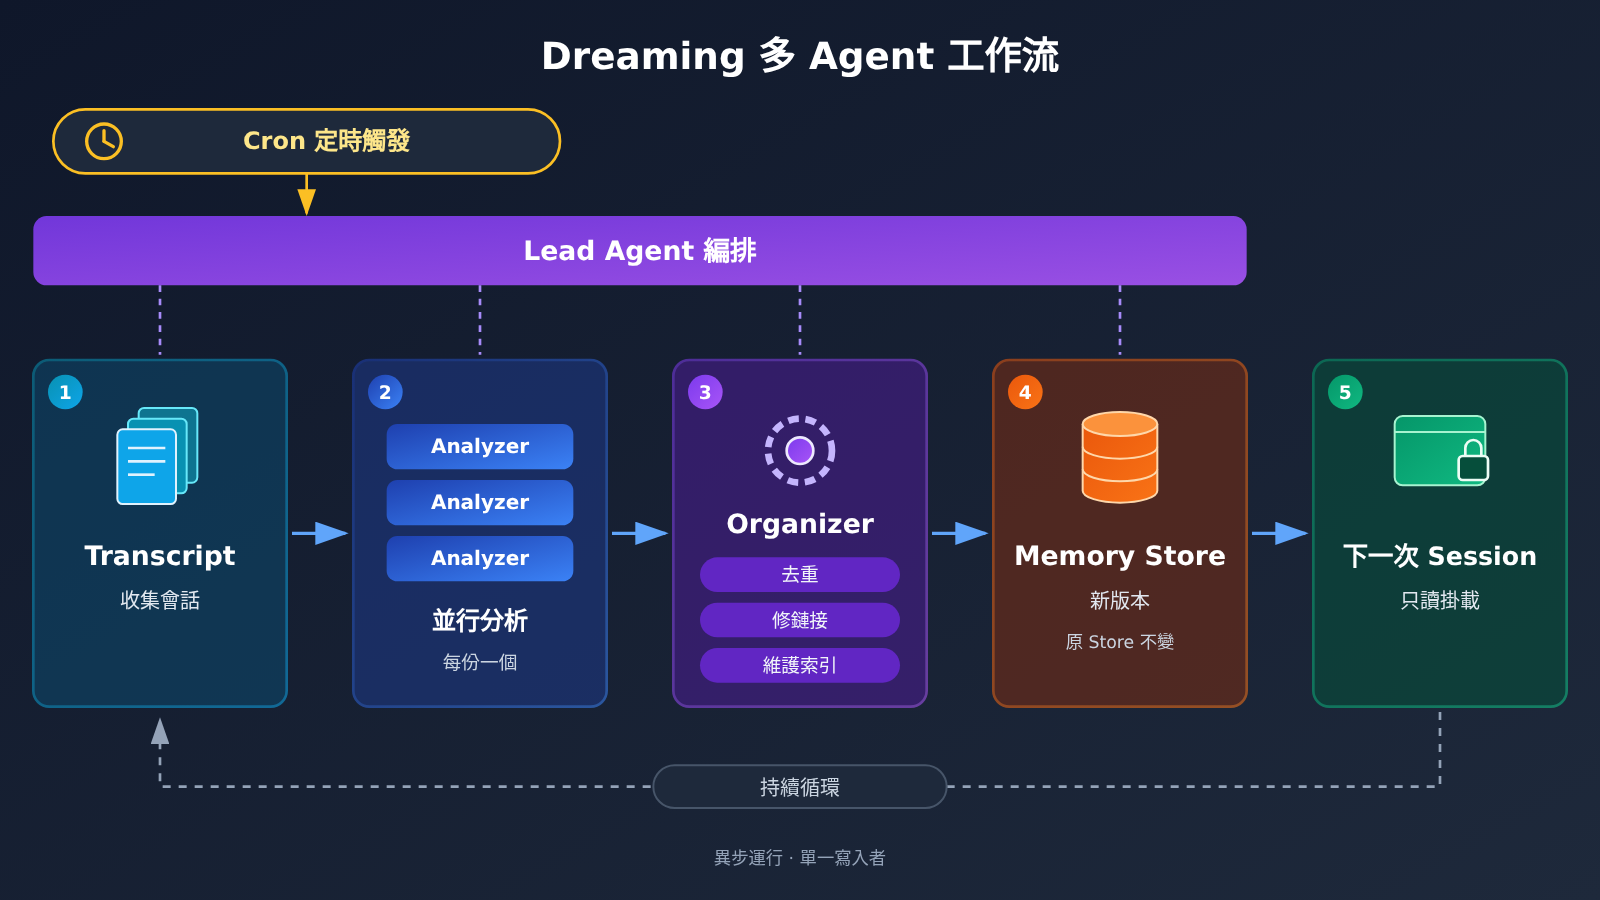
用 Claude 模型自建會話間記憶整理流程
需要先說明:API易 提供的是 Claude 系列模型的調用接口,不等於提供 Managed Agents、Memory Stores 或 Dreams API。不過 Dreaming 的核心思路,也就是“後臺讀 Transcript、提煉經過驗證的規則、交給單一寫入者整理”,完全可以用普通模型調用自己實現。下面是一個最小示例,讓 Claude 分析一份會話記錄並輸出候選記憶。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # 替換爲模型列表中可用的 Claude 模型
    messages=[
        {"role": "system", "content": "只提煉經過驗證的規則、錯誤原因和未來陷阱,忽略易變狀態,每條註明來源行號。"},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
查看完整實現代碼(Analyzer + 單寫入 Organizer)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是記憶分析器。閱讀會話記錄,輸出 JSON 數組,每項包含:
topic(實體或主題名), rule(經過驗證的規則/錯誤原因/陷阱), evidence(原文出處)。
不要記錄每次都能直接從環境讀取的實時狀態。"""

ORGANIZER_PROMPT = """你是記憶整理器。給定某個主題的舊記憶頁面和新候選條目:
1. 與舊記錄衝突時,以 evidence 更可靠者爲準,並註明修正原因;
2. 合併重複條目;
3. 保留原始證據引用;
輸出更新後的 Markdown 頁面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # 一主題一頁面,由單一流程串行寫入,避免併發覆蓋
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"舊頁面:\n{old}\n\n新條目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# 可由 Cron 每晚觸發; 下次會話只讀加載 memory_store 中的索引頁
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 快速上手建議:搭建原型時,可以通過 API易 apiyi.com 用同一個 API Key 測試不同 Claude 模型作爲 Analyzer 和 Organizer 的效果。比較一下哪種組合提煉出的規則更準確、Token 消耗更低,再決定生產環境的配置。
兩種路線的差別可以用下表概括:
| 對比項 | Anthropic Managed Agents Dreams | 基於模型 API 自建記憶整理 |
|---|---|---|
| 獲取方式 | 研究預覽,需申請訪問和 Beta Header | 直接調用 Claude 模型接口 |
| 記憶存儲 | 官方 Memory Store,輸出新 Store | 自行實現文件、數據庫或 Wiki |
| 調度與併發 | 官方異步任務 | 自行實現 Cron、隊列和單寫入控制 |
| 糾錯與權限 | 官方流程內置 | 需要自行設計來源覈對和權限 |
| 可用平臺 | Anthropic 官方 | API易 apiyi.com(模型調用)、官方 API |
Claude Dreaming 常見問題 FAQ
Q1:什麼是 Claude Dreaming?
Dreaming 是 Anthropic 提出的會話間後臺記憶維護過程。它利用歷史 Transcript 糾正舊記錄、合併重複信息、構建 Wiki 和索引,並篩選出需要在新會話中預先注入的高價值上下文。
Q2:Dreaming 和普通的會話摘要、向量檢索有什麼區別?
摘要只壓縮信息,檢索只負責找信息。Dreaming 會回到原始 Transcript 驗證記憶是否仍然成立,比如 Mt. Moon 案例中修正了錯誤方位。它還負責建立跨文檔鏈接,在跨文件綜合任務中 Wiki 得分 87%,純檢索爲 73%。
Q3:Claude Dreaming 現在可以使用了嗎?
相關工程博客發佈於 2026 年 11 月 6 日。Dreams 目前以 Research Preview 形式出現在 Claude Managed Agents 中,需要申請訪問,並且要帶上兩個 Beta Header 才能調用。
Q4:沒有 Managed Agents 訪問權限,能借鑑 Dreaming 思路嗎?
可以。按照“Transcript 收集、後臺分析、單寫入整理、只讀掛載、定期維護”的流程,用普通模型調用就能實現一個簡化版本。通過 API易 apiyi.com 可以用 OpenAI 兼容接口調用 Claude 模型來完成分析和整理。存儲、調度和權限需要自己實現。
Q5:API易 是否直接提供 Claude Dreaming 功能?
不提供。API易 apiyi.com 提供的是 Claude 等模型的調用接口,不包含 Anthropic 的 Managed Agents、Memory Stores 或 Dreams API。適合用它調用模型、自建記憶整理流程,新用戶可以先用免費測試額度驗證方案。
Q6:Dreaming 有哪些已知限制?
單文件就能回答的簡單問題,Wiki 沒有明顯收益。整理可能讓體積膨脹,例如 115 KB 的原文生成了 203 KB 的 Wiki。多 Agent 共享寫入會丟失事實。官方 Dreams 還不具備 ZDR 和 HIPAA 資格,任務耗時從幾分鐘到數小時不等。
Claude Dreaming 核心要點 Key Takeaways
- 記憶不只是存儲:保存全部對話會累積重複、過時和錯誤,需要驗證和組織。
- 4 層記憶結構:Transcripts、Memory notes、Memory representations、Injected context 各司其職。
- 糾錯依賴原始記錄:Dreaming 回到 Transcript 覈對,修正了導致反覆失敗的錯誤方位。
- Wiki 擅長跨文檔任務:併購任務中 Wiki 得分 87%,純檢索爲 73%,每題平均節省約 2 萬 Token。
- 整理也有副作用:併發寫入會丟失事實,Wiki 會膨脹,簡單任務用不上。
- 自建可行:通過 API易 apiyi.com 調用 Claude 模型,可以實現簡化版的會話間記憶整理。
總結
Claude Dreaming 帶來的啓發主要有三點:
- 長期記憶的核心是維護:只有經過驗證、去重、組織的記憶,才能穩定幫助下一次任務。
- 記什麼比記多少更重要:優先記錄難以從環境中重新獲得的規則、錯誤原因和陷阱,不要記錄易變狀態。
- 結構化記憶要看場景:跨文件、多輪次、長期積累的任務值得引入 Wiki,簡單檢索任務不必爲此增加維護成本。
如果你的 Agent 已經在跨多個會話運行,可以先從“保留 Transcript、每晚串行整理一次、只讀掛載索引頁”這個最小閉環做起。推薦通過 API易 apiyi.com 調用 Claude 模型快速驗證這套流程,平臺提供 OpenAI 兼容接口和新用戶免費測試額度。
📚 參考資料
- The components of agent memory:Anthropic 工程博客原文,介紹 4 層記憶結構與 Dreaming 實驗
- 鏈接:
anthropic.com/research/components-of-agent-memory -
說明: CL-Bench、Pokémon、Wiki、合同整理等實驗數據的原始出處
-
Dreaming with a dynamic workflow:Claude 官方 Cookbook
- 鏈接:
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
說明: Lead、Analyzer、Organizer 多 Agent 工作流示例和成本參考
-
Anthropic 官方 X 發佈動態:Dreaming 工程博客的發佈說明
- 鏈接:
x.com/AnthropicAI/status/2118814753154064501 - 說明: 確認發佈時間和官方定位
作者:API易 技術團隊
技術交流:歡迎在 API易 官網首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心


