
作者注:生碼率超過 30% 不等於交付變快。本文拆解“7% 理論上限”的推導邏輯,分析 5 個流程瓶頸,並給出一張團隊自查清單。
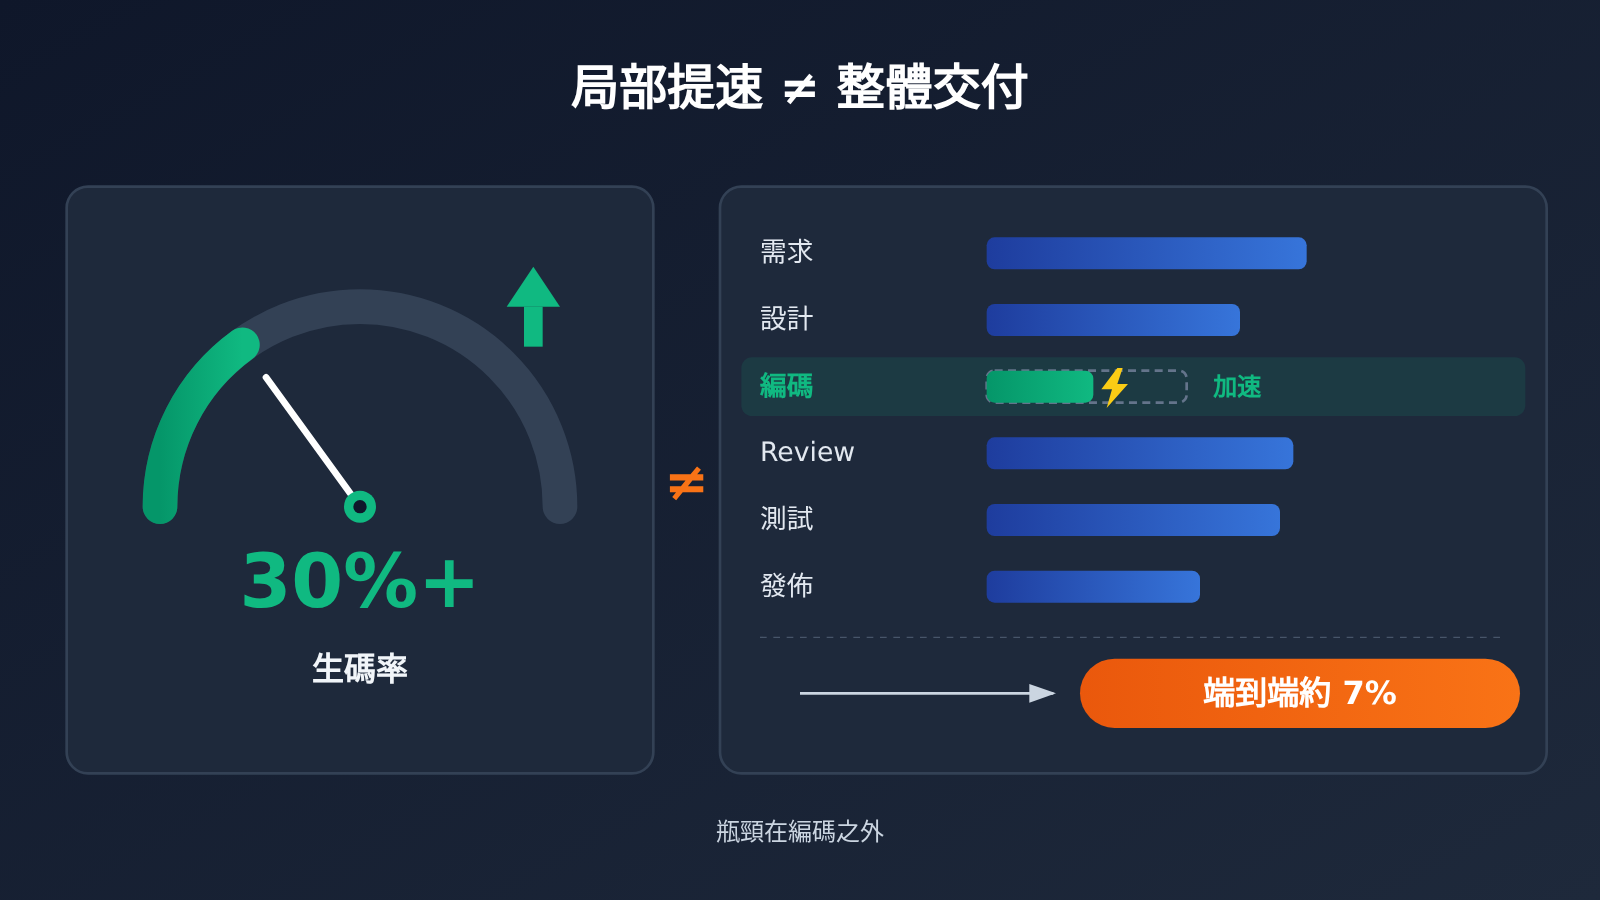
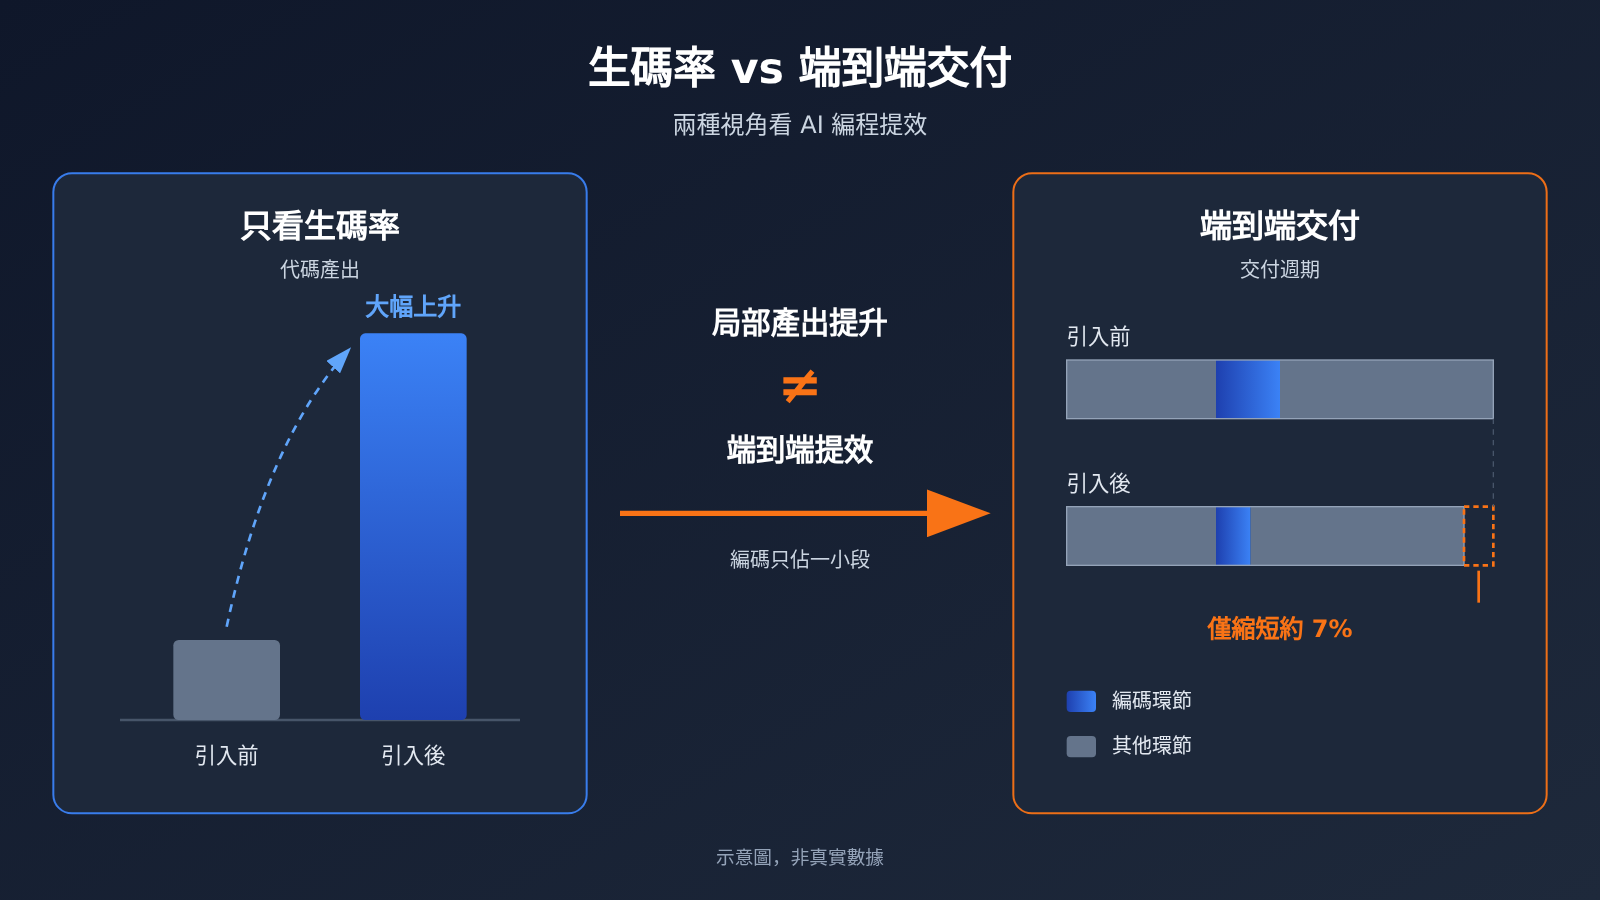
先說結論:生碼率不等於交付速度。AI 生成的代碼佔比從個位數漲到 30% 以上,提升的只是“編碼”這一個環節的產出。端到端交付時間還包括需求確認、設計、Review、測試、聯調、發佈和驗收。編碼在整條鏈路裏往往只佔一部分,所以生碼率提升得再多,交付週期也只能縮短 編碼佔比所允許的那一點。
這也解釋了很多技術管理者的困惑:工具推了、生碼率報表很好看,交付週期卻沒怎麼變。有一份行業材料根據某個團隊的耗時拆解,推算出端到端提效的上限大約在 7% 量級。這不是唱衰 AI 編程,而是提醒大家:真正卡住交付的,是編碼之外的 5 個瓶頸。本文會講清 7% 是怎麼算出來的、它適用的邊界,以及你的團隊該如何自查。
生碼率超過 30% 與 7% 上限:核心信息速覽
在進入推導之前,先用一張表把這次討論的關鍵信息和口徑交代清楚。尤其要注意每個數字的來源和可信程度,後文所有分析都建立在這些邊界之上。
| 信息項 | 詳情 | 口徑說明 |
|---|---|---|
| 生碼率 | 超過 30% | 指代碼中由 AI 生成的比例,只反映編碼環節產出 |
| 端到端提效上限 | 約 7% 量級 | 特定團隊耗時拆解下的推算,不是普適定律 |
| 業界交流說法 | 約 3%-5% | 來自交流,缺少可覈驗樣本 |
| 有效代碼吞吐 | 2-3 倍 | 團隊回顧數據,統計口徑與對照方法未披露 |
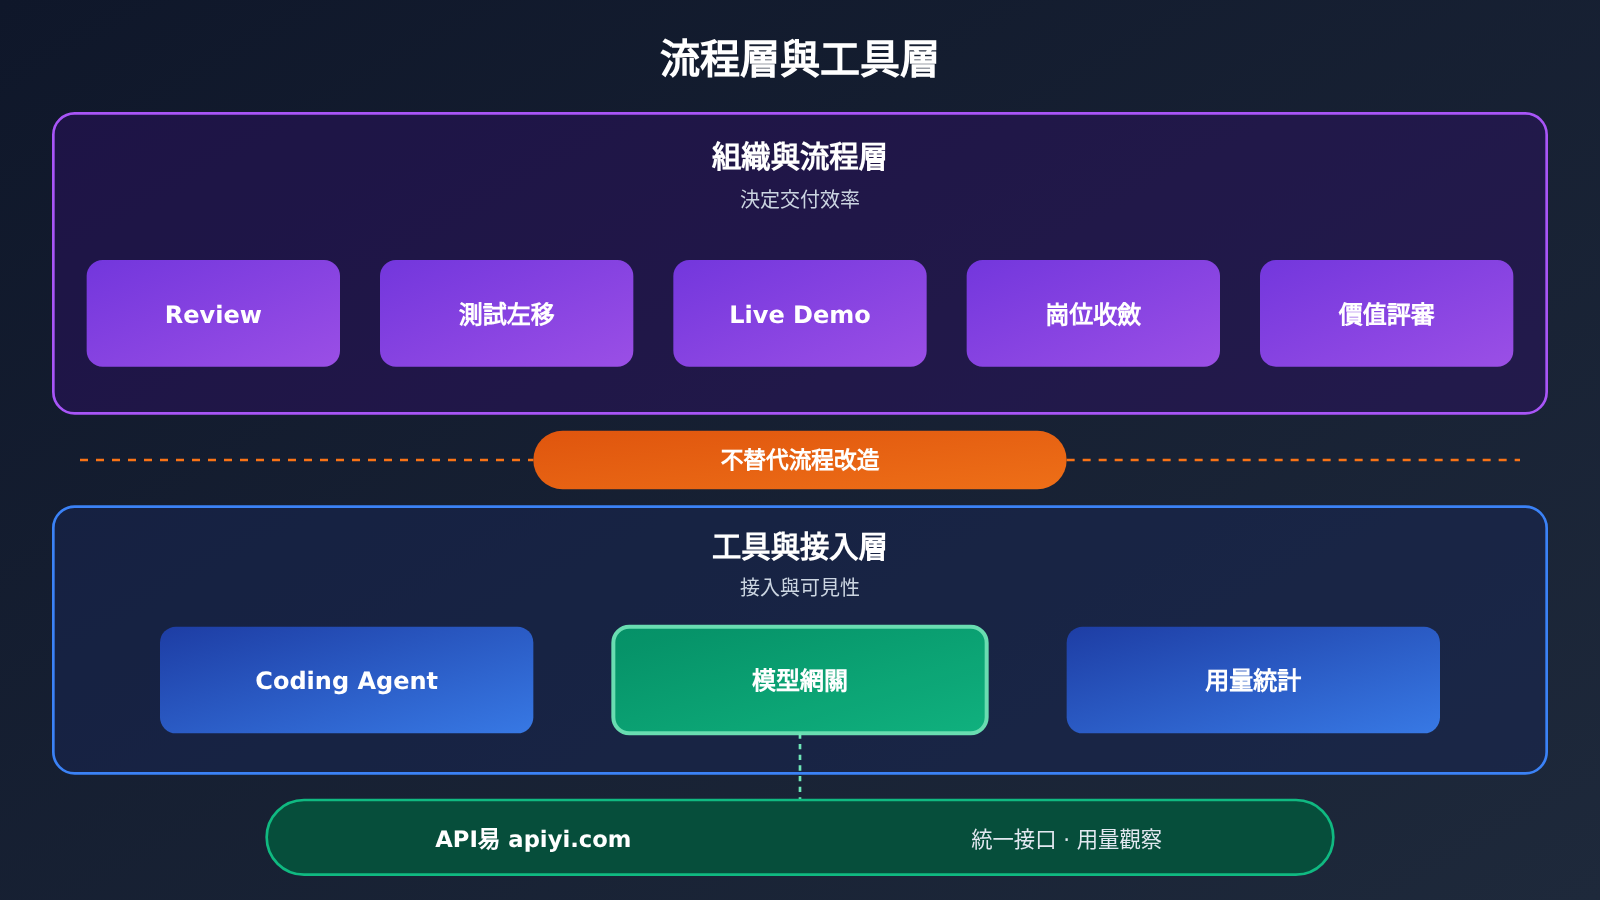
| 五個瓶頸 | Review 排隊、測試與觀測左移、Live Demo、崗位收斂、價值評審 | 組織與流程層面的問題 |
| Coding Agent 接入 | 可通過 API易 apiyi.com 等聚合接口統一接入 | 解決接入與用量觀察,不解決流程瓶頸 |
這幾個數字之間並不矛盾。“2-3 倍有效代碼吞吐”說的是編碼產出,“7%”和“3%-5%”說的是端到端交付。前者是局部指標,後者是全局指標,中間隔着一整條交付鏈路。
7% 上限怎麼來的:生碼率與編碼佔比的乘法關係
端到端提效公式拆解
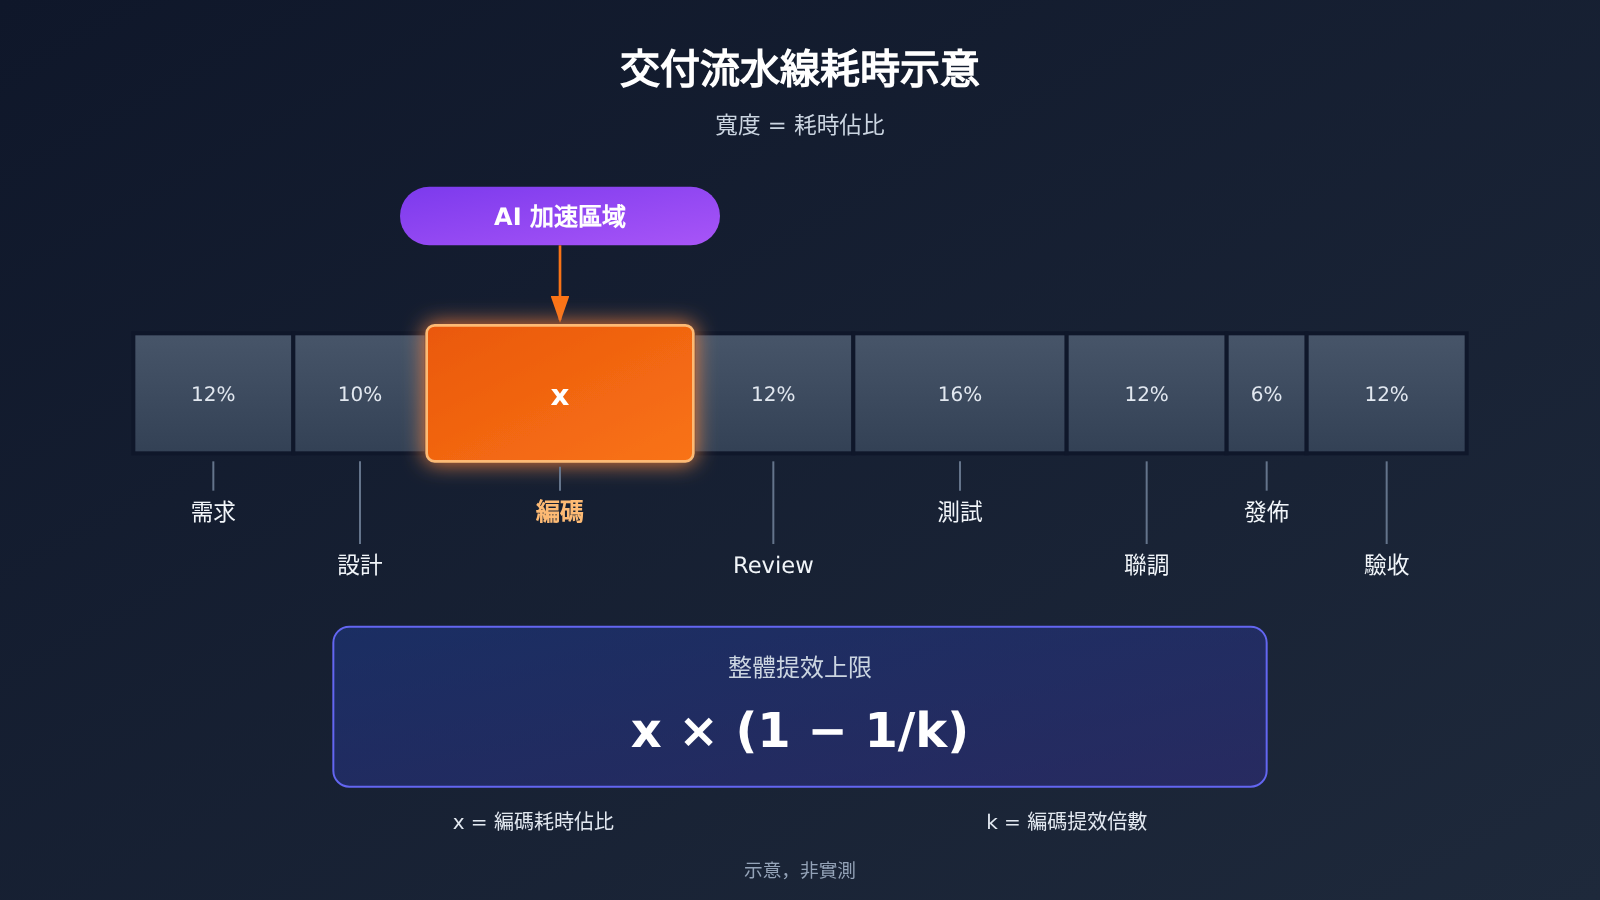
端到端提效的上限可以用一個簡單的公式估算:端到端提效上限 ≈ x × (1 - 1/k)。其中 x 是編碼環節佔總交付時間的比例,k 是編碼環節的提效倍數。這本質上是阿姆達爾定律在研發流程上的應用:你只加速了系統的一部分,整體收益就被這一部分的佔比封頂。
舉個直觀的例子:假設編碼佔交付時間的 14%,AI 讓編碼快了一倍(k = 2),那麼 14% × (1 - 1/2) = 7%。即使假設編碼時間被壓縮到零(k 趨於無窮大),端到端最多也只能縮短 14%。下表列出幾組假設參數下的計算結果,它們只是公式演示,不是任何團隊的實測數據。
編碼佔比 x |
編碼提效倍數 k |
端到端提效上限 | 解讀 |
|---|---|---|---|
| 10% | 3 | 約 6.7% | 編碼快 3 倍,整體仍不到 7% |
| 14% | 2 | 7% | 與材料推算量級相當的一組示例 |
| 20% | 1.5 | 約 6.7% | 提效倍數低時收益很快被稀釋 |
| 20% | 2 | 10% | 編碼佔比高的團隊空間更大 |
| 30% | 2 | 15% | 編碼密集型團隊的情況 |
| 20% | 趨於無窮 | 20% | 編碼時間歸零時的理論天花板 |
生碼率 30% 不等於編碼快 30%
還有一個常被忽略的誤區:生碼率和 k 不是一回事。生碼率說的是“多少代碼由 AI 寫出”,而 k 說的是“編碼耗時縮短了多少”。AI 生成的代碼仍需要閱讀、調試和修改,生成本身也有提示、等待和糾錯的成本。
即便做一個極端簡化的假設,認爲 AI 生成的那 30% 代碼完全不花時間,編碼提效倍數也只有 1 / (1 - 0.3) ≈ 1.43。再乘以編碼佔比,端到端收益就更小了。所以材料裏 7% 的量級並不奇怪,反而說明問題的關鍵不在“生成更多代碼”,而在編碼之外的環節。
需要再次強調:7% 是基於某個特定團隊耗時拆解的推算,你的團隊編碼佔比、需求穩定度、測試體系都不同,結果可能更高也可能更低。它的價值是提供一種思考框架,而不是一個可以直接套用的結論。
交付沒變快的 5 個瓶頸:生碼率之外的真問題
當編碼變快後,壓力會沿着流水線向下遊傳導。下面五個瓶頸,有的是 AI 編程放大出來的新問題,有的是一直存在、只是以前被編碼速度掩蓋了。
瓶頸 1:骨幹 Review 排隊
AI 生成的代碼越多,需要審查的代碼就越多。Review 往往集中在少數骨幹身上,他們既要理解業務上下文,又要判斷 AI 代碼的邊界條件和潛在風險。結果是編碼階段省下的時間,很大一部分變成了 Review 隊列裏的等待時間。
更麻煩的是,AI 代碼“看起來都對”,審查者需要更仔細地讀,單位代碼的 Review 成本未必下降。如果不調整 Review 機制,例如分級審查、明確哪些改動可以由非骨幹審批、把規範檢查交給自動化工具,骨幹就會成爲整條鏈路上最窄的瓶頸。
瓶頸 2:測試與觀測左移
很多團隊的測試、監控和可觀測性是在開發後期才介入的。編碼變快之後,問題被更快地堆積到測試階段,返工反而更集中。如果測試用例、埋點和告警規則不能在編碼前或編碼中同步設計,後期的聯調和修復會吞掉前面的收益。
測試與觀測左移的核心,是讓“驗證”和“編寫”同時發生。對於 AI 生成的代碼,這一點尤其重要,因爲你需要可運行的驗證手段來快速判斷生成結果是否正確,而不是依賴人工逐行確認。
瓶頸 3:用 Live Demo 確認需求,減少返工
交付週期裏最昂貴的往往不是寫代碼,而是寫錯了再改。需求理解偏差導致的返工,會讓編碼、Review、測試全部重來一遍。AI 讓編碼變便宜之後,一個更好的用法是快速做出可運行的 Live Demo,讓需求方在真實交互裏確認“是不是這個意思”。
這相當於把需求確認從文檔評審變成原型評審。文檔容易各自理解,可運行的 Demo 則能儘早暴露分歧。編碼成本下降帶來的真正紅利,可能不是更快寫完正式代碼,而是更便宜地試錯。
瓶頸 4:崗位收斂,PDFE 與 ABE 的角色變化
傳統流程中,產品、設計、前端、後端、測試之間存在大量交接。每一次交接都意味着等待、上下文丟失和重新對齊。材料中提到的 PDFE、ABE 等角色合併方向,本質上是讓一個人或一個小組覆蓋更長的鏈路,減少交接次數。
當 AI 承擔了更多編碼工作後,工程師有餘力向需求和測試兩端延伸,崗位收斂才變得可行。但要注意,不同規模團隊複製這種組織調整的條件和成本,目前缺少證據。小團隊可能天然適合,大型組織則涉及職責、考覈和協作方式的系統性改變,不能簡單照搬。
瓶頸 5:價值評審與概念字典/SDD
如果概念和數據定義沒有對齊,AI 寫得越快,錯得越快。同一個業務名詞在不同模塊裏含義不同,接口字段口徑不一致,這些問題會在聯調和驗收階段集中爆發。材料提到的做法是先做價值評審,再用概念字典和 SDD(規格驅動開發)對齊概念與數據,然後再寫代碼。
價值評審回答的是“這件事值不值得做”,概念字典和 SDD 回答的是“我們說的是不是同一件事”。這兩步看起來增加了前期成本,但它們讓 AI 有了清晰、一致的上下文,生成的代碼更容易一次對齊。
5 個瓶頸與對應動作
| 瓶頸 | 典型症狀 | 建議動作 | 觀察指標 |
|---|---|---|---|
| 骨幹 Review 排隊 | PR 等待時間變長,骨幹超負荷 | 分級審查,自動化規範檢查 | PR 平均等待時長 |
| 測試與觀測左移 | 返工集中在測試階段 | 用例與埋點前置設計 | 測試階段缺陷回退次數 |
| Live Demo 確認需求 | 驗收時發現“不是想要的” | 用可運行原型確認需求 | 需求變更與返工次數 |
| 崗位收斂 | 交接多、等待多、上下文丟失 | 減少交接節點,擴大單人鏈路 | 環節間交接次數 |
| 價值評審與概念字典/SDD | 聯調時口徑不一致 | 編碼前對齊概念與數據 | 聯調階段問題數量 |
團隊自查:如何拆解自己的交付耗時與生碼率收益
與其爭論 7% 還是 3%-5%,不如把自己團隊的數字算出來。下面是一套可以直接落地的拆解方法,建議選一個小項目先跑一遍。
- 拆環節:把一個需求從提出到上線的過程,按需求、設計、編碼、Review、測試、聯調、發佈、驗收拆開,記錄每段的實際耗時和等待時間。
- 算編碼佔比:用編碼環節的耗時除以總交付時間,得到你的
x。很多團隊會發現這個數字比想象中小。 - 找等待與返工:單獨統計 Review 排隊時間、測試返工次數、需求變更次數,這些通常是隱藏的大頭。
- 區分產出與價值:把“代碼產出”和“可交付價值”分開看,生碼率、提交行數屬於前者,上線功能數和交付週期屬於後者。
- 做小規模對照:用一個小項目做前後對照,不要只看生碼率報表。
- 先修最大瓶頸:找到耗時最長的環節優先處理,不要同時上所有工具和所有流程改造。
下面是一個假設性的耗時拆解模板,用於說明填寫方式,不代表任何團隊的真實數據。你可以把自己的數據填進去,對比一下編碼段到底佔多少。
| 交付環節 | 示例佔比(假設) | 主要耗時來源 | AI 編程能否直接加速 |
|---|---|---|---|
| 需求與價值評審 | 15% | 反覆溝通、口徑對齊 | 間接(Live Demo) |
| 設計 | 10% | 方案討論、評審 | 部分 |
| 編碼 | 15% | 編寫、調試 | 直接 |
| Review | 15% | 排隊等待、審查 | 部分(輔助審查) |
| 測試與聯調 | 25% | 用例執行、返工 | 部分(用例生成) |
| 發佈與驗收 | 20% | 審批、驗收反饋 | 很少 |
這張模板的意義在於暴露結構:如果你的編碼佔比只有十幾個百分點,那麼即使生碼率繼續翻倍,端到端收益也很有限。真正的提效空間在 Review、測試和需求環節。
Coding Agent 接入與用量觀察:API易 能做什麼、不能做什麼
在 AI 編程工具的落地過程中,接入和成本觀察是繞不開的一環。API易 apiyi.com 支持 Cursor、Cline 等編程工具接入,提供 OpenAI 兼容的統一接口,一個 API Key 即可調用 OpenAI、Claude、Gemini 等主流模型。配置時,把工具中的 base_url 設爲 https://api.apiyi.com/v1 即可完成接入。
對研發效能團隊來說,更有價值的是用量數據。通過控制檯的用量統計,你可以觀察 Coding Agent 的 token 消耗、不同模型的調用分佈,判斷哪些任務適合用更強的模型,哪些任務用輕量模型就夠了。這些數據可以和前面的交付耗時拆解放在一起看,幫助你評估 AI 編程投入和產出之間的關係。
💡 接入建議:如果團隊同時在評估多個編程模型,可以通過 API易 apiyi.com 統一接入並對比用量,新用戶有免費測試額度,適合先在小項目上做對照。具體價格與模型可用性以控制檯和文檔爲準。
但需要明確一點:網關本身不能提升端到端交付效率。它解決的是接入便利、模型切換和用量可見性,Review 排隊、測試返工、需求偏差這些流程瓶頸,只能在組織側解決。把網關當成提效方案,和把生碼率當成交付指標,犯的是同一類錯誤。
常見問題 FAQ
Q1:生碼率超過 30%,爲什麼端到端交付只快了 7% 左右?
因爲生碼率只作用於編碼環節。端到端提效上限約爲 `x × (1 – 1/k)`,編碼佔比 `x` 本身不高時,收益會被封頂。需要注意,7% 是特定團隊耗時拆解下的推算,不是普適結論,你的團隊需要用自己的數據重新計算。
Q2:3%-5% 和 2-3 倍這兩個數字可信嗎?
都需要謹慎看待。3%-5% 的端到端提效說法來自業界交流,缺少可覈驗樣本;2-3 倍有效代碼吞吐來自團隊回顧,統計口徑和對照方法沒有披露。它們可以作爲參考方向,但不適合直接作爲決策依據。
Q3:5 個瓶頸應該先解決哪個?
先拆解自己的交付耗時,優先處理佔比最大的環節。很多團隊會發現 Review 等待和測試返工是大頭,也有團隊是需求變更最嚴重。不建議同時上所有改造,一次只修最大的瓶頸,效果更容易觀察。
Q4:如何觀察團隊 Coding Agent 的模型用量和成本?
可以把編程工具統一接入到同一個 API 入口,再在控制檯查看 token 消耗和模型分佈。例如通過 API易 apiyi.com 接入 Cursor、Cline 等工具,就能集中查看用量數據。但用量觀察只是輔助決策,流程瓶頸仍需組織側解決。
Q5:崗位收斂適合所有團隊嗎?
不一定。PDFE、ABE 等角色合併的思路是減少交接,但不同規模團隊複製這種調整的條件和成本缺少證據。建議先在一個小組內試點,觀察交接次數和交付週期的變化,再決定是否推廣。
生碼率與端到端交付:核心要點 Key Takeaways
- 生碼率不等於交付速度:它只反映編碼環節產出,不代表端到端提效。
- 7% 來自公式推算:
x × (1 - 1/k),編碼佔比決定了收益天花板。 - 數字口徑要分清:7% 是特定團隊推算,3%-5% 來自交流,2-3 倍口徑未披露。
- 瓶頸在編碼之外:Review、測試、需求確認、交接、概念對齊纔是大頭。
- 先拆耗時再改流程:用小項目對照,一次只修最大的瓶頸。
- 工具層只管接入與觀察:API易 apiyi.com 可統一接入 Coding Agent 並查看用量,但不解決流程問題。
總結:生碼率超過 30% 之後,團隊該做什麼
生碼率超過 30% 是一個真實的進步,但它只是起點。端到端交付由一整條鏈路決定,編碼只佔其中一部分,x × (1 - 1/k) 這個公式清楚地說明了局部提速的上限。7% 這個數字的意義不在於它準不準,而在於提醒我們把目光從“寫了多少代碼”轉向“交付了多少價值”。
真正的提效空間在 Review 機制、測試與觀測左移、Live Demo 需求確認、崗位收斂以及價值評審與概念對齊。這些都是組織和流程層面的工作,沒有任何工具可以替代。在工具層面,推薦通過 API易 apiyi.com 統一接入編程模型並觀察用量,把用量數據和交付耗時放在一起評估投入產出。
團隊自查清單
- [ ] 是否拆解過一個需求從提出到上線的完整耗時?
- [ ] 是否算出了編碼環節佔總交付時間的比例
x? - [ ] 是否單獨統計了 Review 排隊時間和骨幹負載?
- [ ] 測試用例、埋點和告警是否在編碼前或編碼中同步設計?
- [ ] 需求確認是否使用可運行的 Demo,而不只是文檔?
- [ ] 一個需求從提出到上線經過幾次角色交接?
- [ ] 編碼前是否對齊了核心概念和數據口徑(概念字典/SDD)?
- [ ] 彙報指標是否區分了“代碼產出”與“可交付價值”?
- [ ] 是否用小項目做過前後對照,而不只看生碼率報表?
- [ ] 是否只選一個最大瓶頸優先改造,而不是同時上所有工具?
參考資料
- 生碼率與端到端交付相關行業材料:本文 7% 推算、五個瓶頸及數據口徑的來源
- 說明:材料被截斷,本文僅基於可見部分整理,未顯示內容不作爲依據
- API易 文檔中心:編程工具接入與用量統計說明
- 鏈接:
docs.apiyi.com - 說明:價格與模型可用性以控制檯和文檔爲準
作者:API易 技術團隊
技術交流:歡迎訪問 API易 apiyi.com 首頁聯繫我們,更多接入資料可查閱 docs.apiyi.com 文檔中心


