
Примечание автора: d1.2-ultra занимает 1-е место в Decision Index v2.1. В этой статье я сначала помогу вам понять, чем именно занимается ваш продукт — извлечением данных из документов, вызовом инструментов или ответами на сложные вопросы, — затем посмотреть только на те подпоказатели, которые имеют к этому отношение, и уже по 20–50 собственным примерам решить, стоит ли менять модель.
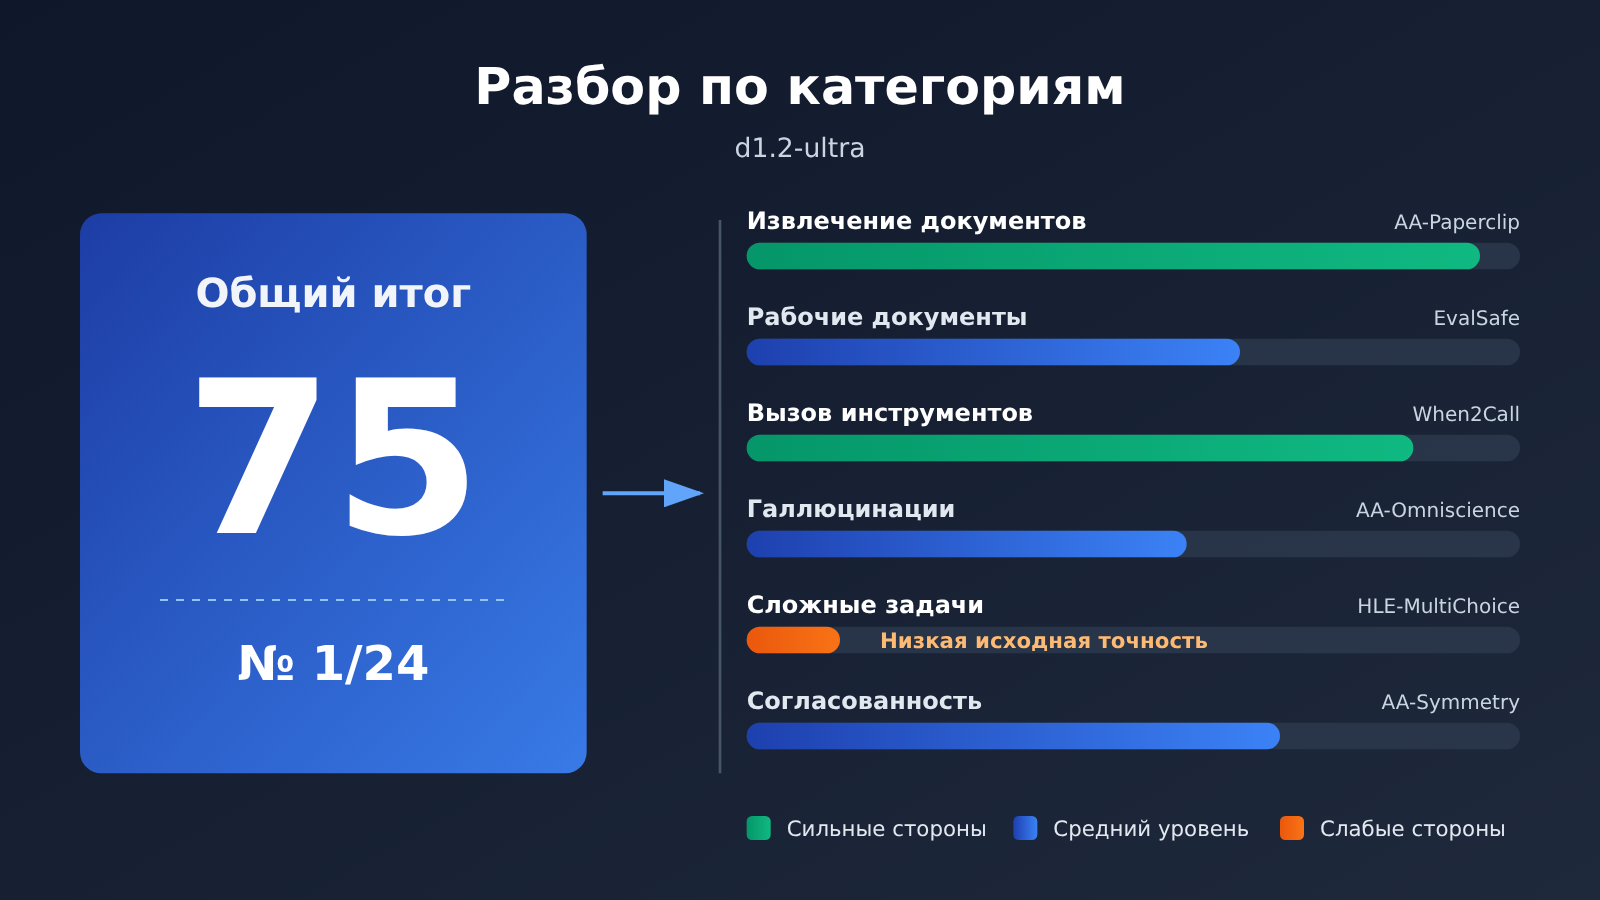
16 ноября 2026 года Liquid AI выпустила d1.2 и d1.2-ultra. В официальном блоге говорится, что d1.2-ultra набрала 75 баллов в Artificial Analysis Decision Index v2.1 — это самый высокий результат среди моделей принятия решений. Многие разработчики, которые как раз интегрируют API, видят «1-е место» и первым делом думают заменить продакшен-модель. Не торопитесь с заменой: совокупные 75 баллов — лишь повод присмотреться. Смотреть надо на тот подпоказатель, который совпадает с вашим бизнесом.
Это не статья, где модель либо топят, либо превозносят. Одна и та же модель лидирует по извлечению данных из документов, но на сложных вопросах с выбором вариантов её исходная точность — самая низкая среди 24 моделей принятия решений. Оба факта верны одновременно, просто совокупный балл их сглаживает.
Главное: после прочтения вы будете знать, на какой подпоказатель смотреть, как читать балл принятия решений и исходную точность, а также как за полдня — по своим 20–50 примерам — сделать вывод, менять модель или нет.
Главное о первом месте d1.2-ultra по сводному индексу
Сначала разберёмся с цифрами на странице рейтинга. Данные взяты со страницы модели d1.2-ultra в Artificial Analysis, дата считывания — 2026-11-17; в сравнении участвовали 24 модели для принятия решений.
| Пункт | Данные со страницы рейтинга | Как читать |
|---|---|---|
| Сводный индекс | 74.85, на странице показано 75, 1-е место из 24 | У второго места, Drex Max v1.1, — 72.62; разница около 2.2 балла. Это те же «два балла» из официального заявления, только округлённые |
| Время выполнения | 218 мс на задачу, 14-е место из 24 | Медиана на странице — 209 мс, результат в середине поля |
| Стоимость полного прохождения индекса | 133 доллара на миллион задач, 11-е место из 24 | Это стоимость выполнения задач, а не цена за миллион токенов |
| Цена ввода | 0.042 доллара за миллион токенов | Совпадает с официальным блогом Liquid; официально учитывается только ввод |
| Brier | 0.150, самый низкий среди 24 | Чем ниже, тем лучше: вероятности, которые выдаёт модель, выглядят довольно «честными» |
Как формируется сводная оценка d1.2-ultra
Decision Index v2.1 — это взвешенное среднее шести компонентов. На странице модели оценка решений определяется так: точность минус Brier score вероятности выбранного ответа, диапазон от 0 до 100, чем выше, тем лучше. Иными словами, за уверенную ошибку штрафуют сильнее, чем за неуверенную. Сырая точность — это доля заданий, в которых модель назначила наибольшую вероятность правильному варианту, и это не то же самое число, что оценка решений.
Эта разница напрямую влияет на то, как читать d1.2-ultra. Модель может получать вполне приличную оценку решений за счёт того, что часто не угадывает и реже делает уверенные ошибки, при этом её сырая точность будет низкой. Если вашему бизнесу нужно «обязательно дать ответ», смотрите на сырую точность; если допустимо «при сомнении передавать человеку», оценка решений полезнее.
| Компонент | Вес | Что измеряет | Категория в AA |
|---|---|---|---|
| AA-Paperclip | 30% | Оценка и извлечение данных из документов: 15 ответов по одному документу считаются одним решением | Документы |
| EvalSafe-O*NET-AA | 15% | Оценка рабочих документов | Документы |
| When2Call | 10% | Вызов инструментов | Инструменты |
| AA-Omniscience-Decision v1.1 | 15% | Знания и галлюцинации | Знания |
| HLE-MultiChoice v1.1 | 15% | Текстовые задания с выбором ответа из Humanity’s Last Exam; можно отказаться от ответа | Рассуждение |
| AA-Symmetry v1.1 | 15% | Проверяет, сохраняется ли суждение после перефразирования, изменения порядка вариантов и добавления отрицания | Согласованность |
Учтите: в AA HLE-MultiChoice помечен как рассуждение, а не как знания. Поэтому ниже, когда речь пойдёт о нём, нельзя называть его «тестом знаний».
Как сопоставить d1.2-ultra с нужной метрикой
Первый шаг — не заглядывать в рейтинг, а взять лист бумаги и записать, к какому типу относится ваша задача: извлечение данных из документов, вызов инструментов, ответы на сложные вопросы или вопрос-ответ по знаниям. После этого смотрите только на подходящую метрику, а на остальные подпункты и общий балл 75 пока не обращайте внимания.
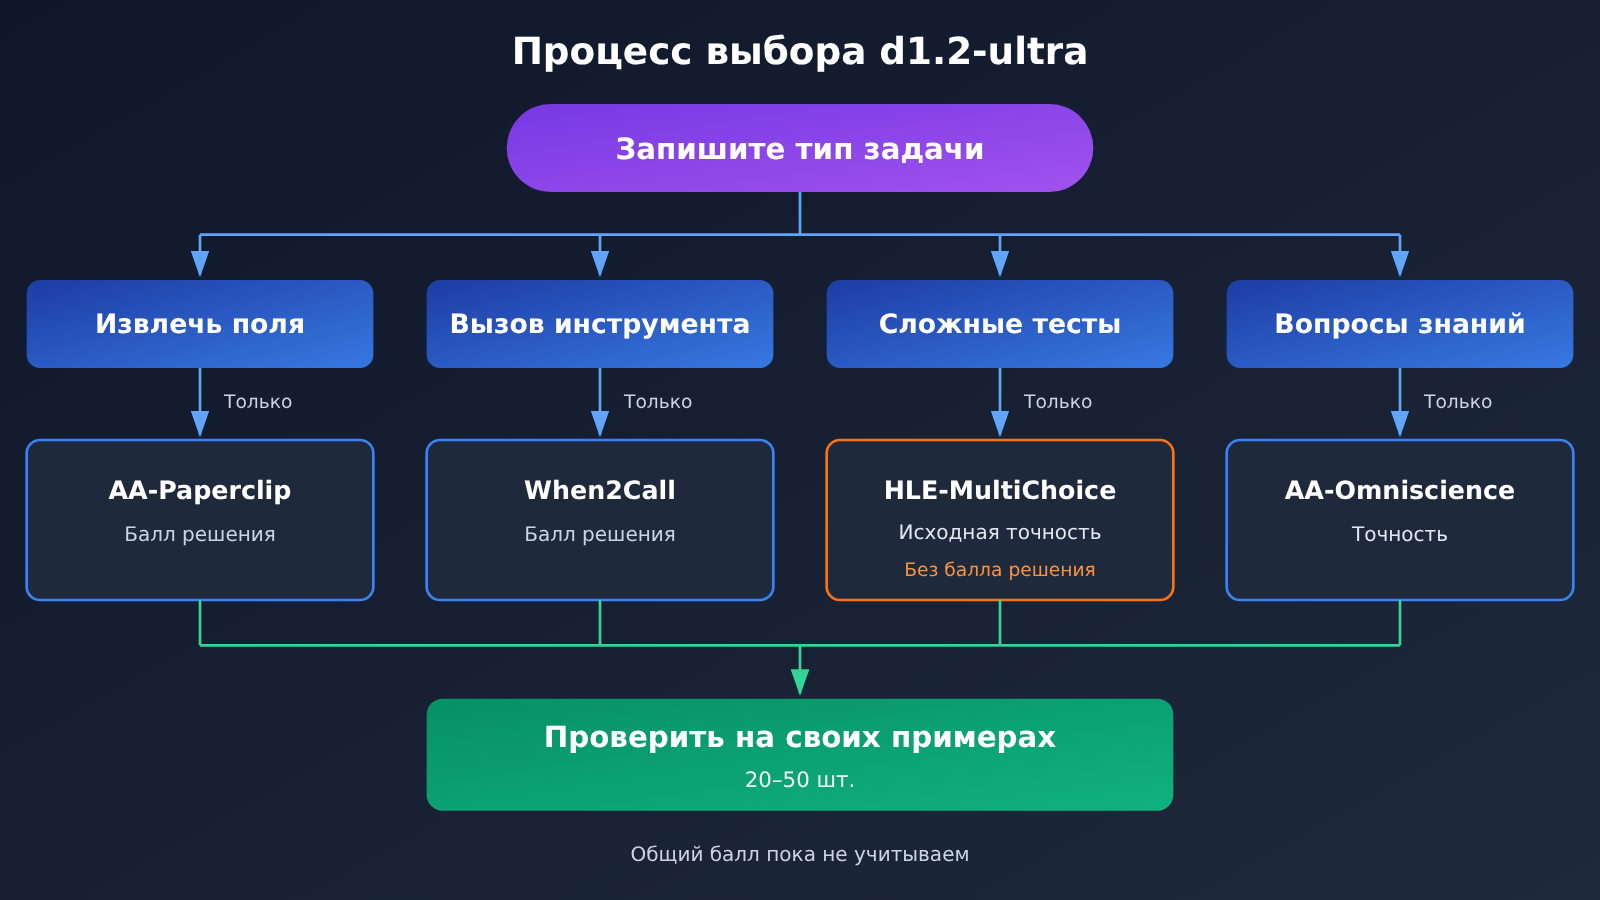
| Что вы делаете | Смотрите только на эту метрику | Данные со страницы рейтинга d1.2-ultra | Как понимать |
|---|---|---|---|
| Извлечение полей из счетов, резюме, статей | AA-Paperclip | Балл принятия решений 75.81, доля полностью правильно обработанных документов 67.7%, по обоим показателям 1-е место из 24 | У занявшего 2-е место Drex Max v1.1 — 72.82 и 63.0%, преимущество довольно явное |
| Вызов инструментов, решение, стоит ли вызывать | When2Call | Балл принятия решений 96.49, 1-е место | У SubQ Snap 1.2 — 96.10, у d1.2 — 96.09, первые несколько мест укладываются примерно в 1 балл |
| Оценка рабочих документов | EvalSafe-O*NET-AA | Балл принятия решений 89.53, 3-е место | Впереди Jev 1.14 (91.14) и GLiDE v1.2 (89.67) |
| Ответы на очень сложные вопросы с вариантами | Исходная точность HLE-MultiChoice | 2.36%, самый низкий показатель среди 24 моделей принятия решений | Балл принятия решений 46.36 вовсе не последний, доля ответов без галлюцинаций 76.1% — модель часто предпочитает не угадывать |
| Вопрос-ответ по знаниям | Точность AA-Omniscience | Исходная точность 23.6%, 20-е место из 24 | Балл принятия решений 60.80 — 6-е место, доля ответов без галлюцинаций 83.8% |
| Стабильность ответа при переформулировке | AA-Symmetry, доля полных прохождений | Балл 86.34 — 2-е место; доля полных прохождений 56.7% — 5-е место | Второе место по баллу не означает второго места по стабильности |
Два пункта в разбивке d1.2-ultra, которые проще всего истолковать неверно
Первый — HLE-MultiChoice. Исходная точность 2.36% действительно самая низкая среди 24 моделей принятия решений, но её балл за принятие решений 46.36 — не последний: на той же странице есть результаты и ниже, например 34.79 у Mercury Decide. Добавьте сюда 76.1% ответов без галлюцинаций — и напрашивается разумная трактовка: столкнувшись с очень сложным вопросом с множественным выбором на рассуждение, d1.2-ultra, скорее всего, не даст ответ с высокой уверенностью. AA относит этот пункт к рассуждению, поэтому нельзя говорить, что модель «последняя по проверке знаний».
Второй — AA-Omniscience. Точность 23.6% — это 20-е место из 24, а не последнее. Любопытно, что у меньшей d1.2 на той же странице в этом пункте 30.0%, а исходная точность HLE — 5.30%; оба показателя выше, чем у ultra. Но сводный индекс d1.2 — 68.69, 9-е место из 24. Так что вывод «более дорогая ultra знает хуже» применим только к этим двум пунктам, и его нельзя раздувать до «хуже вообще во всём».
🎯 Совет по чтению рейтинга: если ваша задача — извлекать данные из квитанций, первое место
d1.2-ultraв AA-Paperclip стоит воспринимать серьёзно; если речь о вызове инструментов, первое место реально, но разрыв с несколькими следующими моделями — в пределах 1 балла, так что менять ли модель, зависит от вашей собственной выборки.
Как использовать официально заявленные данные d1.2-ultra
В том же посте Liquid приводит пять новых задач и результаты внутренних тестов. Производитель прямо указывает: эти новые задачи пока не покрыты публичными бенчмарками. Поэтому все данные ниже — официальные заявления производителя, полученные на внутреннем отложенном наборе, а не результаты Artificial Analysis.
| Новая задача (по данным производителя) | d1.2-ultra | d1.2 | Примечание |
|---|---|---|---|
| Извлечение данных из чеков (CORD, SROIE) | 98% | 96% | Если значения нет, ответ — not found |
| Точность/полнота выделения фрагментов с чувствительной информацией (Nemotron PII) | 94% / 93% | 92% / 88% | Указывается позиция каждого фрагмента |
| Выделение объектов по описанию (серия RefCOCO) | 94% | 94% | Оба варианта на одном уровне |
| Подсчёт объектов с допуском ±1 (COCO) | 93% | 92% | Оценить число и дать диапазон |
| Выделение каждого объекта на изображении (COCO) | 87% | 90% | В этой строке у более дешёвой d1.2 результат выше |
Что касается аудио, по словам производителя, на отложенных аудиозаписях при определении класса звука (ESC-50) и языка (FLEURS, 43 языка) оба варианта показывают примерно от 95% до 97%. По ошибке калибровки Liquid на 13 бенчмарках и 22505 вопросах получила для d1.2-ultra значение 0.8, для d1.2 — 1.2, для Jev 1.14 — 2.7, для Perplexity Decider v1.3 — 3.7, а для Decisions API модели GPT-6 Luna — 7.2.
Здесь важно чётко разделять: GPT-6 Luna (Decisions) в рейтинге принятия решений Artificial Analysis имеет общий индекс 60.25 и занимает 22-е место из 24, а исходная точность на HLE — 7.86%. Все это результаты интерфейса Decisions, и их нельзя считать результатами чат-интерфейса gpt-6-luna. В официальном блоге также написано: «Coming to OpenRouter and Vercel soon». Это анонс производителя, а не подтверждение того, что сервис уже запущен.
d1.2-ultra: быстрый старт — прогоните свои примеры
Рейтинги рейтингами, но решать, стоит ли переходить, придётся по своим данным. Достаточно подготовить 20–50 реальных примеров: скажем, 30 счетов-фактур или 30 резюме. Для каждого заранее разметьте правильные значения полей, и хорошо бы несколько примеров сделать с намеренно пропущенным полем.
Минимальный набор действий
- Возьмите из рабочего процесса 20–50 примеров и вручную разметьте верные значения каждого поля; отсутствующие поля помечайте как not found.
- Напишите один фиксированный промпт: модель должна выдавать указанные поля в JSON, а всё, что не найдено, обязана заполнять как
not found, без домыслов. - Через OpenAI-совместимый SDK задайте
base_url=https://api.apiyi.com/v1, вmodelсначала подставьтеgpt-6-luna, потом прогоните ещё раз сgpt-6.1-sol. - Сверяйте построчно и фиксируйте три числа: точность на уровне полей, долю полностью верных документов и число случаев, когда отсутствующее поле было заполнено выдумкой.
- Когда целевая модель станет доступна для вызова, прогоните ту же выборку с тем же промптом и сравните три числа напрямую.
Посмотреть полную схему сравнения
— **Вход**: файл с примерами, где каждая строка содержит исходный текст (или изображение) и словарь полей с ручной разметкой.
— **Вызов**: в цикле читаем примеры, вызываем `client.chat.completions.create` или эндпоинт `responses`, ставим `temperature` = 0 и требуем строгий JSON на выходе.
— **Разбор**: неудачные попытки разобрать ответ считаем отдельно — это сам по себе показатель пригодности к работе.
— **Сравнение**: по каждому полю делаем нормализованное сравнение (убираем пробелы, приводим даты к единому формату, суммы оставляем с двумя знаками после запятой).
— **Подсчёт галлюцинаций**: поля, помеченные как not found, но заполненные моделью, отдельно считаем как «догадки».
— **Итог**: выводим точность по полям, долю полностью верных документов, число догадок и средний расход токенов — чтобы потом можно было посчитать деньги.
Сначала запускаем базовый прогон через APIYI
На это уйдут токены. d1.2 и d1.2-ultra отсутствуют в списке моделей APIYI, поэтому пока можно взять уже доступные в APIYI (apiyi.com) gpt-6.1-sol или gpt-6-luna, обращаясь к https://api.apiyi.com/v1, и прогнать на них ту же партию счетов-фактур или резюме: проверить, верны ли поля и не начинает ли модель выдумывать значения для отсутствующих полей. Так у вас появится измеримая базовая линия.
Модель пока не добавлена в каталог — мы как можно скорее это исправим; актуальные модели и цены смотрите в списке моделей на платформе.
| Пункт самопроверки | Как фиксировать | Критерий оценки |
|---|---|---|
| Точность полей | число правильных полей / общее число полей | сравнить с текущей рабочей моделью |
| Доля полностью верных документов | доля документов, где все поля верны | соответствует «доле полностью верных документов» из AA-Paperclip |
| Число выдумываний | сколько раз полям со значением not found было присвоено значение | чем меньше, тем лучше — в духе борьбы с галлюцинациями |
| Ошибки парсинга | количество записей, которые не удалось разобрать как JSON | напрямую влияет на затраты при запуске |
| Расход токенов | среднее количество входных и выходных токенов на одну запись | для пересчёта реальной стоимости |
🚀 Совет для старта: сначала прогоните 20 записей на бесплатном тестовом лимите для новых пользователей APIYI apiyi.com, убедитесь, что промпт и скрипт сравнения работают нормально, а затем расширьте до 50 записей — так вы не потратите лимит на отладку в самом начале.
d1.2-ultra: цена и способ вызова
С ценами важно не путать единицы. 133 доллара в рейтинге — это стоимость прогона «за миллион задач», а официальная цена Liquid — «за миллион входных токенов»: d1.2 — 0.02 доллара, d1.2-ultra — 0.042 доллара, и считается только вход. Изображения тарифицируются из расчёта 1.5 токена на каждые 32×32 пикселя по цене текста; для 1024×1024 это примерно 1536 токенов. Текст и изображения в одном запросе считаются один раз, а за каждый дополнительный вопрос добавляется только текст этого вопроса.
Официальный способ вызова тоже отличается от привычных чат-интерфейсов: ID моделей — d1.2-ultra и d1.2, адрес — https://api.liquid.ai/decisions/v1/systemone, ключ выдаётся в консоли Liquid. В официальном блоге упоминаются текстовый, графический и аудиовход; в технических характеристиках на странице Artificial Analysis указаны текст и изображения, контекст 66k. Это число контекстного окна встречается только на странице рейтинга, а не в спецификациях, опубликованных в блоге Liquid.
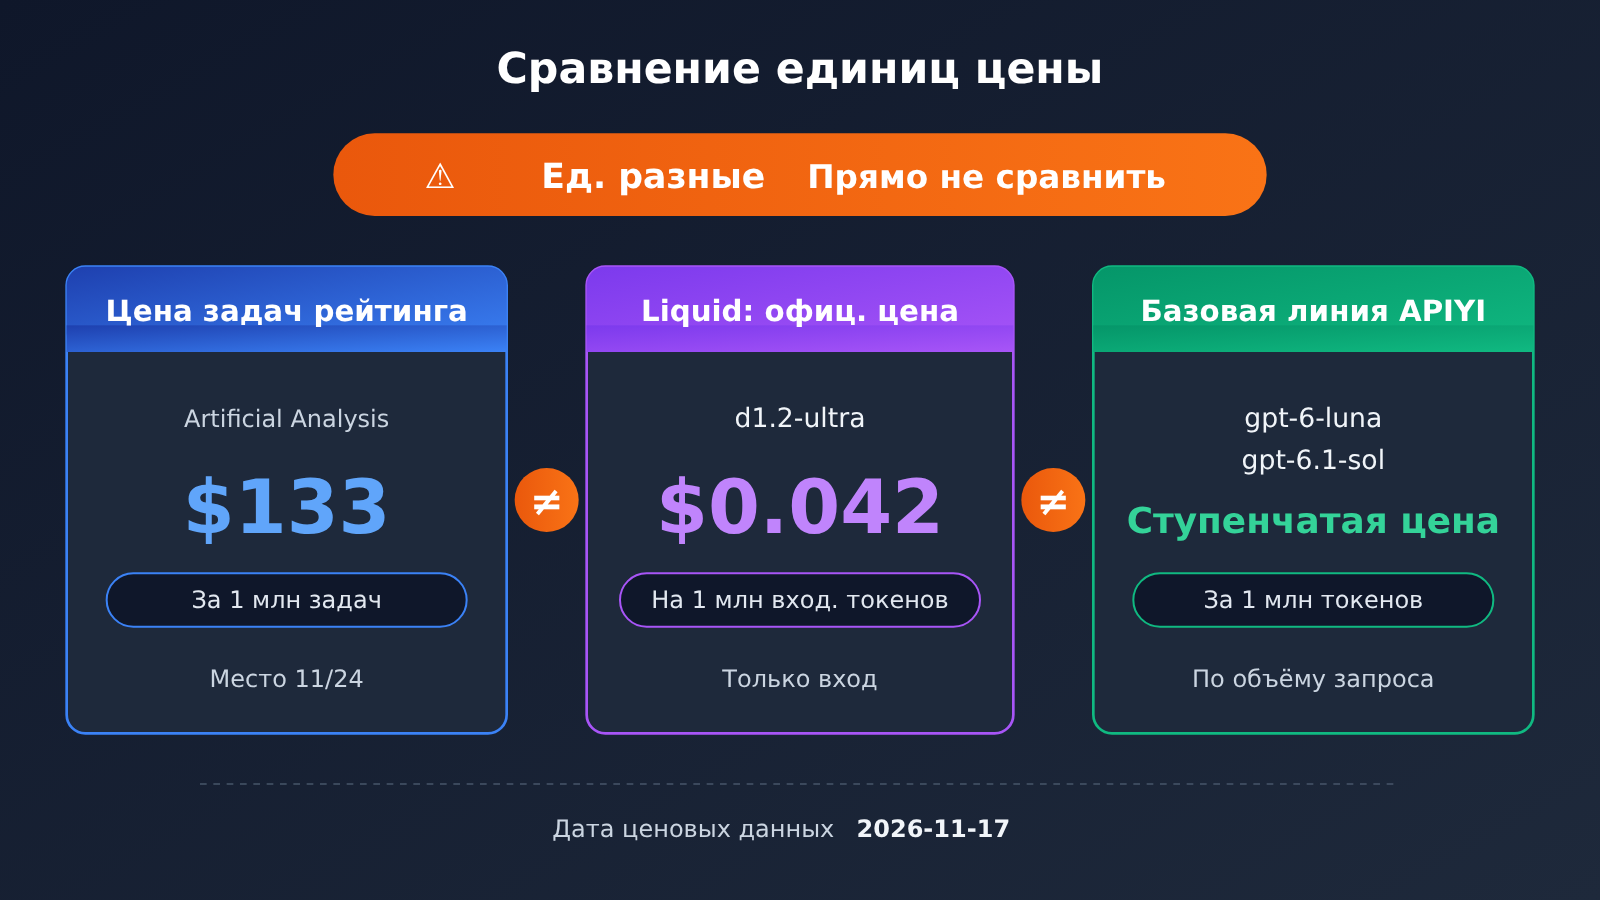
Цены моделей APIYI, использованных для базовой линии, приведены ниже (в долларах за миллион токенов, с разбивкой по объёму токенов в одном запросе; данные из интерфейса прайс-листа от 2026-11-17, согласуются с обновлением сводной таблицы моделей от 2026-11-16):
| Модель | Тарифный диапазон | Вход | Выход | Чтение кеша | Эндпоинт |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses — приоритетный, также доступен chat |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | не указано отдельно | то же |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses — приоритетный, также доступен chat |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | не указано отдельно | то же |
💰 Подсказка по стоимости: для сравнения на 50 примерах
gpt-6-lunaподходит, чтобы сначала набрать объём, аgpt-6.1-sol— как качественный ориентир. Пополнение APIYI apiyi.com считается по курсу 1:7, групповые скидки суммируются, фактическое списание — по данным консоли.
Частые вопросы (FAQ)
Q1: Что за модель d1.2-ultra?
Это модель принятия решений, выпущенная Liquid AI 16.11.2026 одновременно с более компактной d1.2. Особенность таких моделей — они выдают вероятность по каждому варианту и хорошо справляются с задачами «выбора»: извлечение данных из документов, оценка необходимости вызова инструментов, классификация. А вот длинные тексты они не пишут.
Q2: d1.2-ultra первая в общем зачёте — значит, она сильнее всех по всем пунктам?
Нет. Сводный индекс 74.85 — это 1-е место из 24, но в EvalSafe-O\*NET-AA она 3-я, по доле полных прохождений AA-Symmetry — 5-я, по исходной точности AA-Omniscience — 20-я, а исходная точность HLE-MultiChoice у неё самая низкая среди всех 24. Сводный балл говорит лишь о лидерстве после взвешивания.
Q3: Можно ли считать, что по HLE-MultiChoice она последняя в тесте на знания?
Нет. Последняя — как раз исходная точность HLE-MultiChoice, 2.36%, и это исходная точность среди 24 моделей принятия решений; её балл по решениям 46.36 вовсе не на дне, к тому же AA относит этот пункт к рассуждениям, а не к знаниям.
Q4: Для каких задач d1.2-ultra подходит лучше всего?
Судя по странице рейтинга, точнее всего совпадают извлечение полей из счетов, резюме и научных статей (у AA-Paperclip и балл по решениям, и доля полностью верных ответов — первые) и оценка вызова инструментов (When2Call — 1-е место, но разрыв с ближайшими лидерами около 1 балла). А вот на сложных вопросах с выбором варианта и в викторинах на знания её исходная точность не впереди.
Q5: Можно ли уже сейчас вызывать d1.2-ultra через APIYI?
Пока d1.2 и d1.2-ultra отсутствуют в списке моделей APIYI. Мы ещё не выложили их, но скоро добавим эту модель; актуальные модели и цены — по списку моделей на платформе. Рекомендуем сначала на APIYI apiyi.com прогнать `gpt-6-luna` или `gpt-6.1-sol` и получить базовую линию на своих samples, а потом просто сменить модель и сравнить.
Q6: Можно ли верить калибровочной ошибке 0.8, которую опубликовала Liquid?
Это собственные тесты Liquid на 13 бенчмарках и 22505 вопросах — то есть официальные данные от самой компании. Перекрёстно на странице рейтинга подтверждается только то, что Brier 0.150 — самый низкий среди 24, направление совпадает. Но применительно к вашему бизнесу всё равно стоит проверить на своих samples, действительно ли модель реже «гадает наугад».
Q7: 7.2 у GPT-6 Luna и `gpt-6-luna` на APIYI — это одно и то же?
Нет, это разные вещи. 7.2 — калибровочная ошибка Decisions API модели GPT-6 Luna в тестах Liquid, и балл 60.25 в рейтинге — тоже результат интерфейса Decisions. А `gpt-6-luna`, который предоставляет APIYI, — это чат-интерфейс, и его качество нужно измерять на своих samples.
Q8: сколько примеров действительно нужно?
20–50 примеров достаточно, чтобы увидеть заметную разницу. Главное — покрыть реальное распределение: должны быть и частые форматы, и редкие, и примеры с пропущенными полями. Если на 50 примерах две модели расходятся всего на один-два пункта, то менять или не менять — особой разницы нет; смотрите в первую очередь на цену и задержку.
d1.2-ultra: ключевые выводы
- Общий балл 75 — лишь отправная точка: 74.85 и 1-е место из 24, отрыв от второго места около 2.2 балла. Это не значит, что модель первая в каждой категории.
- Для извлечения данных из документов смотрите на AA-Paperclip: балл за принятие решений 75.81 и доля полностью правильных ответов 67.7% — оба показателя первые.
- Для вызова инструментов смотрите на When2Call: 96.49 и 1-е место, но несколько лидеров умещаются в пределах примерно 1 балла.
- Для сложных задач смотрите на исходную точность: у HLE-MultiChoice самый низкий результат — 2.36%, но по баллу за принятие решений модель не последняя; AA помечает её как reasoning-модель.
- Для вопросов на знания смотрите на точность Omniscience: 23.6%, 20-е место из 24 — не последнее.
- Не путайте единицы измерения: 133 доллара — за миллион задач, 0.042 доллара — за миллион входных токенов.
- Принимайте решения по выборке: сначала на APIYI apiyi.com прогоните 20–50 примеров на доступных моделях и фиксируйте точность по полям и количество случайных догадок.
Итог
Чтобы разобраться в лидерборде d1.2-ultra, важны три шага:
- Запишите тип задачи: извлечение данных из документов, вызов инструментов, решение сложных задач или ответы на вопросы по знаниям — смотрите только на те метрики, что имеют к этому отношение.
- Различайте две цифры: балл решений поощряет принцип «не уверен — не гадай», а сырая точность показывает, «сколько удалось угадать». Выбирайте, на что смотреть, исходя из бизнес-задачи.
- Принимайте решение на своих примерах: 20–50 размеченных реальных образцов скажут больше, чем любой сводный балл.
Если ваша задача — именно извлечение данных из документов, d1.2-ultra стоит добавить в шорт-лист. Если же речь о решении сложных задач или ответах на вопросы по знаниям, не спешите переключаться только из-за первого места в общем рейтинге. Рекомендую уже сейчас на APIYI apiyi.com собрать бейзлайн на gpt-6-luna и gpt-6.1-sol, а когда целевая модель станет доступна — сравнить в один клик.
📚 Справочные материалы
-
Официальный блог Liquid AI — релиз d1.2: информация о релизе, официальные цены и собственные результаты тестов
- Ссылка:
liquid.ai/blog/d1-2 - Пояснение: точность на новых задачах и ошибка калибровки — по данным самой компании
- Ссылка:
-
Документация Liquid AI по моделям принятия решений: ID моделей и адреса вызова
- Ссылка:
docs.liquid.ai/lfm/models/decision-models - Пояснение: официальное описание способа вызова
- Ссылка:
-
Artificial Analysis — страница модели d1.2-ultra: сводный индекс и отдельные метрики
- Ссылка:
artificialanalysis.ai/decision-models/d1-2-ultra - Пояснение: данные лидерборда в этой статье считаны 2026-11-17
- Ссылка:
-
Artificial Analysis — страница методологии Decision Index: веса и определения оценок
- Ссылка:
artificialanalysis.ai/methodology/decision-index - Пояснение: разница между баллом решений и сырой точностью
- Ссылка:
-
Общий список моделей APIYI: доступные модели и цены
- Ссылка:
docs.apiyi.com/models - Пояснение: модели и цены — по списку моделей на платформе
- Ссылка:
Автор: техническая команда APIYI
Техническая связь: если есть вопросы по выбору модели или скрипту сравнения — свяжитесь с нами на главной странице сайта APIYI; подробнее о подключении — в центре документации


