
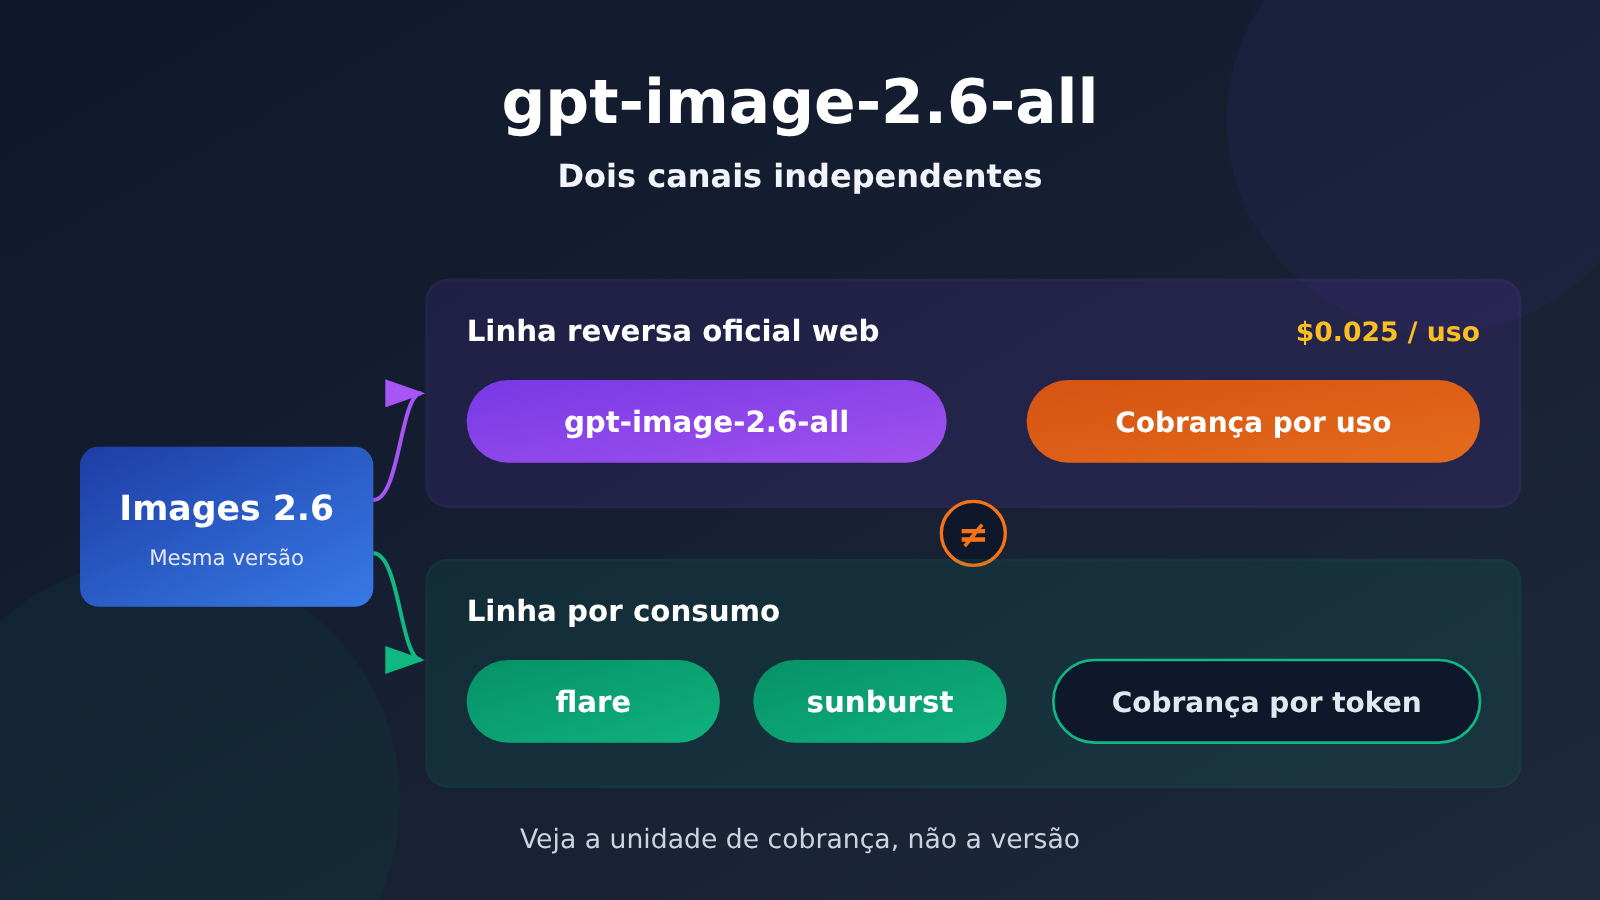
gpt-image-2.6-all entrou no ar na noite de 2026-11-11, às 20h30. O all no nome levou muita gente a pensar logo de cara: “então juntaram toda a família 2.6 num modelo só?”. Não é bem isso. A nota de lançamento da APIYI (apiyi.com) deixa claro que ele corresponde à linha de engenharia reversa oficial (a “官逆”) do Images 2.6 da versão web do ChatGPT. Ou seja, usa a mesma lógica de chamada do site, e é um canal independente da linha de cobrança por uso que o flare e o sunburst utilizam.
Isso não é só mais um número de versão. O flare e o sunburst são outra linha do 2.6 e cobram por token. Já o all cobra por requisição: US$ 0,025 cada. Quando o critério de cobrança é diferente, é sinal de que por baixo não há o mesmo serviço.
Valor principal: depois deste artigo, você consegue usar 4 parâmetros para descobrir em 30 segundos a que linha pertence o nome de modelo que tem em mãos. Assim, não corre o risco de calcular o custo do all (por requisição) como se fosse o flare (por uso).
gpt-image-2.6-all: resumo das informações principais
Vamos colocar na mesa o que importa do comunicado, para evitar confusão por causa dos nomes parecidos.
| Item | Detalhes | Observação |
|---|---|---|
| Data de lançamento | 2026-11-11 20:30 | Horário da publicação do comunicado; data dos dados: 2026-11-12 |
| Linha | Linha de engenharia reversa oficial do Images 2.6 da versão web do ChatGPT | Mesma lógica de chamada da versão web |
| Cobrança | Por requisição, US$ 0,025 / requisição | Não depende do consumo de tokens |
| Parâmetros de requisição suportados | size, n, background, output_format | Novidade em relação ao 2.5-all |
| Outros modelos da família | gpt-image-2.6-flare, gpt-image-2.6-sunburst | Pertencem à linha de cobrança por uso |
| Plataforma disponível | APIYI apiyi.com | Chamada por interface unificada |
Vale explicar melhor o termo “官逆” (engenharia reversa oficial). Ele se refere a uma linha de chamada obtida ao reproduzir, por engenharia reversa, a interface oficial da versão web. A estrutura das requisições segue a do site, então os parâmetros que dá para controlar na versão web normalmente também dá para controlar nessa linha. Isso explica por que o all tem mais parâmetros que o 2.5-all: ele acompanha o comportamento da versão web, e não as convenções de parâmetros da linha por uso.
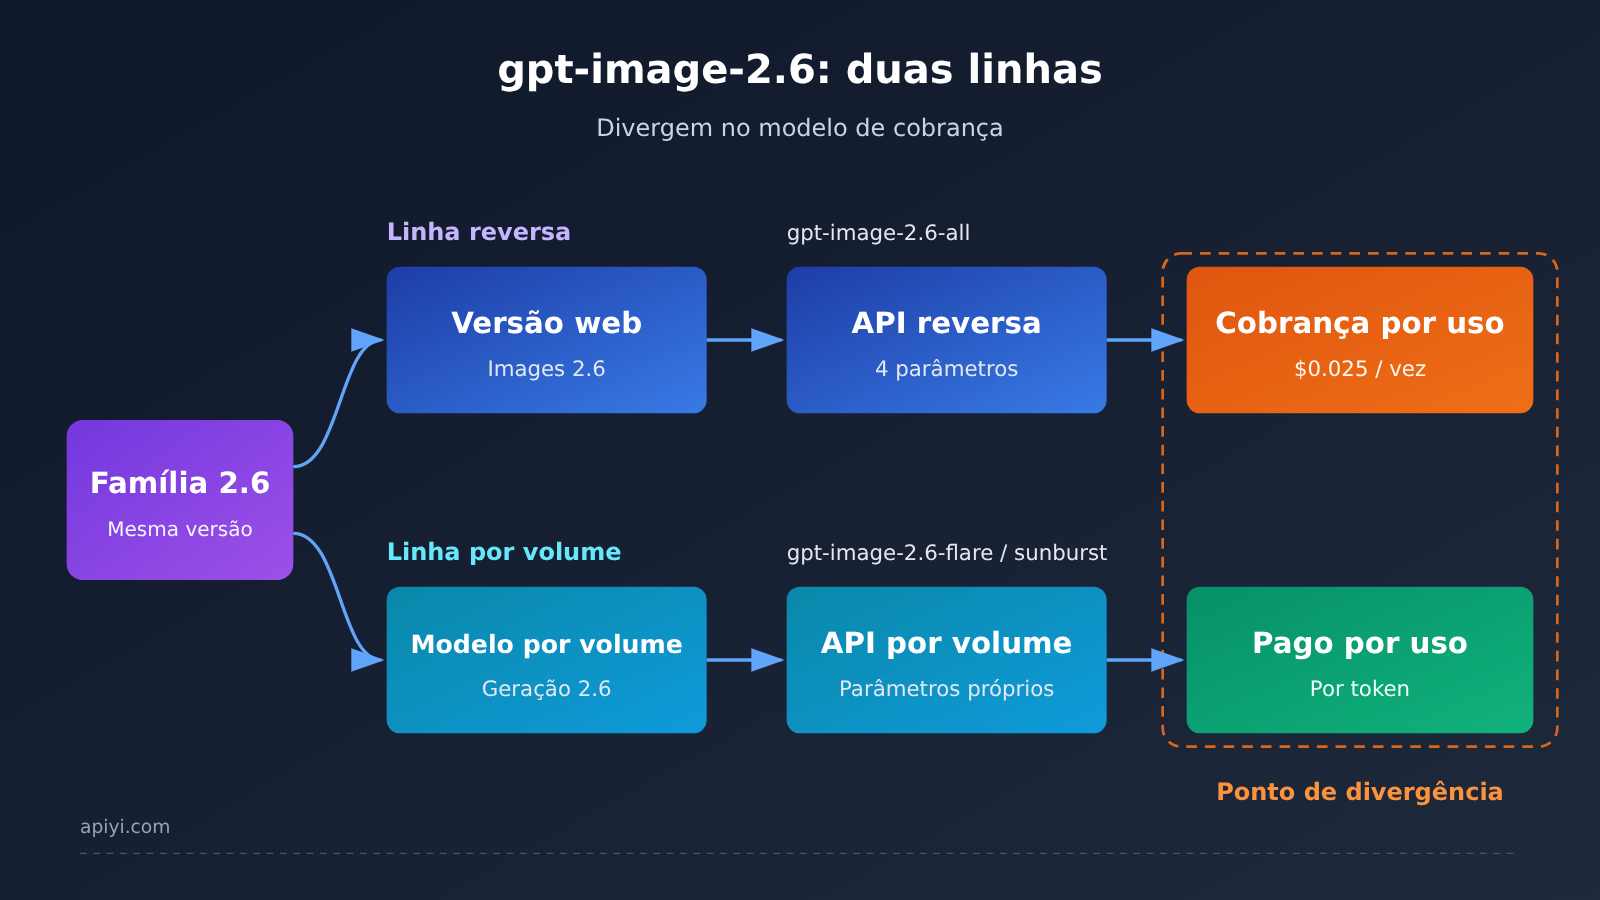
Sobre a figura: o ponto em que as duas linhas se separam é o critério de cobrança, e não o número da versão do modelo. Para conferir a qual linha cada modelo pertence, compare item por item com a nota de lançamento da APIYI em apiyi.com.
Diferenças-chave entre gpt-image-2.6-all e Flare
O erro mais comum é tratar o 2.6 como um bloco único. Quando você separa por linha de acesso, as diferenças se concentram em três pontos.
| Dimensão | gpt-image-2.6-all | gpt-image-2.6-flare / sunburst |
|---|---|---|
| Natureza da linha | Linha de engenharia reversa da versão web oficial | Linha por consumo |
| Unidade de cobrança | Por chamada, $0,025 / chamada | Cobrança por volume de tokens |
| Controle de parâmetros | Suporta size, n, background, output_format | Segue as convenções de parâmetros da própria linha por consumo |
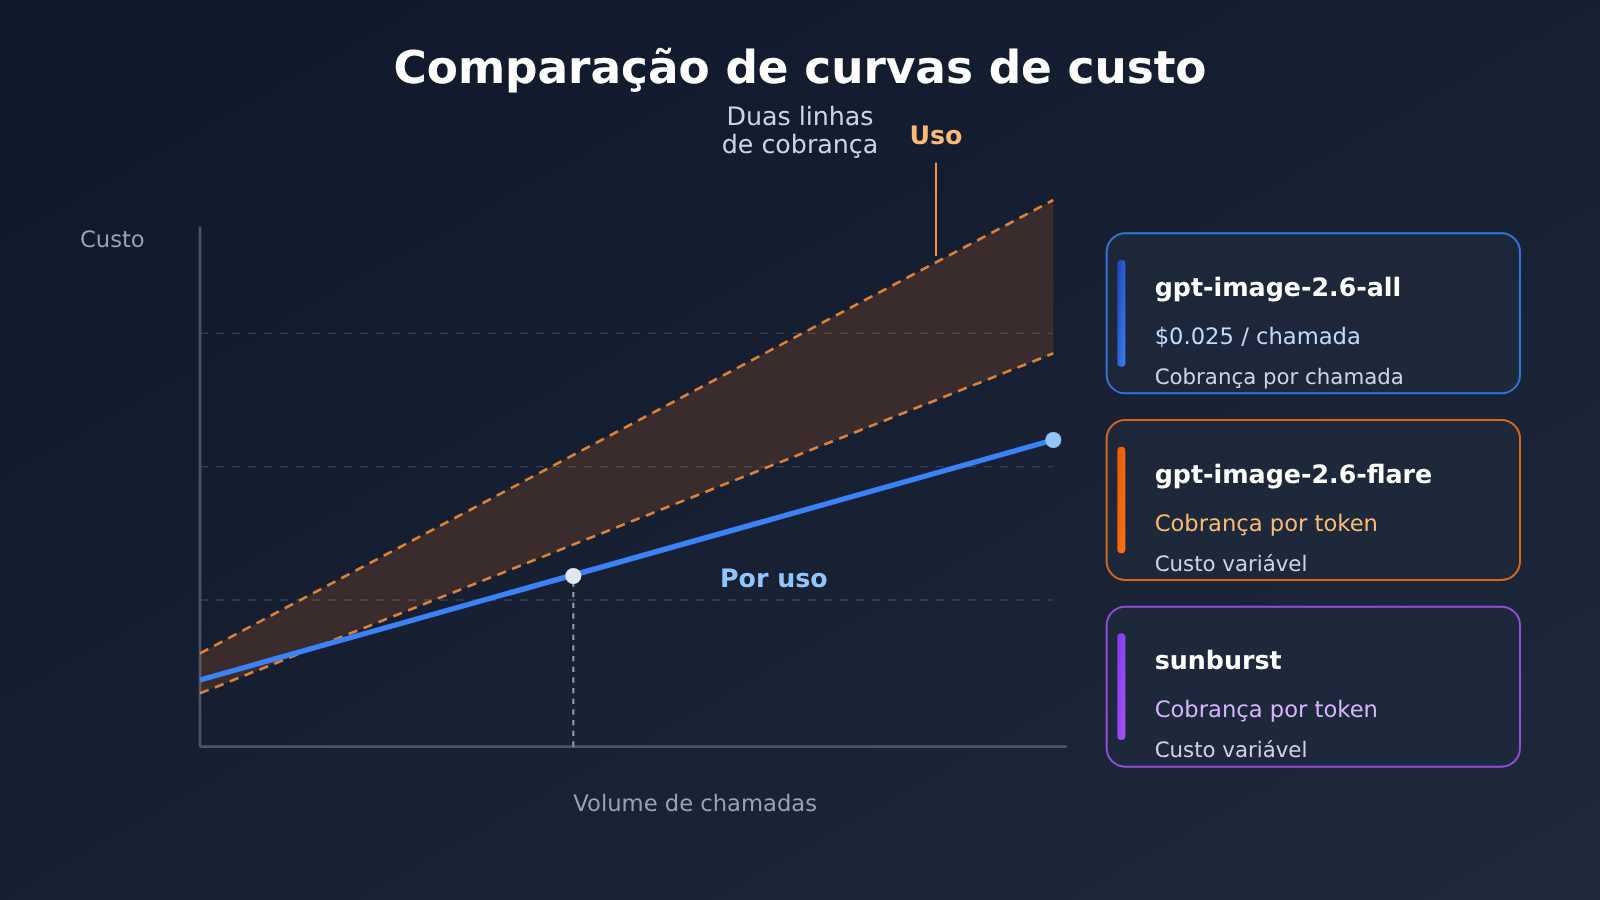
| Variação do custo conforme o uso | Linear, acompanha o número de chamadas | Acompanha o volume real de tokens consumidos |
| Melhor forma de calcular | Orçamento por quantidade de imagens | Orçamento por volume de tráfego |
O gpt-image-2.6-flare é mais flexível na cobrança por consumo, e combina bem com cenários em que o volume de requisições oscila bastante e dá para aceitar um custo que varia conforme o tamanho do conteúdo. Em compensação, o custo dele não segue o número de imagens, então na hora de montar o orçamento você precisa estimar antes o consumo de tokens. Já o gpt-image-2.6-all é mais direto em previsibilidade de custo: 1000 chamadas custam exatamente o preço de 1000 chamadas, sem nenhuma conversão extra.
Essa diferença cresce nos cenários em lote. Num projeto com cobrança por chamada, dá para colocar o custo unitário por imagem direto na proposta comercial. Num projeto com cobrança por consumo, é preciso rodar uma amostra primeiro e projetar o custo a partir dela. Nenhum dos dois é melhor que o outro: o que importa é se o método de cálculo se encaixa no seu modelo de negócio.
💡 Dica de escolha: se você não sabe a qual linha o modelo que tem em mãos pertence, olhe primeiro a unidade de cobrança, e não o número da versão. Na lista de modelos do APIYI (apiyi.com), dá para ver os pontos de acesso das duas linhas ao mesmo tempo, o que facilita validar as duas em paralelo.
O que os 4 parâmetros do gpt-image-2.6-all revelam
Aquela frase do comunicado, “diferente do 2.5-all, ele aceita size, n, background e output_format”, diz mais do que parece.
| Parâmetro | Função | Valor para a análise |
|---|---|---|
size |
Define o tamanho da saída | As proporções disponíveis na versão web podem ser reproduzidas na camada da API |
n |
Retorna várias imagens em uma única requisição | Uma única chamada gera imagens em lote, o que compensa mais com a cobrança por chamada |
background |
Controla como o fundo é tratado | O interruptor-chave para quem precisa de fundo transparente |
output_format |
Define o formato de saída | Decide diretamente se você vai precisar converter o arquivo depois |
Esses 4 parâmetros são todos de “controle no momento da requisição”: você diz ao servidor o que quer na hora de fazer o pedido, em vez de tratar o resultado depois. A linha de cobrança por uso (pay-as-you-go) normalmente também tem o seu próprio conjunto de parâmetros, mas não é esse. Então, se um modelo suporta esses 4 parâmetros, dá para concluir com bastante segurança que ele roda na linha de engenharia reversa da versão web oficial.
Por outro lado, o fato de o 2.5-all não suportar esses 4 parâmetros mostra que a cobertura de parâmetros dessa linha vai sendo completada aos poucos, conforme a versão web evolui. A geração 2.6 preencheu essa lacuna. O “all” no nome significa que a capacidade de parâmetros está completa, e não que todos os modelos foram unificados em um só.
🎯 Dica técnica: adicione uma camada de validação de parâmetros no seu próprio serviço e use
size,n,backgroundeoutput_formatcomo critério de roteamento. Assim, as requisições vão automaticamente para a linha certa. O APIYI (apiyi.com) oferece uma interface compatível com a OpenAI, então para trocar de modelo basta alterar o campomodel.
Como chamar o gpt-image-2.6-all
A chamada não tem nenhuma diferença em relação à interface de imagens convencional: basta apontar o base_url para o endereço unificado. O ponto principal é escrever o nome do modelo corretamente.
- Endereço da interface:
https://api.apiyi.com/v1 - Nome do modelo:
gpt-image-2.6-all - Parâmetros recomendados:
size,n,background,output_format
São esses campos do corpo da requisição que refletem a diferença entre as linhas. Se o servidor devolver um erro de parâmetro não suportado, em geral o nome do modelo foi escrito como flare ou sunburst, mas a requisição está usando a combinação de parâmetros da versão web.
🚀 Início rápido: o APIYI (apiyi.com) oferece crédito gratuito para testes. Depois de se cadastrar, você já recebe sua chave API. Troque o
base_urlporhttps://api.apiyi.com/v1, use o mesmo trecho de código para alternar entre all e flare e compare. Em poucos minutos dá para confirmar qual linha se encaixa melhor na sua estrutura de custos.
O que o lançamento do gpt-image-2.6-all muda para os desenvolvedores
Esse lançamento tem impacto em três frentes.
- O cálculo de custo mudou: com a cobrança de $0,025 por chamada, o custo por imagem vira uma constante. O orçamento de projetos em lote sai direto de uma multiplicação, sem precisar rodar uma amostra para estimar tokens. Para equipes que precisam passar orçamento a clientes, isso é mais útil do que qualquer parâmetro de desempenho.
- Parâmetros alinhados com a versão web: com
size,n,backgroundeoutput_formatdisponíveis, quase todos os controles da versão web podem ser reproduzidos na camada da API. Isso reduz aquela frustração de “na web dá para ajustar, pela API não”. - Identificar a linha virou obrigação: dentro da mesma geração do modelo agora existem duas linhas, uma cobrada por chamada e outra por uso. O sufixo no nome do modelo é o único critério para distinguir uma da outra. Registrar só o número da versão na gestão de configurações já não basta.
Um detalhe fácil de passar despercebido: quando o parâmetro n se combina com a cobrança por chamada, o custo unitário de gerar várias imagens em uma única chamada cai ainda mais. Isso não altera o critério de cobrança, mas muda a estratégia de quantas imagens vale a pena pedir por requisição.
💰 Otimização de custos: em projetos sensíveis a orçamento, vale primeiro usar o crédito gratuito do APIYI (apiyi.com) para validar toda a cadeia de chamadas e depois projetar o gasto mensal a partir do número real de imagens. Isso chega mais perto do custo verdadeiro do que estimar com base na tabela de preços.
gpt-image-2.6-all: perguntas frequentes (FAQ)
P1: Afinal, o que é o gpt-image-2.6-all?
É um modelo da linha “官逆” (engenharia reversa do fluxo oficial) do Images 2.6 da versão web do ChatGPT, com cobrança por chamada: US$ 0,025 por requisição. O `all` no nome indica que o conjunto de parâmetros é completo, e não que ele junta toda a família de modelos.
P2: Qual a diferença entre o gpt-image-2.6-all e o gpt-image-2.6-flare?
Mudam tanto a linha de acesso quanto a forma de cobrança. O all usa a linha de engenharia reversa da versão web e cobra por chamada. Já o flare e o sunburst fazem parte da linha cobrada por uso, com preço calculado pela quantidade de tokens. Eles não são níveis diferentes do mesmo modelo, e sim dois canais independentes.
P3: Por que o all aceita size, n, background e output_format?
Porque ele reproduz a estrutura de requisição da interface da versão web. O que dá para controlar na web, a linha de engenharia reversa geralmente também consegue controlar. O 2.5-all não tinha esse conjunto de parâmetros, o que mostra que a cobertura vai sendo completada conforme a versão web evolui.
P4: Em que cenários a cobrança por chamada faz mais sentido?
Ela é ideal quando dá para estimar o número de chamadas e o custo de cada imagem precisa entrar no orçamento. Já a cobrança por uso combina mais com projetos de tráfego muito variável, em que o custo pode oscilar conforme o conteúdo gerado.
P5: Como chamar o gpt-image-2.6-all rapidamente?
Cadastre-se em uma plataforma que suporte o modelo e pegue sua chave API. Depois, defina o `base_url` como `https://api.apiyi.com/v1` e use `gpt-image-2.6-all` como nome do modelo. O APIYI (apiyi.com) oferece uma interface compatível com a OpenAI e créditos gratuitos para testes. Com o mesmo código, basta trocar o campo `model` para comparar o all com o flare.
P6: Há algo a que prestar atenção nesse lançamento?
O ponto principal é não tratar o `2.6` como um bloco único. Na mesma geração convivem uma linha cobrada por chamada e outra cobrada por uso, então guardar só o número da versão na configuração pode causar erros no cálculo de custos. Além disso, o anúncio traz informações concentradas em três pontos: a qual linha o modelo pertence, os parâmetros e a cobrança. Para os demais detalhes, vale seguir a documentação que vier depois.
gpt-image-2.6-all: Pontos-chave (Key Takeaways)
- Origem da linha: corresponde à linha de engenharia reversa oficial do Images 2.6 da versão web do ChatGPT, e não à linha de cobrança por uso (por token).
- Modelo de cobrança: cobrança por chamada, a US$ 0,025 cada, sem relação com o consumo de tokens.
- Parâmetros suportados: aceita
size,n,backgroundeoutput_format, o que o 2.5-all não suporta. - Diferença entre os modelos da mesma família: flare e sunburst pertencem a outra linha, cobrada por uso, com um modelo de cobrança totalmente diferente.
- Como identificar: olhar a unidade de cobrança e a combinação de parâmetros é mais confiável do que olhar o número da versão.
- Como começar: pela interface unificada do APIYI (apiyi.com), basta apontar o
base_urlparahttps://api.apiyi.com/v1para validar.
Resumo
Sobre o gpt-image-2.6-all, são só três coisas para guardar:
- É a linha de engenharia reversa da versão web, não o Flare: ele e os modelos flare e sunburst pertencem a dois canais diferentes, não são níveis distintos do mesmo modelo.
- Cobrança por chamada, não por uso: US$ 0,025 por chamada, com o custo variando de forma linear conforme o número de chamadas. Isso deixa o orçamento bem mais fácil de calcular do que na linha cobrada por uso.
- Os 4 parâmetros são o critério de identificação: se
size,n,backgroundeoutput_formataparecem nas capacidades do modelo, dá para ter quase certeza de que ele está na linha de engenharia reversa da versão web.
Mesma versão não significa mesma linha. Da próxima vez que você vir um nome de modelo começando com 2.6 na sua configuração, confirme primeiro o modelo de cobrança e só depois decida onde ele deve ficar.
Se quiser comparar o desempenho real das duas linhas lado a lado, recomendo validar rapidamente pelo APIYI (apiyi.com). A plataforma oferece crédito gratuito e uma interface unificada para vários modelos, então basta trocar o campo model para alternar entre eles.
Referências
- Notas de lançamento da APIYI – gpt-image-2.6-all no ar: fonte original sobre a origem da rota, os parâmetros suportados e os critérios de cobrança
- Link:
docs.apiyi.com/live/2026-11/gpt-image-2-6-all-launch -
Descrição: traz a data de lançamento, o preço por chamada e informações sobre os modelos da mesma família. Dados de 12/11/2026
-
Lista de modelos da APIYI: permite consultar os modelos disponíveis e os pontos de acesso para invocação
- Link:
apiyi.com - Descrição: usada para conferir a qual rota pertencem o all, o flare e o sunburst
Autor: Equipe técnica da APIYI
Contato técnico: fale com a gente na página inicial do site da APIYI, apiyi.com. Mais materiais estão disponíveis na central de documentação, docs.apiyi.com


