Claude Fable 5.2 출시, 역량은 어디에서 향상됐나?

img-a90e44e752198ab4a83c483b

Anthropic은 2026년 11월 9일 Claude Fable 5.2를 정식 출시했어요. 공식 성능표와 제3자 평가 순위 모두에서 5.1보다 어려운 작업과 장기 협업 능력이 눈에 띄게 향상된 것으로 나타났어요. 표준 API 가격도 5.1보다 20% 저렴해졌습니다. 핵심 가치: 이 글은 ‘결론부터 짚고, 근거를 살펴본 다음, 한계를 확인하는’ 순서로 Claude Fable 5.2가 어떤 점에서 얼마나 뛰어난지, 그리고 지금 여러분의 작업에 … 더 읽기
코드 생성률은 30%를 넘었지만 납품 속도는 크게 빨라지지 않았다: 7% 상한선 뒤에 숨은 5가지 병목

img-34bc2223fe210534218bb56c

저자 주: AI 코드 생성 비율이 30%를 넘었다고 해서 납품 속도가 빨라지는 것은 아니에요. 이 글에서는 ‘이론적 상한 7%’가 어떻게 도출됐는지 살펴보고, 프로세스의 병목 5가지와 팀 자체 점검 체크리스트를 소개합니다. 결론부터 말하면 AI 코드 생성 비율은 납품 속도와 같지 않아요. AI가 생성한 코드의 비율이 한 자릿수에서 30% 이상으로 늘어도 생산성이 높아지는 건 ‘코딩’ 단계뿐이에요. 전체 … 더 읽기

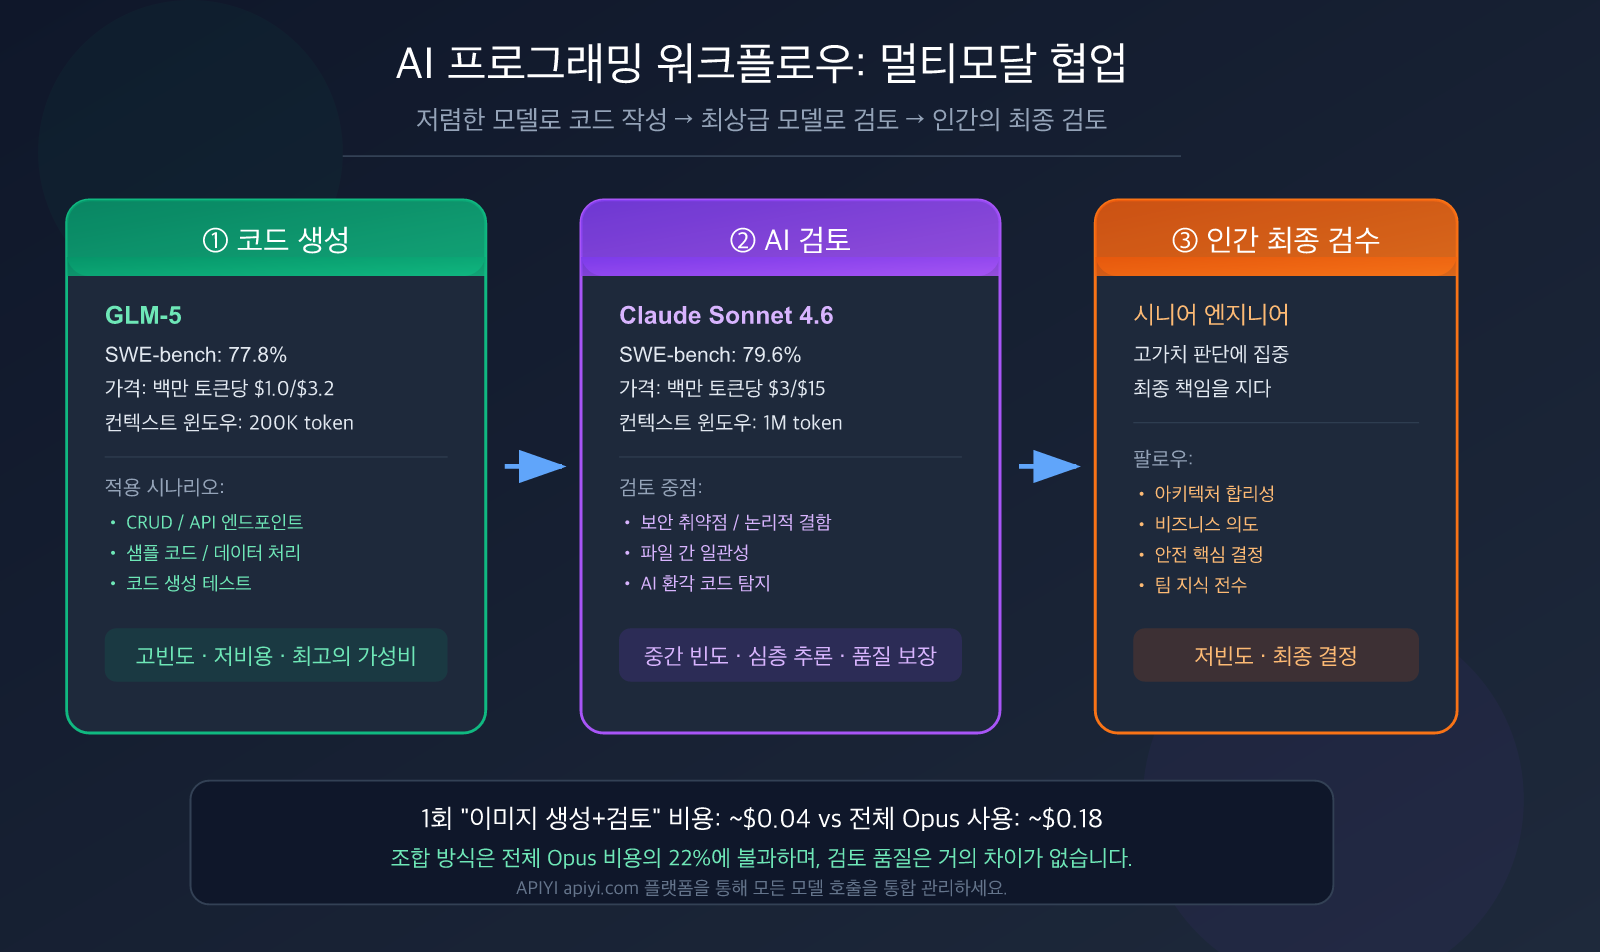
AI 프로그래밍 워크플로우 혁신: GLM-5로 코드 작성 + Claude Sonnet 4.6으로 검토하는 6단계 실전 가이드

ai coding workflow cheap generate premium review best practices ko image 0 图示

2026년, 92%의 개발자가 이미 AI 프로그래밍 도구를 사용하고 있으며, 전체 코드의 41%가 AI의 도움으로 생성되고 있습니다. 하지만 당혹스러운 현실이 하나 있습니다. 바로 개인이 체감하는 시간 절감 효과는 30~60%에 달하지만, 조직의 실제 생산성 향상은 약 10%에 불과하다는 점입니다. 이 격차는 어디서 발생할까요? 바로 '워크플로우'입니다. 적절한 모델 조합과 워크플로우를 사용하면 AI 프로그래밍은 10배의 효율을 내는 부스터가 되지만, … 더 읽기

GPT-5.4 vs GPT-5.3 Codex 프로그래밍 능력 실측 비교: 6가지 벤치마크 테스트로 밝혀낸 최강 프로그래밍 모델

gpt 5 4 vs gpt 5 3 codex coding comparison benchmark guide ko image 0 图示

작가의 말: GPT-5.4와 GPT-5.3 Codex의 코딩 능력을 깊이 비교하고, SWE-Bench, Terminal-Bench 등 6가지 벤치마크 테스트 데이터를 통해 가장 적합한 코딩 모델을 선택하는 데 도움을 드립니다. GPT-5.4가 막 출시되었는데, 많은 개발자들의 첫 번째 질문은 이겁니다: 저는 아직도 GPT-5.3 Codex를 사용해야 할까요? 결국 GPT-5.4는 "프로그래밍, 추론, 컴퓨터 제어 능력을 융합한 최초의 통합 모델"이라고 주장하는 반면, GPT-5.3 Codex는 … 더 읽기