
著者注:d1.2-ultra は Decision Index v2.1 で 1 位に表示されます。この記事では、自分の仕事が伝票抽出なのか、ツール呼び出しなのか、それとも難しい問題への回答なのかをまず見極め、該当するサブスコアだけを確認し、そのうえで自社の 20〜50 件のサンプルを使って乗り換えるかどうかを判断する方法を解説します。
2026-11-16、Liquid AI は d1.2 と d1.2-ultra を発表しました。公式ブログによると、d1.2-ultra は Artificial Analysis Decision Index v2.1 でスコア 75 を記録し、意思決定モデルの中で最高とのことです。「1 位」という文字を見た多くの開発者は、API を叩いている最中ならなおさら、真っ先に本番モデルを交換しようと考えます。でも、焦って乗り換えるのは待ってください。総合スコア 75 はあくまで入口にすぎず、本当に見るべきなのは自分の業務に合致するサブスコアです。
これは、けなす記事でも持ち上げる記事でもありません。 同じモデルが、伝票抽出では 1 位なのに、難易度の高い多肢選択問題では生の正解率が 24 の意思決定モデルの中で最下位になります。この二つは同時に成り立ち、総合スコアはその差をならしてしまいます。
この記事の核心:読み終えるころには、どのサブスコアを見るべきか、意思決定スコアと生の正解率をどう読むか、そして自社の 20〜50 件のサンプルで午後ひとつ分の時間内に乗り換えるかどうかの結論を出す方法がわかります。
d1.2-ultra が総合 1 位になるための核心ポイント
まずはランキングページに載っている数字を整理しておきましょう。以下のデータは Artificial Analysis の d1.2-ultra モデルページから取得したもので、読み取り日は 2026-11-17、比較対象となった意思決定モデルは計 24 個です。
| 項目 | ランキングページのデータ | 読み方 |
|---|---|---|
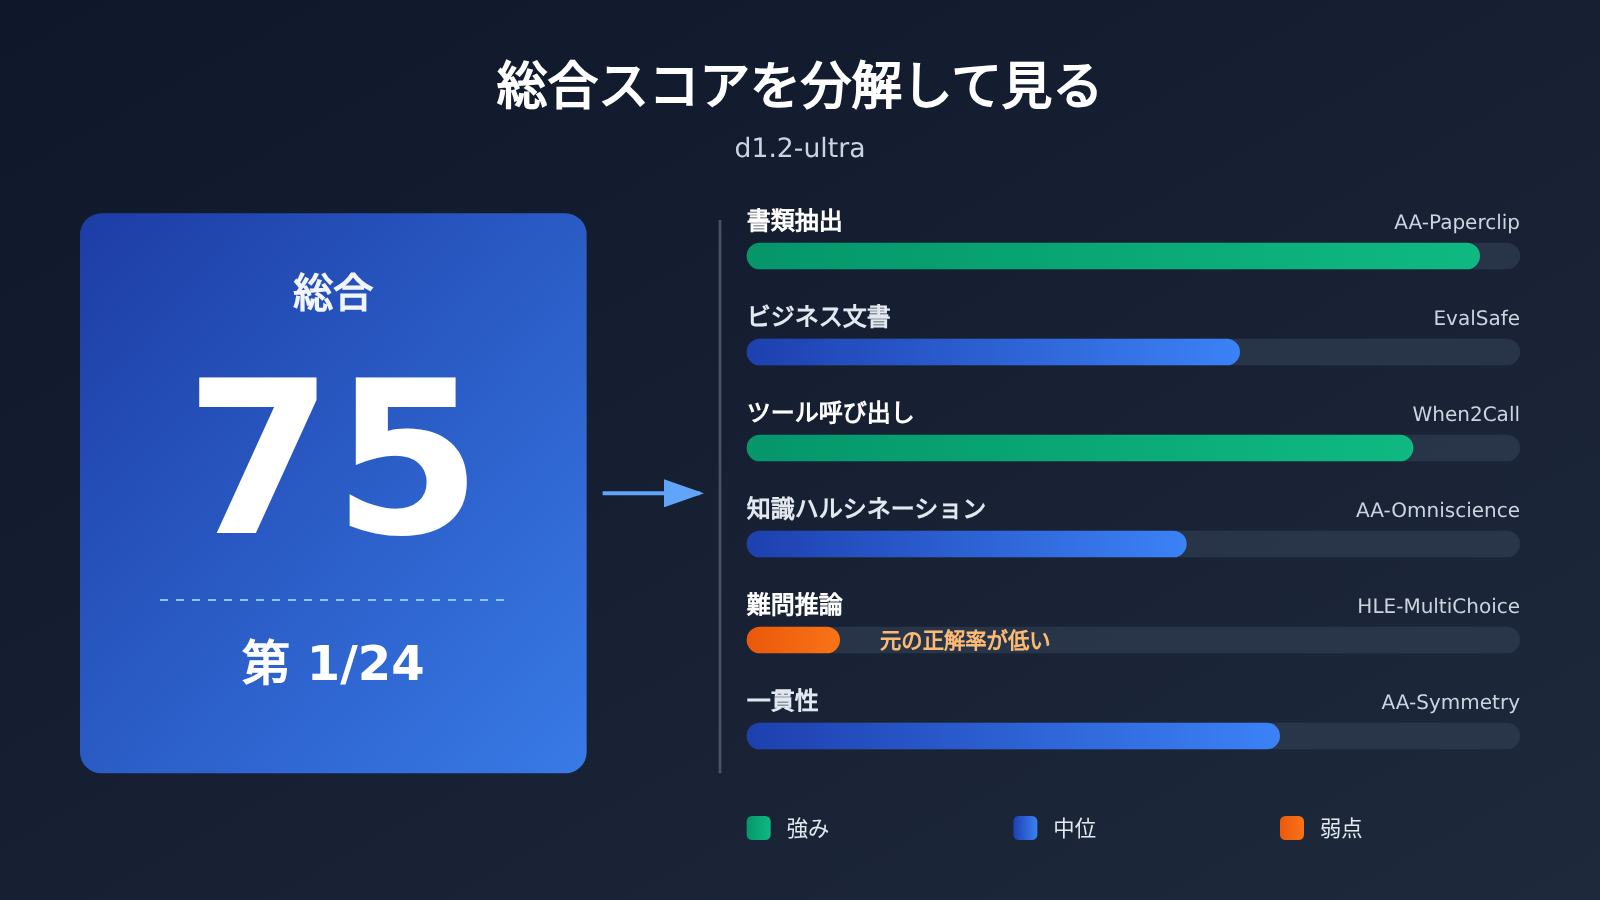
| 総合指数 | 74.85、ページ表示は 75、第 1/24 | 2 位の Drex Max v1.1 は 72.62 で、差は約 2.2 点。公式が言う「2 点」は同じことを四捨五入したものです |
| 所要時間 | 218 ミリ秒/タスク、第 14/24 | ページ中央値は 209 ミリ秒で、中位に位置します |
| 指数を最後まで実行するコスト | 133 ドル/100 万タスク、第 11/24 | これはタスクあたりのコストであり、100 万トークンあたりの表示価格ではありません |
| 入力価格 | 0.042 ドル/100 万トークン | Liquid の公式ブログと一致しており、公式は入力のみを計上しています |
| Brier | 0.150、24 個の中で最も低い | 低いほど良い。提示される確率が比較的「正直」であることを示します |
d1.2-ultra の総合スコアはどこから来るのか
Decision Index v2.1 は 6 つの項目の加重平均です。モデルページにおける意思決定スコアの定義は「正確率から、選択した回答の確率に対する Brier スコアを引いたもの」で、範囲は 0〜100、高いほど良いとされています。つまり、自信を持って間違えるほうが、迷いながら間違えるよりも大きく減点されます。一方、素の正確率は、モデルが最も高い確率を正解の選択肢に割り当てた問題の割合であり、意思決定スコアとは別の数値です。
この違いは d1.2-ultra の読み方に直結します。モデルは、頻繁に推測を避け、自信を持った間違いを減らすことで、それなりに高い意思決定スコアを得ながら、素の正確率は低い、という状態になり得ます。業務上「必ず答えを出す必要がある」なら、見るべきは素の正確率です。逆に「不確かなら人に回してよい」のであれば、意思決定スコアのほうが参考になります。
| 項目 | 重み | 測定内容 | AA の分類 |
|---|---|---|---|
| AA-Paperclip | 30% | 帳票の判断と抽出。1 つの文書で 15 個の回答をまとめて 1 回の判断として数える | 文書 |
| EvalSafe-O*NET-AA | 15% | 職場文書の判断 | 文書 |
| When2Call | 10% | ツール呼び出し | ツール |
| AA-Omniscience-Decision v1.1 | 15% | 知識とハルシネーション | 知識 |
| HLE-MultiChoice v1.1 | 15% | Humanity’s Last Exam のテキスト選択問題。拒否回答が可能 | 推論 |
| AA-Symmetry v1.1 | 15% | 言い換え、選択肢順の入れ替え、否定の後でも判断が変わらないか | 一貫性 |
注意点として、HLE-MultiChoice は AA では推論に分類されており、知識ではありません。そのため、以下でこれに触れる際に「知識テスト」と書くのは誤りです。
d1.2-ultra のスコアを自分のタスクにどう当てはめるか
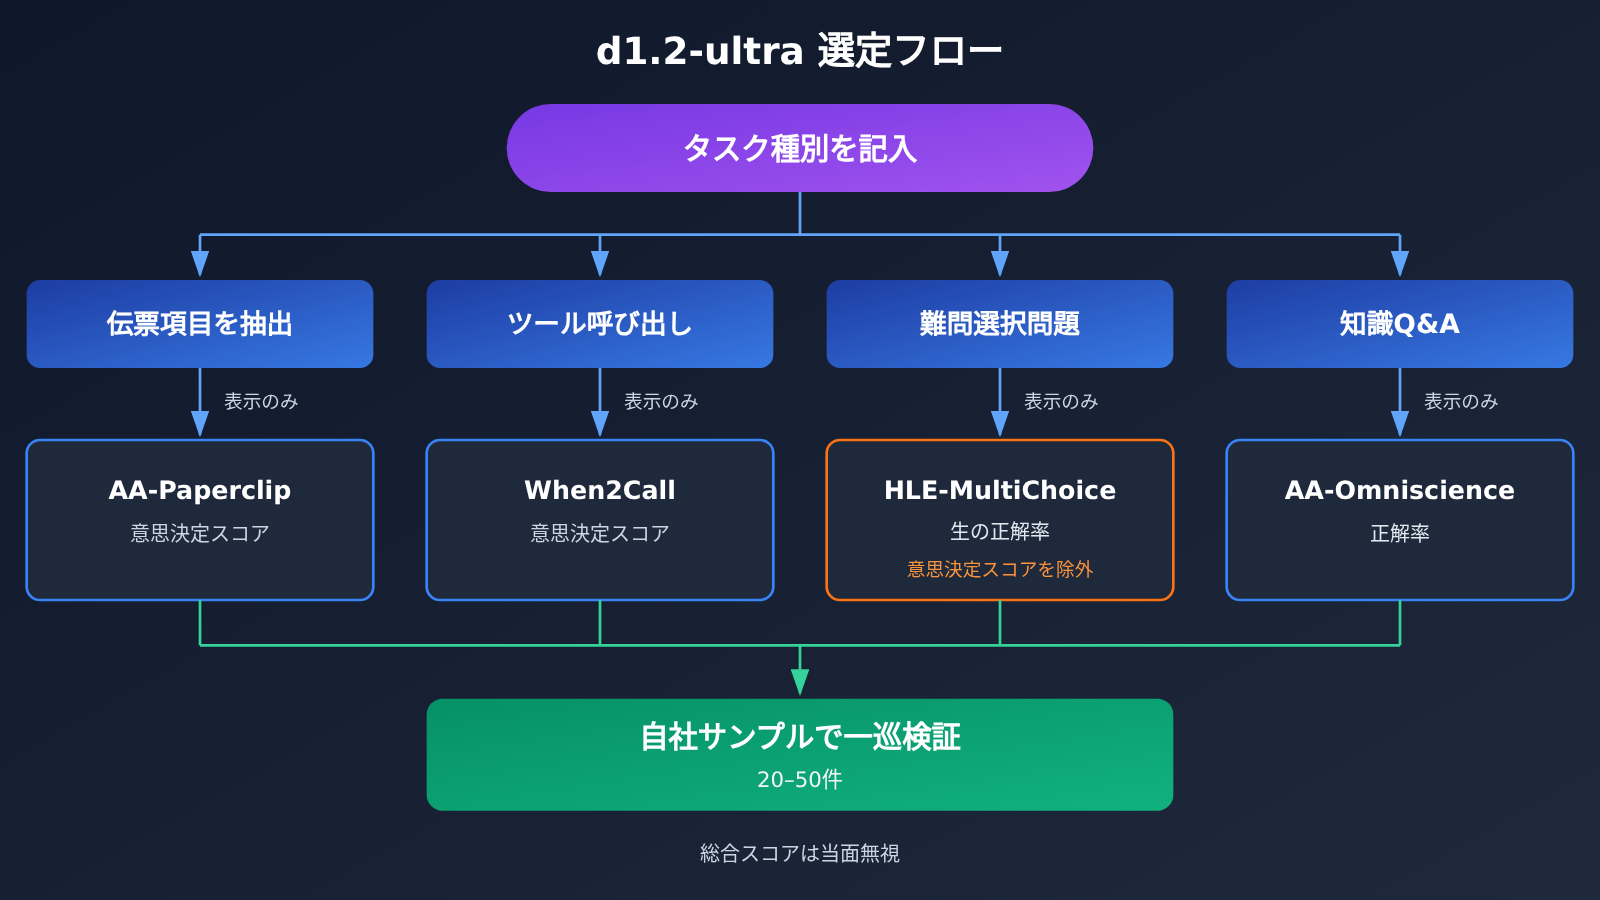
最初にやるべきことはランキングを見ることではなく、紙を一枚用意して、自分のタスクがどのカテゴリに属するかを書き出すことです。伝票の抽出、ツール呼び出し、難問への回答、知識問答のどれか。書き終えたら、該当する項目だけを見てください。他の分項や総合スコア 75 は当面見ないでおきます。
| やりたいこと | 見るべき項目 | d1.2-ultra のランキングページのデータ | 読み方 |
|---|---|---|---|
| 請求書・履歴書・論文のフィールド抽出 | AA-Paperclip | 判断スコア 75.81、文書完全正解率 67.7% で、いずれも 1/24 位 | 2 位の Drex Max v1.1 は 72.82 と 63.0% で、リードは比較的明確です |
| ツール呼び出し、呼ぶべきかどうかの判断 | When2Call | 判断スコア 96.49 で 1 位 | SubQ Snap 1.2 は 96.10、d1.2 は 96.09 で、上位勢は約 1 点の中にひしめいています |
| 職場文書の判断 | EvalSafe-O*NET-AA | 判断スコア 89.53 で 3 位 | 上には Jev 1.14(91.14)と GLiDE v1.2(89.67)がいます |
| 難しい選択問題への回答 | HLE-MultiChoice の生の正解率 | 2.36% で、24 の判断モデルの中で最低 | 判断スコア 46.36 は最下位ではなく、非幻覚率は 76.1%。推測を避けることが多いのです |
| 知識問答 | AA-Omniscience の正解率 | 生の正解率 23.6% で 20/24 位 | 判断スコア 60.80 は 6 位、非幻覚率 83.8% |
| 言い換えても答えが安定するか | AA-Symmetry の全通過率 | スコア 86.34 で 2 位;全通過率 56.7% で 5 位 | スコア 2 位は安定性 2 位を意味しません |
d1.2-ultra の分項で最も読み間違えやすい 2 か所
1 つ目は HLE-MultiChoice です。生の正解率 2.36% は確かに 24 の判断モデルの中で最低ですが、判断スコア 46.36 は最下位ではなく、同じページにはさらに低いモデルもあります(例:Mercury Decide の 34.79)。さらに非幻覚率 76.1% を加味すると、合理的な読み方はこうです。難しい推論の選択問題に遭遇すると、d1.2-ultra は自信の高い答えを出さない傾向があります。AA はこの項目を推論に分類しているので、「知識テストで最下位」と言うことはできません。
2 つ目は AA-Omniscience です。正解率 23.6% は 20/24 位で、最下位ではありません。興味深いのは、同じページの小型モデル d1.2 がこの項目で 30.0%、HLE の生の正解率も 5.30% と、どちらも ultra を上回っている点です。ただし d1.2 の総合指数は 68.69 で 9/24 位なので、「より高価な ultra の方が知識が劣る」はこの 2 項目にのみ当てはまり、全般的に劣ると拡張することはできません。
🎯 ランキングの読み方アドバイス:あなたのタスクが伝票抽出なら、
d1.2-ultraの AA-Paperclip 1 位は真剣に受け止める価値があります。ツール呼び出しなら、1 位は事実ですが、後続の数名との差は 1 点以内なので、乗り換えるかどうかは自分のサンプル次第です。
d1.2-ultra の公式自己申告データをどう使うか
Liquid は同じブログ記事で、5種類の新タスクと社内テスト結果も示しています。ベンダーは、これらの新タスクはまだ公開ベンチマークでカバーされていないと明記しています。以下のデータはすべて公式自己申告によるもので、社内のホールドアウトセットを使った結果であり、Artificial Analysis のスコアではありません。
| 新タスク(公式自己申告) | d1.2-ultra | d1.2 | 備考 |
|---|---|---|---|
| レシート読み取り(CORD、SROIE) | 98% | 96% | 値がない場合は not found と回答 |
| 機密情報スパン(Nemotron PII)の適合率/再現率 | 94% / 93% | 92% / 88% | 各スパンの位置を提示 |
| 記述に基づく物体のバウンディングボックス(RefCOCO シリーズ) | 94% | 94% | 両者同等 |
| 物体のカウント、誤差 1 まで許容(COCO) | 93% | 92% | 数を推定して範囲を提示 |
| 画像内の各物体を抽出(COCO) | 87% | 90% | この行は安価な d1.2 の方が高い |
音声面では、ホールドアウト録音から音のカテゴリ(ESC-50)と言語(FLEURS、43 言語)を判定する際、両モデルとも約 95%~97% だったと公式は述べています。キャリブレーション誤差については、Liquid が 13 のベンチマーク、22505 問で計測したところ、d1.2-ultra が 0.8、d1.2 が 1.2、Jev 1.14 が 2.7、Perplexity Decider v1.3 が 3.7、GPT-6 Luna の Decisions API が 7.2 でした。
ここは特に区別が必要です。GPT-6 Luna(Decisions)は Artificial Analysis の意思決定リーダーボードで総合指数 60.25、22/24 位、HLE の生の正解率 7.86% です。これらはすべて Decisions インターフェースの成績であり、チャットインターフェース gpt-6-luna の成績として扱うことはできません。公式ブログには「Coming to OpenRouter and Vercel soon(OpenRouter と Vercel で近日提供予定)」とも書かれていますが、これはベンダーによる予告であり、すでに提供開始済みという意味ではありません。
d1.2-ultra クイックスタート:自分のサンプルで一通り照合する
ベンチマークを見終えたら、実際に切り替えるかを決めるのは自分のデータです。20〜50件の実サンプルを用意すれば十分です。たとえば請求書30枚、履歴書30件などで、各サンプルには正解のフィールド値をあらかじめ付けておき、そのうち数件は特定のフィールドを意図的に欠損させておくとよいでしょう。
最小限の手順
- 業務から20〜50件のサンプルを選び、各フィールドの正解値を人手でラベル付けする。欠損フィールドは not found とする。
- 固定のプロンプトを書く。モデルに指定フィールドをJSON形式で出力させ、見つからないフィールドは必ず
not foundとし、推測を禁止する。 - OpenAI互換SDKを使い、
base_urlをhttps://api.apiyi.com/v1に設定し、modelはまずgpt-6-luna、次にgpt-6.1-solでそれぞれ実行する。 - 1件ずつ比較し、3つの数値を記録する:フィールド単位の正解率、文書全体の完全正解率、欠損フィールドを誤って埋めた回数。
- 対象モデルが呼び出せるようになったら、同じサンプル群と同一プロンプトでもう一度実行し、3つの数値を直接比較する。
完全な比較の考え方を表示
– **入力**:1サンプル1行のファイル。各行に原文(または画像)と人手で注釈したフィールド辞書を含む。
– **呼び出し**:サンプルをループで読み、`client.chat.completions.create` または `responses` エンドポイントを呼び出す。`temperature` は0に設定し、厳密なJSON出力を要求する。
– **解析**:出力の解析失敗は別にカウントする。これ自体が可用性指標になる。
– **比較**:フィールドごとに正規化して比較する(空白除去、日付形式の統一、金額は小数第2位まで保持)。
– **ハルシネーションのカウント**:not found と注釈されているのにモデルが値を入れたフィールドを、個別に「勝手な推測」として記録する。
– **集計**:フィールド正解率、文書完全正解率、勝手な推測の回数、平均token使用量を出力し、後で費用を計算しやすいようにする。
APIYIでまずベースラインを計測する
これにはtokenを使います。d1.2 と d1.2-ultra はAPIYIのモデル一覧にありません。そのため現時点では、APIYI(apiyi.com)で既に提供中の gpt-6.1-sol または gpt-6-luna を使い、呼び出し先 https://api.apiyi.com/v1 で同じ請求書や履歴書のセットを実行し、フィールドが正しいか、存在しないフィールドを推測しないかを確認できます。これで定量化可能なベースラインが手に入ります。
まだ提供を開始していませんが、このモデルはできるだけ早く提供開始する予定です。モデル名と価格はプラットフォームのモデル一覧を基準にしてください。
| セルフチェック項目 | 記録方法 | 判定基準 |
|---|---|---|
| フィールド正解率 | 正解フィールド数 / 総フィールド数 | 現在の本番モデルと比較 |
| 文書完全正解率 | 全フィールドが正しい文書の割合 | AA-Paperclipの「文書完全正解率」に対応 |
| 勝手な推測の回数 | not found のフィールドに値が入力された回数 | 少ないほどよい。非ハルシネーション率の考え方に対応 |
| 解析失敗 | JSONを解析できない件数 | 本番化コストに直結 |
| token使用量 | 1件あたりの平均入力・出力token | 実際の費用換算に使用 |
🚀 導入のヒント:まずAPIYI(apiyi.com)の新規ユーザー向け無料テスト枠で20件を実行し、プロンプトと比較スクリプトに問題がないことを確認してから50件に拡大しましょう。最初からデバッグで枠を消費するのを避けられます。
d1.2-ultra の価格とAPI呼び出し方式について
価格は単位をはっきり区別する必要があります。ランキング上の133ドルは「100万タスクあたり」のベンチマーク実行コストで、Liquid の公式価格は「100万入力トークンあたり」です。d1.2 が0.02ドル、d1.2-ultra が0.042ドルで、入力のみが課金対象です。画像は32×32ピクセルあたり1.5トークンとしてテキスト価格で計算され、1024×1024なら約1536トークンになります。1回のリクエストに含まれるテキストと画像はそれぞれ1回だけカウントされ、追加で質問する場合はその質問自体のテキスト分だけが加算されます。
公式の呼び出し方式も一般的なチャットインターフェースとは異なります。モデルIDは d1.2-ultra と d1.2、エンドポイントは https://api.liquid.ai/decisions/v1/systemone で、APIキーは Liquid コンソールで申請します。公式ブログにはテキスト・画像・音声の入力が記載されていますが、Artificial Analysis のページの技術仕様にはテキストと画像、コンテキスト66kと書かれています。このウィンドウの数値はランキングページにのみ登場するもので、Liquid のブログが公表した仕様ではありません。
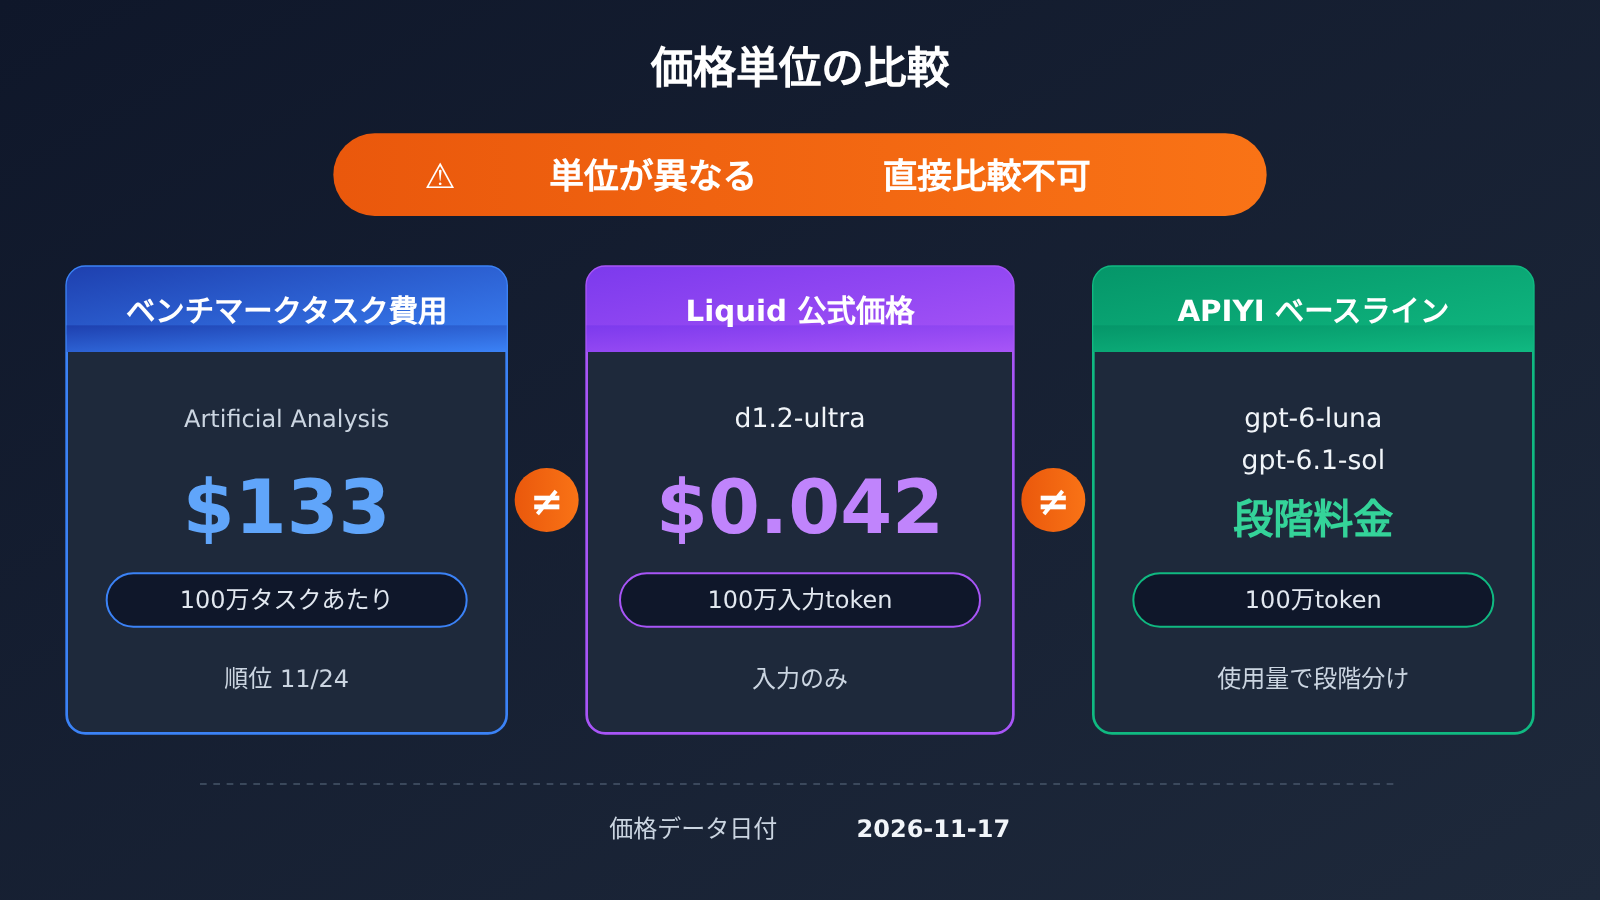
ベースライン実行で使用した APIYI のモデルと価格は次のとおりです(単位:ドル/100万トークン、1回のリクエストのトークン量による段階制。データは2026-11-17の価格APIから取得し、モデル一覧表の2026-11-16更新と一致):
| モデル | 段階 | 入力 | 出力 | キャッシュ読み取り | エンドポイント |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses 優先、chat もあり |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | 個別記載なし | 同上 |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses 優先、chat もあり |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | 個別記載なし | 同上 |
💰 コストのヒント:50件のサンプルで比較する場合、
gpt-6-lunaはまず量をこなす用途に、gpt-6.1-solは高品質な参照用に適しています。APIYI apiyi.com のチャージは1:7換算で、グループ割引も重ねて適用できます。実際の請求額はコンソールでご確認ください。
よくある質問 FAQ
Q1:d1.2-ultra とはどんなモデルですか?
Liquid AI が 2026-11-16 に発表した意思決定モデルで、小型の d1.2 と同時期にリリースされました。意思決定モデルの特徴は、各選択肢に対して確率を与える点にあります。帳票抽出、ツール呼び出しの判断、分類といった「選択を行う」タスクが得意で、長文の執筆は苦手です。
Q2:d1.2-ultra が総合 1 位なら、すべてにおいて最強なのですか?
いいえ。総合指数は 74.85 で 24 モデル中 1 位ですが、EvalSafe-O\*NET-AA は 3 位、AA-Symmetry の全通過率は 5 位、AA-Omniscience の素の正解率は 20 位、HLE-MultiChoice の素の正解率は 24 モデル中最低です。総合スコアはあくまで重み付け後にリードしていることを示すだけです。
Q3:HLE-MultiChoice の項目は知識テストで最下位ということですか?
いいえ。最下位なのは HLE-MultiChoice の素の正解率 2.36% で、これは 24 の意思決定モデルの中での素の正解率です。意思決定スコア 46.36 は最下位ではなく、AA はこの項目を知識ではなく推論として分類しています。
Q4:d1.2-ultra はどんな場面に最も適していますか?
ランキングページから見ると、最も相性が良いのは請求書・履歴書・論文のフィールド抽出(AA-Paperclip の意思決定スコアと全問正解率がいずれも 1 位)と、ツール呼び出しの判断(When2Call で 1 位、ただし上位数モデルの差は約 1 点)です。難しい選択問題や知識問答では、素の正解率は優位ではありません。
Q5:今 APIYI で d1.2-ultra を呼び出せますか?
現在、d1.2 と d1.2-ultra は APIYI のモデルリストに含まれていません。まだ未掲載ですが、できるだけ早く掲載する予定です。モデルと価格はプラットフォームのモデルリストを基準にしてください。まずは APIYI apiyi.com で `gpt-6-luna` や `gpt-6.1-sol` を使って自社サンプルのベースラインを取得し、その後にモデルを差し替えて比較することをおすすめします。
Q6:Liquid が公表した校正誤差 0.8 はそのまま信頼できますか?
それは Liquid 自身が 13 のベンチマーク、22505 問で行ったテストであり、公式の自己申告値です。ランキングページで相互に裏付けできるのは、Brier 0.150 が 24 モデル中最低という点で、方向性は一致しています。ただし実際の業務では、自社サンプルにおいて「当て勘で答える回数」が本当に少ないかを確認する必要があります。
Q7:GPT-6 Luna の 7.2 と APIYI 上の gpt-6-luna は同じものですか?
同じものではありません。7.2 は GPT-6 Luna の Decisions API を Liquid がテストした際の校正誤差で、ランキング上の 60.25 も Decisions インターフェースの成績です。APIYI が提供する `gpt-6-luna` はチャットインターフェースなので、性能は自社のサンプルで測る必要があります。
Q8:サンプルは結局何件あれば足りますか?
20〜50 件あれば、明らかな差は見分けられます。重要なのは実際の分布をカバーすることです。よくある形式、珍しい形式、フィールドが欠けたサンプルをいずれも含めてください。50 件で 2 モデルの差が 1〜2 件以内なら、どちらに替えても大差ないということなので、価格とレイテンシを優先して判断しましょう。
d1.2-ultra の主なポイント
- 総合75はあくまで入口:74.85で24モデル中1位、2位に約2.2ポイント差。ただし全項目で1位というわけではありません。
- 伝票抽出を見るなら AA-Paperclip:意思決定スコア75.81、全問正解率67.7%で、いずれも1位です。
- ツール呼び出しを見るなら When2Call:96.49で1位ですが、上位モデルは約1ポイント差に集中しています。
- 難問を見るなら生の正解率:HLE-MultiChoiceは2.36%で最低ですが、意思決定スコアは最下位ではなく、AAでは推論として分類されています。
- 知識QAを見るなら Omniscience の正解率:23.6%で24モデル中20位、最下位ではありません。
- 単位を混同しない:133ドルは100万タスクあたり、0.042ドルは100万入力トークンあたりです。
- サンプルで判断:まず APIYI apiyi.com で利用可能なモデルを使い20〜50件を実行し、フィールド精度と当て推量の回数を記録します。
まとめ
d1.2-ultra のリーダーボードを読むときのポイントは3ステップです。
- タスク種別を書き出す:伝票抽出、ツール呼び出し、難問回答、知識QAのどれかを見て、該当するサブスコアだけを確認します。
- 2つの数値を区別する:意思決定スコアは「自信がなければ推測しない」ことを評価し、生の正解率は「どれだけ当てたか」を測ります。業務要件に応じてどちらを見るか選びましょう。
- 自社サンプルで最終判断する:ラベル付きの実データ20〜50件は、どんな総合スコアよりも問題をよりよく示します。
もしあなたの業務がまさに伝票抽出なら、d1.2-ultra は候補リストに入れる価値があります。難問推論や知識QAなら、総合1位という理由だけで乗り換えないでください。今すぐ APIYI apiyi.com で gpt-6-luna と gpt-6.1-sol を使ってベースラインを構築しておき、対象モデルが利用可能になったらワンクリックで比較することをおすすめします。
📚 参考資料
-
Liquid AI 公式ブログ – d1.2 リリース:リリース情報、公式価格、自社報告ベンチマーク
- リンク:
liquid.ai/blog/d1-2 - 説明: 新タスクの正解率とキャリブレーション誤差はいずれも公式の自己申告値です
- リンク:
-
Liquid AI 意思決定モデル ドキュメント:モデル ID と呼び出しエンドポイント
- リンク:
docs.liquid.ai/lfm/models/decision-models - 説明: 公式の呼び出し方法についての説明
- リンク:
-
Artificial Analysis – d1.2-ultra モデルページ:総合指数と各評価項目
- リンク:
artificialanalysis.ai/decision-models/d1-2-ultra - 説明: 本記事のランキングデータはすべて 2026-11-17 に取得したものです
- リンク:
-
Artificial Analysis – Decision Index 方法ページ:重み付けとスコア定義
- リンク:
artificialanalysis.ai/methodology/decision-index - 説明: 意思決定スコアと生の正解率との違い
- リンク:
-
APIYI モデル一覧:提供中のモデルと価格
- リンク:
docs.apiyi.com/models - 説明: モデルと価格はプラットフォームのモデル一覧を基準とします
- リンク:
作者:APIYI 技術チーム
技術交流:モデル選定や比較スクリプトについてご不明な点があれば、APIYI 公式サイトのトップページからお気軽にお問い合わせください。接続方法の詳細はドキュメントセンターをご覧ください


