
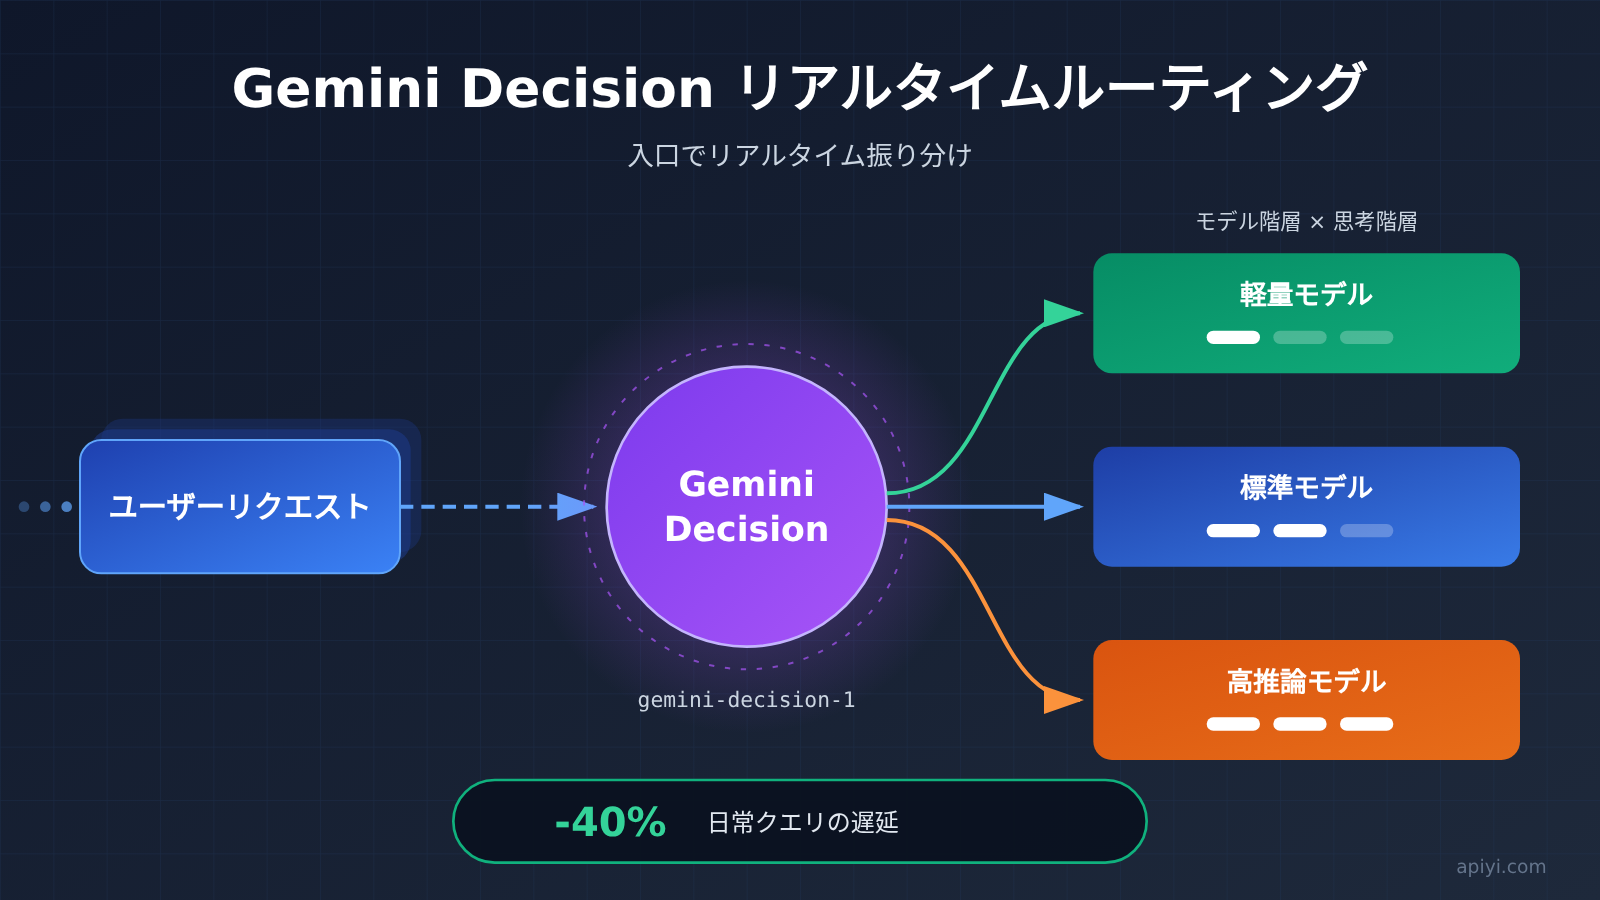
Google は 2026-11-11 の開発者ブログで、かなり具体的な利用例を紹介しました。Gemini Notebook が Decisions API をリアルタイムルーターとして使い、リクエストが届いた時点で日常的な質問を適切なモデル階層と思考階層に振り分けるというものです。公式の自己申告では、日常クエリのレイテンシが最大 40% 短縮されたとのことです。ただしこの数字は Google 自身が公表したもので、第三者による負荷テストでも、特定プラットフォームでの実測結果でもない点に注意してください。
これは単なるモデル性能のアップグレードではありません。 「どのモデルを使うか」という選択を、開発者のコードの中から、リクエストの経路上へ移したのです。
この記事のポイント:gemini-decision-1 とは何か、どう課金されるのか、そして呼び出しチェーンにどんな影響があるのかを、3 分で整理します。
Gemini Decision の主要情報まとめ
| 項目 | 詳細 |
|---|---|
| 発表日 | 2026-11-11、Google 開発者ブログ |
| モデル ID | gemini-decision-1 |
| 位置づけ | リアルタイムのルーティングと意思決定用(コンテンツ生成用ではない) |
| 最初の公開事例 | Gemini Notebook 内部での日常的な質問の階層振り分け |
| 入力価格 | $0.10 / 1M tokens |
| 出力価格 | $0 |
| レイテンシ改善 | 公式の自己申告で、日常クエリが最大 40% 短縮 |
| 集約プラットフォームでの提供状況 | 2026-11-12 時点で、APIYI apiyi.com の価格表にはこの ID はまだ掲載されていません |
表の中で見落としやすいのが、出力価格が $0 という行です。gemini-decision-1 の出力は本文ではなく、「どの階層に振り分けるか」「思考予算をどれだけ使うか」といったごく短い判断結果だということを示しています。このモデルを対話型モデルと同じ価格表に並べて単価を比べると、まったく的外れな結論になってしまいます。
もうひとつ注目したいのは、ドキュメント上のサンプルにとどまらず、すでに実際の本番ユースケースがあることです。Gemini Notebook は Google 自社のプロダクトで、まず自社サービスでこのルーティングを動かしてから外部に向けて発表した形です。単なるベンチマークよりは信頼性が高いと言えますが、あくまで公式による一方的な説明であることに変わりはありません。
Gemini Decision の仕組み:公式が紹介するルーティング事例
Google のブログによると、Gemini Notebook の日常的な質問は、まず Decisions API で判定されます。その結果に応じて、どのモデルティアで、どの思考ティアで処理するかが決まります。つまり、ルーティングの判断そのものがモデル呼び出しになっているわけです。固定の if-else ルールや、手作業で調整したしきい値には頼っていません。
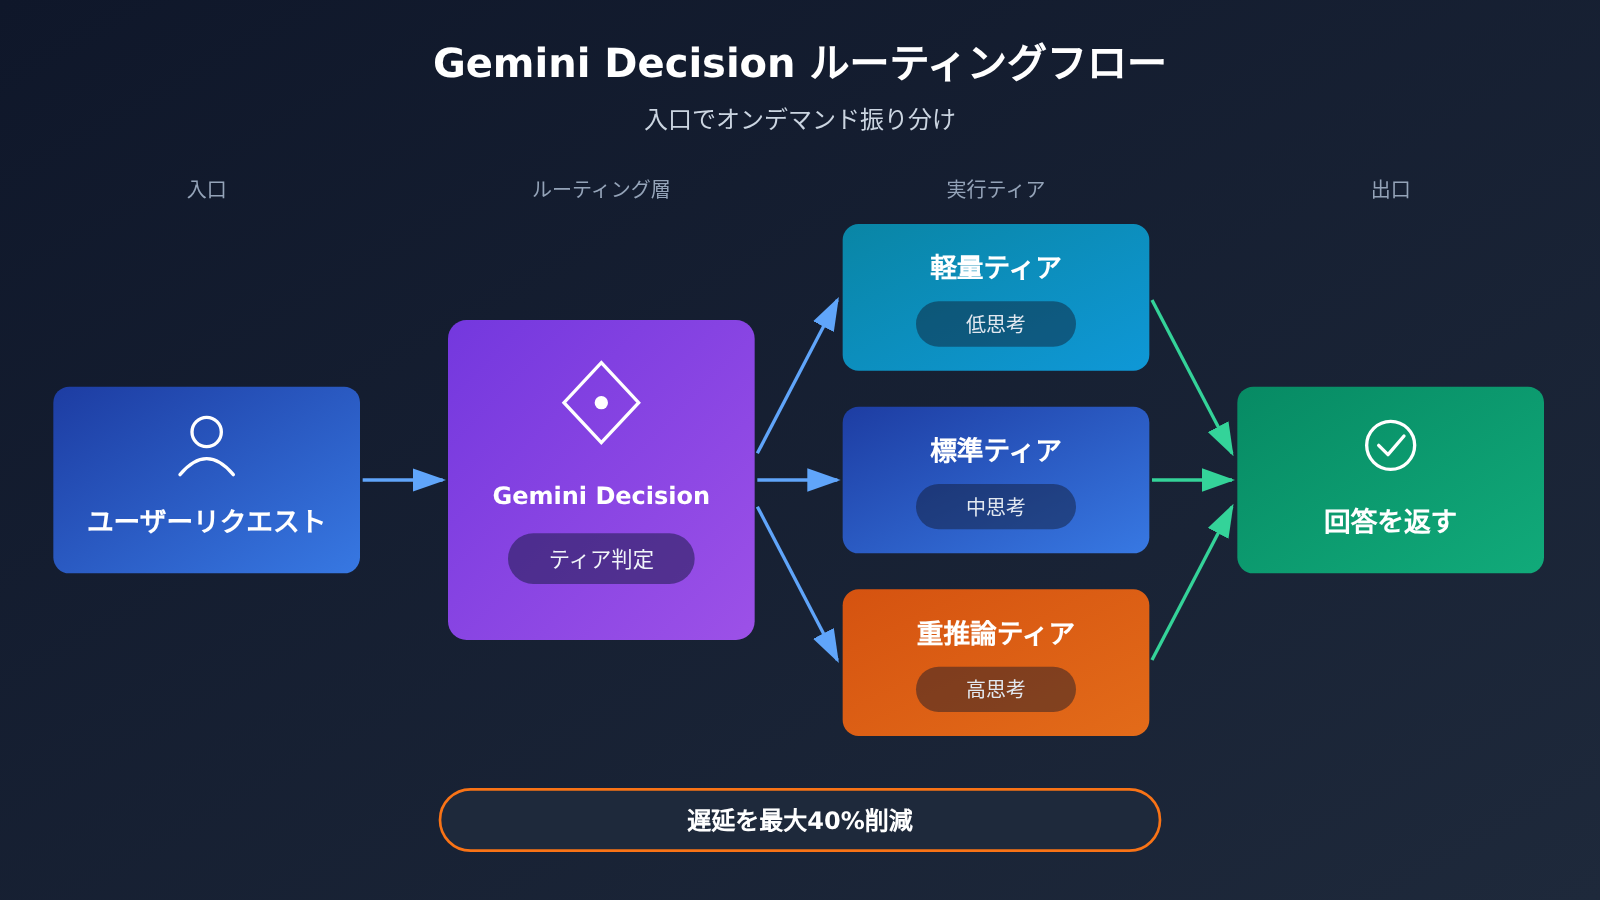
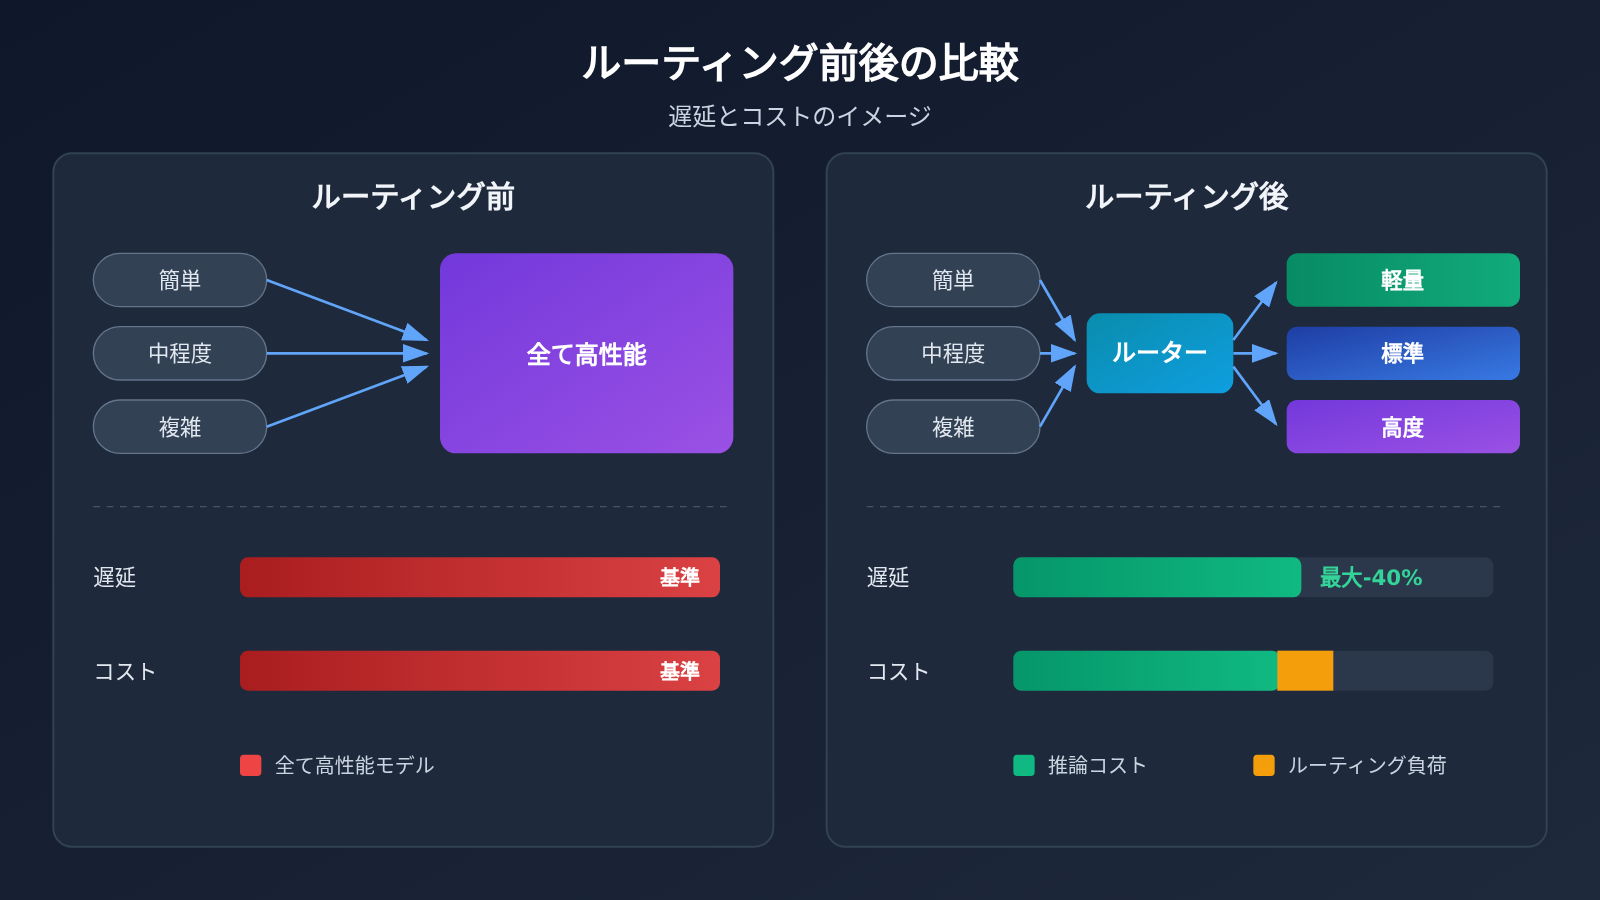
この設計が解決しようとしている課題は、とても現実的です。同じプロダクトの中でも、リクエストの大半は軽い日常的な質問で、本格的な推論が必要なものはごく一部です。すべてを同じティアで処理すると、軽いリクエストまで重いモデルに引きずられ、レイテンシもコストも一緒に膨らみます。逆にすべてを軽量ティアで処理すると、複雑な問題にうまく答えられません。入口に判断専用のモデルを置くことは、「必要に応じた割り当て」をインフラとして実現することにほかなりません。
| 項目 | ルーティング導入前によくある方法 | Decision 導入後 |
|---|---|---|
| ティアの判定 | コード内のルールやキーワードマッチ | リクエスト内容をもとにモデルが判断 |
| 運用方法 | 業務の変化に合わせてしきい値を手動で調整 | 判断ロジックがモデルの更新とともに進化 |
| レイテンシへの影響 | 重いティアのリクエストが多いと全体が遅くなる | 公式の自己申告では、日常的なクエリで最大 40% 短縮 |
| コストへの影響 | すべてのリクエストが同じティアで課金される | 軽いリクエストは軽量ティアに回り、請求の構成が変わる |
注意したいのは、40% という数字が当てはまるのは「日常的なクエリ」の場面であり、すべてのリクエストではないという点です。公式の表現は上限としての数字であり、実際のビジネスでどれだけ効果が出るかは、リクエストのうちティアを下げられる問題がどのくらいあるかで決まります。たとえば、プロダクトの用途が長文ドキュメントの分析や複雑なコーディングタスクばかりなら、ティアを下げられる余地はもともと小さくなります。
🎯 技術アドバイス:こうしたルーティングの考え方が自社の業務でどれだけ効果を発揮するか確かめたい場合は、まず APIYI(apiyi.com)の統合インターフェースを使って、ティアの異なるモデルに同じリクエストを流してみましょう。レイテンシと出力品質を比較してから、ルーティング層を導入するかどうか決めるのがおすすめです。
Gemini Decision の料金体系とコストへの影響
入力が $0.10 / 1M tokens、出力が $0 という料金体系は、本質的には「どれだけのコンテキストを読み込んだか」に対して課金する仕組みです。ルーティングの判断はリクエストの内容を見なければ下せないので、入力側に料金がかかるのは理にかないます。一方、出力は階層(ティア)の判定結果をひとつ返すだけなので、出力側のコストはほぼ発生せず、公式が思い切って 0 に設定しています。
つまり、導入する側はもうひとつ計算しておく必要があります。ルーティング層自体もトークンを消費するということです。リクエストが下位のティアに振り分けられて節約できた推論コストが、この追加の判断コストを上回って初めて、全体として得になります。リクエストが長く、ティア間の差が大きいほど収支はプラスになりやすく、逆にリクエストが短くてもともと軽量なティアで処理していたケースでは、ルーティング層を足すことでかえってコストが増える可能性もあります。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# gemini-decision-1 は現時点でプラットフォームの料金表にまだ掲載されていません
# まずは model を既存の対話モデルに置き換えて、業務フローを検証できます
response = client.chat.completions.create(
    model="YOUR_MODEL",
    messages=[{"role": "user", "content": "这个问题需要多深的推理?"}]
)
print(response.choices[0].message.content)
🚀 クイックスタート:2026-11-12 時点では、APIYI(apiyi.com)の料金一覧に gemini-decision-1 はまだ掲載されていません。プラットフォームでは今後できるだけ早く対応する予定です。掲載されるまでの間は、同じ OpenAI 互換インターフェースで他のモデルを呼び出してフローを検証しておけば、切り替えコストはほぼゼロです。具体的なモデル名と料金は apiyi.com の一覧でご確認ください。
誰が影響を受けるか:3種類の呼び出しチェーンで実際に変わること
アプリ側:ルーティングは自前で書くものから、インターフェースを呼ぶものへ
これまで複数モデルへの振り分けを行う場合、チームは通常ルールテーブルを維持し、モデルのバージョンが変わるたびに何度もパラメータを調整する必要がありました。ルーティングの判断を専用の判定モデルに任せられるなら、アプリ側のロジックはかなり薄くなります。残る作業は「どんなティアを用意するか」と「各ティアにどのモデルを置くか」を定義することです。代償として直列の呼び出しが1回増えるため、入口層のネットワーク品質が全体のレイテンシに直接影響します。
コスト側:レイテンシが下がっても請求額が下がるとは限らない
レイテンシとコストは別々の曲線です。ティアを下げれば両方を同時に抑えられますが、ルーティング自体は入力トークンに応じて課金されるため、短いリクエストが中心の場面では限界コストが上がってしまいます。堅実なやり方は、まずリクエストの種類ごとにグループ分けし、「複雑さの差が大きい」トラフィックにだけルーティングを有効にすることです。それ以外のトラフィックは固定のティアに流します。
| チームのタイプ | 主なメリット | 注意すべきコスト項目 |
|---|---|---|
| 一般ユーザー向けのQ&Aプロダクト | 日常的な質問のレイテンシが下がり、体験が目に見えて改善する | ルーティング呼び出しによる追加トークン消費 |
| 社内ツール | 複雑なリクエストと単純なリクエストが混在し、ティア間の差が大きい | ティア分けの再設計が必要 |
| 高頻度・短文リクエストのサービス | メリットは限定的で、ティアを下げる余地も小さい | 直列でワンホップ増える分、割に合わない可能性がある |
プラットフォーム側:新しいモデルIDへの対応スピードが選定要因になる
モデルの更新ペースは年々速くなっており、IDが公開されてから安定して使えるようになるまでには、たいてい空白期間があります。アグリゲーション型のプラットフォームを使うチームにとって、この期間中にすぐ呼び出せるインターフェースを入手できるかどうかは、検証のスケジュールに直結します。ここがAPIYI(apiyi.com)のようなプラットフォームの価値です。1つのAPIキーとOpenAI互換インターフェースで、モデルが追加されたあともコード構造を変えずに切り替えられます。対応状況や課金の詳細は、apiyi.comのページ表示をご確認ください。
よくある質問 FAQ
Q1: Gemini Decision とは何ですか?
Google が公開した gemini-decision-1 は、リアルタイムのルーティングと意思決定に使うモデルです。本文の生成は行わず、リクエストをどのモデル階層(ティア)に振り分けるか、どの思考レベルで処理するかを判断します。Gemini Notebook が、現時点で公開されている最初の本番利用事例です。
Q2: 通常の Gemini モデルとは何が違いますか?
通常の対話モデルはコンテンツを出力しますが、このモデルが出力するのはごく短い判断結果だけです。そのため課金体系もまったく異なり、入力は $0.10 / 1M tokens、出力は $0 です。「もっと安い生成モデル」として捉えてしまうと、方向性を誤ってしまいます。
Q3: 「レイテンシが最大 40% 低下」という数字はどこから来ていますか?
この数字は Google 公式ブログの自己申告値で、Gemini Notebook の日常的なクエリにおけるレイテンシ改善の上限を指します。第三者による独立した負荷テストの結果ではありません。実際の効果は、リクエストのうち軽量なティアに振り分けられる質問がどれだけ含まれているかによって変わります。
Q4: 自分のビジネスではどれくらいコストを削減できますか?
万人に当てはまる答えはありません。推論コストの削減は、リクエストがより軽いティアに振り分けられることで生まれますが、ルーティング自体にも入力 token 分の料金がかかります。リクエストが長く、ティア間の差が大きいほど純粋なメリットは大きくなります。一方、短いリクエストが高頻度で発生するケースでは、慎重な見積もりが必要です。
Q5: 今すぐ Gemini Decision を呼び出せますか?
2026-11-12 時点では、APIYI(apiyi.com)の料金表に gemini-decision-1 はまだありません。できるだけ早く追加される予定です。それまでは apiyi.com の統一インターフェースで業務フローを先に動かしておき、ID が追加されたらモデル名を差し替えるだけで切り替えられます。具体的なモデルと価格は、apiyi.com の一覧をご確認ください。
Q6: ルーティング層を導入すると、どんなデメリットがありますか?
主に次の3点です。
– リクエストの経路上にシリアルな呼び出しが1回増えるため、入口のネットワーク品質がより重要になります。
– ルーティング判断自体が入力 token を消費するので、短いリクエストでは限界コストが上がります。
– ティアの分け方は業務ごとに設計し直す必要があり、他社の区分をそのまま流用することはできません。
Gemini Decision の要点 Key Takeaways
- 位置づけ:gemini-decision-1 はリアルタイムのルーティングモデルです。出力するのは「どの階層で処理するか」という判断だけで、本文は生成しません。
- ユースケース:Gemini Notebook が、日常的な質問を適切なモデル階層と思考階層に振り分けるために使っています。
- メリット:公式の自己申告によると、日常的なクエリのレイテンシが最大40%短縮されます。あくまで自己申告ベースの数字です。
- 課金:入力は $0.10 / 1M tokens、出力は $0 で、読み込んだコンテキストに対して課金されます。
- トレードオフ:ルーティング自体もトークンを消費します。短いリクエストが中心の場合、実際の効果は別途試算が必要です。
- 提供状況:2026-11-12 時点で、APIYI(apiyi.com)にはこのIDはまだありません。対応でき次第お知らせします。価格は apiyi.com の一覧をご確認ください。
- 検証方法:まず統一インターフェースで一連の流れを動かしてみて、そのうえで本番環境にルーティング層を導入するかどうかを判断しましょう。
まとめ
今回の発表で注目したいのは、モデルそのものの性能ではありません。Google が「モデルを選ぶ」という処理を外部向けのインターフェースとして切り出し、まず自社プロダクトで実際に動かしてみせた点です。開発者として押さえておきたいポイントは次の3つです。
- ルーティングの判断が、コード上のロジックからモデル呼び出しへと移りつつあります。
- レイテンシの改善効果は公式の自己申告による上限値です。自社のトラフィック構成に合わせて、あらためて見積もる必要があります。
- 新たに課金項目が加わるため、コスト構造が変わります。下位の階層に振り分けて節約できる分だけを見ていては不十分です。
この方式を先に試したい場合は、既存のモデルで階層分けのロジックを動かしておくのがおすすめです。gemini-decision-1 が APIYI(apiyi.com)に登場したら、モデル名を差し替えるだけで切り替えられます。型番と価格は apiyi.com の一覧をご確認ください。
参考資料
- Google 公式ブログ:Gemini Decisions API
- リンク:
blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ -
説明: 本記事で扱うモデルID、ルーティングのユースケース、レイテンシの数値、料金に関する唯一の一次情報源です
-
APIYI apiyi.com 料金一覧
- リンク:
apiyi.com - 説明: gemini-decision-1 の提供状況と、最終的な課金基準を確認するために使用します
著者: APIYI 技術チーム
技術交流: APIYI apiyi.com のトップページからお気軽にお問い合わせください。モデルの新規追加情報や新しいインターフェースの説明は、サイト内のドキュメントセンターでご確認いただけます


