
Note de l’auteur : décortiquer le tableau de test à l’aveugle de Hy4 flash publié par Tencent, préciser sur quel tableau repose le « proche de Haiku, coût par tâche environ dix-huit fois inférieur », puis vérifier séparément les deux niveaux de prix officiels de Claude Haiku 5.5 et le tableau des modèles d’APIYI.
Le 16 novembre 2026, Tencent Hunyuan a publié Hy4 flash. La publication officielle le présente comme « le modèle de productivité quotidienne le moins cher » et avance une conclusion très accrocheuse : lors de tests à l’aveugle menés par des humains sur des tâches quotidiennes, il est au même niveau que Claude Haiku 5.5 (high), tout en affichant un coût par tâche 18 fois plus faible.
Ce n’est pas une comparaison où tout serait « 18 fois moins cher ». Le facteur 18 ne provient que d’une colonne d’un tableau : le coût par tâche du test à l’aveugle interne à Tencent, 4,73 yuans contre 0,26 yuan. Cet article distingue clairement ce tableau, le WorkIndex et l’annexe de la page d’étude, les deux niveaux de prix officiels d’Anthropic, ainsi que le tableau des modèles d’APIYI. Si vous devez choisir entre Haiku 5.5 et un modèle quotidien moins cher, vous saurez, après lecture, comment interpréter ce chiffre.
L’essentiel : comprendre les limites de la conclusion qui compare Hy4 flash à Claude Haiku 5.5, et savoir quelles tâches justifient un changement de modèle, lesquelles doivent continuer avec le modèle actuel.
Hy4 flash face à Claude Haiku 5.5 : d’où vient ce rapport de 1 à 18, et de quel tableau ?
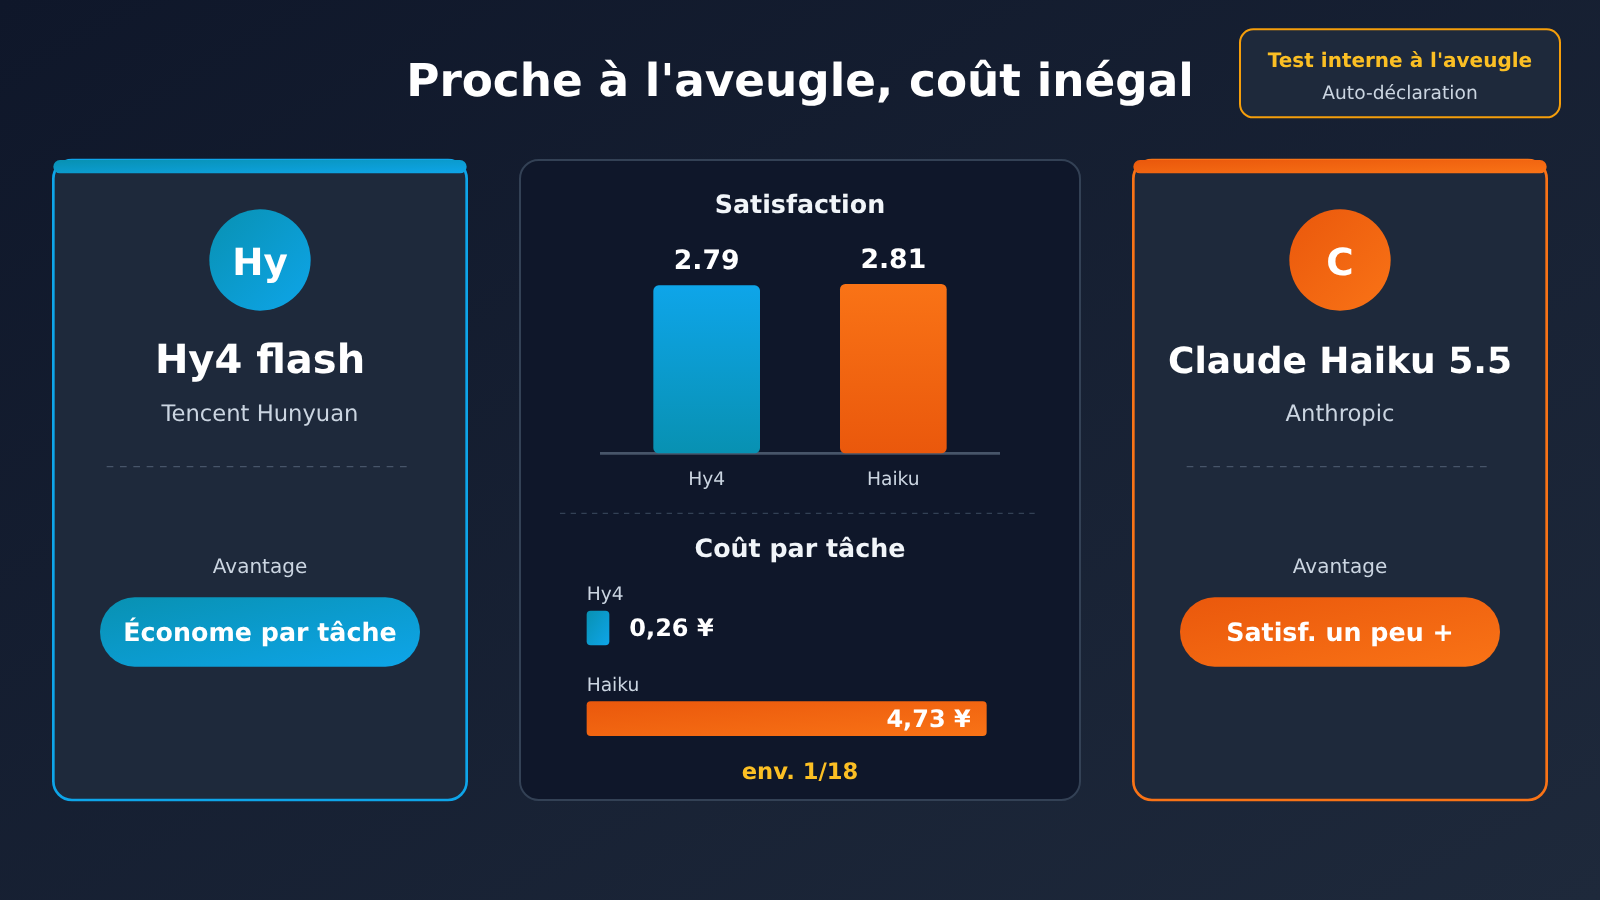
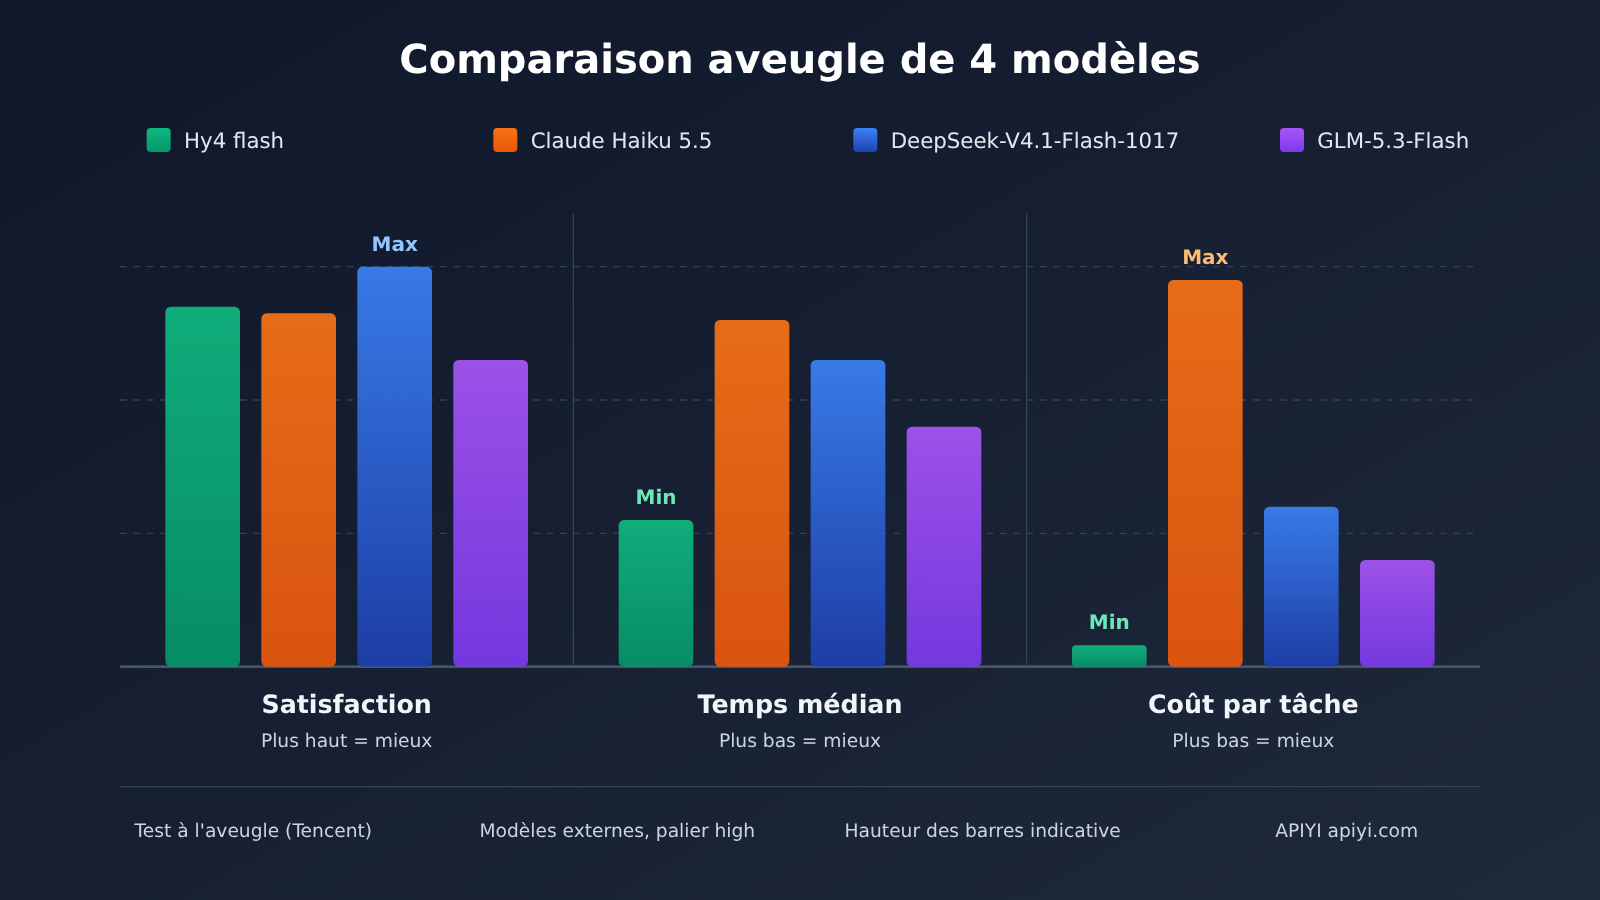
Commençons par les données brutes. Le tableau ci-dessous provient du texte et des illustrations officielles de la page de recherche Hy4 flash ; il s’agit d’un test à l’aveugle interne, rapporté par Tencent lui-même. Les participants étaient 85 utilisateurs internes de WorkBuddy, pour un total de 259 tâches couvrant 27 catégories. Les modèles externes (DeepSeek, Claude Haiku, GLM) sont en mode high, tandis que la ligne Hy4 flash ne précise pas le mode.
| Modèle | Satisfaction (sur 4) | Temps médian de bout en bout | Coût par tâche (RMB) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 (high) | 3,09 | 10,3 minutes | 1,20 yuan |
| Hy4 flash | 2,79 | 6,7 minutes | 0,26 yuan |
| Claude-Haiku-5.5 (high) | 2,81 | 6,8 minutes | 4,73 yuan |
| GLM-5.3-Flash (high) | 2,53 | 7,6 minutes | 0,81 yuan |
4,73 divisé par 0,26 donne environ 18,2 : c’est de là que vient le « 18x » mentionné dans le post. La comparaison porte sur Haiku, pas sur DeepSeek ni sur Hy4. Dans le tableau, la satisfaction la plus élevée est celle de DeepSeek, à 3,09 ; Hy4 flash est 0,02 point en dessous de Haiku. La page de recherche emploie le terme close to (« proche de »), donc on ne peut pas écrire « dépasse Haiku ».
Pourquoi l’écart de prix unitaire de Hy4 flash est loin d’atteindre un facteur 18
Si l’on compare les prix catalogue par million de tokens, l’écart est bien plus faible. La page de recherche indique pour Hy4 flash un tarif de 0,070 dollar en entrée et de 0,281 dollar en sortie. Le tarif officiel de Claude Haiku 5.5 pour moins de 100 000 tokens est de 0,10 dollar en entrée et de 0,50 dollar en sortie. En ne regardant que l’entrée, Hy4 flash représente environ 70 % de Haiku ; en ne regardant que la sortie, environ 56 %.
Ainsi, le facteur 18 correspond au « coût total pour mener à bien une tâche », et non au rapport des prix unitaires des tokens. La page de recherche mentionne que l’apprentissage par renforcement a réduit de 50 % le nombre moyen de tokens de sortie de bout en bout. Pour autant, le tableau du test à l’aveugle ne décompose pas la structure des coûts : impossible d’affirmer que le facteur 18 découle entièrement d’un seul facteur. La lecture la plus prudente est la suivante : sur ce lot de tâches quotidiennes internes à Tencent, avec cette configuration, l’écart de coût par tâche est d’environ 18 fois. Si vous changez de tâches, de longueur d’invite ou de niveau de réflexion, il faudra recalculer le résultat.
Hy4 flash vs Claude Haiku 5.5 : les différences essentielles
Le tableau ci-dessous met côte à côte les spécifications publiques des deux modèles. Celles de Hy4 flash proviennent de la page de recherche, celles de Haiku 5.5 de la page officielle Anthropic du modèle.
| Dimension de comparaison | Hy4 flash | Claude Haiku 5.5 | Remarque |
|---|---|---|---|
| Nombre de paramètres | 224B de paramètres totaux (dont 64B de paramètres Engram), 12B activés par token | Non communiqué par l’éditeur | On ne peut comparer qu’un seul côté |
| Fenêtre de contexte | 1M de tokens | 1M, sortie maximale de 128K | Match nul |
| Modalités | Multimodal natif | Entrée texte et image, sortie texte | Chacun a son point fort |
| Raisonnement | La page de recherche ne précise pas le niveau par défaut | Le raisonnement adaptatif est activé par défaut, effort par défaut = medium | Le test à l’aveugle utilisait high |
| Tarif catalogue (USD / million de tokens) | cache 0,003 ; entrée 0,070 ; sortie 0,281 | jusqu’à 100 000 : lecture du cache 0,01 ; entrée 0,10 ; sortie 0,50 | Hy4 flash est moins cher à l’unité |
| Vitesse de décodage | La page de recherche annonce plus de 150 tokens/s | Non couvert par les sources de cet article | — |
| ID du modèle | Non fourni sur la page de recherche, se référer à ce qu’affiche la console TokenHub | claude-haiku-5-5 |
— |
| Plateformes disponibles | Tencent Cloud TokenHub, etc. ; pas encore disponible sur APIYI | Anthropic officiel, APIYI apiyi.com | Voir la section tarifs ci-dessous |
Un détail passe facilement inaperçu : le niveau d’effort par défaut de Haiku 5.5 est medium, alors que le test à l’aveugle a utilisé high. Si vous appelez Haiku avec les paramètres par défaut dans votre propre projet, la vitesse et le coût que vous mesurez ne correspondent pas à la ligne Haiku du tableau du test à l’aveugle. Pour comparer avec les conclusions du test, il faut au minimum aligner le niveau d’effort.
WorkIndex et annexe : Haiku n’est pas dans ce tableau
La page de recherche propose aussi une évaluation interne appelée WorkIndex, qui comprend 8 jeux internes : génération de diapositives, édition de diapositives, co-écriture humain-machine de diapositives, co-écriture Markdown, édition de documents, réparation de tableaux, traitement audio/vidéo et compréhension visuelle. D’après le texte de la page de recherche, sur WorkIndex, le coût moyen par tâche de Hy4 flash représente 1/13 de celui de Hy4 preview, 1/20 de celui de Hy4 et 1/8 de celui de DeepSeek-V4.1-Flash-1017 (niveau Max, tarif en heures de pointe). Ces trois ratios ne concernent que WorkIndex et ne peuvent pas remplacer les montants en yuans du tableau de test à l’aveugle.
Le tableau récapitulatif en annexe compare au total 7 modèles, et Claude Haiku 5.5 n’y figure pas. Il n’existe donc pas de « score Terminal-Bench de Haiku », et cet article n’en ajoutera pas. L’annexe sert à illustrer l’écart entre les capacités maximales de Hy4 flash et de Hy4. Les données ci-dessous sont extraites de l’annexe de la page de recherche. Chaque cellule indique « score / coût par tâche (en yuans) » ; les coûts sont calculés par Tencent à partir des tarifs API officiels de chaque fournisseur, avec 1 dollar = 7.2 yuans :
| Élément (annexe de la page de recherche) | Hy4 flash | Hy4 | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|
| PPTCoEditBench | 74.0 / 0.105 | 78.9 / 1.714 | 76.8 / 0.459 |
| MdCoEditBench | 56.9 / 0.057 | 57.7 / 0.899 | 29.2 / 0.194 |
| AutomationBench v1.0.6 | 52.2 / 0.038 | 56.2 / 0.908 | 54.3 / 0.620 |
| Terminal-Bench 4.0 | 19.2 / 0.558 | 44.4 / 12.014 | 40.0 / 3.882 |
| ProgramBench (presque résolu) | 16.0 / 0.561 | 30.0 / 30.281 | 29.0 / 9.214 |
La tendance est assez claire. Sur les tâches de type document et de co-écriture, les scores de Hy4 flash et de Hy4 sont proches, mais le coût est inférieur d’un ordre de grandeur. Pour les tâches d’ingénierie longue haleine comme Terminal-Bench et ProgramBench, son score est inférieur à la moitié de celui de Hy4. Les prix en yuans de la colonne DeepSeek du tableau sont calculés par Tencent sur la base d’un tarif fixe en heures de pointe ; ils ne représentent pas la facture que vous auriez sur une plateforme quelconque. Ce ne sont pas non plus des places finales dans des classements publics.
La page de recherche contient aussi plusieurs témoignages des équipes produit. Par exemple, WorkBuddy affirme que, par rapport à Hy4, le temps moyen par tâche baisse de 70 %, que le coût est d’environ 1/15 et que la capacité de codage longue haleine diminue légèrement. Ce 1/15 est une évaluation de WorkBuddy elle-même ; ce n’est pas le même chiffre que le 1/20 de WorkIndex.
Comment comparer les prix de Hy4 flash et Claude Haiku 5.5
Les prix doivent être examinés selon deux référentiels distincts : le tarif officiel publié par Anthropic, et le tableau des modèles d’APIYI. Les deux ne suivent pas la même logique et ne peuvent pas être résumés en une seule phrase.
Les deux paliers tarifaires officiels de Claude Haiku 5.5
| Poste de facturation (USD par million de tokens) | Invite ≤ 100 000 tokens | Invite > 100 000 tokens |
|---|---|---|
| Entrée | 0.10 | 0.50 |
| Sortie | 0.50 | 2.50 |
| Écriture de cache 5 minutes | 0.125 | 0.625 |
| Écriture de cache 1 heure | 0.20 | 1 |
| Lecture de cache | 0.01 | 0.05 |
Selon les règles officielles, dès que l’invite dépasse 100 000 tokens, l’entrée, la sortie et la lecture de cache basculent ensemble vers le palier supérieur, et c’est la totalité de la requête qui est facturée au tarif élevé — pas seulement la portion qui dépasse. Pour calculer la longueur de l’invite, les lectures et les écritures de cache sont comptées. Résultat : dans des cas comme le question-réponse sur de longs documents, le prix unitaire réel peut atteindre cinq fois celui de la colonne de gauche du tableau.
Les modèles Haiku et apparentés dans le tableau des modèles APIYI
Lors d’une consultation, le 2026-11-16, de la liste des modèles et de l’interface de tarification d’APIYI (apiyi.com), les prix de claude-haiku-5-5 et claude-haiku-5-5-thinking dans le tableau principal étaient les suivants : entrée 0.10, sortie 0.50, lecture du cache 0.01 USD par million de tokens. La note de bas de page du tableau principal ne précise que les paliers d’entrée : 0.10 jusqu’à 100 000 tokens, 0.50 au-delà. La note ne mentionne pas le second palier de sortie. L’interface de tarification affiche, au-delà de 100 000 tokens, un InputRatio de 0.25 et un CompletionRatio toujours à 5. Pour la facturation réelle dans les scénarios à invite longue, fiez-vous à la liste des modèles et à la facture de la plateforme APIYI, et n’appliquez pas directement le 2.50 officiel.
| Modèle APIYI | Entrée / Sortie / Lecture du cache (USD par million de tokens) | Point de terminaison | Remarques |
|---|---|---|---|
claude-haiku-5-5 |
0.10 / 0.50 / 0.01 | chat, messages | Prix du tableau principal, la note ne liste que les paliers d’entrée |
hy4 |
0.85 / 2.55 / 0.045 | chat | C’est Hy4, pas Hy4 flash ; la page de recherche indique aussi 0.834 / 2.501 / 0.042 au tarif catalogue |
deepseek-v4.1-flash |
0.30 / 1.20 / 0.006 | chat, messages | Correspond au tarif de pointe officiel de DeepSeek, pas au tarif des heures creuses |
glm-5.3-flash |
0.15 / 0.50 / 0.03 | Uniquement OpenAI Chat Completions | Ne prend pas en charge Messages ni Responses |
DeepSeek dispose aussi de plusieurs canaux indépendants, par exemple deepseek-v4-1-flash-260910 (0.15 / 0.60 / 0.003) et deepseek-v4-1-flash-economy-261017 (0.24 / 0.96 / 0.006). Ce sont des modèles tarifés séparément, qui ne représentent pas le prix de toute la série V4.1 Flash.
Hy4 flash n’est pas encore disponible ; nous le mettrons en ligne dès que possible. Les modèles et les prix font foi selon la liste des modèles de la plateforme. Pour l’instant, Hy4 flash ne peut être appelé que via des canaux comme Tencent Cloud TokenHub ; la page de recherche ne fournit pas d’ID de modèle API, donc avant tout appel, référez-vous au nom affiché dans la console TokenHub. La page de recherche mentionne également que, jusqu’au 2026-11-30, l’utilisation est gratuite dans WorkBuddy et que l’API TokenHub est à moitié prix ; il s’agit d’un tarif promotionnel limité dans le temps, qui reviendra au tarif catalogue après l’échéance.
💰 Conseil de comparaison tarifaire : pour les modèles déjà disponibles sur APIYI, vous pouvez utiliser la même clé API demandée sur apiyi.com, envoyer les requêtes à
https://api.apiyi.com/v1, placer Haiku, DeepSeek et GLM dans un même lot de tâches pour comparer, puis calculer le coût par tâche d’après votre propre facture.
Recommandations de scénarios : Hy4 flash face à Claude Haiku 5.5
Les cas où choisir Hy4 flash
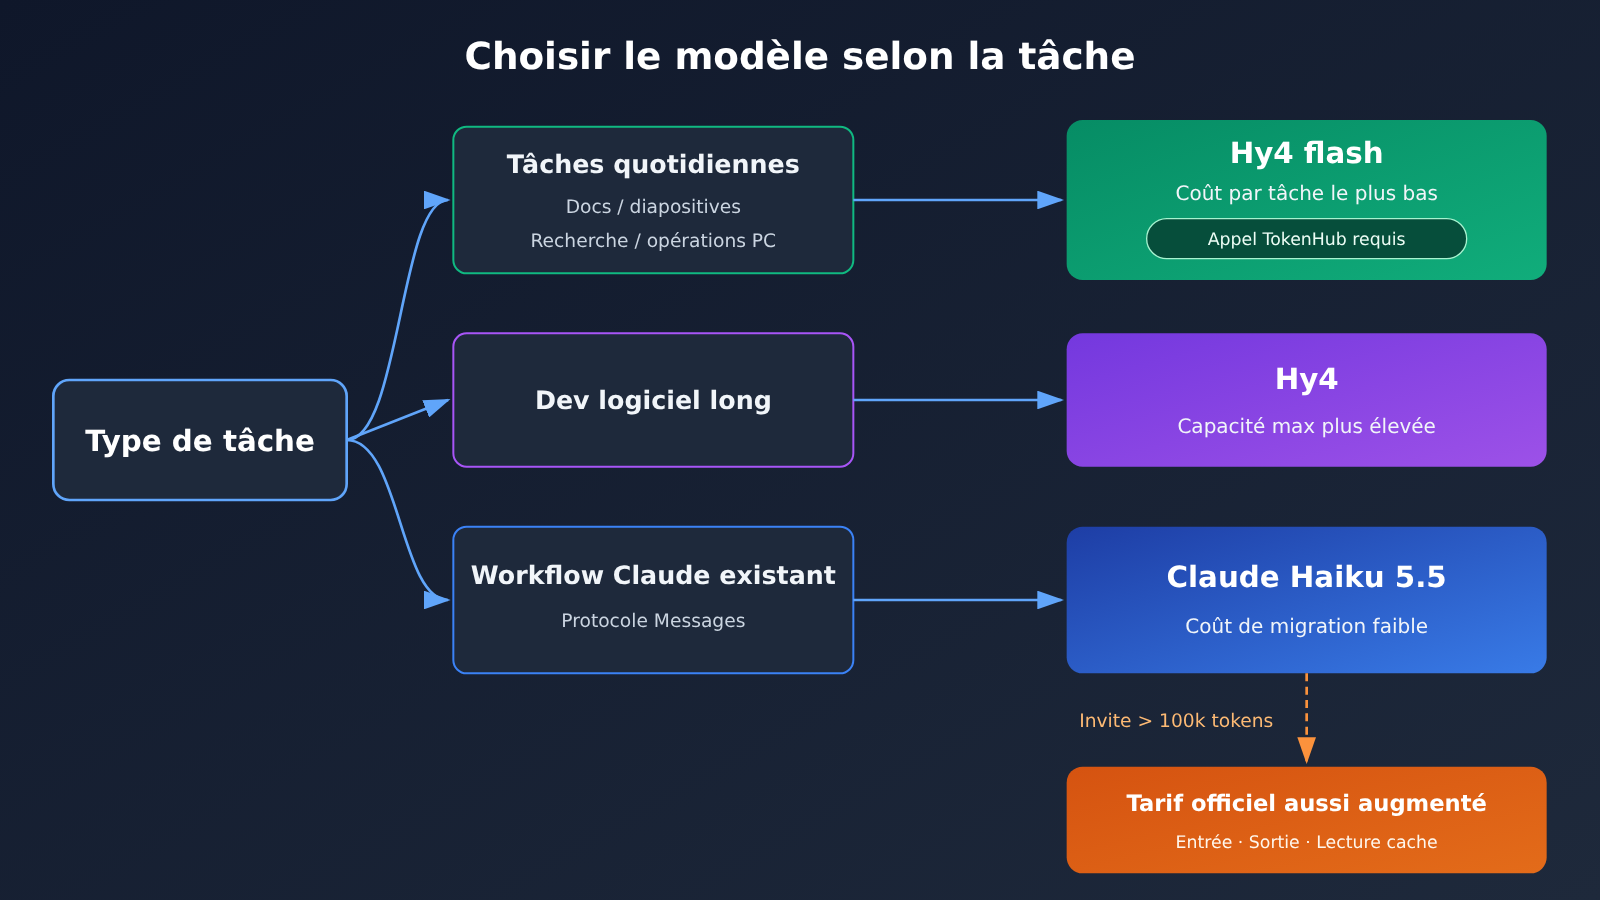
- Tâches quotidiennes à haute fréquence : la page de recherche le recommande pour la recherche approfondie, le traitement de documents, la création de diapositives, les démos front-end simples et les opérations sur ordinateur.
- Pipelines par lots sensibles au coût : lors des tests à l’aveugle, c’est le coût par tâche le plus faible, et le temps de complétion médian le plus court.
- Interactions sensibles au temps d’attente : la page de recherche annonce une vitesse de décodage supérieure à 150 tokens/s.
Les cas où continuer avec Claude Haiku 5.5
- Workflow Claude déjà en place : par exemple un projet qui s’appuie sur le protocole Anthropic Messages ou sur le groupe Claude Code — le coût de migration est plus faible.
- Besoin d’appeler dès maintenant via une plateforme d’agrégation : Haiku est déjà disponible sur APIYI, avec prise en charge des endpoints chat et messages.
- Appels à haute fréquence sur des invites courtes : tant que l’invite reste sous 100 000 tokens, le prix unitaire de Haiku est déjà bas, et son niveau de satisfaction dans les tests à l’aveugle est proche de celui de Hy4 flash.
Deux autres références
Si ce que vous privilégiez avant tout est la satisfaction, le meilleur score des tests à l’aveugle revient à DeepSeek-V4.1-Flash-1017 — au prix du temps d’exécution le plus long. Pour les tâches d’ingénierie logicielle de longue haleine, la page de recherche conseille de rester sur Hy4, dont le plafond de capacité est plus élevé. L’écart de 19,2 contre 44,4 sur Terminal-Bench, dans l’annexe, va dans le même sens.
Recommandations de décision : Hy4 flash face à Claude Haiku 5.5
Ne prenez pas une décision sur la seule base d’un facteur 18. Suivez l’ordre ci-dessous : votre conclusion n’en sera que plus fiable :
- Identifiez le type de tâche : ce n’est que pour les tâches quotidiennes comme les documents, les diapositives ou la recherche qu’il faut se référer aux conclusions du test à l’aveugle ; pour le codage de longue haleine, allez directement à l’annexe.
- Alignez le niveau de réflexion : dans le test à l’aveugle, Haiku était en mode high ; quand vous reproduisez le test, ne comparez pas avec le mode medium par défaut.
- Comptez la longueur de l’invite : au-delà de 100 000 tokens, le prix officiel de Haiku passe à un palier supérieur ; vérifiez séparément le tableau général d’APIYI et les notes de bas de page.
- Vérifiez le protocole :
glm-5.3-flashne prend en charge que Chat Completions ; Haiku etdeepseek-v4.1-flashprennent en charge à la fois les points de terminaison chat et messages. - Faites vos calculs avec vos propres tâches : le test à l’aveugle est une notation réalisée par 85 utilisateurs internes ; la répartition de vos activités peut être différente.
💡 Conseil de choix : après avoir trouvé l’ID exact du modèle sur docs.apiyi.com, utilisez une clé API d’apiyi.com pour connecter Haiku et les autres modèles déjà disponibles à la même adresse compatible OpenAI
https://api.apiyi.com/v1. Enregistrer la satisfaction, le temps passé et la facture sur un même lot de tâches réelles a bien plus de valeur de référence que de citer n’importe quel tableau d’autrui.
FAQ — questions fréquentes
Q1 : Entre Hy4 flash et Claude Haiku 5.5, lequel obtient la meilleure satisfaction ?
D’après les tests en aveugle publiés par Tencent elle-même, Haiku 5.5 obtient 2,81 et Hy4 flash 2,79, soit un écart de 0,02 point. La formulation utilisée sur la page de recherche est « proche ». Dans le tableau, le meilleur score de satisfaction revient à DeepSeek-V4.1-Flash-1017, avec 3,09.
Q2 : « 18 fois moins cher » signifie-t-il que tous les appels coûtent 18 fois moins ?
Non. Le facteur 18 provient uniquement du coût par tâche en aveugle : 4.73 元 contre 0.26 元. Si l’on calcule à partir du tarif catalogue par token, l’entrée de Hy4 flash représente environ 70 % de celle de Haiku et sa sortie environ 56 % — on est donc très loin d’un facteur 18.
Q3 : Dans l’annexe, comment le score Terminal-Bench de Hy4 flash se compare-t-il à celui de Haiku ?
La comparaison n’est pas possible. Haiku 5.5 ne figure pas dans le tableau général de l’annexe. Pour comparer les deux, il faut se limiter au tableau du test en aveugle. L’annexe est davantage adaptée à la comparaison entre Hy4 flash, Hy4 et DeepSeek, par exemple.
Q4 : Quand pourrai-je appeler Hy4 flash depuis APIYI ?
Au 2026-11-16, Hy4 flash n’est pas encore disponible sur APIYI ; la plateforme ne propose pour l’instant que `hy4`. Pour connaître les disponibilités, consultez la liste des modèles sur apiyi.com. En attendant, vous pouvez passer par Tencent Cloud TokenHub.
Q5 : Comment appeler Claude Haiku 5.5 depuis APIYI ?
Récupérez votre clé sur apiyi.com, définissez le base_url sur `https://api.apiyi.com/v1` et renseignez le model `claude-haiku-5-5` ; pour la version avec réflexion, utilisez `claude-haiku-5-5-thinking`. Les deux endpoints chat et messages sont utilisables.
Q6 : À quoi faut-il faire attention avec Haiku sur les longues invites ?
Selon les règles officielles d’Anthropic, au-delà de 100 000 tokens d’invite, l’entrée, la sortie et la lecture de cache de toute la requête passent au palier supérieur. Le tableau récapitulatif d’APIYI ne mentionne en note de bas de page que le palier d’entrée ; pour le second palier de sortie, référez-vous à la liste de la plateforme et à votre facture réelle.
Q7 : Les poids de Hy4 flash sont-ils open source ?
La page de recherche indique qu’une publication open source est prévue, mais elle ne précise pas que les poids ont déjà été diffusés. La mise en ligne sur OpenRouter est également annoncée comme « imminente ».
Hy4 flash face à Claude Haiku 5.5 : l’essentiel à retenir
- Proches en test à l’aveugle, pas supérieurs : satisfaction 2,79 contre 2,81, données issues d’un test à l’aveugle interne autodéclaré par Tencent.
- Le facteur 18 n’a qu’une seule source : coût par tâche en test à l’aveugle de 4,73 yuans contre 0,26 yuan, ce qui ne signifie pas une baisse générale des tarifs.
- Les configurations doivent être alignées : dans le test à l’aveugle, Haiku tourne au niveau high, alors que son effort par défaut est medium.
- Haiku est absent de l’annexe : ne déduisez pas et ne complétez pas les scores de Haiku à partir de l’annexe.
- Pour l’ingénierie au long cours, choisissez Hy4 : sur Terminal-Bench, Hy4 flash obtient 19,2 et Hy4 44,4.
- Haiku passe à l’échelon supérieur sur les longues invites : au-delà de 100 000 tokens au tarif officiel, l’entrée, la sortie et la lecture du cache augmentent ensemble.
- Les prix se lisent sur deux grilles : vérifiez séparément le tarif officiel et la table des modèles APIYI, Hy4 flash n’est pas encore disponible sur APIYI.
En résumé
La comparaison entre Hy4 flash et Claude Haiku 5.5 tient en trois phrases :
- Qualité : dans le test à l’aveugle interne de Tencent sur des tâches quotidiennes, les niveaux de satisfaction sont proches, et le temps médian de Hy4 flash est légèrement plus court.
- Coût : le facteur d’environ un dix-huitième concerne le coût par tâche, l’écart de prix par token est bien plus faible que ce multiple.
- Limites : pour l’ingénierie logicielle au long cours, continuez avec Hy4 ; pour les scénarios à longues invites, calculez d’abord les règles de montée en gamme de Haiku.
Pour les tâches de documents quotidiens, de diapositives et de recherche, il vaut la peine d’ajouter Hy4 flash à la liste des candidats. À ce stade, Haiku, DeepSeek et GLM sont déjà disponibles : vous pouvez commencer par les tester sur APIYI apiyi.com avec vos propres tâches, et calculer le coût par tâche.
📚 Références
- Page de recherche Hy4 flash : spécifications, tests à l’aveugle, WorkIndex, annexes et informations sur les canaux de distribution
- Lien :
hy.tencent.ai/research/hy4-flash - Description : les tests à l’aveugle, le WorkIndex et les témoignages produits sont tous des déclarations de l’entreprise elle-même
- Lien :
- Publication officielle de Tencent Hunyuan : coût de tâche 18x et tarifs publics (prix catalogue), citation exacte
- Lien :
x.com/TencentHunyuan/status/2122217770314301469 - Description : publié le 2026-11-16
- Lien :
- Page officielle du modèle Claude Haiku 5.5 : ID du modèle, contexte et deux paliers de prix
- Lien :
platform.claude.com/docs/en/models/haiku-5-5/overview - Description : la règle de changement de palier à 100 000 tokens s’appuie sur cette page
- Lien :
- Page de tarification officielle de DeepSeek : prix des deux paliers, heure de pointe et heure creuse
- Lien :
api-docs.deepseek.com/quick_start/pricing - Description : sert à vérifier à quel palier correspond le modèle APIYI
- Lien :
Auteur : Équipe technique APIYI
Échanges techniques : pour les ID de modèles et les prix, référez-vous à la liste des modèles sur docs.apiyi.com ; n’hésitez pas à nous contacter via la page d’accueil du site APIYI


