
Anmerkung des Autors: d1.2-ultra belegt Platz 1 im Decision Index v2.1. Dieser Artikel zeigt dir, wie du zuerst einordnest, ob deine Aufgabe eher in die Dokumentenextraktion, den Tool-Aufruf oder das Beantworten schwieriger Fragen fällt, dann nur die Teilwertung betrachtest, die zu deinem Fall passt, und anschließend mit 20 bis 50 eigenen Beispielen entscheidest, ob du wechselst.
Am 16.11.2026 veröffentlichte Liquid AI d1.2 und d1.2-ultra. Laut offiziellem Blog erreicht d1.2-ultra im Artificial Analysis Decision Index v2.1 einen Wert von 75 – der höchste unter den Entscheidungsmodellen. Viele Entwickler, die gerade an der API arbeiten, sehen „Platz 1“ und wollen sofort ihr Produktionsmodell austauschen. Nicht so schnell wechseln: Die Gesamtpunktzahl von 75 ist nur der Aufhänger. Worauf es wirklich ankommt, ist der Teilwert, der zu deinem Geschäft passt.
Dies ist weder ein Verriss noch eine Lobeshymne. Dasselbe Modell steht bei der Dokumentenextraktion auf Platz 1 und hat bei schwierigen Multiple-Choice-Fragen die niedrigste Rohgenauigkeit aller 24 Entscheidungsmodelle. Beides gilt gleichzeitig – eine Gesamtpunktzahl nivelliert genau diesen Unterschied.
Der Kernnutzen: Nach der Lektüre weißt du, welchen Teilwert du heranziehen solltest, wie du Entscheidungswert und Rohgenauigkeit liest und wie du mit 20 bis 50 eigenen Beispielen an einem Nachmittag zu einer Entscheidung für oder gegen den Wechsel kommst.
d1.2-ultra – Die Kernpunkte des Gesamtsiegers
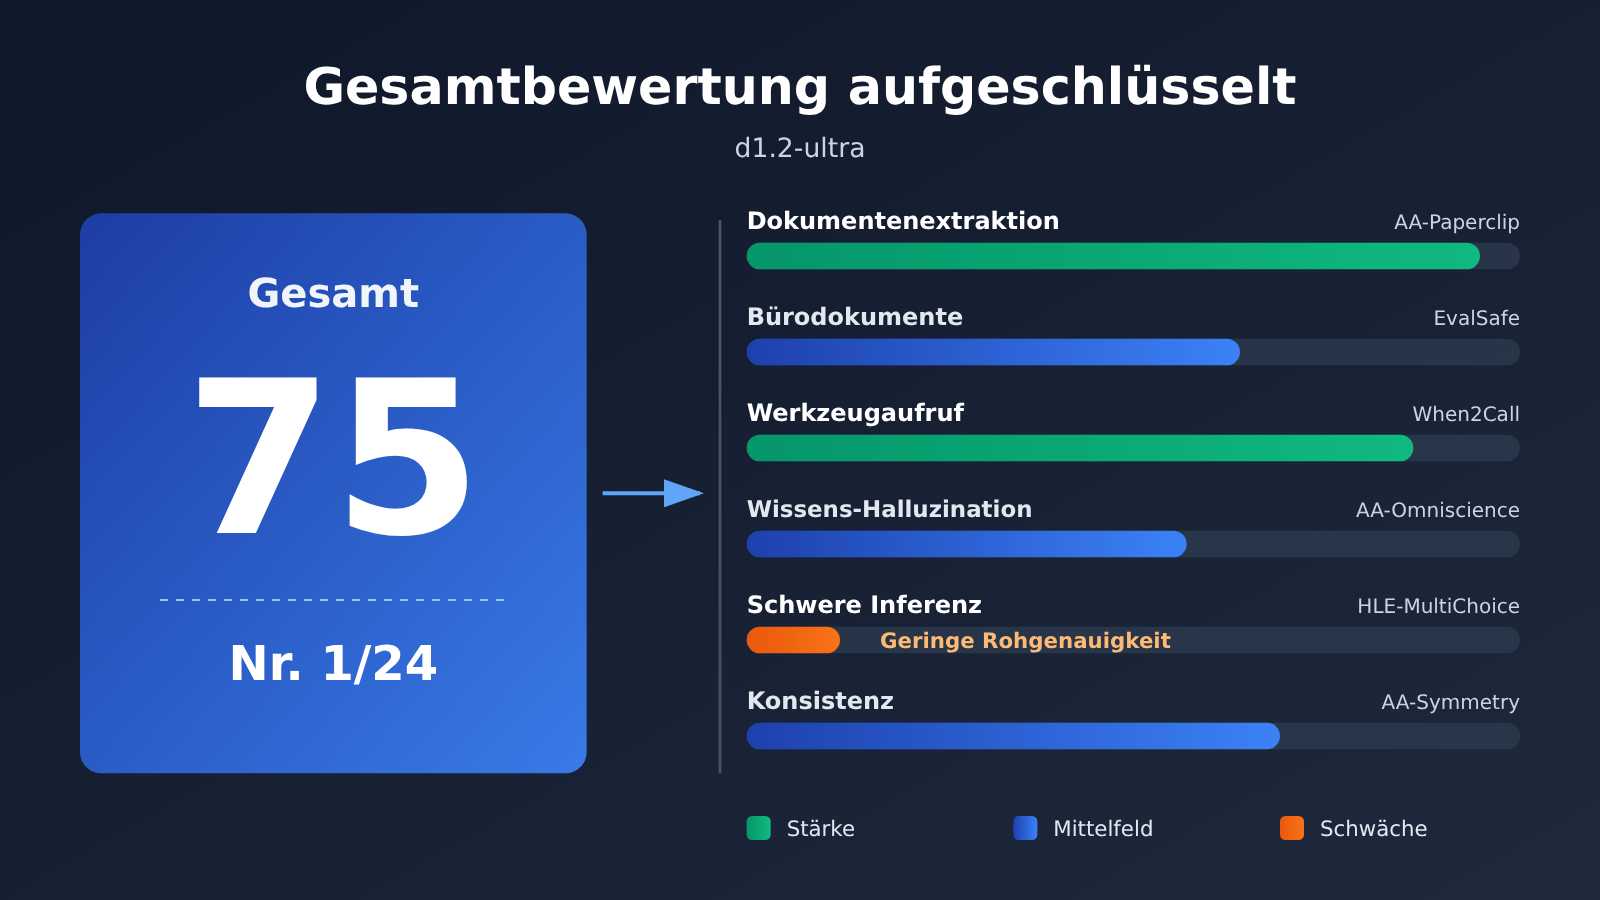
Klären wir zuerst die Zahlen auf der Ranglistenseite. Die folgenden Daten stammen von der Modellseite von d1.2-ultra bei Artificial Analysis, Stand 2026-11-17. Insgesamt wurden 24 Entscheidungsmodelle verglichen.
| Kennzahl | Daten auf der Ranglistenseite | Interpretation |
|---|---|---|
| Gesamtindex | 74.85, die Seite zeigt 75, Platz 1/24 | Platz 2, Drex Max v1.1, liegt bei 72.62; die Differenz beträgt etwa 2.2 Punkte. Das ist dieselbe Aussage wie die offiziell genannten „zwei Punkte“, nur gerundet |
| Laufzeit | 218 Millisekunden/Aufgabe, Platz 14/24 | Der Seitenmedian liegt bei 209 Millisekunden, damit im Mittelfeld |
| Kosten für einen vollständigen Indexlauf | 133 US-Dollar pro Million Aufgaben, Platz 11/24 | Das sind Aufgabenkosten, nicht der Listenpreis pro Million Token |
| Eingabepreis | 0.042 US-Dollar pro Million Token | Deckt sich mit dem offiziellen Liquid-Blog; offiziell wird nur der Input berechnet |
| Brier | 0.150, der niedrigste von 24 | Niedriger ist besser; die ausgegebenen Wahrscheinlichkeiten sind vergleichsweise „ehrlich“ |
Wie die Gesamtpunktzahl von d1.2-ultra zustande kommt
Der Decision Index v2.1 ist der gewichtete Durchschnitt aus sechs Unterwerten. Die Modellseite definiert den Entscheidungswert so: Genauigkeit minus Brier-Score der Wahrscheinlichkeit der gewählten Antwort, Skala von 0 bis 100, höher ist besser. Anders gesagt: Selbstsicher falsch zu antworten kostet mehr Punkte als zögerlich falsch zu antworten. Die Rohgenauigkeit ist dagegen der Anteil der Aufgaben, bei denen das Modell der richtigen Option die höchste Wahrscheinlichkeit zuweist. Sie ist nicht derselbe Wert wie der Entscheidungswert.
Dieser Unterschied wirkt sich direkt darauf aus, wie du d1.2-ultra liest. Ein Modell kann einen gar nicht so niedrigen Entscheidungswert erreichen, indem es häufig nicht rät und dadurch weniger selbstsichere Fehler macht, während die Rohgenauigkeit sehr niedrig ist. Wenn dein Anwendungsfall zwingend eine Antwort verlangt, solltest du auf die Rohgenauigkeit schauen; wenn bei Unsicherheit an einen Menschen übergeben werden darf, ist der Entscheidungswert aussagekräftiger.
| Unterwert | Gewicht | Was gemessen wird | AA-Kategorie |
|---|---|---|---|
| AA-Paperclip | 30 % | Beurteilung und Extraktion von Belegen; 15 Antworten pro Dokument zählen als eine Beurteilung | Dokumente |
| EvalSafe-O*NET-AA | 15 % | Beurteilung von Dokumenten aus dem Arbeitsumfeld | Dokumente |
| When2Call | 10 % | Tool-Aufrufe | Tools |
| AA-Omniscience-Decision v1.1 | 15 % | Wissen und Halluzinationen | Wissen |
| HLE-MultiChoice v1.1 | 15 % | Text-Multiple-Choice aus Humanity’s Last Exam; Antwort kann verweigert werden | Reasoning |
| AA-Symmetry v1.1 | 15 % | Ob das Urteil unverändert bleibt, wenn man die Formulierung ändert, die Reihenfolge der Optionen vertauscht oder eine Negation hinzufügt | Konsistenz |
Achtung: HLE-MultiChoice wird bei AA als Reasoning und nicht als Wissen eingestuft. Wenn es weiter unten erwähnt wird, sollte es deshalb nicht als „Wissenstest“ bezeichnet werden.
So ordnest du die d1.2-ultra-Punktzahl dem richtigen Kriterium zu
Der erste Schritt ist nicht, auf die Rangliste zu schauen. Nimm dir stattdessen ein Blatt Papier und schreibe auf, zu welcher Kategorie deine Aufgabe wirklich gehört: Belege extrahieren, Tools aufrufen, schwierige Fragen beantworten oder Wissensfragen. Danach schaust du nur auf den Punkt, der dazu passt. Alle anderen Teilwerte und den Gesamtwert 75 lässt du vorerst außen vor.
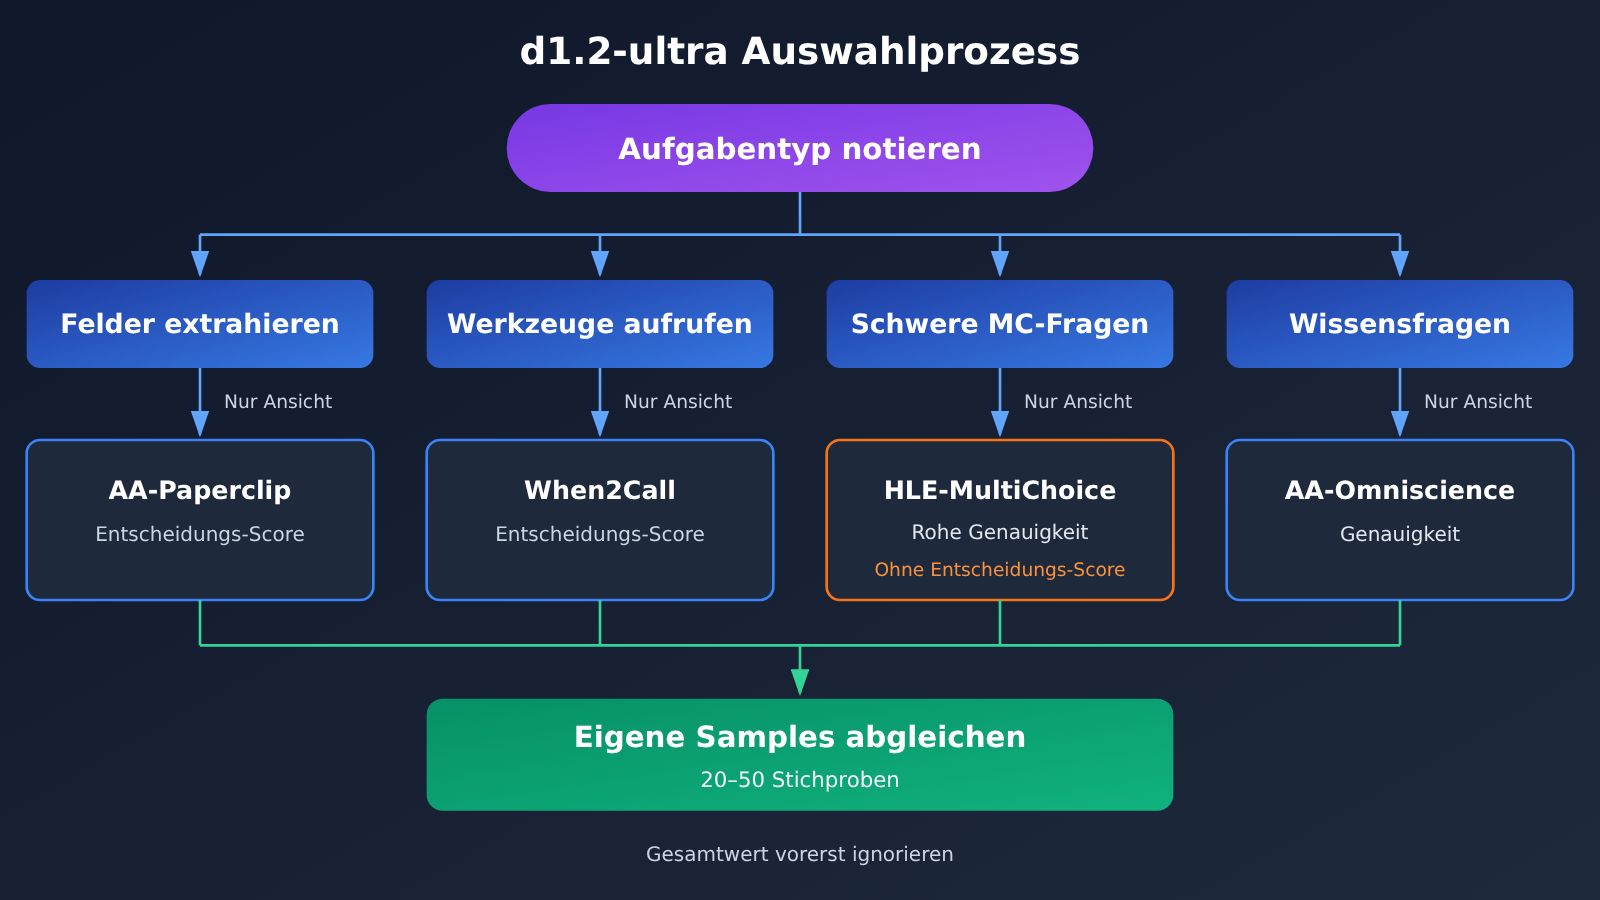
| Deine Aufgabe | Nur diese Kennzahl ansehen | Daten auf der d1.2-ultra-Ranglistenseite | So liest du sie |
|---|---|---|---|
| Rechnungen, Lebensläufe, Paper-Felder extrahieren | AA-Paperclip | Entscheidungswert 75,81, Dokument-Volltrefferquote 67,7 %, beides Platz 1/24 | Platz 2: Drex Max v1.1 mit 72,82 und 63,0 % – der Vorsprung ist recht deutlich |
| Tools aufrufen und entscheiden, ob ein Aufruf nötig ist | When2Call | Entscheidungswert 96,49, Platz 1 | SubQ Snap 1.2 liegt bei 96,10, d1.2 bei 96,09; die Spitzengruppe drängt sich auf rund 1 Punkt zusammen |
| Bewertung von Arbeitsplatzdokumenten | EvalSafe-O*NET-AA | Entscheidungswert 89,53, Platz 3 | Davor liegen Jev 1.14 (91,14) und GLiDE v1.2 (89,67) |
| Sehr schwierige Multiple-Choice-Fragen beantworten | HLE-MultiChoice-Rohgenauigkeit | 2,36 %, der niedrigste Wert unter 24 Entscheidungsmodellen | Der Entscheidungswert 46,36 liegt nicht auf dem letzten Platz; die Nicht-Halluzinationsrate beträgt 76,1 % – das Modell entscheidet sich oft dafür, nicht zu raten |
| Wissensfragen | AA-Omniscience-Genauigkeit | Rohgenauigkeit 23,6 %, Platz 20/24 | Entscheidungswert 60,80, Platz 6; Nicht-Halluzinationsrate 83,8 % |
| Antwortstabilität bei Umformulierung | AA-Symmetry-All-Pass-Rate | Punktzahl 86,34, Platz 2; All-Pass-Rate 56,7 %, Platz 5 | Platz 2 beim Punktwert heißt nicht Platz 2 bei der Stabilität |
d1.2-ultra: die zwei am leichtesten fehlinterpretierbaren Einzelposten
Der erste Punkt ist HLE-MultiChoice. Die rohe Genauigkeit von 2,36 % ist tatsächlich die niedrigste unter den 24 Entscheidungsmodellen, aber der Entscheidungswert von 46,36 liegt nicht am Ende der Skala – auf derselben Seite stehen noch niedrigere Werte, etwa Mercury Decide mit 34,79. Zusammen mit der Nicht-Halluzinationsrate von 76,1 % ist die sinnvolle Lesart: Bei sehr schwierigen Multiple-Choice-Denkaufgaben neigt d1.2-ultra dazu, keine Antwort mit hoher Konfidenz zu geben. AA ordnet diesen Posten der Kategorie „Reasoning“ zu, deshalb sollte man ihn nicht als „Letzter im Wissenstest“ darstellen.
Der zweite Punkt ist AA-Omniscience. Die Genauigkeit von 23,6 % bedeutet Platz 20 von 24, nicht den letzten Platz. Interessant ist, dass das kleinere d1.2 auf derselben Seite bei diesem Posten 30,0 % erreicht und auch bei der rohen HLE-Genauigkeit 5,30 % – beide Werte liegen über ultra. Aber der Gesamtindex von d1.2 beträgt 68,69, was Platz 9 von 24 entspricht. Die Aussage „das teurere ultra hat schlechteres Wissen“ gilt also nur für diese beiden Posten und lässt sich nicht zu einem pauschal schlechteren Abschneiden hochrechnen.
🎯 Tipp zum Lesen der Rangliste: Wenn Ihre Aufgabe darin besteht, Belege zu extrahieren, verdient der Platz 1 von
d1.2-ultrabei AA-Paperclip durchaus Beachtung; geht es um Tool-Aufrufe, ist der Platz 1 echt, aber der Abstand zu den nachfolgenden Plätzen liegt innerhalb von 1 Punkt – ob ein Wechsel sinnvoll ist, hängt von Ihren eigenen Stichproben ab.
Wie die offiziellen Eigenangaben von d1.2-ultra zu lesen sind
Liquid hat im selben Blogbeitrag außerdem fünf neue Aufgaben und interne Testergebnisse veröffentlicht. Der Anbieter schreibt ausdrücklich, dass diese neuen Aufgaben noch von keinem öffentlichen Benchmark abgedeckt sind. Die folgenden Werte sind daher durchweg Eigenangaben des Herstellers, erhoben auf einem internen Holdout-Set – nicht Ergebnisse von Artificial Analysis.
| Neue Aufgabe (Herstellerangabe) | d1.2-ultra | d1.2 | Anmerkung |
|---|---|---|---|
| Kassenzettel auslesen (CORD, SROIE) | 98% | 96% | Fehlende Werte werden mit not found beantwortet |
| Spans sensibler Daten (Nemotron PII), Präzision/Recall | 94% / 93% | 92% / 88% | Gibt die Position jedes Abschnitts an |
| Objekte per Beschreibungsbox (RefCOCO-Serie) | 94% | 94% | Beide gleichauf |
| Objekte zählen, Abweichung 1 erlaubt (COCO) | 93% | 92% | Schätzt eine Zahl und gibt eine Spanne an |
| Jedes Objekt im Bild heraussuchen (COCO) | 87% | 90% | In dieser Zeile liegt das günstigere d1.2 vorn |
Im Audio-Bereich gibt der Hersteller an, dass beide auf Holdout-Aufnahmen bei der Erkennung von Schallkategorien (ESC-50) und der Sprache (FLEURS, 43 Sprachen) etwa 95 bis 97% erreichen. Bei der Kalibrierungsabweichung hat Liquid über 13 Benchmarks und 22505 Fragen für d1.2-ultra einen Wert von 0.8 gemessen, für d1.2 1.2, für Jev 1.14 2.7, für Perplexity Decider v1.3 3.7 und für die Decisions API von GPT-6 Luna 7.2.
Hier muss man besonders genau unterscheiden: GPT-6 Luna (Decisions) kommt in der Entscheidungsrangliste von Artificial Analysis auf einen Gesamtindex von 60.25, Platz 22/24, und auf eine rohe HLE-Genauigkeit von 7.86%. Das sind alles Werte der Decisions-Schnittstelle – die darf man nicht als Werte der Chat-Schnittstelle gpt-6-luna verbuchen. Im offiziellen Blog steht außerdem „Coming to OpenRouter and Vercel soon“. Das ist eine Ankündigung des Herstellers und bedeutet nicht, dass es bereits live ist.
d1.2-ultra schnell ausprobieren: Mit eigenen Stichproben gegenprüfen
Nach der Bestenliste entscheidet vor allem eines: deine eigenen Daten. 20 bis 50 echte Beispiele reichen schon aus, zum Beispiel 30 Rechnungen oder 30 Lebensläufe. Kennzeichne vorab die korrekten Feldwerte – und baue am besten ein paar Beispiele ein, bei denen bewusst ein Feld fehlt.
Minimaler Ablauf
- Wähle 20 bis 50 Beispiele aus dem Geschäftsbetrieb aus und trage für jedes Feld den korrekten Wert manuell ein. Fehlende Felder markierst du als
not found. - Schreibe eine feste Eingabeaufforderung: Das Modell soll die gewünschten Felder als JSON ausgeben. Felder, die nicht gefunden werden, müssen mit
not foundgefüllt werden – Raten ist nicht erlaubt. - Nutze das OpenAI-kompatible SDK, setze
base_urlaufhttps://api.apiyi.com/v1und trage beimodelzuerstgpt-6-lunaein. Wechsle danach zugpt-6.1-solund lass beide Modelle einmal über dieselben Beispiele laufen. - Vergleiche Datensatz für Datensatz und notiere drei Kennzahlen: Feldgenauigkeit, Anteil vollständig korrekter Dokumente und wie oft fehlende Felder fälschlich befüllt wurden.
- Sobald das Zielmodell aufrufbar ist, lässt du dieselben Beispiele mit derselben Eingabeaufforderung erneut laufen und vergleichst die drei Kennzahlen direkt.
Vollständige Vergleichslogik ansehen
– **Eingabe**: Eine Beispieldatei, in der jede Zeile den Originaltext (oder das Bild) und eine manuell erstellte Zuordnung der Feldwerte enthält.
– **Aufruf**: Lies die Beispiele in einer Schleife ein, rufe `client.chat.completions.create` oder den `responses`-Endpoint auf, setze `temperature` auf 0 und verlange eine strikte JSON-Ausgabe.
– **Parsing**: Zähle fehlgeschlagenes Parsing der Ausgabe separat – das ist bereits ein eigener Indikator für die Nutzbarkeit.
– **Vergleich**: Vergleiche jedes Feld normalisiert: Leerzeichen entfernen, Datumsformat vereinheitlichen, Beträge auf zwei Nachkommastellen runden.
– **Halluzinationszählung**: Felder, die als `not found` annotiert sind, aber vom Modell mit einem Wert gefüllt wurden, zählst du separat als „geraten“.
– **Zusammenfassung**: Gib Feldgenauigkeit, Dokument-Gesamtkorrektheit, Zahl der Fehlschätzungen und durchschnittlichen Token-Verbrauch aus, damit du später die Kosten berechnen kannst.
Mit APIYI zuerst eine Baseline erstellen
Das kostet Token. d1.2 und d1.2-ultra stehen nicht auf der Modellliste von APIYI. Deshalb kannst du vorerst bei APIYI (apiyi.com) die bereits verfügbaren Modelle gpt-6.1-sol oder gpt-6-luna verwenden, die Endpoint-Adresse https://api.apiyi.com/v1 nutzen und dieselbe Charge Rechnungen oder Lebensläufe durchlaufen lassen. So siehst du, ob die Felder stimmen und ob das Modell bei fehlenden Feldern rät. Damit hast du eine quantifizierbare Baseline in der Hand.
Derzeit noch nicht verfügbar: Wir stellen dieses Modell so bald wie möglich bereit. Modellbezeichnung und Preis richten sich nach der Modellliste der Plattform.
| Prüfpunkt | Erfassung | Bewertung |
|---|---|---|
| Feldgenauigkeit | Korrekte Felder / Gesamtfelder | Vergleich mit dem aktuellen Produktionsmodell |
| Anteil vollständig korrekter Dokumente | Anteil der Dokumente, bei denen alle Felder korrekt sind | entspricht der „Dokument-Gesamtkorrektheit“ von AA-Paperclip |
| Zahl der Fehlschätzungen | Anzahl der not found-Felder, denen ein Wert zugewiesen wurde |
Je weniger, desto besser; folgt dem Gedanken einer niedrigen Halluzinationsrate |
| Parsing-Fehler | Anzahl nicht parsebarer JSON-Antworten | wirkt sich direkt auf die Kosten im Produktivbetrieb aus |
| Token-Verbrauch | Durchschnittliche Input-/Output-Token pro Datensatz | dient zur Umrechnung in tatsächliche Kosten |
🚀 Tipp für den Einstieg: Nutze zuerst das kostenlose Testguthaben für neue Nutzer bei APIYI auf apiyi.com, um 20 Datensätze laufen zu lassen. Prüfe, ob Eingabeaufforderung und Vergleichsskript funktionieren, und erweitere dann auf 50 – so verbrauchst du dein Guthaben nicht von Anfang an fürs Debuggen.
d1.2-ultra: Preise und Aufrufweise
Bei den Preisen muss man die Einheit genau beachten. Die 133 USD in der Rangliste sind die Benchmark-Kosten „pro Million Aufgaben“. Der offizielle Liquid-Preis bezieht sich dagegen auf „pro Million Eingabe-Token“: d1.2 kostet 0.02 USD, d1.2-ultra kostet 0.042 USD, wobei nur die Eingabe berechnet wird. Bilder werden mit 1.5 Token pro 32×32 Pixel zum Textpreis berechnet; 1024×1024 entsprechen etwa 1536 Token. Text und Bilder einer Anfrage werden nur einmal gezählt; kommt eine weitere Frage hinzu, wird nur der Text dieser Frage zusätzlich angerechnet.
Auch die offizielle Aufrufweise unterscheidet sich von gängigen Chat-Schnittstellen: Die Modell-IDs sind d1.2-ultra und d1.2, die Adresse ist https://api.liquid.ai/decisions/v1/systemone, und der Schlüssel wird in der Liquid-Konsole beantragt. Der offizielle Blog nennt Text-, Bild- und Audioeingaben; die technische Spezifikation auf der Artificial-Analysis-Seite führt Text und Bilder sowie ein Kontextfenster von 66k auf. Diese Fenstergröße erscheint nur auf der Ranglistenseite und ist keine von Liquid im Blog veröffentlichte Spezifikation.
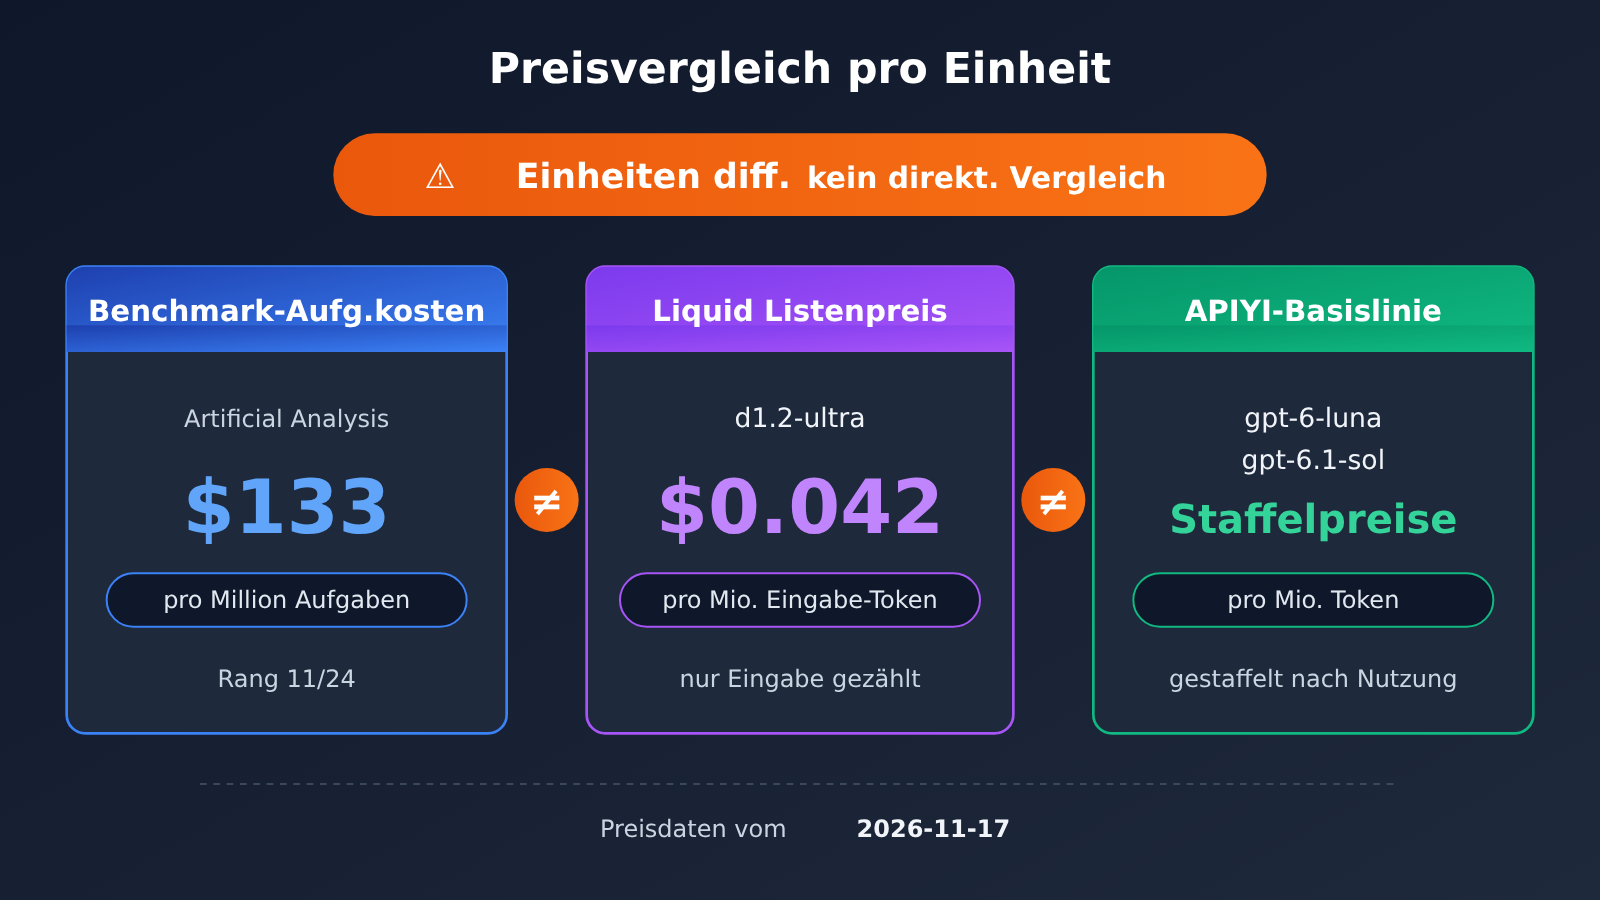
Die für die Baseline verwendeten APIYI-Modelle kosten wie folgt (Einheit: USD pro Million Token, gestaffelt nach Tokenmenge pro Anfrage; Daten aus der Preis-API vom 2026-11-17, konsistent mit der Aktualisierung der Modellübersicht vom 2026-11-16):
| Modell | Stufe | Eingabe | Ausgabe | Cache-Lesezugriff | Endpunkt |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses bevorzugt, auch chat |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | nicht separat ausgewiesen | wie oben |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses bevorzugt, auch chat |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | nicht separat ausgewiesen | wie oben |
💰 Kostenhinweis: Für einen Vergleich mit 50 Stichproben eignet sich
gpt-6-luna, um zunächst Volumen zu fahren;gpt-6.1-soltaugt als hochwertige Referenz. Bei APIYI apiyi.com wird die Aufladung mit 1:7 gerechnet, Gruppenrabatte lassen sich kombinieren; maßgeblich ist die tatsächliche Abrechnung in der Konsole.
Häufige Fragen (FAQ)
F1: Was für ein Modell ist d1.2-ultra?
Es ist ein Entscheidungsmodell von Liquid AI, veröffentlicht am 2026-11-16 und zeitgleich mit dem kleineren d1.2 erschienen. Entscheidungsmodelle zeichnen sich dadurch aus, dass sie für jede Option eine Wahrscheinlichkeit ausgeben. Sie eignen sich für Aufgaben, bei denen eine Auswahl getroffen werden muss – Beleg-Extraktion, Beurteilung von Tool-Aufrufen, Klassifikation – und weniger für lange Textproduktion.
F2: Ist d1.2-ultra, weil es im Gesamtranking Platz 1 belegt, auch insgesamt das stärkste Modell?
Nein. Der Gesamtindex von 74.85 bedeutet Platz 1 von 24, aber bei EvalSafe-O\*NET-AA liegt es auf Platz 3, bei der All-Pass-Rate von AA-Symmetry auf Platz 5, bei der Rohgenauigkeit von AA-Omniscience auf Platz 20, und bei HLE-MultiChoice hat es die niedrigste Rohgenauigkeit aller 24. Der Gesamtwert sagt nur, dass es nach der Gewichtung vorne liegt.
F3: Ist das bei HLE-MultiChoice nicht der letzte Platz in einem Wissenstest?
Nein. Letzter ist HLE-MultiChoice bei der Rohgenauigkeit mit 2.36 %, und zwar unter den 24 Entscheidungsmodellen. Der Entscheidungswert von 46.36 liegt dagegen nicht am Ende, und AA führt diesen Punkt als Reasoning und nicht als Wissen.
F4: Für welche Szenarien passt d1.2-ultra am besten?
Auf der Ranglistenseite passen am besten das Extrahieren von Feldern aus Rechnungen, Lebensläufen und Papers (AA-Paperclip: Entscheidungswert und Volltrefferquote jeweils Platz 1) sowie die Beurteilung von Tool-Aufrufen (When2Call Platz 1, wobei die Abstände zwischen den Spitzenplätzen etwa 1 Punkt betragen). Bei schwierigen Multiple-Choice-Fragen und Wissensfragen ist die Rohgenauigkeit nicht im Vorteil.
F5: Kann ich d1.2-ultra derzeit bei APIYI aufrufen?
Derzeit stehen d1.2 und d1.2-ultra nicht in der Modellliste von APIYI. Sie sind noch nicht gelistet, wir werden dieses Modell aber so schnell wie möglich aufnehmen; Modelle und Preise richten sich nach der Modellliste der Plattform. Unsere Empfehlung: Erstellen Sie zuerst bei APIYI auf apiyi.com mit `gpt-6-luna` oder `gpt-6.1-sol` eine Baseline auf Ihren eigenen Samples, um dann direkt das Modell zu wechseln und zu vergleichen.
F6: Kann man den von Liquid veröffentlichten Kalibrierungsfehler von 0.8 einfach so glauben?
Das war Liquids eigener Test über 13 Benchmarks und 22505 Aufgaben, also eine Angabe des Anbieters selbst. Was sich mit der Ranglistenseite gegenprüfen lässt, ist der Brier-Wert von 0.150 – der niedrigste unter den 24. Die Richtung passt, aber für Ihr konkretes Geschäft sollten Sie trotzdem prüfen, ob die Zahl der „Rateversuche“ in Ihren eigenen Samples tatsächlich geringer ausfällt.
F7: Sind die 7.2 von GPT-6 Luna und das `gpt-6-luna` bei APIYI dasselbe?
Nein, das ist nicht dasselbe. Die 7.2 sind der Kalibrierungsfehler der Decisions API von GPT-6 Luna im Test von Liquid, und die 60.25 auf der Rangliste sind ebenfalls ein Ergebnis der Decisions-Schnittstelle. Das `gpt-6-luna` bei APIYI ist eine Chat-Schnittstelle; die Leistung müssen Sie mit Ihren eigenen Samples messen.
F8: Wie viele Samples braucht man eigentlich?
20 bis 50 Stichproben reichen aus, um einen deutlichen Unterschied zu erkennen. Entscheidend ist, dass sie die reale Verteilung abdecken: häufige Formate, seltene Formate und Beispiele mit fehlenden Feldern müssen alle vorkommen. Liegen zwei Modelle bei 50 Stichproben nur ein bis zwei Fälle auseinander, heißt das: Ein Wechsel ist optional – dann zählt zuerst der Preis und die Latenz.
d1.2-ultra Kernpunkte (Key Takeaways)
- Die 75 in der Gesamtwertung ist nur der Aufhänger: 74,85 und damit Platz 1 von 24, rund 2,2 Punkte Vorsprung vor Platz 2 – das heißt aber nicht, dass es in jeder Kategorie Erster ist.
- Für die Belegauswertung: AA-Paperclip: Entscheidungswert 75,81, Volltrefferquote 67,7 % – beides Platz 1.
- Für Tool-Aufrufe: When2Call: 96,49, Platz 1 – doch die führenden Modelle liegen innerhalb von etwa 1 Punkt beieinander.
- Bei schwierigen Aufgaben die rohe Genauigkeit ansehen: HLE-MultiChoice liegt mit 2,36 % am niedrigsten; beim Entscheidungswert ist es nicht Schlusslicht, AA führt es als Reasoning-Modell.
- Bei Wissensfragen die Omniscience-Genauigkeit ansehen: 23,6 %, Platz 20 von 24 – nicht Letzter.
- Einheiten nicht verwechseln: 133 US-Dollar pro Million Aufgaben, 0,042 US-Dollar pro Million Input-Token.
- Mit Stichproben entscheiden: Testen Sie zuerst auf APIYI apiyi.com mit den aktuell verfügbaren Modellen 20 bis 50 Fälle und protokollieren Sie Feldgenauigkeit und Anzahl der Rateversuche.
Zusammenfassung
Wer die Rangliste von d1.2-ultra liest, sollte auf drei Dinge achten:
- Aufgabentyp notieren: Belegextraktion, Tool-Aufrufe, schwierige Fragestellungen oder Wissensfragen – schauen Sie nur auf die Kategorien, die dazu passen.
- Zwei Kennzahlen auseinanderhalten: Der Decision Score belohnt „nicht raten, wenn man unsicher ist“, die Rohgenauigkeit misst, „wie oft richtig geraten wurde“ – wählen Sie je nach Geschäftsanforderung, welche Sie heranziehen.
- Mit eigenen Samples entscheiden: 20 bis 50 annotierte echte Datensätze sagen mehr aus als jeder Gesamtscore.
Wenn Ihre Arbeit genau Belegextraktion ist, gehört d1.2-ultra auf die Kandidatenliste; geht es um schwierige Schlussfolgerungen oder Wissensfragen, wechseln Sie nicht nur wegen des ersten Platzes im Gesamtrating. Empfehlung: Legen Sie jetzt bei APIYI apiyi.com mit gpt-6-luna und gpt-6.1-sol eine Baseline an, um dann, wenn das Zielmodell verfügbar ist, mit einem Klick zu vergleichen.
📚 Referenzen
-
Offizieller Liquid-AI-Blog – Veröffentlichung von d1.2: Release-Informationen, offizielle Preise und selbst gemeldete Tests
- Link:
liquid.ai/blog/d1-2 - Hinweis: Genauigkeit bei neuen Aufgaben und Kalibrierungsfehler sind offizielle Selbstauskünfte
- Link:
-
Liquid-AI-Dokumentation zu Decision-Modellen: Modell-IDs und Aufruf-Endpunkte
- Link:
docs.liquid.ai/lfm/models/decision-models - Hinweis: Offizielle Beschreibung der Aufrufmethode
- Link:
-
Artificial Analysis – Modellseite d1.2-ultra: Gesamtindex und Einzelkategorien
- Link:
artificialanalysis.ai/decision-models/d1-2-ultra - Hinweis: Alle Ranglistendaten in diesem Artikel wurden am 17.11.2026 abgerufen
- Link:
-
Artificial Analysis – Methodikseite des Decision Index: Gewichtung und Definition der Scores
- Link:
artificialanalysis.ai/methodology/decision-index - Hinweis: Unterschied zwischen Decision Score und Rohgenauigkeit
- Link:
-
APIYI Modellübersicht: verfügbare Modelle und Preise
- Link:
docs.apiyi.com/models - Hinweis: Modelle und Preise richten sich nach der Modellliste der Plattform
- Link:
Autor: APIYI Technik-Team
Technischer Austausch: Bei Fragen zur Modellauswahl oder zu Vergleichsskripten kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Integrationshinweise finden Sie im Dokumentationszentrum


