
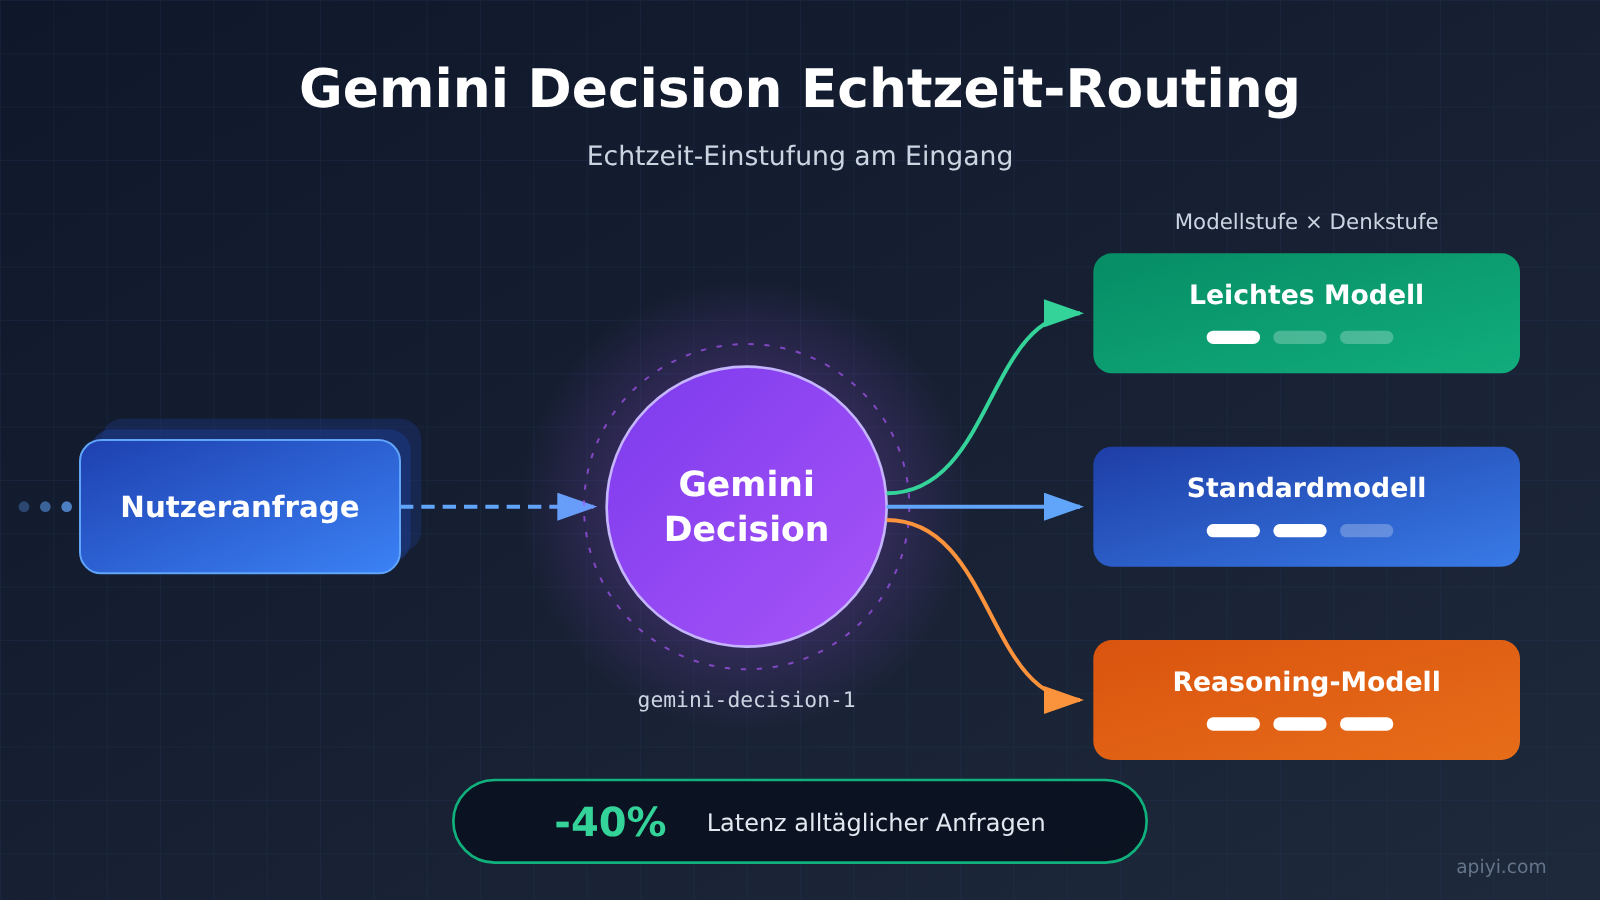
Google hat in seinem Entwickler-Blog vom 2026-11-11 einen sehr konkreten Anwendungsfall beschrieben: Gemini Notebook nutzt die Decisions API als Echtzeit-Router. Sobald eine Anfrage eingeht, ordnet sie alltägliche Fragen der passenden Modellstufe und Denkstufe zu. Laut Google sinkt die Latenz alltäglicher Anfragen dadurch um bis zu 40 %. Wichtig: Diese Zahl stammt von Google selbst. Es ist weder ein Last- und Performancetest von Dritten noch ein Messergebnis einer bestimmten Plattform.
Das ist kein weiteres Upgrade der Modellfähigkeiten. Die Wahl des Modells wandert stattdessen aus dem Code der Entwickler in den Anfragepfad.
Kernnutzen: In 3 Minuten wissen Sie, was gemini-decision-1 eigentlich ist, wie es abgerechnet wird und was es für Ihre Aufrufkette bedeutet.
Gemini Decision im Überblick
| Info | Details |
|---|---|
| Veröffentlicht | 2026-11-11, Google-Entwickler-Blog |
| Modell-ID | gemini-decision-1 |
| Positionierung | Echtzeit-Routing und Entscheidungen, keine Inhaltserzeugung |
| Erster öffentlicher Anwendungsfall | Einstufung alltäglicher Fragen in Gemini Notebook |
| Eingabepreis | $0.10 / 1M Tokens |
| Ausgabepreis | $0 |
| Latenzgewinn | Laut Google bis zu 40 % weniger bei alltäglichen Anfragen (Eigenangabe) |
| Verfügbarkeit bei Aggregator-Plattformen | Stand 2026-11-12 in der Preisliste von APIYI apiyi.com noch nicht gelistet |
Am leichtesten übersieht man in der Tabelle die Zeile mit dem Ausgabepreis von $0. Sie zeigt: gemini-decision-1 liefert keinen Fließtext, sondern ein extrem kurzes Urteil, nämlich welche Stufe gewählt wird und wie viel Denkbudget zum Einsatz kommt. Wer dieses Modell in einer Preisliste mit Chat-Modellen nebeneinanderlegt und die Einzelpreise vergleicht, kommt zu völlig falschen Schlüssen.
Ein weiteres Detail: Es gibt bereits einen echten Produktiveinsatz, das Modell steckt also nicht nur in Dokumentationsbeispielen fest. Gemini Notebook ist ein eigenes Google-Produkt. Google hat dieses Routing also zuerst im eigenen Produkt zum Laufen gebracht und erst danach öffentlich darüber gesprochen. Das ist glaubwürdiger als ein reiner Benchmark, bleibt aber eine einseitige Darstellung des Herstellers.
Wie Gemini Decision funktioniert: Ein offiziell berichteter Routing-Fall
Laut Google-Blog läuft eine alltägliche Frage in Gemini Notebook zuerst durch die Decisions API. Die entscheidet, welche Modellstufe und welche Denkstufe zum Zug kommen. Die Routing-Entscheidung selbst ist also ein eigener Modellaufruf – keine fest verdrahtete if-else-Regel und kein von Hand getunter Schwellenwert.
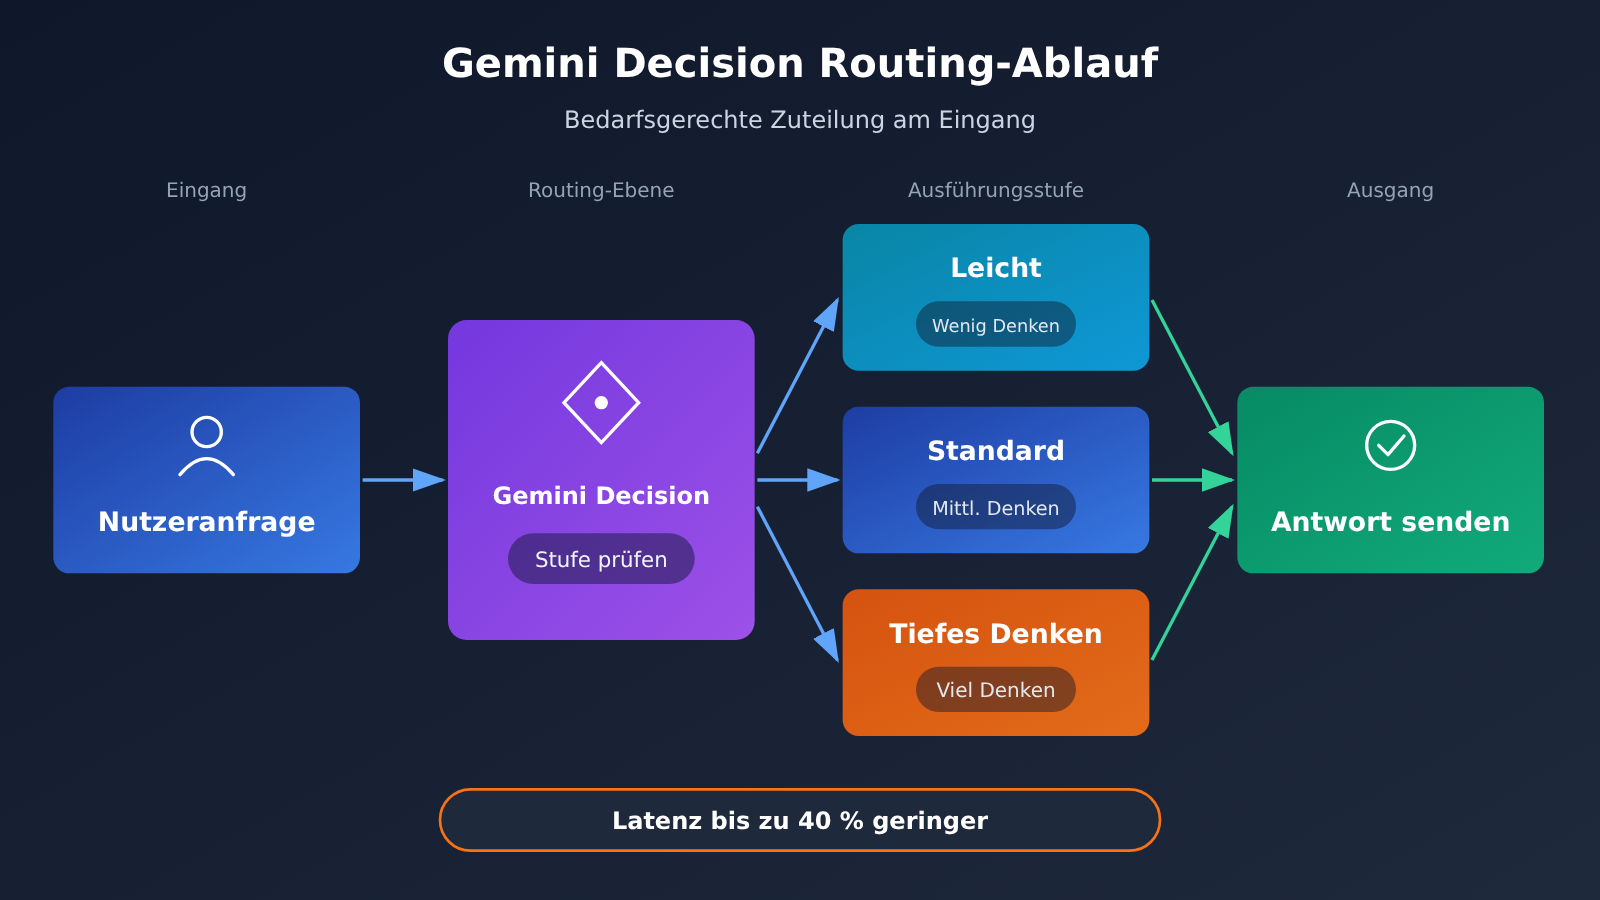
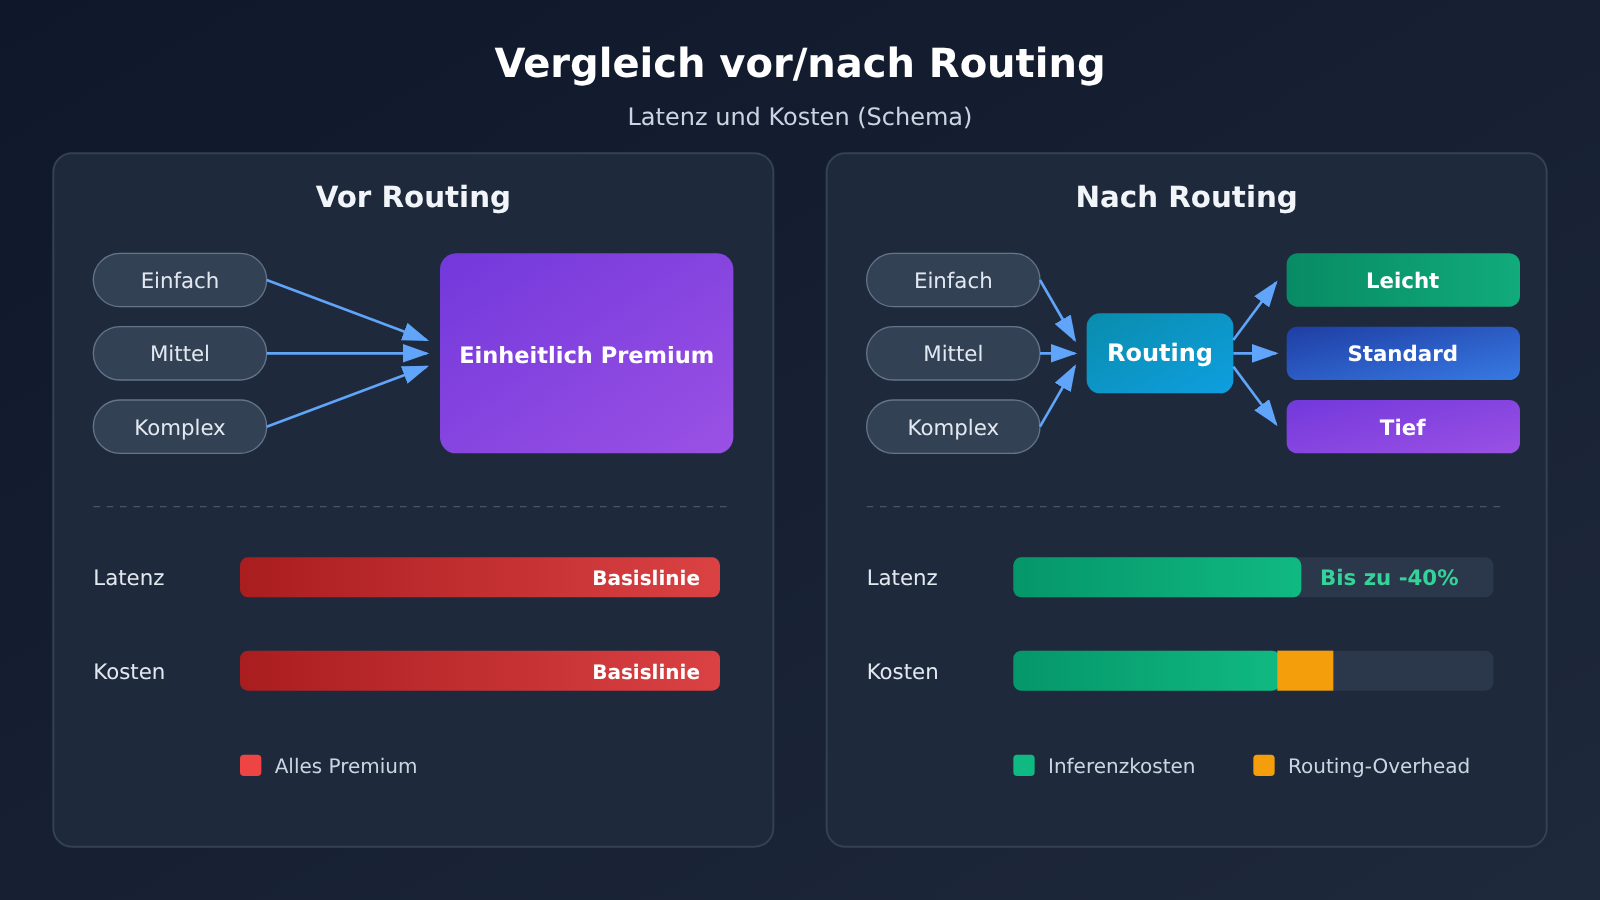
Das Problem, das dieses Design löst, ist ziemlich praxisnah: In ein und demselben Produkt sind die meisten Anfragen leichte Alltagsfragen, und nur wenige brauchen wirklich aufwendiges Reasoning. Läuft alles über dieselbe Stufe, werden leichte Anfragen von einem schweren Modell ausgebremst, und Latenz wie Kosten steigen gemeinsam. Läuft dagegen alles über die leichte Stufe, werden komplexe Fragen schlechter beantwortet. Ein eigenes Entscheidungsmodell am Eingang macht die „Zuteilung nach Bedarf“ zu einem Teil der Infrastruktur.
| Aspekt | Übliches Vorgehen ohne Routing | Mit Decision |
|---|---|---|
| Stufenwahl | Regeln im Code oder Keyword-Matching | Das Modell entscheidet anhand des Anfrageinhalts |
| Wartung | Schwellenwerte müssen bei geänderten Anforderungen manuell angepasst werden | Die Entscheidungslogik entwickelt sich mit dem Modell weiter |
| Auswirkung auf die Latenz | Bei vielen schweren Anfragen wird alles langsamer | Laut Eigenangabe bis zu 40 % weniger Latenz bei Alltagsanfragen |
| Auswirkung auf die Kosten | Alle Anfragen werden zur selben Stufe abgerechnet | Leichte Anfragen landen in der leichten Stufe, die Kostenstruktur ändert sich |
Wichtig zur Einordnung: Die 40 % beziehen sich auf „Alltagsanfragen“, nicht auf sämtliche Anfragen. Google nennt dabei eine Obergrenze. Was Sie im eigenen Betrieb tatsächlich gewinnen, hängt davon ab, wie viele Ihrer Anfragen überhaupt zu der Sorte gehören, die sich herunterstufen lässt. Besteht Ihr Produkt ohnehin hauptsächlich aus Analysen langer Dokumente oder komplexen Coding-Aufgaben, bleibt naturgemäß weniger Spielraum für eine niedrigere Stufe.
🎯 Technischer Tipp: Wollen Sie prüfen, was ein solcher Routing-Ansatz in Ihrem eigenen Szenario bringt, nutzen Sie am besten zunächst die einheitliche Schnittstelle von APIYI (apiyi.com). Lassen Sie damit Modelle verschiedener Stufen dieselben Anfragen bearbeiten und vergleichen Sie Latenz und Ausgabequalität. Danach können Sie entscheiden, ob sich eine Routing-Schicht lohnt.
Abrechnungsstruktur und Kostenfolgen von Gemini Decision
Eingabe 0,10 $ / 1 Mio. Tokens, Ausgabe 0 $: Diese Struktur rechnet im Kern danach ab, wie viel Kontext hineingelesen wird. Für die Routing-Entscheidung muss das Modell den Inhalt der Anfrage sehen, deshalb ist die Berechnung auf der Eingabeseite nachvollziehbar. Ausgegeben wird nur ein einzelnes Stufenergebnis, die Ausgabeseite verursacht also kaum Kosten – offiziell wurde sie gleich auf 0 gesetzt.
Das heißt: Wer das Modell einbindet, muss eine zusätzliche Rechnung aufmachen, denn die Routing-Schicht verbraucht selbst Tokens. Nur wenn die eingesparten Inferenzkosten durch die Herabstufung einer Anfrage diesen zusätzlichen Entscheidungsaufwand übersteigen, steht unterm Strich ein Gewinn. Je länger die Anfrage und je größer der Abstand zwischen den Stufen, desto leichter geht die Rechnung auf. Bei kurzen Anfragen, die ohnehin über die leichte Stufe laufen, kann eine zusätzliche Routing-Schicht dagegen sogar teurer werden.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# gemini-decision-1 ist derzeit noch nicht in der Preisliste der Plattform gelistet
# Ersetzen Sie model zunächst durch ein vorhandenes Chat-Modell, um die Geschäftslogik zu prüfen
response = client.chat.completions.create(
    model="YOUR_MODEL",
    messages=[{"role": "user", "content": "这个问题需要多深的推理?"}]
)
print(response.choices[0].message.content)
🚀 Schnellstart: Stand 12.11.2026 ist gemini-decision-1 in der Preisliste von APIYI (apiyi.com) noch nicht enthalten; die Plattform wird es so bald wie möglich ergänzen. Bis es soweit ist, können Sie Ihre Integration mit anderen Modellen über dieselbe OpenAI-kompatible Schnittstelle testen – der Wechsel kostet praktisch keinen Aufwand. Genaue Modellvarianten und Preise entnehmen Sie bitte der Liste auf apiyi.com.
Wer betroffen ist: Drei Aufrufketten und was sich bei ihnen ändert
Anwendungsseite: Routing wird nicht mehr selbst gebaut, sondern per Schnittstelle aufgerufen
Wer bisher Anfragen auf mehrere Modelle verteilt hat, musste in der Regel eine Regeltabelle pflegen und sie mit jeder neuen Modellgeneration immer wieder nachjustieren. Lässt sich die Routing-Entscheidung an ein dediziertes Entscheidungsmodell auslagern, wird die Logik auf der Anwendungsseite deutlich schlanker. Übrig bleibt die Aufgabe, festzulegen, welche Stufen es gibt und welches Modell in welche Stufe gehört. Der Preis dafür: ein zusätzlicher, serialisierter Aufruf. Die Netzwerkqualität am Einstiegspunkt wirkt sich deshalb direkt auf die Gesamtlatenz aus.
Kostenseite: Sinkende Latenz heißt nicht automatisch sinkende Rechnung
Latenz und Kosten sind zwei verschiedene Kurven. Eine niedrigere Stufe drückt beide, aber das Routing selbst wird nach Eingabe-Tokens abgerechnet, und bei kurzen Anfragen fallen die Grenzkosten dadurch höher aus. Am sichersten gehen Sie so vor: Gruppieren Sie die Anfragen zuerst nach Typ und aktivieren Sie das Routing nur für den Teil des Traffics, in dem die Komplexität stark schwankt. Der übrige Traffic läuft über feste Stufen.
| Teamtyp | Hauptnutzen | Zu beachtender Kostenpunkt |
|---|---|---|
| Frage-Antwort-Produkte für Endkunden (C-Seite) | Geringere Latenz bei alltäglichen Fragen, spürbar bessere Nutzererfahrung | Zusätzlicher Token-Verbrauch durch den Routing-Aufruf |
| Interne Unternehmenstools | Komplexe und einfache Anfragen laufen gemischt, große Unterschiede zwischen den Stufen | Die Stufeneinteilung muss neu konzipiert werden |
| Dienste mit vielen kurzen Anfragen | Begrenzter Nutzen, wenig Spielraum für niedrigere Stufen | Der zusätzliche serielle Hop lohnt sich womöglich nicht |
Plattformseite: Wie schnell neue Modell-IDs verfügbar sind, wird zum Auswahlkriterium
Modelle werden immer schneller aktualisiert, und zwischen der Ankündigung einer ID und ihrer stabilen Verfügbarkeit liegt oft ein Zeitfenster. Für Teams, die eine Aggregationsplattform nutzen, entscheidet in dieser Phase die Frage, wie schnell sie eine aufrufbare Schnittstelle bekommen, direkt über die Planung der Validierung. Genau hier liegt der Wert von Plattformen wie APIYI (apiyi.com): ein API-Schlüssel, eine OpenAI-kompatible Schnittstelle, und sobald ein Modell gelistet ist, können Sie wechseln, ohne die Codestruktur anzufassen. Den Stand der Listung und die Abrechnungsdetails entnehmen Sie bitte den Angaben auf apiyi.com.
Häufige Fragen (FAQ)
Q1: Was ist Gemini Decision?
gemini-decision-1, von Google vorgestellt, ist ein Modell für Routing und Entscheidungen in Echtzeit. Es erzeugt keinen Fließtext, sondern entscheidet, welche Modellstufe und welche Denkstufe eine Anfrage bekommen soll. Gemini Notebook ist der erste öffentlich bekannte Produktionseinsatz.
Q2: Worin unterscheidet es sich von normalen Gemini-Modellen?
Ein normales Dialogmodell liefert Inhalte. gemini-decision-1 gibt dagegen nur ein extrem kurzes Entscheidungsergebnis aus, deshalb sieht auch die Abrechnung völlig anders aus: Eingabe 0,10 $ / 1 Mio. Token, Ausgabe 0 $. Wer es als „günstigeres Generierungsmodell“ versteht, liegt falsch.
Q3: Woher kommen die „bis zu 40 % weniger Latenz“?
Die Zahl stammt aus dem offiziellen Google-Blog und ist eine Eigenangabe. Sie beschreibt die maximale Latenzverbesserung von Gemini Notebook bei alltäglichen Anfragen, ist also kein unabhängiger Benchmark von Dritten. Der tatsächliche Nutzen hängt davon ab, wie viele Ihrer Anfragen leichte Fragen sind, die sich auf eine niedrigere Stufe herabstufen lassen.
Q4: Wie viel kann ich damit in meinem Geschäft sparen?
Eine allgemeingültige Antwort gibt es nicht. Die eingesparten Inferenzkosten entstehen dadurch, dass Anfragen auf leichtere Stufen verteilt werden, während das Routing selbst nach Eingabe-Token abgerechnet wird. Je länger die Anfragen und je größer die Unterschiede zwischen den Stufen, desto deutlicher fällt der Nettogewinn aus. Bei häufigen, kurzen Anfragen sollten Sie genau nachrechnen.
Q5: Kann ich Gemini Decision schon aufrufen?
Stand 12.11.2026 ist gemini-decision-1 noch nicht in der Preisliste von APIYI (apiyi.com) enthalten; die Plattform nimmt es so bald wie möglich auf. Bis dahin können Sie Ihre Geschäftskette bereits über die einheitliche Schnittstelle von apiyi.com aufbauen und testen und später nur den Modellnamen austauschen, sobald die ID verfügbar ist. Konkrete Modellvarianten und Preise entnehmen Sie bitte der Liste auf apiyi.com.
Q6: Welche bekannten Nachteile hat eine Routing-Schicht?
Vor allem drei: Im Anfragepfad kommt ein weiterer serieller Aufruf hinzu, wodurch die Netzwerkqualität am Einstiegspunkt wichtiger wird. Die Routing-Entscheidung verbraucht selbst Eingabe-Token, sodass die Grenzkosten bei kurzen Anfragen steigen. Und die Stufeneinteilung muss für Ihren Anwendungsfall neu entworfen werden – die Aufteilung anderer lässt sich nicht einfach übernehmen.
Gemini Decision – Kernpunkte (Key Takeaways)
- Rolle: gemini-decision-1 ist ein Echtzeit-Routing-Modell. Es gibt eine Stufenentscheidung aus und erzeugt keinen Fließtext.
- Einsatz: Gemini Notebook nutzt es, um alltägliche Fragen der passenden Modellstufe und der passenden Denkstufe zuzuordnen.
- Nutzen: Laut Google sinkt die Latenz bei alltäglichen Anfragen um bis zu 40 %. Das ist eine Eigenangabe des Herstellers.
- Abrechnung: Eingabe 0,10 $ pro 1 Mio. Tokens, Ausgabe 0 $. Berechnet wird der eingelesene Kontext.
- Preis des Ansatzes: Das Routing verbraucht selbst Tokens. Bei kurzen Anfragen sollten Sie den Nettonutzen separat berechnen.
- Verfügbarkeit: Stand 12.11.2026 ist diese ID bei APIYI (apiyi.com) noch nicht gelistet. Wir ziehen so schnell wie möglich nach. Maßgeblich sind die Preise in der Liste auf apiyi.com.
- Vorgehen zur Überprüfung: Zuerst die Pipeline über eine einheitliche Schnittstelle zum Laufen bringen und erst dann entscheiden, ob Sie eine Routing-Schicht in die Produktion übernehmen.
Fazit
Der Wert dieser Ankündigung liegt weniger in der Leistungsfähigkeit des Modells selbst. Google macht die „Modellwahl“ zu einer Schnittstelle, die man von außen nutzen kann, und hat sie zuvor im eigenen Produkt zum Laufen gebracht. Für Entwickler lohnt es sich, drei Dinge mitzunehmen: Die Routing-Entscheidung wandert aus der Programmlogik in einen Modellaufruf. Der Latenzgewinn ist eine Eigenangabe von Google und eher als Obergrenze zu verstehen, deshalb sollten Sie ihn anhand Ihrer eigenen Traffic-Struktur neu abschätzen. Und die neue Abrechnungsdimension verändert die Kostenstruktur, sodass es nicht reicht, nur die Einsparung durch das Herunterstufen zu betrachten.
Wenn Sie diesen Weg schon jetzt testen möchten, bauen Sie die Stufenlogik zunächst mit vorhandenen Modellen auf. Sobald gemini-decision-1 bei APIYI (apiyi.com) verfügbar ist, tauschen Sie nur noch den Modellnamen aus. Modellbezeichnungen und Preise entnehmen Sie bitte der Liste auf apiyi.com.
Referenzen
- Google-Blog: Gemini Decisions API
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ -
Hinweis: Die einzige Originalquelle dieses Artikels für Modell-ID, Routing-Anwendungsfälle, Latenzwerte und Preise
-
APIYI (apiyi.com) – Preisliste
- Link:
apiyi.com - Hinweis: Dient zur Prüfung, ob gemini-decision-1 bereits gelistet ist, und zur Klärung der endgültigen Abrechnungsgrundlage
Autor: APIYI-Technikteam
Austausch: Melden Sie sich gerne über die Startseite von APIYI (apiyi.com) bei uns. Neue Modelle und Hinweise zu neuen Schnittstellen finden Sie im Dokumentationsbereich der Website.


