
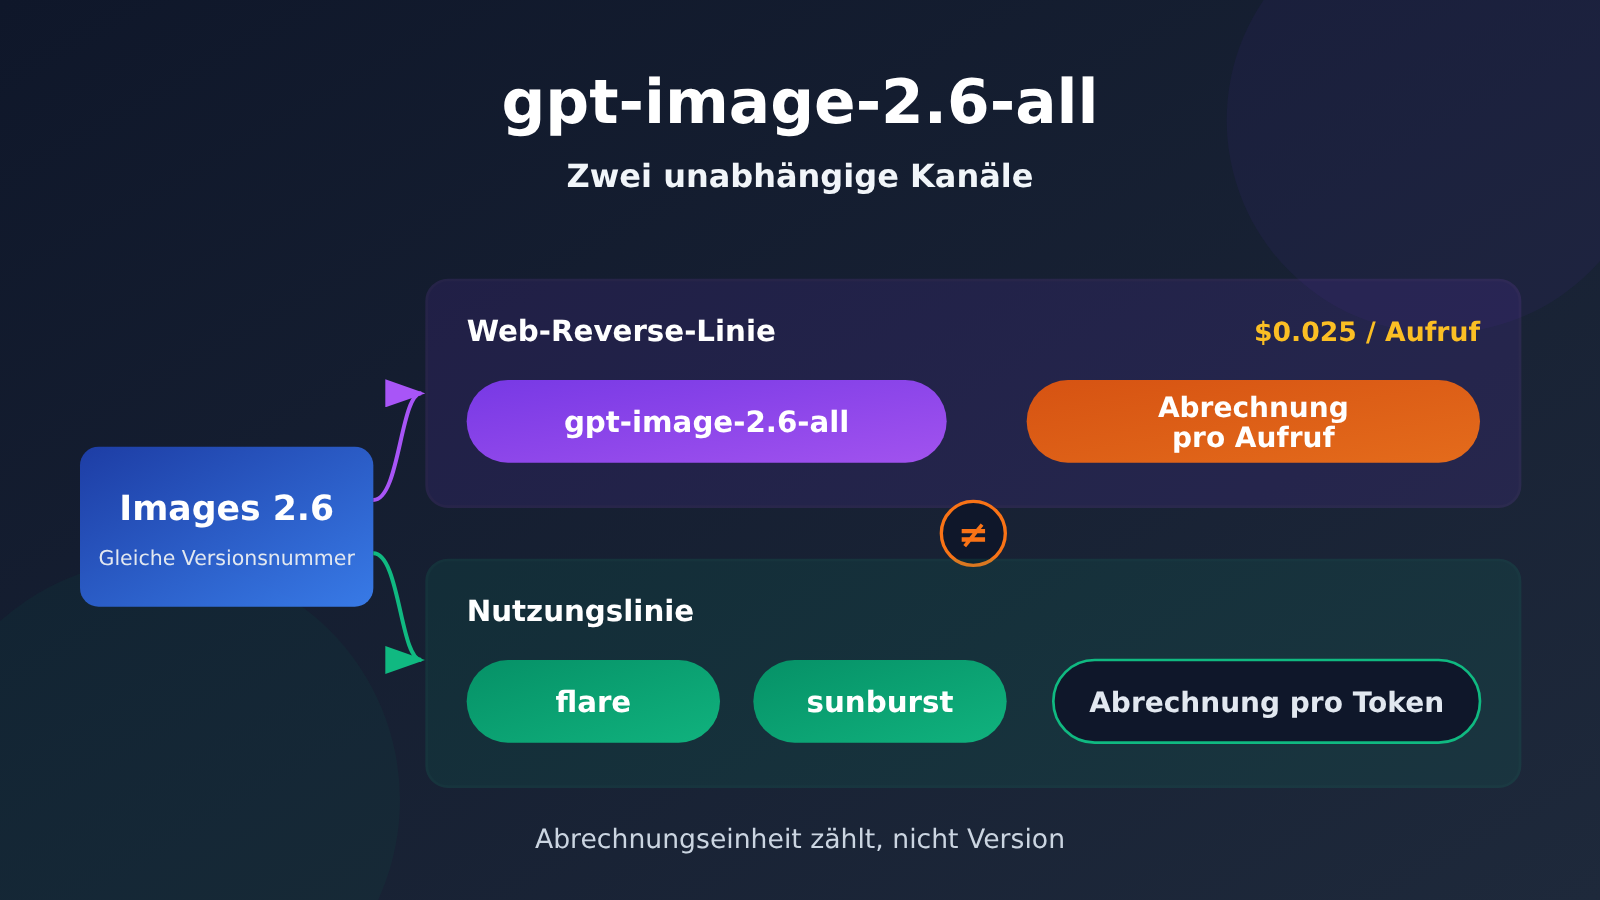
gpt-image-2.6-all ging am 11.11.2026 um 20:30 Uhr online. Beim all im Namen denken viele zuerst: „Die komplette 2.6-Reihe wurde zu einem Modell zusammengelegt.“ So ist es nicht. In den Release Notes von APIYI (apiyi.com) steht klar, dass das Modell der Reverse-Engineering-Linie („官逆“) von Images 2.6 in der ChatGPT-Weboberfläche entspricht. Es nutzt also die Aufruflogik der Web-Version und ist ein eigener Kanal, unabhängig von der nutzungsbasierten Linie, über die flare und sunburst laufen.
Das ist keine bloße Versionsnummern-Addition. flare und sunburst bilden die andere 2.6-Linie und werden nach Token-Menge abgerechnet. all wird dagegen pro Aufruf abgerechnet, mit $0,025 pro Anfrage. Die Abrechnungslogik unterscheidet sich, also läuft darunter nicht derselbe Dienst.
Der Nutzen für dich: Nach diesem Artikel kannst du anhand von 4 Parametern in 30 Sekunden einordnen, zu welcher Linie ein Modellname gehört. So rechnest du das pro Aufruf abgerechnete all nicht versehentlich wie das nutzungsbasierte flare durch.
gpt-image-2.6-all im Überblick
Zuerst die wichtigsten Angaben aus der Ankündigung, damit die ähnlichen Namen nicht zu Missverständnissen führen.
| Punkt | Details | Erläuterung |
|---|---|---|
| Veröffentlichung | 11.11.2026, 20:30 Uhr | Zeitpunkt der Ankündigung, Datenstand 12.11.2026 |
| Linienzuordnung | Reverse-Engineering-Linie (官逆) von ChatGPT-Web Images 2.6 | Aufruflogik wie in der Web-Version |
| Abrechnung | Pro Aufruf, $0,025 / Aufruf | Unabhängig vom Token-Verbrauch |
| Unterstützte Anfrageparameter | size, n, background, output_format | Neu im Vergleich zu 2.5-all |
| Weitere Modelle der Familie | gpt-image-2.6-flare, gpt-image-2.6-sunburst | Gehören zur nutzungsbasierten Linie |
| Verfügbare Plattform | APIYI (apiyi.com) | Aufruf über eine einheitliche Schnittstelle |
Der Begriff „官逆“ verdient eine kurze Erklärung. Gemeint ist eine Aufruflinie, die durch Reverse Engineering der offiziellen Web-Schnittstelle entstanden ist. Die Anfragestruktur entspricht der Web-Version. Parameter, die sich dort steuern lassen, kannst du deshalb in der Regel auch über diese Linie steuern. Das erklärt auch, warum all bei den Parametern einen Schritt weiter ist als 2.5-all: Es folgt dem Verhalten der Weboberfläche und nicht den Parameterkonventionen der nutzungsbasierten Linie.
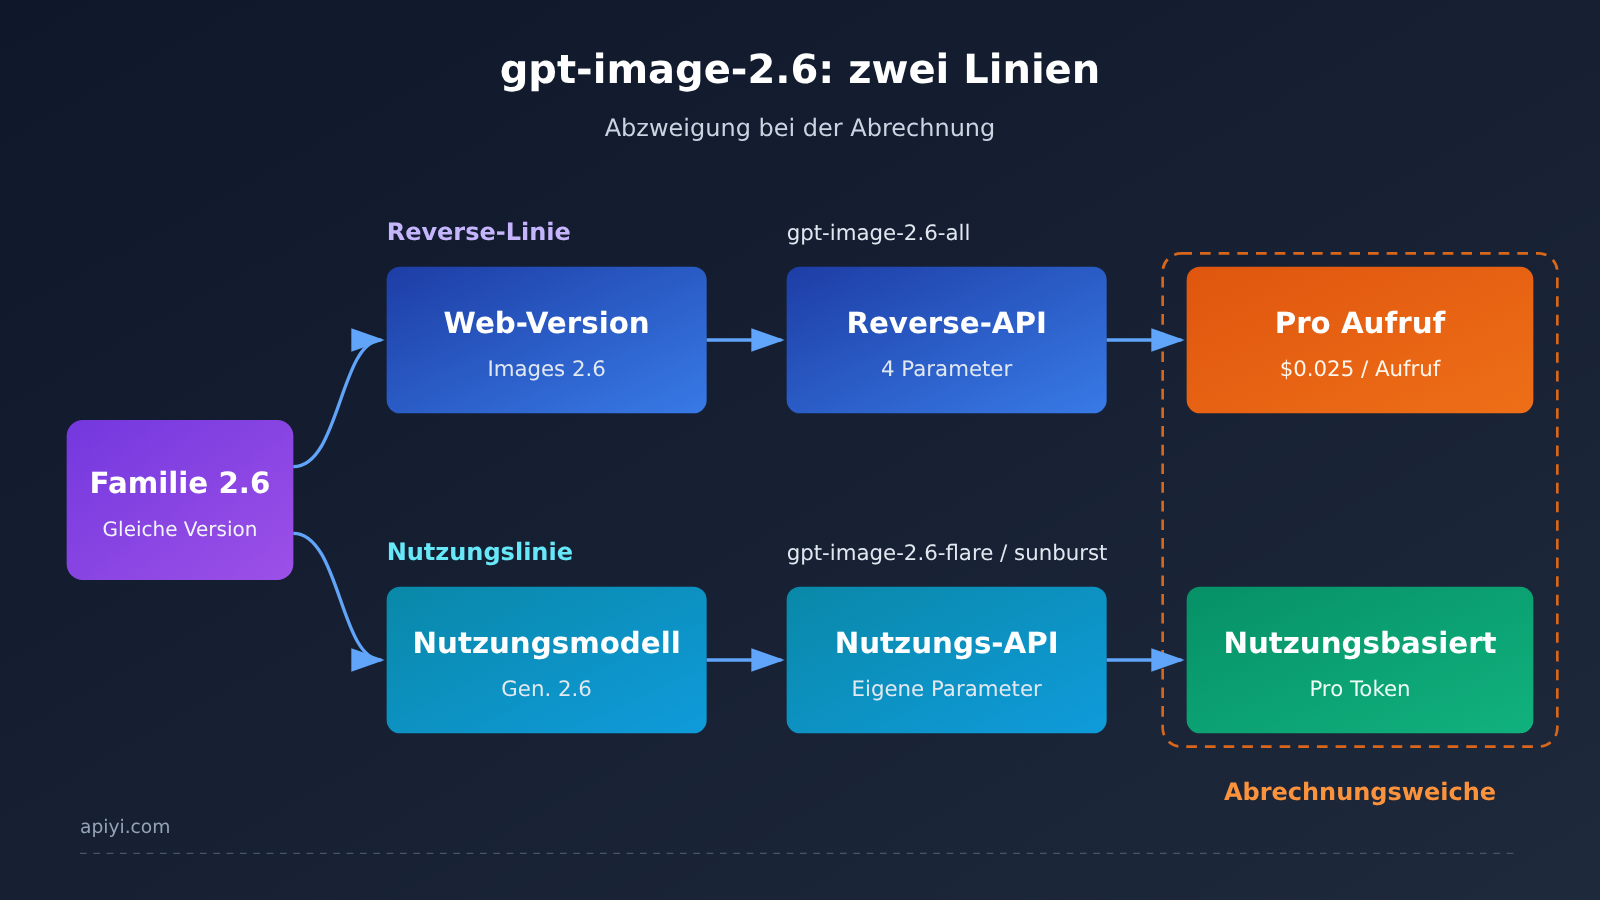
Zur Abbildung: Die beiden Linien trennen sich bei der Abrechnungslogik, nicht bei der Modellversionsnummer. Um die Linienzuordnung genau zu prüfen, kannst du sie Punkt für Punkt mit den Release Notes von APIYI (apiyi.com) abgleichen.
Die wichtigsten Unterschiede zwischen gpt-image-2.6-all und Flare
Der häufigste Fehler besteht darin, 2.6 als eine einheitliche Größe zu behandeln. Schaut man sich die einzelnen Leitungen genauer an, konzentrieren sich die Unterschiede auf drei Bereiche.
| Dimension | gpt-image-2.6-all | gpt-image-2.6-flare / sunburst |
|---|---|---|
| Art der Leitung | Offizielle Reverse-Leitung der Webversion | Nutzungsbasierte Leitung |
| Abrechnungseinheit | Pro Aufruf, $0.025 / Aufruf | Abrechnung nach Token-Menge |
| Parametersteuerung | Unterstützt size, n, background, output_format | Eigene Parameterkonventionen der nutzungsbasierten Leitung |
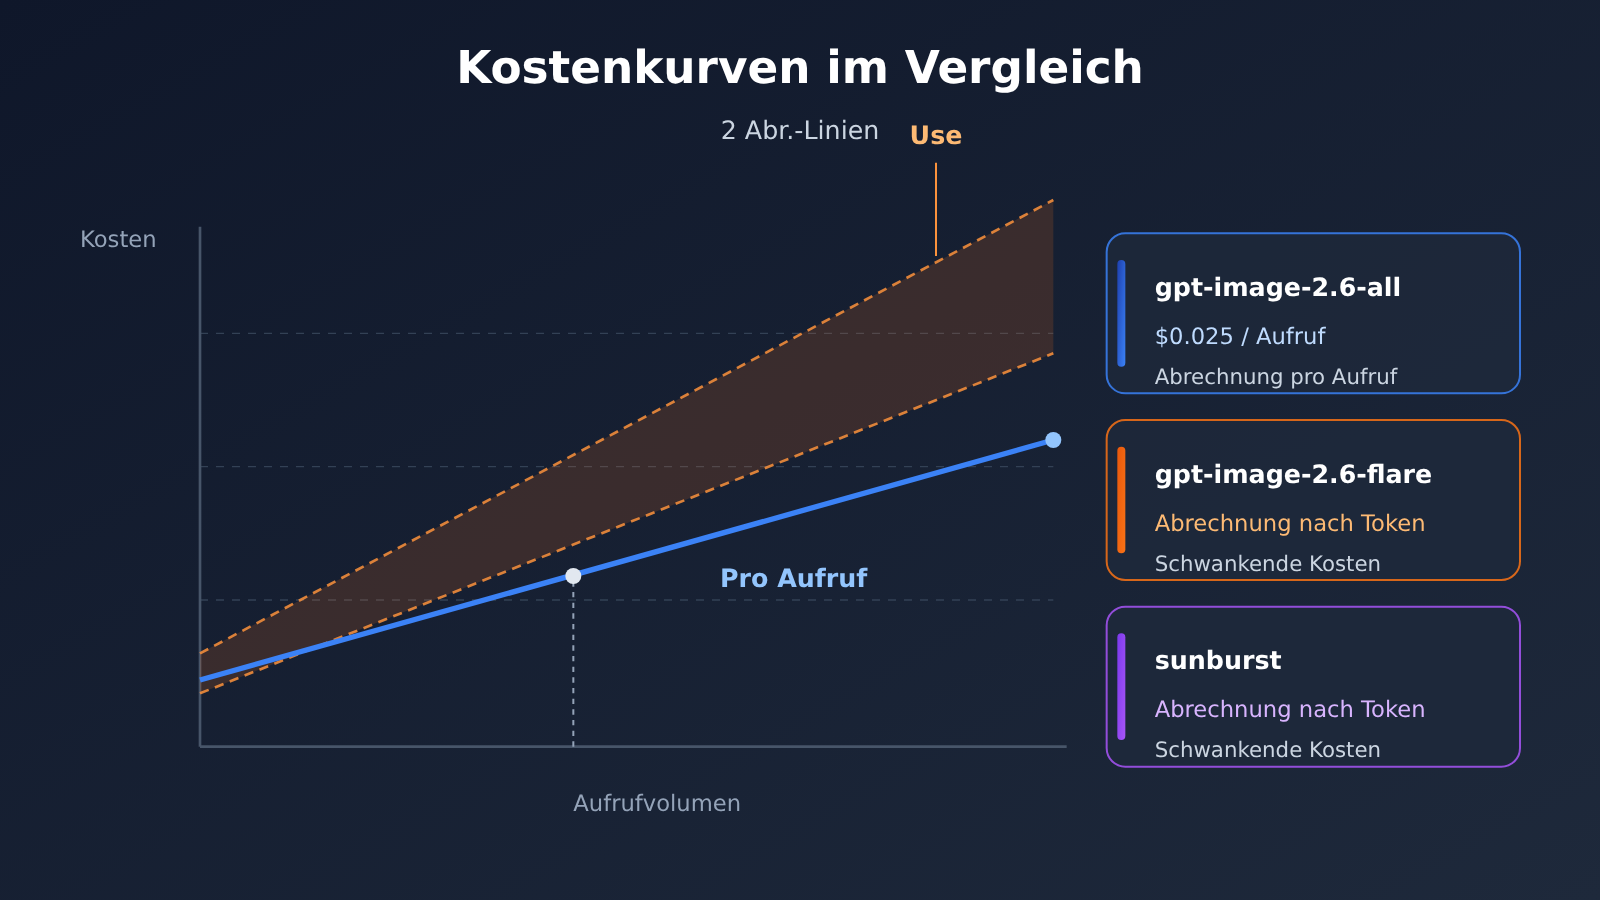
| Kostenverlauf bei steigender Aufrufzahl | Steigt linear mit der Zahl der Aufrufe | Folgt der tatsächlich verbrauchten Token-Menge |
| Geeignete Kalkulationsweise | Budget nach Bildanzahl | Budget nach Datenvolumen |
gpt-image-2.6-flare ist bei der nutzungsbasierten Abrechnung flexibler und eignet sich für Szenarien, in denen das Anfragevolumen stark schwankt und die Kosten mit der Länge der Inhalte variieren dürfen. Dafür orientieren sich die Kosten nicht an der Bildanzahl, sodass Sie für die Budgetplanung zunächst den Token-Verbrauch abschätzen müssen. gpt-image-2.6-all ist dagegen besser planbar: 1000 Aufrufe kosten genau 1000-mal den Einzelpreis, eine zusätzliche Umrechnung entfällt.
Bei Batch-Szenarien wird dieser Unterschied noch deutlicher. Projekte mit Abrechnung pro Aufruf können die Kosten pro Bild direkt ins Angebot schreiben, bei nutzungsbasierter Abrechnung müssen Sie erst eine Stichprobe laufen lassen und daraus hochrechnen. Keine der beiden Varianten ist grundsätzlich besser – entscheidend ist, ob die Kalkulationsweise zu Ihrem Geschäftsmodell passt.
💡 Empfehlung: Wenn Sie nicht sicher sind, zu welcher Leitung Ihr Modell gehört, schauen Sie zuerst auf die Abrechnungseinheit und nicht auf die Versionsnummer. In der Modellliste von APIYI (apiyi.com) sehen Sie die Zugänge beider Leitungen nebeneinander und können sie parallel testen.
Was die 4 Parameter von gpt-image-2.6-all verraten
Der Satz aus der Ankündigung – „Anders als 2.5-all akzeptiert es size, n, background und output_format“ – sagt mehr aus, als man zunächst vermutet.
| Parameter | Funktion | Aussagekraft |
|---|---|---|
size |
Legt die Ausgabegröße fest | Die Bildformate der Web-Version lassen sich auch auf API-Ebene nachbilden |
n |
Liefert mehrere Bilder pro Anfrage | Ein einziger Aufruf kann mehrere Bilder erzeugen, was sich in Kombination mit Abrechnung pro Aufruf besonders lohnt |
background |
Steuert die Hintergrundbehandlung | Der entscheidende Schalter für Anforderungen mit transparentem Hintergrund |
output_format |
Legt das Ausgabeformat fest | Entscheidet direkt darüber, ob eine Nachbearbeitung zur Konvertierung nötig ist |
Alle 4 Parameter gehören zur „Steuerung zum Anfragezeitpunkt“: Man sagt dem Server im Moment der Bestellung, was man haben möchte, statt erst im Nachhinein etwas zu korrigieren. Auch die nutzungsbasierte Linie hat in der Regel einen eigenen Parametersatz, aber nicht diesen. Unterstützt ein Modellname also genau diese 4 Parameter, hängt er mit hoher Wahrscheinlichkeit an der Web-Version-Reverse-Linie (der „offiziellen Reverse-Linie“).
Umgekehrt zeigt die fehlende Unterstützung bei 2.5-all, dass die Parameterabdeckung dieser Linie mit den Iterationen der Web-Version nach und nach nachgezogen wird. Mit der Generation 2.6 ist diese Lücke geschlossen. Das „all“ im Namen steht für die vollständige Parameterunterstützung, nicht dafür, dass alle Modellreihen zusammengelegt wurden.
🎯 Technischer Tipp: Bauen Sie in Ihrem eigenen Service eine Parameterprüfung ein und nutzen Sie
size,n,backgroundundoutput_formatals Routing-Kriterium. So lassen sich Anfragen automatisch auf die richtige Linie verteilen. APIYI (apiyi.com) bietet eine OpenAI-kompatible Schnittstelle, sodass für den Modellwechsel lediglich das Feldmodelangepasst werden muss.
So rufen Sie gpt-image-2.6-all auf
Der Aufruf unterscheidet sich nicht von den üblichen Bilderzeugungs-Schnittstellen: Sie richten base_url auf den einheitlichen Einstiegspunkt aus. Entscheidend ist nur, dass der Modellname stimmt.
- Schnittstellenadresse:
https://api.apiyi.com/v1 - Modellname:
gpt-image-2.6-all - Empfohlene Parameter:
size,n,background,output_format
Diese Felder im Request-Body machen den Unterschied zwischen den Linien aus. Liefert der Server die Fehlermeldung, dass ein Parameter nicht unterstützt wird, liegt es meist daran, dass der Modellname auf flare oder sunburst lautet, der Request aber die Parameterkombination der Web-Version enthält.
🚀 Schnellstart: APIYI (apiyi.com) bietet ein kostenloses Testkontingent. Nach der Registrierung erhalten neue Nutzer sofort einen API-Schlüssel. Setzen Sie
base_urlaufhttps://api.apiyi.com/v1und wechseln Sie mit demselben Code zwischen all und flare. So sehen Sie in wenigen Minuten, welche Linie besser zu Ihrer Kostenstruktur passt.
Was der Launch von gpt-image-2.6-all für Entwickler bedeutet
Die Neuerung wirkt sich vor allem auf drei Ebenen aus.
- Die Kostenrechnung ändert sich: Mit 0,025 $ pro Aufruf sind die Kosten pro Bild konstant. Das Budget für Batch-Projekte lässt sich direkt ausrechnen, ohne vorher mit Testläufen die Token zu schätzen. Für Teams, die Kunden ein Angebot machen müssen, ist das praktischer als jeder Leistungsparameter.
- Die Parameter entsprechen der Web-Version: Mit
size,n,backgroundundoutput_formatlassen sich die meisten Einstellungen der Web-Oberfläche auch über die Schnittstelle nachbilden. Das verringert die Lücke zwischen „im Web einstellbar, per API nicht“. - Die Linie zu erkennen, wird Pflicht: Innerhalb derselben Modellgeneration gibt es jetzt eine Linie mit Abrechnung pro Aufruf und eine mit nutzungsbasierter Abrechnung. Das Suffix im Modellnamen ist das einzige Unterscheidungsmerkmal. Nur die Versionsnummer in der Konfiguration zu hinterlegen, reicht nicht mehr aus.
Leicht übersehen wird dabei: Kombiniert man den Parameter n mit der Abrechnung pro Aufruf, sinken die Stückkosten weiter, sobald ein Aufruf mehrere Bilder liefert. Die Abrechnungslogik bleibt dieselbe, aber die Frage, wie viele Bilder pro Anfrage sinnvoll sind, muss neu beantwortet werden.
💰 Kostenoptimierung: Bei budgetsensiblen Projekten lohnt es sich, zuerst mit dem kostenlosen Kontingent von APIYI (apiyi.com) die Aufrufkette zum Laufen zu bringen und die monatlichen Ausgaben dann anhand der tatsächlichen Bildanzahl hochzurechnen. Das liegt näher an der Realität als eine Schätzung aus der Preisliste.
gpt-image-2.6-all FAQ – Häufige Fragen
Q1: Was genau ist gpt-image-2.6-all?
Es ist das Modell der „Official-Reverse“-Linie (官逆线) für Images 2.6 der ChatGPT-Weboberfläche. Abgerechnet wird pro Aufruf, ein Aufruf kostet 0,025 $. Das `all` im Namen steht für den vollständigen Parameterumfang, nicht dafür, dass alle Modelle der Serie zusammengefasst wären.
Q2: Worin unterscheiden sich gpt-image-2.6-all und gpt-image-2.6-flare?
Sowohl die Linie als auch die Abrechnung sind verschieden. all läuft über die Official-Reverse-Linie der Weboberfläche und wird pro Aufruf abgerechnet. flare und sunburst gehören zur nutzungsbasierten Linie und werden nach Token-Menge berechnet. Es handelt sich nicht um zwei Stufen desselben Modells, sondern um zwei voneinander unabhängige Kanäle.
Q3: Warum unterstützt all die Parameter size, n, background und output_format?
Weil es die Anfragestruktur der Web-Schnittstelle nachbildet. Was sich in der Weboberfläche steuern lässt, lässt sich über die Official-Reverse-Linie in der Regel ebenfalls steuern. 2.5-all bietet diese Parameter nicht – die Parameterabdeckung wurde also mit den Weiterentwicklungen der Weboberfläche Schritt für Schritt ergänzt.
Q4: Für welche Szenarien eignet sich die Abrechnung pro Aufruf?
Am besten passt sie, wenn sich die Zahl der Aufrufe gut abschätzen lässt und die Kosten pro Bild in ein Angebot eingepreist werden müssen. Die nutzungsbasierte Abrechnung ist dagegen sinnvoller für Projekte mit stark schwankendem Traffic, bei denen die Kosten je nach Inhalt variieren dürfen.
Q5: Wie rufe ich gpt-image-2.6-all schnell auf?
Registrieren Sie sich bei einer Plattform, die das Modell unterstützt, und holen Sie sich einen API-Schlüssel. Setzen Sie `base_url` auf `https://api.apiyi.com/v1` und tragen Sie als Modellnamen `gpt-image-2.6-all` ein. APIYI (apiyi.com) bietet eine OpenAI-kompatible Schnittstelle und kostenloses Testguthaben. Mit demselben Code können Sie über das Feld `model` zwischen all und flare wechseln und beide vergleichen.
Q6: Worauf sollte ich bei diesem Release achten?
Vor allem darauf, `2.6` nicht als Einheit zu betrachten. In derselben Generation existieren eine Linie mit Abrechnung pro Aufruf und eine nutzungsbasierte Linie nebeneinander. Wer in der Konfiguration nur die Versionsnummer festhält, verrechnet sich leicht bei der Kostenkalkulation. Außerdem konzentriert sich die Ankündigung auf drei Punkte: Linienzugehörigkeit, Parameter und Abrechnung. Für alle weiteren Details gilt die spätere Dokumentation.
gpt-image-2.6-all: Die wichtigsten Punkte (Key Takeaways)
- Zugehörige Linie: Das Modell entspricht der „Official Reverse“-Linie (官逆) von Images 2.6 in der ChatGPT-Weboberfläche und gehört nicht zur nutzungsbasierten Linie.
- Abrechnung: Abgerechnet wird pro Aufruf, und zwar mit 0,025 $ je Aufruf – unabhängig vom Token-Verbrauch.
- Parameter: Unterstützt werden
size,n,backgroundundoutput_format. Das Modell 2.5-all kennt diese Parameter nicht. - Abgrenzung innerhalb der Familie: flare und sunburst gehören zu einer anderen, nutzungsbasierten Linie mit völlig anderer Abrechnung.
- So erkennen Sie die Linie: Abrechnungseinheit und Parameterkombination sind verlässlicher als die Versionsnummer.
- Einstieg: Über die einheitliche Schnittstelle von APIYI (apiyi.com) setzen Sie
base_urlaufhttps://api.apiyi.com/v1und können das Modell direkt ausprobieren.
Fazit
Zu gpt-image-2.6-all müssen Sie sich nur drei Dinge merken:
- Es ist ein Web-Official-Reverse-Zugang, kein Flare: Das Modell läuft auf einem anderen Kanal als flare und sunburst. Es handelt sich also nicht um dasselbe Modell in verschiedenen Stufen.
- Pro Aufruf statt nutzungsbasiert: 0,025 $ pro Aufruf – die Kosten steigen linear mit der Zahl der Aufrufe. Das macht die Budgetplanung einfacher als bei der nutzungsbasierten Linie.
- Vier Parameter als Erkennungsmerkmal: Tauchen
size,n,backgroundundoutput_formatin den Modellfähigkeiten auf, hängt das Modell mit hoher Wahrscheinlichkeit an der Web-Official-Reverse-Linie.
Gleiche Versionsnummer heißt nicht gleiche Linie. Wenn Sie das nächste Mal in einer Konfiguration einen Modellnamen mit 2.6 am Anfang sehen, klären Sie zuerst die Abrechnungsart und entscheiden Sie dann, wo das Modell hingehört.
Wenn Sie beide Linien direkt vergleichen möchten, probieren Sie es am besten über APIYI (apiyi.com) aus: Die Plattform bietet ein kostenloses Kontingent und eine einheitliche Schnittstelle für mehrere Modelle. Zum Umschalten ändern Sie nur das Feld model.
Referenzen
- APIYI Release Notes – gpt-image-2.6-all ist online: Originalquelle für Leitungszuordnung, unterstützte Parameter und Abrechnungsbasis
- Link:
docs.apiyi.com/live/2026-11/gpt-image-2-6-all-launch -
Hinweis: Enthält Startzeitpunkt, Preis pro Aufruf und Angaben zu Modellen der gleichen Familie; Datenstand: 12.11.2026
-
APIYI Modellliste: Zeigt die verfügbaren Modelle und Aufrufeinstiege
- Link:
apiyi.com - Hinweis: Dient dazu, die Leitungszuordnung von all, flare und sunburst abzugleichen
Autor: APIYI-Technikteam
Fachaustausch: Schreiben Sie uns gern über die Startseite von APIYI (apiyi.com). Weitere Materialien finden Sie im Dokumentationscenter unter docs.apiyi.com


