
作者注:多模型应用应通过统一消息格式、厂商适配层和能力注册表,处理工具调用、推理状态、流式输出、结构化数据与缓存差异。
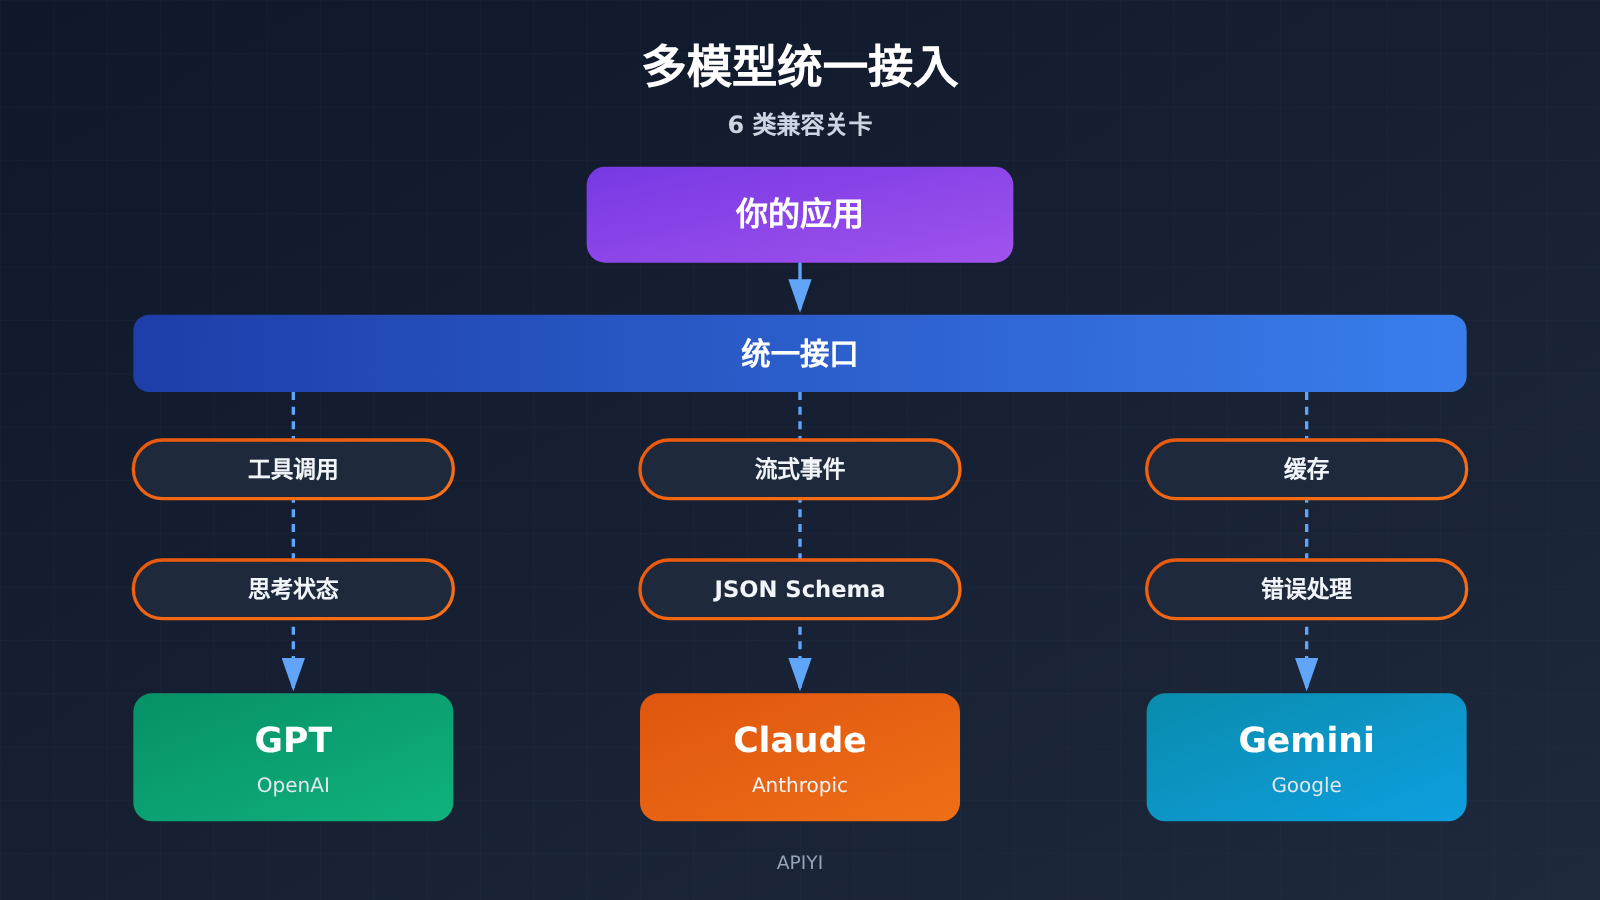
GPT、Claude 和 Gemini 都能完成普通文本调用,Claude 和 Gemini 也提供官方的 OpenAI SDK 兼容入口。生产级应用在切换模型时,需要解决 6 类兼容问题:消息角色与系统指令、工具调用协议、推理参数与思考状态、流式事件、结构化输出与多模态、缓存计费与错误处理。只替换 Model ID 能跑通简单问答,多轮工具调用、断流恢复和成本核算则需要单独处理。比较稳妥的工程方案是“统一业务接口 + 厂商适配层(Provider Adapter)+ 模型能力注册表”。这样,模型切换可以作为一项可维护的产品功能来管理。
下文先对照三家原生 API 的结构差异,并说明 OpenAI 兼容接口能覆盖哪些场景。随后逐一拆解 6 类兼容问题会引发哪些真实故障,再给出六层接入架构和可运行的统一调用代码。最后列出上线前的六项兼容性测试,并说明统一 API 网关与原生能力适配之间如何分工。
To Know:多模型 API 兼容术语表
| 术语 | 解释 |
|---|---|
| API | 应用向模型服务发送请求并取回结果的接口。 |
| SDK | 封装好接口调用细节的软件开发工具包。 |
| 原生 API | 厂商自己设计的主力接口,例如 OpenAI Responses、Claude Messages、Gemini Interactions。 |
| 兼容接口 | 沿用另一套请求格式(通常是 OpenAI 格式)的适配入口,便于用同一个 SDK 调用。 |
| 函数调用(Function Calling) | 模型用结构化参数请求应用执行某个外部函数。 |
| 调用 ID | 把模型发起的工具请求与应用回传的执行结果对应起来的标识。 |
| 思考签名(Thought / Thinking Signature) | 部分模型用来保存推理和工具调用上下文的加密状态数据,需要原样回传。 |
| 流式输出(Streaming) | 服务端按事件逐段返回结果,前端可以边收边显示。 |
| JSON Schema | 描述 JSON 数据结构和校验规则的规范。 |
| 提示词缓存(Prompt Caching) | 对重复出现的输入前缀复用计算结果,以降低延迟和费用。 |
| TTL | 缓存的存活时长,过期后需要重新写入。 |
| 适配器(Provider Adapter) | 把统一请求转换成某家厂商的原生格式,再把返回结果转换回统一格式的组件。 |
| 能力注册表 | 记录每个模型、每个接入端点实际支持哪些参数和功能的配置清单。 |
| 幂等 | 同一操作执行一次和执行多次的效果相同,用来防止重试造成重复扣款、重复发信。 |
1 多模型 API 兼容:为什么换模型不能只换 Model ID
三家都能通过一个 model 字段指定模型,但请求体、响应对象和上下文状态的组织方式各不相同。普通问答的差异集中在字段名上,适配成本较低。Agent 类应用会依赖工具调用、推理状态和流式事件,差异就会直接变成线上故障。
1.1 GPT、Claude、Gemini 三家原生 API 对照
下表只描述原生 API,不涉及任何兼容层或网关端点。
| 维度 | OpenAI(原生) | Claude(原生) | Gemini(原生) |
|---|---|---|---|
| 主力接口 | Responses API,/v1/responses |
Messages API,/v1/messages |
Interactions API(2026 年 6 月 GA,官方推荐新项目使用);generateContent 仍受支持 |
| 输入组织 | model + input |
model + messages + max_tokens,system 独立于消息数组 |
原生 Interactions 结构,另有 system_instruction 规则 |
| 输出结构 | 多类型输出项:文字、reasoning 项、function_call 等 |
content blocks:text、thinking、tool_use 等 |
steps:模型输出、工具调用、推理等步骤 |
| 结束判断 | 响应完成事件 / 输出项类型 | stop_reason(正常结束、需要执行工具等) |
步骤类型与交互状态 |
| 上下文延续 | previous_response_id |
应用自行回传完整消息历史 | previous_interaction_id,可选服务端会话状态 |
| 内置工具 | 平台工具 + 自定义函数 | 自定义工具为主 | Google Search、URL Context、代码执行等内置工具;第三方工具由应用执行 |
从上表可以看到,三家在“谁来保存上下文”这一点上就分成了两条路线。OpenAI 和 Gemini 支持服务端延续上下文,Claude Messages 由应用自行回传历史。如果应用的会话存储只按其中一种方式设计,切换到另一家时就会出现上下文丢失或重复发送。
1.2 OpenAI 兼容接口能解决多少问题
Claude 和 Gemini 都提供 OpenAI SDK 兼容入口。Gemini 的官方兼容端点是 generativelanguage.googleapis.com/v1beta/openai/,使用 OpenAI 客户端时修改 base_url、API Key 和 model 即可。Claude 的兼容文档则明确限定了支持范围,截至 2026-11-13 的已知限制如下:
- 工具定义中的
strict参数会被忽略,工具参数的严格约束因此失效。 - 不支持 Prompt Caching。
- 不支持 audio、file 类型的输入。
system与developer消息会被提到最前面合并处理。thinking相关字段与原生 API 存在差异。
兼容接口适合三类场景:普通聊天、单轮生成,以及快速对比不同模型的回答质量。复杂 Agent 迁移涉及严格工具参数、缓存、文件输入和多轮推理状态,这些能力需要回到原生 API,或者经过逐项验证后再上线。一个实用的判断标准是:应用依赖的功能如果只在原生文档中出现,就把它记入能力注册表,交给专门的适配器处理。
2 GPT、Claude、Gemini 模型切换最容易遇到的六类兼容问题
2.1 消息角色与系统指令的兼容处理
OpenAI 区分 developer 和 system 等角色。Claude 的 system 指令位于消息数组之外。Gemini 使用 system_instruction,用户与模型内容也有自己的结构规则。三者表达的都是“指令优先级 + 多轮历史”,承载的字段位置却各不相同。
常见故障来自偷懒的拼接:把系统指令、历史消息和工具结果拼成一整段字符串,交给模型当作用户输入。这样做能跑通,但指令优先级会被削弱,模型可能把历史中的工具输出当作用户的新要求。正确做法是在应用内部保留角色语义,由适配器负责映射到各家的字段。另外要注意,Claude 兼容层会把 system 和 developer 合并,依赖两者分层的提示词设计需要实测效果。
2.2 工具调用协议与调用 ID 的兼容处理
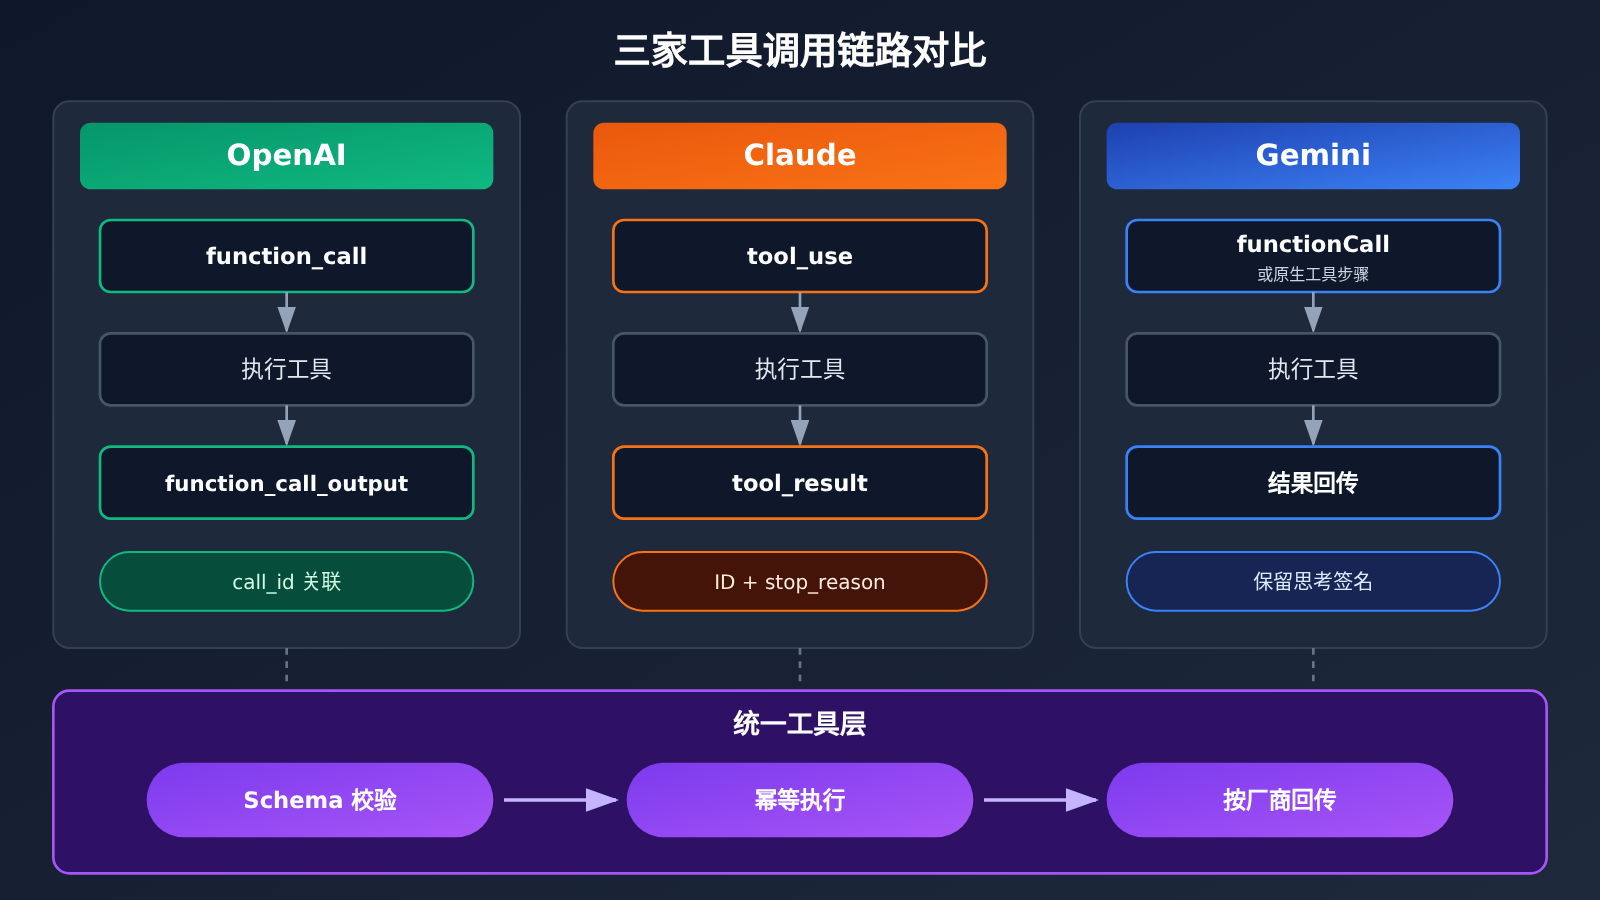
三家都支持 Function Calling,调用链路的形态如下:
| 环节 | OpenAI | Claude | Gemini |
|---|---|---|---|
| 模型发起调用 | function_call 输出项 |
tool_use 内容块 |
functionCall / 原生工具步骤 |
| 关联标识 | call_id |
tool_use 的 ID |
对应调用标识 |
| 应用回传 | function_call_output |
tool_result 内容块 |
对应结果回传结构 |
| 是否需继续 | 根据输出项判断 | stop_reason 指示需要执行工具 |
根据步骤状态判断 |
| 推理状态 | reasoning 项可能需随历史传递 | thinking 块可能需原样回传 | stateless 模式需保留 thought 块和签名 |
工具层需要完整保存六项信息:调用 ID、函数名、参数 JSON、并行调用关系、执行结果,以及模型是否要求继续推理。并行调用是最容易出错的地方。模型一次发起多个工具请求,应用只回传了其中一个结果,或者结果与 ID 对错了,下一轮请求就会报参数错误,或者模型基于错误数据继续回答。
建议统一工具层先用 JSON Schema 校验参数,校验通过后再执行真实的外部操作。模型生成的参数并不总是合法,提前校验可以把错误拦截在“调用外部系统”之前。
2.3 思考模式及上下文状态的兼容处理
推理参数的名称和含义在三家之间并不对等:
- OpenAI:使用
reasoning.effort等参数。GPT-6 Astra 和 GPT-6.1 Sol 不接受reasoning.effort=none,这两款模型的工具调用也要求使用 Responses API。 - Claude:新一代模型主要采用 Adaptive Thinking,配合 effort 等思考配置。部分新模型已不再支持旧式固定
budget_tokens的手动思考模式。 - Gemini:不同模型使用 thinking level 或 budget,能否关闭推理、有哪些档位都因模型而异。原生 API 与 OpenAI 兼容入口的参数映射规则也不同。
产品界面上设计“快速、标准、深入”三档推理强度时,档位名称表达的是产品意图。适配器需要把它转换成每个模型实际支持的参数,三家在同一档位下获得的计算资源也不相同。另外,用户看到的思考摘要与实际计费的思考 Token 数可能对不上,成本统计要以接口返回的用量字段为准。
多轮工具调用中的加密状态,是长程 Agent 最容易忽略的问题:
- OpenAI Responses 的 reasoning 项和工具调用可能需要随历史继续传递。
- Claude 的
thinking/redacted_thinking块可能包含加密状态,工具执行后回传时要保持原始结构。 - Gemini Interactions 的 stateless 模式要求原样保留 thought 块和签名;使用 stateful 模式时,部分状态可由服务端维护。
只保存聊天窗口里显示的文字,无法完整恢复模型的推理历史。典型故障是:Agent 在第三轮工具调用后突然报错,或者开始重复已经完成的步骤。原因通常是中间某一轮丢掉了签名块。
2.4 Streaming 流式事件的统一
三家的流式事件类型、顺序和结束信号各不相同。OpenAI Responses 可能输出 response.output_text.delta、工具调用增量以及 response 完成事件。Claude Messages 流使用 message_start、content_block_delta、message_delta 等事件。Gemini 的原生 API 则使用自己的输出与步骤结构。
前端如果直接解析厂商的原始事件,每接入一个模型就要改一次前端代码。建议后端统一转换成内部事件协议:
| 内部事件 | 含义 | 处理要点 |
|---|---|---|
text_delta |
文本增量 | 直接追加显示 |
reasoning_summary |
思考摘要 | 可折叠展示,计费以 usage 为准 |
tool_call_start |
工具调用开始 | 记录调用 ID 与函数名 |
tool_call_args |
参数分片 | 按调用 ID 或索引拼接,全部收齐后才能解析 |
tool_result |
工具执行结果 | 与调用 ID 一一对应 |
usage |
用量统计 | 区分输入、缓存、思考、输出 Token |
completed |
正常结束 | 必须收到明确的结束信号 |
error |
错误或断流 | 区分可重试与不可重试 |
流式处理有三个高频故障点。第一,多个工具调用的参数分片交替到达,按到达顺序拼接会串号。第二,JSON 参数被切在任意字符处,收到一半就解析会抛异常。第三,连接半途断开却没有收到完成事件,界面会一直停在“生成中”。转换层需要显式处理这三种情况。
2.5 JSON Schema 结构化输出与多模态能力差异
三家都提供结构化输出能力,但支持的 JSON Schema 特性、严格模式以及与工具调用的组合方式存在差异。Claude 官方区分了两种机制:JSON outputs 约束最终回答的结构,Strict tool use 约束工具调用参数的结构。部分模型使用严格格式时,还会产生额外的 Schema 编译或缓存开销。
工程上的建议是:应用维护一份自己的标准 JSON Schema,在能力注册表里记录每个模型支持哪些 Schema 特性。对于不支持的特性,由适配器做降级转换。无论模型声称多严格,应用侧都要再做一次校验,校验失败时进入可控的重试或报错流程。
多模态同理。“支持图片输入”只说明了能力类别,具体还要比较以下几点:可接受的文件类型、大小和图片数量,视频与音频能力,文件上传方式,长上下文上限与实际可用范围,最大输出 Token,以及工具调用能否与多模态输入组合使用。Claude 兼容层不支持 audio、file 输入,就是一个需要写进注册表的具体限制。
2.6 缓存、计费与错误处理的跨模型差异
三家的提示词缓存机制差别明显:
- OpenAI:GPT-5.6 及后续模型支持隐式缓存和显式缓存断点,TTL 有 30 分钟和 12 小时两种。
- Claude:通过
cache_control指定自动或显式缓存,支持 5 分钟与 1 小时两种模式;该能力在其 OpenAI 兼容层中不受支持。 - Gemini:新模型提供自动隐式缓存,部分 API 和模型支持显式创建缓存对象。
模型切换后,原厂商的缓存通常无法复用。会话中途从 Claude 切到 Gemini,第一轮请求会按完整输入计费。成本预估如果默认“缓存一直命中”,切换策略越频繁,账单偏差就越大。
各家标准单价也有明显差距。截至 2026-11-13 的官方标准价格如下(USD / 百万 Token):
| 模型 | 输入 | 输出 | 备注 |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | 工具调用需使用 Responses API |
| GPT-6.1 Sol | $1 | $5 | 工具调用需使用 Responses API |
| Claude Sonnet 5.5 | $2 | $10 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | 促销价至 2026-12-31;2027-01-01 起计划调整为 $1.50 / $7.50 |
这张表用来说明计费差异,各模型的能力和使用条件不同,价格高低不能直接换算成性能比较。表中也没有包含缓存写入、工具调用、服务档位和第三方加价等费用。
💰 成本核算建议:多模型应用的账单需要按“普通输入、缓存写入、缓存命中、思考与输出、工具费用、长上下文附加”分项记录。通过 API易 apiyi.com 统一调用多个模型时,可以在同一处查看各模型用量,便于把路由策略和实际成本对应起来。
错误处理方面,三家的请求速率、Token 速率、配额、超时和错误格式都不同。应用应建立统一的错误分类:鉴权失败、模型不支持、参数不合法、请求过大或超出上下文、429 限流、服务端错误、网络断线、响应流中断、工具调用失败。
模型回退还要考虑任务是否有副作用。主模型在工具执行之后才超时,系统自动切换到备用模型重跑整个任务,付款、发邮件、改文件这类操作就可能执行两次。解决方法是给有副作用的工具加幂等键,回退时只从“尚未执行的步骤”继续。
3 多模型 API 兼容架构应该怎样设计
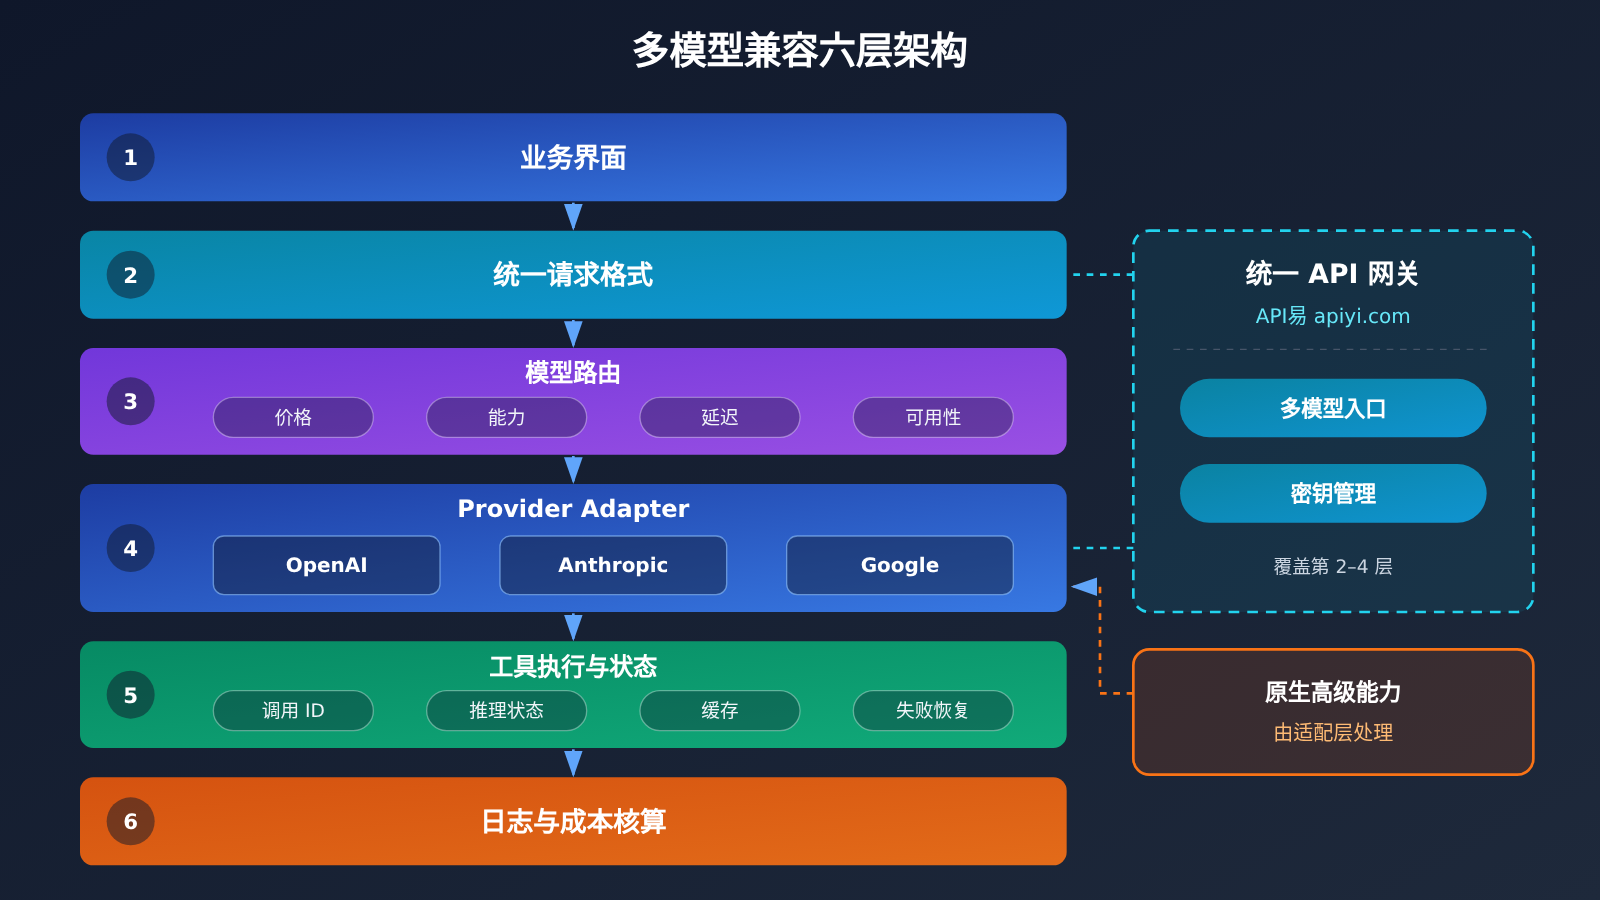
推荐的六层结构如下:
- 业务界面:用户提问、上传材料、选择模型和任务。
- 统一请求格式:用统一结构表示消息历史、附件、工具列表、结构化输出要求、推理强度和任务 ID。
- 模型路由:根据价格、能力、延迟、可用性和业务规则选择 GPT、Claude 或 Gemini。
- Provider Adapter:把标准请求转成各家原生格式,再把返回结果映射回内部格式。
- 工具执行与状态管理:维护调用 ID、执行记录、对话上下文、厂商推理状态、缓存和失败恢复。
- 日志与成本核算:记录每次请求的模型、Token、实际费用、延迟、缓存、错误和工具调用。
3.1 建立统一消息及工具格式
统一格式的核心原则是把历史分成两层存储。第一层是可通用的标准历史,包括用户消息、模型最终回答、工具请求和工具结果,任何厂商都能读懂。第二层是厂商专属状态,例如 reasoning 项、thinking 签名、thought 块,按厂商隔离存放,只在请求同一家时原样带回。
from dataclasses import dataclass, field
from typing import Any, Literal

@dataclass
class ToolCall:
    call_id: str              # 统一调用 ID,适配器负责与厂商 ID 互相映射
    name: str
    arguments: dict[str, Any]
    result: Any = None
    idempotency_key: str = "" # 有副作用的工具必须设置

@dataclass
class Message:
    role: Literal["system", "developer", "user", "assistant", "tool"]
    content: list[dict]                      # 文本、图片等多模态块
    tool_calls: list[ToolCall] = field(default_factory=list)
    # 厂商专属状态:键为厂商名,值为原样保存的签名 / reasoning 块
    vendor_state: dict[str, Any] = field(default_factory=dict)
切换模型时,适配器读取标准字段生成新请求。vendor_state 中属于其他厂商的部分不发送,属于目标厂商的部分原样回传。
3.2 通过 Provider Adapter 适配原生 API
每个适配器承担三项职责:
- 输入转换:角色映射(例如把 system 移到 Claude 的独立字段)、工具定义转换、Schema 降级、推理档位映射。
- 输出转换:把原生响应和流式事件转成第 2.4 节的内部事件,把工具调用 ID 映射成统一 ID。
- 状态处理:提取并保存签名、reasoning 项等厂商状态,决定使用服务端延续(
previous_response_id、previous_interaction_id)还是完整回传历史。
普通问答可以走 OpenAI 兼容格式的公共适配器。需要严格工具参数、缓存控制、加密思考状态的场景,再分别实现原生适配器。这样既保留了统一入口的便利,又让高级能力有明确的落点。
3.3 用能力注册表决定可用功能
能力注册表以“模型 + 接入端点”为单位记录实际支持情况,同一个模型走原生 API 和走兼容层,可能对应两条记录。下面是一个结构示例,具体取值必须以官方文档和你自己的测试结果为准:
gpt-6.1-sol@responses:
  tools: true
  tool_api: responses          # 工具调用要求使用 Responses API
  reasoning_effort: [low, medium, high]   # 不接受 none
  vendor_state: reasoning_items
claude-sonnet@openai-compat:
  tools: true
  strict_tools: false          # 兼容层忽略 strict
  prompt_caching: false
  file_input: false
  merges_system_developer: true
gemini-flash@interactions:
  tools: true
  builtin_tools: [google_search, url_context, code_execution]
  vendor_state: thought_signatures
路由层在选模型前查询注册表。请求带了文件,就排除 file_input: false 的条目;需要严格工具参数,就只选择 strict_tools: true 的条目。产品界面也可以据此隐藏当前模型不支持的选项,减少用户触发报错。
4 多模型 API 兼容上线前的测试与观测
4.1 从简单问答到多轮工具链的六项兼容测试
按复杂度递增,依次完成以下六项测试:
- 普通问答:同一段提示词发给三个模型,检查回答内容和 Token 统计是否正常。
- 流式输出:确认输出持续到达,并且收到正确的结束信号。
- 工具调用:模型调用天气查询或数据查询工具,应用执行后回传结果。
- 多工具循环:连续两轮以上调用工具,确认历史记录和调用 ID 完整。
- 结构化 JSON:按同一份 Schema 输出,并用应用侧校验器验证结构。
- 模型切换:同一业务会话在 GPT、Claude、Gemini 之间切换,确认上下文、工具记录和最终回答都正常。
第 4、6 项最能暴露推理状态的问题,建议放进持续集成流程。每当升级模型版本或更换接入端点,都重新跑一遍。
4.2 建立统一的成本及稳定性观测
每次请求至少记录以下字段:模型与端点、请求成功率、异常类型(按第 2.6 节的分类)、首字延迟与总任务耗时、分项 Token(输入、缓存写入、缓存命中、思考、输出)、工具调用次数与失败次数、重试与回退次数。
评估模型时要看完整任务的总耗时和总成本,单次请求的数据参考价值有限。一个单价便宜的模型如果工具参数出错率高,需要多轮重试,整体成本可能反而更高。
5 统一 API 网关在多模型 API 兼容中的作用
5.1 接入与维护成本
同时使用三家模型,意味着三套账号、三套密钥、三套计费和三套 SDK 配置。统一 API 网关把这些工作收敛到一个入口:集中管理模型接入和凭据,减少各服务商的配置维护,支持在配置层选择和切换模型,并统一观察用量与成本。对于需要频繁对比模型效果的团队,试用新模型的门槛也随之降低。
5.2 API易 的定位:统一入口与原生能力适配的分工
API易 是 AI 大模型 API 聚合平台,用一个 API Key 即可通过 OpenAI 兼容接口调用 OpenAI、Claude、Gemini 等主流模型,按量计费。它适合承担架构中的“统一调用入口”这一层:普通问答、流式输出、模型对比和多模型路由都可以直接接入。
统一调用入口与厂商原生能力完全一致,是两项不同的技术要求。接入具体模型时,仍需在能力注册表中逐项核实工具调用、思考状态、多模态、缓存和结构化输出的支持范围。依赖 Responses API、cache_control、加密签名等原生能力的链路,要确认对应端点确实可用后再上线,或者为其保留专门的原生适配器。
多模型 API 兼容快速上手
极简示例:同一提示词对比三个模型
以下代码用同一个 OpenAI SDK 客户端依次调用三个模型,对应第 4.1 节的第 1 项测试。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口
)

# 模型 ID 以平台模型列表为准
MODELS = ["你的GPT模型ID", "你的Claude模型ID", "你的Gemini模型ID"]

for model in MODELS:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是幂等"}],
    )
    print(model, "→", resp.choices[0].message.content)
    print("usage:", resp.usage)
查看完整实现:统一流式事件 + 能力注册表 + 工具校验
import json
import openai
from openai import OpenAI
from jsonschema import validate, ValidationError

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口
)

# 能力注册表:取值仅为结构示例,请按官方文档与实测结果维护
CAPABILITIES = {
    "gpt":    {"model": "你的GPT模型ID",    "tools_via": "responses"},  # 工具调用需走 Responses 适配器
    "claude": {"model": "你的Claude模型ID", "tools_via": "chat"},
    "gemini": {"model": "你的Gemini模型ID", "tools_via": "chat"},
}

def classify_error(e: Exception) -> str:
    """统一错误分类,决定是否可重试"""
    if isinstance(e, openai.AuthenticationError):
        return "auth_failed"
    if isinstance(e, openai.NotFoundError):
        return "model_not_supported"
    if isinstance(e, openai.RateLimitError):
        return "rate_limited"          # 可退避重试
    if isinstance(e, openai.BadRequestError):
        return "invalid_request"       # 参数错误或超出上下文,不应盲目重试
    if isinstance(e, openai.APIConnectionError):
        return "network_error"
    if isinstance(e, openai.InternalServerError):
        return "server_error"
    return "unknown"

def stream_chat(provider: str, messages: list, tools: list | None = None):
    """把 OpenAI 兼容格式的流转换为内部统一事件"""
    cap = CAPABILITIES[provider]
    if tools and cap["tools_via"] != "chat":
        raise NotImplementedError(f"{provider} 的工具调用请交给原生适配器处理")

    kwargs = {
        "model": cap["model"],
        "messages": messages,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    if tools:
        kwargs["tools"] = tools

    calls: dict[int, dict] = {}   # 按 index 拼接并行工具调用的参数分片
    finished = False
    try:
        for chunk in client.chat.completions.create(**kwargs):
            if not chunk.choices:
                if chunk.usage:
                    yield {"type": "usage", "data": chunk.usage.model_dump()}
                continue
            choice = chunk.choices[0]
            delta = choice.delta
            if delta.content:
                yield {"type": "text_delta", "data": delta.content}
            for tc in delta.tool_calls or []:
                slot = calls.setdefault(tc.index, {"id": None, "name": "", "args": ""})
                if tc.id:
                    slot["id"] = tc.id
                if tc.function and tc.function.name:
                    slot["name"] = tc.function.name
                    yield {"type": "tool_call_start", "data": {"id": slot["id"], "name": slot["name"]}}
                if tc.function and tc.function.arguments:
                    slot["args"] += tc.function.arguments
                    yield {"type": "tool_call_args", "data": {"index": tc.index}}
            if choice.finish_reason:
                finished = True
                yield {"type": "completed", "data": {
                    "finish_reason": choice.finish_reason,
                    "tool_calls": list(calls.values()),
                }}
    except Exception as e:
        yield {"type": "error", "data": classify_error(e)}
        return
    if not finished:
        yield {"type": "error", "data": "stream_interrupted"}  # 半途断流

EXECUTED_KEYS: set[str] = set()   # 生产环境请换成持久化存储

def run_tool(call: dict, schema: dict, func, idempotency_key: str | None = None):
    """先校验参数,再幂等执行"""
    try:
        args = json.loads(call["args"])   # 只在分片收齐后解析
        validate(instance=args, schema=schema)
    except (json.JSONDecodeError, ValidationError) as e:
        return {"error": f"invalid_arguments: {e}"}
    if idempotency_key:
        if idempotency_key in EXECUTED_KEYS:
            return {"skipped": "already_executed"}
        EXECUTED_KEYS.add(idempotency_key)
    return func(**args)

# 使用示例
for event in stream_chat("claude", [{"role": "user", "content": "介绍一下流式输出"}]):
    print(event)
🚀 快速开始:通过 API易 apiyi.com 注册即可获取免费测试额度,用上面的代码在同一个 Key 下完成第 4.1 节的前两项测试。工具调用和多轮推理相关测试,请结合能力注册表逐个模型验证。
常见问题 FAQ
Q1:多模型 API 兼容问题主要指什么?
指同一个应用在 GPT、Claude、Gemini 之间切换时,因原生 API 结构不同而需要处理的差异。主要包括 6 类:消息角色、工具调用、推理状态、流式事件、结构化输出与多模态、缓存计费与错误处理。
Q2:用 OpenAI 兼容接口调用 Claude 和 Gemini,还需要适配层吗?
普通聊天可以直接使用兼容接口。涉及严格工具参数、Prompt Caching、文件输入、加密思考状态时,就需要适配层。以 Claude 官方兼容层为例,它会忽略 `strict`,也不支持缓存和 audio/file 输入。这些差异应写进能力注册表。
Q3:Gemini 新项目应该用 Interactions API 还是 generateContent?
Interactions API 于 2026 年 6 月进入 GA,Google 推荐新项目优先采用。它支持服务端会话状态、`previous_interaction_id` 和 steps 结构。`generateContent` 仍受支持,存量项目可以按计划迁移。
Q4:会话中途切换模型,历史记录要怎么处理?
用户消息、最终回答、工具请求和工具结果存为标准历史,切换后由目标适配器重新组装。签名、reasoning 项等厂商专属状态单独保存,只在请求同一厂商时原样回传。另外,切换后原厂商的缓存通常无法复用,要预留首轮的完整输入成本。
Q5:如何快速验证三个模型在我的业务里的兼容性?
建议按以下步骤操作:
1. 访问 API易 apiyi.com 注册账号,获取 API Key 和免费测试额度。
2. 使用本文代码,将 base_url 设为 API易 接口地址,填入三个模型 ID。
3. 按第 4.1 节的六项测试逐级执行,并记录成功率、异常类型、成本和总耗时。
Q6:设置模型自动回退时要注意什么?
先判断任务是否有副作用。付款、发邮件、改文件等工具必须带幂等键,回退时从未完成的步骤继续,避免整个任务重跑。限流和服务端错误适合退避重试,参数错误和超出上下文需要修正请求后再发送。
Q7:多模型路由时怎样控制成本?
按分项 Token 记录费用,以完整任务的总成本做比较。三家单价差距较大,例如 GPT-6 Astra 的输出价格为每百万 Token $50,Gemini 3.8 Flash 当前促销价为 $3.75。在 API易 apiyi.com 统一查看各模型用量,可以更快发现高成本链路,再据此调整路由规则。
Q8:统一 API 网关有哪些局限?
网关统一的是调用入口、密钥和计费。厂商原生高级能力(如 Responses API 专属工具调用、`cache_control`、加密签名回传)是否可用,取决于具体端点的支持情况,需要逐项实测。依赖这些能力的链路,应保留原生适配器作为补充。
多模型 API 兼容核心要点 Key Takeaways
- 换模型 ≠ 换 ID:普通问答可以直接迁移,Agent 链路需要处理 6 类差异。
- 兼容层有边界:Claude 兼容层忽略
strict,不支持缓存和文件输入。 - 签名必须原样保存:thinking / thought 签名丢失是多轮工具链报错的常见原因。
- 流式事件统一化:后端输出 8 种内部事件,前端只对接一套协议。
- 能力注册表驱动路由:以“模型 + 端点”为单位记录真实支持的功能。
- 回退要幂等:有副作用的工具加幂等键,防止重复执行。
- 先测再上线:用 API易 apiyi.com 的免费额度跑通六项兼容测试。
总结
一个应用同时接入 GPT、Claude 和 Gemini,关键在于把差异集中到少数几个组件中管理:
- 统一消息与工具格式:标准历史与厂商专属状态分层存储,切换模型时上下文不丢失。
- Provider Adapter:负责输入转换、输出转换和状态处理,原生高级能力在这里落地。
- 能力注册表:如实记录每个模型、每个端点的工具、推理、多模态、Schema 和缓存支持情况,由它决定路由和界面选项。
在此基础上,用六项兼容测试和分项成本观测守住上线质量。普通调用和模型对比阶段,推荐通过 API易 apiyi.com 用一个 Key 快速完成多模型验证,再根据测试结果决定哪些链路需要原生适配。
📚 参考资料
- OpenAI Function Calling:工具调用、
call_id与function_call_output - 链接:
developers.openai.com/api/docs/guides/function-calling -
说明: Responses API 工具调用协议的权威说明
-
OpenAI 最新模型迁移指南:GPT-6 系列推理参数与接口要求
- 链接:
developers.openai.com/api/docs/guides/latest-model -
说明:
reasoning.effort取值限制与 Responses API 要求 -
OpenAI Prompt Caching:缓存断点与 TTL
- 链接:
developers.openai.com/api/docs/guides/prompt-caching -
说明: 隐式与显式缓存机制
-
Claude OpenAI SDK 兼容:兼容层支持范围与限制
- 链接:
platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk -
说明:
strict、缓存、文件输入、system 合并等差异 -
Claude Extended Thinking:Adaptive Thinking 与思考签名
- 链接:
platform.claude.com/docs/en/build-with-claude/extended-thinking -
说明: 多轮工具调用中 thinking 块的回传规则
-
Claude 结构化输出与缓存:JSON outputs、Strict tool use、
cache_control - 链接:
platform.claude.com/docs/en/build-with-claude/structured-outputs - 链接:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
说明: 结构化约束与缓存模式
-
Gemini Interactions API 与 OpenAI 兼容:新接口与兼容入口
- 链接:
ai.google.dev/gemini-api/docs/interactions-overview - 链接:
ai.google.dev/gemini-api/docs/openai -
说明: steps 结构、会话状态与兼容参数映射
-
Gemini 思考签名、工具调用与缓存
- 链接:
ai.google.dev/gemini-api/docs/thought-signatures - 链接:
ai.google.dev/gemini-api/docs/function-calling - 链接:
ai.google.dev/gemini-api/docs/caching -
说明: stateless 模式签名保留、工具协议与显式缓存
-
三家官方价格页
- 链接:
developers.openai.com/api/docs/pricing - 链接:
platform.claude.com/docs/en/models/sonnet-5-5/overview - 链接:
ai.google.dev/gemini-api/docs/pricing - 说明: 本文价格表的数据来源,核对日期 2026-11-13
作者:API易 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心


