
作者注:本文所有能力边界均对照 API易模型文档整理,写作前按 2026 年 11 月版本核对过一遍,结论以文档为准。
一张人像图、一段音频,想让画面里的人开口说话,这是图生视频里最常见的诉求。很多人的第一反应是把 driving_audio 一起塞给 happyhorse-1.1-i2v,结果音频驱动没有生效,于是开始怀疑素材、怀疑参数顺序,甚至怀疑自己的调用方式。
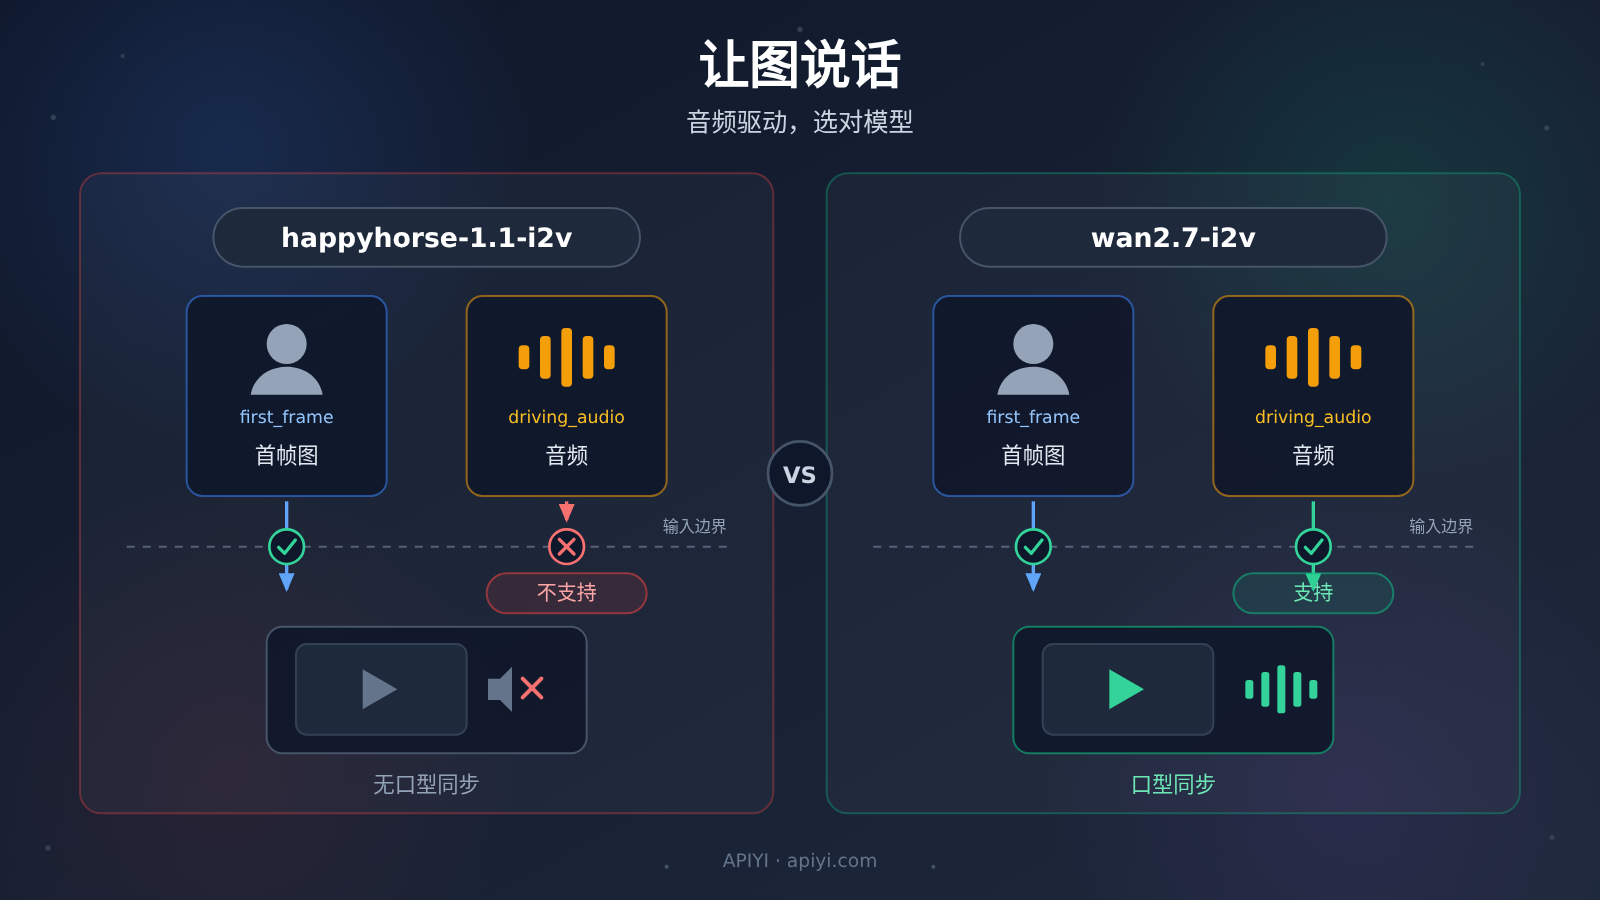
这不是玄学故障,也不是素材不够好。文档在这件事上写得非常直白:happyhorse-1.1-i2v 只接受 first_frame,不支持 driving_audio;要做口型同步或说唱,文档给出的方向是换 wan2.7-i2v。
核心价值:看完本文,你会清楚 happyhorse-1.1-i2v 和 wan2.7-i2v 的分工边界,知道“让图说话”该把参数传给谁,一次跑通。
happyhorse-1.1-i2v 核心要点
先给结论,细节后面展开:
| 要点 | 文档记载 | 对你的意义 |
|---|---|---|
| 只认首帧图 | happyhorse-1.1-i2v 接受 first_frame 输入 |
图像是它唯一的驱动入口 |
| 不支持音频驱动 | 该模型不支持 driving_audio |
传了也不生效,不必反复重试 |
| 口型同步另有去处 | 文档建议口型同步场景改用 wan2.7-i2v |
换模型比换参数更快解决问题 |
第一点是最容易误判的地方。driving_audio 不是 happyhorse-1.1-i2v 的隐藏参数,也不是要等某个版本才开放的能力。模型文档明确把它标注为不支持,连概览页的图生视频条目也写了同样的结论。换句话说,问题不在你的调用姿势,而在模型的能力边界本来就在这里。
第二点关于替代路线。文档记载,音频驱动是 wan2.7-i2v 的专属能力,HappyHorse 的 i2v 不承担这类任务。所以当人物需要开口说话时,正确的动作不是继续调参,而是直接切换模型。
happyhorse-1.1-i2v 与 wan2.7-i2v 核心差异
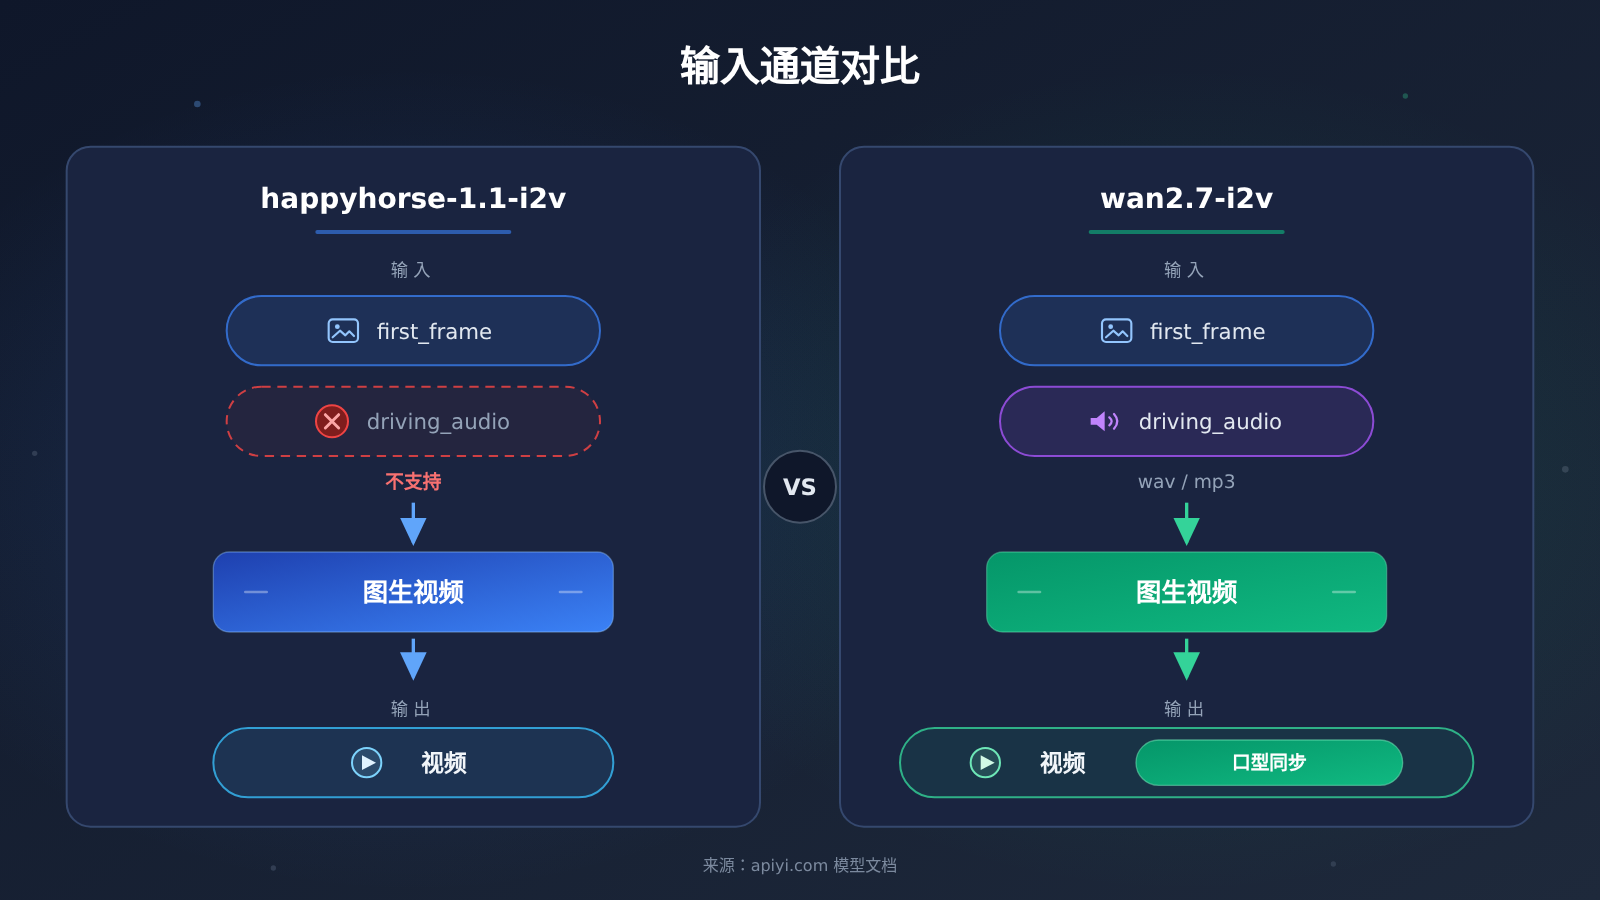
两个模型同为首帧图生视频,定位重叠,真正拉开差距的是音频输入这一行:
| 对比维度 | happyhorse-1.1-i2v |
wan2.7-i2v |
差异结论 |
|---|---|---|---|
| 任务类型 | 首帧图生成视频 | 首帧图生成视频 | 定位重叠,别按名字分高下 |
first_frame |
接受 | 必须有 1 个 | 图像输入两边都不可缺 |
driving_audio |
不支持 | 支持,可选 1 个 | 口型同步的分水岭 |
| 音频格式 | 不适用 | wav 或 mp3 |
传参前先确认格式 |
| 口型同步场景 | 文档建议改用 wan2.7-i2v |
文档指定承载该场景 | 选型看这一行就够了 |
上表与配图均依据 API易模型文档(apiyi.com)整理,不是经验推测。
happyhorse-1.1-i2v 在“让静态首帧动起来”这件事上是正路:给它一张 first_frame,它负责把画面演下去。但音频不在它的输入清单里,文档记载音频驱动能力没有开放给 HappyHorse 的 i2v。相比之下,wan2.7-i2v 在同样的首帧输入之外多开了一扇门,driving_audio,人物的动作节奏可以跟着音频走。
wan2.7-i2v 的约束也更具体:媒体里必须恰好有 1 个 first_frame,driving_audio 至多 1 个,音频格式限定 wav 或 mp3。这些约束写得很死,好处是你照着文档组装,一次就能跑通,不用靠猜。
为什么 happyhorse-1.1-i2v 不接受 driving_audio
把文档线索摊开,至少有四层信息指向同一个结论:
- 模型页写明:
happyhorse-1.1-i2v是首帧图生成视频模型,只接受first_frame。 - 同页明确标注:不支持
driving_audio。 - 概览页的图生视频条目,同样标注不支持音频驱动。
- 面对口型或说唱需求,文档直接给出迁移建议:改用
wan2.7-i2v。
于是回到那个经典场景:你在请求里放进了 driving_audio,结果与预期对不上,开始逐项排查素材和参数。无论接口最终以什么形式反馈,根因都只有一个——这个字段对 happyhorse-1.1-i2v 来说不在输入范围内。文档没有留下“换个写法就行”的口子,重试和换素材都改变不了输入边界。
如果你是在 API易(apiyi.com)上发起的调用,排查时先把请求里的模型 ID 与字段名和文档逐项对照,再检查其它环节。多数“音频没生效”的问题,在这一步就能定位,不需要绕远路。
用 wan2.7-i2v 的 driving_audio 完成口型同步:快速上手
确认换用 wan2.7-i2v 之后,整个流程只剩四步,重心全在媒体组装上:
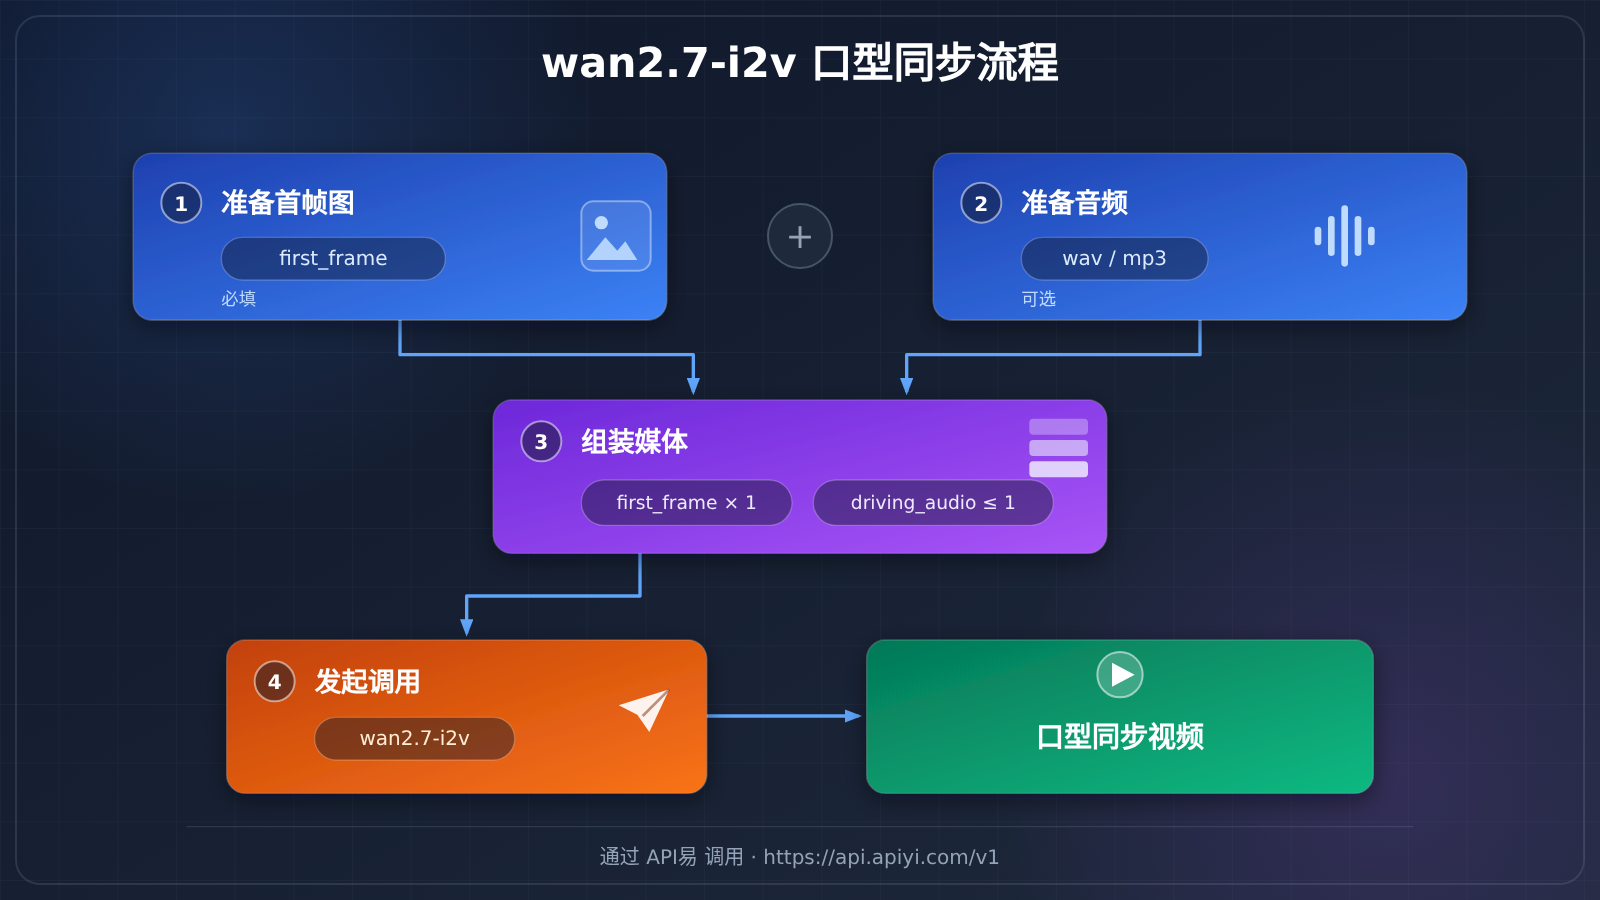
- 准备首帧图:一张人物清晰、构图稳定的图,作为
first_frame。 - 准备音频:
wav或mp3格式,作为driving_audio驱动口型与节奏。 - 组装媒体:恰好 1 个
first_frame,至多 1 个driving_audio,不要多塞。 - 发起调用:模型填
wan2.7-i2v;通过 API易调用时,接口基础地址为https://api.apiyi.com/v1。
| 字段 | 是否必填 | 数量约束 | 格式要求 |
|---|---|---|---|
first_frame |
必填 | 恰好 1 个 | 首帧图 |
driving_audio |
可选 | 至多 1 个 | wav 或 mp3 |
前两步没有悬念,真正决定成败的是第 3 步。文档对数量的表述非常严格:first_frame 必须有且恰好 1 个,driving_audio 可选且至多 1 个。图或音频多传都可能让请求不符合约定,别把“多多益善”的直觉带进参数组装。
🚀 快速开始:推荐直接通过 API易 apiyi.com 验证这套流程。平台聚合 OpenAI、Claude、Gemini 等主流模型 API,一个 Key 可调用多个模型,按量计费,新用户有免费测试额度,跑通
wan2.7-i2v的口型同步几乎零成本。
happyhorse-1.1-i2v 还是 wan2.7-i2v:场景推荐
| 你的需求 | 推荐模型 | 关键输入 |
|---|---|---|
| 人物开口说话、口型对齐音频 | wan2.7-i2v |
first_frame 加 driving_audio |
| 说唱、台词等节奏型表演 | wan2.7-i2v |
first_frame 加 driving_audio |
| 让静态图自然动起来,不需要声音 | happyhorse-1.1-i2v |
仅 first_frame |
继续留在 happyhorse-1.1-i2v 的场景
不需要声音参与的动态化任务,happyhorse-1.1-i2v 依然是正经选择。它的职责是把一张首帧图演成一段有运动感的视频,输入干净,只认 first_frame。如果你的成片交给后期配音,或者根本不需要音频,留在这里反而省事。
- 首帧驱动运动:让人物、景物从静态画面里自然动起来。
- 无声内容生产:成片后期配音,或用于不需要声音的展示场景。
换到 wan2.7-i2v 的场景
只要成片需要人物“跟着声音动”,答案就落在 wan2.7-i2v 上。文档记载的音频驱动能力,让它成为这两个模型里唯一接收 driving_audio 的选项,口型与节奏由音频直接牵引。
- 口型同步:一张人像加一段人声,生成开口说话的视频。
- 音频驱动表演:说唱、台词等节奏型内容,动作跟着音频走。
如果两类需求你都有,可以在 API易上把同一组素材分别跑一次,切换模型不需要换 Key,对比完再定分工也不迟。
happyhorse-1.1-i2v 与 wan2.7-i2v 决策建议
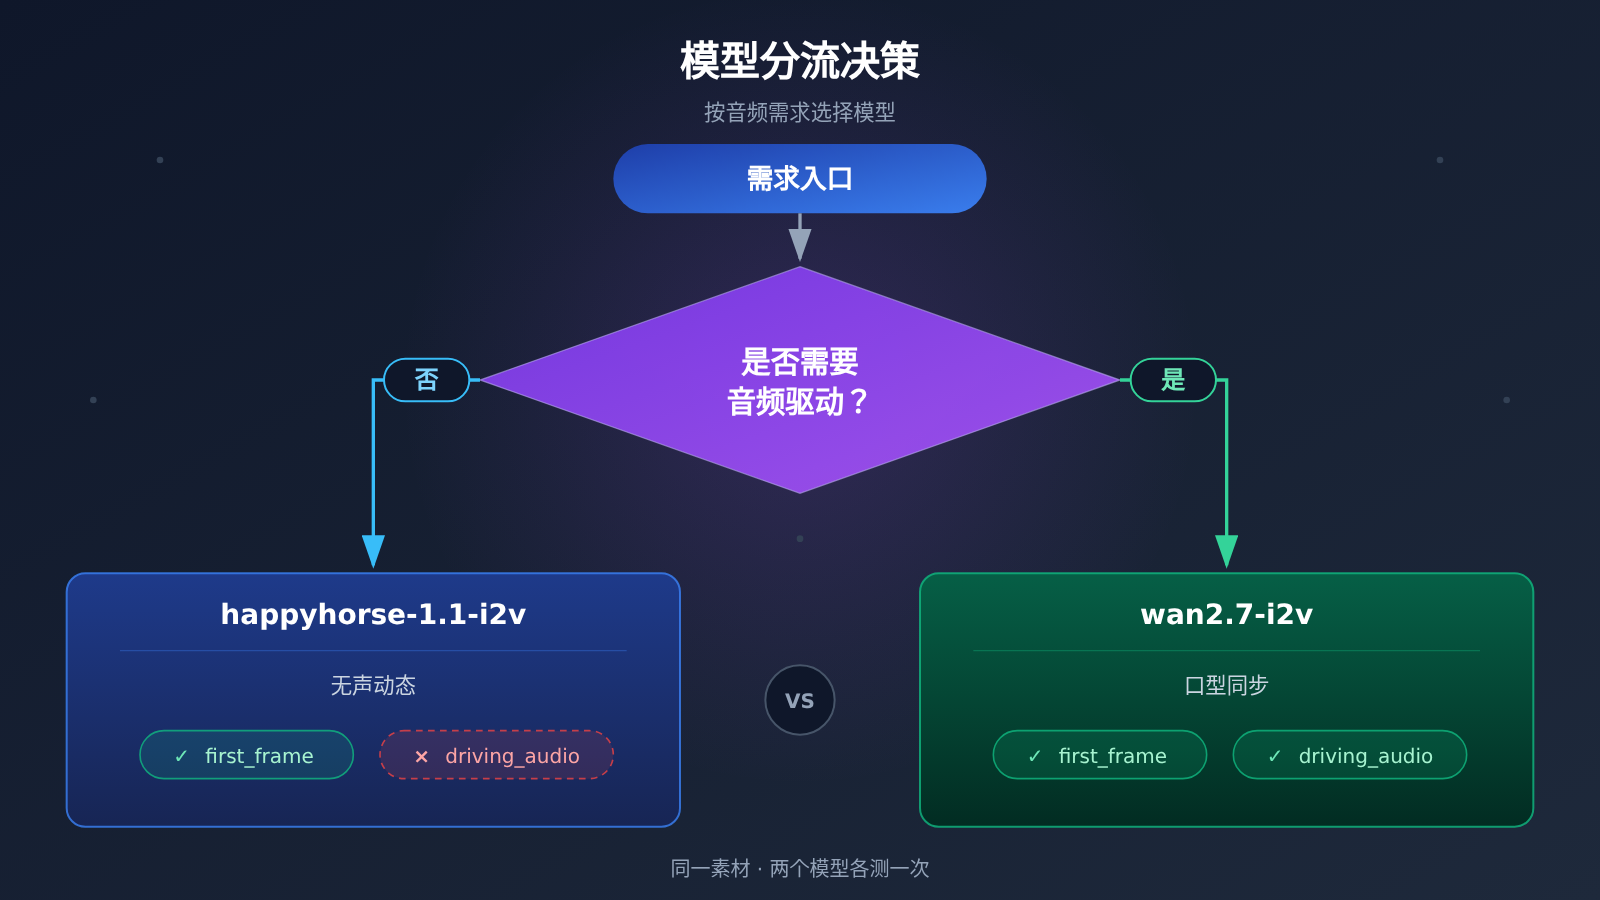
| 当前状态 | 建议动作 |
|---|---|
| 口型同步是硬需求 | 直接用 wan2.7-i2v,带上 driving_audio |
| 只需要画面动起来 | 留在 happyhorse-1.1-i2v,只传 first_frame |
已把音频传给 happyhorse-1.1-i2v 却不生效 |
停止重试,换 wan2.7-i2v,这不是参数问题 |
决策的核心只有一句话:先问“这段视频需要开口吗”。需要声音参与表演,答案就是 wan2.7-i2v;不需要,happyhorse-1.1-i2v 继续胜任首帧图生视频。把音频交给正确的模型,比在任何模型上死磕参数都省时间。
💡 选择建议:拿不准效果时,别停留在文档层面的推理,直接在 API易 apiyi.com 上各跑一次最小用例,用两段真实结果做决定最可靠。
关于 driving_audio 的常见问题 FAQ
Q1:什么是 happyhorse-1.1-i2v?
首帧图生成视频模型,输入只接受 `first_frame`。文档明确标注它不支持 `driving_audio`,音频驱动不在它的能力范围内。
Q2:happyhorse-1.1-i2v 和 wan2.7-i2v 在音频驱动上有什么区别?
文档把音频驱动标注为 `wan2.7-i2v` 的专属能力,同时写明 HappyHorse 的 i2v 不支持。也就是说,`wan2.7-i2v` 接收 `driving_audio`,`happyhorse-1.1-i2v` 不接收。其它型号是否支持,请以各自文档为准,别按系列名类推。
Q3:把 driving_audio 传给 happyhorse-1.1-i2v 会发生什么?
文档的答复很直接:不支持,只接受 `first_frame`。与其研究各种反馈细节,不如把这组素材改投 `wan2.7-i2v`,同样的图和音频立刻就有用武之地。
Q4:driving_audio 对格式和数量有什么要求?
音频格式为 `wav` 或 `mp3`;媒体中必须恰好有 1 个 `first_frame`,至多 1 个 `driving_audio`。照这个约束组装请求,一次通过率最高。
Q5:如何通过 API 快速调用 wan2.7-i2v?
推荐从聚合平台起步:
1. 在 API易 apiyi.com 注册并获取 API Key,新用户有免费测试额度;
2. 接口基础地址使用 `https://api.apiyi.com/v1`;
3. 按“1 个 `first_frame` 加 1 个 `driving_audio`”组装媒体,模型填 `wan2.7-i2v`。
Q6:是不是万相系列都能这样传音频?
不能这么类推。文档只把音频驱动写给了 `wan2.7-i2v`,其它型号是否支持,以对应文档为准,别凭系列名猜能力。
Q7:去哪里核对这两个模型的能力说明?
API易把能力边界写在模型文档里,访问 docs.apiyi.com 即可逐条核对。选型前查一遍文档,比踩坑后再排查便宜得多。
happyhorse-1.1-i2v 与 driving_audio 核心要点 Key Takeaways
- 能力边界:
happyhorse-1.1-i2v只接受first_frame,driving_audio不在其输入中。 - 专属能力:音频驱动属于
wan2.7-i2v,口型同步直接找它。 - 媒体约束:恰好 1 个
first_frame,至多 1 个driving_audio,音频限wav或mp3。 - 迁移指引:文档建议口型或说唱场景从
happyhorse-1.1-i2v换到wan2.7-i2v。 - 验证方式:用一组素材各跑一次最小用例,两段结果即可敲定选型。
总结
关于“想让图说话”这件事,三个结论值得带走:
- 输入边界:
happyhorse-1.1-i2v不接受driving_audio,只认first_frame,这是文档写明的能力边界。 - 正确去处:口型同步与音频驱动是
wan2.7-i2v的专属能力,一张图加一段wav或mp3即可开工。 - 排障思路:音频不生效时先查模型与字段的匹配关系,而不是反复重试。
选型拿不准时,用最小用例各跑一次再决定。推荐通过 API易 apiyi.com 快速验证,平台提供免费测试额度和多模型统一接入,换模型不需要换 Key。
📚 参考资料
- API易文档 · HappyHorse 图生视频
- 链接:
docs.apiyi.com/api-capabilities/happyhorse/image-to-video.md -
说明:
happyhorse-1.1-i2v的输入定义与“不支持driving_audio”的原文出处。 -
API易文档 · Wan 图生视频
- 链接:
docs.apiyi.com/api-capabilities/wan/image-to-video.md -
说明:
wan2.7-i2v对first_frame与driving_audio的数量及格式约束。 -
API易文档 · HappyHorse 概览
- 链接:
docs.apiyi.com/api-capabilities/happyhorse/overview.md - 说明: 图生视频条目对音频驱动能力的整体标注。
作者: API易技术团队
技术交流: 欢迎在 API易 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心


