
摘要:本文說明 AI 產品免費試用額度應該如何確定,並給出一套按真實調用成本推算預算、按數據覆盤調整的方法。
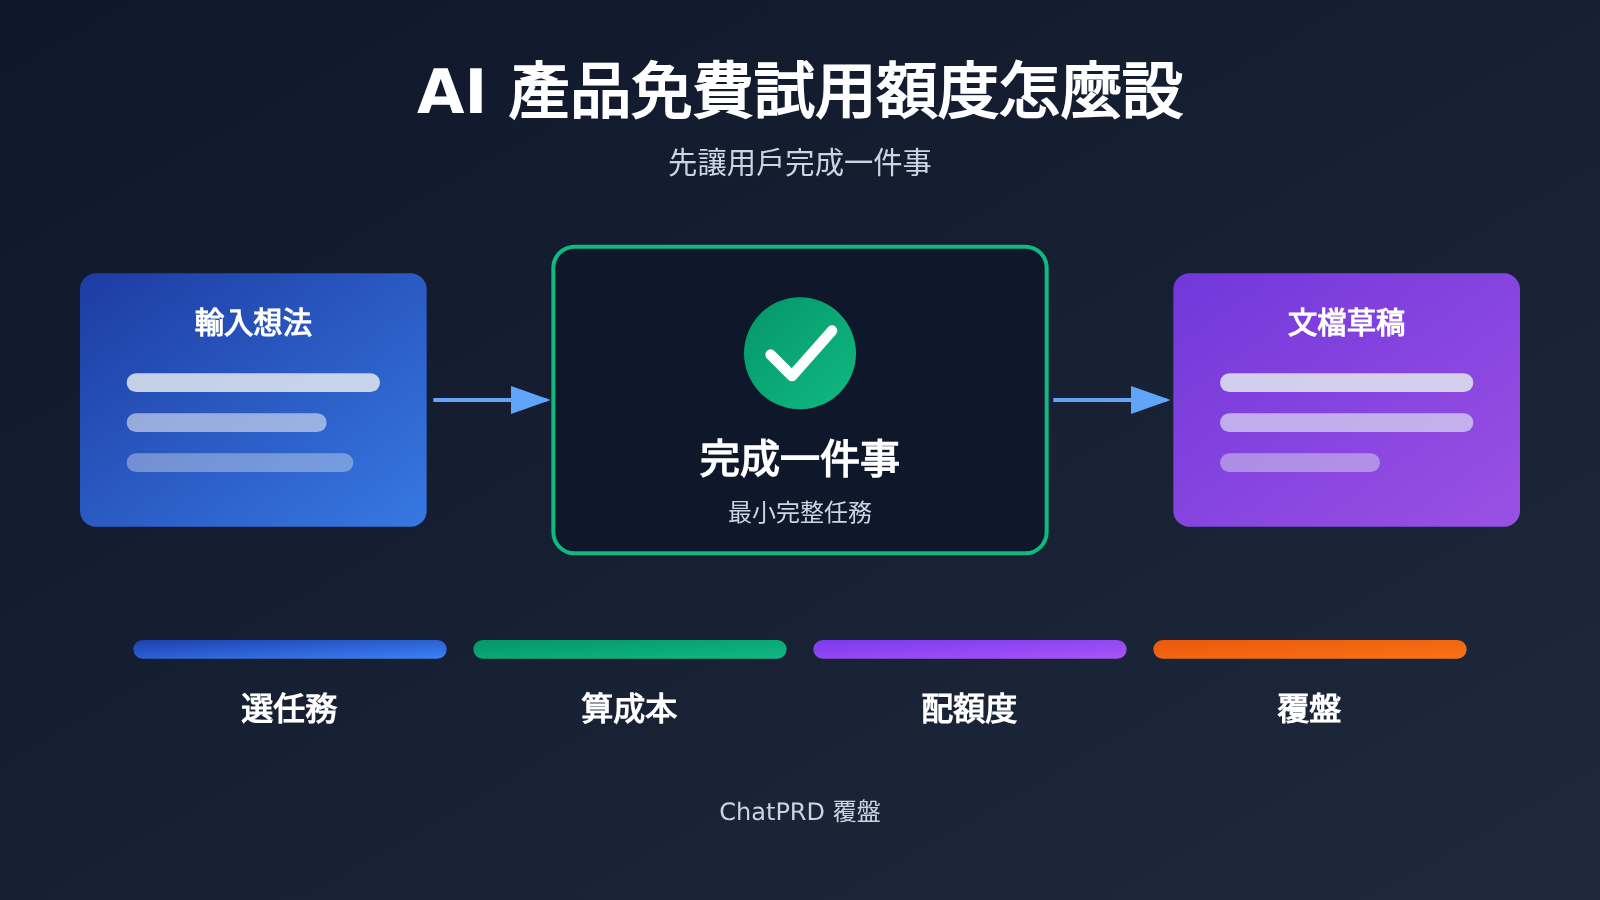
結論先行:AI 產品免費試用額度應該圍繞一件事來設
AI 產品的免費試用額度不能從 token 數量或“給多少積分”開始定,應該先定下用戶在試用期內要完成的那一件事。產品方需要先確定一個用戶能直接感到價值的最小完整任務,再用真實樣本測出完成它要花多少調用成本,最後乘以合理的試用任務次數,得到單賬號額度和總預算。
這個答案受三個條件影響。第一個是任務能否在試用範圍內真正完成,做不完的任務給多少額度都難以轉化。第二個是成本是否來自真實樣本,包括輸入、輸出、重試以及適用的緩存或工具費用。第三個是額度用完時用戶是否清楚自己得到了什麼、下一步能做什麼。
ChatPRD 的覆盤提供了一個現實參照:試用額度設得不好會造成成本損失,而一刀切關掉試用同樣會傷害獲客。所以要做的是把試用設計成可計算、可覆盤的東西,而不是在“全開”和“全關”之間二選一。
免費試用額度設計的知識地圖與索引
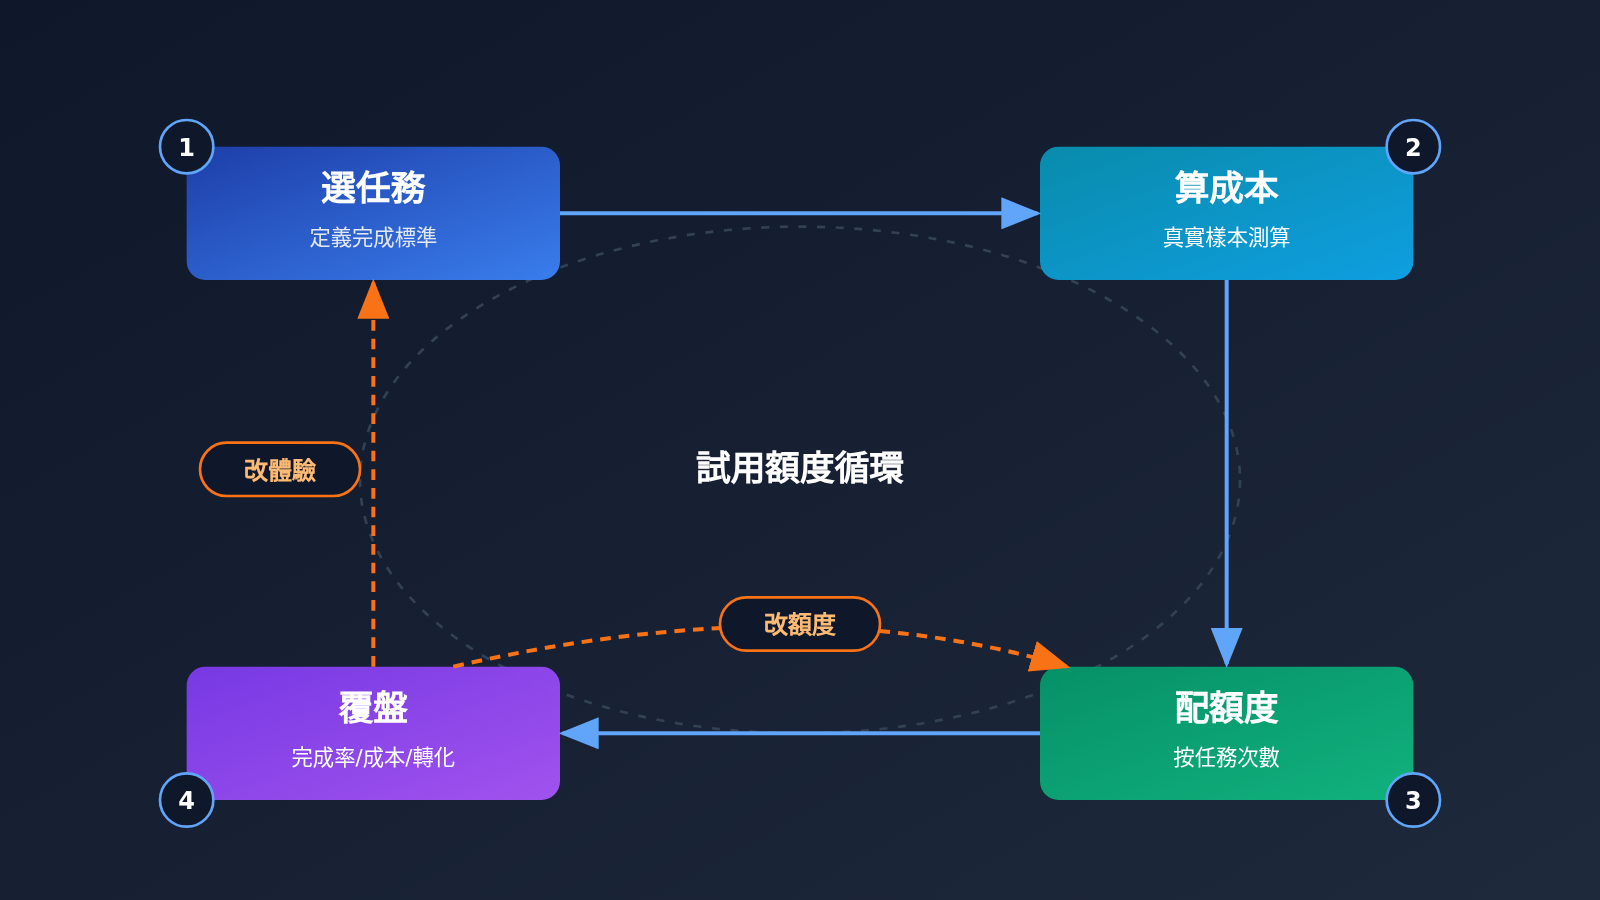
下面這張表同時充當知識地圖和閱讀索引。四個環節按執行先後排列,前一步的輸出就是後一步的輸入。
| 環節 | 對應正文 | 爲什麼要做 | 需要什麼 | 得到什麼 |
|---|---|---|---|---|
| 選任務 | 2、2.1、2.2 | 額度只有用於完成一件有價值的事纔有意義 | 產品核心價值、典型用戶的首個需求 | 一個有明確完成標準的最小任務,以及試用可用的功能邊界 |
| 算成本 | 3、3.1、3.2 | 沒有單次成本,額度和預算都只能拍腦袋 | 真實調用樣本、模型單價、重試與附加費用 | 一次完成成本、單賬號成本、總預算上限 |
| 配額度 | 3.3、4 | 用戶需要看懂額度能做幾次事,而不是看懂 token | 單賬號成本、任務次數、用完時的提示文案 | 以“任務次數”表達的額度,以及清晰的用完提示 |
| 覆盤 | 4.1 | 額度效果要靠數據驗證,才能判斷改體驗還是改額度 | 完成率、每名完成者成本、付費轉化數據 | 下一輪調整方向 |
推薦的閱讀順序是從第 1 節讀到第 4 節。第 1 節交代問題背景,幫你避免對 ChatPRD 案例的誤讀。第 2 節給出示範任務,第 3 節的計算全部建立在這個任務上。第 4 節的覆盤指標又會反過來修正第 2、3 節的設定,構成一個循環。如果你已經有明確的核心任務,可以直接從第 3 節開始。
To Know:理解免費試用額度測算的必要術語
| 術語 | 簡明解釋 |
|---|---|
| Token | 大模型計量輸入和輸出文本長度的單位,多數模型 API 按輸入、輸出 token 分別計價 |
| 最小完整任務 | 用戶在試用中能獨立完成、並能直接感受到產品價值的一件事,是額度設計的基本單位 |
| 重試 | 用戶對結果不滿意而重新生成,或請求失敗後再次調用,都會產生額外成本 |
| 一次完成成本 | 完成一次最小完整任務的平均調用成本,包含重試和適用的附加費用 |
| 首次有效任務完成率 | 試用用戶中,至少完整完成一次核心任務的人所佔比例 |
1. ChatPRD 覆盤:免費試用額度出問題時發生了什麼
1.1 覆盤中的關鍵事實
ChatPRD 創始人 Claire Vo 在 2026-11-16 發佈了一篇覆盤,主題是 token 欺詐正在侵蝕 AI 產品的利潤。她自述,此前近一年裏爲此花掉了數萬美元,還曾經關閉免費試用,結果損害了獲客和企業銷售線索的獲取。
覆盤裏還有一個容易被誤讀的數字:近 20 萬美元。這是失敗的支付嘗試金額,並不是實際損失的金額。轉述這個案例時,要把“已花掉的數萬美元”和“近 20 萬美元失敗支付嘗試”分開說,否則會嚴重誇大問題規模。
1.2 不要從這個案例得出“取消試用”的結論
ChatPRD 現行公開定價頁仍然列有免費計劃,Pro 和 Teams 方案也提供 14 天試用。所以不能把這次覆盤理解爲 ChatPRD 已經取消所有免費試用,更不能把單個產品的經歷外推成整個行業的做法。
這個案例真正值得借鑑的是兩面教訓。試用額度被濫用會直接喫掉利潤,而關掉試用又會讓真實的潛在用戶和企業客戶流失。產品方需要的是一種既能讓真實用戶感到價值、又能把補貼成本算清楚的額度設計方法,下面幾節就圍繞這個目標展開。
2. 用“生成一份可編輯的 PRD 草稿”設計免費試用額度
爲了讓後面的計算有具體對象,這裏用一個示範任務:用戶輸入一個產品想法,最終得到一份可以繼續編輯的 PRD 草稿。之所以選它,是因爲它離產品經理的真實工作最近,用戶拿到結果後能馬上判斷“這東西有沒有用”。
需要說明的是,這只是一個示範任務,用來演示方法,不代表 ChatPRD 實際的試用設計。你的產品可以把它替換成“生成一份競品分析”“改寫一段營銷文案”或“完成一次代碼審查”,方法不變。
2.1 定義免費試用任務的完成標準
完成標準要能被檢查,最好能在產品數據裏埋點判斷。對“生成一份可編輯的 PRD 草稿”來說,可以這樣定義:
- 用戶提交了一個產品想法,並回答了必要的澄清問題。
- 系統生成了一份結構完整的草稿,至少包含背景、目標用戶、核心需求和驗收條件這幾個部分。
- 用戶對草稿進行過至少一次編輯或要求修改,說明內容進入了他的實際工作流。
- 用戶導出、複製或保存了這份草稿。
第 3 條和第 4 條是區分“看過”和“用上”的關鍵。只生成不編輯、不保存,往往說明結果沒有打動用戶,這類試用計入完成會讓後面的覆盤數據失真。
2.2 選擇免費試用可用的功能和邊界
功能邊界決定了完成任務需要調用哪些能力,也直接決定成本結構。試用期間開放的功能,應當剛好覆蓋完成標準所需,不必把全部高級能力一起開放。
- 應該開放:澄清對話、草稿生成、基於對話的修改、導出或複製。這些是完成任務的必經步驟,缺一個用戶就做不完。
- 可以限制:長文檔上傳、聯網檢索、多文檔對比等高成本或非必需的能力。它們可以留到付費方案中作爲升級理由。
- 需要設上限:單次輸入長度、單份草稿的修改輪數。上限的作用是讓成本可預測,而不是爲難用戶。
邊界定好之後,就能列出完成一次任務的典型調用路徑,第 3 節的成本測算就是沿着這條路徑逐步累加的。
3. 按真實用量推算免費試用額度的補貼預算
這一節的核心公式只有一個:試用預算等於完成目標任務所需的調用成本乘以合理的試用任務數,其中調用成本要從實際樣本中統計輸入、輸出、適用的緩存或工具費用以及重試。總體預算上限和額度用完時的提示,則由產品方另行設定。
3.1 從真實樣本統計一次完成成本
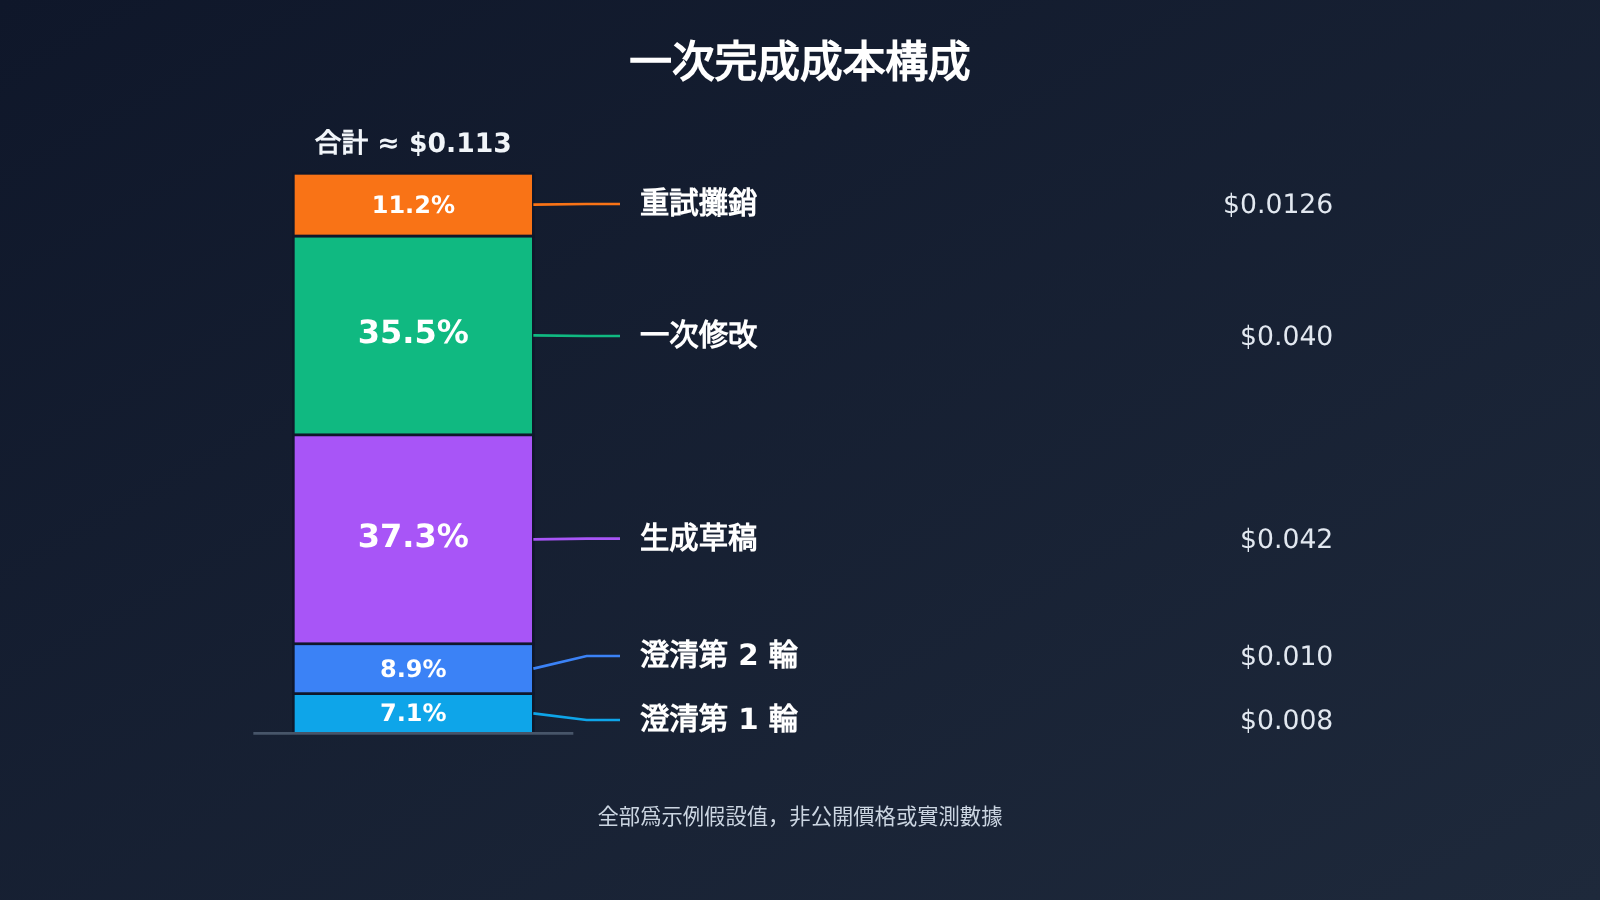
先強調口徑:下表中的 token 數、重試率和單價全部是爲演示計算而設的假設值,不是任何模型的公開價格,也不是實測數據。實際操作時,你應該用內部測試或灰度用戶的真實調用日誌替換這些數字。
如果你的模型調用經由聚合平臺,可以對照平臺公開的模型價格頁和調用日誌查詢功能取數,例如 API易 的模型價格文檔和日誌查詢文檔。需要注意,這類平臺只提供成本數據,試用政策本身仍由應用方設計。
示例假設:輸入單價按每百萬 token 2 美元計,輸出單價按每百萬 token 8 美元計,不使用聯網等工具,緩存摺扣按 0 計。
| 步驟 | 輸入 token(假設) | 輸出 token(假設) | 單次成本(美元) |
|---|---|---|---|
| 澄清對話第 1 輪 | 2,000 | 500 | 0.008 |
| 澄清對話第 2 輪 | 3,000 | 500 | 0.010 |
| 生成草稿 | 5,000 | 4,000 | 0.042 |
| 一次修改 | 10,000 | 2,500 | 0.040 |
| 小計 | 20,000 | 7,500 | 0.100 |
| 重試(假設 30% 的用戶重新生成一次草稿) | — | — | 0.0126 |
| 一次完成成本 | — | — | 約 0.113 |
計算過程很直接:每一步的成本等於輸入 token 乘輸入單價,加上輸出 token 乘輸出單價。修改這一步的輸入明顯更大,是因爲它要把之前的對話和整份草稿一起帶上,這是多輪任務成本的常見特點。重試只計入最常發生的草稿生成步驟,按 0.042 美元乘以 30% 攤入。
3.2 從一次完成成本推到單賬號和總預算
有了一次完成成本,再決定每個試用賬號允許完成幾次任務。示範中設爲 3 次:第一次用來體驗,後兩次讓用戶在自己的真實項目上再用一用。這個次數同樣是假設值,取決於你的用戶通常需要幾次才能形成判斷。
| 預算項 | 計算方式 | 示例結果(假設) |
|---|---|---|
| 一次完成成本 | 來自 3.1 的樣本統計 | 約 0.113 美元 |
| 單賬號試用任務數 | 產品方根據用戶決策習慣設定 | 3 次 |
| 單賬號成本上限 | 一次完成成本 × 任務數 | 約 0.34 美元 |
| 預計月度新試用賬號 | 來自獲客計劃 | 5,000 個 |
| 月度預算上限 | 單賬號成本上限 × 賬號數 | 約 1,690 美元 |
這裏算出的是所有用戶都用滿額度時的上限。實際支出通常低於它,因爲不少用戶只用一兩次就離開或直接付費。產品方可以在這個上限基礎上設定總體預算,一旦實際支出明顯超出預期,就說明出現了異常用量或者樣本口徑有問題,需要回到 3.1 重新覈對。
3.3 可照填的免費試用額度預算表
把上面的步驟合併成一張空白模板,團隊可以直接填入自己的數據:
| 填寫項 | 你的數據 | 數據來源 |
|---|---|---|
| 最小完整任務名稱 | 第 2 節的任務定義 | |
| 每步平均輸入 token | 真實調用日誌 | |
| 每步平均輸出 token | 真實調用日誌 | |
| 輸入、輸出單價 | 所用模型的公開價格頁 | |
| 適用的緩存或工具費用 | 賬單或價格文檔 | |
| 常用重試比例及涉及步驟 | 埋點數據 | |
| 一次完成成本 | 以上各項彙總 | |
| 單賬號試用任務數 | 產品決策 | |
| 預計試用賬號數 | 獲客計劃 | |
| 總預算上限與超限處理方式 | 產品與財務共同決定 |
填完之後,對外展示的額度應當用“任務次數”而不是 token 或積分來表達,例如“試用期內可生成 3 份 PRD 草稿”。用戶能直接理解額度能幫他做多少事,產品方內部再按成本上限做覈算。
4. 免費試用額度用完時的清晰提示
額度用完的那一刻,是用戶判斷要不要付費的關鍵節點。提示做得模糊,用戶會誤以爲產品出了故障;提示做得生硬,用戶會覺得前面的體驗只是誘餌。一個合格的提示應該包含三類信息:
- 已經得到什麼:例如“你已完成 3 份 PRD 草稿,均已保存在項目中”,讓用戶確認試用成果仍然可用。
- 現在不能做什麼:明確說明哪項操作需要額度,避免用戶在操作中途才被攔下。
- 下一步有哪些選擇:如繼續使用免費計劃中的基礎功能、開通付費方案,或聯繫團隊瞭解企業方案。
還有一個細節值得提前設計:儘量不要在任務做到一半時耗盡額度。可以在開始一次新任務前檢查剩餘額度是否足夠完成它,不夠就在開始前提示。這樣用戶感受到的是“我已經做完了幾件事”,而不是“做到一半被打斷”。
4.1 覆盤免費試用額度:改體驗還是改額度
試用上線後,用三個指標判斷問題出在哪裏:
- 首次有效任務完成率:按 2.1 的標準完整完成至少一次任務的試用用戶佔比,反映試用體驗是否通暢。
- 每名完成者成本:試用總成本除以完成者人數,反映爲每一個“感受到價值”的用戶付出了多少補貼。
- 付費轉化:完成者中最終付費的比例,反映價值是否足以支撐購買決策。
三個指標組合起來看,才能判斷該調整什麼:
| 數據表現 | 可能原因 | 調整方向 |
|---|---|---|
| 完成率低,每名完成者成本高 | 用戶卡在任務中途,補貼花在沒完成的人身上 | 改體驗:簡化步驟、優化引導、檢查功能邊界是否漏掉必需能力 |
| 完成率低,且大量用戶在任務中途耗盡額度 | 單次任務成本被低估,額度不夠完成一件事 | 改額度:用新樣本重算一次完成成本,或縮小任務範圍 |
| 完成率高,付費轉化低 | 任務能完成,但價值不足以付費,或額度過多讓用戶無需升級 | 先檢查任務價值,再考慮減少任務次數 |
| 完成率高,轉化正常,每名完成者成本持續上升 | 重試變多或輸入變長 | 回到 3.1 排查重試原因和上下文長度 |
判斷的順序建議先看完成率,再看成本,最後看轉化。完成率不達標時調整額度通常沒有意義,因爲用戶連一件事都沒做完,多給額度只是放大浪費。等完成率穩定後,再用成本和轉化去微調任務次數和總預算,然後回到第 2 節檢查任務定義是否需要更新。
整套方法落地後,你應當能回答一個具體問題:每多一個真正感受到價值的試用用戶,產品要花多少錢,這筆錢又帶來了多少付費。能算清這筆賬,免費試用額度就從一項難以控制的開支,變成了一個可以持續優化的獲客環節。
千里之行,始於足下。——《老子》
參考資料
-
ChatPRD 創始人 Claire Vo 的覆盤文章:關於 token 欺詐侵蝕 AI 利潤及應對方式
- 鏈接:
chatprd.ai/how-i-ai/token-fraud-is-eating-ai-margins-here-s-how-claire-vo-is-fighting-it - 說明: 本文第 1 節案例事實的來源
- 鏈接:
-
ChatPRD 定價頁:現行免費計劃與 Pro、Teams 14 天試用信息
- 鏈接:
chatprd.ai/pricing - 說明: 用於確認該產品現行試用政策
- 鏈接:
-
API易 模型價格文檔:各模型公開計價
- 鏈接:
docs.apiyi.com/models - 說明: 可用於查詢單價,填寫 3.3 預算表
- 鏈接:
-
API易 調用日誌查詢文檔:調用記錄與用量查詢
- 鏈接:
docs.apiyi.com/api-capabilities/log-query - 說明: 可用於統計真實樣本中的輸入、輸出 token 與重試情況
- 鏈接:


