
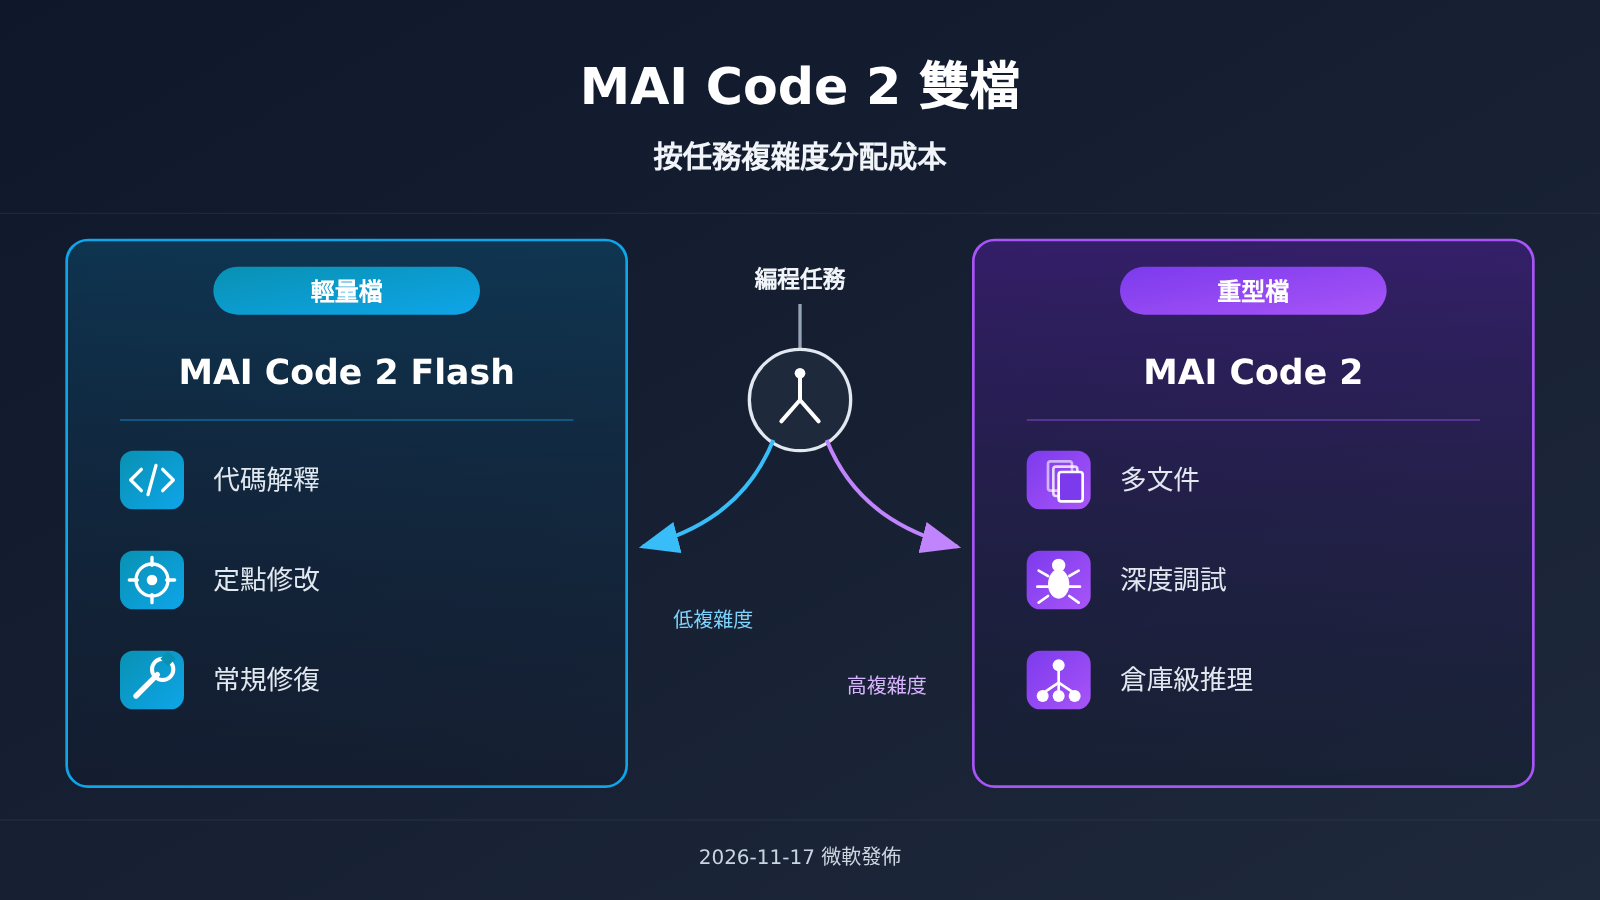
微軟爲複雜工程與高頻日常任務分別提供模型。本文的判斷是,這給企業按任務複雜度分配成本提供了新選項。2026 年 11 月 17 日,微軟發佈 MAI Code 2 與 MAI Code 2 Flash。前者面向多文件修改、深度調試和倉庫級推理,後者面向代碼解釋、定點修改、常規修復和高頻迭代。
本文的核心結論是:企業評估編程 AI 時,不應只看哪個模型“最強”。更重要的問題是,哪些任務可以交給輕量檔,哪些任務必須升級到重型檔,以及每一次成功合併到底花了多少錢。需要說明的是,下文的任務分層流程是編輯部建議,不是微軟已經提供的自動路由保證。
您讀完本文能瞭解到什麼
- MAI Code 2 與 MAI Code 2 Flash 的定位差異,以及它們目前在哪些渠道可用、哪些渠道仍處於“即將上線”狀態。
- 模型卡披露了哪些規格,哪些信息屬於廠商自述、尚未經過獨立驗證。
- 企業如何借鑑“雙檔”思路,搭建自己的編程任務分層流程,並用成功率、返工率和每次合併成本來衡量效果。
- 試點前在數據駐留和權限方面需要覈查的事項,以及幾種容易出現的過度解讀。
MAI Code 2 解讀索引
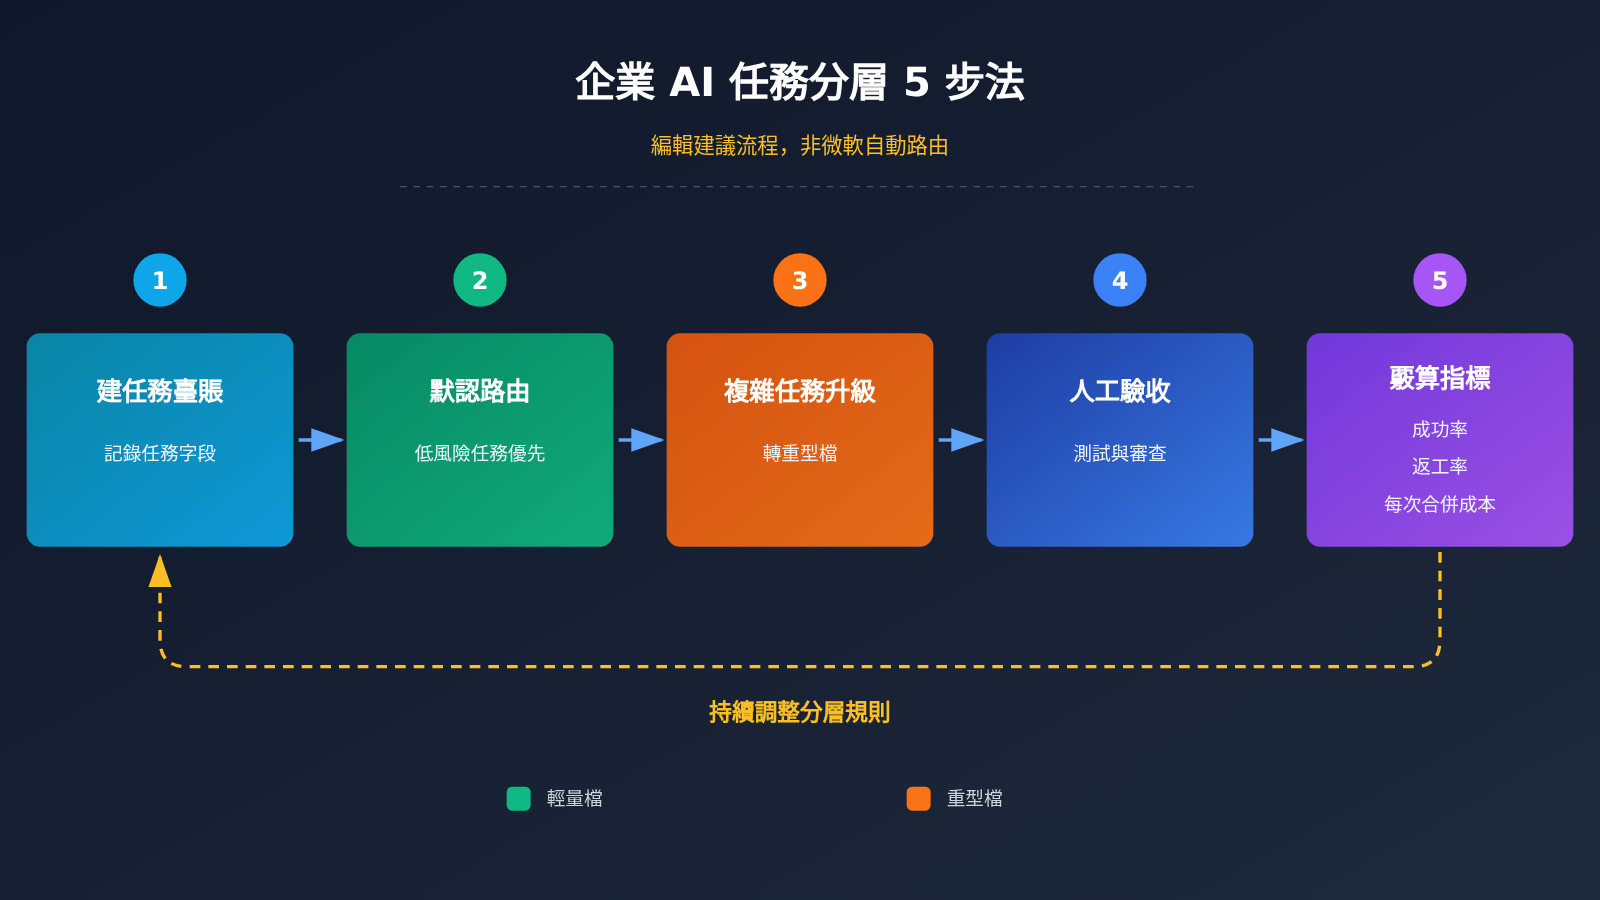
第一部分「客觀事實」依次整理雙檔定位、上線渠道、模型卡規格、企業案例與 MAI Work Flash 的關係,來源爲微軟公開材料與 GitHub 價格文檔。第二部分「分析判斷」是編輯部觀點,先解釋雙檔背後的商業邏輯,再給出建任務臺賬、默認路由、升級規則、人工驗收和指標覈算五個步驟,最後討論試點核查項和需要避免的誤讀。
To Know:理解 MAI Code 2 雙檔發佈的關鍵概念
| 概念 | 簡要解釋 |
|---|---|
| MAI Code 2 | 微軟的重型編程模型,定位爲多文件、深度調試和倉庫級推理 |
| MAI Code 2 Flash | 同系列的輕量檔,定位爲代碼解釋、定點修改、常規修復和高頻迭代 |
| MAI Work Flash | 在 Code 2 Flash 基礎上進一步優化的衍生模型,服務 M365 和 FabricIQ 等辦公與數據場景 |
| Foundry | 微軟面向企業的模型與 AI 應用開發平臺,Flash 在這裏以受限預覽形式提供 |
| Limited-access preview | 受限訪問預覽,需要申請或滿足條件才能使用,不等於全面開放 |
| 上下文窗口 | 模型單次可處理的 token 總量,模型卡標註爲 1.05M |
| 倉庫級推理 | 理解整個代碼庫的結構和依賴關係後再修改,而不只看單個文件 |
| 模型路由 | 按任務特徵把請求分配給不同模型的策略,可由人工規則或程序實現 |
| 返工率 | AI 產出被打回、需要再次修改的比例,是衡量真實效率的關鍵指標 |
| 數據駐留 | 數據存儲和處理所在的地理區域,關係到合規要求 |
MAI Code 2 雙檔發佈的影響速覽
- 企業技術負責人:採購和評估的維度從“選一個最強模型”變爲“爲不同任務配不同檔位”,需要準備任務分類和成本覈算口徑。
- 使用 GitHub Copilot 的開發者:兩款模型已在 Copilot 中提供,日常可以根據任務大小主動切換,但具體可選範圍以所在組織的策略爲準。
- 在 Foundry 上構建應用的團隊:目前只有 Flash 以受限預覽形式提供,需要先確認訪問資格,不宜按全面可用來排期。
- 依賴第三方平臺的開發者:發佈稿中 OpenRouter、Vercel、Hermes、OpenCode、Kilo 等渠道標註爲“即將上線”,在實際開放前不應寫進生產方案。
- 合規與安全團隊:多出一個模型就多一組數據流向和權限邊界,需要在試點前完成核查。
1. 客觀事實:MAI Code 2 與 Flash 發佈了什麼
本部分只整理微軟公開材料中的信息。涉及性能與案例的內容均爲廠商發佈或轉述,並非獨立評測,本團隊也沒有對這兩款模型進行實測。
1.1 MAI Code 2 雙檔定位:Code 2 與 Flash 各管什麼
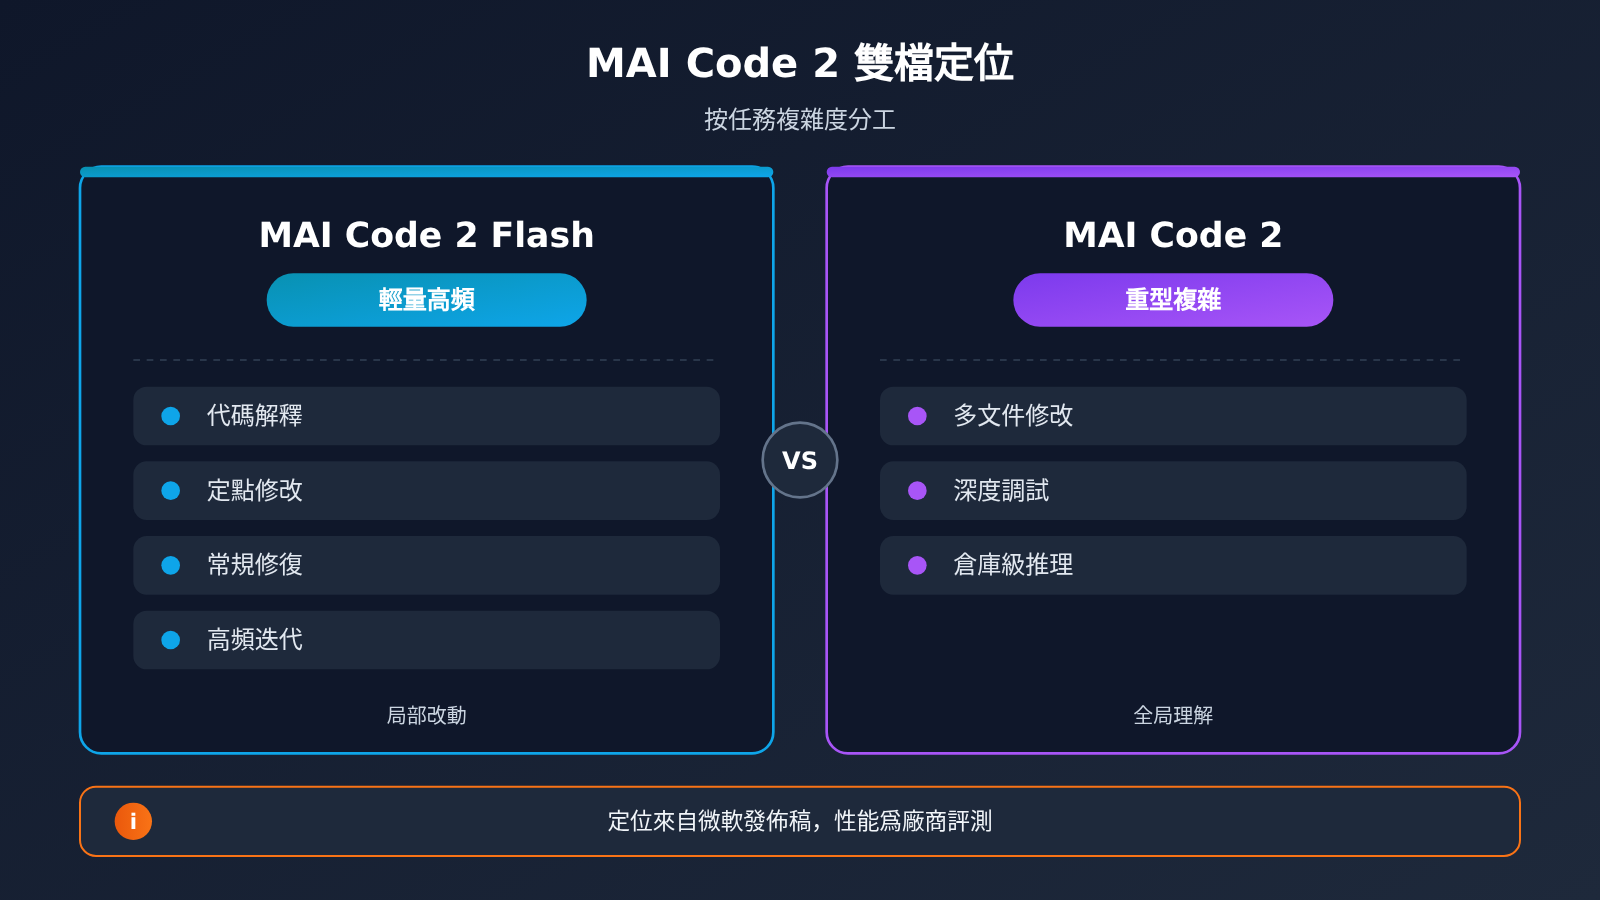
微軟在發佈稿中把兩款模型的分工寫得比較清楚:重型檔負責需要全局理解的複雜工程任務,輕量檔負責高頻、局部、節奏快的日常任務。
| 維度 | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| 官方定位 | 多文件修改、深度調試、倉庫級推理 | 代碼解釋、定點修改、常規修復、高頻迭代 |
| 任務特徵 | 跨文件依賴多,需要理解整體結構 | 範圍明確,改動集中在局部 |
| 選型建議(本文判斷) | 先評估跨文件正確性 | 先評估局部任務質量與響應速度 |
| 評測性質 | 廠商評測 | 廠商評測 |
1.2 MAI Code 2 的上線渠道與可用狀態
可用性是最容易被誤讀的部分。根據微軟發佈稿和 Azure AI Foundry 博客,各渠道狀態如下:
| 渠道 | MAI Code 2 | MAI Code 2 Flash | 狀態說明 |
|---|---|---|---|
| GitHub Copilot | 已提供 | 已提供 | 已上線 |
| Microsoft Foundry | 未列爲可用 | 受限訪問預覽 | 需申請資格 |
| OpenRouter、Vercel、Hermes、OpenCode、Kilo | 即將上線 | 即將上線 | 發佈稿標註爲 soon,不代表已全量開放 |
1.3 MAI Code 2 模型卡規格
微軟同時發佈了兩款模型的模型卡。目前可以確認的公開規格如下:
- 輸入模態爲文字和圖片,輸出模態爲文字。
- 模型上下文爲 1.05M token,其中輸入上限 922k、輸出上限 128k。
- 以上是模型卡規格,不是每個產品入口的可用額度承諾。使用時需另查具體產品限制。例如在某個 IDE 插件中能用到的上下文,可能小於模型卡數值。
關於總參數量,公開材料中存在版本不一致的情況,本文不予採信和引用。
1.4 MAI Code 2 企業定製案例與 MAI Work Flash
微軟在 MAI Code 2 的模型頁面中提到了 AT&T 和 Woven by Toyota 兩家企業的定製模型場景。這些內容屬於廠商轉述,描述的是特定企業的特定定製化用法,不能推廣爲“所有企業任務都能獲得同樣效果”。
另一條值得單獨說明的信息是 MAI Work Flash。發佈稿稱它是在 Code 2 Flash 基礎上進一步優化的衍生模型,服務於 M365 和 FabricIQ。因此,MAI Work Flash 在辦公場景中的成績,不能直接當作基礎版 Code 2 Flash 的成績來引用。
1.5 做預算時,要區分促銷費率與長期成本
GitHub Copilot 價格文檔列出的每百萬 token 美元費率如下,順序爲輸入/緩存輸入/輸出:
| 模型 | 促銷費率 | 自2027年5月17日起的常規費率 |
|---|---|---|
| MAI Code 2 | 0.50/0.025/2.50 | 1.00/0.05/5.00 |
| MAI Code 2 Flash | 0.05/0.005/0.25 | 0.10/0.01/0.50 |
官方未說明該日期的具體時區。這裏是 Copilot 計費口徑,不能直接當作 Foundry 或第三方平臺報價。微軟發佈稿中的相對成本宣傳採用50%促銷價和指定評測配置;企業長期預算應同時測算常規價、失敗重試與人工返工。
2. 分析判斷:MAI Code 2 雙檔背後的企業任務分層
以下爲編輯部的分析與建議,不代表微軟官方立場。下文不是對微軟產品自動路由功能的說明;這裏提出的企業分流、升級和驗收規則需要另行設計與驗證。
2.1 爲什麼 MAI Code 2 拆成兩檔:競爭點從總榜轉向成本分配
企業請求可能同時包含“重構整個模塊”和“解釋一個函數”等任務,比例應從團隊臺賬統計,不能預設大多數都是簡單任務。若簡單任務也一律使用大型模型,可能增加不必要的成本;實際延遲仍需測量。如果全部交給輕量模型,複雜任務又容易失敗並反覆返工。
雙檔發佈實際上是把這種取捨擺到了檯面上:廠商不再只強調單一模型的上限,而是提供一對分工明確的組合。對企業來說,真正形成差異的,是能否把合適的任務交給合適的檔位,並持續覈算結果。這一判斷基於 1.1 節的官方定位,至於實際成本差距有多大,需要每個團隊用自己的數據來驗證。
2.2 第一步:爲 MAI Code 2 類雙檔模型建立任務臺賬
先不要急着接模型,而是用兩到四周時間,把團隊實際交給 AI 的編程任務登記下來。臺賬不必複雜,關鍵是記錄能夠判斷複雜度的字段:
| 臺賬字段 | 記錄內容 | 用於判斷 |
|---|---|---|
| 任務類型 | 解釋、修復、新功能、重構、調試 | 初步分檔 |
| 涉及文件數 | 單文件或多文件 | 是否需要倉庫級理解 |
| 是否有可復現錯誤 | 有報錯日誌或測試用例 | 調試深度 |
| 驗收方式 | 單測通過、人工審查、上線觀察 | 驗收成本 |
| 結果 | 一次通過、返工幾次、放棄 | 檔位是否選對 |
有了臺賬,後續的分層規則就有了依據,而不是憑感覺劃線。
2.3 第二步:設定低成本默認路由
建議只讓低風險、範圍明確、驗收條件充分的任務從輕量檔開始。文件數量可以作爲線索,不能獨立決定風險:一個文件裏的鑑權、支付或生產配置修改,也可能需要直接升級並加強人工審查。
可先寫一張人工分流表,而不是馬上接入自動代理:代碼解釋和無副作用的建議任務先用輕量檔;跨模塊變更、根因不明的調試交給複雜檔;涉及祕密信息、生產權限或安全邊界的任務先經過負責人審覈。本文沒有執行接入測試,也不保證任何第三方已支持這兩款模型。
2.4 第三步:爲複雜任務制定升級規則
默認路由只解決了“先走哪條路”的問題,還需要明確什麼時候升級。建議採用兩類觸發條件:
- 事前升級:臺賬顯示任務涉及多文件、需要倉庫級理解或深度調試時,直接交給重型檔。
- 事後升級:輕量檔的產出未通過測試,或同一任務返工超過約定次數,自動或手動切換到重型檔重試。
給每次嘗試記錄任務標識、模型、用量、驗收結果和升級原因。重試應帶上上一輪的失敗信息,並設置次數或預算上限;超過上限轉人工處理,不無限循環。不能只憑輸出含有函數名或“測試通過”的文字判定成功,應運行可信測試並覈對實際變更。
2.5 第四步:人工驗收不能省
無論哪一檔模型,產出最終都要經過人工審查才能合併。建議按任務檔位設置不同的驗收強度:輕量檔的定點修改以測試通過加快速審查爲主;重型檔的多文件改動則需要資深工程師審查依賴關係和潛在副作用。廠商評測成績再好,也不能替代你所在代碼庫裏的驗收。
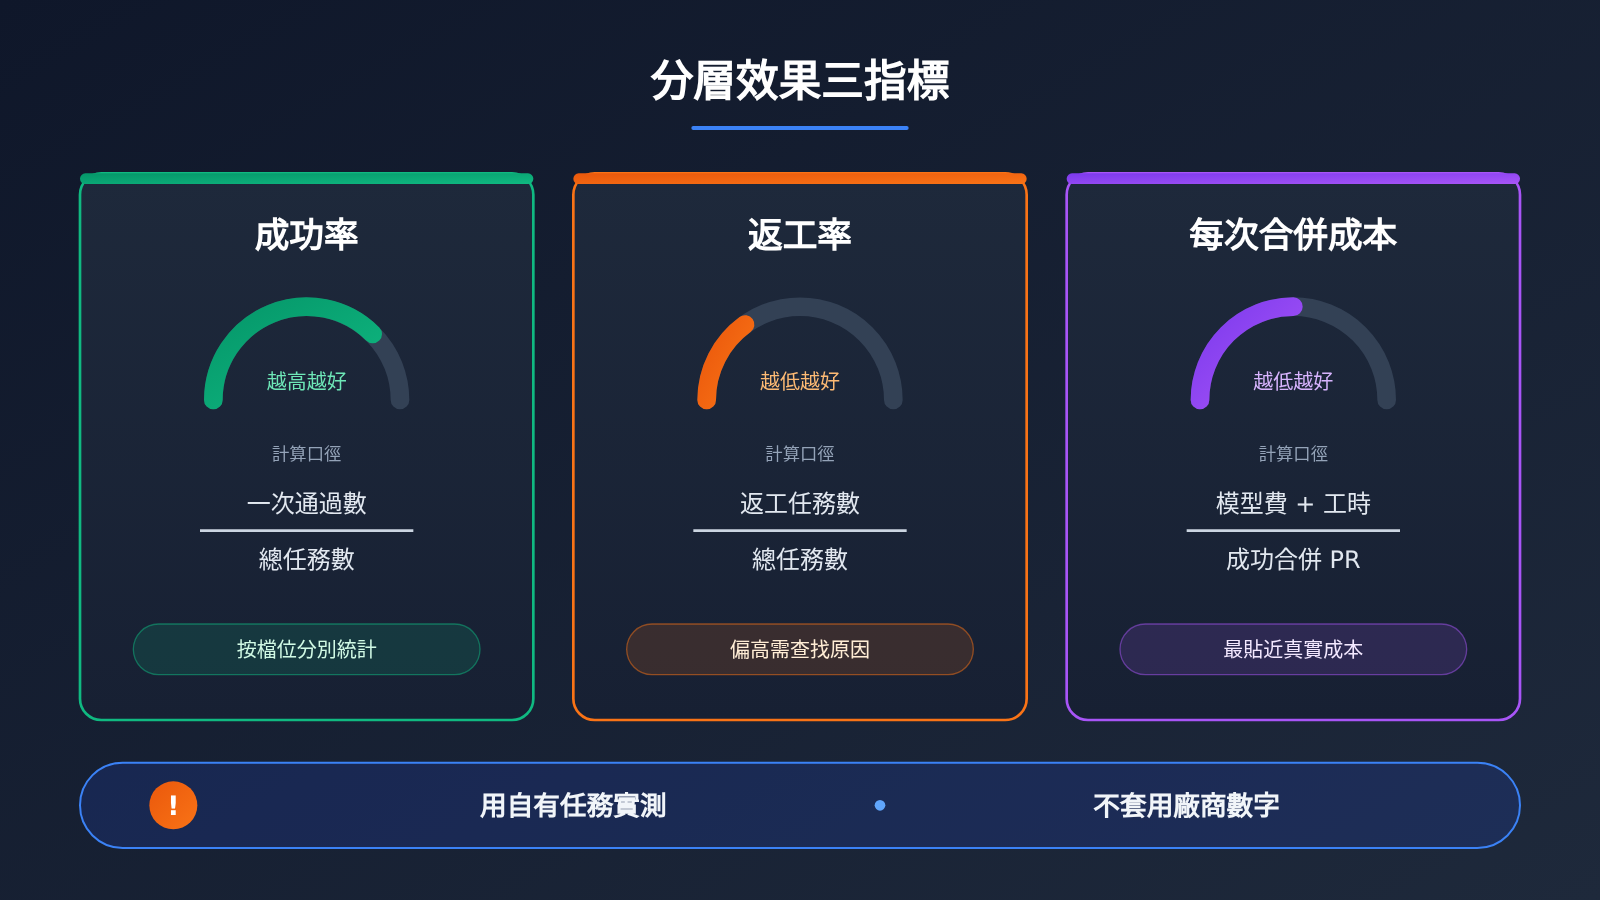
2.6 第五步:用成功率、返工率和每次合併成本衡量 MAI Code 2 分層效果
只看 token 單價容易得出錯誤結論:輕量檔單次更便宜,但如果返工三次,總成本可能反而更高。建議用下面三個指標做覈算:
| 指標 | 計算口徑 | 說明 |
|---|---|---|
| 成功率 | 一次通過驗收的任務數 ÷ 總任務數 | 按檔位、按任務類型分別統計 |
| 返工率 | 被打回重做的任務數 ÷ 總任務數 | 返工率高時同時排查分檔、資料缺失和驗收定義 |
| 每次合併成本 | (模型調用費用 + 人工審查與返工工時折算)÷ 成功合併的 PR 數 | 最接近真實業務成本 |
這三個指標應在自己的任務上測出來,不宜直接套用廠商或媒體給出的“效率提升百分比”。不同代碼庫、不同語言、不同驗收標準下,結果差異可能很大。
2.7 試點前核查:MAI Code 2 的數據駐留與權限
多引入一個模型檔位,就多出一組數據流向。試點前建議至少覈查以下事項:
- 數據駐留:確認所用渠道(Copilot、Foundry 或第三方平臺)的數據處理區域是否滿足所在行業和地區的合規要求。Foundry 上的 Flash 處於受限預覽階段,預覽期條款可能與正式版不同。
- 代碼訪問權限:倉庫級推理意味着模型可能讀取更大範圍的代碼。應限定可訪問的倉庫和目錄,並排除密鑰、配置文件等敏感內容。
- 組織策略:在 Copilot 中能否切換模型、能切換哪些模型,取決於組織管理員的設置,需要提前確認。
- 審計日誌:確保每次調用的模型、發起人和輸入範圍都可追溯,以便事後覆盤。
2.8 MAI Code 2 不應過度解讀的三件事
- 產品路由不等於本文的企業治理流程。即使所用產品提供自動模型選擇,也需獨立覈驗路由規則、驗收門檻和權限,不能把它視爲本文五步法已自動實現。
- 不等於微軟放棄與 OpenAI 的合作。推出自研編程模型,並不能推出微軟棄用 OpenAI 模型的結論,現有公開材料也不支持這一推論。
- 不等於廠商評測可以直接複用。性能數據與企業案例均來自微軟,AT&T、Woven by Toyota 屬於特定定製場景,MAI Work Flash 是另行優化的衍生模型,它們的成績都不能直接遷移到你的任務上。
2.9 MAI Code 2 後續值得關注的信號
以下屬於預測性觀察,有待後續事實驗證。第一,OpenRouter 等渠道何時真正開放,以及開放後的計費方式。第二,Foundry 上的 Flash 何時結束受限預覽,重型檔是否也會進入 Foundry。第三,產品層面的上下文限制與模型卡中的 1.05M 相差多少,這會直接影響倉庫級任務能否一次性放入上下文。
雙檔發佈釋放的信號很樸素:編程 AI 的價值,不在於每次都調用最強的模型,而在於爲每類任務找到成本與質量的平衡點。先把任務登記清楚,再讓數據決定分界線,比追逐任何一個總榜名次都更可靠。正如《論語·衛靈公》所說:“工欲善其事,必先利其器。”
參考資料
- Microsoft AI:MAI Code 2 與 Flash 發佈稿
- Microsoft Foundry:模型選擇與企業定製
- MAI Code 2 與 Flash 官方模型卡
- Microsoft AI:企業定製案例
- GitHub:Copilot 模型價格與促銷日期


