
Google 在 2026-11-11 的開發者博客裏給出了一個很具體的用例:Gemini Notebook 把 Decisions API 當作實時路由器,在請求進入時把日常問題分到合適的模型檔和思考檔,官方自報日常查詢延遲最多降低 40%。注意這個數字是 Google 自己報的,不是第三方壓測,也不是某家平臺的實測結論。
這不是又一次模型能力升級,而是把“選模型”這件事從開發者的代碼裏搬到了請求路徑上。
核心價值:3 分鐘看清 gemini-decision-1 到底是什麼、怎麼計費、以及它對你的調用鏈意味着什麼。
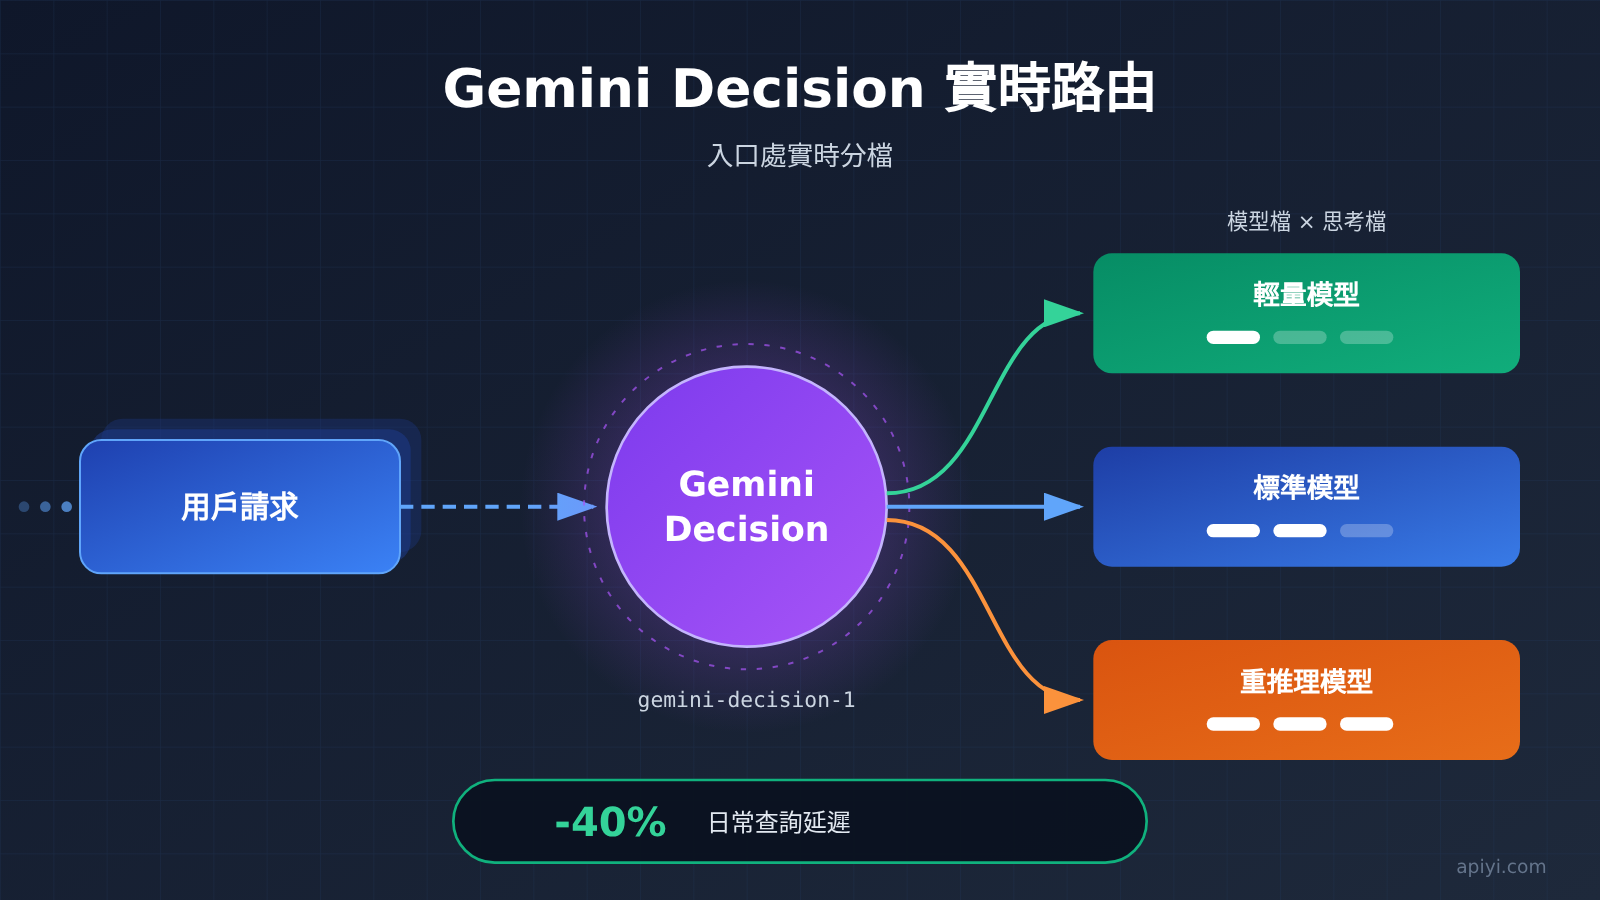
Gemini Decision 核心信息速覽
| 信息項 | 詳情 |
|---|---|
| 公佈時間 | 2026-11-11,Google 開發者博客 |
| 模型 ID | gemini-decision-1 |
| 定位 | 實時路由與決策,而非內容生成 |
| 首個公開用例 | Gemini Notebook 內部做日常問題分檔 |
| 輸入價格 | $0.10 / 1M tokens |
| 輸出價格 | $0 |
| 延遲收益 | 官方自報日常查詢最多降低 40% |
| 聚合平臺上架情況 | 截至 2026-11-12,API易 apiyi.com 價目表中暫無該 ID |
表格裏最容易被忽略的是輸出價格爲 $0 這一行。它說明 gemini-decision-1 的產出不是一段正文,而是一個極短的判斷結果——分到哪一檔、用多少思考預算。把這種模型和對話模型放在同一張價目表裏比較單價,會得出完全錯誤的結論。
另一個細節是它已經有一個真實的生產用例,而不是停留在文檔示例階段。Gemini Notebook 是 Google 自家產品,這套路由是先在自己產品裏跑起來、再對外講的做法,可信度比純 benchmark 更高,但仍然屬於官方單方面的描述。
Gemini Decision 如何工作:官方自報的路由案例
按照 Google 博客的說法,Gemini Notebook 的日常問題會先經過 Decisions API 判斷,再決定走哪個模型檔、哪個思考檔。也就是說,路由決策本身變成了一次模型調用,而不是一段寫死的 if-else 規則或一個手調的閾值。
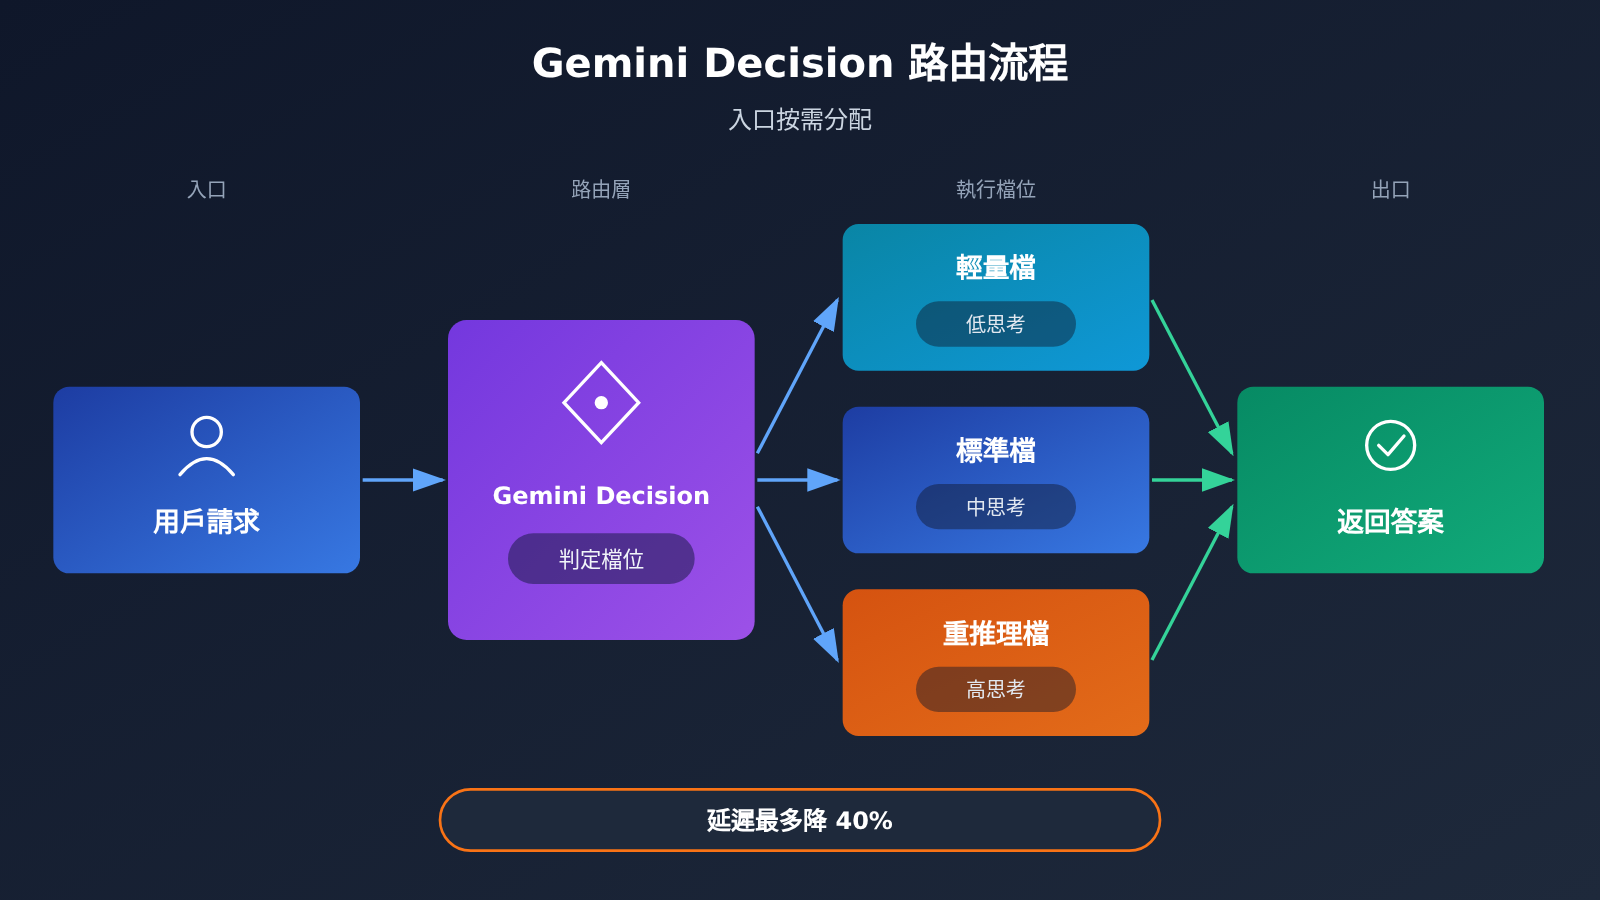
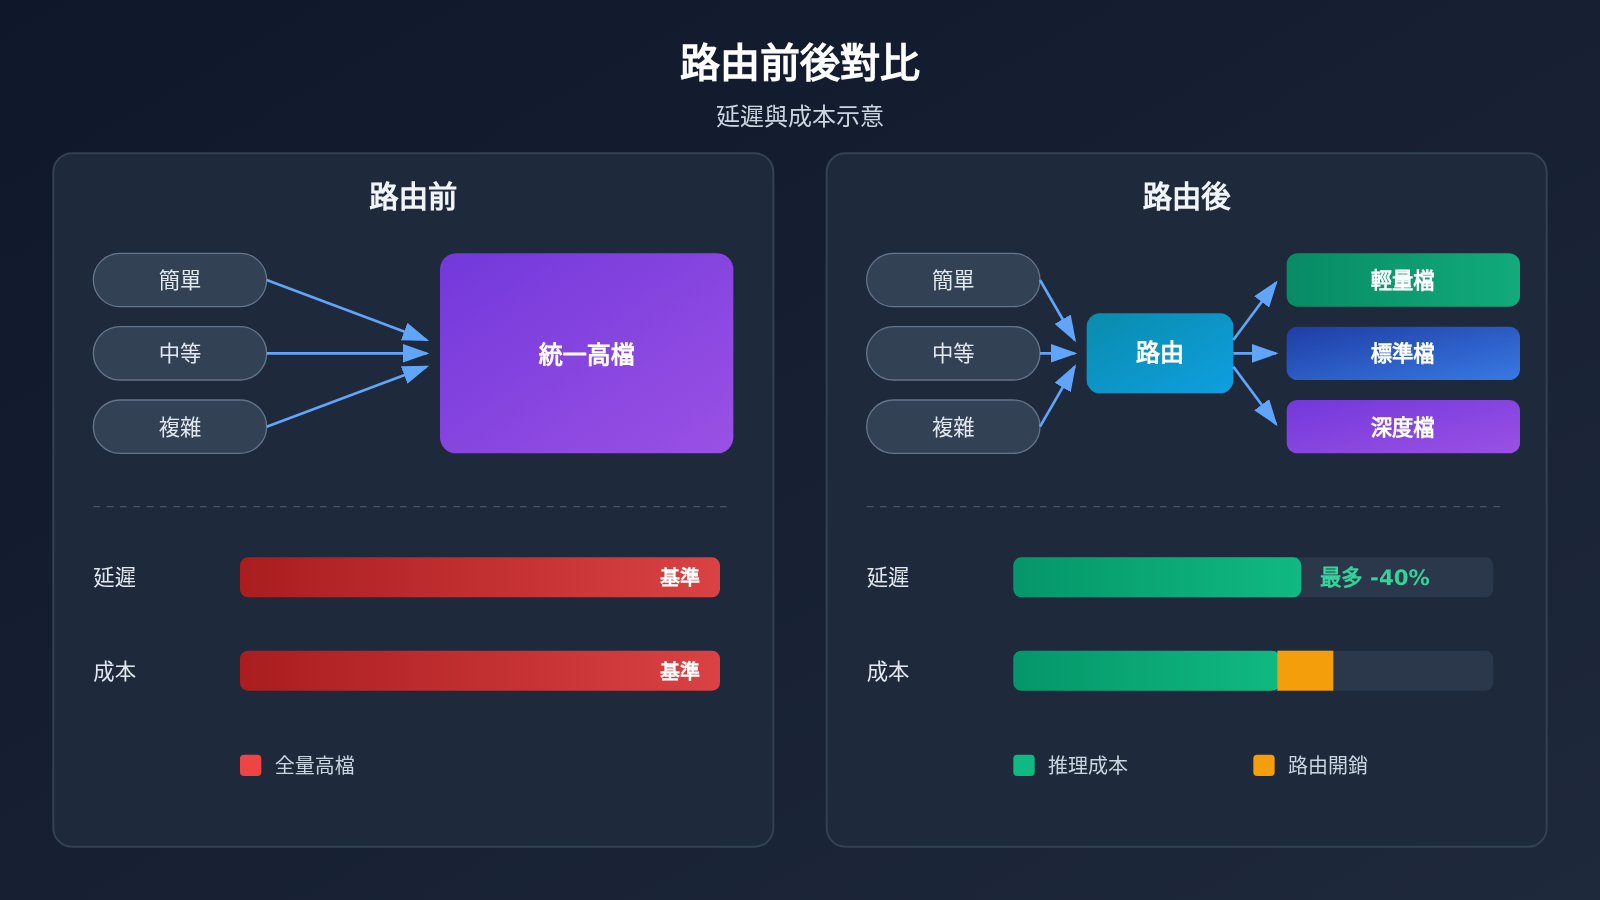
這套設計要解決的問題很現實:同一款產品裏,大部分請求是輕量的日常提問,少數才需要重推理。如果所有請求都走同一檔,輕請求被重模型拖着走,延遲和成本一起上升;如果全走輕檔,複雜問題又答不好。用一個專門的決策模型在入口處做判斷,等於把“按需分配”做成了基礎設施。
| 環節 | 路由前的常見做法 | 引入 Decision 之後 |
|---|---|---|
| 檔位判斷 | 代碼裏寫規則或按關鍵詞匹配 | 由模型根據請求內容判斷 |
| 維護方式 | 閾值隨業務變化需要人工調 | 判斷邏輯隨模型更新 |
| 延遲影響 | 重檔請求多時整體變慢 | 官方自報日常查詢最多降 40% |
| 成本影響 | 全部請求按同一檔計費 | 輕請求落到輕檔,賬單結構改變 |
需要說清楚的是,40% 這個數字對應的場景是“日常查詢”,不是所有請求。官方表述用的是上限口徑,實際業務裏的收益取決於你的請求裏有多少屬於那部分可以被降檔的問題。如果你的產品本身就全是長文檔分析或複雜代碼任務,可降檔的空間天然更小。
🎯 技術建議:想驗證這類路由思路在自己業務上的收益,可以先用 API易 apiyi.com 的統一接口把不同檔位的模型各跑一遍,對比同一批請求的延遲與輸出質量,再決定是否引入路由層。
Gemini Decision 的計費結構與成本含義
輸入 $0.10 / 1M tokens、輸出 $0,這個結構本質上是在按“讀進去多少上下文”收費。路由判斷需要看到請求內容才能做決定,所以輸入側收費合理;而它只吐出一個檔位結論,輸出側幾乎不產生成本,官方乾脆定爲 0。
這意味着接入方要多算一筆賬:路由層自己也在消耗 token。當請求被降檔後省下的那部分推理成本,要能覆蓋掉這筆額外的判斷開銷,整體纔是淨收益。請求越長、檔位差越大,這筆賬越容易算正;請求短、本來就走輕檔的場景,加一層路由可能反而更貴。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# gemini-decision-1 目前尚未在平臺價目表中上架
# 可先把 model 換成現有的對話模型驗證業務鏈路
response = client.chat.completions.create(
    model="YOUR_MODEL",
    messages=[{"role": "user", "content": "這個問題需要多深的推理?"}]
)
print(response.choices[0].message.content)
🚀 快速開始:截至 2026-11-12,API易 apiyi.com 的價目列表裏還沒有 gemini-decision-1,平臺會盡快跟進上架。在它上架之前,用同一套 OpenAI 兼容接口調用其他模型驗證鏈路,切換成本幾乎爲零;具體型號與價格請以 apiyi.com 列表爲準。
誰會被影響:三類調用鏈的實際變化
應用側:路由從自己寫變成調接口
過去做多模型分流,團隊通常要維護一套規則表,還要隨模型版本換代反覆調參。如果路由判斷可以外包給一個專門的決策模型,應用側的邏輯會明顯變薄,剩下的工作變成定義“有哪些檔”和“每檔放哪個模型”。代價是多了一次串行調用,因此入口層的網絡質量會直接影響總延遲。
成本側:延遲下降不等於賬單下降
延遲和成本是兩條不同的曲線。降檔能同時壓低兩者,但路由自身按輸入 token 計費,短請求場景下的邊際成本會變高。穩妥的做法是先按請求類型分組,只對“複雜度差異大”的那部分流量啓用路由,其他流量走固定檔位。
| 團隊類型 | 主要受益點 | 需要注意的成本項 |
|---|---|---|
| 面向 C 端的問答產品 | 日常問題延遲下降,體驗改善明顯 | 路由調用的額外 token 開銷 |
| 企業內部工具 | 複雜與簡單請求混跑,檔位差異大 | 需要重新設計檔位劃分 |
| 高頻短請求服務 | 收益有限,降檔空間小 | 串行多一跳可能得不償失 |
平臺側:新模型 ID 的跟進速度變成選型因素
模型更新節奏越來越快,一個 ID 從公佈到穩定可用之間往往有窗口期。對使用聚合平臺的團隊來說,這段時間裏能不能快速拿到可調用的接口,直接影響驗證排期。這也是 API易 apiyi.com 這類平臺的價值所在:一個 API Key、OpenAI 兼容接口,模型上架後不需要改代碼結構就能切換。上架進度和計費細節以 apiyi.com 頁面展示爲準。
常見問題 FAQ
Q1: Gemini Decision 是什麼?
Google 公佈的 gemini-decision-1 是一個用於實時路由與決策的模型。它不負責生成正文,而是判斷一個請求該走哪個模型檔和哪個思考檔,Gemini Notebook 是它目前公開的第一個生產用例。
Q2: 它和普通 Gemini 模型有什麼區別?
普通對話模型輸出的是內容,它的輸出是一個極短的判斷結果,因此計費結構完全不同:輸入 $0.10 / 1M tokens,輸出 $0。把它當作“更便宜的生成模型”來理解,方向就錯了。
Q3: 延遲最多降低 40% 是怎麼來的?
這個數字來自 Google 官方博客的自報,指的是 Gemini Notebook 在日常查詢場景下的延遲改善上限,並非第三方獨立壓測結果。實際收益取決於你的請求中有多少屬於可以被降檔的輕量問題。
Q4: 它能爲我的業務省下多少錢?
沒有通用答案。省下的推理成本來自請求被分到更輕的檔位,而路由本身按輸入 token 計費。請求越長、檔位差異越大,淨收益越明顯;高頻短請求場景要謹慎評估。
Q5: 現在能調用 Gemini Decision 嗎?
截至 2026-11-12,API易 apiyi.com 的價目表中還沒有 gemini-decision-1,平臺會盡快上架。在此之前,可以用 apiyi.com 的統一接口先跑通業務鏈路,等 ID 上架後替換模型名即可;具體型號與價格以 apiyi.com 列表爲準。
Q6: 引入路由層有哪些已知代價?
主要三點:請求路徑上多一次串行調用,入口網絡質量變得更重要;路由判斷本身消耗輸入 token,短請求的邊際成本上升;檔位劃分需要按業務重新設計,不能照搬別人的分檔方式。
Gemini Decision 核心要點 Key Takeaways
- 定位:gemini-decision-1 是實時路由模型,輸出檔位判斷,不生成正文。
- 用例:Gemini Notebook 用它把日常問題分到合適的模型檔與思考檔。
- 收益:官方自報日常查詢延遲最多降低 40%,屬自報口徑。
- 計費:輸入 $0.10 / 1M tokens,輸出 $0,按讀入上下文收費。
- 代價:路由自身消耗 token,短請求場景淨收益需單獨測算。
- 上架:截至 2026-11-12,API易 apiyi.com 暫無該 ID,會盡快跟進,價格以 apiyi.com 列表爲準。
- 驗證方式:先用統一接口跑通鏈路,再決定是否在生產引入路由層。
總結
這次公佈的價值不在模型本身有多強,而在於 Google 把“選模型”做成了一個可以對外提供的接口,並且先在自己產品裏跑通。對開發者來說,值得記住三點:路由決策正在從代碼邏輯變成一次模型調用;延遲收益是官方自報的上限口徑,需要按自己的流量結構重新估算;新增的計費維度會讓成本結構變化,不能只看降檔省下的那部分。
想提前驗證這條路,可以先用現有模型把分檔邏輯跑起來,等 gemini-decision-1 在 API易 apiyi.com 上架後再替換一次模型名即可完成切換,型號與價格以 apiyi.com 列表爲準。
參考資料
- Google 官方博客:Gemini Decisions API
- 鏈接:
blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ -
說明: 本文關於模型 ID、路由用例、延遲數字與定價的唯一原始來源
-
API易 apiyi.com 價目列表
- 鏈接:
apiyi.com - 說明: 用於覈對 gemini-decision-1 的上架狀態與最終計費口徑
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 apiyi.com 首頁聯繫我們,模型上架動態與新接口說明可在站內文檔中心查看


