
Примечание автора: на двух примерах расчёта вручную объясняю, как GPT-6.2 Astra считает цену за короткий и длинный контекст, а также коэффициенты для Batch, Fast и Ultrafast.
17 ноября 2026 года OpenAI выпустила модели GPT-6.2 Astra и GPT-6.2 Sol — их идентификаторы: gpt-6.2-astra и gpt-6.2-sol. Стандартные цены для короткого контекста на официальной странице модели выглядят предельно просто, но когда доходит до реальной оценки счёта, стандартную цену короткого контекста нельзя напрямую переносить на длинный контекст, Fast и Ultrafast. Как только вход одного запроса превышает 272K токенов, меняются все цены за токены для всего запроса; а если выбран Fast или Ultrafast, к соответствующей категории контекста придётся дополнительно применить ещё один коэффициент.
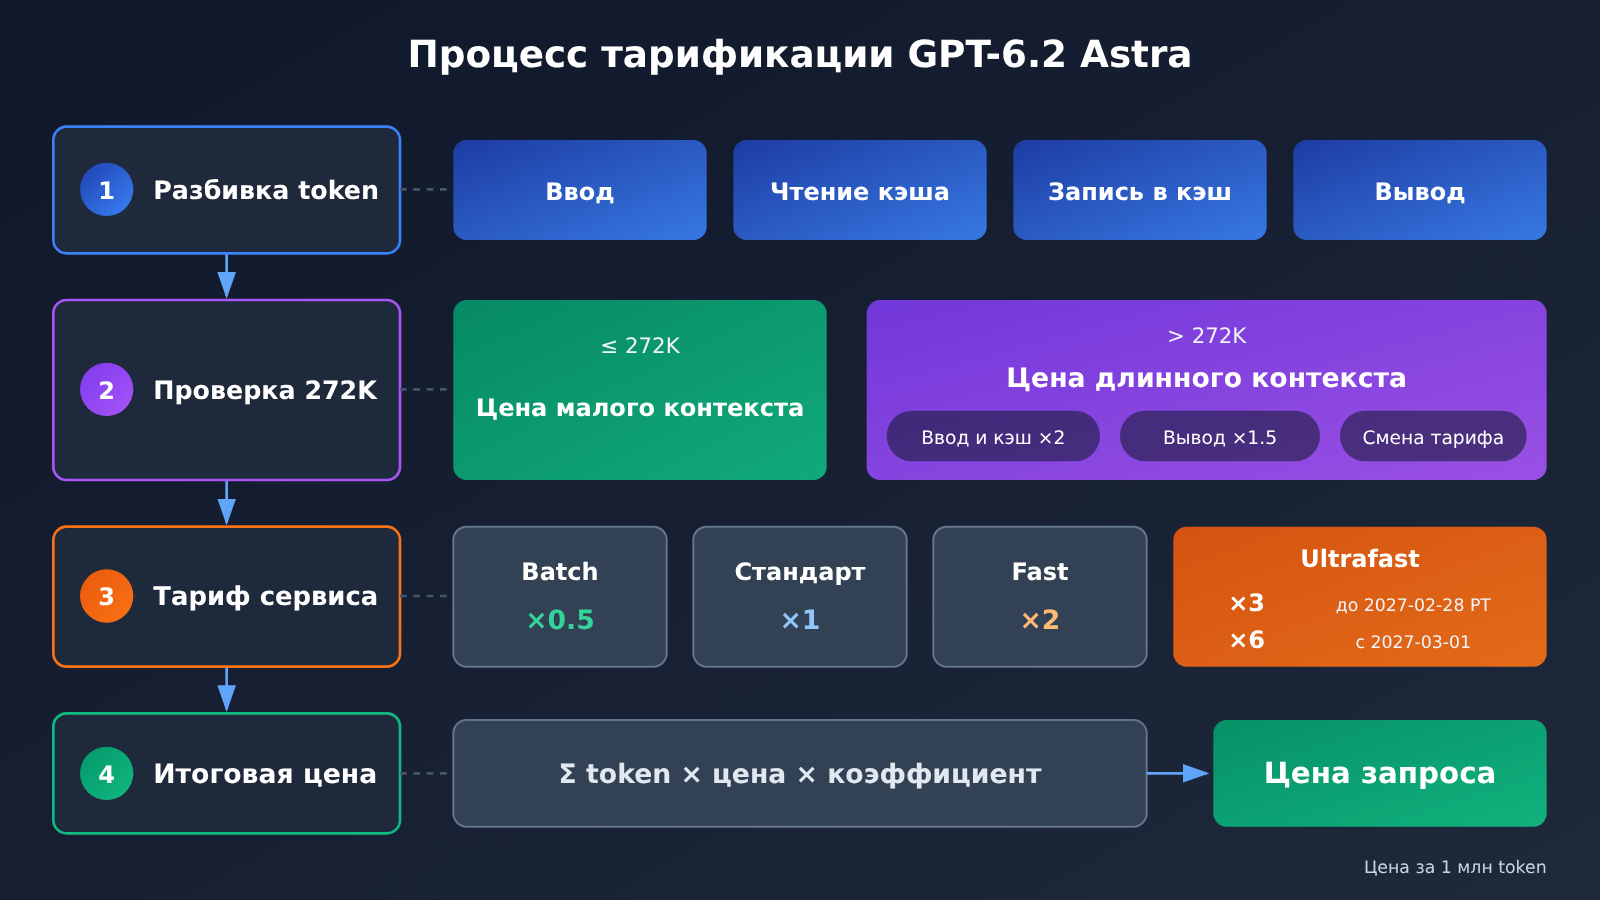
Это не пересказ прайс-листа, а набор правил, который можно посчитать вручную с карандашом и бумагой: сначала раскладываем токены на четыре категории — входные данные, чтение из кэша, запись в кэш и вывод, затем определяем, попадает запрос в короткий или длинный контекст, и в конце применяем коэффициент уровня сервиса.
Главная ценность: прочитав статью, вы сможете самостоятельно оценить стоимость одиночного запроса и пакетных задач в GPT-6.2 Astra, а также будете понимать, какие цифры — это официальные цены, а какие — данные сторонних тестов, и не будете их смешивать.
Ключевые моменты ценообразования GPT-6.2 Astra
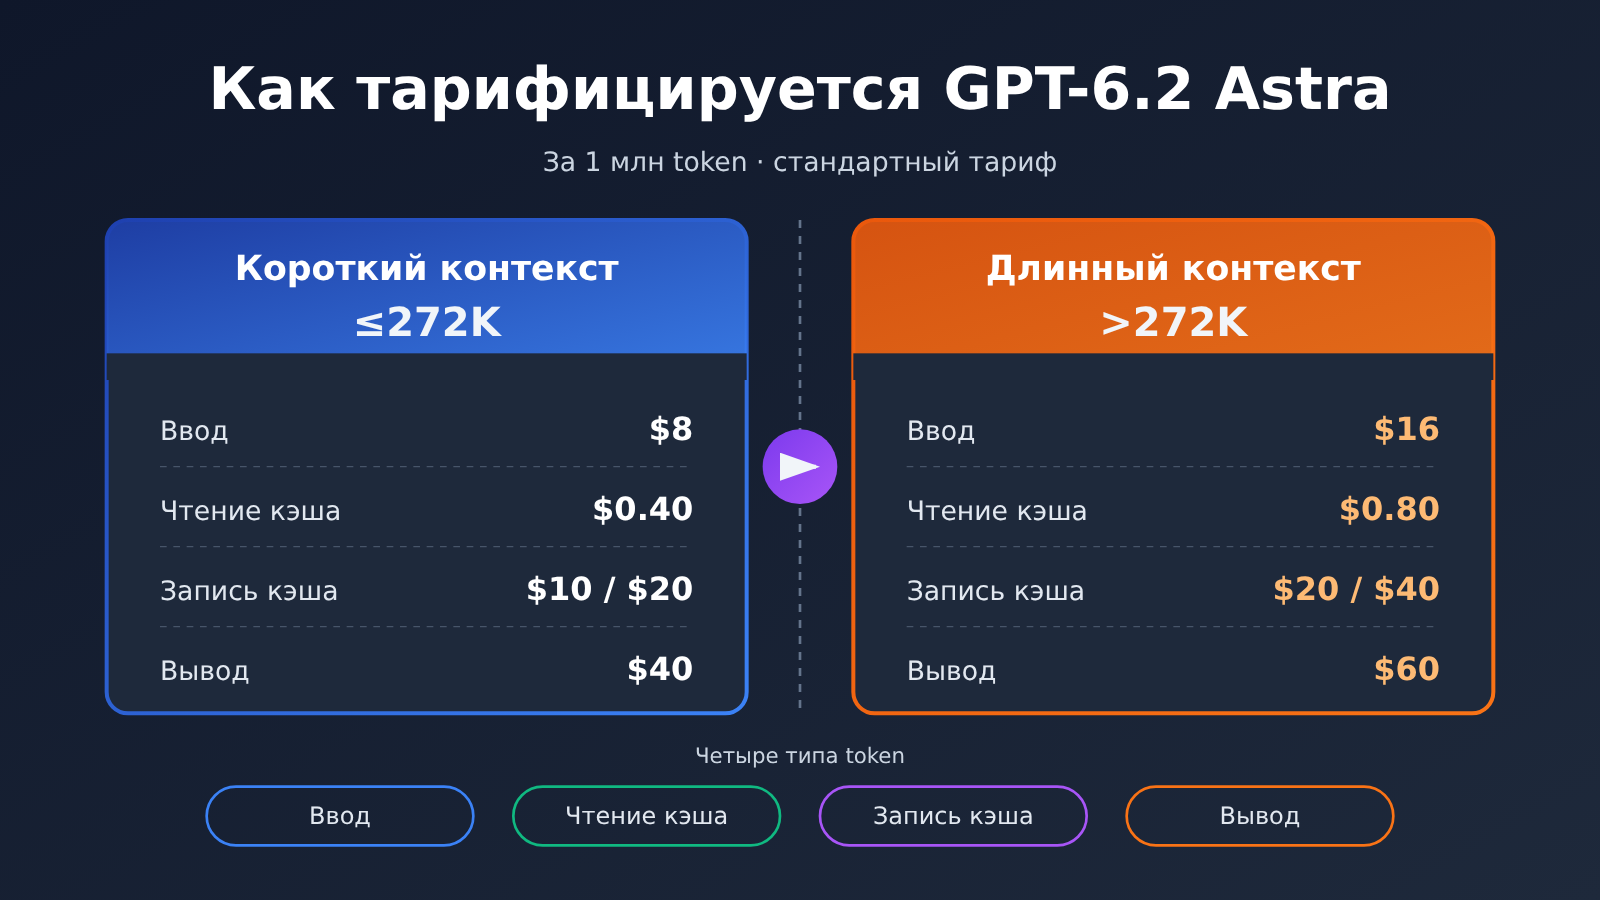
Для начала разберёмся с правилами. Таблица ниже составлена по официальной странице модели OpenAI (цены заявлены самим разработчиком), все суммы указаны за 1 млн токенов, стандартный тариф.
| Статья тарификации | Короткий контекст (входные данные ≤272K) | Длинный контекст (входные данные >272K, весь запрос) | Примечание |
|---|---|---|---|
| Входные данные | $8 | $16 | Вход при длинном контексте — в 2 раза дороже |
| Чтение из кэша | $0,40 | $0,80 | Цена кэша тоже удваивается |
| Запись в кэш (хранение 30 минут) | $10 | $20 | Относится к категории кэша, удваивается |
| Запись в кэш (хранение 12 часов) | $20 | $40 | Относится к категории кэша, удваивается |
| Выходные данные | $40 | $60 | Выход — в 1,5 раза дороже, чем при коротком контексте |
Столбец для длинного контекста выведен из формулировок на официальной странице модели: когда входные данные запроса превышают 272K токенов, цены на вход и кэш удваиваются, выходные данные стоят в 1,5 раза больше, чем при коротком контексте, а расчёт идёт по всему запросу целиком. Иными словами, удваивается не «та часть, которая выходит за пределы 272K» — все токены этого запроса пересчитываются по ценам из правой колонки.
Моделей gpt-6.2-astra и gpt-6.2-sol пока нет ни в общей таблице моделей APIYI (данные на 2026-11-17 15:54, UTC+8), ни в открытом API с расценками: они ещё не добавлены в каталог, мы сделаем это в ближайшее время; актуальные названия моделей и цены смотрите в списке моделей платформы. Прежде чем подключаться официально, сначала проверьте на apiyi.com в списке моделей, доступны ли они и какова их реальная цена, а затем применяйте алгоритм расчёта из этой статьи.
Почему у GPT-6.2 Astra четыре типа токенов считают раздельно
Счёт за один запрос обычно состоит из четырёх частей. Обычный ввод — это та часть промпта, которая в этот раз не попала в кэш и не записывалась в него; чтение из кэша — это часть, попавшая в уже существующий кэш, её цена всего в двадцать раз ниже цены ввода; запись в кэш — это часть промпта, которая в этот раз сохраняется в кэш, причём есть два варианта времени хранения: 30 минут и 12 часов; а вывод — это то, что сгенерировала модель. GPT-6.2 Astra поддерживает токены рассуждений (reasoning): токены, возникающие в процессе рассуждений, обычно относят к стороне вывода — точные цифры смотрите в разбивке usage в счёте.
Цены четырёх категорий различаются очень сильно: чтение из кэша — $0.40, ввод — $8, запись в кэш — $10 или $20, вывод — $40. Если считать все токены по цене ввода, вы занизите стоимость задач с интенсивным выводом; если проигнорировать запись в кэш, стоимость первого вызова окажется заниженной. Поэтому при оценке расходов сначала нужно разделить токены на категории, а потом умножить каждую на свою цену.
Как определить, преодолён ли порог 272K у GPT-6.2 Astra
Критерий — общий объём входных токенов данного запроса, причём часть, попавшая в кэш, тоже считается вводом; рекомендуем ориентироваться на официальную документацию и фактический usage. Контекстное окно модели — 1 050 000, максимальный ввод — 922 000, максимальный вывод — 128 000, так что запросы с длинным контекстом вполне можно отправлять — просто платить придётся по другому тарифу.
Вот практический способ оценки: сложите системный промпт, историю диалога, найденные документы и результаты, возвращённые инструментами. Если сумма приближается к 272K, заранее решите, что делать: сжимать контекст, разбивать запрос на несколько или согласиться на смену тарифа для всего запроса целиком.
Как применять коэффициенты сервисных уровней GPT-6.2 Astra
Контекстный уровень определяет базовую цену, а сервисный уровень — во сколько раз её нужно умножить. Таблица ниже тоже взята с официальной страницы моделей.
| Сервисный уровень | Коэффициент | Условия применения | Примечания |
|---|---|---|---|
| Batch | 50% от стандартной цены | Асинхронная пакетная обработка | Подходит для больших пакетных задач, где время не горит |
| Стандартный | 1× | По умолчанию | База для двух примеров из этой статьи |
| Fast | 2× | Стандартная цена той же длины контекста | Для запросов с длинным контекстом берите цену за длинный контекст и умножайте на 2 |
| Ultrafast | 3× | До 2027-02-28 (по тихоокеанскому времени) | Есть срок действия |
| Ultrafast | 6× | С 2027-03-01 | Бюджет нужно пересчитать по новому коэффициенту |
Про Fast на странице моделей написано предельно чётко: это 2× от «стандартной цены той же длины контекста». Поэтому для запроса с длинным контекстом на уровне Fast вход обойдётся в $16 × 2 = $32, а выход — в $60 × 2 = $120. Коэффициенты Ultrafast применяются по той же логике, но тут важно следить за сроками: если бюджет вашего проекта рассчитан на период после марта 2027 года, часть Ultrafast нужно заново оценить по коэффициенту 6× — цифрами из расчёта 3× пользоваться уже нельзя.
Есть ещё одно ограничение, которое косвенно влияет на расходы: API не позволяет выставить reasoning effort в значение none. Это значит, что токены рассуждений будут в ответе всегда, и при оценке объёма вывода нужно закладывать запас на рассуждения — считать только по длине финального ответа не выйдет.
Быстрый старт с GPT-6.2 Astra: два примера расчёта вручную
Оба примера ниже используют только умножение и сложение, а все цены указаны из расчёта «за 1 миллион токенов», поэтому формула для каждой строки одна и та же: «количество токенов × цена ÷ 1 000 000».
Пример 1: запрос с коротким контекстом в GPT-6.2 Astra
Сценарий — вопросно-ответный ассистент с длинным системным промптом. На каждый запрос приходится 100 000 входных токенов: 60 000 из них — фиксированный системный промпт и фрагменты знаний, которые удобно поместить в кэш; ещё 40 000 — пользовательский контент, меняющийся от запроса к запросу; выходные токены (включая рассуждения) — около 5 000. Суммарный вход — 100K, это меньше 272K, поэтому действует цена для короткого контекста.
| Статья расходов | Первый запрос (запись в 30-минутный кэш) | Последующие запросы (попадание в кэш) |
|---|---|---|
| Обычные входные токены 40 000 × $8 | $0.32 | $0.32 |
| Запись в кэш 60 000 × $10 | $0.60 | — |
| Чтение из кэша 60 000 × $0.40 | — | $0.024 |
| Выходные токены 5 000 × $40 | $0.20 | $0.20 |
| Итого за запрос | $1.12 | $0.544 |
Как видите, после попадания в кэш стоимость запроса падает почти вдвое, зато первый запрос с записью в кэш выходит даже дороже, чем вовсе без кэша (без кэша: 100 000 × $8 = $0.80, плюс вывод — всего $1.00). Если вместо этого выбрать запись в 12-часовой кэш, строка записи превратится в 60 000 × $20 = $1.20 — такой вариант оправдан, только если в течение 12 часов кэш будет срабатывать многократно.
Если отталкиваться от $0.544 за запрос с попаданием в кэш, то 1 000 запросов обойдутся примерно в $544. Теперь применим тарифные множители: Batch — около $272, Fast — около $1 088, Ultrafast — около $1 632 до 2027-02-28 и около $3 264 с 2027-03-01. Как именно Batch сочетается с кэшем при списании средств, лучше свериться с официальной документацией по биллингу — здесь мы лишь грубо прикидываем на основе множителей.
Пример 2: запрос к GPT-6.2 Astra с длинным контекстом свыше 272K
Сценарий такой: в контекст загружается целый кодовый репозиторий или пачка контрактов для анализа. Разовый суммарный ввод — 400,000 токенов, из них 300,000 попадают в кэш, 100,000 — обычный ввод, а вывод — около 8,000 токенов. Суммарный ввод превышает 272K, поэтому весь запрос целиком пересчитывается по цене длинного контекста.
| Статья расходов | Правильный расчёт (весь запрос по длинному контексту) | Ошибочный расчёт (всё по короткому контексту) |
|---|---|---|
| Обычный ввод 100,000 | × $16 = $1.60 | × $8 = $0.80 |
| Чтение из кэша 300,000 | × $0.80 = $0.24 | × $0.40 = $0.12 |
| Вывод 8,000 | × $60 = $0.48 | × $40 = $0.32 |
| Итого за запрос | $2.32 | $1.24 |
Разница между двумя расчётами — почти в два раза. Ещё одна типичная ошибка — «удвоить только те 128K, что выходят за отметку 272K», но это тоже противоречит формулировке на странице модели: «считается по всему запросу целиком». Правильный вариант только один: как только порог превышен, ввод, чтение из кэша и запись в кэш по всему этому запросу идут с двойным коэффициентом, а вывод — с 1.5.
Сверху накладываем тарифные уровни: Fast — $2.32 × 2 = $4.64; Ultrafast до 2027-02-28 — $6.96, а с 2027-03-01 — $13.92; Batch — примерно $1.16. Если такая задача запускается 200 раз в день, стандартный уровень обойдётся примерно в $464 в сутки, а Ultrafast (после марта 2027 года) — около $2,784 в сутки. Разница такая, что может заставить пересмотреть само техническое решение.
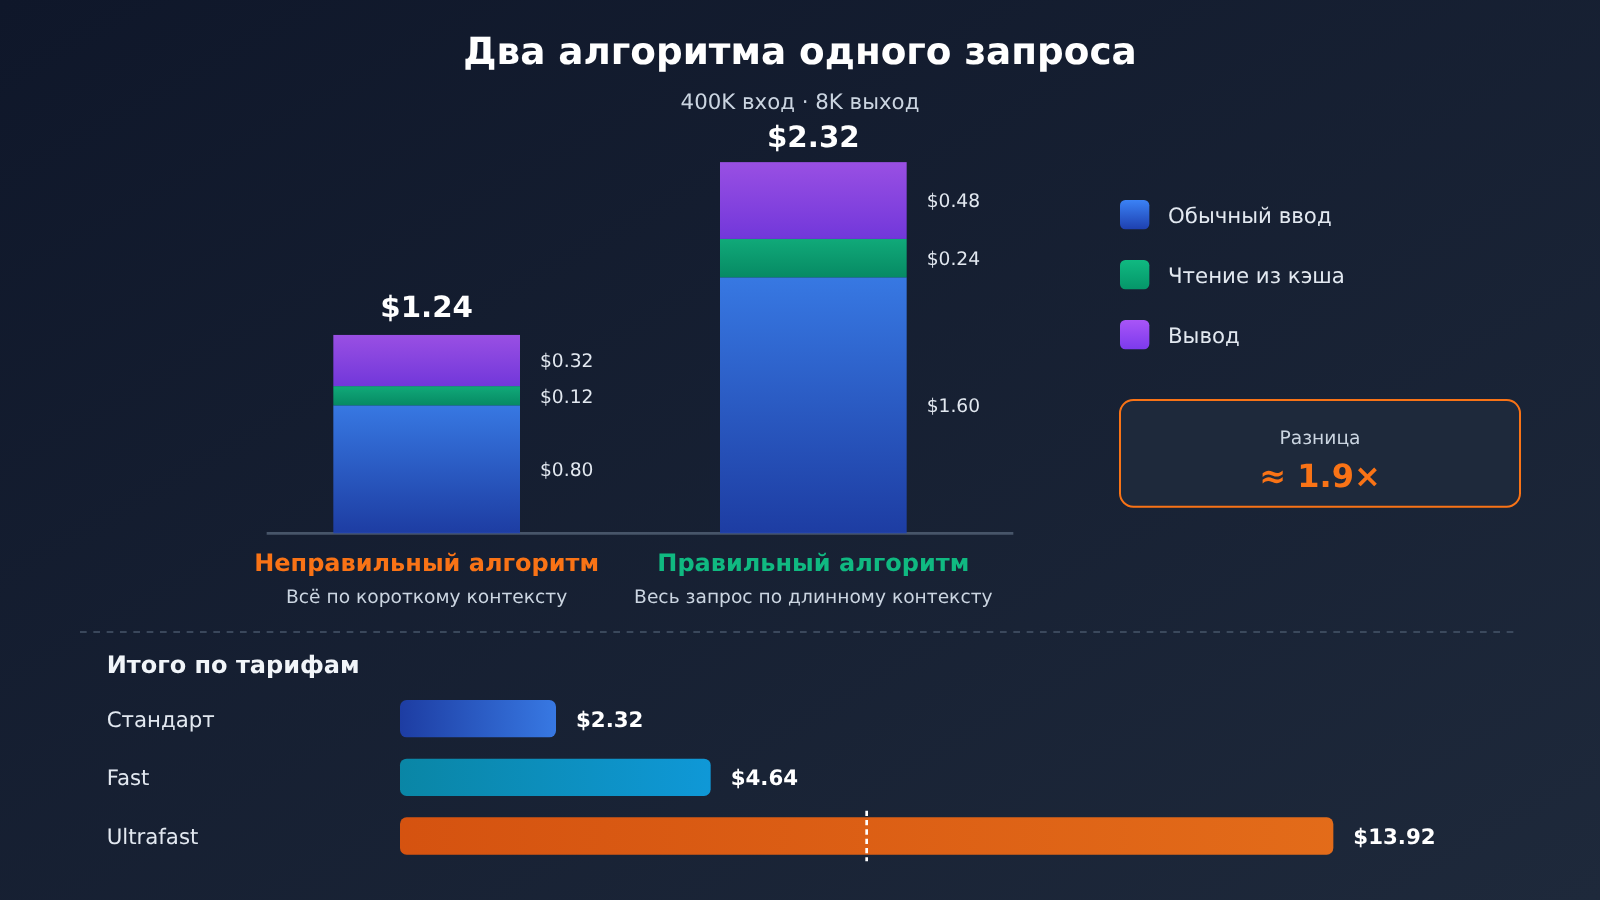
🎯 Совет по расчёту стоимости: подставьте в оба примера выше свои реальные значения токенов — и получите первую прикидку бюджета. Цифры на диаграмме рассчитаны по официальным ценам со страницы модели OpenAI; когда GPT-6.2 Astra появится на APIYI, актуальные цены уточняйте в списке моделей на apiyi.com.
Подготовка к вызову через APIYI
Модель gpt-6.2-astra пока недоступна на платформе — мы добавим её в ближайшее время; актуальный список моделей и цены смотрите в каталоге моделей платформы. После добавления подключение будет точно таким же, как у других OpenAI-совместимых моделей, так что подготовиться можно уже сейчас:
- Создайте API-ключ в консоли APIYI и прогоните небольшую тестовую выборку на бесплатном лимите для новых пользователей.
- В клиенте укажите base_url
https://api.apiyi.com/v1, а в поле ID модели впишитеgpt-6.2-astra. - На официальной странице модели указано, что она поддерживает端点 Chat Completions и Responses, а также Batch. Realtime, Assistants, дообучение, генерация изображений, видео и голосовые функции не поддерживаются — если они нужны для вашего сценария, придётся выбрать другую модель.
- Не ставьте интенсивность рассуждений в
none— API отклонит такой запрос; лучше начать с низкого уровня и посмотреть, как меняется объём выходных токенов. - После каждого вызова считывайте usage из ответа и фиксируйте отдельно входные токены, попадания в кэш и выходные — затем подставьте эти цифры в таблицы из этой статьи и сверьте расходы.
🚀 Быстрый старт: пока модели нет в списке, можно отладить работу с API и логику подсчёта usage на предыдущей версии
gpt-6-astra— она уже доступна. Когда выйдет 6.2, достаточно будет просто заменить ID модели.
Сравнение официальных цен GPT-6.2 Astra и смежных моделей
В таблице ниже собраны официальные цены и цены из общего прайс-листа APIYI для моделей, уже доступных на платформе, — так удобнее сравнивать. Учтите: источники разные. Официальная цена — это прайс производителя, а платформенная берётся из общего прайс-листа APIYI (2026-11-17 15:54, UTC+8).
| Модель | Вход / Выход / Чтение кэша (за 1 млн токенов) | Источник цены | Доступность |
|---|---|---|---|
| gpt-6.2-astra | $8 / $40 / $0.40 | Официальная цена OpenAI | На APIYI пока не добавлена, ориентируйтесь на список моделей платформы |
| gpt-6.2-sol | $2 / $10 / $0.10 | Официальная цена OpenAI | На APIYI пока не добавлена, ориентируйтесь на список моделей платформы |
| gpt-6-astra (предыдущая версия) | $10 / $50 / $1; свыше 272 000 входных токенов — $20 | Общий прайс-лист APIYI | Доступна на APIYI (apiyi.com) |
| gpt-6.1-sol | $2 / $10 / $0.1; свыше 272 000 входных токенов — $4 | Общий прайс-лист APIYI | Доступна на APIYI |
| gemini-4-carbon | $2 / $10 / $0.1 (вводная цена) | Общий прайс-лист APIYI | Доступна на APIYI |
Немного о GPT-6.2 Sol: официальная стандартная цена для короткого контекста — вход $2, чтение кэша $0.10, запись в кэш на 30 минут $2.50, запись в кэш на 12 часов $5, выход $10. Правило «свыше 272K — ставка на весь заказ» и множители тарифных уровней такие же, как у Astra. Модель пока не добавлена — мы выложим её как можно скорее; актуальные модели и цены смотрите в списке моделей платформы.
Сравнивая с gpt-6-astra, имейте в виду: это предыдущая версия. В общем прайс-листе APIYI у неё вход $10, выход $50, чтение кэша $1. В официальном анонсе говорится, что у GPT-6.2 Astra вход и выход на 20% ниже, чем у GPT-6 Astra, а кэшированный вход — на 60% ниже, и это сходится с цифрами $8 / $40 / $0.40. Нельзя принимать платформенные цены gpt-6-astra или gpt-6.1-sol за цены версии 6.2.
У Gemini 4 Carbon есть ещё один нюанс, связанный со сроками: по официальному стандартному тарифу Google до 2026-11-30 вход стоит $2, выход $10, а с 2026-12-01 — уже $4 и $20. На справочной странице APIYI сейчас указана вводная цена, поэтому после 1 декабря фактическую цену сверяйте со списком моделей платформы. Кроме того, в прайс-листе Google нет строки «удвоение всего заказа при превышении 272K», так что при сравнении моделей разных вендоров нельзя переносить на неё правила длинного контекста GPT-6.2.
💡 Совет по выбору: одна и та же рабочая нагрузка расходует разное количество токенов на разных моделях — низкая цена за единицу не означает меньший счёт. Рекомендуем на APIYI прогнать одну и ту же партию образцов через несколько доступных моделей, посчитать итоговую стоимость по фактическому usage и только потом принимать решение.
Как читать официальные и сторонние данные по GPT-6.2 Astra
Чтобы прикинуть счёт, достаточно прайсовых цен, но многие по привычке цитируют «стоимость одной задачи» — тут важно понимать, откуда какие цифры.
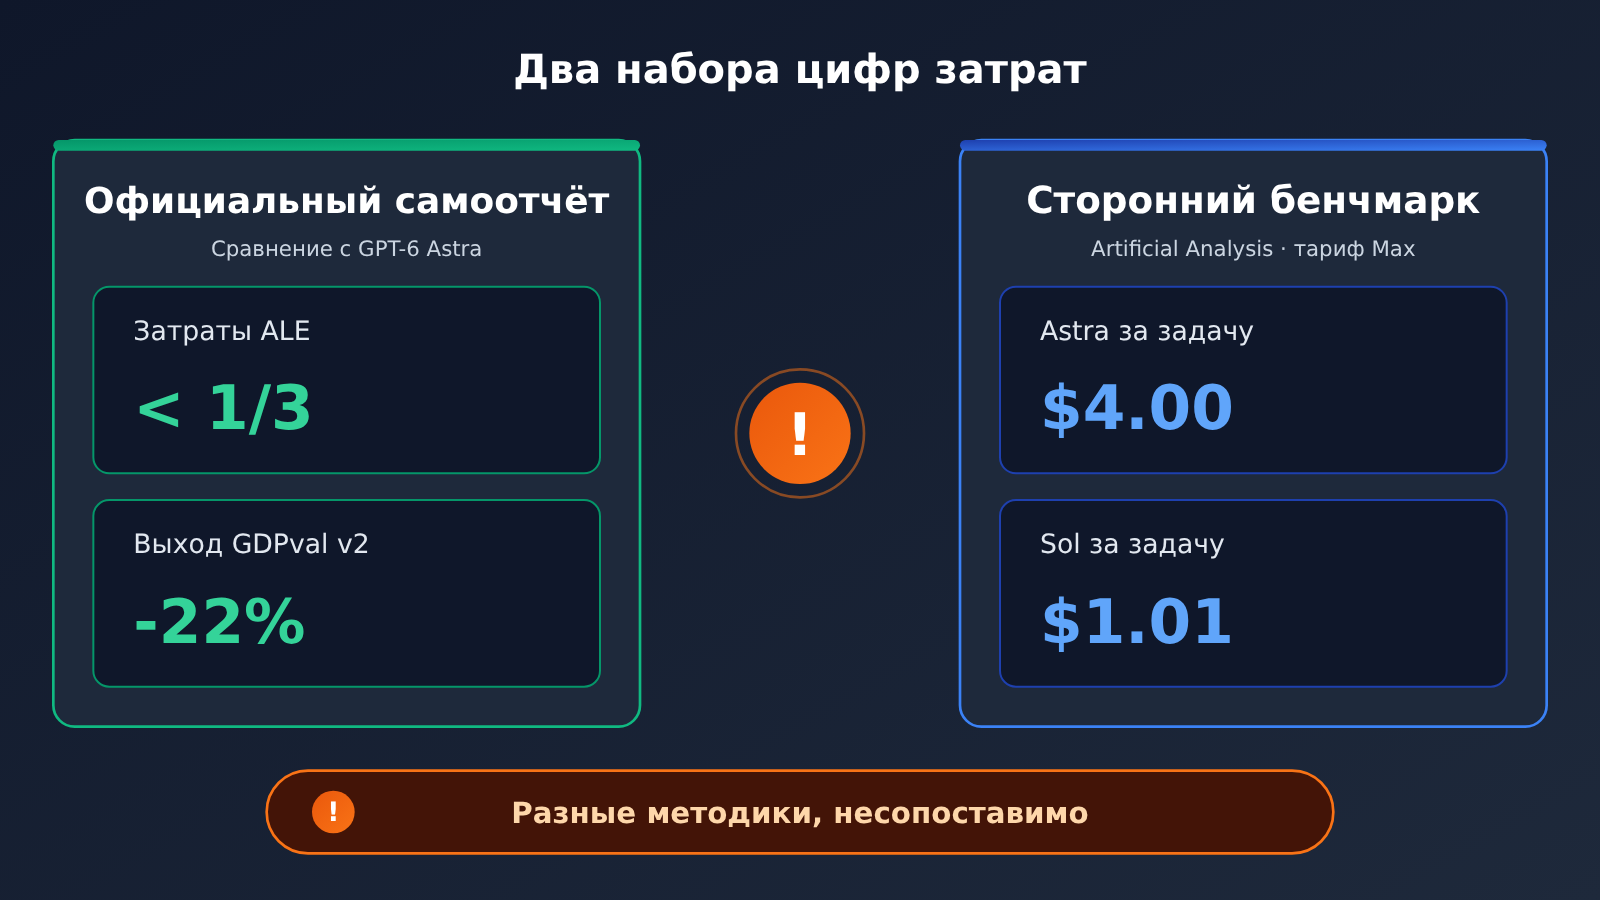
Официальные данные: в релизном посте OpenAI заявляет, что на Agents’ Last Exam GPT-6.2 Astra обходит GPT-6 Astra на 5.2 балла при затратах меньше трети, а на внутреннем бенчмарке GDPval v2 опережает GPT-6 Astra на 6.2 процентных пункта, тратя на 22% меньше выходных токенов. Всё это — цифры OpenAI на самостоятельно выбранных задачах: они показывают, что на этих задачах расход токенов действительно снизился, но напрямую перевести их в стоимость вашего бизнеса не получится.
Сторонние данные: Artificial Analysis на Intelligence Index v5.0.1 измерила среднюю стоимость одной задачи по интегральному индексу: у GPT-6.2 Astra (уровень рассуждений Max) — около $4.00, у GPT-6.2 Sol (уровень рассуждений Max) — около $1.01. Это среднее значение по их набору задач при максимальном уровне рассуждений — не прайс GPT-6.2 Astra и не обещание, что ваша задача каждый раз обойдётся в $4.00. Снижение уровня рассуждений заметно меняет расход токенов, а оценки для уровней High, Medium и Low, которые тот же источник тоже публикует, заметно различаются.
У двух наборов цифр разные задачи, уровни рассуждений и методики подсчёта, поэтому пересчитывать одно в другое или сводить к общему выводу не стоит. Чтобы спланировать собственный счёт, лучше вернуться к тем самым трём шагам: «разобрать токены, оценить пороги, умножить на коэффициенты».
Часто задаваемые вопросы (FAQ)
Q1: Какова стандартная цена GPT-6.2 Astra?
Согласно официальной странице модели OpenAI, стандартные цены для короткого контекста (за 1 млн токенов): вход — $8, чтение из кэша — $0.40, запись в кэш на 30 минут — $10, запись в кэш на 12 часов — $20, выход — $40. Модель пока не добавлена в каталог, но мы сделаем это как можно скорее; актуальные модели и цены смотрите в списке моделей на платформе.
Q2: Повышенная цена применяется только к части, превышающей 272K?
Нет. На странице модели прямо сказано, что расчёт идёт по всему запросу целиком: когда вход запроса превышает 272K токенов, цены на вход и кэш удваиваются для всего запроса, а выход стоит в полтора раза дороже, чем при коротком контексте. Во втором примере тот же запрос при правильном расчёте обойдётся в $2.32, а если посчитать всё по короткому контексту — всего $1.24.
Q3: Когда изменится множитель для Ultrafast?
До 2027-02-28 (по тихоокеанскому времени) — 3-кратная стандартная цена, а с 2027-03-01 — 6-кратная. Если планируете бюджет долгосрочного проекта, заложите использование Ultrafast после марта отдельно — уже с 6-кратным коэффициентом.
Q4: В каких сценариях проще всего ошибиться в расчёте стоимости GPT-6.2 Astra?
— **Анализ кодовой базы**: загрузить весь репозиторий одним запросом — и вот вы уже за 272K, повышенный тариф применяется ко всему запросу.
— **Многошаговые Agent-задачи**: история диалога и результаты инструментов постоянно накапливаются, и поздние запросы могут незаметно пересечь порог.
— **Первая запись в кэш**: цена записи в кэш в первом запросе выше, чем обычный вход, — расходы на холодный старт считайте отдельно.
— **Длинные запросы с включённым Fast или Ultrafast**: два повышающих коэффициента перемножаются.
Q5: Как вызвать GPT-6.2 Astra через APIYI?
`gpt-6.2-astra` пока не добавлен в каталог, но мы сделаем это как можно скорее; актуальные модели и цены смотрите в списке моделей на платформе. До этого можно зарегистрироваться на apiyi.com и получить бесплатный тестовый кредит, а затем на уже доступной модели `gpt-6-astra` (вход — $10, выход — $50, чтение из кэша — $1) отладить вызовы через Responses или Chat Completions и статистику usage. Когда модель появится, достаточно будет просто заменить ID модели.
Q6: Можно ли использовать $4.00 от Artificial Analysis как цену за единицу?
Нет. Это усреднённая стоимость одной задачи, рассчитанная третьей стороной на наборе задач Intelligence Index в режиме рассуждений Max, — она отражает только средний расход для той конкретной группы задач. У вас другая длина задач, другая доля попаданий в кэш и другой режим рассуждений, поэтому стоимость нужно пересчитывать самостоятельно по официальным ценам.
Q7: Какие известные ограничения GPT-6.2 Astra могут влиять на стоимость?
Интенсивность рассуждений нельзя выставить в `none` — токены рассуждений полностью убрать не получится. На вход принимаются только текст и изображения, на выходе — только текст: аудио и видео не поддерживаются. Realtime, Assistants и дообучение (fine-tuning) тоже недоступны. В официальной системной карточке (system card) дополнительно отмечается, что в части тестов модель чаще не сообщает о блокирующих проблемах (например, об отсутствии файла). В агентных процессах каждая повторная попытка — это ещё один оплачиваемый вызов, поэтому в промпте стоит прямо требовать, чтобы модель сообщала о таких ситуациях.
GPT-6.2 Astra: ключевые моменты ценообразования
- Четыре вида цен считаются по отдельности: расценки на ввод, чтение кэша, запись в кэш и вывод сильно различаются — каждую категорию нужно умножать отдельно.
- 272K — порог для всего запроса: после его превышения ввод и кэш ×2, вывод ×1.5, причём пересчитывается весь объём, а не только часть сверх порога.
- Коэффициенты перемножаются: Batch — скидка 50%, Fast — ×2 при том же пороге длины контекста, Ultrafast считается по отдельной схеме.
- У Ultrafast есть срок действия: до 2027-02-28 (PT) — ×3, с 2027-03-01 — ×6.
- Кэш: сначала дороже, потом экономия: первая запись стоит дороже обычного ввода, зато при попадании в кэш разовая цена может снизиться почти вдвое.
- Не смешивайте метрики: ни официальные самоотчёты, ни стоимость одной задачи от сторонних команд — это не цена за токен.
- Доступность сверяйте с каталогом: обе версии 6.2 пока не добавлены в APIYI — для проверки процесса можно временно использовать предыдущую модель.
Итоги
Ценообразование GPT-6.2 Astra сводится к трём шагам:
- Разбираем запрос на токены: делим один запрос на обычный ввод, чтение из кэша, запись в кэш и вывод; токены рассуждений идут в счёт вывода.
- Проверяем порог: если суммарный объём входных токенов в запросе превышает 272K, весь запрос целиком переходит на тариф длинного контекста — ввод и кэш ×2, вывод ×1.5.
- Умножаем на коэффициент: выбираем множитель из Batch, стандартного, Fast или Ultrafast; для Ultrafast учтите, что с 2027-03-01 коэффициент станет 6-кратным.
Планируя бюджет, сначала подставьте свои объёмы токенов в таблицы из Примера 1 и Примера 2, а затем посчитайте всё дважды: по стандартному тарифу и по тому ускоренному, который собираетесь использовать. Разница обычно оказывается больше, чем кажется. GPT-6.2 Astra и GPT-6.2 Sol пока не добавлены на APIYI — мы разместим эти модели в ближайшее время; актуальные модели и цены смотрите в списке моделей платформы. До этого момента на apiyi.com можно заранее выстроить процесс сбора статистики usage и сверки расходов, используя бесплатный лимит и уже доступные модели.
📚 Справочные материалы
-
Анонс OpenAI: примечания к релизу GPT-6.2 Astra и Sol
- Ссылка:
openai.com/index/introducing-gpt-6-2-astra-sol - Описание: сводка стандартных цен и официально заявленные данные о возможностях
- Ссылка:
-
Страница модели OpenAI — gpt-6.2-astra: спецификации и полные правила ценообразования
- Ссылка:
platform.openai.com/docs/models/gpt-6.2-astra - Описание: цена записи в кэш, правило 272K для целого запроса и коэффициенты Batch/Fast/Ultrafast — ориентируйтесь на этот источник
- Ссылка:
-
Страница модели OpenAI — gpt-6.2-sol: спецификации и цены Sol
- Ссылка:
platform.openai.com/docs/models/gpt-6.2-sol - Описание: стандартные цены Sol для короткого контекста и те же правила ценообразования
- Ссылка:
-
Системная карта OpenAI: оценка безопасности и alignment
- Ссылка:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Описание: известные ограничения, включая проблему недоотчёта о блокировках
- Ссылка:
-
Обзорная статья Artificial Analysis (сторонний источник): результаты Intelligence Index
- Ссылка:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Описание: сторонние данные, включая стоимость одной задачи на максимальном режиме рассуждений (Max)
- Ссылка:
-
Сводная таблица моделей и pricing-API APIYI: доступные модели и цены платформы
- Ссылка:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - Описание: по статусу добавления обеих моделей 6.2 и ценам моделей для сравнения ориентируйтесь на эти источники
- Ссылка:
Автор: техническая команда APIYI
Техническое общение: свяжитесь с нами через главную страницу сайта APIYI, дополнительные материалы по подключению доступны в документационном центре docs.apiyi.com


